💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
文章目录
1、研究背景
新生儿败血症作为新生儿期严重的感染性疾病,其早期诊断与病情评估高度依赖临床多指标数据的动态变化。传统医疗信息化系统虽积累了海量的生命体征记录,但缺乏针对新生儿这一特殊群体的深度挖掘与可视化呈现手段,导致数据价值难以被临床医生快速捕捉。面对心率、血氧、体温、血压等多维度时序数据,以及ICU住院时长、败血症发病时段等复杂临床场景,亟需一套能够整合大数据存储与计算能力、机器学习算法以及前端可视化技术的分析平台。基于Hadoop与Spark构建的大数据底座,结合MySQL进行结构化数据管理,并利用K-Means聚类、Isolation Forest异常检测等数据挖掘技术,能够有效解决传统方法在处理高并发、高维度医疗数据时的性能瓶颈。Vue与ECharts的引入,使得复杂的临床指标能够以雷达图、热力图、时序折线图等直观形式展现,为新生儿败血症的临床研究提供了从数据采集、清洗、分析到可视化的全链路技术支撑,顺应了精准医疗与大数据融合发展的必然趋势。
2、研究目的和意义
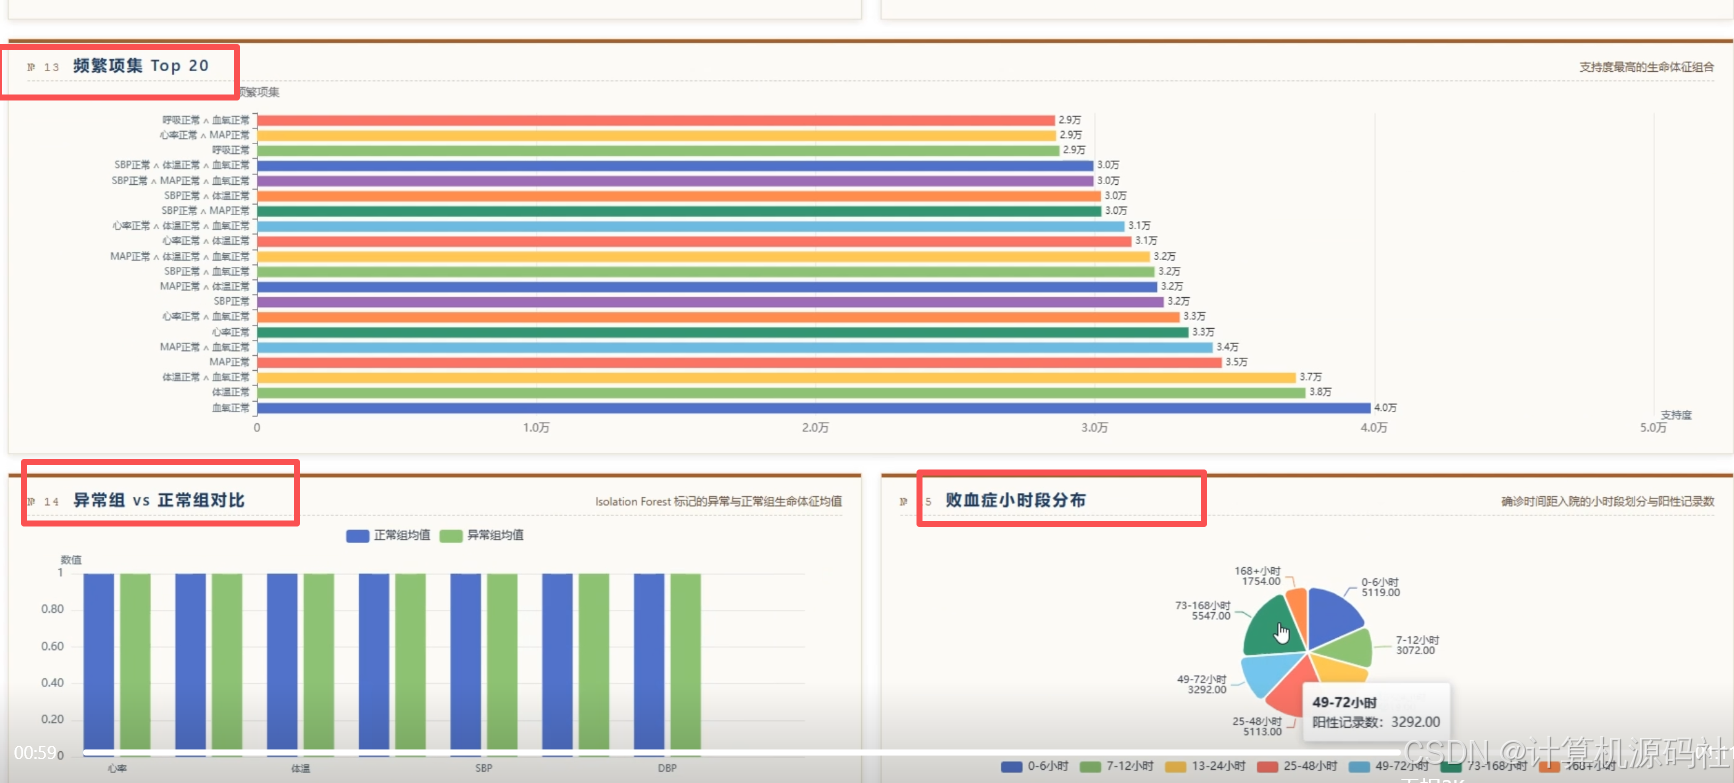
本系统旨在构建一个面向新生儿败血症临床多指标数据的综合性可视化分析平台,以解决临床数据碎片化与决策支持不足的问题。通过整合患者编号、性别、年龄等基础信息与心率、血氧饱和度、体温、收缩压、平均动脉压等生命体征数据,系统实现了对海量临床记录的集中管理与高效查询。利用K-Means算法对生命体征进行聚类画像,系统能够识别出不同患者的生理特征模式,辅助医生进行精细化分型。通过Isolation Forest算法标记异常组与正常组,系统提供了对比分析功能,有助于发现潜在的病情恶化征兆。系统还特别关注败血症的时段分布与ICU时长聚类,通过柱状图与环形图直观展示不同时间段的确诊记录数与住院时长构成,从而帮助医疗人员掌握疾病的时间规律与资源占用情况。最终,系统通过数据大屏与详细数据表相结合的方式,为临床科研人员提供从宏观趋势到微观个体的全方位数据洞察,提升新生儿败血症的临床管理效率与科研分析深度。
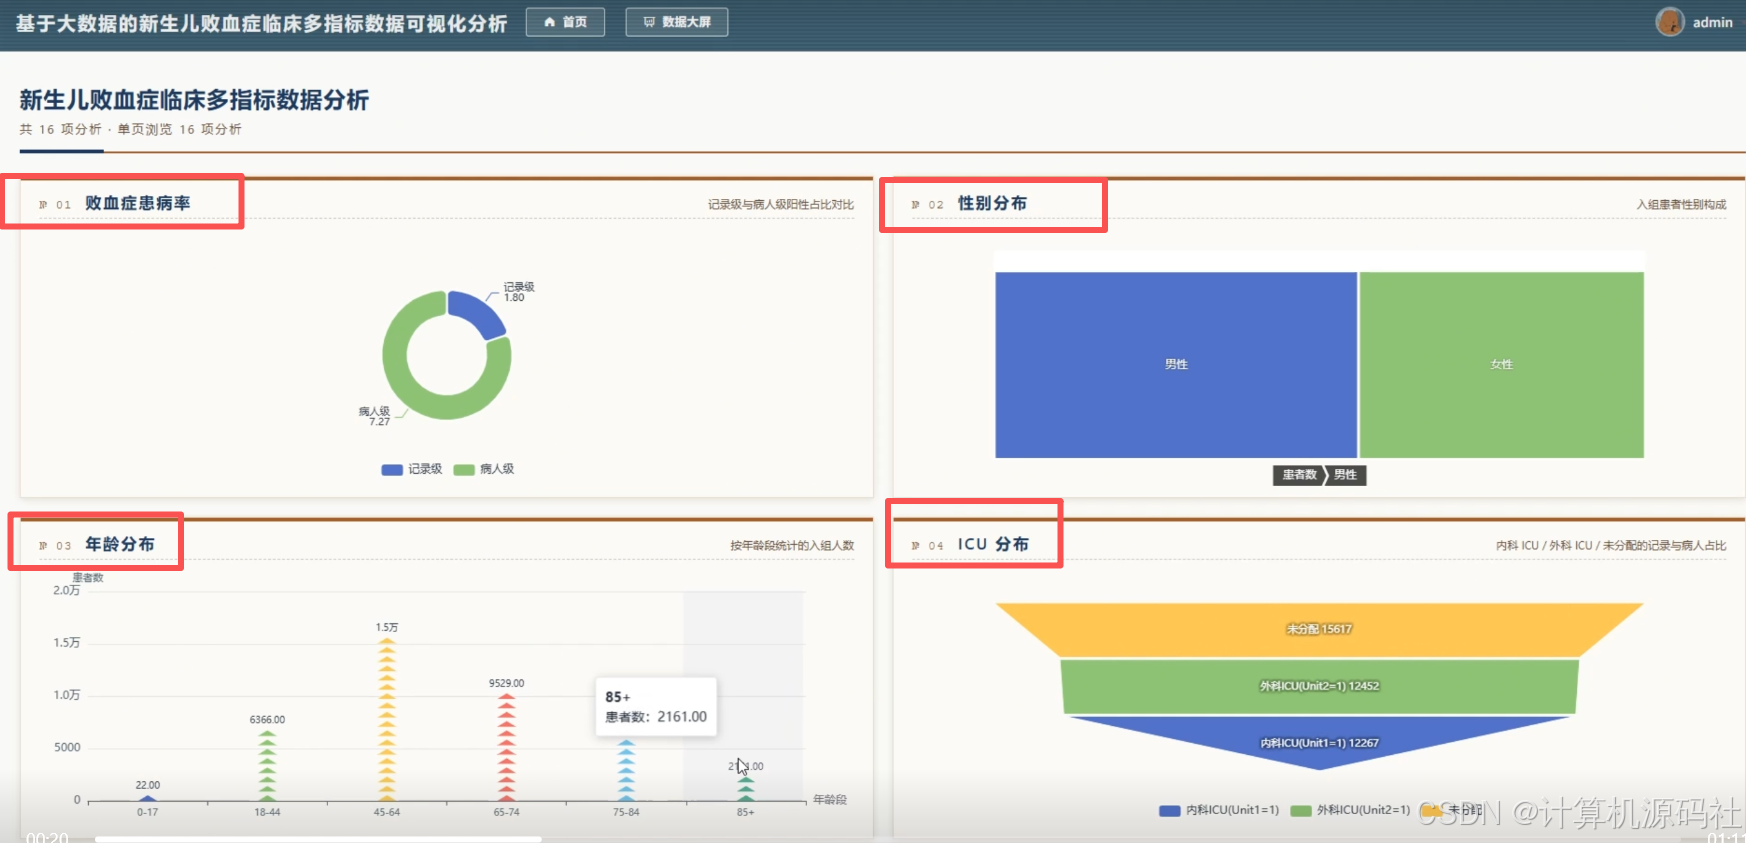
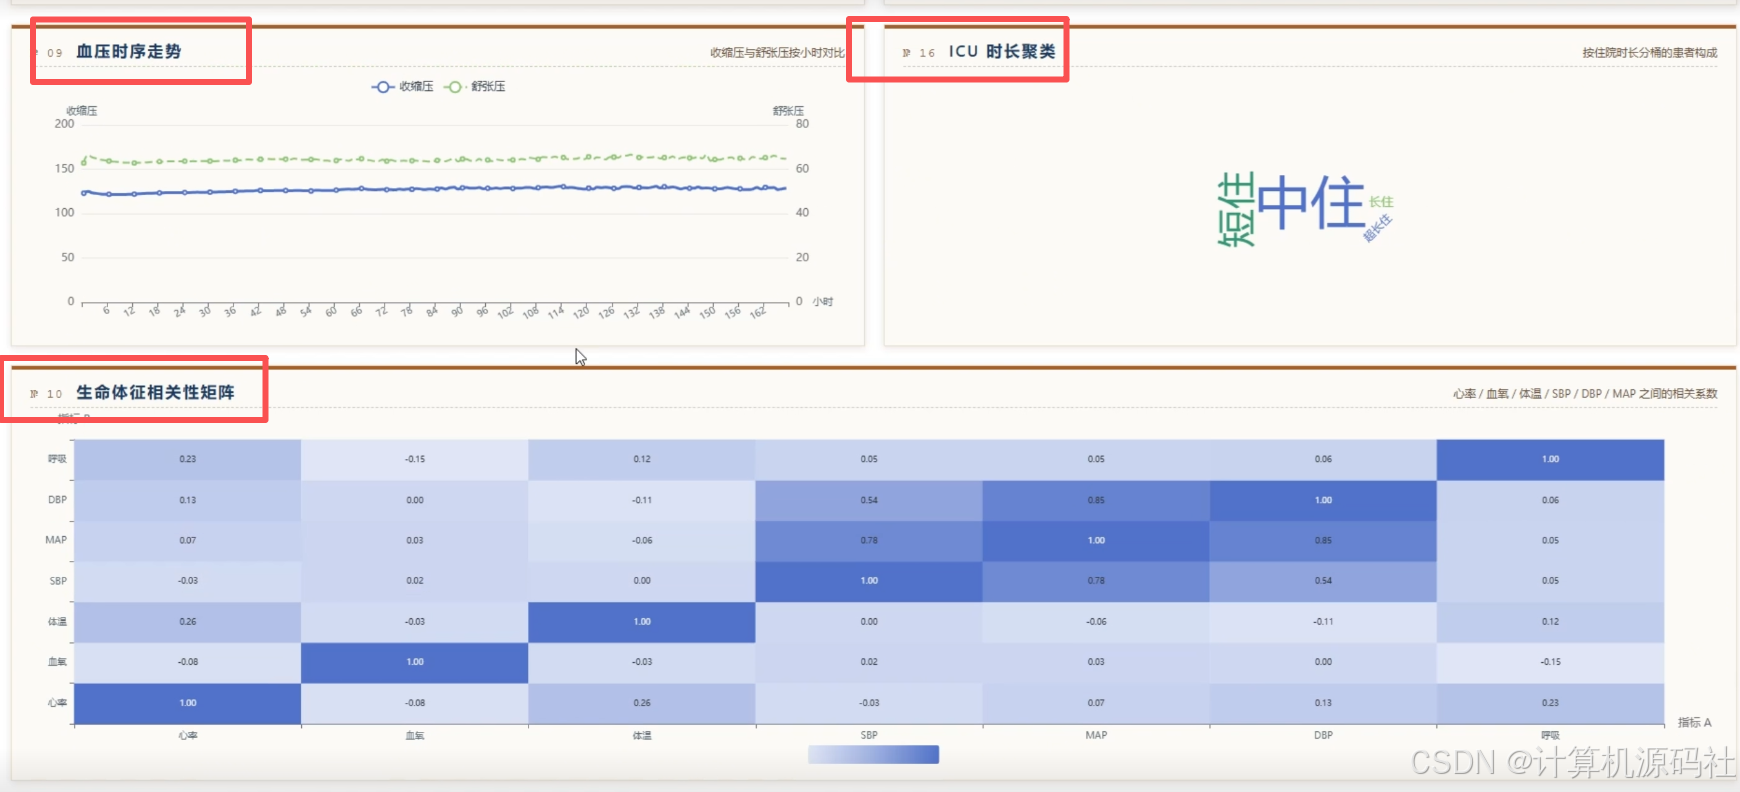
该系统的开发对于提升新生儿败血症的临床诊疗水平与科研转化能力具有显著的实践意义。在临床层面,通过生命体征相关性矩阵与频繁项集Top 20分析,系统揭示了心率、血氧、体温等指标之间的内在关联与高频组合模式,为医生制定综合干预方案提供了数据驱动的参考依据。在科研层面,系统对字段缺失率分布与异常组对比的呈现,有助于研究人员评估数据质量并优化数据采集流程,推动临床数据标准化建设。系统对败血症小时段分布的精细划分,能够帮助医疗机构合理调配ICU资源,优化护理排班与应急响应机制。从技术应用角度看,系统成功验证了大数据技术栈在医疗垂直领域的落地可行性,将Spark的分布式计算能力与ECharts的交互式可视化相结合,降低了临床医生使用复杂数据分析工具的门槛。通过数据大屏与后台管理模块的协同,系统不仅服务于一线临床决策,也为医院管理层提供了科室绩效与病区分布的可视化看板,对推动新生儿医疗服务的数字化、智能化转型具有深远的示范价值。
3、系统研究内容
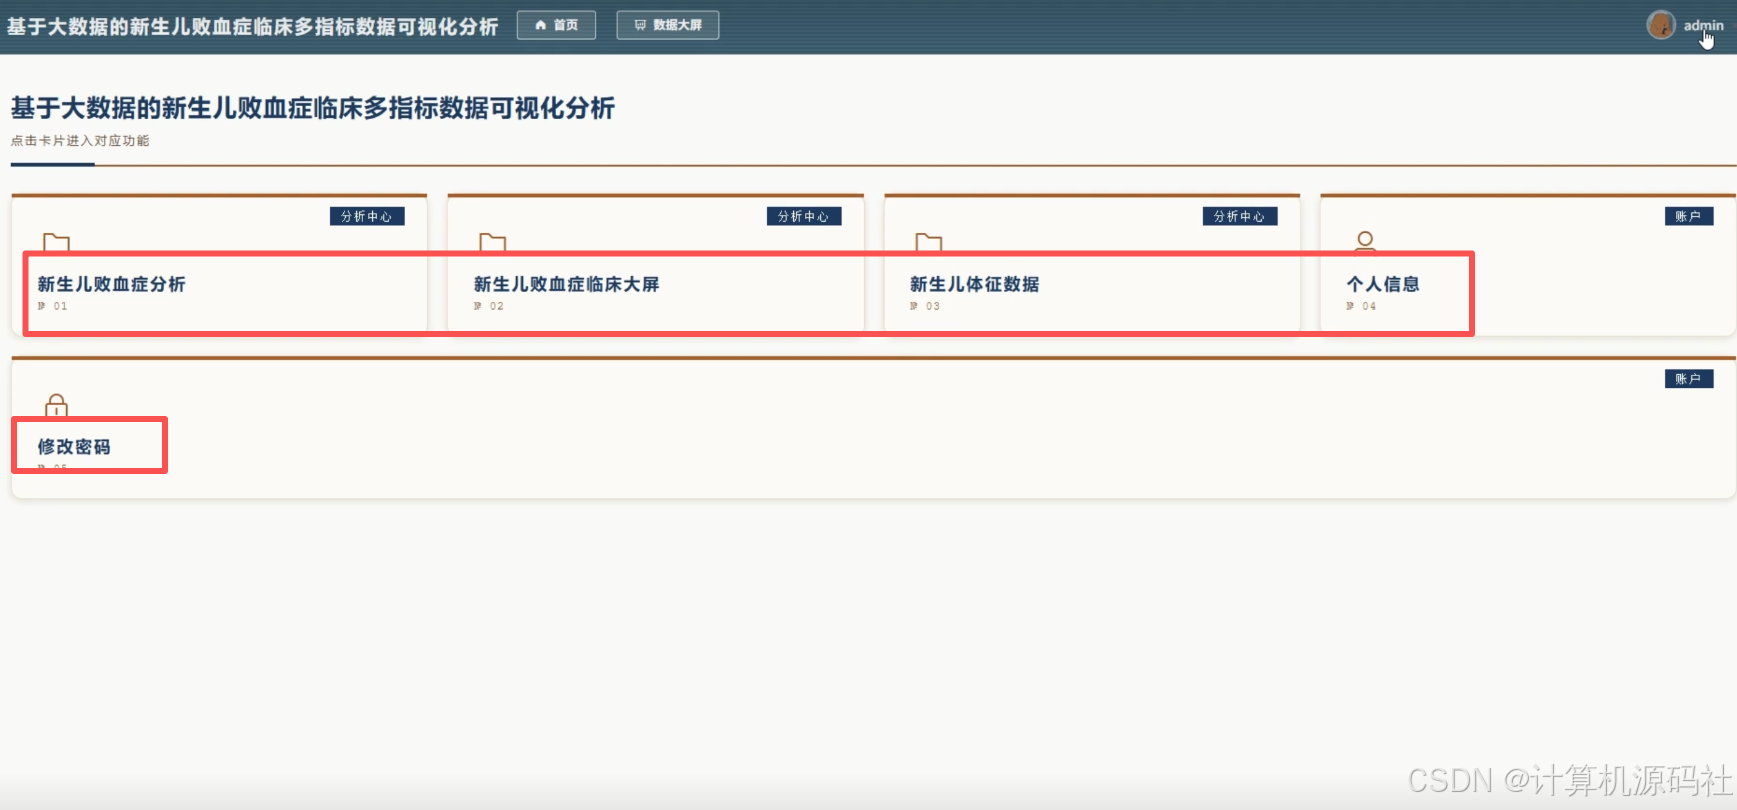
本系统的开发内容围绕数据采集、存储、计算、分析与可视化展示五大核心环节展开,构建了完整的临床多指标数据分析闭环。数据层采用Hadoop与Spark框架处理海量新生儿临床记录,利用MySQL存储结构化数据,并通过数据挖掘技术对缺失值进行统计与处理,确保数据质量。算法层应用K-Means聚类对生命体征进行画像分析,将患者划分为不同观察类别,并利用Isolation Forest算法实现异常组与正常组的自动标记与对比。分析层涵盖了败血症患病率、性别分布、年龄分布、ICU分布等基础统计,以及心率、血氧、体温、呼吸、血压的时序走势分析,通过相关性矩阵与频繁项集挖掘指标间的深层联系。展示层基于Vue与ECharts构建了交互式数据大屏与后台管理界面,大屏集成了雷达图、环形图、热力图、散点图等多种图表,直观呈现生命体征聚类、ICU时长聚类及败血症时段分布;后台则提供了患者信息查询、数据表格展示、新增删除及分页操作功能。系统还包含用户权限管理模块,支持修改密码与个人信息维护,确保数据安全与操作规范,最终形成了一套集数据治理、智能分析与可视化决策于一体的完整医疗大数据应用系统。
4、系统页面设计
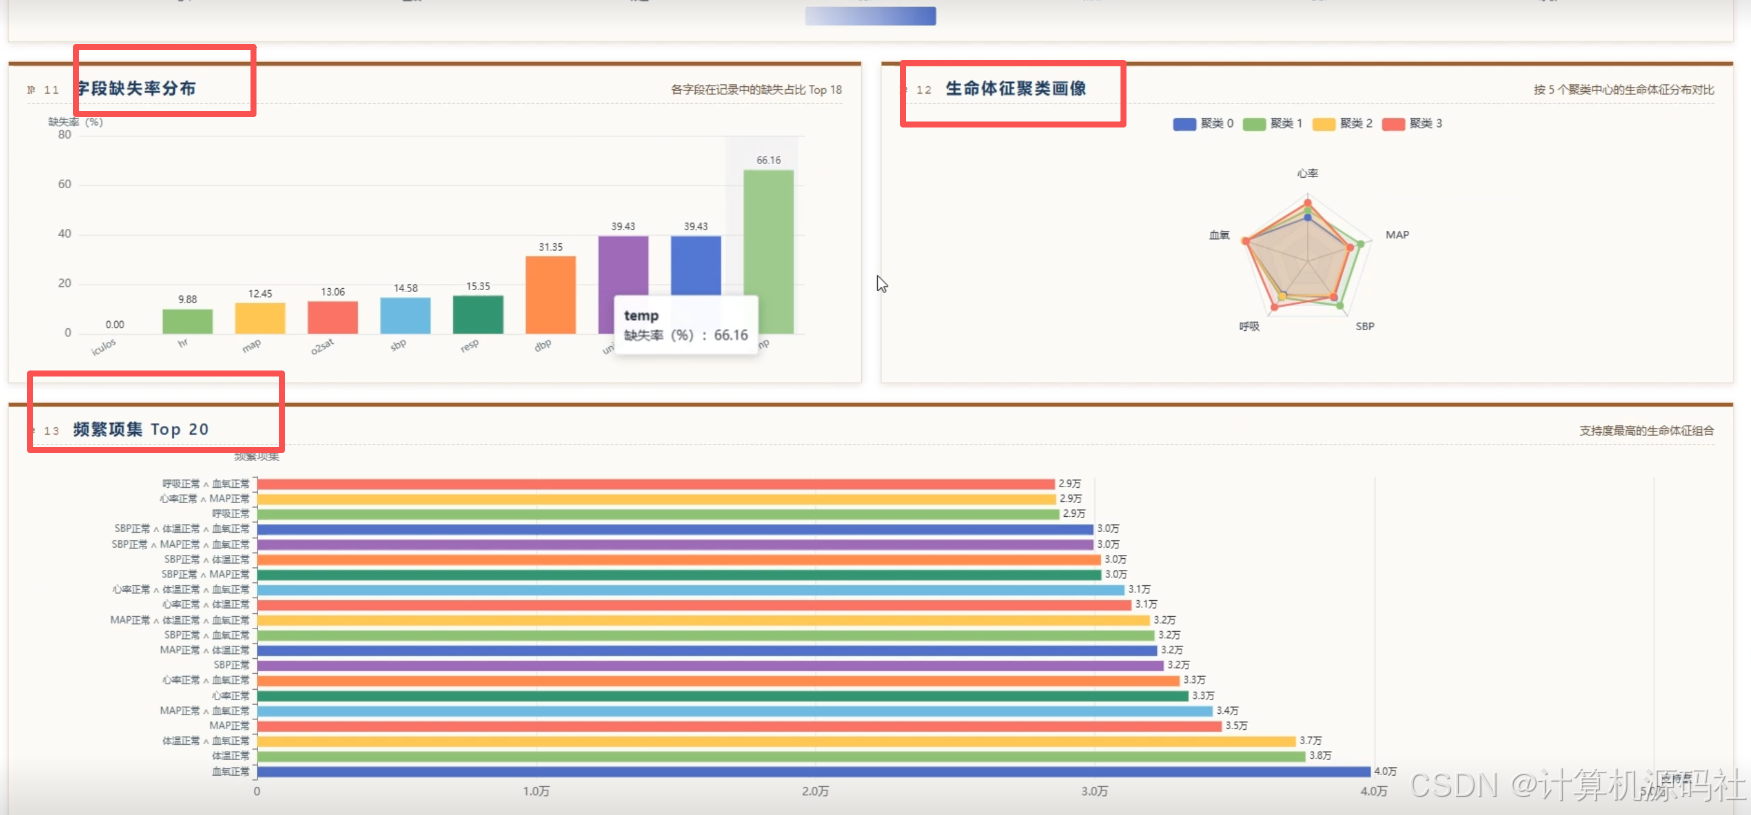
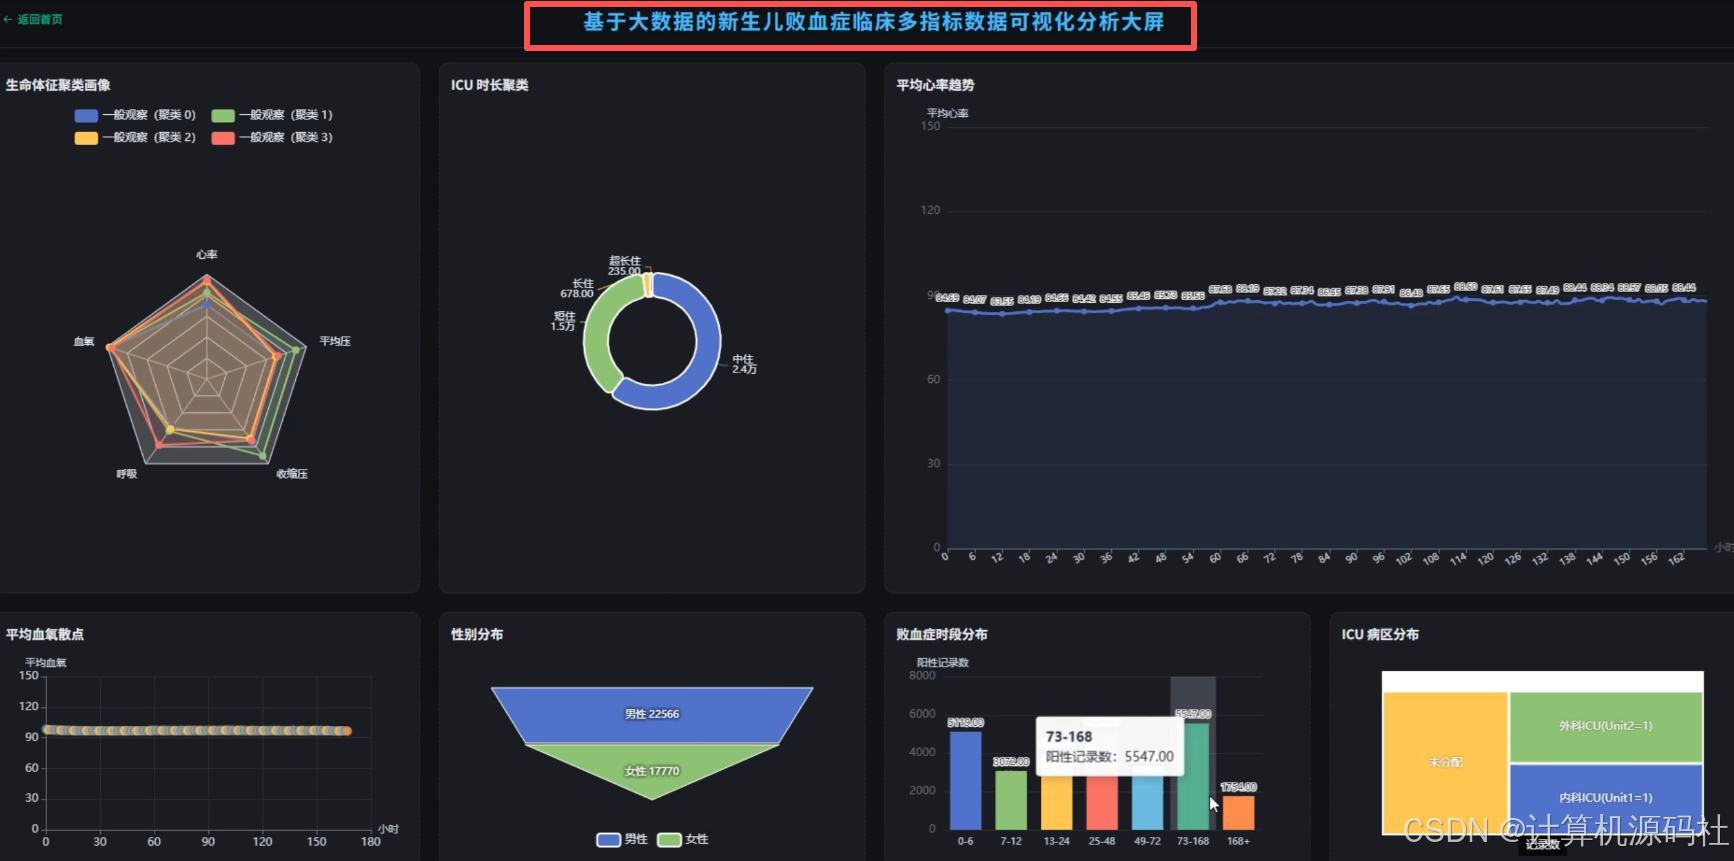
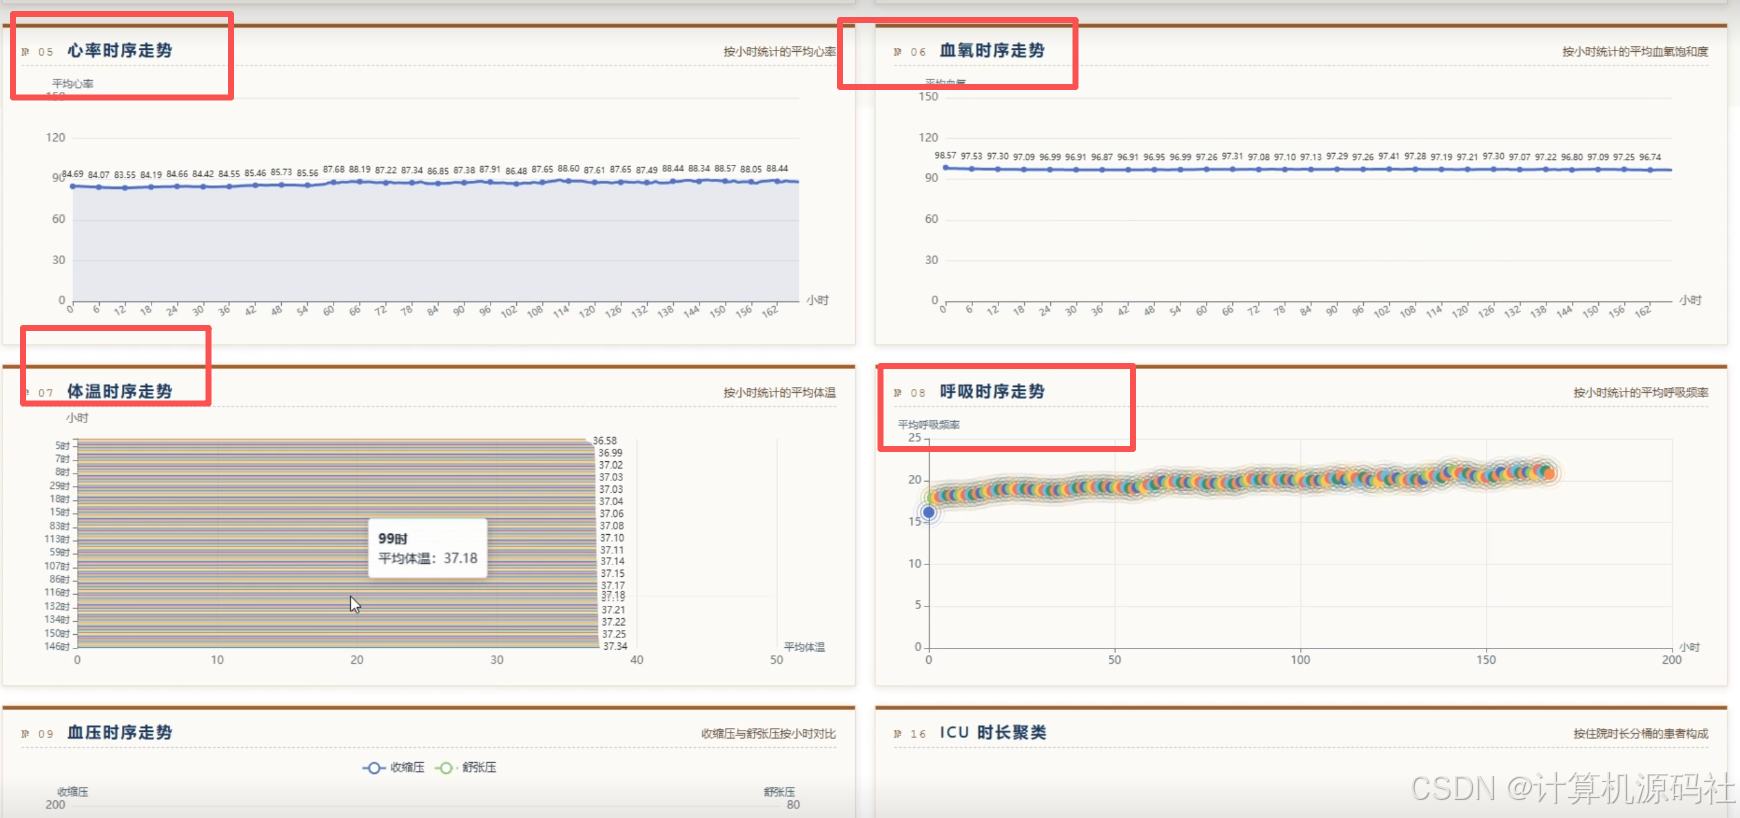
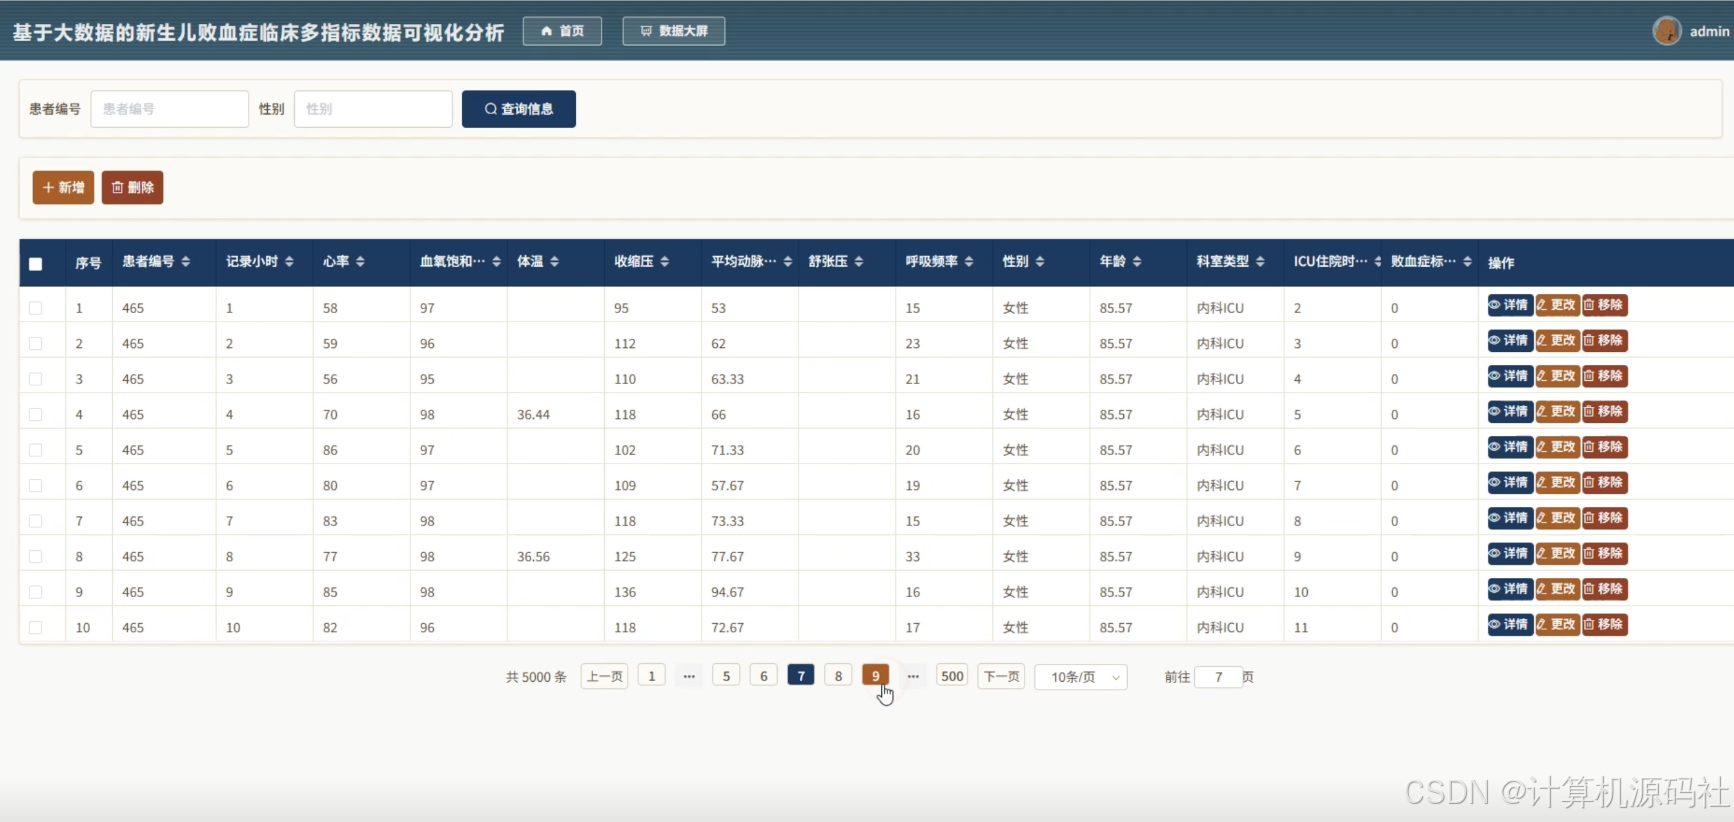
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
1李泽伟,徐德昌. 细胞图像分析中的数据增强:技术进展与临床转化(英文)J/OL.生物信息学,1-92026-09-17.https://link.cnki.net/urlid/23.1513.Q.20260825.1022.002.
2尚红艳. 医疗质控数据的挖掘分析与临床管理风险预测系统研究J.信息与电脑,2026,38(17):93-95.
3何融泉,李建棣,何世培,等. 大数据驱动的肿瘤病理智能分析:跨越形态学与多组学的诊疗桥梁J.广西医科大学学报,2026,43(3):314-325.DOI:10.16190/j.cnki.45-1211/r.2026.03.002.
4高晟,黄清音. 基于优化LDA模型与共现网络的电子资源行为数据主题挖掘与演化分析------以临床医学专业为例J.图书馆研究,2026,56(3):106-120.
5袁周萍,张杰良,刘安利,等. 基于数据挖掘技术分析古籍中照海的临床应用J.光明中医,2026,41(7):7-12.
6刘涛,刘晓岚,谢义松. 基于数据挖掘技术分析腰痹病的临床用药规律J.中国现代医生,2026,64(7):47-50.
7方正,李文博,董国娟. 基于数据挖掘的风门穴临床应用古代文献分析J.临床医学研究与实践,2026,11(3):117-120.DOI:10.19347/j.cnki.2096-1413.202603029.
8王淑芳.医学数据挖掘技术在临床诊断中的应用分析C//河南省民办教育协会.2026年高等教育发展论坛论文集(下册).2026:250-252.DOI:10.26914/c.cnkihy.2026.001734.
9张馨元,石森,臧家根,等. 基于多模态信息融合的口咽癌复发风险研究J/OL.智能计算机与应用,1-92026-09-17.https://doi.org/10.20169/j.issn.2095-2163.25121901.
10齐晓焱,陈莉莉,许静凯. 基于Citespace的风湿免疫临床大数据研究热点与趋势分析J.中国医学前沿杂志(电子版),2025,17(11):23-31.
11王嘉琪,梁凤霞. 基于数据挖掘技术分析关元穴的临床应用J.时珍国医国药,2025,36(23):4587-4594.
12常东明,孟庆桐,胡若晨,等. SignBrain Viewer:可穿戴脑电数据分析软件J.中国生物医学工程学报,2025,44(5):631-635.
13李国宇,刘姗姗,吕鹤群,等. 基于数据挖掘技术分析古代文献中百会穴的临床应用规律J.世界科学技术-中医药现代化,2025,27(8):2284-2297.
14潘丹,朱宇航,周天一,等. 基于数据挖掘技术分析曲凡治疗多囊卵巢综合征临床用药规律J.新中医,2025,57(13):11-16.DOI:10.13457/j.cnki.jncm.2025.13.003.
15王琳琳,崔芳芳,何贤英. 跨机构临床数据共享平台构建与应用J.医学信息学杂志,2025,46(5):67-72.
16王英栋.基于数据挖掘及生物信息学探讨红皮病型银屑病临床特点、核心处方及其机制D.天津中医药大学,2025.DOI:10.27368/d.cnki.gtzyy.2025.000463.
17宫欣玉.面向缺失多模态数据的青光眼转诊模型研究D.中南大学,2025.DOI:10.27661/d.cnki.gzhnu.2025.001757.
18段一凡.基于大语言模型的临床数据挖掘主题文献知识单元识别方法研究D.北京协和医学院,2025.DOI:10.27648/d.cnki.gzxhu.2025.001186.
19郭阳阳.基于突变密度与机器学习的临床数据病变分析与专家系统模型D.东华大学,2025.DOI:10.27012/d.cnki.gdhuu.2025.002118.
20卢慧勤,刘祖玫,陈燕,等. 药物临床试验中数智化质量管理系统的设计与实践J.中国临床药理学杂志,2025,41(6):877-880.DOI:10.13699/j.cnki.1001-6821.2025.06.024.
6、核心代码
java
# 初始化SparkSession,连接Hadoop集群进行大数据处理
spark = SparkSession.builder \
    .appName("NeonatalSepsis_Clustering") \
    .config("spark.sql.warehouse.dir", "/user/hive/warehouse") \
    .enableHiveSupport() \
    .getOrCreate()

# 从MySQL或Hive中读取新生儿生命体征数据(对应图片中的心率、血氧、平均压、呼吸、收缩压)
# 假设数据表名为 neonatal_vital_signs
df = spark.read.format("jdbc") \
    .option("url", "jdbc:mysql://localhost:3306/neonatal_db") \
    .option("dbtable", "neonatal_vital_signs") \
    .option("user", "root") \
    .option("password", "password") \
    .load()

# 选取用于聚类的五个核心特征列,并过滤掉缺失值
feature_cols = ["heart_rate", "blood_oxygen", "mean_pressure", "respiratory_rate", "systolic_pressure"]
df_clean = df.select(feature_cols).dropna()

# 使用VectorAssembler将多个特征列合并为一个特征向量列
assembler = VectorAssembler(inputCols=feature_cols, outputCol="features")
df_vector = assembler.transform(df_clean)

# 对特征向量进行标准化处理,消除量纲差异对聚类结果的影响
scaler = StandardScaler(inputCol="features", outputCol="scaled_features", withStd=True, withMean=True)
scaler_model = scaler.fit(df_vector)
df_scaled = scaler_model.transform(df_vector)

# 设置K-Means聚类参数,将患者划分为4个聚类(对应图片中的聚类0、1、2、3)
kmeans = KMeans(featuresCol="scaled_features", k=4, seed=42, maxIter=100)

# 训练K-Means模型
model = kmeans.fit(df_scaled)

# 对原始数据进行聚类预测,为每条记录打上聚类标签
predictions = model.transform(df_scaled)

# 提取聚类中心,用于后续在雷达图中展示各聚类的生命体征分布对比
centers = model.clusterCenters()
# 将聚类中心转换为DataFrame,便于前端ECharts读取
centers_df = pd.DataFrame(centers, columns=feature_cols)
centers_df['cluster'] = ['聚类0', '聚类1', '聚类2', '聚类3']

# 使用轮廓系数评估聚类效果,确保聚类划分的合理性
evaluator = ClusteringEvaluator(featuresCol="scaled_features", metricName="silhouette")
silhouette_score = evaluator.evaluate(predictions)
print(f"聚类轮廓系数: {silhouette_score}")

# 将聚类结果写回MySQL,供前端Vue大屏调用
predictions.select("patient_id", "prediction").write \
    .format("jdbc") \
    .option("url", "jdbc:mysql://localhost:3306/neonatal_db") \
    .option("dbtable", "patient_cluster_results") \
    .option("user", "root") \
    .option("password", "password") \
    .mode("overwrite") \
.save()💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询