中国研究生数学建模竞赛(华为杯)学习笔记------AI绘图方法
文章目录
解决字体乱码问题
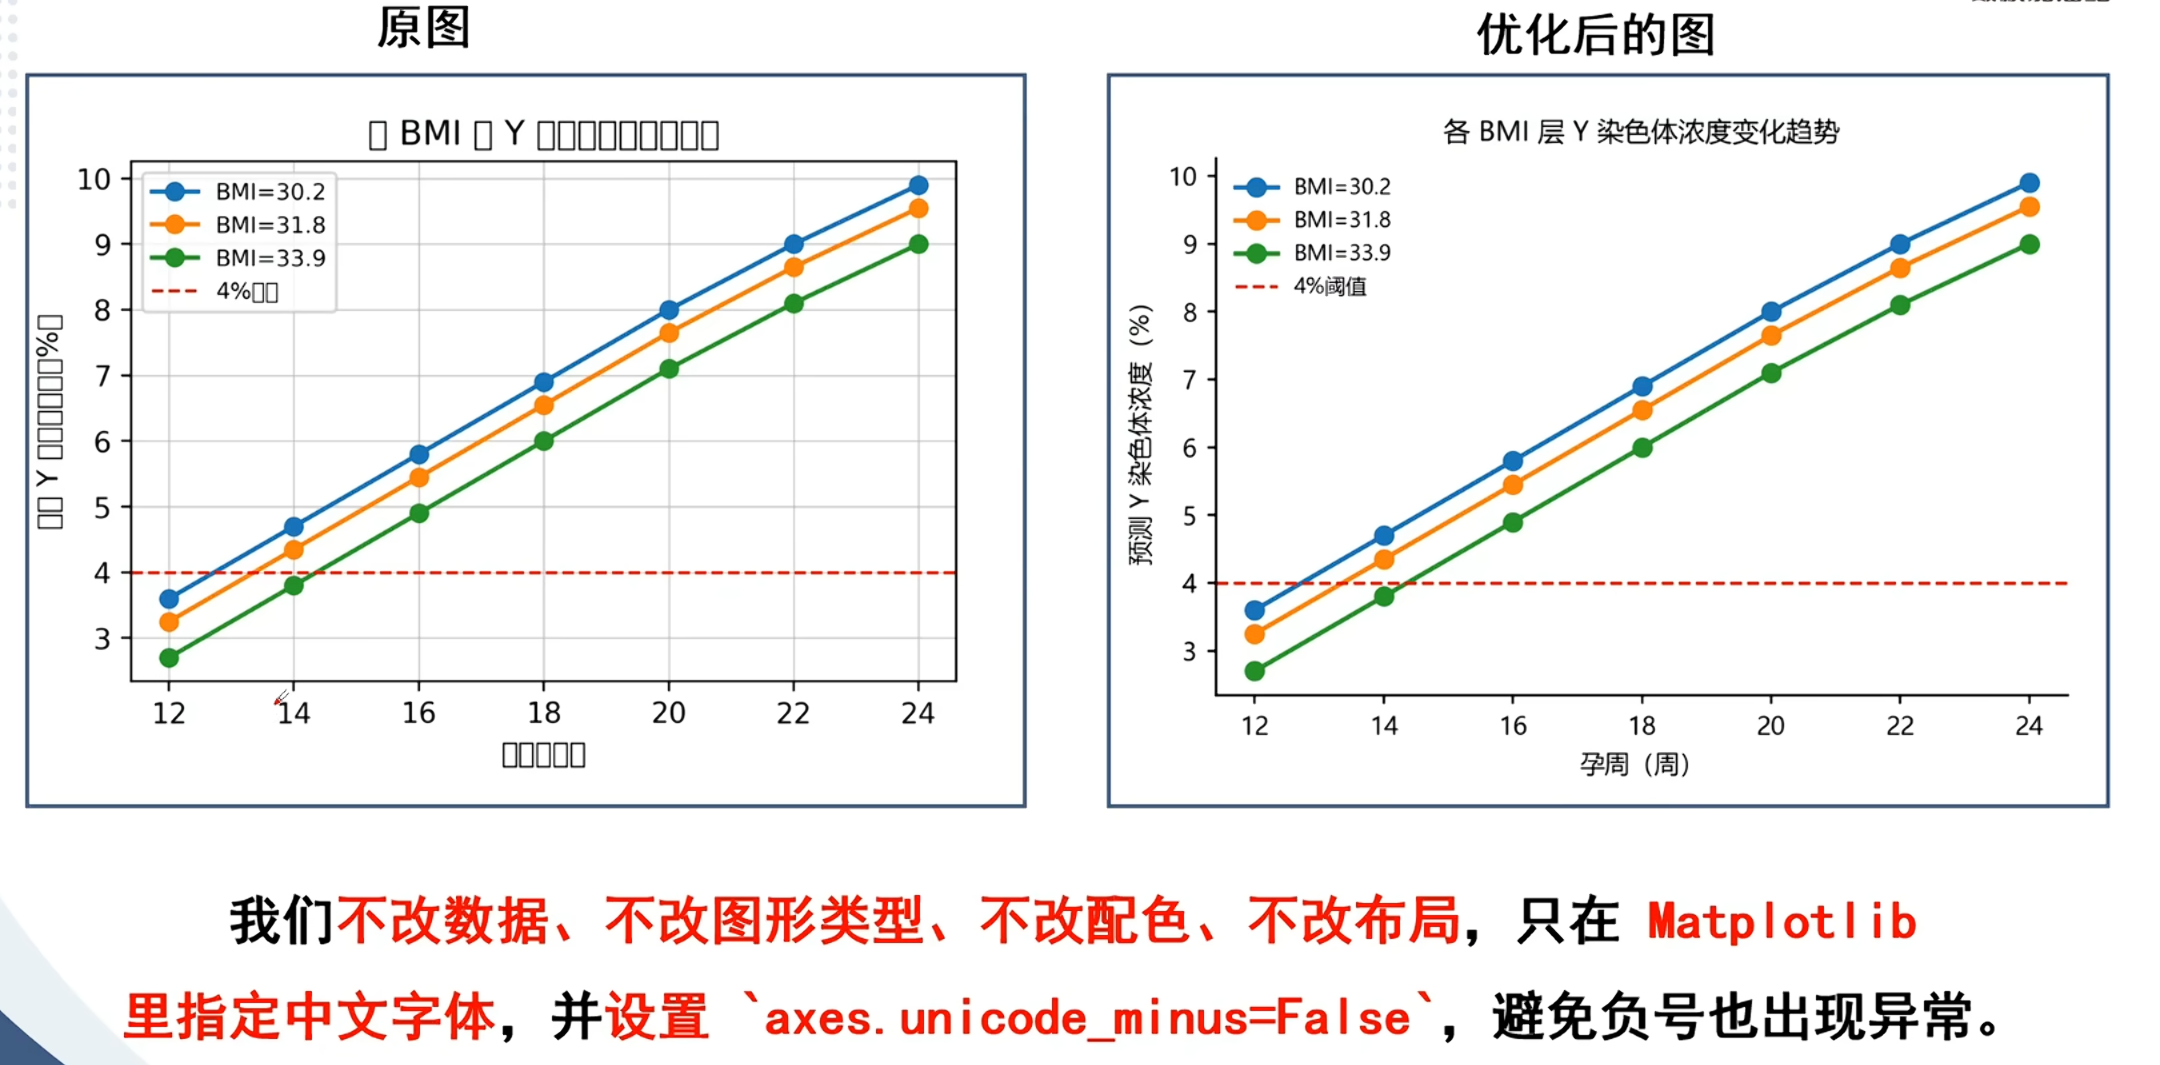
Matplotlib 中文显示为方框,根因在于默认字体(DejaVu Sans)不含中文字形------所以解法只动字体配置、不动数据和样式:在导入 matplotlib 后用 plt.rcParams'font.sans-serif' = 'SimHei', 'Microsoft YaHei' 指定中文字体,再用 plt.rcParams'axes.unicode_minus' = False 让负号用普通连字符显示,避免换字体后负号再次变成方框。
参考代码
python
import matplotlib.pyplot as plt
from matplotlib import rcParams

# 设置 Matplotlib 使用支持中文的字体
rcParams['font.sans-serif'] = ['SimHei']        # 黑体(Windows 默认支持)
rcParams['axes.unicode_minus'] = False          # 解决负号显示为方块的问题
提升图片的高级感
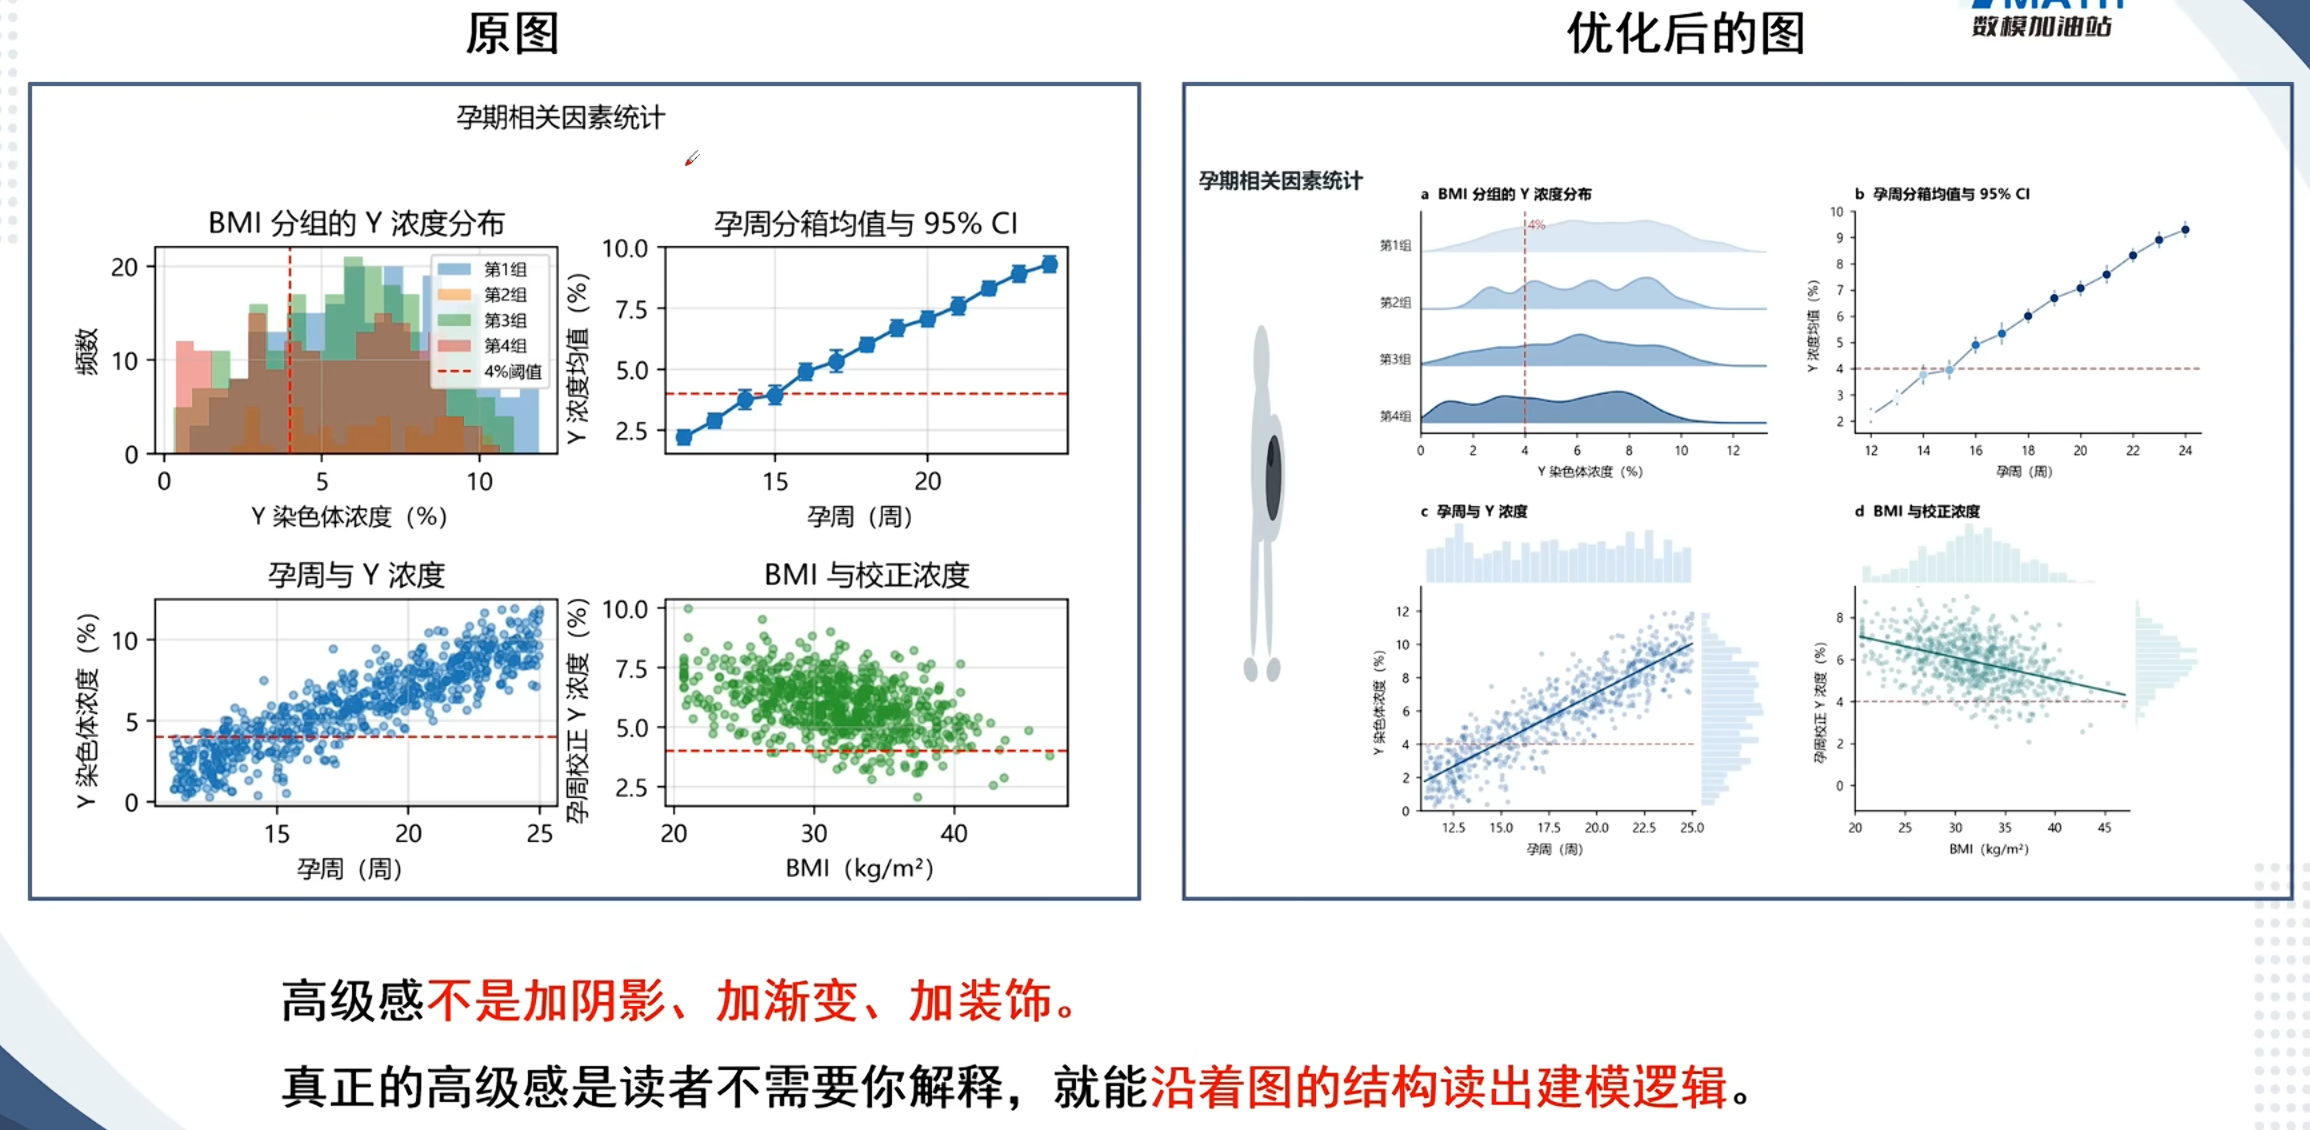
左图的四张子图虽然都有内容,但缺主题、缺编号、缺连贯的线索,读者看着只能拿到一堆零散信息;右图的优化思路其实只有三个动作------统一总标题("孕期相关因素统计")+ 给子图加 a/b/c/d 编号和子标题 + 统一配色,再在散点图里加边缘直方图(marginal histogram),让点的整体走向和单维分布密度一次说清。真正的高级感不是加阴影、加渐变、加装饰,而是读者不需要你解释,就能沿着图的结构读出建模逻辑------装饰是加法,结构才是乘法。
参考代码
python
"""模拟数据复刻四联图。运行:python replicate_figure.py
依赖:pip install numpy matplotlib
所有数据均为人工模拟,不能用于医学推断;四个面板为独立的视觉示例。
"""
from pathlib import Path
import csv
import warnings
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib import font_manager

OUT = Path(__file__).resolve().parent
SEED = 20260907


def setup_style():
    fonts = {f.name for f in font_manager.fontManager.ttflist}
    candidates = ["Microsoft YaHei", "SimHei", "Noto Sans CJK SC", "Source Han Sans SC", "PingFang SC", "WenQuanYi Zen Hei"]
    chinese = next((name for name in candidates if name in fonts), None)
    if chinese is None:
        warnings.warn("未找到中文字体,请安装 Noto Sans CJK SC 或黑体后重新运行。")
    plt.rcParams.update({
        "font.family": "sans-serif",
        "font.sans-serif": ([chinese] if chinese else []) + ["DejaVu Sans"],
        "font.size": 10, "axes.titlesize": 12, "axes.titleweight": "bold",
        "axes.labelsize": 10, "axes.linewidth": 1.1,
        "axes.spines.top": False, "axes.spines.right": False,
        "axes.unicode_minus": False, "xtick.direction": "out", "ytick.direction": "out",
        "svg.fonttype": "none", "pdf.fonttype": 42,
        "savefig.facecolor": "white",
    })


def write_csv(name, header, rows):
    with (OUT / name).open("w", encoding="utf-8-sig", newline="") as f:
        writer = csv.writer(f)
        writer.writerow(header)
        writer.writerows(rows)


def kde(samples, grid, bandwidth=0.42):
    """高斯核密度估计,避免额外依赖 scipy。"""
    z = (grid[:, None] - samples[None, :]) / bandwidth
    return np.exp(-0.5 * z**2).mean(axis=1) / (bandwidth * np.sqrt(2 * np.pi))


def joint_axes(fig, spec, title):
    sub = spec.subgridspec(2, 2, height_ratios=[1, 4], width_ratios=[4, 1], hspace=0.015, wspace=0.015)
    ax = fig.add_subplot(sub[1, 0])
    top = fig.add_subplot(sub[0, 0], sharex=ax)
    right = fig.add_subplot(sub[1, 1], sharey=ax)
    top.set_title(title, loc="left", pad=7)
    top.axis("off")
    right.axis("off")
    return ax, top, right


def scatter_marginals(ax, top, right, x, y, color, histcolor):
    ax.scatter(x, y, s=13, color=color, alpha=0.28, linewidths=0)
    slope, intercept = np.polyfit(x, y, 1)
    xx = np.linspace(x.min(), x.max(), 200)
    ax.plot(xx, slope * xx + intercept, color=color, lw=1.6)
    top.hist(x, bins=28, color=histcolor, edgecolor="white", linewidth=0.4)
    right.hist(y, bins=28, orientation="horizontal", color=histcolor, edgecolor="white", linewidth=0.4)
    ax.axhline(4, color="#ad8984", ls="--", lw=1.2, alpha=0.85)


def main():
    OUT.mkdir(parents=True, exist_ok=True)
    setup_style()
    rng = np.random.default_rng(SEED)
    fig = plt.figure(figsize=(8.4, 6.96), facecolor="white")
    gs = fig.add_gridspec(2, 2, left=0.074, right=0.992, bottom=0.088,
                          top=0.952, height_ratios=[1, 1.30], wspace=0.255, hspace=0.36)

    # a:混合正态分布产生不同形状;各曲线按自身峰值归一化高度。
    ax = fig.add_subplot(gs[0, 0])
    configs = [
        ([3.0, 5.8, 8.6, 10.7], [1.0, 1.1, 0.9, 0.65], [0.25, 0.35, 0.31, 0.09]),
        ([2.7, 4.3, 6.5, 8.7], [0.40, 0.45, 0.52, 0.65], [0.19, 0.23, 0.25, 0.33]),
        ([2.0, 4.0, 6.1, 8.8], [0.95, 0.7, 0.75, 0.90], [0.18, 0.22, 0.34, 0.26]),
        ([1.0, 3.3, 5.3, 7.6], [0.46, 0.74, 0.9, 0.92], [0.14, 0.25, 0.23, 0.38]),
    ]
    colors = ["#d6e6f1", "#a9cbe2", "#85adcb", "#638eb2"]
    grid = np.linspace(0, 13.3, 600)
    all_rows = []
    for i, (means, sigmas, weights) in enumerate(configs):
        component = rng.choice(4, 1600, p=weights)
        sample = rng.normal(np.array(means)[component], np.array(sigmas)[component])
        sample = sample[(sample >= 0) & (sample <= 13.3)]
        density = kde(sample, grid, bandwidth=0.35)
        base = 3 - i
        curve = base + density / density.max() * 0.57
        ax.fill_between(grid, base, curve, color=colors[i], alpha=0.88)
        ax.plot(grid, curve, color=colors[i], lw=1.5)
        all_rows.extend((i + 1, float(value)) for value in sample)
    ax.axvline(4, color="#ad8984", ls="--", lw=1.3)
    ax.text(4.08, 3.41, "4%", color="#ad8984", fontsize=9)
    ax.set(xlim=(0, 13.3), ylim=(-0.18, 3.72), xticks=np.arange(0, 13, 2),
           yticks=[3.1, 2.1, 1.1, 0.1], yticklabels=["第1组", "第2组", "第3组", "第4组"],
           xlabel="Y 染色体浓度(%)")
    ax.tick_params(axis="y", length=0, pad=7)
    ax.set_title("a  BMI 分组的 Y 浓度分布", loc="left", pad=10)
    write_csv("panel_a.csv", ["bmi_group", "y_percent"], all_rows)

    # b:各孕周独立生成样本,误差棒为均值 ± 1.96 × 标准误(近似 95% CI)。
    ax = fig.add_subplot(gs[0, 1])
    weeks = np.arange(12, 25)
    targets = np.array([2.2, 2.8, 3.75, 3.95, 4.9, 5.35, 6.05, 6.75, 7.1, 7.6, 8.35, 8.9, 9.3])
    values = [rng.normal(mu, 0.72, 55) for mu in targets]
    means = np.array([v.mean() for v in values])
    ci = np.array([1.96 * v.std(ddof=1) / np.sqrt(len(v)) for v in values])
    ax.axhline(4, color="#ad8984", ls="--", lw=1.3)
    ax.plot(weeks, means, color="#6d91ac", lw=1.2, zorder=1)
    for i, (week, mean, error) in enumerate(zip(weeks, means, ci)):
        ax.errorbar(week, mean, yerr=error, fmt="o", ms=5, capsize=0,
                    color=plt.cm.Blues(0.16 + 0.80 * i / 12), ecolor="#8ea9b9", elinewidth=1.15)
    ax.set(xlim=(11.4, 24.6), ylim=(1.5, 10), xticks=np.arange(12, 25, 2),
           yticks=np.arange(2, 11), xlabel="孕周(周)", ylabel="Y 浓度均值(%)")
    ax.set_title("b  孕周分箱均值与 95% CI", loc="left", pad=10)
    write_csv("panel_b_raw.csv", ["week", "y_percent"], ((w, float(v)) for w, vals in zip(weeks, values) for v in vals))
    write_csv("panel_b_summary.csv", ["week", "mean", "ci95_half_width", "n"], zip(weeks, means, ci, [55] * len(weeks)))

    # c:孕周与浓度正相关,并保留随机散布。
    ax, top, right = joint_axes(fig, gs[1, 0], "c  孕周与 Y 浓度")
    x = rng.uniform(11, 25, 900)
    y = 1.6 + 0.60 * (x - 11) + rng.normal(0, 1.12, x.size)
    scatter_marginals(ax, top, right, x, y, "#426f96", "#d4e6f2")
    ax.set(xlim=(10.8, 25.2), ylim=(0, 13.5), xticks=np.arange(12.5, 25.1, 2.5),
           yticks=np.arange(0, 13, 2), xlabel="孕周(周)", ylabel="Y 染色体浓度(%)")
    write_csv("panel_c.csv", ["week", "y_percent"], zip(x, y))

    # d:独立构造孕周校正后的浓度,呈现与 BMI 的负相关。
    ax, top, right = joint_axes(fig, gs[1, 1], "d  BMI 与校正浓度")
    bmi = rng.normal(31, 5.2, 1300)
    bmi = bmi[(bmi >= 20) & (bmi <= 47)][:1000]
    adjusted_y = 7.0 - 0.102 * (bmi - 20) + rng.normal(0, 0.97, bmi.size)
    scatter_marginals(ax, top, right, bmi, adjusted_y, "#448985", "#dfefef")
    ax.set(xlim=(20, 47.5), ylim=(-1.2, 9.5), xticks=np.arange(20, 46, 5),
           yticks=np.arange(0, 9, 2), xlabel="BMI(kg/m²)", ylabel="孕周校正 Y 浓度(%)")
    write_csv("panel_d.csv", ["bmi", "adjusted_y_percent"], zip(bmi, adjusted_y))

    for ext in ["png", "svg", "pdf"]:
        fig.savefig(OUT / f"replicated_figure.{ext}", dpi=300)
    fig.savefig(OUT / "preview.png", dpi=120)
    plt.close(fig)
    print(f"已保存图片和模拟数据到:{OUT}")


if __name__ == "__main__":
main()复现仓库:https://github.com/kaixin-aa/figure-code/tree/main/examples/001-bmi-y-concentration
提升图片的配色搭配
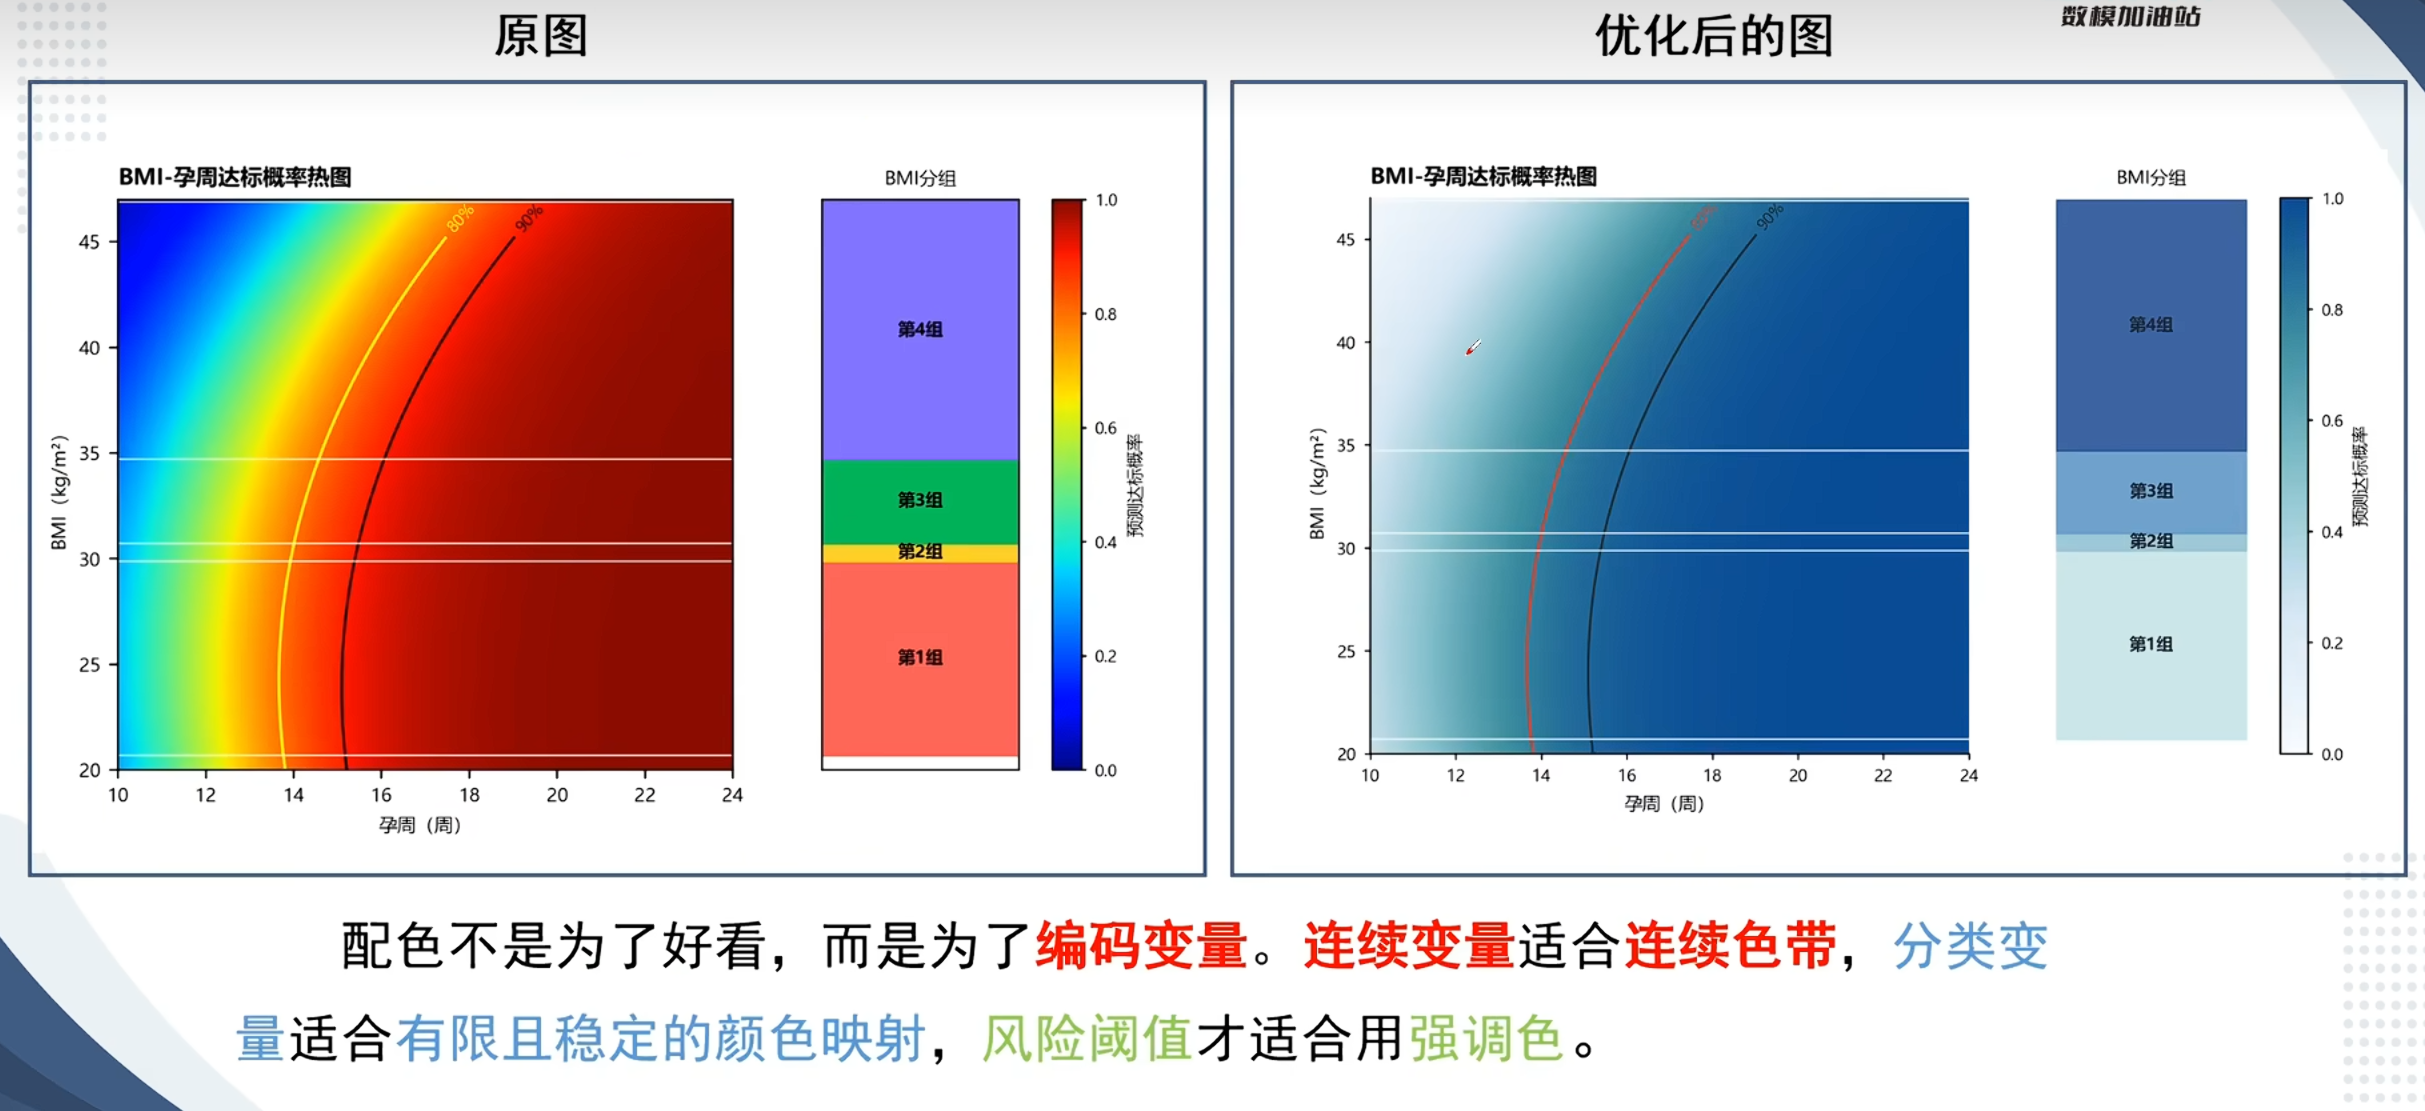
这张 BMI--孕周妊娠达标概率热力图,把"配色服务变量"这件事讲得非常彻底:原图主体用了彩虹 jet 色带,把一个 0--1 的连续概率硬切成蓝→青→绿→黄→红五六个"伪类别",读者会本能以为每段色带代表一种类型,但这个变量根本没有类别含义;右边的 BMI 分组条又用红/黄/绿/紫四种毫无语义关联的强饱和色硬配,四组之间没有顺序感,眼睛也无法快速定位"第几组属于哪一段";更要命的是,背景这么花,想突出的两条阈值曲线(黑、白)反而被彩噪吞掉了。
优化稿只做三件事------把主体换成单色蓝渐变(Blues),用"越深=越高"的单调直觉替代假的色带分箱;把 BMI 四组改成浅蓝→深蓝的离散色阶,让组间顺序一眼可读;让阈值曲线用黑+红强调线落到安静下来的背景上,瞬间成为全场最显眼的元素。所以选色真正的判断流程只有三步:先识别变量类型(连续单调就用单色渐变、偏离零即变差就用发散色板、有序分类用同色系离散色阶、风险阈值才用强调色),再看颜色是否编码了方向(深=多、浅=少这种直觉是否能直接焊死在色板上),最后强调色只留给最想讲的 1--2 个元素。
出图前只用一句话自检:去掉所有颜色后图还能不能讲清楚故事------能讲清,彩色就是增益;讲不清,彩色就是在掩盖结构问题。好配色的目标从来不是漂亮,而是让数据自己说话。
参考提示词
你是数学建模竞赛的可视化配色助教。下面是一份 BMI-孕周达标概率热图代码,它的问题是使用了默认彩虹色和跳跃的分组颜色。
请只升级"配色系统",不要改变热图数据、概率公式、坐标轴范围、等值线水平、BMI 分组边界和图表结构。
具体要求:
- 把 cmap="jet" 改成低饱和、亮度连续、适合论文打印的概率色带。
- 颜色语义要清楚:浅色表示低达标概率,深色表示高达标概率。
- BMI 分组带使用同一色系的层级颜色,不要红黄绿紫混用。
- 80% 和 90% 等概率线只使用少量强调色,不能喧宾夺主。
- 白底,坐标轴简洁,中文正常显示。
- 不添加大段解释文字,不改变为其他图形。
- 输出完整可运行 Python 代码。
- 导出 PNG,保存后调用 plt.show()。
提升图片的场景创新性
左边是一张规规矩矩的方框流程------母体采血→血浆 cfDNA 提取→高通量测序→染色体比例计算→最后分支出 13/18/21 染色体筛查和 Y 染色体浓度与胎儿性别判定,干净、规范,但读起来像一张抽象骨架,评委看不出"这是在解决一个真实的产前检测临床问题";右边把同一套数据流嵌进了真实场景------左侧的孕妇与胎儿插画交代问题域("你在帮谁"),中间的采血管、测序读段与质控流程交代方法步骤("你怎么做"),右侧的染色体核型(13/18/21 + XY)和 QC 报告圈交代产出("你最终给人什么答案"),一层视觉就把问题---方法---结果全部铺满。真正适合论文的场景融合图,核心不在美术而在这三层结构:背景层放领域真实元素(孕妇、车流、风机、河流、电网),流程层放方法步骤并就近贴标签,产出层放具体可量化的对象(染色体编号、车流量、发电量、污染指标),所有元素必须服务于"讲清楚你在解决什么"。
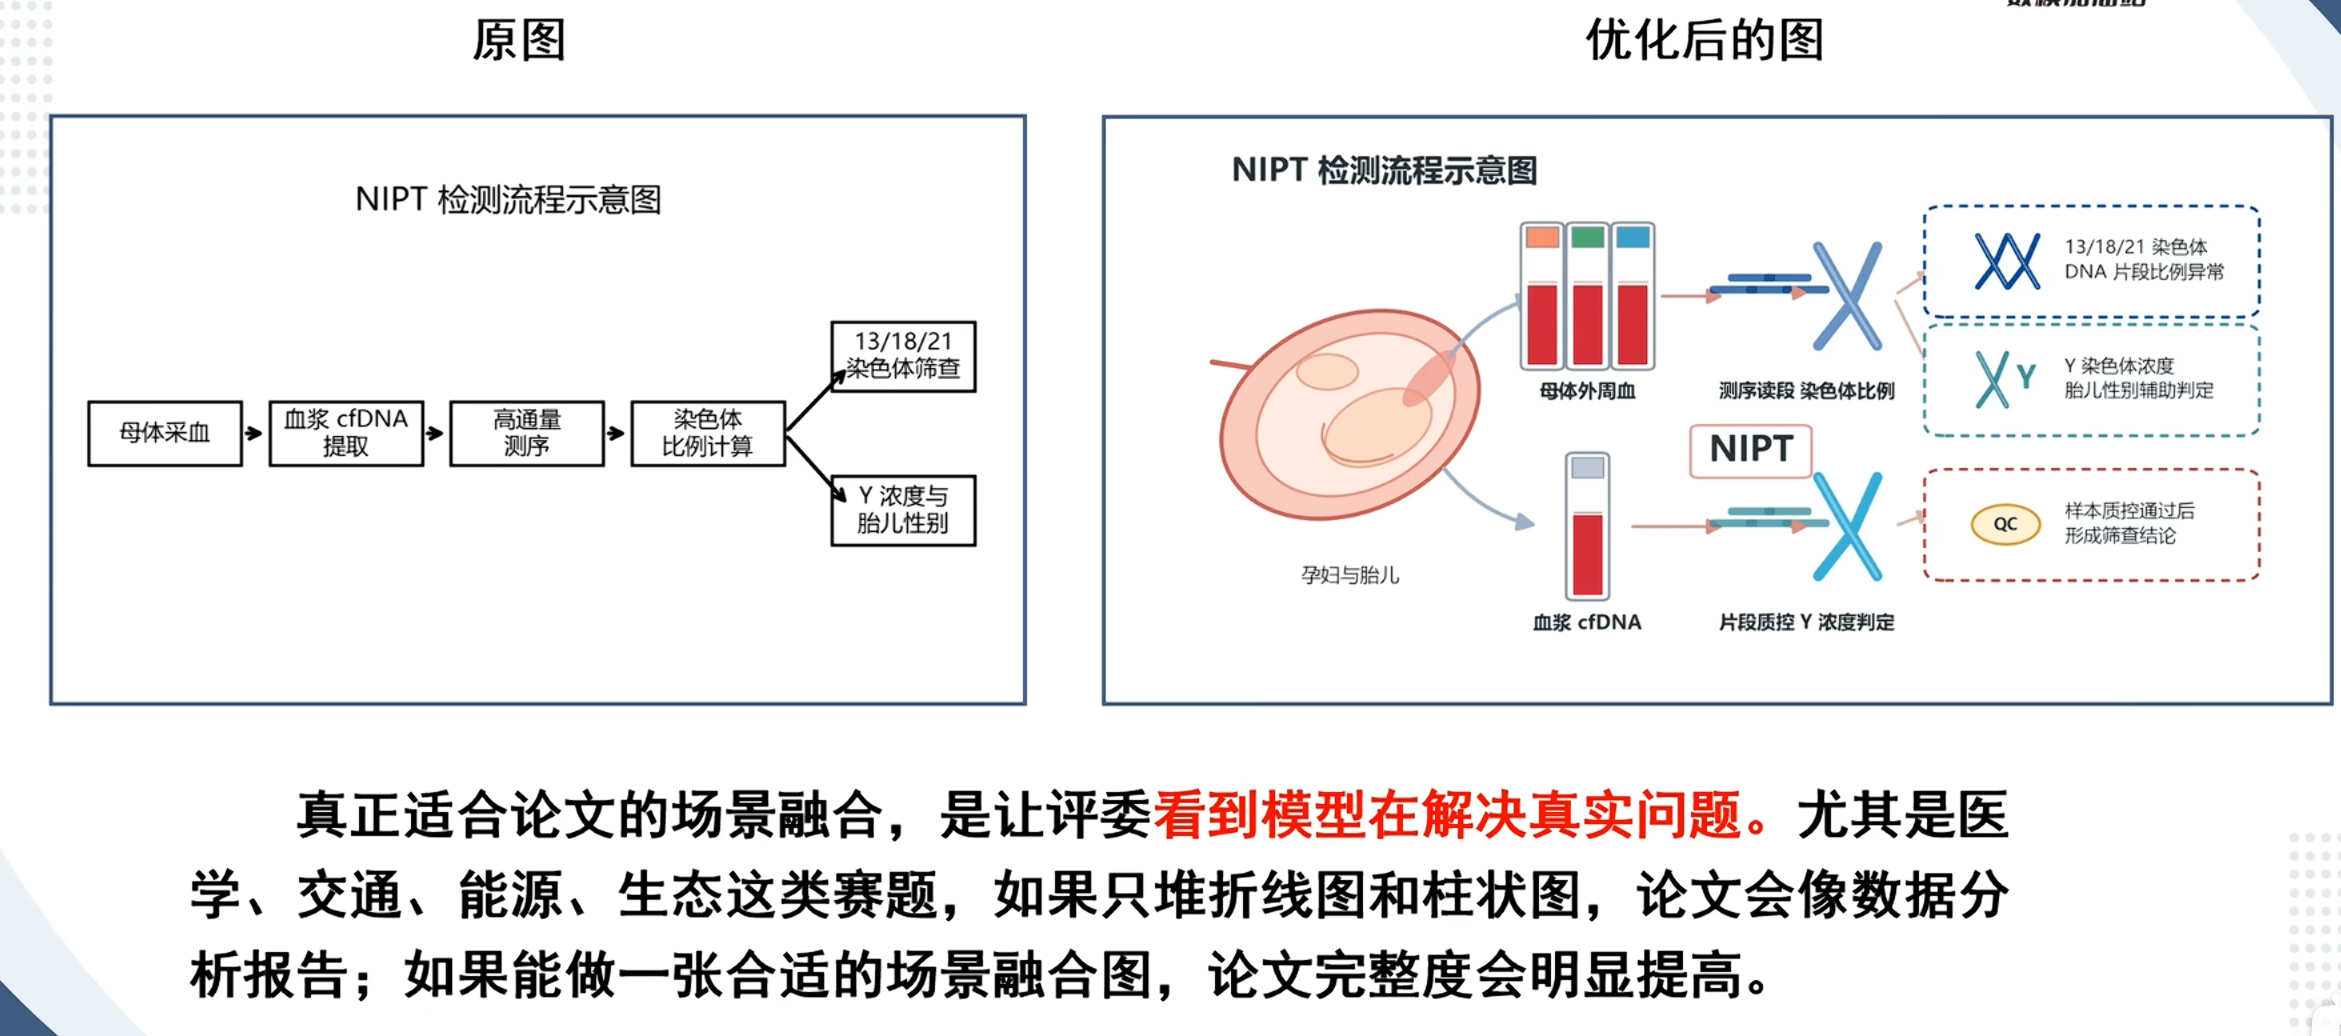
参考提示词
你是数学建模竞赛的论文图设计助教。下面是一份普通 NIPT 流程框图代码,它能说明步骤,但缺少题目背景对象和医学机制图的视觉表达。
请只升级"赛题场景融合",重点放在 NIPT 检测流程和题目背景,不要把推荐检测时点作为主图重点,不要编造新检测结论。
请把普通流程框图升级为医学机制示意图:
- 左侧绘制孕妇/胎儿或子宫胎儿示意,作为题目背景对象。
- 中间绘制母体外周血样管、血浆 cfDNA、NIPT、测序读段、染色体比例检测和 Y 染色体浓度判定。
- 右侧使用简洁虚线结果框,呈现 13/18/21 染色体 DNA 片段比例异常、Y 染色体浓度/胎儿性别辅助判定、样本质控与筛查结论。
- 图内只用短标签,不写大段说明文字。
- 白底、医学论文示意图风格,颜色克制,箭头清楚。
- 不做宣传海报,不使用装饰性背景。
- 输出完整可运行 Python 代码。
- 导出 PNG,保存后调用 plt.show()。
- 只输出代码,不要解释。
学习参考
https://www.bilibili.com/video/BV1SMhV6PEQC/?spm_id_from=333.1007.tianma.1-1-1.click\&vd_source=b305d6a8930c4bc504711f7d564a096f
https://github.com/kaixin-aa/figure-code/tree/main/examples/001-bmi-y-concentration