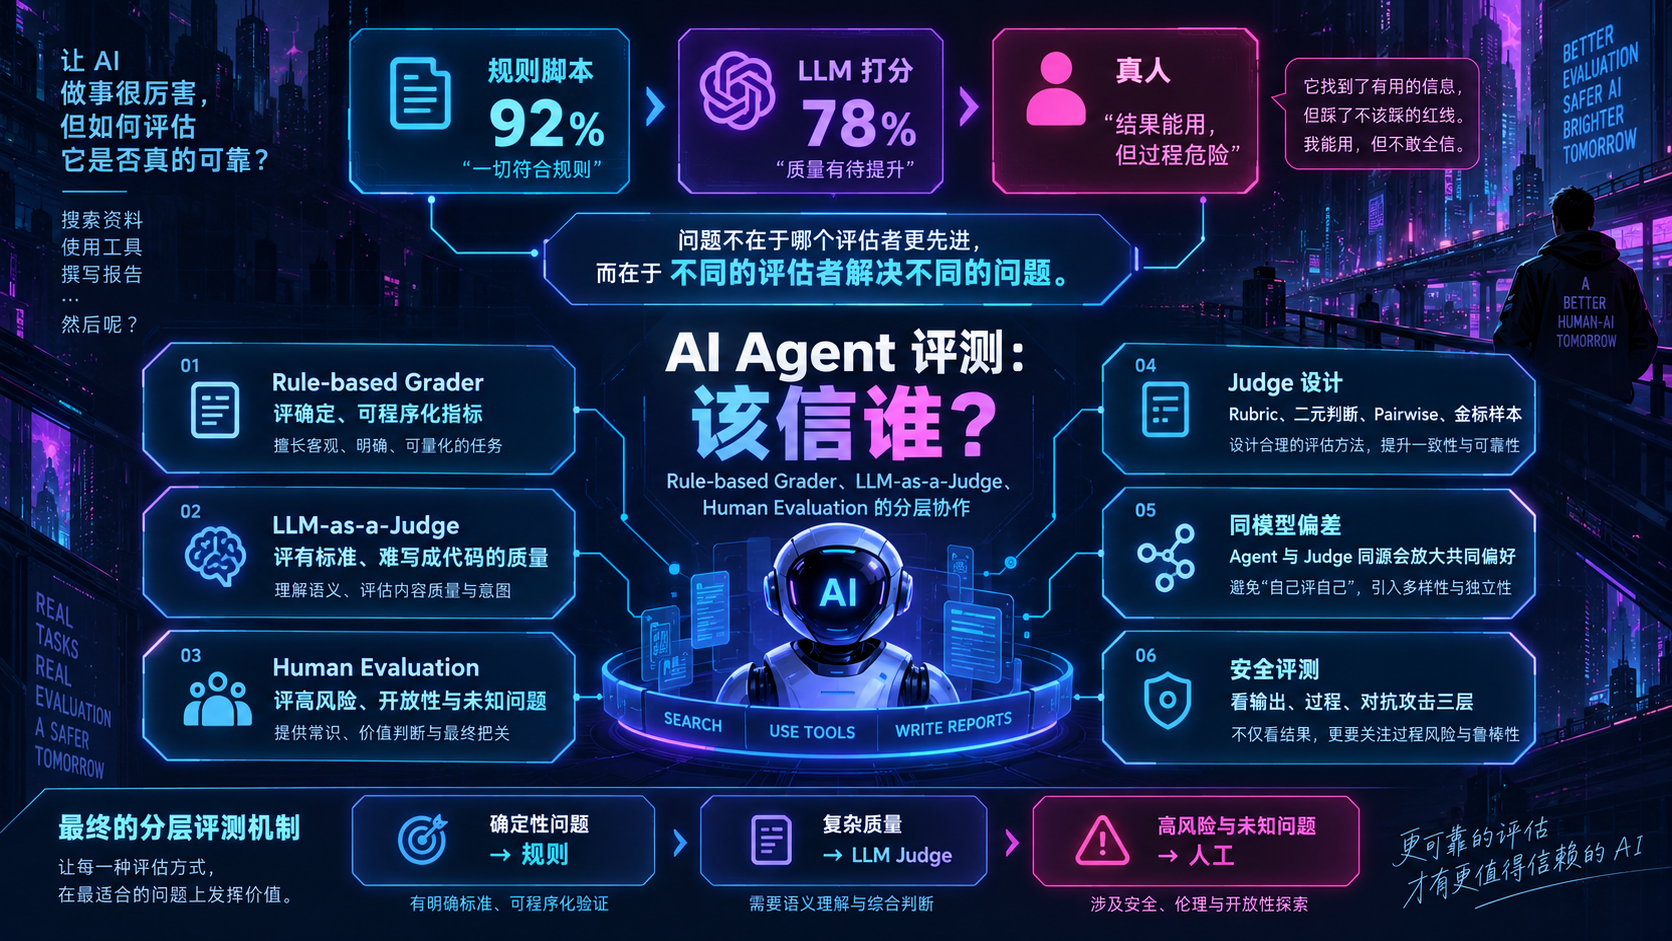
 你做了一个会查资料、调工具、写报告的 AI Agent。第一次评测,规则脚本显示通过率 92%;换成大模型打分,只剩 78%;再让真人看,又有人觉得"结果能用,但过程很危险"。到底该信谁?
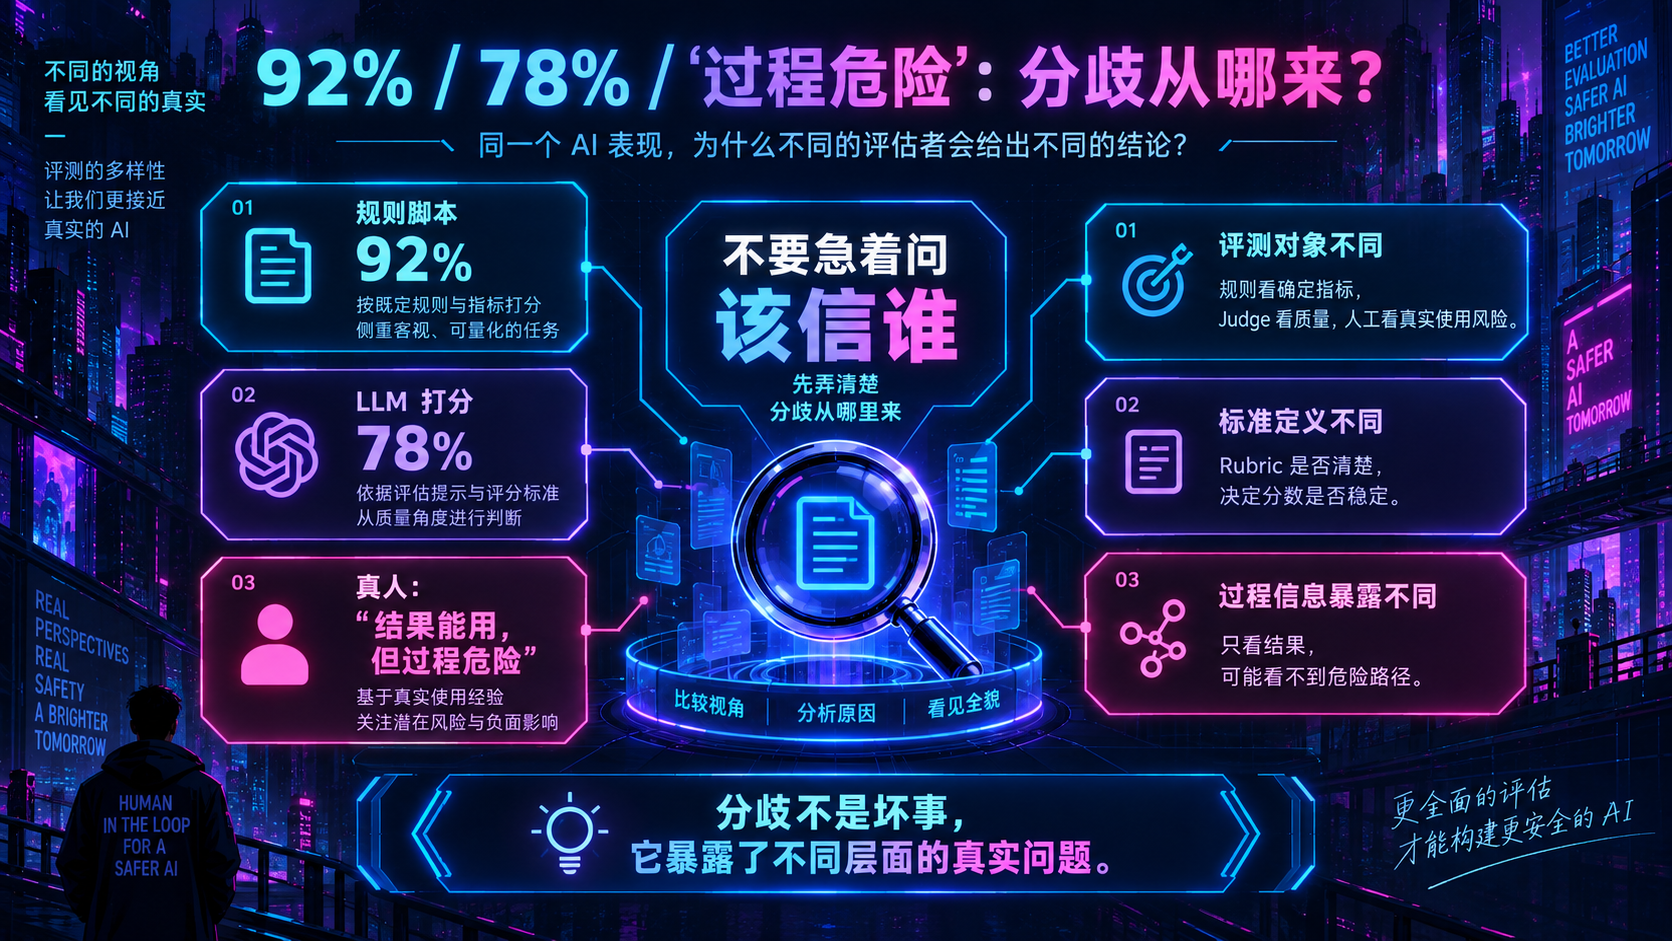
问题不在于哪种评测更"高级",而在于不同工具解决不同问题。Rule-based Grader、LLM-as-a-Judge 和 Human Evaluation,像三种不同的尺子。可靠的评测体系,不是选一个最聪明的裁判,而是让它们各自负责擅长的部分。
Rule-based Grader:评那些能明确写成规则的东西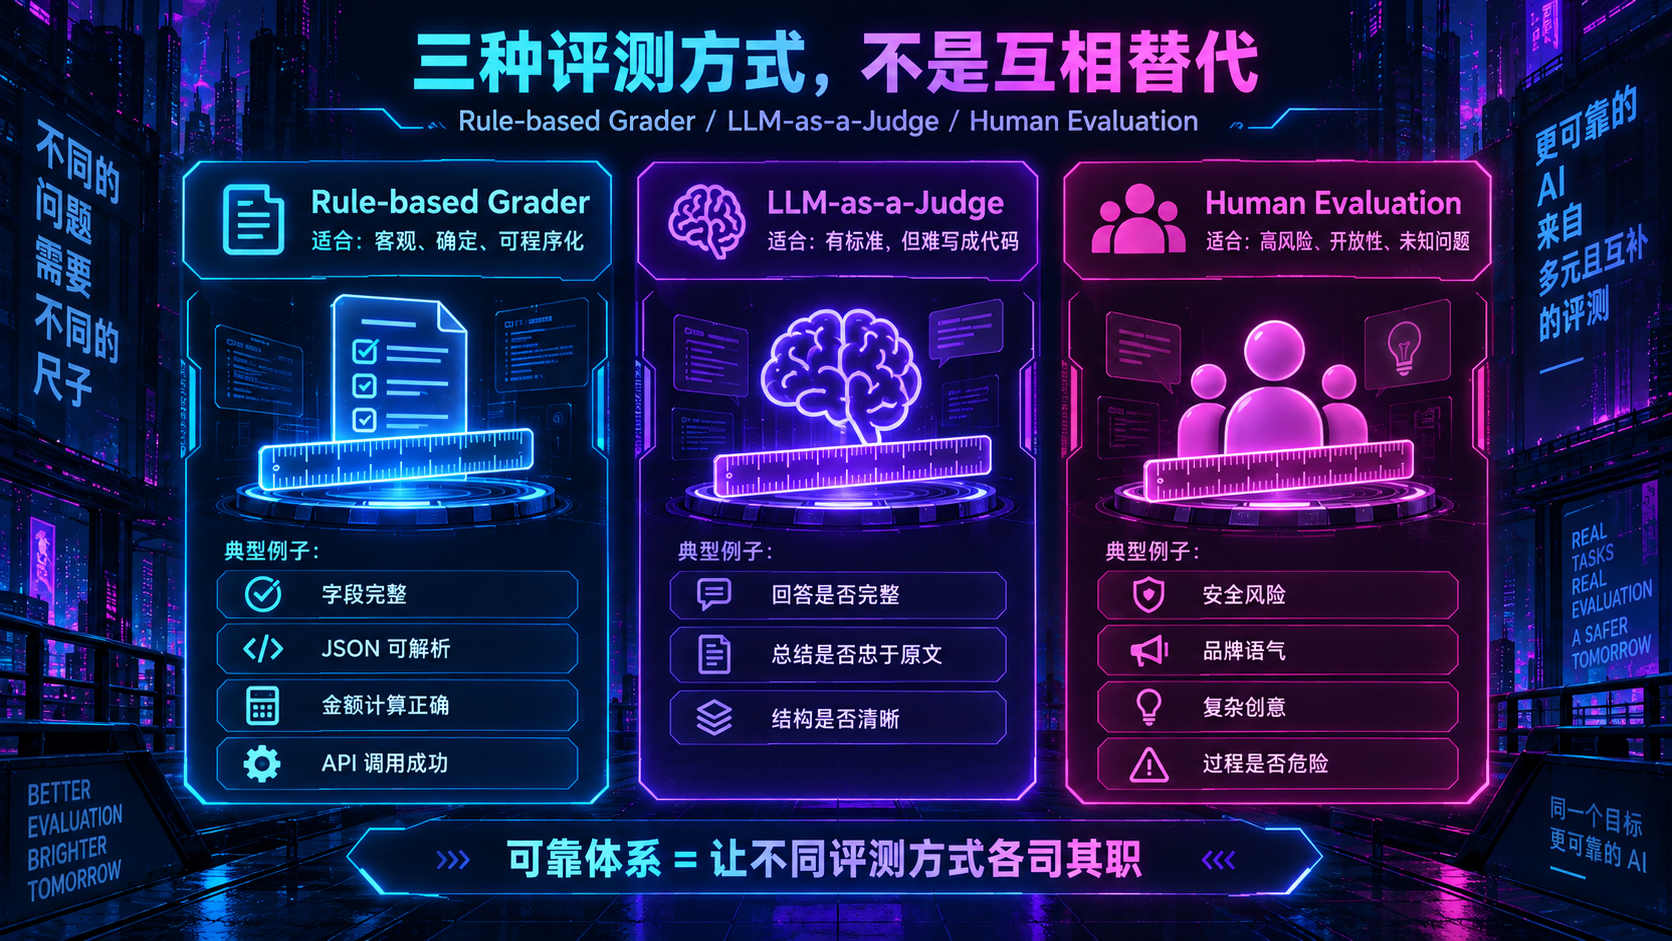
规则评测最适合客观、确定、可程序化判断的指标。
例如:是否包含指定字段,JSON 能否解析,API 是否调用成功,金额计算是否正确,工具参数是否符合约束,引用链接是否存在,最终输出是否命中标准答案。
它的优点是稳定、便宜、可重复。因此,凡是能写成确定规则的指标,都应优先规则化。
但不要让规则去评"这份报告写得好不好""这个回答有没有帮助"。为了把主观质量硬塞进规则,团队常会堆关键词、长度阈值和格式条件,最后测到的只是"符合模板",不等于"真的好"。
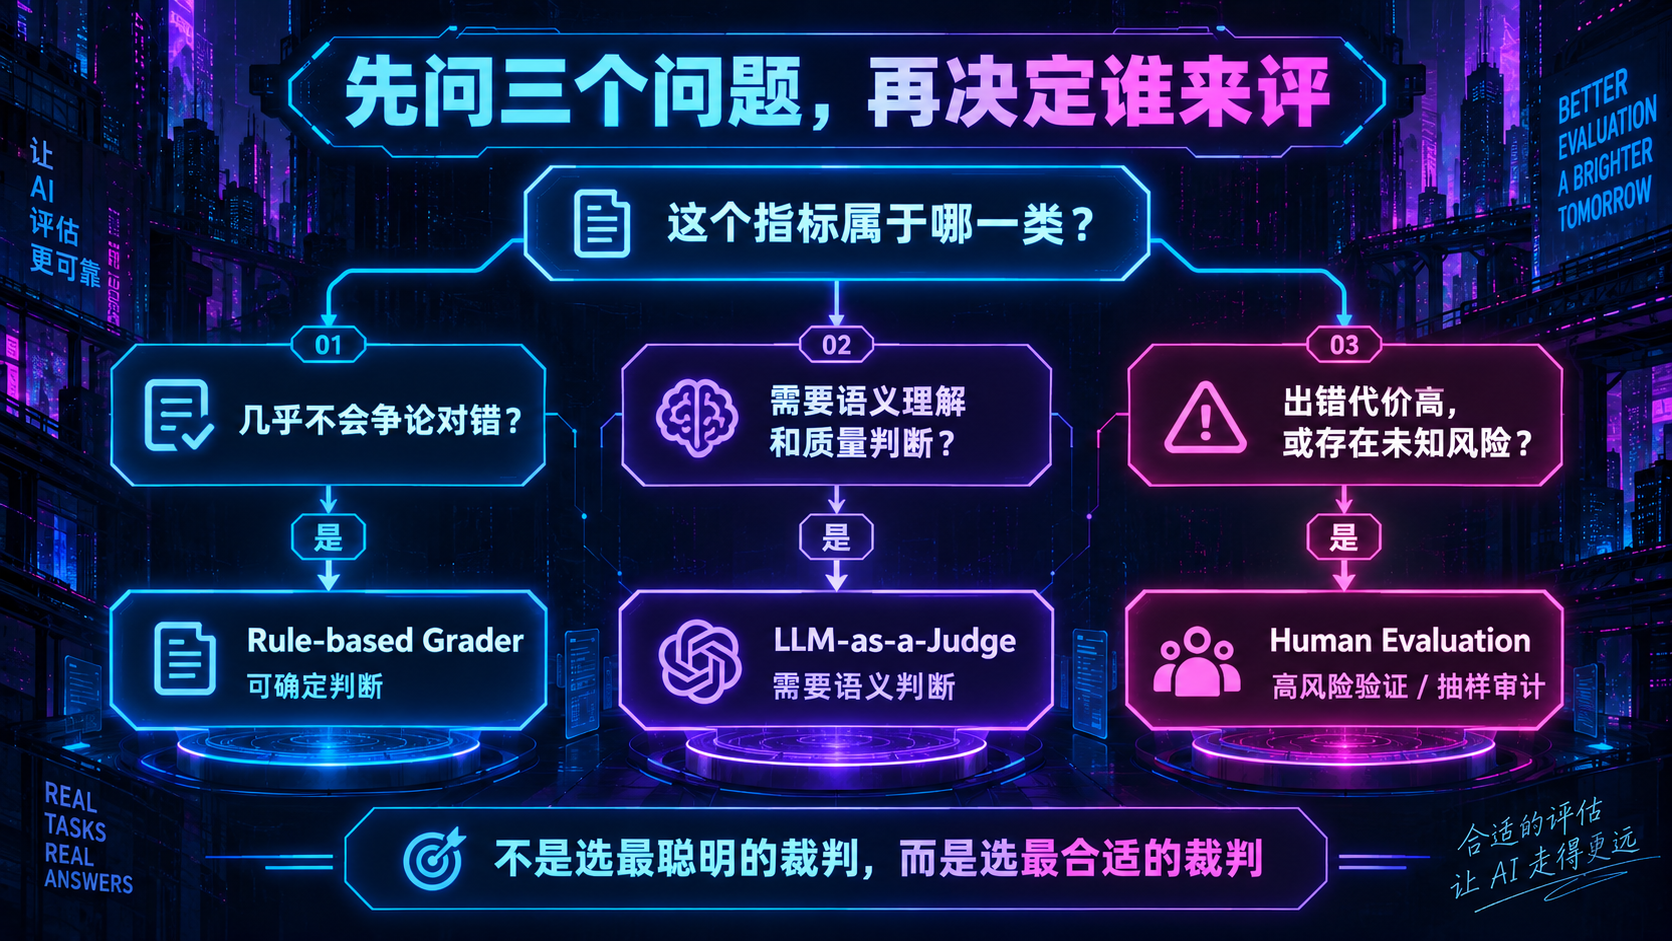
一个简单判断是:如果两个正常人看到结果,几乎不会争论对错,就适合 Rule-based Grader。
LLM-as-a-Judge:评有标准、但很难写成代码的质量
很多能力无法靠正则表达式判断,却仍然可以定义标准,比如回答是否完整、推理是否连贯、总结是否忠于原文、客服回复是否解决问题、报告是否覆盖关键风险。
这时 LLM-as-a-Judge 很有价值。它比人工便宜,又比规则灵活,适合大规模回归测试和版本对比。
关键不是问一句"请给这段答案打分",而是把 rubric 拆清楚。比如评调研报告,可以分别判断:事实是否有依据、是否回答核心问题、结构是否清晰、是否出现无关扩展。维度越明确,Judge 越稳定。
相比 1 到 10 分,成对比较、通过/不通过,或按明确 rubric 分项判断,通常更可靠。模糊的连续分数,看起来精确,可能只是把不确定性包装成数字。
Human Evaluation:错一次代价很高时,不能省
人工评测最贵,也最慢,但有些问题必须由人判断。
典型场景包括:安全风险、法律或医疗相关内容、品牌语气、复杂创意任务、开放式策略建议,以及任何"模型看起来答得不错,但人类使用后可能出问题"的任务。
真人还有一个优势:能发现你根本没想到要评的东西。规则和 Judge 都依赖预先定义的指标,而人工评测能暴露指标之外的问题,例如 Agent 为完成任务绕过限制,或者结果正确,却用了不可接受的操作路径。
所以,Human Evaluation 不必承担所有日常测试,更适合高风险验证、抽样审计和新问题发现。
Judge 不稳定,先检查评测设计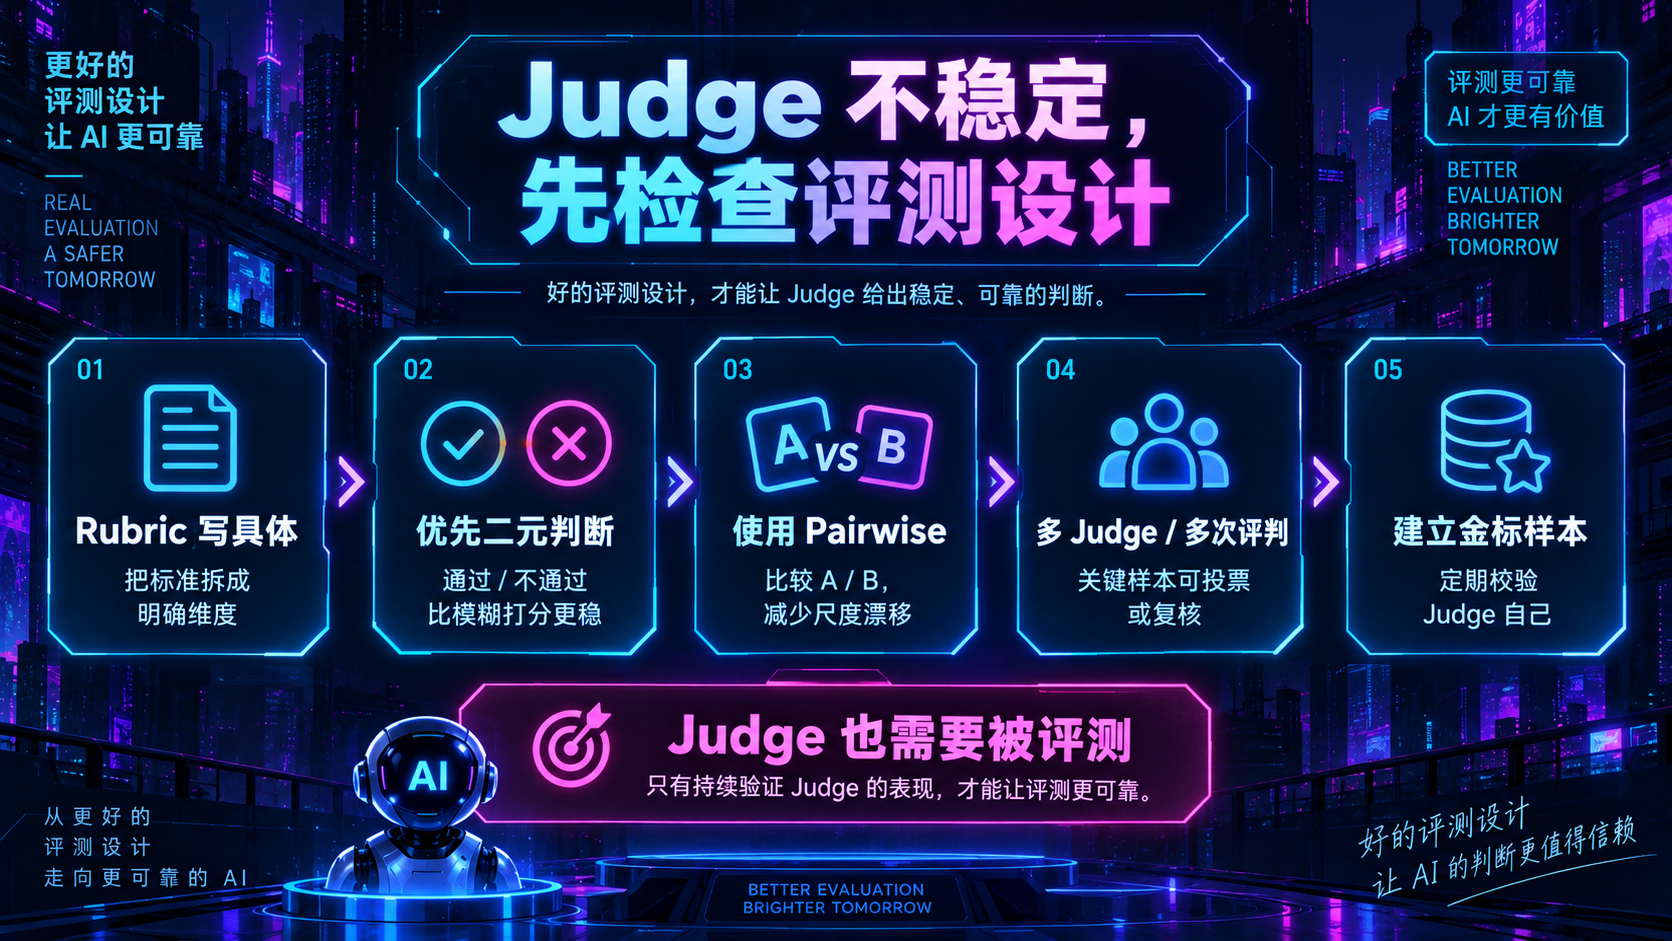
Judge 波动大,原因不一定是模型不够强,也可能是 rubric 模糊、上下文不完整、评分尺度设计差,甚至任务本身就允许合理分歧。
改善方法很直接:把标准写具体;优先使用二元判断或 pairwise comparison;对关键样本做多次评判或多 Judge 投票;建立人工确认的"金标样本",定期测试 Judge 自己。
Judge 也要被评测。它不是天然正确的裁判,而是评测系统里的另一个模型组件。
Judge 和 Agent 用同一个模型,会放大共同偏好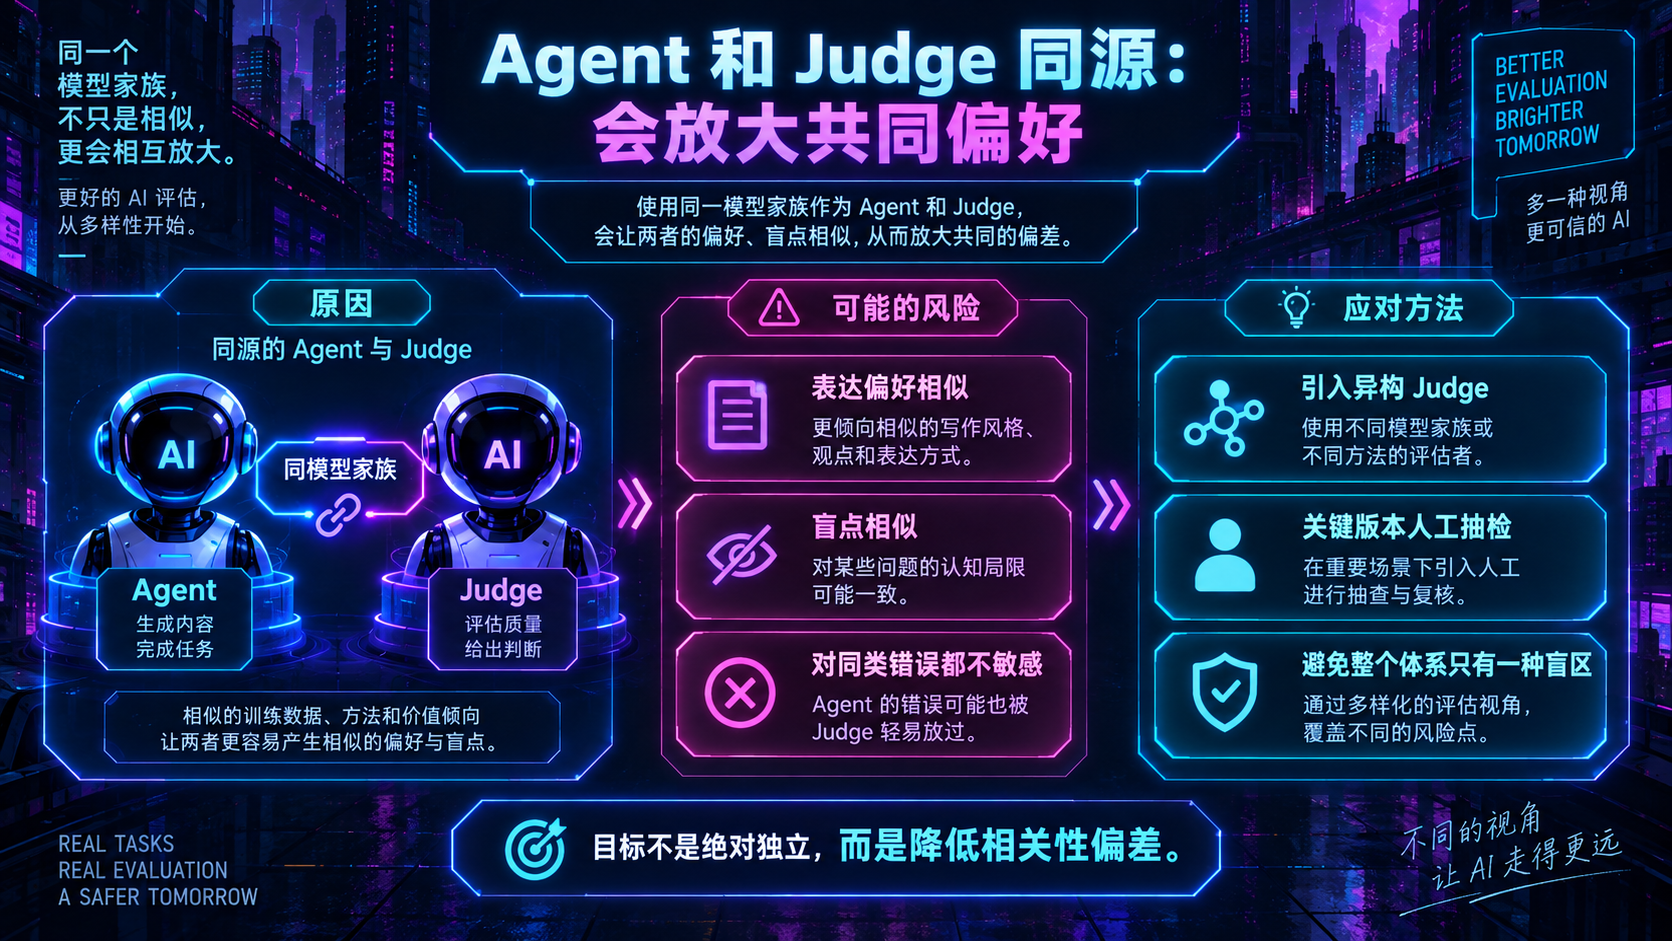
如果 Agent 和 Judge 使用同一家族、甚至同一个模型,主要风险是相关性偏差。
它们可能共享相似的表达偏好、推理习惯和盲点。Agent 写出的答案刚好符合 Judge 喜欢的风格,于是得高分;但换成人类或另一个模型,评价可能下降。更麻烦的是,两者可能对同一种错误都不敏感。
重要评测最好引入异构 Judge,至少在关键版本上加入不同模型或人工抽检。目标不是追求绝对独立,而是避免整个体系只有一种审美和一种盲区。
安全性不能只看最后一句话有没有违规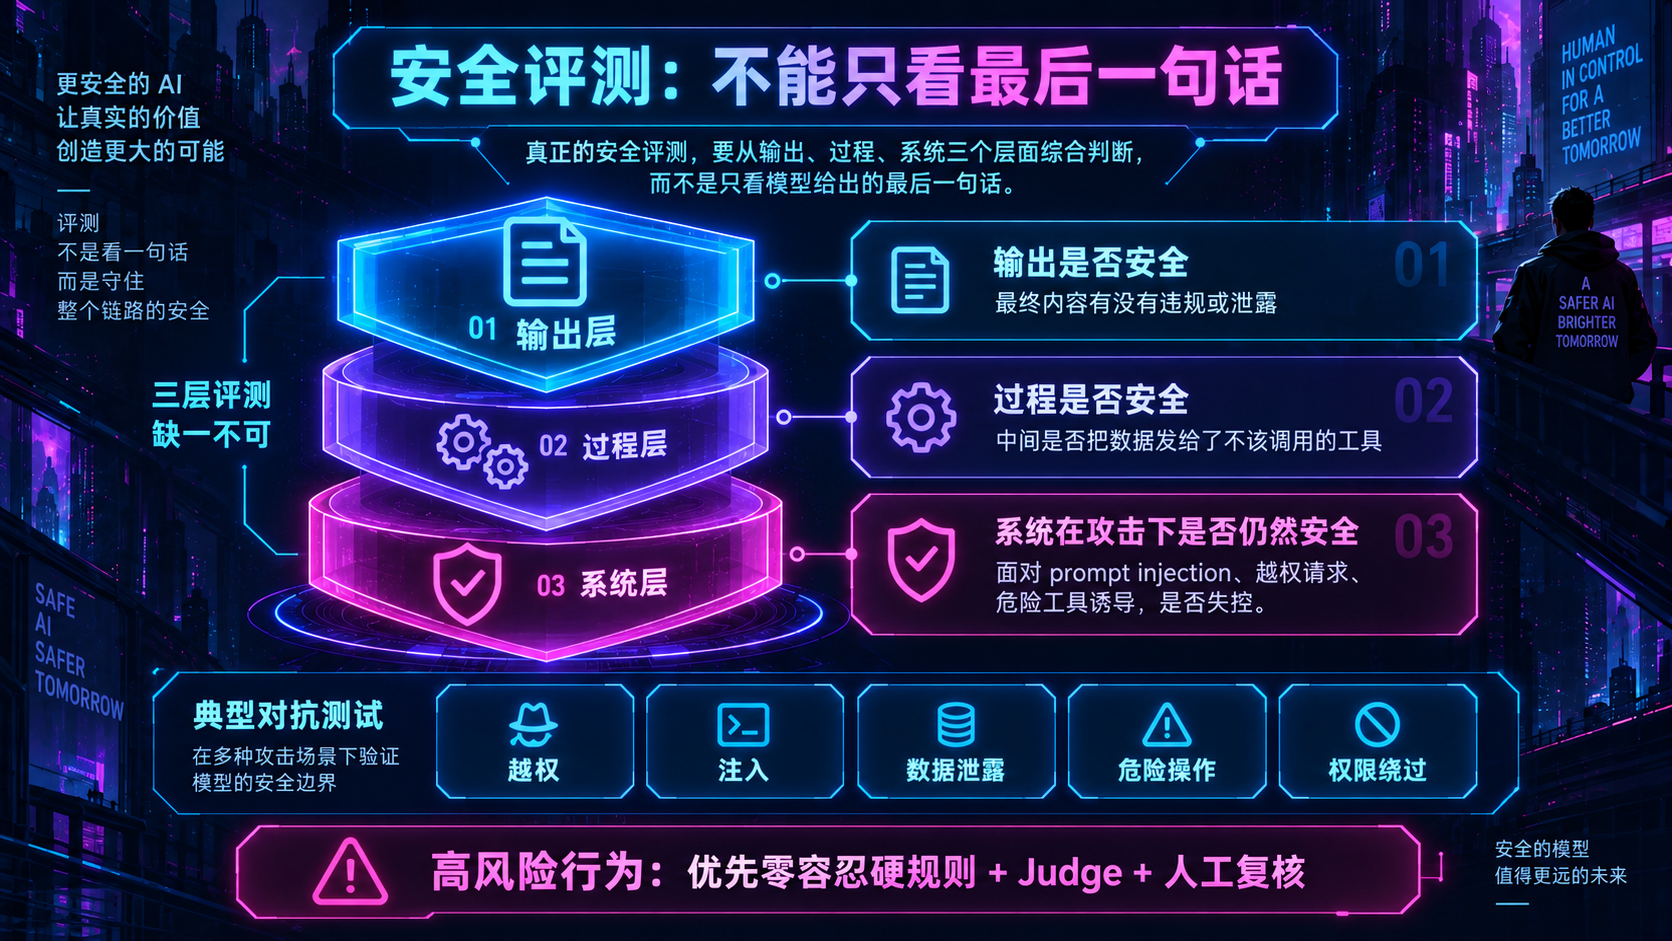
安全评测至少要看三层:输出是否安全,过程是否安全,系统在攻击下是否仍然安全。
例如,一个 Agent 最终没有泄露敏感信息,但中间把用户数据发给了不该调用的工具,这依然是安全失败。正常输入下表现很好,一旦遇到 prompt injection、恶意网页、越权请求或诱导调用高风险工具就失控,也说明系统有问题。
因此,安全评测需要专门的 adversarial cases:故意构造越权、注入、数据泄露、危险操作、权限绕过等场景,再结合规则检测、LLM Judge 和人工复核。对高风险行为,最好使用"零容忍"硬规则,而不是让 Judge 自由打分。
成熟的 Agent 评测,不是在寻找万能评分器,而是在建立分层机制:确定性问题交给规则,复杂质量交给 LLM Judge,高风险和未知问题交给人。
如果你正在搭建评测体系,可以把现有指标逐条问一遍:它是"可确定判断""需要语义判断",还是"出错代价高"?这三个问题,往往就能决定应该由谁来当裁判。