机器视觉的架构正在换代:过去二十年「工业相机负责成像、上位机与服务器负责理解」的分体式架构,正在让位于传感、处理、IO 封装一体的智能相机。这不只是形态变化------当推理单元与感光元件的距离从几十米缩短到几厘米,延迟模型、带宽模型、部署与运维模型全部要重写。本文按架构演进、数据通路、算力选型、模型链路、热设计、端云协作六个环节,拆解一台智能相机的工程决策链,供选型与自研团队参考。
一、架构迁移的三级链路
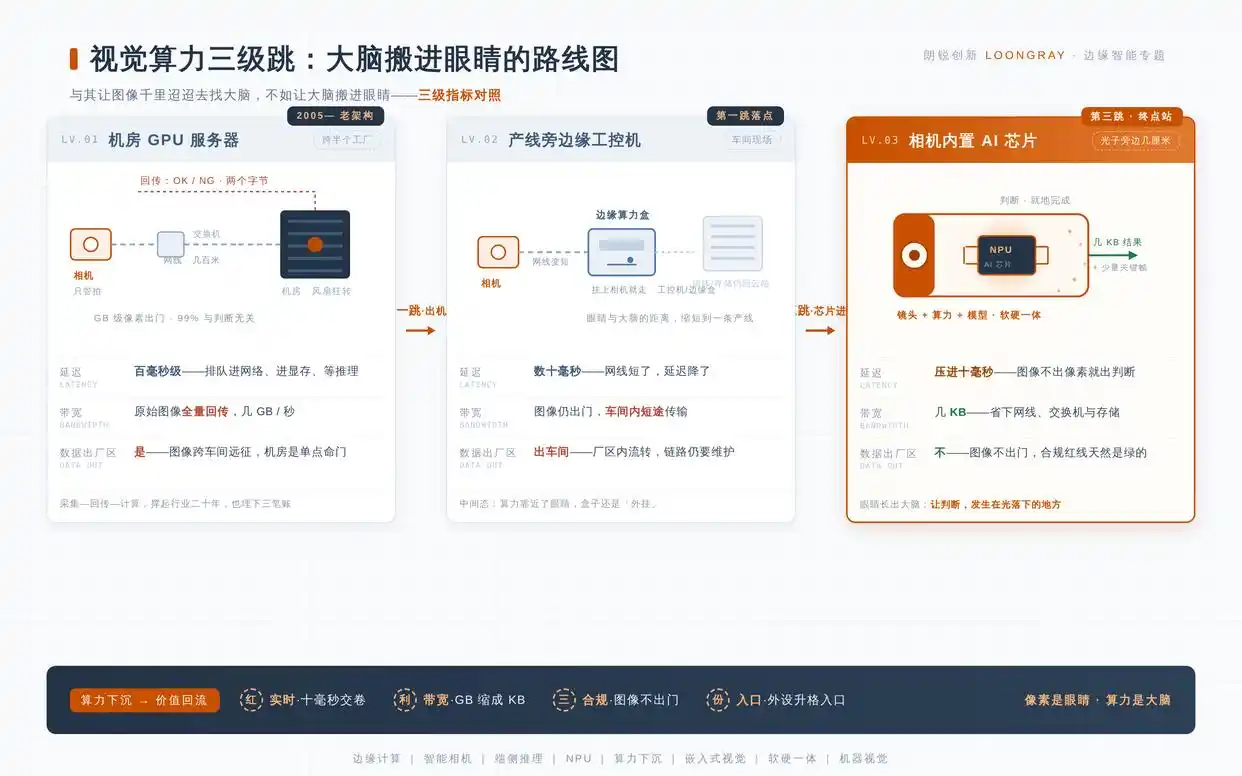
分体式(工业相机 + 采集卡 + 工控机)是行业默认起点:相机只做光电转换,图像经 GigE/USB3 传回机柜,GPU 负责推理。它的痛点不在单点性能,而在链路:传输排队、网络抖动、驱动拷贝,每一环都在给延迟和故障率加码。
第二级是边缘化:把推理主机从机房挪到产线旁的工控机或边缘盒,传输距离缩短,排队环节减少。但相机与主机仍是两套设备,线缆、供电、部署节点一个不少。
第三级是一体化:推理 SoC 进机身,传感器与算力之间不再有网线,全链路在一个壳子里闭环。关键变化在于故障模式被整体收纳------分体式里「网线松了、交换机过热、抓帧丢包」是三类独立故障,一体机里它们压根不存在。架构迁移的本质,是把一堆需要现场联调的部件,变成一台可以整体测试、整体备份、整体更换的设备。
| 维度 | 服务器集中式 | 产线边缘盒 | 一体化智能相机 |
|---|---|---|---|
| 推理位置 | 机房 GPU | 产线旁主机 | 机身内 SoC |
| 典型判断往返 | 100ms 级 | 数十 ms 级 | 10ms 内 |
| 中间环节 | 相机/线缆/交换机/服务器 | 相机/短跳线 | 无外部链路 |
| 故障定位 | 全链路排查 | 两端排查 | 整体更换 |
| 部署密度 | 一柜服务多工位 | 一盒一工位 | 一机一工位 |
二、数据通路:传感直连的第一性账
一体化架构的第一笔红利在物理层。以 500 万像素、10bit、60fps 计,原始数据率约 370MB/s------这个量级在千兆以太网(有效载荷约 110MB/s)上根本跑不动,分体式只能靠降帧或 ROI 裁剪凑合;而传感器直连(MIPI CSI-2,4 lane)承载它毫无压力。直连意味着「满帧全画幅进处理器」从奢侈品变成默认值,很多在分体式架构里被迫放弃的算法方案(逐帧全图分析),在机身内重新可行。
代价是选型责任前移:MIPI 的走线长度、抗串扰、与 ISP 的时序配合,从「买成品相机」变成了「自己做板级设计」------这也是为什么智能相机的门槛在系统设计,不在单点器件。
直连还顺带改变了控制回路:判断结果不再绕道上位机,直接从机身 IO 输出到 PLC------触发、曝光、推理、输出在同一时间基准上闭环,省掉一次跨设备握手。对高速剔除这类应用,这条短路径就是方案成立的前提。
三、算力选型:TOPS 之外的三张考卷
厂商参数表把 TOPS 排在第一位,工程实践里它顶多排第三。真正决定量产成败的是三件事。
算子覆盖率。 NPU 标称算力是标准算子 INT8 峰值的理想值;一旦模型里有算子不被 NPU 支持、fallback 到 CPU,该层时延可能放大一个数量级,且不可控。正确流程是先拿目标模型跑一遍算子兼容性验证,输出每层耗时分布,再定芯片------顺序反了,就是在给项目埋雷。
内存带宽。 多数轻量 CNN 是带宽受限而非算力受限:经验比例上,每 1 TOPS 的有效算力需要 1~2GB/s 内存带宽支撑。LPDDR4 的 6~12GB/s 才是端侧推理吞吐的真实锚点。只看 TOPS 选中高标称低带宽的方案,实测吞吐往往只有参数表的三四成。
功耗包络。 无风扇机身靠外壳被动散热,整机预算通常 5~8W,其中 NPU 只能占 2~4W。推荐选型顺序:先锁功耗与散热包络,再筛内存带宽,最后才比 TOPS------倒着选的方案,大多在量产热测阶段返工。
还有一个容易被忽视的维度:多传感器同步。RGB 与深度若要融合,两路数据必须对齐在同一时间基准上。机身内直连架构天然共享时钟;分体方案要靠外部触发线硬同步------同步精度每差一毫秒,运动场景的融合误差就多一截。同步能力是买不来的参数,它长在架构里。
四、模型链路:从几个 GB 到几十 MB
云端视觉模型动辄数 GB,端侧存储与内存只装得下几十 MB,中间隔着一条完整的压缩链路。
训练后量化(PTQ)先行:INT8 量化通常能把体积压到 1/4、吞吐提 2~4 倍,多数层精度损失可控;对量化敏感的层(典型如检测头、小目标特征层)保留 INT16 或加入白名单,用 QAT(量化感知训练)单独补偿。剪枝与蒸馏在此基础上再压一档。级联推理是时延的另一个杠杆:低分辨率粗定位 + ROI 内精检测,平均时延常能降一个量级,代价是流程复杂度。
比压缩更重要的纪律是回归测试:每一次量化、每一次重训、每一次换硬件版本,都在同一套留出集上跑精度回归,任何「顺手优化」不允许跳过这条流水线。压缩链路上还有一条隐蔽的红线:量化误差与光照域偏移会叠加------模型在标准光照下量化损失 0.5%,到强反光工位可能放大到 2%,回归集必须覆盖产线的真实光照分布,只拿实验室样本验收,等于给现场留暗雷。端侧模型是固件,不是脚本------固件的改动必须有版本、有记录、有回滚。
五、热与结构:无风扇的代价
被动散热机身里,热设计直接决定三个东西:稳定性(推理满载与待机的温差、夏季车间环境温度、产灯辐射叠加后的结温余量)、寿命(长期高温加速器件老化)、画质(sensor 温漂推高暗电流与噪声------热设计就是画质设计,这是多数选型清单里缺失的一项)。
工程上做三件事:整机热成像摸清热点分布;设定温控降频墙,宁可牺牲峰值帧率也要守住结温上限;外壳参与导热路径设计,把结构件当散热器用。三件事都该在 EVT 阶段完成,拖到量产热测才发现问题,改的是结构件,回来的是开模费。结构上还要补一笔:机身刚性与镜头热漂。振动会让对焦平面微移,温漂会推动焦距微变------它们都伪装成「模型不稳定」,实则出身机械。热设计的验收清单里应当包含成像稳定性,而不只是芯片结温。
六、端云协作与 OTA:模型的运维化
训练在云、推理在端的分工没有争议,争议常在中间的迭代链路怎么做。三个实践要点。
其一,数据回路:端侧以影子模式回传低比例关键帧与误判样本,云端持续累积再训练------没有数据回路的端侧模型,三个月后就开始陈旧。其二,升级安全:模型与固件同权管理,签名校验防篡改,A/B 双分区保证写入失败可回滚,灰度按产线批次分批推送,绝不一把梭。其三,失效复盘:现场每一次误判都要有样本归档与归因,闭环进下一轮训练------OTA 运维的工程量比模型本身大一个量级,但它决定项目的实际寿命。最后补一条版本纪律:模型与固件必须成对发布,NPU 驱动、算子库、模型权重三者任意一项单独升级,都可能出现兼容性裂缝------版本配对表要跟着发布走,宁可慢,不可错位。
七、选型清单与结语
把全文收成六项 checklist,按序执行:
| # | 检查项 | 通过标准 |
|---|---|---|
| 1 | 功耗包络 | 整机预算内,夏季工况结温有余量 |
| 2 | 内存带宽 | 实测吞吐达参数表的七成以上 |
| 3 | 算子覆盖 | 目标模型全层在 NPU 上运行,无 fallback |
| 4 | 量化回归 | 留出集精度损失在合同阈值内 |
| 5 | 热实测 | 整机热成像无局部热点,温控墙生效 |
| 6 | OTA 闭环 | 双分区 + 签名 + 灰度 + 回滚全通 |
智能相机不是「加了 AI 的相机」,而是把视觉系统从工程集成问题变成单件产品问题------集成的复杂度被封进机身,交付物从一堆需要联调的部件,变成一台可整体测试的设备。算力下沉的这一步,改变的不只是延迟数字,还有整条产业链的分工方式。