一、概览
- Tool Calling & MCP 架构、原理
- Agent 架构、ReAct、Planner&Executor、Reflection、A2A、ANP
- HITL
- Skill 文件结构、渐进式披露、编写原则
- KNN、IVF、HNSW
二、Tool Calling & MCP
2.1 Tool Calling 和 MCP 概念
LLM 本身只有生成文本的能力,是无法对外界产生任何影响的。但是通过 Tool Calling,就能够让 LLM 长出来手和脚。让 LLM 知道 Tool 的存在、何种输入、输出什么,就可以让 LLM 根据要求进行参数输出,Tool 进行操作,这样 LLM 就完成了 Tool Calling
但是不同的 Tool 的参数格式不同,而且需要使用多个工具的情况下,就要把这些工具名称、工具调用方式全都塞到上下文窗口。大量的 Tool 意味着大量的重复代码的开发,所以 MCP(Model Context Protocol)诞生了。
就像充电口有 Type-C、Micro-USB、Lightning 一个设备如果想要支持这三种口的话,那么就需要开发三个接口,非常冗余。但是如果只支持一个口,这个口是一个转接器,而这个转接器支持以上所有的接口的话,那么工作量就大大减少了,就像 Mac Mini 的那种可以放在小主机底下的底座,上面有各种各样的接口,但是和小主机只有一个连接。
这个"转接器",就是 MCP,更精确地说,MCP 是一种让 LLM 通过统一的方式进行工具的发现、理解、调用的协议。
2.2 MCP 核心架构
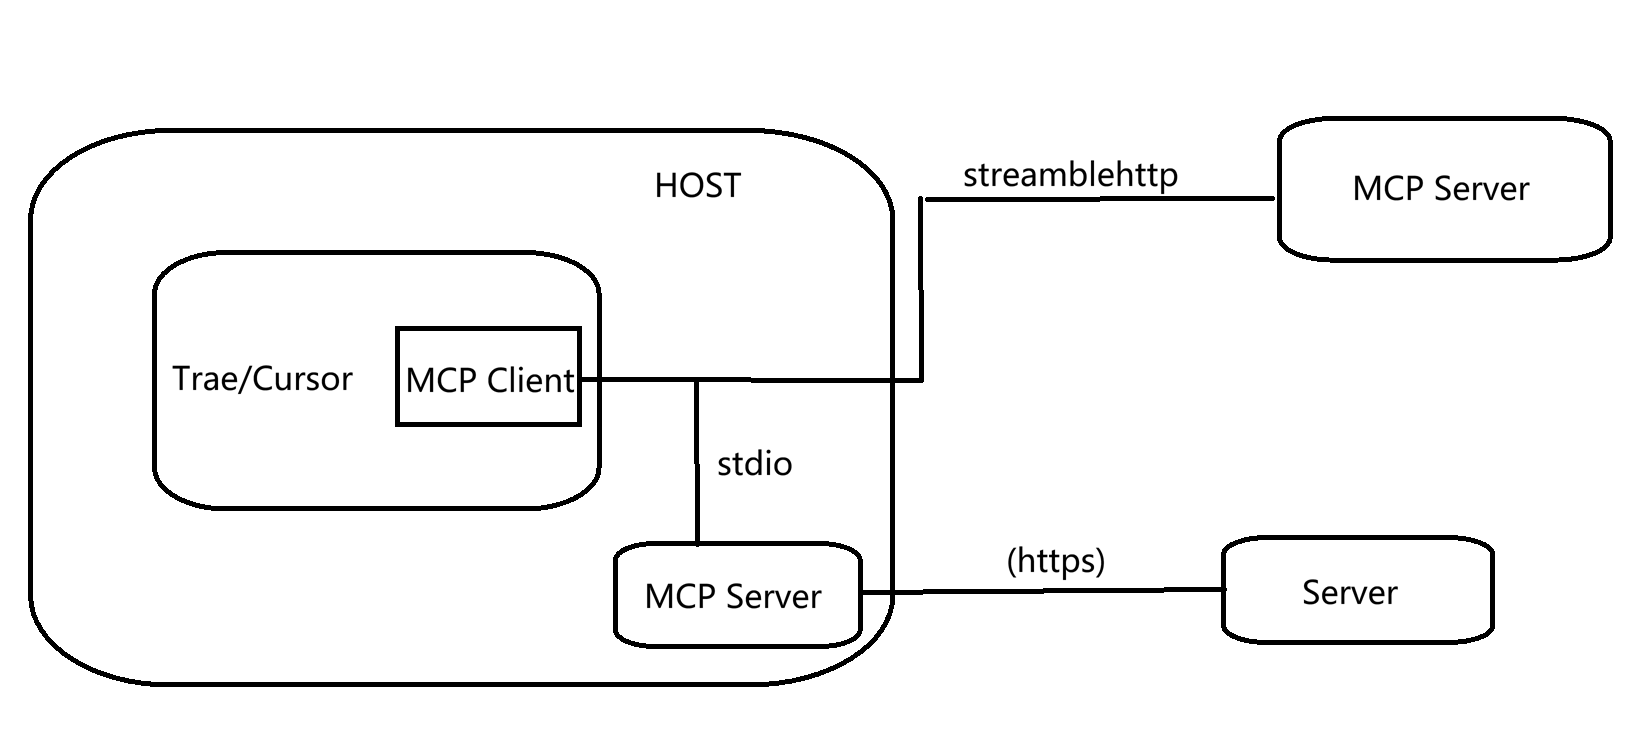
MCP 基于 CS 架构,通过 MCP Client 向 MCP Server 发送请求,MCP Server 负责执行实际的操作。
- AI 应用或者 IDE,一般集成了 MCP Client,为用户提供了一个和 AI 交互的前端界面,称为 MCP Host
- MCP Client 和 MCP Server 之间的通信方式一般有两种:
- Streamable HTTP:一般 MCP Server 位于远程服务器(如果是开发或部署的本地 MCP 服务也可能在本地运行),通过 HTTP 协议通信
- stdio:一般 MCP Server 在本地运行,作为子进程通过标准输入输出(stdin/stdout)通信
2.3 MCP 工作原理
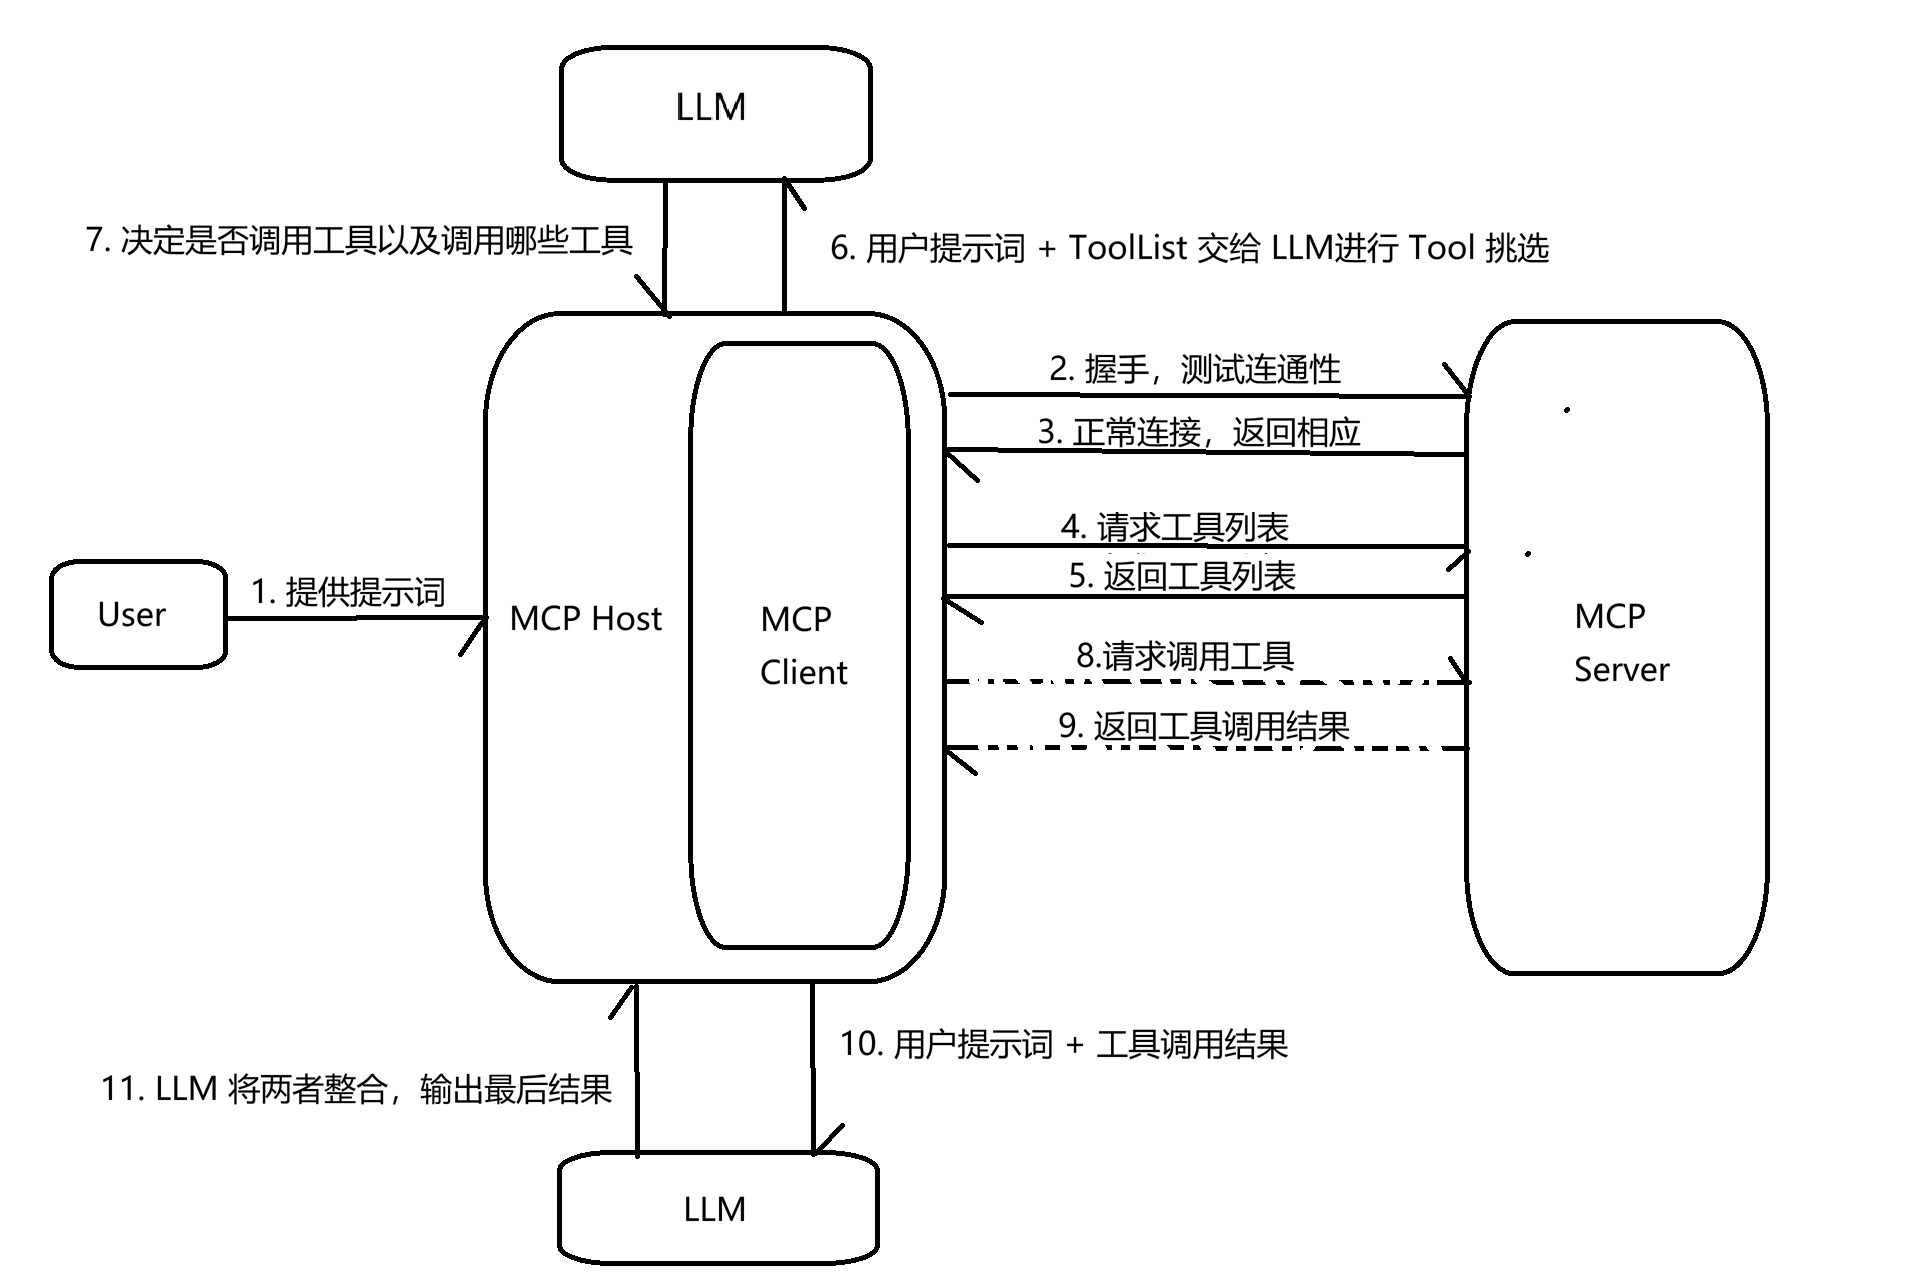
现在为了提高效率,2、3的握手阶段也经常合进工具列表获取阶段
三、Agent
3.1 Agent 特点
- 感知环境
- 自主调用工具
- 自主决策
- 有记忆能力
3.2 Agent 架构
一个 Agent 的组成可以通过下面的公式来表达:
Agent = LLM + Planning + Memory + Tools
其中,LLM 起到大脑的作用,驱动整个 Agent 的工作。其余三个部分解释如下:
- Planning 作为 Agent 的策略,可以分为下面几种:
Chain of Thoughts,思维链模式。从需求和条件出发,一步一步思考得到最后结果Subgoal Decomposition,分解子目标。当一个目标过于宏大,就适合将其分为多个子目标来执行,比如制作一个博客网站,就可以分为制作首页、个人信息页、公共组件开发等Reflection,反思。完成一步思考或者处理后,回过头来检查是否做出了正确的更改。比如现在使用 OpenCode,几乎在所有修改后都能够看到 Agent 明确声明自己开始检查代码更改的合理性Self Critics,自我批判。生成最后的结果后,检查输出内容是否符合要求,如果不符合那么就返工重干
- Memory,起到经验的作用,也是 Agent 的学习能力的基础。记忆主要分为两种:
Short-term Memory,短期记忆。作用范围只在对话的周期里Long-term Memory,长期记忆。作用范围到了跨对话的维度
- Tools,是 Agent 的手脚,负责对外界产生实际的影响和操作,具体的实现方式例如前面的 Tool Calling 或者 MCP
3.3 Agent 和工作流
工作流由开发人员构建,流程固定,受模型输出的影响小,自主性低,一旦一个节点出错会影响整个流程的进行;Agent 由 LLM 驱动,流程也是由 LLM 确定的,灵活性相对高得多,并且具有主动性、学习性等工作流不具备的特点,一方面带来了更高的适应性和容错性,另一方面受 LLM 的影响很大
实际上两者经常结合在一起,在 Agent 中融入工作流来限制 LLM 的灵活性
3.4 Agent 设计模式
3.4.1 ReAct 模式
先来看两种比较极端的方式
Reasoning Only,只进行推理,不进行工具调用。这意味着答案只来自于 AI 自己对某件事的认知,极大的受到幻觉的影响
Action Only,只进行工具调用,不进行推理。虽然说获取到的是外部真实的信息,但是这种方式本质上是对结果的堆砌,并且容易产生自相矛盾的结果。比如 "我现在发烧 39.3℃ 能去健身房吗?推荐什么动作?",那么 Action Only 的模式可能会产生 "发烧 39.3℃一定要在家里卧床休息。为你推荐卧推、深蹲等动作。"
那么将两种结合起来,就是常说的 React 模式,用下面的图来表示:
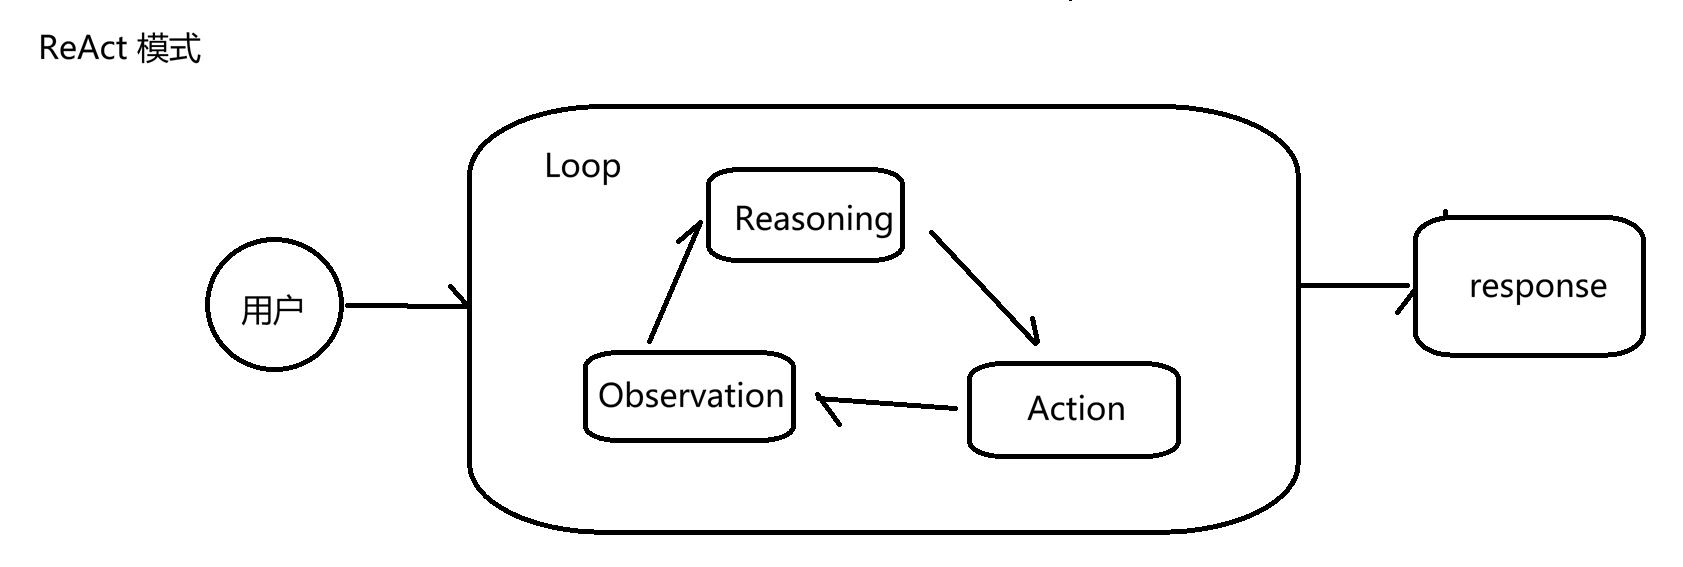
其中:
Reasoning,为推理,负责思考问题并规划下一步的行动Action,根据上一步推理结果,进行实际的工具调用Observation,对上一步工具调用获取到的信息进行整理总结,为下一轮的思考提供新的输入内容
ReAct 模式保证了内容的可信度,极大降低了模型的幻觉,并且能够不断自我改进、完善思考过程;但是缺点也很明显:
- 频繁的工具调用,可能会消耗大量 Token
- 可能会陷入死循环,不断的修改
- Action 操作获得的结果可能会导致整个循环偏离用户最初的问题方向
- 时间消耗大,难以并行化处理任务
出于上面的原因,几乎不会有 Agent 直接使用 ReAct,但是工具调用的属性使得 ReAct 经常出现在其他设计模式的子环节
3.4.2 Planner&Executor
Planner&Executor 弥补了 ReAct 模式的缺点。整体分为两个部分:
- Planner,负责将任务切分为若干的子任务,并指明每个任务的目标
- Executor,负责执行这些任务
用流程图表示的话,就是这样:
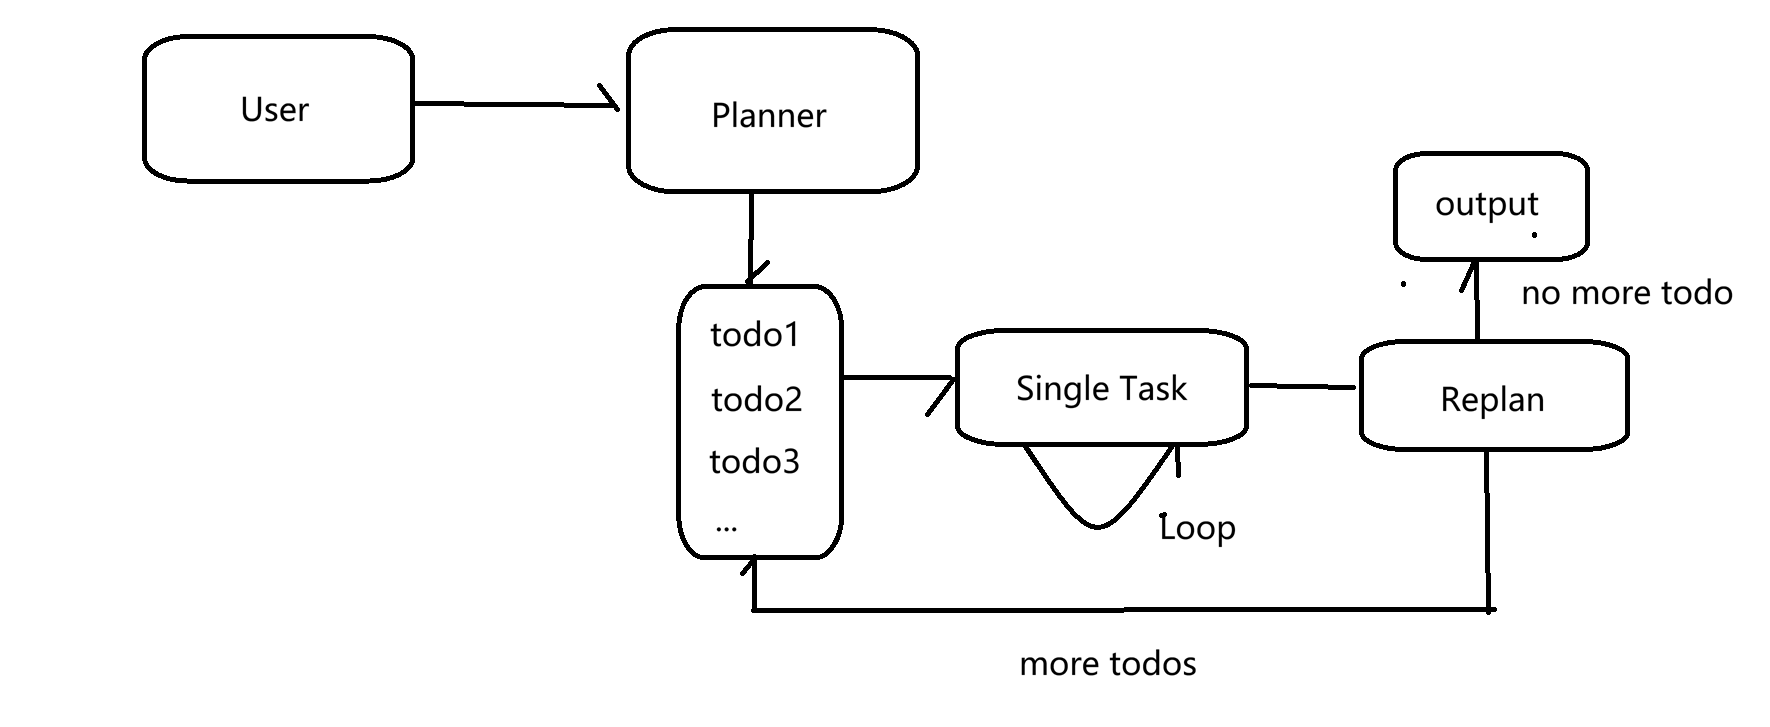
- Planner,根据用户输入划分出若干任务
- 这里每个任务的执行,如果没有依赖关系的话,是可以并行执行的,每个任务可以通过 ReAct 的方式去执行。
- 一个任务执行完后,Planner 进行重新规划,如果需要的话,添加新的任务到需要完成的任务中
- 如果所有任务都完成了,那么输出最后结果
从过程来看,Planner&Executor 好像弥补了 ReAct 的缺点,但事实上它也有自己新的缺点:
- 异常分支处理能力弱。虽然可以通过结合 ReAct 的方式进行优化,但是并不能保证输出内容不出异常,并且因为计划是由 Planner 提前规划好的,导致异常信息会直接作为有效内容被考虑进后续的任务规划中
- 因为计划是提前规划好的,所以并不适合探索性任务这种以结果为导向的任务
3.4.3 Reflection 模式
这里的 Reflection 指的是反思,即生成一份结果后,由同一个或其他 AI 来对结果进行评判并提出改进建议,以此重复直到生成合乎标准的结果。
用流程图演示如下:
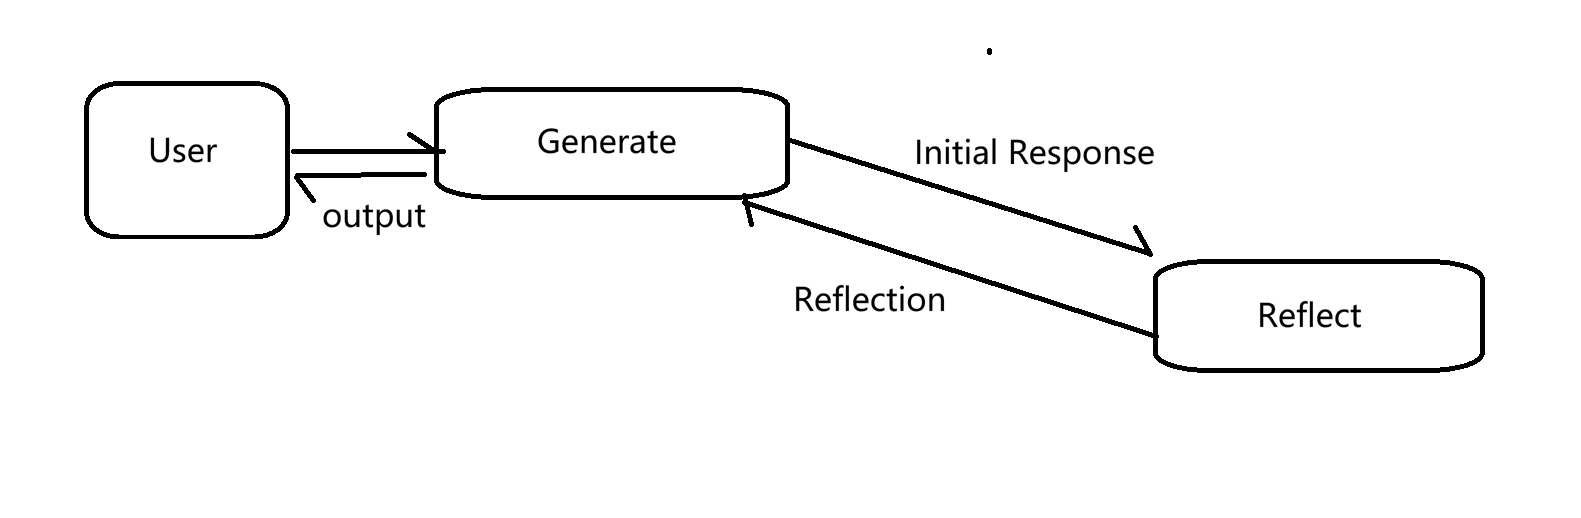
这种博弈性的设计,使得生成结果的质量很高,但是也有自己的缺点:
- 负责做出反思的一方,依赖模型的能力,比如处理数学问题时,让一个不擅长数学的模型完成反思就会收效甚微
- 可能会吹毛求疵的修改细节,导致不自然的结果或者陷入较长时间的循环
- 可能会消耗更多的 Token,没有将 Tool Calling 加入进设计,对于新信息的获取能力有限
3.5 Agent 通信机制
MCP 解决 Agent ↔ 工具,A2A 与 ANP 解决 Agent ↔ Agent。
3.5.1 A2A
企业级任务委派协议,C/S 模式。核心是 Task 状态机:通过 Agent Card 发现能力后,客户端向远端委派任务,远端返回 Artifact。
3.5.2 ANP
开放互联网的去中心化对等协议,三层:DID 身份与加密通信 → 元协议协商 → 能力描述与发现。
四、HITL
4.1 何为 HITL
Human In The Loop,是人工介入机制,主要出于以下原因:
- 风险性决策:如删库、删表,push 代码,发送文件或执行其他操作
- 道德问题:LLM 的人设主要来源于预训练基座、后训练对齐、系统提示词、对话上下文等,简而言之 LLM 并没有和人一样的道德观念
- 创造性任务:需要由用户确定质量和方向是否符合要求
- 法律问题:目前的法律不会让 AI 生成错误内容导致严重后果时,让 AI 承担责任,而是由开发者
但是,HITL,并不是"事事确认",而是"精准介入"
4.2 HITL 核心机制
- 用户输入
- Agent 思考处理,LLM 思考是否需要人工介入
- 如果需要人工介入,那么断点触发,所有任务暂停,保存现场
- 人工介入后,恢复现场继续任务执行
五、Skill
5.1 Skill 组成
简单来说,Skill = SKILL.md + 文件夹,包含了对 Agent 的完整的行为指导和工作链路,更详细的文件结构:
shell
skill/
├── SKILL.md            # 必需,唯一入口(YAML frontmatter + Markdown 正文)
├── scripts/            # 可选:需要精确执行的脚本,比如 Python、Bash、Node.js
├── references/         # 可选:长文档,这样参考文档不需要加入 SKILL.md,并且可以提供足够的参考资料
├── assets/             # 可选:模板、图片等被复制使用的文件
└── ...                 # 其他文件、资源
5.2 SKILL.md
SKILL.md 包含了 Skill 元信息和指令,元信息主要包括:
- name,Skill 名称,最长 64 个字符,组成只能是小写字母、数字和
-,并且不能以-开头或结尾 - description,Skill 描述,包括使用场景与规则说明,最长 1024 个字符
除了这两个必须字段,还包括以下非必须字段:
- license,Skill 许可证信息
- compatibility,Skill 兼容性信息
- metadata,其他自定义键值对,比如作者信息
- allowed-tools,允许使用的工具列表
- https://github.com/anthropics/skills/tree/main/skills,推荐 Anthropic 的 Skills
- 另一个推荐的 skill 就是 playwright-cli,能够直接操作浏览器。安装:
shellnpm install playwright-cli -g playwright-cli install --skills
5.3 Skill 作用
- 按需取用,减少 Token 消耗,节省上下文窗口
- 提供可靠的固化经验
- 隔离各个 Skill,防止改一个乱一套
- 只要有 SKILL.md 和所需文件,就可以实现 Skill 的无缝迁移
5.4 渐进式披露
如果直接一整个 SKILL.md 塞到上下文窗口中,那么上下文窗口很容易溢出并且 Token 消耗量很大。所谓渐进式披露,就是采取了"用多少读多少的思想",渐进式披露可以分为下面的步骤:
- Agent 启动时到相应目录加载 Skill,此时只会读取 SKILL.md 头部的属性信息,包括 name、description,这样最后拿在手里的就是一份所有 Skill 的简短列表,不会造成很大的 Token 消耗
- 在后面的优化步骤中,Agent 会根据用户需求结合 description 判断是否需要调用 Skill
- 如果需要的话,Agent 会去读取完整的 SKILL.md 文件,并按照其中指引去执行 scripts 中的脚本、读取 references 中的文件以及 assets 中的静态资源等,依然是用多少读多少
5.5 编写原则
- description,由渐进式披露不难发现,description 决定了 Agent 何时调用 Skill,因此 description 应当清晰明了的概括 Skill 的使用场景与功能
- SKILL.md 正文应当简洁干练,不要堆砌无意义或者 Agent 已经知道的功能。在调用 Skill 时,会将整篇 SKILL.md 加载,因此需要引用的长篇文档应该直接放在 references 目录下,尽量不要超过 500 行
- 不断打磨,SKILL.md 本质上还是要靠模型来读取生效的,因此换用不同的模型可能会产生不同的效果
- 对于复杂任务、关键性步骤,可以增加检查,如果符合要求了,再继续下一步的生成过程
- 逻辑分块清晰,脚本、参考资料等按需加载
六、向量查询算法 KNN、IVF、HNSW
要解决的问题只有一个:从海量向量中,快速找到与查询向量最相似的 K 个。三者是同一条演进路线上的三种答案。
6.1 KNN(暴力检索)
把查询向量和库里的每一个向量都算一遍距离,排序后取最近的 K 个。
- 思想:不挑不拣,全量扫描
- 特点:结果最准,但每来一个查询都要全算一遍,数据量越大越慢,是所有算法的基线
6.2 IVF(聚类分桶)
入库时先用 k-means 把向量聚成若干个簇;查询时先找最近的几个簇,只在这几个簇内部计算距离。
- 思想:先选区域,再细找,用"少算"换速度
- 特点:速度快,但簇边界附近的向量可能被漏掉;搜索的簇越多越准、越慢,是一个可调的精度与速度旋钮
6.3 HNSW(分层导航小世界)
HNSW 是 ANN 的一种实现方式,通过精度换取速度。给向量建多层近邻图:上层节点少、连接远,负责快速跳跃到目标区域;下层节点密、连接近,负责精确定位。查询时从最顶层贪心走向更近的邻居,逐层下降到底层。
- 思想:图上导航,先走"高速路"再走"小路",类似跳表;或者可以从 B+ 树的方式理解,上层是稀疏索引,最下层是真正用来存储数据的稠密索引
- 特点:查询快、召回高;代价是图占内存大、构建慢