目录
一.Elasticsearch介绍_全文检索
Elasticsearch是一个全文检索服务器。
全文检索是一种非结构化数据的搜索方式
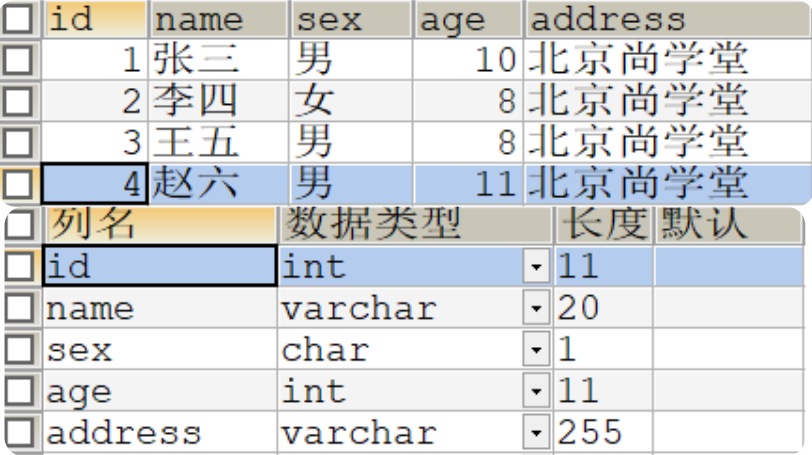
- 结构化数据:指具有固定格式固定长度的数据,如数据库中的字段。
- 非结构化数据:指格式和长度不固定的数据,如电商网站的商品详情。
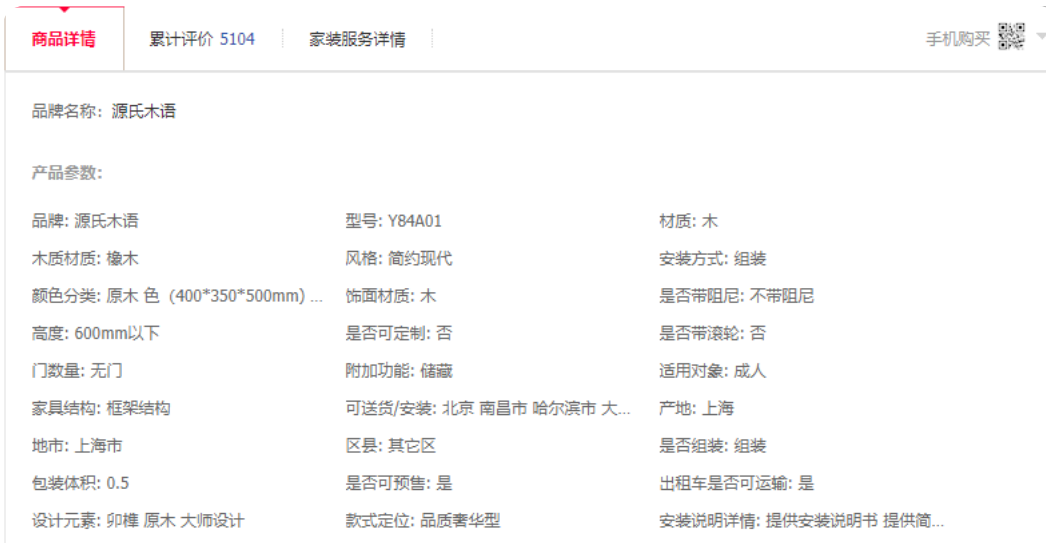
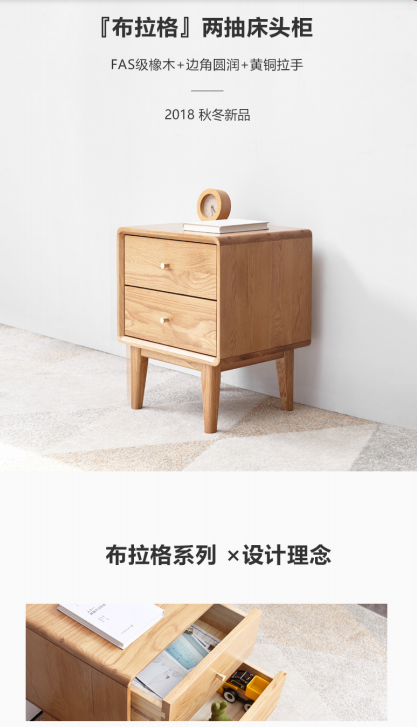
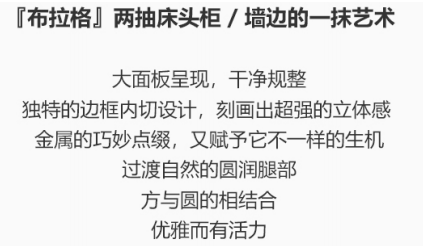
结构化数据一般存入数据库,使用 sql 语句即可快速查询。但由于非结构化数据的数据量大且格式不固定,我们需要采用全文检索的方式进行搜索。全文检索通过建立倒排索引 加快搜索效率。
二.Elasticsearch介绍_正排索引&倒排索引
索引
将数据中的一部分信息提取出来,重新组织成一定的数据结构,我们可以根据该结构进行快速搜索,这样的结构称之为索引。
索引即目录,例如字典会将字的拼音提取出来做成目录,通过目录即可快速找到字的位置。
索引分为 正排索引 和 倒排索引 。
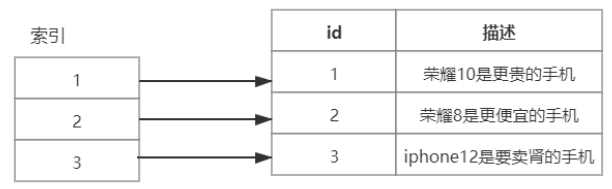
正排索引(正向索引)
将文档 id 建立为索引,通过 id 快速可以快速查找数据。如数据库中的主键就会创建正排索引。
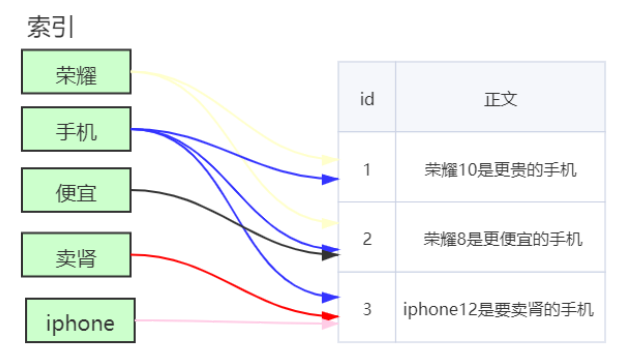
倒排索引(反向索引)
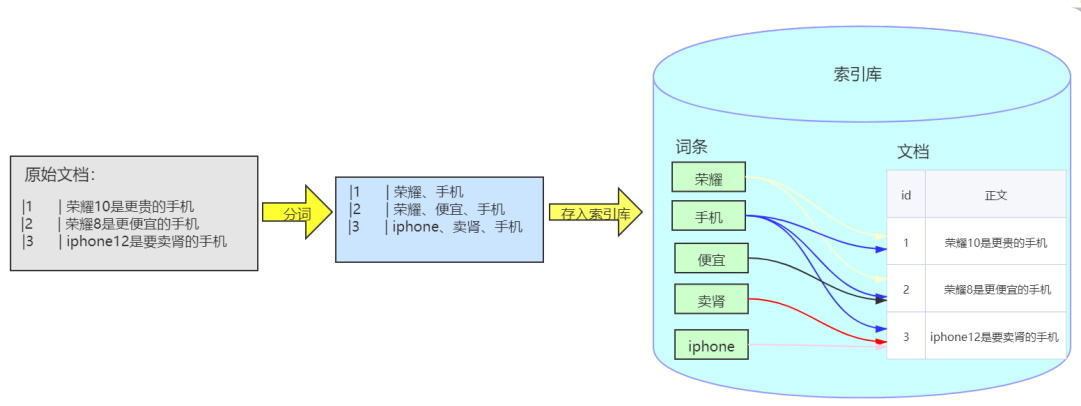
非结构化数据中我们往往会根据关键词查询数据。此时我们将数据中的关键词建立为索引,指向文档数据,这样的索引称为倒排索引。
创建倒排索引流程:
三.Elasticsearch的出现
多年前,一个刚结婚的名叫 Shay 的失业开发者,跟着妻子去了伦敦,他的妻子在那里学习厨师。Shay 使用全文检索工具 ------lucene,给他的妻子做一个食谱搜索引擎。
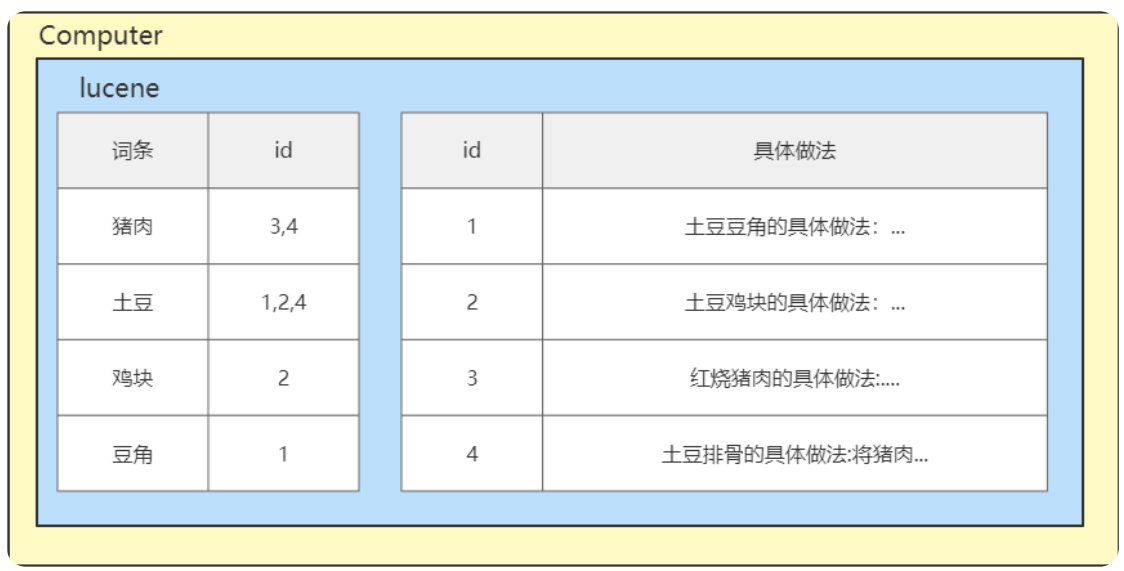
但 Lucene 的操作非常复杂,且 Lucene 是一个单机软件,不支持联网访问。因此 Shay 基于 Lucene 开发了开源项目 Elasticsearch 。Elasticsearch本质是一个 java 语言开发的 web 项目,我们可以通过
RESTful 风格的接口访问该项目内部的 Lucene ,从而让全文搜索变得简单。
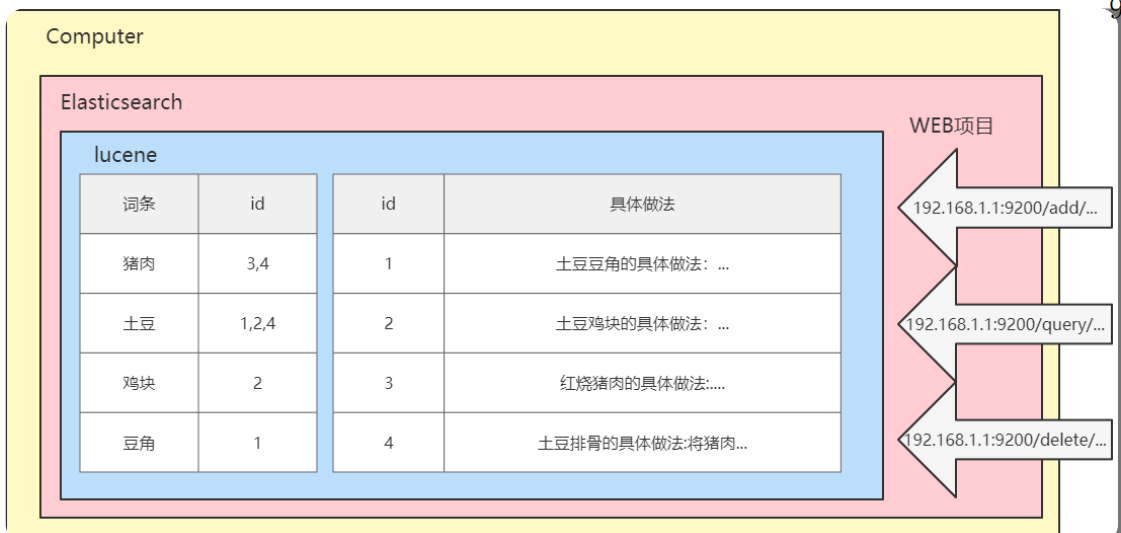
从此以后, Elasticsearch 成为了 Github 上最活跃的项目之一,Elastic公司围绕 Elasticsearch 提供商业服务,并开发新的特性。Elasticsearch将永远开源并对所有人可用。
四.Elasticsearch应用场景
- 2013年初,GitHub抛弃了Solr,采取Elasticsearch来做PB级的搜索。GitHub使用Elasticsearch搜索20TB 的数据,包括13亿文件和1300亿行代码。
- 维基百科:以Elasticsearch为基础的核心搜索架构。
- 百度:百度目前广泛使用Elasticsearch作为文本数据分析,采集百度所有服务器上的各类指标数据及用户自定义数据。目前覆盖百度内部20多个业务线(包括casio、云分析、网盟、预测、文库、直达号、钱包、风控等),单集群最大100台机器,200个ES节点,每天导入30TB+数据
- 新浪使用ES分析处理32亿条实时日志。
- 阿里使用ES构建自己的日志采集和分析体系。
- 我们可以使用Elasticsearch实现全站搜索,线上商城系统的搜索,分析日志等功能。
最常见的一个例子,就是购物网站的商品搜索栏,就是用的es。
五.Elasticsearch对比Solr
Solr 也是基于 Lucene 的一款全文搜索引擎,下面是他们的对比。
- Solr利用Zookeeper进行分布式管理,而Elasticsearch自身带有分布式协调管理功能;
- Solr支持更多格式的数据,而Elasticsearch仅支持json文件格式;
- Solr官方提供的功能更多,而Elasticsearch本身更注重于核心功能,高级功能多由第三方插件提供;
- Solr在传统的搜索应用中表现好于Elasticsearch,但在处理实时搜索应用时效率明显低于 Elasticsearch。
目前 Elasticsearch 的市场占有率越来越高, Spring 从 2020 年起也已经停止Spring Data Solr 的维护,更多的公司使用 Elasticsearch 作为搜索引擎。
六.Elasticsearch数据结构
文档( Document ):文档是可被查询的最小数据单元,一个Document 就是一条数据。类似于关系型数据库中的记录的概念。
类型( Type ):具有一组共同字段的文档定义成一个类型,类似于关系型数据库中的数据表的概念。
索引( Index ):索引是多种类型文档的集合,类似于关系型数据库中的库的概念。
域( Filed ):文档由多个域组成,类似于关系型数据库中的字段的概念。
Elasticsearch 跟关系型数据库中概念的对比:
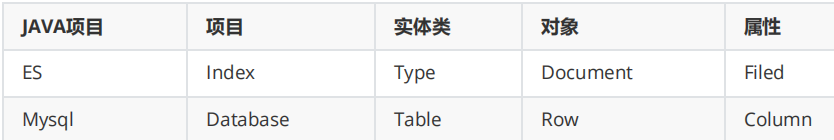
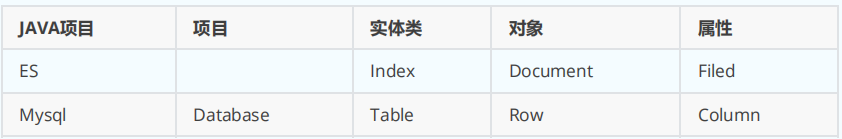
注:ES7.X之后删除了type的概念!!!一个索引不会代表一个库,而是代表一张表。我们课程中使用ES8,所以目前的ES中概念对比为:
七.Elasticsearch安装
先换个源吧,换成阿里源,因为centOS7 官方已经停止维护,默认源会报错,安装一些东西时都会报错,所以换成阿里镜像源。
下载阿里源配置文 件
curl -o /etc/yum.repos.d/CentOS-Base.repo https://mirrors.aliyun.com/repo/Centos-7.repo
清理旧缓存,生成新缓存
yum clean all
yum makecache
出现 Metadata cache created 代表换源成功。
然后就能正常下载了,比如安装vim,yum install vim -y
1.安装ES服务
-
准备一台搭载有CentOS7系统的虚拟机,使用XShell连接虚拟机
ip addr查看ens33的IP地址 -
关闭防火墙,方便访问ES
关闭防火墙 systemctl stop firewalld.service
禁止防火墙自启动:
systemctl disable firewalld.service -
配置最大可创建文件数大小
打开系统文件:
vim /etc/sysctl.conf
添加以下配置:
vm .max_map_count = 655360
然后 :wq 保存退出。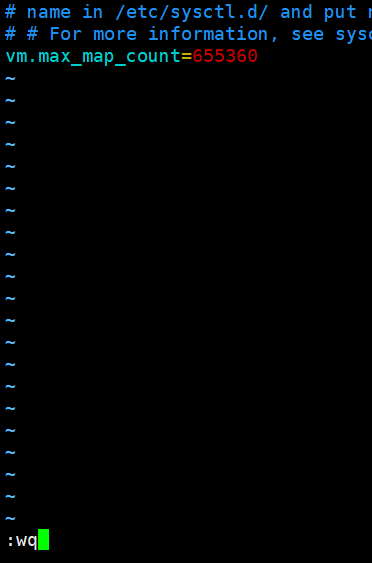
配置生效:
sysctl -p -
由于ES不能以root用户运行,我们需要创建一个非root用户,此处创建一个名为es的用户:
创建用户:
useradd es
使用 rz 命令将 linux 版的 ES 上传至虚拟机
命令行输入rz从电脑里上传文件到centOS7里。
如果传输速率一直为0,那么可能是如下原因:
rz命令不是 Linux 自带,只是一个命令名,如果没装包,执行rz后,Xshell 弹窗,但 Linux 端没有 Zmodem 接收程序,双方握手失败,一直 0 速度。
安装即可:
yum install -y lrzsz
2 解压ES
tar -zxvf elasticsearch-9.5.3-linux-x86_64.tar.gz重命名:
mv elasticsearch-9.5.3 elasticsearch1移动文件夹:
mv elasticsearch1 /usr/local/
es用户取得该文件夹权限:为es分组下的es用户分配权限
chown -R es:es /usr/local/elasticsearch1
启动 ES 服务:
#切换为es用户(一定要切换为普通用户!!!!!!!!!ES 从 5 版本起强制禁止 root 账号运行,你现在如果是 root 用户执行
./elasticsearch,直接退出码 1。 ):
su es进入 ES 安装文件夹:
cd /usr/local/elasticsearch1/bin/
启动 ES 服务:
./elasticsearch
当启动成功,可以看到类似以下的日志输出。首次启动Elasticsearch,默认会启用安全配置功能,启用身份认证和授权,内置超级用户 elastic ,并生成默认密码,此时要注意保存,否则之后启动不会再显示。
bug解决: 启动失败,查看日志是机器学习库的原因
报错根源
org.elasticsearch.ElasticsearchException: Failure running machine learning native code. This could be due to running on an unsupported OS or distribution, missing OS libraries, or a problem with the temp directory. To bypass this problem by running Elasticsearch without machine learning functionality set [xpack.ml.enabled: false].一句话总结:ES9.5.3 内置的 X-Pack 机器学习模块,需要原生 C++ 库,精简版 CentOS7 缺少依赖,ML 模块启动直接崩溃,整个 ES 跟着退出。
日志提示的解决方案很明确:关闭机器学习功能
xpack.ml.enabled: false,单机测试环境完全不需要 ML。操作步骤
编辑 es 配置文件
vim /usr/local/elasticsearch1/config/elasticsearch.yml
在文件末尾追加这一行:
xpack.ml.enabled: false
注意 yml 语法:冒号后面必须有空格
- 保存退出(vim:
Esc→:wq回车)
补充说明(精简 CentOS7 坑)
- Elasticsearch 9.x 的 ML 原生库对系统依赖要求很高,最小化 CentOS7 缺少相关 glibc 版本 / 系统库,很难补全。单机学习环境直接关闭 ML 是最简单稳妥方案。
启动成功之后会有如下的一些信息:
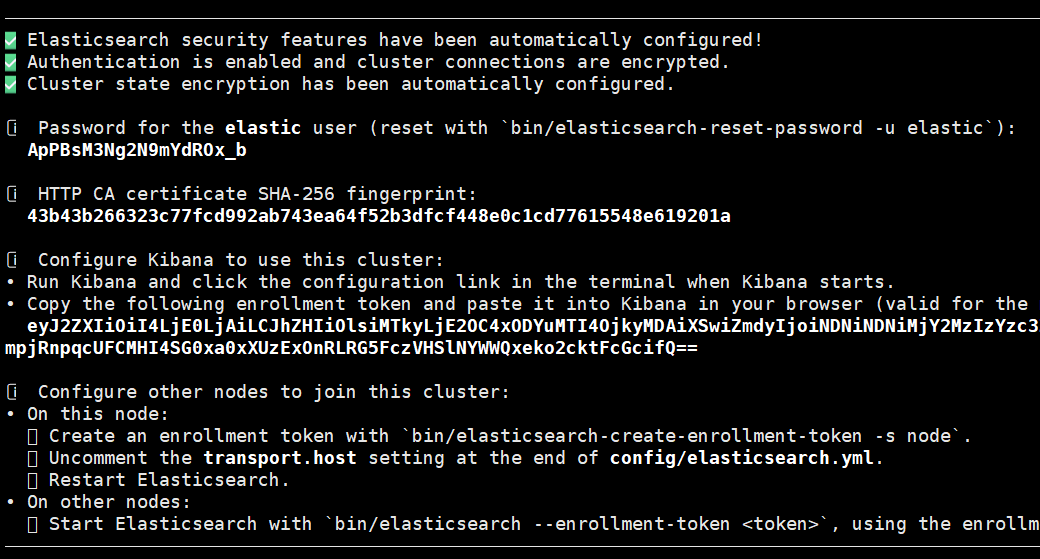
记得把这几个密码都保存,因为只有第一次启动成功才会显示。执行下面的操作时,es必须是运行状态!
启动es后窗口的状态会如下显示:
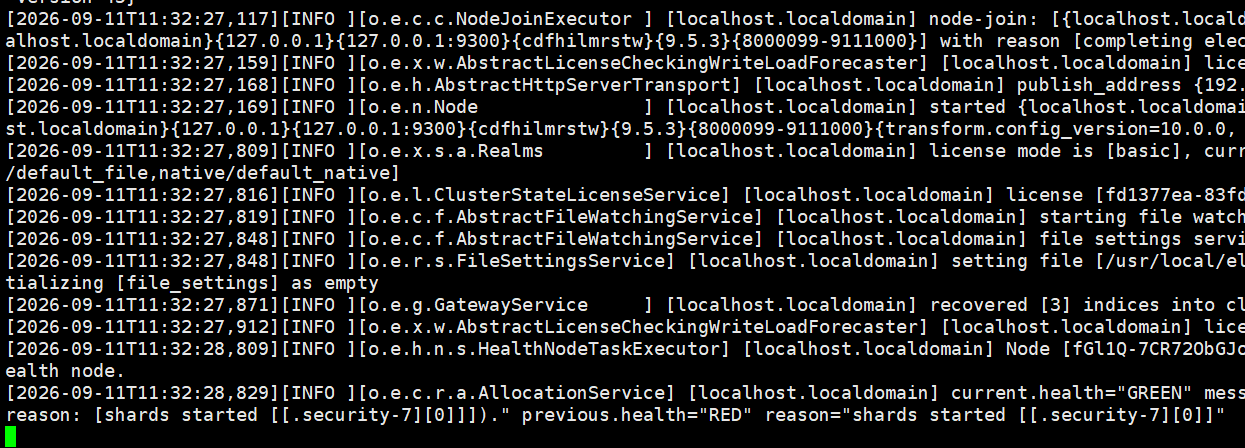
当前这个窗口就是 ES 服务本体,必须保持窗口开着;操作命令在新 Xshell 窗口里敲。
重置默认密码:
cd /usr/local/elasticsearch1/bin/
./elasticsearch-reset-password -u elastic自定义密码:
cd /usr/local/elasticsearch1/bin/
./elasticsearch-reset-password --username elastic -i
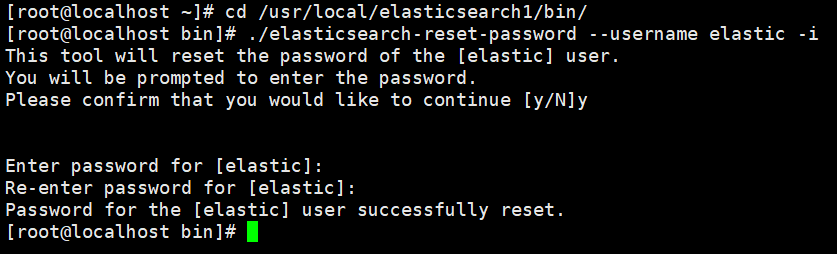
2.安装kibana
Kibana 是一款开源的数据分析和可视化平台,设计用于和Elasticsearch协作。我们可以使用 Kibana 对 Elasticsearch 索引中的数据进行搜索、查看、交互操作。
注意!Kibana的版本和es的版本必须一致!
使用 rz 工具将 Kibana 压缩文件上传到 Linux 虚拟机
2
解压(解压到/usr/local/目录下)
tar -zxvf kibana-8.10.4-linux-x86_64.tar.gz -C /usr/local/
修改配置
进入 Kibana 解压路径
cd /usr/local/kibana-8.10.4/config
修改配置文件
vim kibana.yml
加入以下内容
主机 IP ,服务名
server.host: " 虚拟机 IP"
server.name: "kibana"
启动:
kibana 不能以 root 用户运行,我们给 es 用户设置 kibana 目录的权限,并使用es 用户运行 kibana给 es 用户设置 kibana 目录权限
chown -R es:es /usr/local/kibana-8.10.4/
切换为 es 用户
su es
启动 kibana
cd /usr/local/kibana-8.10.4/bin/
./kibana
在浏览器输入地址,连接elasticsearch成功!
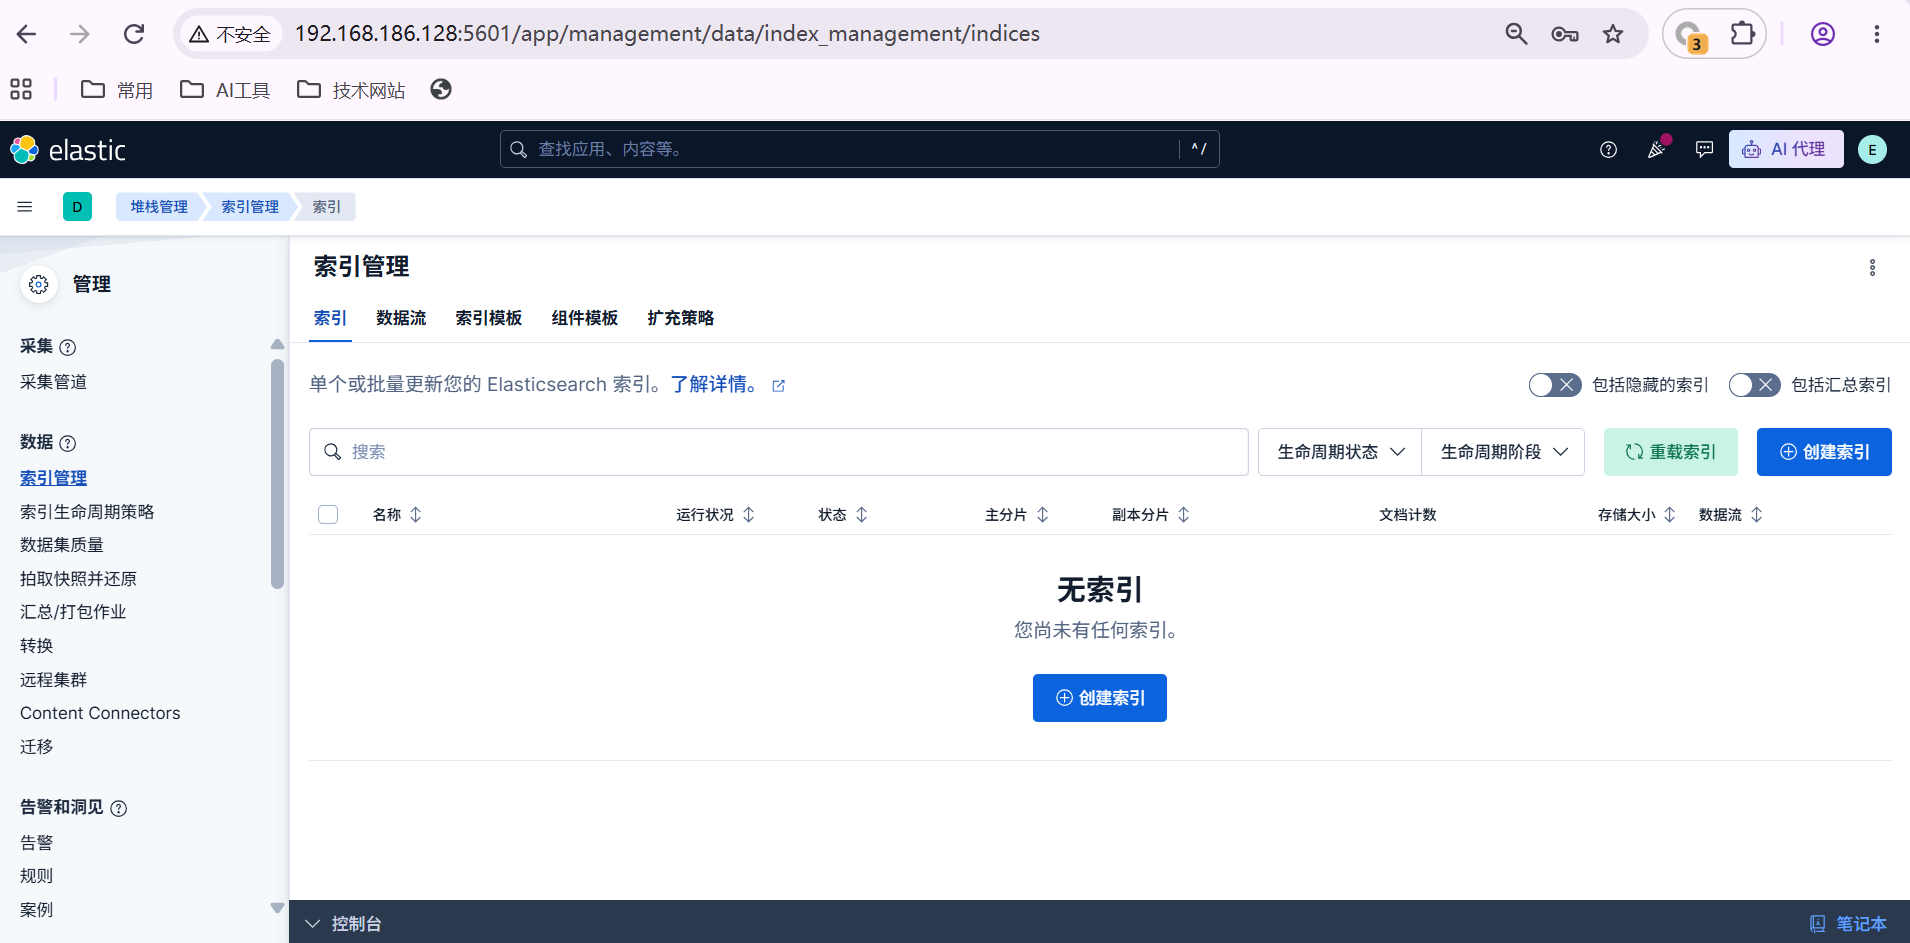
访问 kibana : http:// 虚拟机 IP:5601
首次访问 Kibana 管理台会提示输入 ES 生成的 token 秘钥,可以在ES首次启动日志中找。
如果 token 已失效或不正确,你也可以重新生成 token 。
进入 es 安装目录
cd /usr/local/elasticsearch1/bin
重新生成 kibana 的 token
./elasticsearch-create-enrollment-token --scope kibana
紧接着输入登录账号 elastic ,密码也同样是从 ES 首次启动日志中找。
点击 Management => Index Management 可以查看es 索引信息。
八.Elasticsearch常用操作
1.索引操作
Elasticsearch 是使用 RESTful 风格的 http 请求访问操作的,请求参数和返回值都是Json 格式的,我们可以使用 kibana 发送 http 请求操作ES。
创建没有结构的索引
路径: ip 地址 : 端口号 / 索引名
注:在 kibana 中所有的请求都会省略 ip地址:端口号 ,之后的路径我们省略写 ip地址:端口号
请求方式:PUT
为索引添加结构
点一下左上角的菜单栏
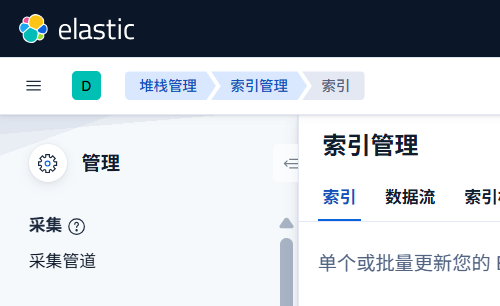
找到management,选开发工具
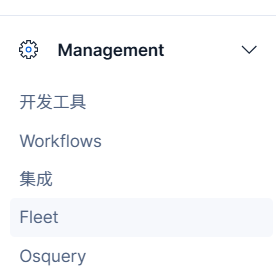
在控制台输入如下,创建一个新索引student
bash
PUT /student点击菜单栏,找到management,选择stack management,再选索引管理,就可以看到一个创建好的索引,
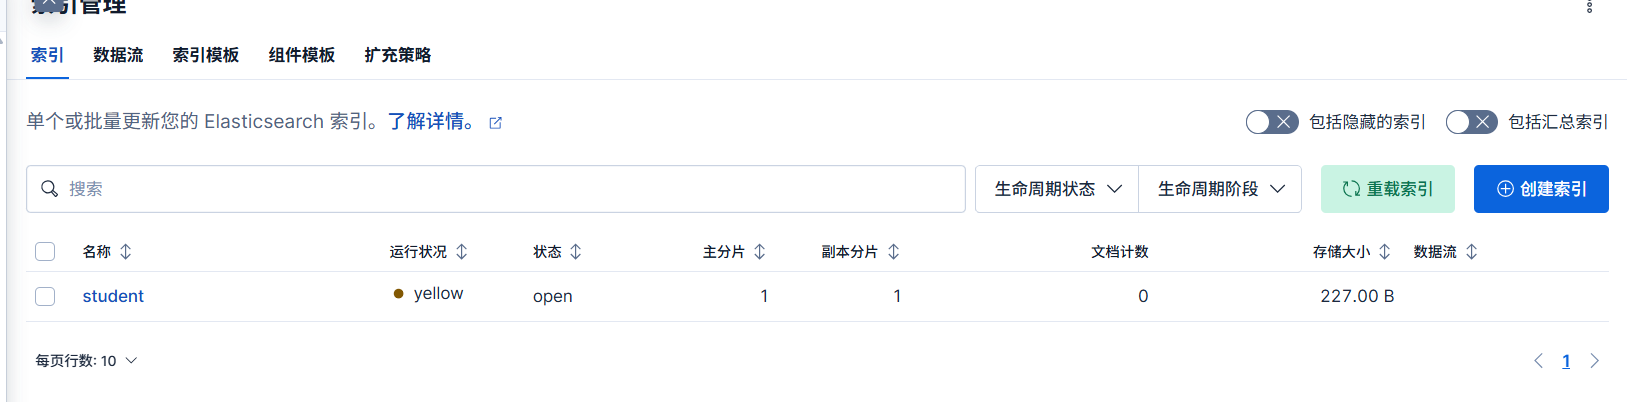
接下来给索引设置索引结构
注意写对类型拼写方式
bash
POST /student/_mapping
{
    "properties":{
        "id":{
            "type":"integer"
        },
        "name":{
            "type":"text"
        },
        "age":{
            "type":"integer"
        }
    }
}
按上面的方法找到索引,点击索引,然后点映射,显示你索引的结构如下:
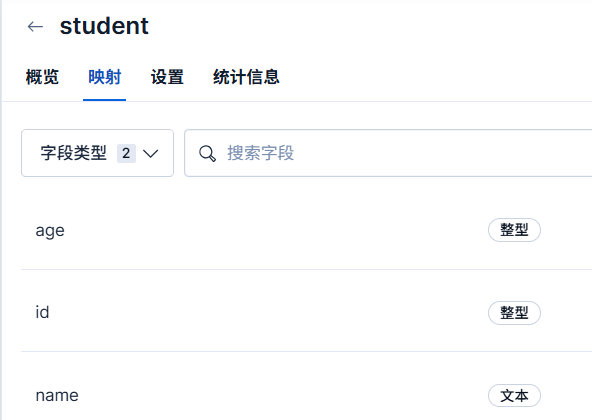
也可以创建索引同时添加结构
bash
PUT /student1
{
  "mappings": {
    "properties": {
      "id": {
        "type": "integer"
      },
      "name": {
        "type": "text"
      },
      "age": {
        "type": "integer"
      }
    }
  }
}
2.文档操作
新增 / 修改文档
bash
PosT /索引/_doc/[id值]
{
    "fie1d名 ": field值
}
注:id值不写时自动生成文档id,id和已有id重复时修改文档。这里的id代表的是文档的唯一标识!
field里如果写个id,那么这里面的id只是个普通的域。
根据 id 查询文档
bash
GET /索引/_doc/id值先新增几个
bash
POST student/_doc/1
{
    "id":1,
    "name":"xiaoming",
    "age":10
}
新增一个文档,唯一标识为1
bash
POST student/_doc/
{
    "id":2,
    "name":"Hong",
    "age":23
}
新增一个文档,自动生成id
从输出信息里可以看到自动生成的id
bash
{
  "_index": "student",
  "_id": "YWE-sqABAmp-Hk9k80hy",
  "_version": 1,
  "result": "created",
  "_shards": {
    "total": 2,
    "successful": 1,
    "failed": 0
  },
  "_seq_no": 2,
  "_primary_term": 2
}
通过唯一id查询:
bash
GET /student/_doc/1

GET /student/_doc/YWE-sqABAmp-Hk9k80hy
删除文档
bash
DELETE /索引/_doc/id值
bash
DELETE /student/_doc/YWE-sqABAmp-Hk9k80hy删完了之后,再查询就是404 not found了。
根据 id 批量查询文档
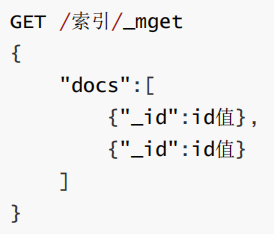
eg:
bash
GET /student/_mget
{
    "docs":[
        {"_id":1},
        {"_id":2}
    ]
}
查询所有文档
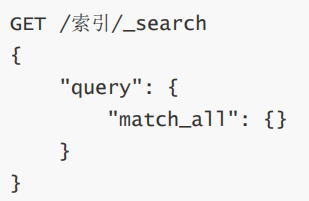
eg:
bash
GET /student/_search
{
    "query":{
        "match_all":{}
    }
}
修改文档部分字段
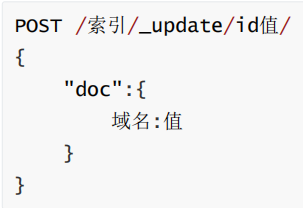
eg:
先查询,再修改,再查询,观察变动
bash
POST /student/_update/1/
{
    "doc":{
        "name":"Wang"
    }
}
注:Elasticsearch 执行删除操作时, ES 先标记文档为 deleted 状态, 而不是直接物理删除。当ES 存储空间不足或工作空闲时,才会执行物理删除操作。
Elasticsearch 执行修改操作时, ES 不会真的修改 Document 中的数据,而是标记ES 中原有的文档为 deleted 状态,再创建一个新的文档来存储数据。
3.域的属性
(1)index
该域是否创建索引。只有值设置为 true ,才能根据该域的关键词查询文档。
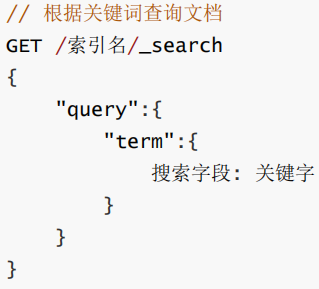
先创建两个索引,一个index设置为true,另一个false
bash
PUT /student1
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "index":true
      }
    }
  }
}

PUT /student2
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "index":false
      }
    }
  }
}
然后往这两个索引里分别添加两条数据
bash
POST /student1/_doc/1
{
    "name":"i love LOL"
}

POST /student2/_doc/1
{
    "name":"i love LOL"
}
然后根据关键字进行查询:
bash
GET /student1/_search
{
    "query":{
        "term":{
            "name": "love"
            }
    }
}

GET /student2/_search
{
    "query":{
        "term":{
            "name": "love"
            }
    }
}
第一个成功,第二个报错。
(2)type
域的类型
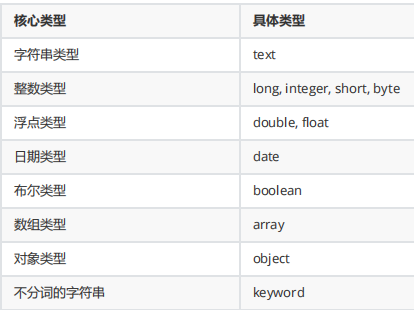
不分词的意思是,比如"i love LOL"不分词的话是一个整体,无法通过单独的某个词比如love查到。这种类型一般用于手机号,身份证,这种信息分开的话没有意义。
eg:
bash
DELETE /student2

PUT /student2
{
  "mappings": {
    "properties": {
      "name": {
        "type": "keyword",
        "index":true
      }
    }
  }
}

POST /student2/_doc/1
{
    "name":"i love LOL"
}

GET /student2/_search
{
  "query": {
    "term": {
      "name": "love"
    }
  }
}

GET /student2/_search
{
  "query": {
    "term": {
      "name": "i love LOL"
    }
  }
}
(3)store
是否单独存储。如果设置为 true ,则该域能够单独查询。
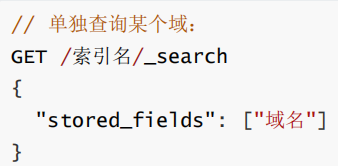
eg:
bash
DELETE /student1
DELETE /student2

PUT /student1
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "index":true,
        "store": true
      },
      "age":{
        "type": "integer"
      }
    }
  }
}

PUT /student2
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "index":true,
        "store": false
      },
      "age":{
        "type": "integer"
      }
    }
  }
}

POST /student1/_doc/1
{
    "name":"i love LOL",
    "age":10
}

POST /student2/_doc/1
{
    "name":"i love NBA",
    "age":15
}

GET /student1/_search
{
    "stored_fields": ["name"]
}

GET /student2/_search
{
    "stored_fields": ["name"]
}
student1的能查出来,而student2的查不出来。