在完成多通道气路时序样本的构建后,智能体面临的核心任务是从这些高维时序矩阵中提取出具备高辨识度的退化特征。然而在实际工程场景中,故障样本数量极其稀少且类型多样,如果直接使用传统深度神经网络进行全监督端到端分类训练,模型极易陷入局部过拟合,难以捕捉不同故障模式之间的细微表征差异。在论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》中,针对这一问题设计了专用的特征区分模块。该模块不依赖合成虚拟样本,而是通过"自编码器无监督预训练"与"加权对比学习微调"相结合的两阶段策略,从有限的真实数据中提炼出较为稳健的故障特征。
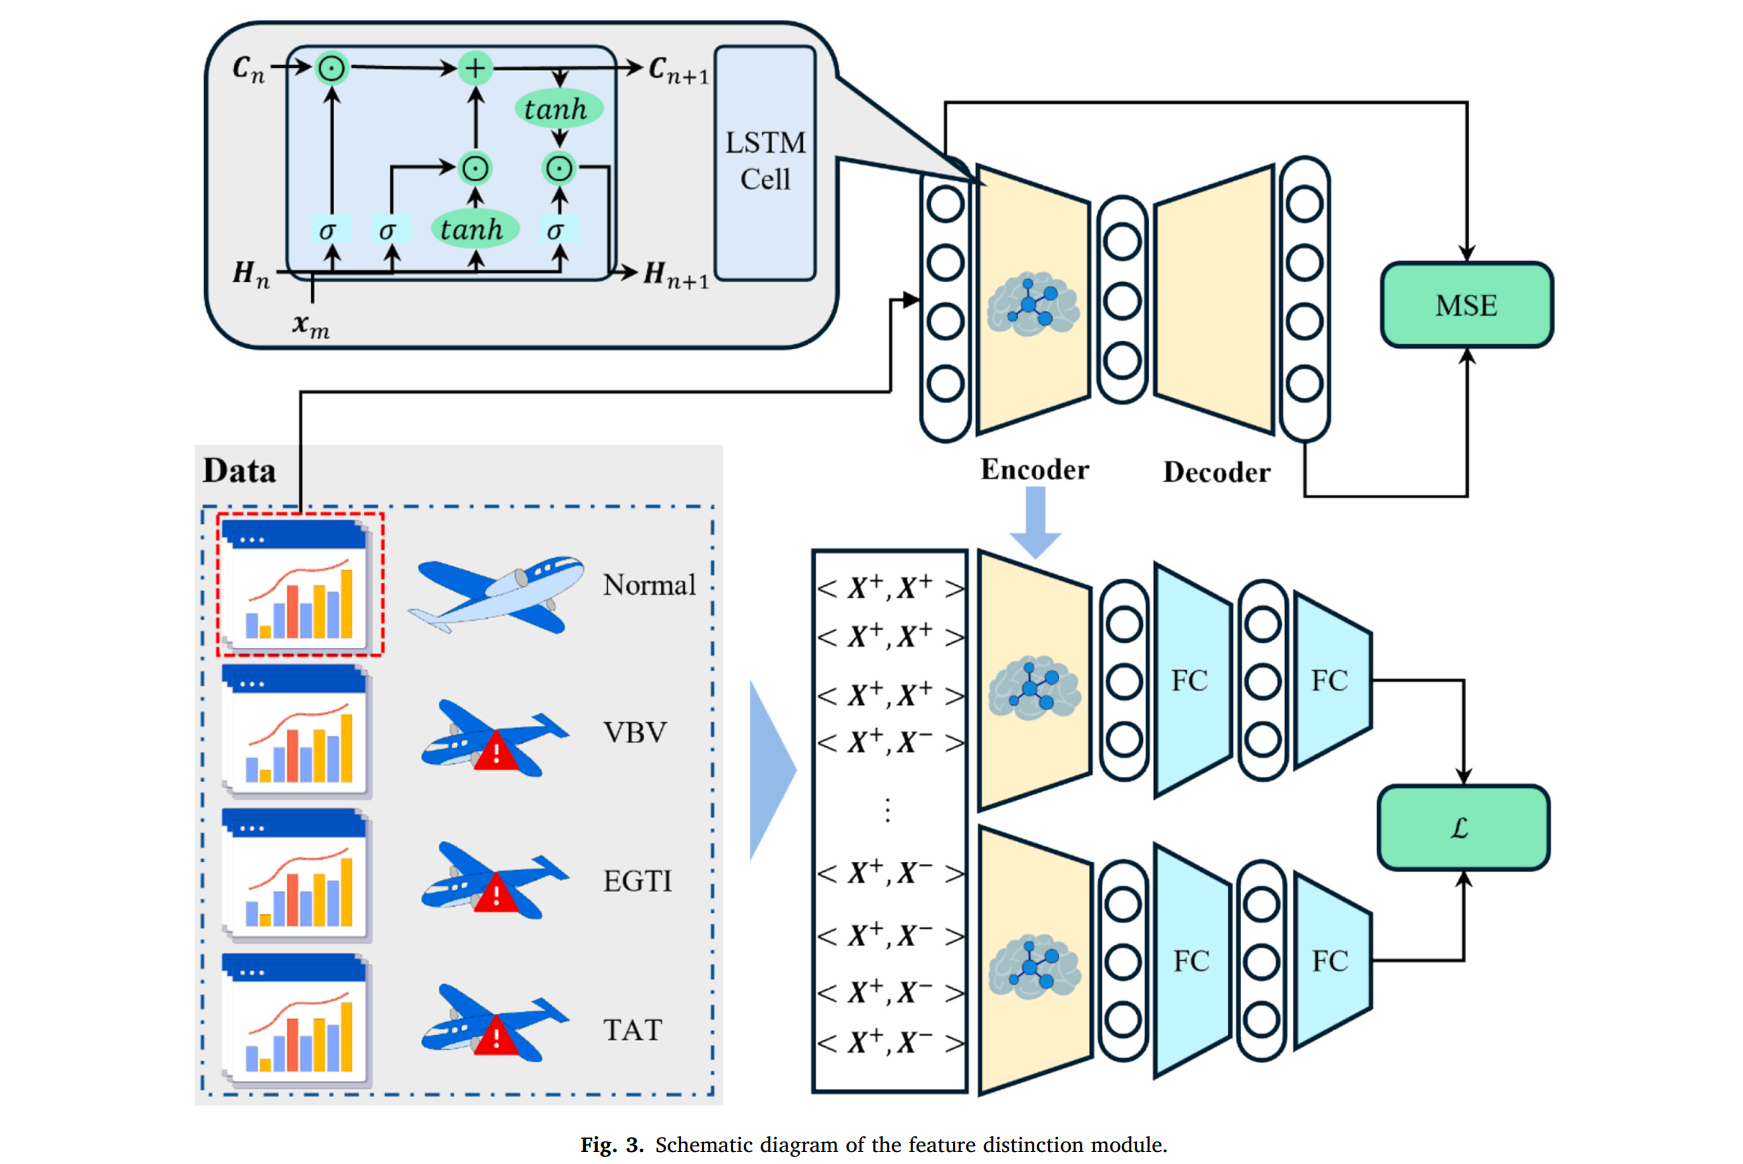
特征提取的第一阶段着眼于充分利用海量的正常运行数据。由于正常飞行工况数据量大且涵盖了发动机在不同运行阶段的基础动态特性,研究构建了一个基于长短期记忆网络的自编码器结构,仅使用正常样本进行重构训练。长短期记忆网络通过内部的门控机制能够有效捕捉飞行数据中连续多航段的前后依赖关系。
在该阶段中,自编码器强制网络将多通道输入时序压缩为低维隐藏状态,并由解码器还原原始序列。通过这种仅依赖正常数据的自监督重建过程,编码器在不接触任何稀缺故障样本的前提下,预先掌握了气路监测参数的基础时序压缩与动态表征能力,在一定程度上避免了模型在初始阶段就向特定故障模式发生偏置。
在完成基础特征压缩能力的构建后,第二阶段引入对比学习机制以拉开不同故障类型在特征空间中的分布边界。在计算机视觉领域,对比学习通常依赖旋转、裁剪等数据增强手段构造正样本对,但在航空发动机时间序列领域,人为扰动容易破坏热力学参数原有的物理相关性。因此,该模块直接利用真实工况数据构建样本对,将同一故障类型的不同真实飞行样本配对作为正样本,将不同故障模式以及正常状态的样本配对作为负样本。这种完全基于真实记录的样本对构建机制,从源头上尽量规避了人工合成数据引入的虚假退化趋势和不确定性。
为了进一步适应发动机时序数据的特点,对比学习阶段采用了定制的加权损失函数与分层微调机制。由于发动机在不同故障状态下仍遵循整体的气路流动规律,不同故障的时序曲线在数值范围上存在重叠。为此,模块在优化目标中对正样本聚集与负样本排斥分别赋予差异化的权重调节,着重增强同类故障特征在隐空间的聚类凝聚力,同时适度约束异类样本之间的过度分离。在训练过程中,预训练编码器采用较低的更新步长进行微调,以保留对基础时序规律的记忆,而新增加的投射层则以正常步长学习类别分离,从而实现了平稳的特征空间重塑。
通过上述两阶段的处理,高维、多通道的气路监测时序被映射为低维且聚类较为紧凑的特征向量,不同故障模式与正常状态之间的表征间隔得到了较好的拉伸。这一特征区分模块为后续的故障决策提供了边界清晰、物理可靠的特征输入。在拥有了高质量的特征表征之后,诊断智能体如何利用这些特征在类别极度不平衡的严苛条件下做出可靠的分类决策,将在下一篇技术博客中针对强化学习决策模块进行深入探讨。
来源文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenariosJ. Advanced Engineering Informatics, 2025, 65( C ): 103297.
https://www.sciencedirect.com/science/article/pii/S1474034625001909