这是 RocketMQ 系列的第一篇。本系列围绕「一条消息的生命周期」这条主线展开:第一篇建立全局地图,之后的文章再逐段放大------发送、存储、消费、特殊消息、可靠性。本文先讲清楚 RocketMQ 由谁组成、为什么这么分工、以及一条消息是怎么跑通的。
一、什么是消息队列
消息队列简称 MQ (Message Queue),它本质上是一个异步中间件 。它的三个核心功能是:异步、解耦、削峰填谷。
1. 异步------提升主流程响应速度
在没有 MQ 的旧系统里,分布式服务之间都是直接相互调用。举个电商下单场景:
- 主服务:订单服务
- 下游:库存、短信、积分、物流、统计
以前的做法是,一个订单的创建/完成需要在一个方法里依次调用所有下游服务。这样的问题很明显:
一是调用链路非常长。 一个请求要穿透库存、短信、积分、物流、统计等多个服务,才能返回。
二是会演化成超长事务。 订单服务在一开始开启了事务,下游一长串调用都挂在这个事务里,数据库连接和锁会被长时间占用,高峰时段直接拖垮性能。
三是不重要的服务也在拖后腿。 像短信、积分这种,其实失败了大不了后面补偿一下,完全没必要让主流程一直等着。
引入 MQ 之后,订单服务完成主流程后,把订单消息丢进 MQ ,然后就可以直接返回了,不用再等那些不重要的下游服务。各下游服务自己去订阅、各自消费。主流程的响应速度大幅提升------这就是异步的价值。
2. 解耦------下游崩溃不影响主服务
还是同步写法的场景:如果某个下游服务崩溃了,整个订单主服务也跟着不能运行。这不合理------总不能因为短信服务挂了,订单都下不了。
有了 MQ,订单服务只需要把消息发到 MQ 就完事。即使短信服务卡住或挂了,订单服务照样正常返回;短信服务几分钟后恢复,再去消费 MQ 里积压的消息补发即可。这就是解耦------上下游之间不再强依赖,通过 MQ 这个「缓冲垫」松耦合。
3. 削峰填谷------扛住瞬时流量洪峰
以 618 秒杀为例:瞬间 10000 请求/秒 来下单,但数据库只能扛 2000 QPS。
- 不用 MQ:一瞬间一万请求直接打向数据库,DB 被压垮,大量报错。
- 用 MQ:秒杀请求先做校验,合法请求生产消息丢入 MQ;消费者控制消费速度,每秒只拉取约 1500 条慢慢落库处理。
瞬时的高峰被 MQ 这个队列存了起来,慢慢消费。请求的「形状」从剧烈的高峰低谷变成了平缓的曲线------这就是削峰填谷。
4. 其他作用
除了三大核心作用,MQ 还支持很多高级特性,比如延迟消息:订单创建后 30 分钟未支付自动关闭、释放库存。下单时发一条 30 分钟的延迟消息,30 分钟后消息才投递,消费端检查订单状态,未支付就关闭。
二、MQ 的高可用要求,以及随之而来的四个问题
从上面的描述不难看出:MQ 本身作为中间件,可用性要求极高。一旦 MQ 宕机,等于所有消息都无法发送,所有下游都拿不到上游的信息。
但同时,引入 MQ 也带来了一组必须面对的问题,这四个问题也是本系列后续文章要逐一解决的:
- 消息丢失:生产者发消息时网络断了,消息没进 MQ,订单消息就丢了。
- 重复消费:消费者业务执行成功,但在提交 offset 前网络断开,触发重试,消息被重复投递。所以像「加积分」这类操作必须做幂等,不能重复加。
- 消息堆积:消费代码里有个慢 SQL,消费速度跟不上生产速度,消息越堆越多。
- 顺序问题:订单状态是「创建 → 支付 → 发货」的。如果消息乱序,消费端先收到「发货」消息,业务就出错了,这时需要顺序消息。
三、RocketMQ 简介
RocketMQ 是由阿里巴巴团队开发、后来捐献给 Apache 基金会并成为顶级项目的分布式消息中间件,纯 Java 实现。它的几个关键特点:
- 高吞吐、低延迟:单机 TPS 可达到十万级别。
- 海量堆积能力 :因为消息是持久化到磁盘的,所以 RocketMQ 可以堆积海量消息(亿级),这是它区别于纯内存队列的显著优势。
- 消息持久化:消息落盘存储,保证消息不丢失。
- 功能丰富:支持顺序消息、延迟消息、事务消息、消息过滤等。
这一系列特点背后,都指向它最核心的设计:把消息可靠地存储在磁盘上。这也是为什么我们后面要专门花一篇文章讲它的存储原理。
四、整体架构:四大组成部分
RocketMQ 主要由四个部分组成:生产者组(Producer)、消息存储(Broker)、注册中心(NameServer)、消费者组(ConsumerGroup)。架构图如下:
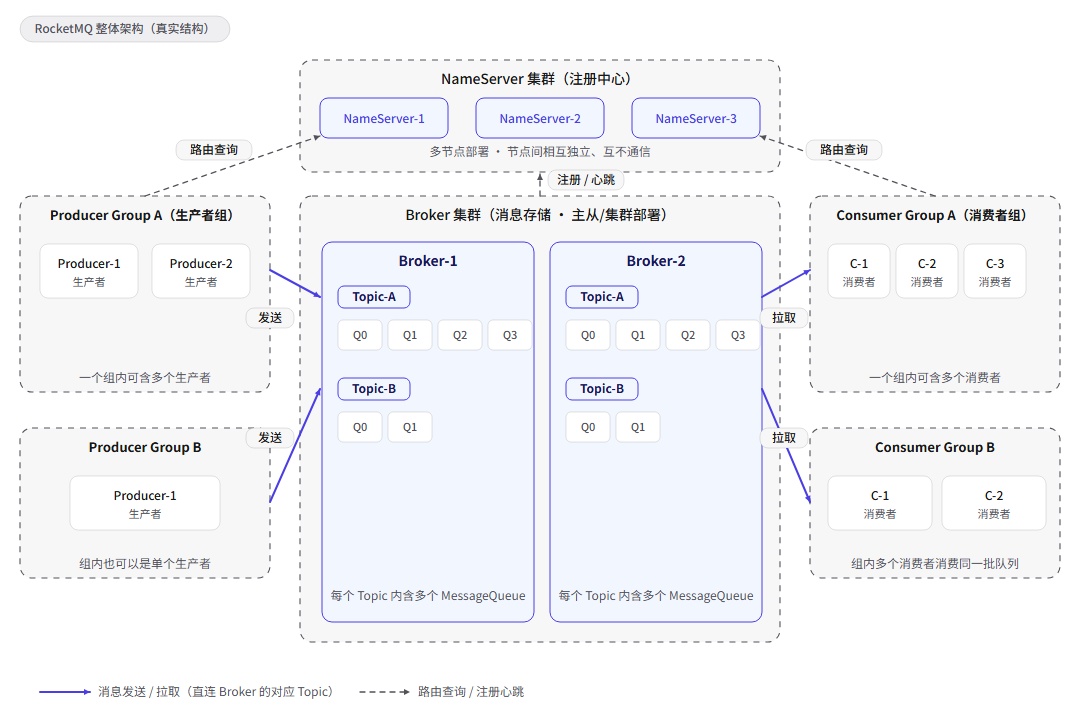
下面逐个讲清楚这四个部分,以及它们是怎么连起来的。
1. Producer(生产者组)
Producer 集成在业务调用链路的上游 ,负责生产消息。需要特别注意:这个「组」字其实没有实际意义,没有强规则约束,只是方便管理、标识一组生产者而已,记住即可。
2. Broker(消息存储)
Broker 是 MQ 中实际存储消息的部分,真实的消息就存在这里。它内部由下面几个概念组成:
- Topic(主题) :消息传输和存储的分组容器。一个主题内部由多个队列组成,消息的存储和水平扩展实际上是通过主题内的队列来实现的。
- MessageQueue(队列) :消息传输和存储的实际单元容器 ,可以类比其他消息队列中的「分区」。RocketMQ 用流式特性的无限队列结构 来存储消息,消息在队列内具备顺序性存储的特征。
- Message(消息) :最小的传输单元。消息具备不可变性------在初始化发送并完成存储后就不可变了。
其中,Message 的结构直接决定了我们能对一条消息做什么,核心字段分为业务主动设置 和系统自动填充两类。
业务主动设置的字段:
| 字段 | 必填 | 作用 |
|---|---|---|
topic |
是 | 主题,消息发送到哪个 Topic |
body |
是 | 消息体,byte[] 类型,业务自己序列化(如 JSON) |
tags |
否 | 标签,Topic 下的二级分类,用于消费端过滤 |
keys |
否 | 业务关键标识(如订单号),用于精确查询和幂等去重 |
properties |
否 | 用户自定义的扩展属性(Map) |
其中 keys 就是上文提到的 Key(关键标识符),它的作用是在消费端做幂等去重时,用这个唯一标识判断「这条消息是不是已经处理过了」。
系统自动填充的元数据(部分):
messageId:全局唯一的消息 ID(由生产主机信息 + 时间戳组成)。bornHost/bornTimestamp:消息的生产主机、生产时间。storeHost/storeTimestamp:消息的存储主机、存储时间。queueId/queueOffset:消息所在队列 ID、在队列中的偏移位置。reconsumeTimes:重试次数。
可以看到,Message 在发送前只有业务关心的字段,落到 Broker 存储后,系统会补上一整套「位置信息 + 生产/存储痕迹」,为后续的精确查询、消息轨迹、重试机制提供支撑。
另外,Broker 为了高可用,通常支持主从部署和集群部署,可以有多个 Broker,不同业务使用不同的 Broker。
3. NameServer(注册中心)
NameServer 是一个轻量级的注册中心 ,承担的责任主要是:Broker 注册、路由管理、路由发现、心跳检测剔除失效节点。
它非常轻量、无状态,并且可以多节点部署,节点之间相互独立(互不通信),各自和 Broker 通信更新状态。
4. ConsumerGroup(消费者组)
消费者组可以有多个消费者 。要注意它和生产者组截然不同:消费者组是有实际意义的、很重要的组。
这里有一个重点------订阅关系要求一致性 :同一个消费组内的全部消费者,订阅关系必须完全一致(同一个 topic:tag)。至于为什么,后续文章会详细讲解,这里先记住这个约束。
五、四个部分是怎么连接起来的
这里需要先回答一个疑问:为什么要一个 NameServer,直接连 Broker 不行吗?
原因是:为了消息在 MQ 中不丢失且有高可用,Broker 是可以主从部署、集群部署的。也就是说,系统里可能存在多个 Broker,不同业务使用不同的 Broker。这样一来,Producer/Consumer 就不知道该连哪个 Broker 了。
于是就有了这样的关系:
- 订阅关系 :生产者组和消费者组是根据 Topic 来投递和消费消息的,而一个 Broker 下面有多个 Topic。
- 路由表 :NameServer 维护着一张路由表,记录「各个 Topic 的消息存在哪些 Broker 上」。
- 按 Topic 取路由:Producer 和 Consumer 要投递/消费消息时,根据 Topic 去问 NameServer,NameServer 返回对应 Broker 的地址,然后再去连接。
所以 Producer/Consumer 只需要连接 NameServer,按 Topic 拿到 Broker 地址后直连 Broker 即可,不需要自己维护「哪个 Topic 在哪个 Broker」。
最后补充两个概念,这里先了解个大概,后续会详讲:
- Tag :Topic 底下还可以再分 Tag,用于二次过滤 。注意订阅关系一致性同样适用于 Tag------订阅必须是同一个
topic:tag。 - Key :消息发送时还可以附带上一个 Key(关键标识符) ,这是后续避免重复消费的重点,具体用法会在消费篇详讲。
六、设计哲学:两个反直觉的设计选择
前面的角色介绍里,我们其实已经埋下了几个「反常」的点:消息要持久化到磁盘、NameServer 只存 Topic 路由、Broker 完全不维护订阅关系。把它们放到一起,会发现背后是同一套设计哲学------让 Broker 尽可能地「无状态」,只专心做好「可靠地存消息」这一件事,其余的状态全部甩给客户端。
理解这一点,就理解了 RocketMQ 区别于 RabbitMQ 的根本取向。这一章就围绕这套哲学,展开两个反直觉的设计选择:一是消息落盘而非留在内存,二是让 Broker 不维护订阅关系、连连接管理也一并交给客户端。
1. 选择一:消息落盘,而不是留在内存
一个消息队列,第一反应往往是「用内存存消息,读写更快」。但 RocketMQ 偏偏选择把消息顺序写入磁盘,这是权衡之后的刻意选择。
内存队列确实快,但有两个致命短板:
- 容量有限:内存贵且小,一旦堆消息,很快打满;而磁盘可以低成本堆到亿级、TB 级。
- 易丢失:进程一挂,内存里的消息全没了。
RocketMQ 面向的是「不能丢消息、还要能堆积海量消息」的场景,所以选择持久化落盘。落盘带来的性能损耗,则通过顺序写 (磁盘顺序写接近内存速度)和零拷贝 等技术去弥补------这些是后面「存储原理」篇的核心,这里先记住结论:落盘是它海量堆积和不丢消息的根基。
2. 选择二:Broker 不维护订阅关系(与 RabbitMQ 的本质区别)
这是最关键的一个差异,一定要和 RabbitMQ 对着看。
RabbitMQ 的做法 :通过交换机(Exchange)与队列(Queue)的绑定关系来路由。Producer 把消息发到交换机,交换机根据绑定规则路由到指定队列,Broker 内部需要维护「交换机 ↔ 队列 ↔ 消费者」这一整套绑定关系。也就是说,Broker 明确知道每个队列被哪些消费者消费。
RocketMQ 的做法 :完全没有交换机绑定队列这一层 。消费组与队列之间的联系,完全靠对 Topic 的订阅来建立。Broker 完全不管「是哪个消费组在消费我」,它只管自己有多少个 Topic、每个 Topic 下面有几个队列------仅此而已。
换句话说,Broker 维护的信息极其简单:Topic 及其下的队列。它不需要存储任何「和多个消费者组的联系信息」。消费者要拿消息时,直接通过 NameServer 路由到对应 Broker,直连拉取即可。
那为什么要这样刻意「砍掉」Broker 里的订阅关系?这是理解 RocketMQ 架构取向的关键,背后是两个很实际的原因:
- 让存储节点保持无状态,专心做好一件事。 Broker 的价值就是「可靠地顺序写盘 + 高吞吐地读盘」。一旦它还要维护「谁在消费我、推到哪了」这类状态,就必须引入连接状态机、滑动窗口、心跳管理等一系列复杂逻辑,白白消耗内存和 CPU。把这些都拿掉,Broker 才能做到极致简单,也才能放心地水平扩展、主从切换和故障恢复------一个 Broker 挂了重启,消息还在盘上,换一个 Broker 接管即可,根本不需要重建任何订阅关系。
- 消费关系是高频变化、规模巨大的,放在客户端更扛得住。 线上一个 Topic 可能有成千上万个消费实例,而且会不停地扩缩容、上下线。如果这些关系都要注册并同步到 Broker,Broker 就会变成一个庞大的「订阅关系中心」,任何一次变更都得向所有节点广播,根本撑不住。RocketMQ 把这部分交给客户端(消费组通过 NameServer 拿路由后,用 Rebalance 自行协商),Broker 完全不用感知这种动态变化。
正是这两点,让 NameServer 可以做到极简、Broker 可以做到「存储就是存储、不掺和消费关系」。
这套「无状态」取向,还直接决定了连接管理的形态------这也是它和 RabbitMQ 的另一个显著区别。为什么要在意这个?因为互联网场景下消费者数量是海量的:一个大的电商平台里,下单、支付、库存、营销等各个业务的消费实例加起来,动辄几万甚至几十万个,到了大促(618、双 11)还会瞬时翻倍。如果 Broker 要为每个消费者都维护一条独立连接、并记住这条连接的状态,那 Broker 最后是被「连接本身」拖垮的,而不是被业务消息拖垮的。
RabbitMQ 的做法:每个 Consumer 都和 Broker 保持 TCP 长连接,Broker 知道每个连接对应的消费者是谁。当 Consumer 数量达到几万甚至几十万时,Broker 的文件描述符、内存、CPU 会被连接本身耗尽,直接成为瓶颈。
RocketMQ 的做法:
- Consumer Group 只是一个逻辑概念,Broker 根本不维护 Group 级别的连接池。
- Consumer 通过 NameServer 拿到 Broker 地址后,直接与 Broker 建立少量共享连接(默认一个 JVM 实例只建 1~4 条 TCP 连接)。
- 同一个 Group 下的多个 Consumer 实例,通过客户端的 Rebalance 自行协商分配队列,Broker 完全不参与。
这样一来,哪怕面对「几十万消费者、大促还翻倍」的场景,Broker 端的连接数也被控制在极低水平------业务连接的成本由客户端自己扛,Broker 专心做存储,真正实现了「计算与连接」的解耦。
顺带一提:RocketMQ 的「主动拉取(Pull)」和 RabbitMQ 的「主动推送(Push)」也是两者的一大区别,我们会在「消息消费」篇详细对比,这里先不展开。
七、一条消息的生命周期
最后,把前面所有概念串起来,看一条消息从生产到消费的完整旅程:

整个过程可以拆成这几步:
- 生产者问路:Producer 向 NameServer 请求某个 Topic 的路由信息(该 Topic 的消息存在哪些 Broker、哪些队列)。
- 拿到地址:NameServer 返回对应的 Broker 地址。
- 直连发送:Producer 从路由信息里选中一个 MessageQueue,把消息直连发到对应 Broker,Broker 落盘存储。
- 消费者问路:Consumer 同样向 NameServer 请求该 Topic 的路由。
- 拿到地址:NameServer 返回 Broker 地址。
- 拉取消费:Consumer 直连 Broker,拉取消息消费。
你会发现整条链路里,NameServer 只在「问路」时出现一次,真正的消息收发是 Producer/Consumer 与 Broker 直连的。这个设计让 NameServer 保持极轻,即使 NameServer 短暂不可用,正在运行的收发链路也不会立刻断掉。
小结
这一篇我们建立了一张完整的地图:RocketMQ 由 Producer、Broker、NameServer、ConsumerGroup 四个部分构成,其中 Broker 负责存储、NameServer 负责路由。核心名词 Topic / MessageQueue / Message / Tag / Key 各自有明确职责,而「一条消息的生命周期」这条主线把它们串了起来。
从下一篇开始,我们会把这条主线上的每一段放大来讲------首先是消息发送,也就是 Producer 这端:同步、异步、单向到底有什么区别,以及选队列、重试、Tag、Key 的细节。