最重要的不是把 memory bank、object pointer、temporal position encoding 全部一次吃透,而是先建立两个核心认知:
SAM 2 = 把 SAM 的 promptable segmentation 从 image 扩展到 video
以及:
原来 SAM 学到的 segmentation prior 仍然被保留,只是前面多了一层时序条件化
这两个点理解了,后面的 memory 机制会顺很多。
1. promptable segmentation 怎么从 image 扩展到 video
SAM 里的任务是:
也就是:
在一张图上给 point / box / mask,输出这一张图里的目标 mask。
SAM 2 把这个任务定义成 Promptable Visual Segmentation, PVS。
输入变成:Video + Prompt on any frame
输出不再只是单张 mask,而是整个视频里的:masklet(同一个目标在一段视频中跨多个帧的连续 mask 序列),也就是:
目标物体在一系列视频帧上的时空 segmentation。论文明确说,prompt 可以放在视频任意帧上,模型要预测目标 segment 的 spatio-temporal mask,也就是 masklet。
最核心的扩展:
变成:
2. Prompt 本身其实没有发生根本变化
SAM 2 并没有重新发明一套 prompt。
它仍然支持:positive / negative point;box;mask。
甚至论文直接说:
SAM 2 的 prompt encoder 和 SAM 是相同的。
Sparse prompts 仍然是:position encoding + learned prompt-type embedding
mask 仍然通过 convolution 编码,然后加到 frame embedding 上。
也就是说,从接口上看:
它真正扩展的不是:
"prompt 长什么样"
而是:
一个 prompt 的影响范围,从当前 image 扩展到了整个 temporal sequence。
3. SAM 2 的任务层面变化
SAM 中,一个 point 只需要回答:
"这一张图中,我点的是哪个 region?"
SAM 2 中,一个 point 要回答:
"我在 frame 1 点的是这个 object,那么这个 object 在 frame 2、frame 3、frame 4......分别在哪里?"
所以:spatial prompting 扩展成了 spatio-temporal prompting
更进一步,SAM 2 允许在后面的任意 frame 继续加 prompt 修正。
例如:frame 1: click,先确定 object。
然后 SAM 2 自动传播:
假设 frame 3 出错了,可以:frame 3: another click,这个修正不是只改 frame 3,而是可以继续影响整个 masklet。
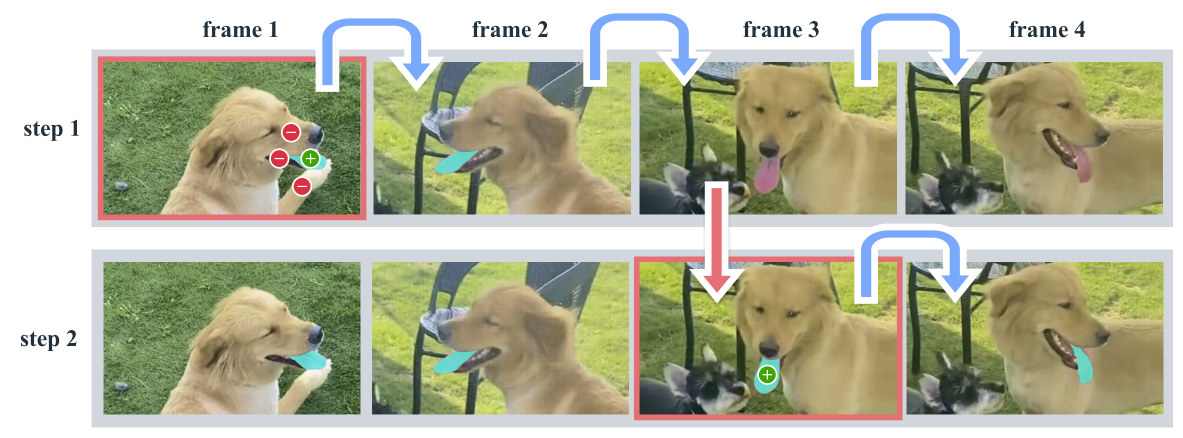
Figure 2 展示的就是这个过程:第一次 prompt 在 frame 1,目标传播到后续帧;如果中间丢失目标,只需在后续帧再加一个 correction click,模型就能利用已有上下文恢复目标。
这就是 PVS 比传统 image promptable segmentation 多出来的东西。
4. 为什么这比"SAM + tracker"更自然?
传统的一个办法是:SAM + video tracker(视频里的目标跟踪器)
流程可能是:
问题是这两个模块是分开的。
如果 tracker 在 frame 10 跑偏了,你通常得:
- 再用 SAM 把 frame 10 重新分出来;
- 然后 tracker 从 frame 10 重新开始。
SAM 2 则是统一模型:prompting + segmentation + temporal propagation 都在同一套表示中完成。
论文也专门指出,传统 "SAM + tracker" 的问题之一是,一旦出错,很难利用之前的交互上下文进行自然 refinement;而 SAM 2 可以直接基于历史 memory 修正。
所以可以把任务升级理解成:
single-frame interactive segmentation → interactive spatio-temporal segmentation
5. segmentation prior 是怎么被复用的?
这个其实和 CONVERSEG 非常相关。
segmentation prior可以理解成:
SAM 已经通过大规模 segmentation 数据学到了一套非常强的"什么东西构成一个合理 mask"的先验。
包括:
- object boundary;
- part / whole structure;
- foreground continuity;
- shape;
- local texture;
- region grouping;
- point / box / mask 到 pixel region 的映射关系。
也就是说,SAM 已经很擅长:prompt-conditioned spatial segmentation
SAM 2 没有把这套能力推倒重来。它
保留原来的 prompt-to-mask decoder 范式 + 给当前帧特征加入 temporal memory context
6. SAM 2 的整体结构可以先压缩成这样
先别看复杂 memory 细节,只看主干:
(
是当前 frame 的视觉表示)
然后 SAM 2 多加一步:
得到一个:memory-conditioned frame embedding
最后:
论文的描述非常清楚:
SAM 2 spatially behaves similarly to SAM;轻量的 promptable mask decoder 接收 frame embedding 和 prompts,然后输出当前 frame mask。区别在于,这个 frame embedding 不再直接来自 image encoder,而是先被 memory 条件化。
7. 所以 segmentation prior 到底藏在哪里?
主要有两处。
第一处是:SAM-style prompt encoder
第二处更重要:SAM-style mask decoder
SAM 2 论文明确说:
decoder design largely follows SAM。
依然使用:two-way transformer 去更新:
- prompt embeddings;
- frame embeddings。
而且 ambiguous prompt 时依旧预测 multiple masks。
所以 SAM 2 的 spatial segmentation 核心没有变成一个纯 tracker。
它仍然在做:
只是现在 visual features 已经是:temporal-context-aware 的了。
8. 可以把它理解成"先加入时间信息,再调用 SAM 的分割能力"
SAM:
SAM 2:
所以:Memory Attention 不负责真正生成 mask
它主要负责:
"当前 frame 里面,哪些视觉信息与我们之前追踪的那个 object 有关?"
然后真正的 pixel-level segmentation: 仍然交给 SAM-like mask decoder。
CONVERSEG 也是:
前面模块负责提供更高级的语义条件,后面的 SAM2 decoder 负责把这个条件落到 pixels。
9. 这就是所谓 reuse segmentation prior 的核心
你可以用一个非常简化的类比。
SAM 已经学会:
"给我一个好的 condition,我很会画 mask。"
SAM 2 不重新学习"怎么画 mask"。它重点学习的是:
"视频中当前 frame 的 condition 应该如何结合之前 frame 的信息。"
所以:Spatial segmentation knowledge 是被继承的,
新增的是:Temporal object correspondence
也就是:同一个 object 在不同 frame 中如何持续对应
10. Image Encoder 也发生了变化,但思想没变
SAM 用的是 ViT image encoder。
SAM 2 换成了:,也是 MAE-pretrained。
Hiera 是 hierarchical image encoder,可以提供 multi-scale features。它为每个 frame 先提供 unconditioned tokens。
"unconditioned": 纯当前 frame 的视觉信息
还不知道:
- 用户要哪个 object;
- 之前 object 长什么样;
- object 上一帧在哪里。
之后经过 Memory Attention,才变成:
也就是 object-conditioned / memory-conditioned frame feature。
11. Memory Attention 暂时只需要理解成"检索之前目标信息"
只需要记:
比如 frame 1 里用户点了 dog,那么 memory 里会保存一些与这个 dog 有关的信息。
到 frame 2: 本来只是:
frame 2 中所有东西的视觉表示。
经过 memory attention:,相当于模型被提醒:
"我们现在关心的是之前那个 dog。"
然后:
就可以继续分那个 dog。
Memory attention 的作用正是让当前 frame feature 去 cross-attend 之前的 frame memory 和 object information。
12. 为什么说这就是"reuse segmentation prior"而不是重新做 video segmentation?
因为 SAM 2 的思路不是: 全新 video segmentation network
而是:
它隐含一个假设:
视频 segmentation 的难点,不一定是重新学习"什么是 mask";更主要的是,如何让已有强 spatial segmentation 能力在时间轴上保持 object identity。
换句话说,SAM 已经解决了:
where are the pixels of this object?
SAM 2 新增解决:
which object in the current frame corresponds to the previous target?
然后再调用已有 segmentation 能力。
13. 为什么 mask decoder 仍然保留 two-way transformer?
因为即使到了 video,当前 frame 里还是要解决:
的对齐问题。
所以 SAM 2 仍然需要:
同时:
进行双向交互。
只不过现在:frame features 已经经过 memory attention。
所以可以写成:
然后:
14. SAM 2 还保留了 SAM 对 ambiguity 的处理
SAM ,一个 point 可能对应:
- whole object;
- part;
- subpart。
所以输出多个 masks。
SAM 2 里还是一样,而且 video 中 ambiguity 更复杂,因为 ambiguity 可以跨帧持续存在。
因此 SAM 2 依旧:predict multiple masks
如果用户后面没有额外 prompt 来消除 ambiguity,就传播 predicted IoU 最高的那个。
15. 但 video 多了一个 SAM 没有的问题:目标可能消失
SAM 中如果给了 positive point:一定存在一个可以分割的东西
但视频中:frame 1 有这个 object,frame 10 可能被完全遮挡:
所以 SAM 2 新增了一个 head:object present? 判断当前 frame 是否存在目标。
论文明确说,这是 PVS 相比 SAM 新增的一种输出模式。
这个细节其实很能体现:
不是单纯"多跑几帧",而是任务定义本身发生了变化。
16. 现在再看 segmentation prior 的复用,会更清楚
可以把 SAM 2 拆成两层能力:
第一层:Temporal reasoning / correspondence
负责:
核心模块:Memory Attention
第二层:Spatial segmentation
负责:
核心模块:Prompt Encoder + Two-Way Mask Decoder,这一层大量继承 SAM。
所以:SAM 2 = temporal association + SAM-style spatial decoding
虽然这是一个简化总结,但对你现在理解架构非常有效。
17. 这和 CONVERSEG-NET 的关系其实更直接了
之前看 CONVERSEG-NET 时,重点是:
那么为什么作者愿意直接复用 SAM2 decoder?
因为 SAM2 已经提供了非常强的:segmentation prior
也就是:
给定一个合适的高层 condition,怎么把它稳定地落到 pixel mask。
CONVERSEG 不需要重新学习:
- boundary;
- mask topology;
- local detail;
- region coherence。
它主要需要解决:抽象语言语义 → SAM2 能理解的 conditioning representation
然后:SAM2 decoder 负责 condition → pixels
这就是"复用 segmentation prior"最核心的价值。
18. 现在读 SAM 2,建议只记住这张图
可以先把整篇论文压缩成:
然后:
再:
最后:
预测结果又会: 供下一帧使用。
最重要的是:
当前帧不是直接进入 mask decoder, 而是先被历史目标信息条件化,然后真正的 spatial segmentation 仍然复用 SAM 的 decoder 范式
如果是为了继续看 CONVERSEG-NET,SAM 2 你现在理解到这个程度基本就够用了:
SAM 提供 prompt-to-mask spatial prior
SAM 2 在此基础上加入 memory-conditioned visual representation
CONVERSEG 再进一步,把 VLM semantic representation 接到这个 segmentation interface 上
所以三篇工作的关系可以很简洁地理解为:
SAM: prompt → pixels
SAM 2: prompt + memory → pixels
CONVERSEG: VLM semantics → SAM2-style prompt/conditioning → pixels