🌸雨落在了我的手上:个人主页
🐟个人仓库:Gitee仓库
❄️个人专栏:<<JaveSe>> <<C语言>> <<C语言数据结构>>**
🔥🔥🔥 人生格言:无人扶我青云志,我自踏雪至山巅
🎬 博主简介:
目录
内容大纲:
哈希表通过哈希函数将关键码映射到存储位置,实现快速查找。插入与搜索无需比较,时间复杂度接近O(1)。但因数组容量有限,冲突不可避免。冲突可通过闭散列(如线性探测)或开散列(哈希桶)解决。开散列更优,支持动态扩容,且在冲突严重时可转为红黑树。负载因子控制冲突率,通常阈值为0.75。Java中HashMap/HashSet基于哈希桶实现,自定义类作键需重写hashCode与equals方法。
一:哈希表
1.概念
顺序结构以及平衡树中,元素关键码与其存储位置之间没有对应的关系,因此在查找⼀个元素时,必 须要经过关键码的多次⽐较。顺序查找时间复杂度为O(N),平衡树中为树的⾼度,即O(),搜索的效率 取决于搜索过程中元素的⽐较次数。
理想的搜索⽅法:可以不经过任何⽐较,⼀次直接从表中得到要搜索的元素。如果构造⼀种存储结 构,通过某种函数(hashFunc)使元素的存储位置与它的关键码之间能够建⽴⼀⼀映射的关系,那么在 查找时通过该函数可以很快找到该元素
当向该结构中:
• 插⼊元素
• 根据待插⼊元素的关键码,以此函数计算出该元素的存储位置并按此位置进⾏存放
• 搜索元素
• 对元素的关键码进⾏同样的计算,把求得的函数值当做元素的存储位置,在结构中按此位置取元素 ⽐较,若关键码相等,则搜索成功
该⽅式即为哈希(散列)⽅法,哈希⽅法中使⽤的转换函数称为哈希(散列)函数,构造出来的结构称为哈希表(HashTable)(或者称散列表)
例如:数据集合{1,7,6,4,5,9};
哈希函数设置为:hash (key) =key % capacity; capacity为存储元素底层空间总的⼤⼩。
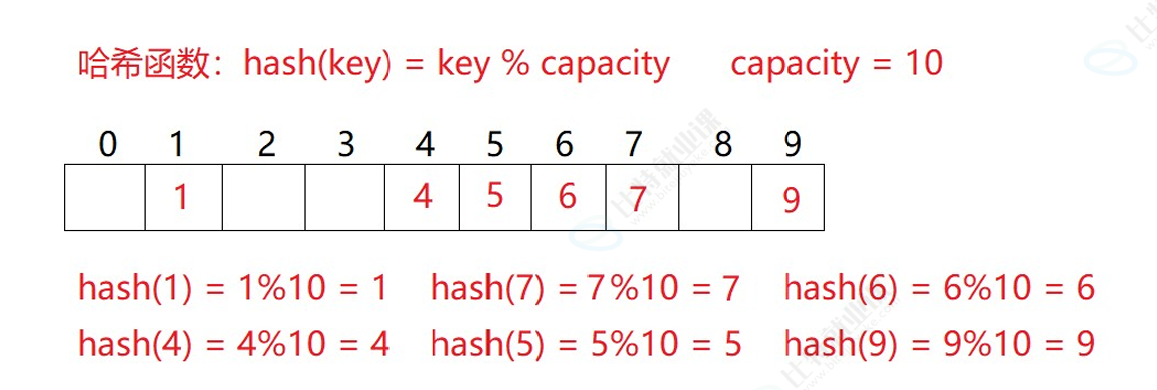
⽤该⽅法进⾏搜索不必进⾏多次关键码的⽐较,因此搜索的速度⽐较快问题:按照上述哈希⽅式,向 集合中插⼊元素44,会出现什么问题?
2.冲突-概念
对于两个数据元素的关键字 和 (i!=j),有 != ,但有:Hash( )==Hash( ), 即:不同关键字通过相同哈希函数计算出相同的哈希地址,该种现象称为哈希冲突或哈希碰撞。
把具有不同关键码⽽具有相同哈希地址的数据元素称为"同义词"。
3.冲突-避免
⾸先,我们需要明确⼀点,由于我们哈希表底层数组的容量往往是⼩于实际要存储的关键字的数量 的,这就导致⼀个问题,冲突的发⽣是必然的,但我们能做的应该是尽量的降低冲突率。
4.冲突-避免-哈希函数设计
引起哈希冲突的⼀个原因可能是:哈希函数设计不够合理。哈希函数设计原则:
• 哈希函数的定义域必须包括需要存储的全部关键码,⽽如果散列表允许有m个地址时,其值域必须 在0到m-1之间
• 哈希函数计算出来的地址能均匀分布在整个空间中
• 哈希函数应该⽐较简单
常⻅哈希函数:
- 直接定制法--(常⽤)
取关键字的某个线性函数为散列地址:ash(Key)=A*Key+B优点:简单、均匀,缺点:需要事先知道关键字的分布情况使⽤场景:
相关面试题:https://leetcode.cn/problems/first-unique-character-in-a-string/description/
- 除留余数法--(常⽤)
设散列表中允许的地址数为m,取⼀个不⼤于m,但最接近或者等于m的质数p作为除数,按 照哈希函数:Hash(key)=key%p(p<=m),将关键码转换成哈希地址
注意:哈希函数设计的越精妙,产⽣哈希冲突的可能性就越低,但是⽆法避免哈希冲突
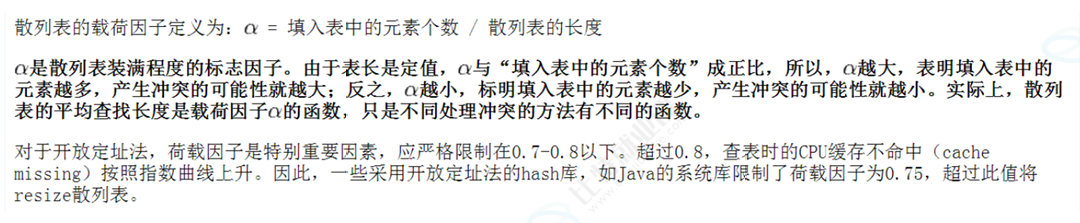
5.冲突-避免-负载因⼦调节(重点掌握)
负载因⼦和冲突率的关系粗略演⽰:
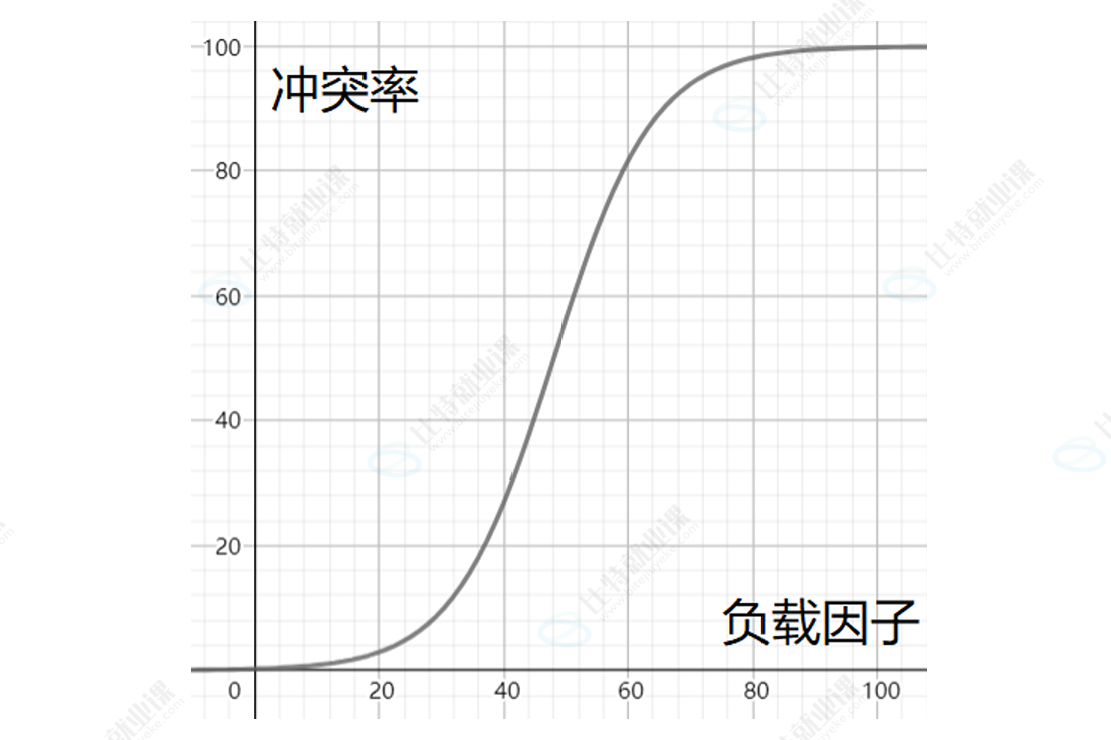
所以当冲突率达到⼀个⽆法忍受的程度时,我们需要通过降低负载因⼦来变相的降低冲突率。
已知哈希表中已有的关键字个数是不可变的,那我们能调整的就只有哈希表中的数组的⼤⼩。
6.冲突-解决
解决哈希冲突两种常⻅的⽅法是:闭散列和开散列
7.冲突-解决-闭散列
闭散列:也叫开放地址法,当发⽣哈希冲突时,如果哈希表未被装满,说明在哈希表中必然还有空位置,那么可以把key存放到冲突位置中的"下⼀个"空位置中去。那如何寻找下⼀个空位置呢?
线性探测:
⽐如上⾯的场景,现在需要插⼊元素44,先通过哈希函数计算哈希地址,下标为4,因此44理论上应该 插在该位置,但是该位置已经放了值为4的元素,即发⽣哈希冲突。
线性探测:从发⽣冲突的位置开始,依次向后探测,直到寻找到下⼀个空位置为⽌。
• 插⼊:
◦ 通过哈希函数获取待插⼊元素在哈希表中的位置
◦ 如果该位置中没有元素则直接插⼊新元素,如果该位置中有元素发⽣哈希冲突,使⽤线性探测 找到下⼀个空位置,插⼊新元素
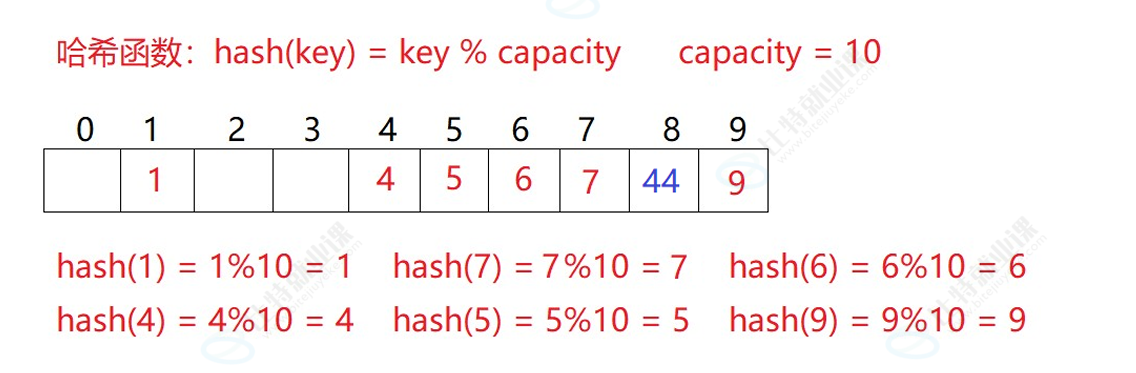
采⽤闭散列处理哈希冲突时,不能随便物理删除哈希表中已有的元素,若直接删除元素会影响其他元 素的搜索。⽐如删除元素4,如果直接删除掉,44查找起来可能会受影响。因此线性探测采⽤标记的伪删除法来删除⼀个元素。
⼆次探测:
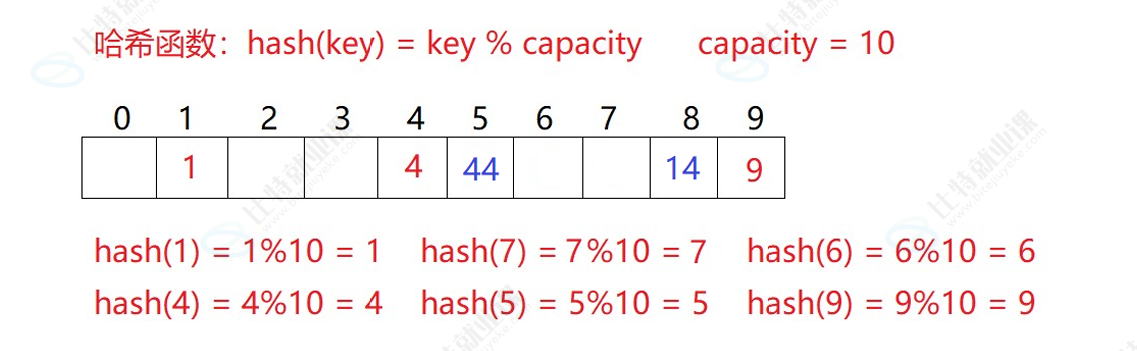
线性探测的缺陷是产⽣冲突的数据堆积在⼀块,这与其找下⼀个空位置有关系,因为找空位置的⽅式 就是挨着往后逐个去找,因此⼆次探测为了避免该问题,是通过散列函数Hash(x)对元素的关键码 key 进⾏计算得到的位置,m是表的⼤⼩。对于2.1中如果要插⼊44,产⽣冲突,使⽤解决后的情况 为
总结:
- 优点:
• 不需要额外的数据结构(如链表),空间利⽤率⾼。
• 实现相对简单。
• 缓存性能好,因为数据都存储在连续的内存空间中。
• 不需要存储指针,节省空间。
- 缺点:
• 容易产⽣聚集现象(尤其是线性探测)。
• 删除操作复杂(需要特殊处理以保持查找链的完整性)。
• 装载因⼦不能太⼤,否则性能会急剧下降。
• ⼆次聚集(对于⼆次探测)。
8.冲突-解决-开散列/哈希桶(重点掌握)
开散列法⼜叫链地址法(开链法),⾸先对关键码集合⽤散列函数计算散列地址,具有相同地址的关键码 归于同⼀⼦集合,每⼀个⼦集合称为⼀个桶,各个桶中的元素通过⼀个单链表链接起来,各链表的头 结点存储在哈希表中。
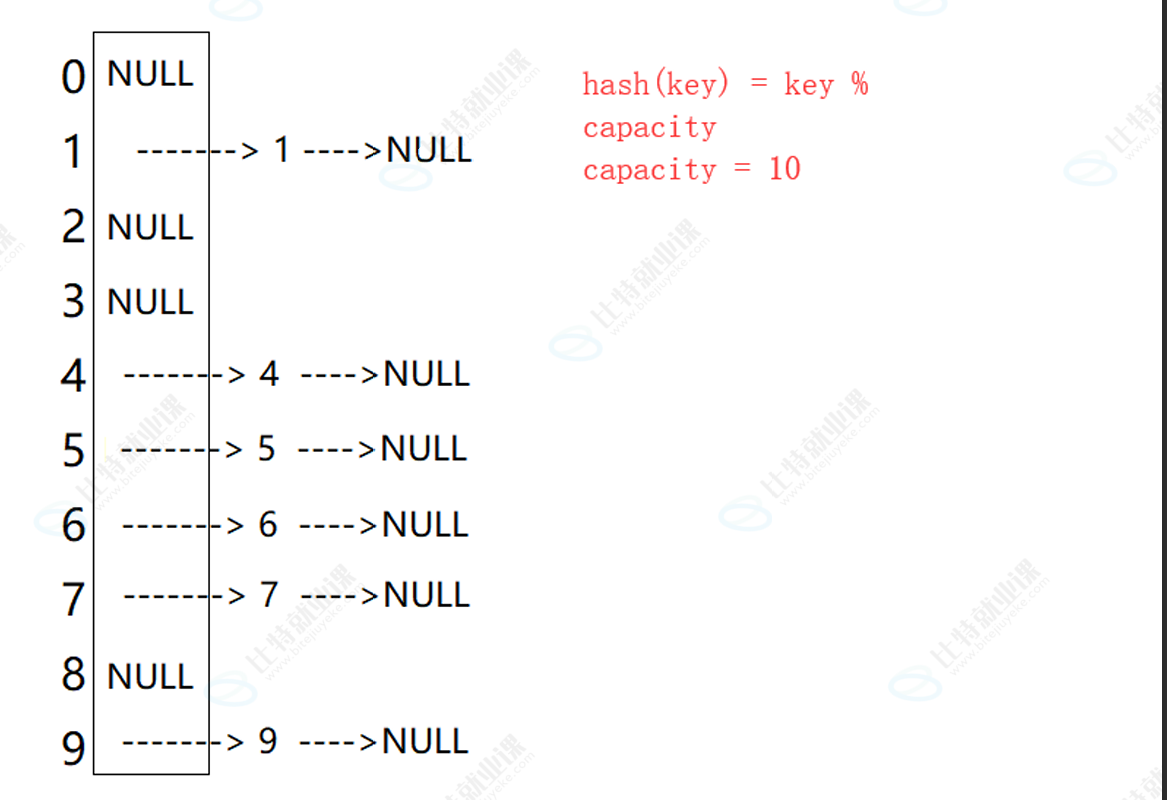
从上图可以看出,开散列中每个桶中放的都是发⽣哈希冲突的元素。
开散列,可以认为是把⼀个在⼤集合中的搜索问题转化为在⼩集合中做搜索了。
9.冲突严重时的解决办法
刚才我们提到了,哈希桶其实可以看作将⼤集合的搜索问题转化为⼩集合的搜索问题了,那如果冲突严重,就意味着⼩集合的搜索性能其实也时不佳的,这个时候我们就可以将这个所谓的⼩集合搜索问题继续进⾏转化,例如:
1.每个桶的背后是⼀棵搜索树
2.每个桶的背后是另⼀个哈希表
3.哈希函数重新设计
...............
10.代码实现
java
//哈希表的模拟实现
public class HashBucket {

    //1.定义内容节点类
    private static class Node{
        private int key;
        private int value;
        Node next;//指向下一个节点的指针

        public Node(int key, int value) {
            this.key = key;
            this.value = value;
        }
    }

    //2.成员变量
    private Node[]array; //存放链表的数组(哈希桶)
    private int size; //当前存储的键值对的个数
    private static final double LOAD_FACTOR = 0.75; // 负载因子(用于触发扩容)

    //3.构造方法
    public HashBucket(){
        this.array = new Node[8]; // 默认初始容量为 8
        this.size = 0;
    }

    //4.插入数据
    public int put(int key,int value) {
        // a. 计算哈希值(确定在数组中的下标)
        int index = key % array.length;

        // b. 在链表中查找 key 是否已存在
        // 如果找到了,更新 value,并返回旧的 value
        for (Node cur = array[index]; cur != null; cur = cur.next) {
            if (key == cur.key) {
                int oldValue = cur.value;
                cur.value = value;
                return oldValue; // 更新成功,返回旧值
            }
        }

        // c. 如果链表中没有该 key,插入一个新节点(头插法)
        Node node = new Node(key, value);
        node.next = array[index];// 新节点的 next 指向原来的头节点
        array[index] = node; // 数组下标指向新节点,成为新的头
        size++;                   // 个数加一

        // d. 检查是否需要扩容 (对应图片第 35-38 行)
        // 负载因子 = 当前元素个数 / 数组长度。如果 >= 0.75 就扩容
        if (loadFactor() > LOAD_FACTOR) {
            resize();
        }

        return -1;// 插入新节点成功,返回 -1 (表示没有覆盖旧值)
    }

    //5.扩容方法
    private void resize(){
        // a. 创建一个新数组,容量扩大为原来的 2 倍
        Node[] newArray = new Node[array.length*2];

        // b. 遍历旧数组的每一个下标位置
        for (int i=0;i<array.length;i++){
            Node next ;// 用来暂存下一个节点
            // c. 遍历当前下标下面的整条链表
            for (Node cur = array[i];cur !=null;cur=next){

                // 【难点解析】:必须先保存 cur.next!
                // 因为我们马上要修改 cur.next 的指向,如果不提前保存,链表后面的数据就丢失了。
                next=cur.next;

                // d. 重新计算在新数组中的下标(容量变了,取模的结果也会变)
                int index = cur.key% newArray.length;

                // e. 将当前节点重新以"头插法"挂到新数组对应位置
                cur.next=newArray[index];
                newArray[index]=cur;
            }
        }
        // f. 将底层数组替换为新的扩容后的数组
        array=newArray;
    }


    //6.计算当前负载因子
    private double loadFactor(){
        // 乘以 1.0 是为了避免整数除法导致的精度丢失(比如 size=3, length=4,如果不乘 1.0 结果会是 0 而不是 0.75)
        return size *1.0/array.length;
    }

    //7.查询数据
    public int get(int key){
        // a. 计算下标
        int index = key%array.length;

        // b. 遍历链表寻找 key
        Node head = array[index];
        for (Node cur = head;cur!=null;cur=cur.next){
            if (key==cur.key){
                return cur.value;// 找到了,返回对应的 value
            }
        }
        // c. 找遍了也没找到,返回 -1 代表不存在
        return -1;
    }

    //辅助方法:打印哈希桶结构
    public void printBucket(){
        System.out.println("当前元素个数: " + size + ", 数组容量: " + array.length);
        for (int i=0;i<array.length;i++){
            if (array[i]!=null){
                System.out.println("下标"+i+": ");
                Node cur= array[i];
                while (cur!=null){
                    System.out.print("[" + cur.key + "=" + cur.value + "] -> ");
                    cur = cur.next;
                }
                System.out.println("null");
            }
        }
    }

    // ==================== main 方法测试 ====================
    public static void main(String[] args) {
        HashBucket hashBucket = new HashBucket();

        System.out.println("==== 测试插入与扩容 ====");
        // 初始容量是 8,负载因子 0.75,阈值是 6 (8 * 0.75)。
        // 所以插入第 7 个元素时(size变为 7,7/8 = 0.875 > 0.75),会触发扩容!
        for (int i = 1; i <= 10; i++) {
            hashBucket.put(i, i * 100);
        }
        hashBucket.printBucket();

        System.out.println("==== 测试查找 ====");
        System.out.println("查找 key 3: " + hashBucket.get(3)); // 应输出 300
        System.out.println("查找 key 8: " + hashBucket.get(8)); // 应输出 800
        System.out.println("查找 key 99: " + hashBucket.get(99)); // 应输出 -1(不存在)

        System.out.println("\n==== 测试更新 ====");
        int oldValue = hashBucket.put(3, 9999);
        System.out.println("更新 key 3 的旧值是: " + oldValue); // 应输出 300
        System.out.println("更新后查找 key 3: " + hashBucket.get(3)); // 应输出 9999
    }
}
11.性能分析
虽然哈希表⼀直在和冲突做⽃争,但在实际使⽤过程中,我们认为哈希表的冲突率是不⾼的,冲突个 数是可控的,也就是每个桶中的链表的⻓度是⼀个常数,所以,通常意义下,我们认为哈希表的插⼊/ 删除/查找时间复杂度是O(1)。
12.和java类集的关系
-
HashMap和HashSet即java中利⽤哈希表实现的Map和Set
-
java 中使⽤的是哈希桶⽅式解决冲突的
-
java 会在冲突链表⻓度⼤于⼀定阈值后,将链表转变为搜索树(红⿊树)
-
java 中计算哈希值实际上是调⽤的类的hashCode⽅法,进⾏key的相等性⽐较是调⽤key的 equals ⽅法。所以如果要⽤⾃定义类作为HashMap的key或者HashSet的值,必须覆写 hashCode和equals⽅法,⽽且要做到equals相等的对象,hashCode⼀定是⼀致的。
以上就是我们的全部内容了!!!!