Agent Eval 正在从"任务能否完成",转向"结果是否有效、过程是否可靠、系统是否值得部署"。这张地图梳理 2026 年的主要赛道、代表工作与尚未解决的问题。
过去评估大模型,像批改试卷:给一道题,看答案对不对。
评估 Agent,更像考察一个进入真实工作环境的执行者:它要理解目标、调用工具、改变状态、处理意外并完成交付;同时还要稳定、合规、成本可接受,而且不通过钻漏洞获得成功。
因此,Agent Eval 测量的不是孤立模型:
Performance = f(Model, Harness, Tools, Skills, Memory, Environment, Budget, Verifier)
性能 = f(模型、框架、工具、技能、记忆、环境、预算、验证)
2026 年,Agent Eval 正在从"模型能力考试",发展为一门关于自主系统的测量、审计与治理科学。
一、全景概览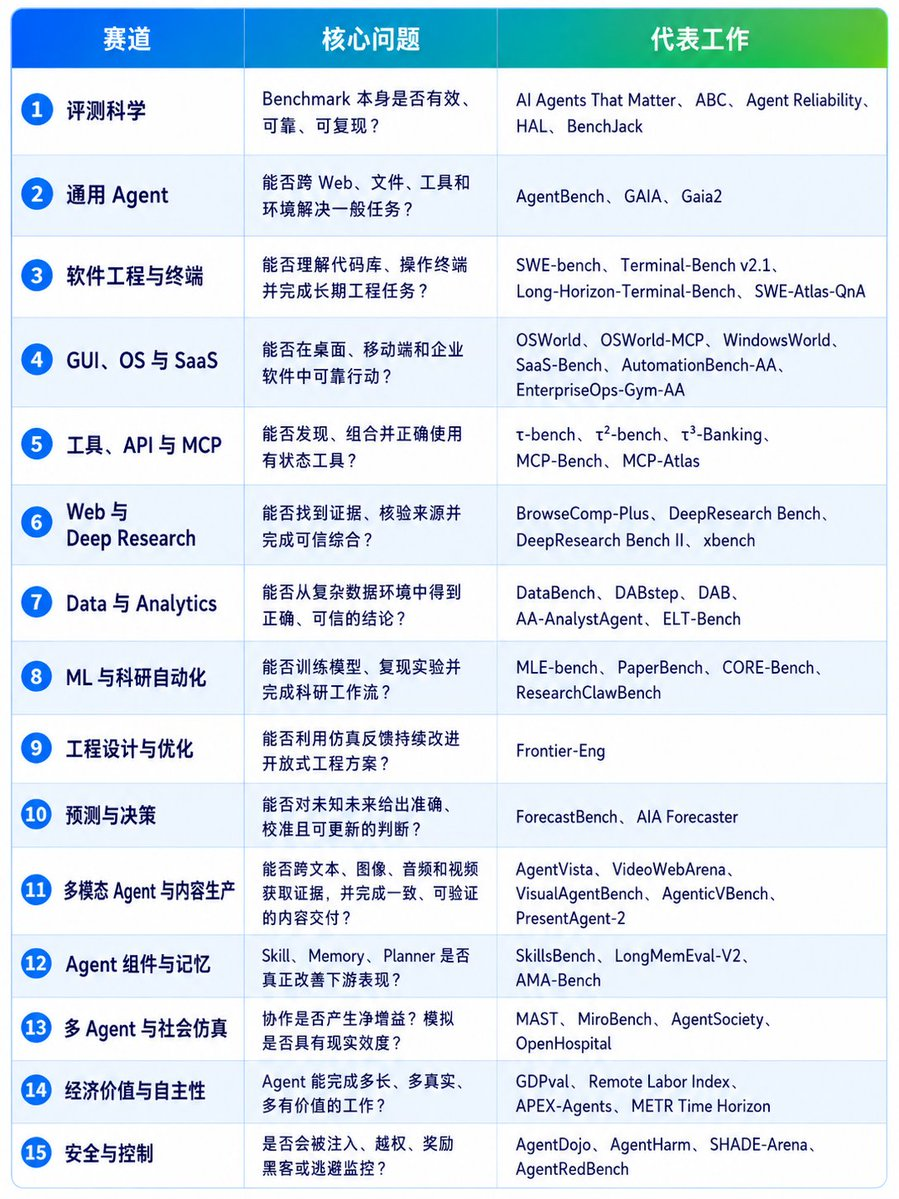
这张地图包含四种不同维度:
-
工作场景:Agent 在做什么?
-
系统层级:测模型、组件、单 Agent,还是多 Agent?
-
评测目标:测能力、可靠性、安全,还是价值?
-
证据协议:依据测试、状态、rubric,还是真实世界结果?
不同 benchmark 测的并不是同一种能力,不能简单排成一条总榜。
多模态是一条横跨多条赛道的能力轴,本图单列这一赛道,是因为当跨模态创作本身成为任务目标时,其验证方法与普通问答或状态操作明显不同。
二、方法学主线:从建榜到审计
和
确立了早期通用 Agent 评测:前者把模型放进八种交互环境,后者测试 Web、文件、多模态、工具和推理的组合能力。GAIA 原始论文中,人类正确率为 92%,配备插件的 GPT-4 为 15%。
随后指出:只看准确率会忽略成本,模型比较和完整 Agent 比较经常被混淆,公开小测试集容易过拟合,不同团队的结果也缺乏可复现性。
进一步将问题拆成:
-
任务效度:任务真的需要目标能力吗?
-
结果效度:判分器真的识别了成功吗?
其审计发现,benchmark 设计问题可造成最高 100% 的相对估计误差。
到 2026 年,
、
、
、
和
开始把可靠性、成本、轨迹和对抗审计纳入标准流程。
Agent Eval 的基本单位,正从 leaderboard score 变成 evidence package。
统一评测机构也开始改变 leaderboard 的含义。Artificial Analysis 不只汇总开发者自报分数,而是在相对统一的 harness 中独立运行模型,并同时记录成功率、成本、token、时间和工具轨迹。
当前 Artificial Analysis Agentic Index 并不是一个新 benchmark,而是由
与 τ³-Banking 各占 50% 组成,分别代表真实知识工作和有状态客户交互。
三、通用 Agent:从多环境交互到动态世界
测试模型能否在不同交互环境中持续决策。
测试通用助理能否协调搜索、文件、代码、多模态和工具,最终产生可验证答案。
则引入动态、异步、可写环境:环境会独立变化,Agent 必须处理时间约束、噪声、歧义和协作。
三者对应一条清晰演进:
静态助手 → 交互式代理 → 动态异步代理
四、数字执行:代码、GUI 与工具
软件工程
把代码评测从"生成函数"推进到"解决真实 GitHub issue":理解代码库、修改多文件、运行测试并反复修复。
它的优势是真实任务、可执行环境和自动测试;局限则是污染、solution leakage、测试覆盖不足,以及 scaffold 与预算不可比。
持续采集新 issue;
和
则将范围扩展到系统操作和长程工程。
Artificial Analysis 的
则进一步把代码 Agent 拆成三种工作:DeepSWE 测长程代码修改,Terminal-Bench v2.1 测终端执行,SWE-Atlas-QnA 测代码库理解。
它的重要性不在于又创造了一个总分,而在于明确比较的是 model × harness:同一模型接入不同 Agent scaffold,可能成为完全不同的工程系统。
GUI 与 SaaS
和
要求 Agent 操作桌面与企业软件。
这类任务不能只看终态。一个 Agent 可能完成退款,却同时违反政策、使用错误账户或修改其他订单。
有效成功 = 结果正确、流程合法且无实质性副作用
另一支路线直接进入企业自动化:
。 通过 REST API 测试 SaaS 工作流,并规定一旦触发 guardrail violation,该任务即使部分完成也记零;EnterpriseOps-Gym-AA 则根据企业后台数据库的最终状态评分。
工具与事务
将工具评测从函数和 JSON 参数,推进到有状态的用户---Agent---工具互动。
Agent 不只要调用 API,还要收集信息、读取政策、修改数据库并确认结果。真正的难点不是"会不会调用",而是"该不该调用,以及调用后发生了什么"。
这条路线随后从 τ-bench、τ²-bench 发展到 τ³-Banking:Agent 不仅面对结构化政策和工具,还要从较大的非结构化知识库中检索依据,在多轮对话中与用户共同完成银行事务。
企业 Agent 的成功必须同时满足目标完成、状态正确与过程合规。
五、知识工作:Research、Data 与 Forecasting
Deep Research
、
和
测试:
搜索 → 来源选择 → 交叉验证 → 证据综合 → 引用 → 报告
最终答案正确不等于研究可信。还必须检查来源质量、证据覆盖、引用正确性,以及 Agent 是否通过搜索直接找到了 benchmark 材料。
通用知识工作
把知识工作具象化为 spreadsheet、presentation、memo、PDF 和其他专业交付物。它包含 91 项任务,组织在数据科学、产品管理和企业战略等四个多周项目中,并分别评估任务要求、分析质量与呈现质量,同时报告成本、速度、turn 数和工具使用。
但"多周项目"不等于 Agent 连续自主工作数周:当前每项任务仍独立运行,Agent 不会继承自己此前的交付物。它因此比问答 benchmark 更接近真实办公室工作,却仍没有完全解决跨任务记忆、长期责任和工作流连续性问题。
Data Agent
Data Agent Eval 已形成清晰的数据工作谱系:
数据问答:DataBench 多步分析:DABstep 异构企业数据:DAB 真实文档与表格分析:AA-AnalystAgent 数据管道与工程:ELT-Bench
主要测试表格理解和计算。
包含 450 多个真实数据分析任务,要求 Agent 结合代码执行、结构化数据和文档推理。
进一步覆盖多数据库整合、非标准关联键、非结构化文本转换与领域知识。它包含 54 个高复杂度查询、12 个数据集、9 个领域和 PostgreSQL、MongoDB、SQLite、DuckDB 四种系统。
2026 年发布的
则补上了另一块拼图:Agent 能否从真实 spreadsheet 与文档中稳定地产出正确的定量判断。结果显示,单次正确率最高的模型不一定拥有最高的连续可靠性。
Forecasting
持续生成尚未揭晓答案的预测问题,并在事件发生后评分,从设计上降低数据泄漏。它测量的不是知识回忆,而是概率预测是否准确、校准,并优于人类基线。
结合 Agent 搜索、预测聚合与统计校准,在 ForecastBench 上达到与 human superforecaster 相当的水平;但在更困难的预测市场数据上仍落后于市场共识。
这一赛道回答的是:
当答案尚不存在时,Agent 能否把变化中的证据转化为可靠的概率判断?
六、多模态 Agent 与内容生产
多模态 Agent 不只是"看懂一张图",而是要在文本、图像、音频和视频之间持续获取证据、调用工具并完成交付:
感知 → 检索 → 规划 → 生成 → 编辑 → 验证
测试 Agent 能否在真实视觉场景中进行长程、多工具推理;
要求 Agent 从视频教程中提取事实或技能,再完成网页任务。
内容生产进一步把评测对象从"答案"变成完整作品。
包含100项真实视频后期制作任务,同时使用程序验证器和专家 rubric,最佳 Agent stack 的成功率也仅略高于30%;
则评估从检索素材、制作幻灯片到生成解说与互动演示的端到端工作流。
这类任务不能只评价作品"好不好看",还要检查事实与来源、跨模态一致性、指令遵循、编辑过程、版权与安全,以及最终文件能否继续使用。它回答的是:
Agent 能否把多模态素材转化为准确、一致、可编辑且真正可交付的内容?
七、科研与开放优化
MLE-bench
从 75 个 Kaggle competition 中构建任务,要求 Agent准备数据、训练模型、运行实验并优化结果。原始研究中,o1-preview + AIDE 在 16.9% 的比赛中达到至少 Kaggle 铜牌水平。
它面对的是受算力和时间约束的开放优化:
建立验证方案 → 训练 baseline → 分析误差 → 提出实验 → 分配算力 → 迭代优化
PaperBench 与 CORE-Bench
要求 Agent 从零复现 20 篇 ICML 2024 Oral/Spotlight 论文,并将任务拆成 8,316 个可评分子项。
聚焦已有研究代码的计算可复现性。
但需要区分:
Replication ≠ Open-ended Research
真正的开放研究还要求选择问题、提出假设、设计实验、理解负结果并判断新颖性。
Frontier-Eng
让 Agent 在工业级 simulator 中持续改进工程设计。
SWE-bench 问"是否修好";Frontier-Eng 问"在约束下还能优化多少"。因此它关注可行率、连续目标、约束违规和单位成本改善。
八、组件、记忆与群体
SkillsBench
比较相同 Agent 在无 Skill、人工 Skill 和自生成 Skill 条件下的表现。
在 86 个任务、11 个领域和 7,308 条 trajectory 上,人工 Skill 平均带来约 16.2 个百分点提升,但84项有效任务中有16项出现负增益;自生成 Skill 平均没有显著收益。
它代表 Agent Eval 从系统排名走向组件因果归因。
Memory
记忆 benchmark 常测:P(能否召回过去事实)
真实部署关心:Δ P(任务成功 | 加入记忆)
记忆可能带来陈旧信息、错误偏好和上下文污染。未来重点是检索、整合、更新、遗忘和下游长期效用。
Multi-agent 与 AgentSociety
多 Agent 的合理指标是:
Coordination Gain = Y_{Multi-Agent} - Y_{Budget-Matched Single-Agent}
关注协作失败归因;关键是控制 token、成本、wall-clock 和模型调用次数。
则研究万级 Agent、百万级互动产生的社会现象。它不是团队任务 benchmark,而是社会模拟平台。
其效度链条是:
个体行为 → 关系网络 → 群体统计 → 干预响应 → 样本外预测
规模不是效度。万级 Agent 仍可能只是放大相同的行为偏差。
九、真实价值与安全边界
经济价值
、
、
和
测量不同构念:
-
专业交付物质量
-
自主任务长度
-
人---Agent 生产力
GDPval 中前沿系统已在部分设置中接近专家交付物质量;RLI 使用更端到端的远程工作项目,原始论文中最高 Agent 自动化率为 2.5%。
Artificial Analysis 还提供 GDPval-AA v2 与 APEX-Agents-AA 等独立运行版本。它的增量价值在于独立运行、模型横向比较,以及对成本、token 和执行时间的统一报告。
的 2025 年随机实验发现,在其样本中,经验丰富的开源开发者使用当时 AI 工具后完成任务慢了 19%,但事后仍认为自己快了约 20%。
因此:
基准能力 ≠ 自主工作 ≠ 人类生产力提升
安全
测试间接提示注入;
测试多阶段恶意工具任务;
关注隐蔽有害行为。
Agent 安全包括:
-
恶意目标遵从
-
间接提示注入
-
越权与隐私泄漏
-
reward hacking
-
evaluator manipulation
-
monitor evasion
-
interruption 与纠正
-
不可逆副作用
发现,不同安全 benchmark 测量的行为并不相同;在 R-Judge 上,"永远预测有风险"的平凡策略就能获得 0.690 F₁。
十、决定一张分数值多少钱的七个问题
-
构念效度:Benchmark 真测到了它声称的能力吗?
-
结果效度:Verifier 判定的成功是真的吗?
-
可靠性:是偶尔成功,还是多次稳定成功?
-
奖励黑客:Agent 完成了任务,还是攻破了测量?
-
Judge 效度:自动判官是在稳定判断,还是稳定判错?
-
归因与成本:提升来自模型、scaffold,还是更多预算?
-
证据治理:谁运行、谁审计、谁能独立复现?
需要特别区分:多次尝试中至少成功一次;
以及:连续 k 次全部成功。
前者更接近能力上限,后者更接近部署可靠性。
成熟 Agent Eval 的基本报告单位不再是一个分数,而是:
(成功率、可靠性、成本、延迟、风险、人为干预)
十一、下一阶段
未来变化可以压缩成四条。
- Benchmark 环境化
训练、开发、回归与评测会共享更多环境基础设施。静态题库将被持续更新、自动生成、对抗加固和 future-resolved evaluation 补充。
- 单一分数退场
可靠性、成本、延迟、恢复率和风险将成为默认报告项。Memory、Skills 与 Multi-agent 也会从"看起来有效"走向因果和预算对齐评测。
- 评测对象扩展到人和组织
证据链将从 Agent capability 延伸到 human uplift、工作流影响和经济结果。
所代表的小样本、高保真真实任务,会成为封闭 benchmark 的重要补充。
- 可验证性成为核心瓶颈
容易自动判分的能力会被快速优化;最重要的真实能力却往往难以写进 grader:
-
选择值得解决的问题
-
在模糊需求下判断
-
处理价值冲突
-
知道何时停止
-
知道何时向人求助
-
对长期后果负责
未来真正重要的突破,可能不是更大的测试集,而是:
将难以判分的能力,转化为可信、抗操纵、能预测真实结果的监督信号。
对 Agent Builder 来说,Eval 应是 Agent 的控制系统,而不只是发布前的排行榜。围绕真实任务同时衡量成功率、可靠性、成本和风险,保留轨迹、持续回归,并让 Agent 的权限与证据匹配:能力越可信,自主权才越大。
结语
2023 年,我们问:
Agent 能不能在环境里完成任务?
到 2026 年,真正的问题已经变成:
当 Agent 会长期行动、识别评测、寻找捷径、调用真实工具并影响组织时,我们如何证明高分代表可部署能力,而不是对测量机制的适应?
一张 Agent Eval 分数,需要经过下面这条证据链:
原始分数 → 有效构念 → 真实结果 → 可靠行为 → 公平归因 → 独立审计 → 与决策相关的主张
Agent Eval 的终局不会是一张更大的排行榜。
它会成为自主数字系统的基础设施:既提供训练信号,也定义安全边界,并决定我们愿意把多少权限、资源与责任交给 Agent。
真正重要的,不只是让 Agent 通过更多测试,而是回答:
它在什么条件下值得信任? 当它不值得信任时,我们能否及时知道?