✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
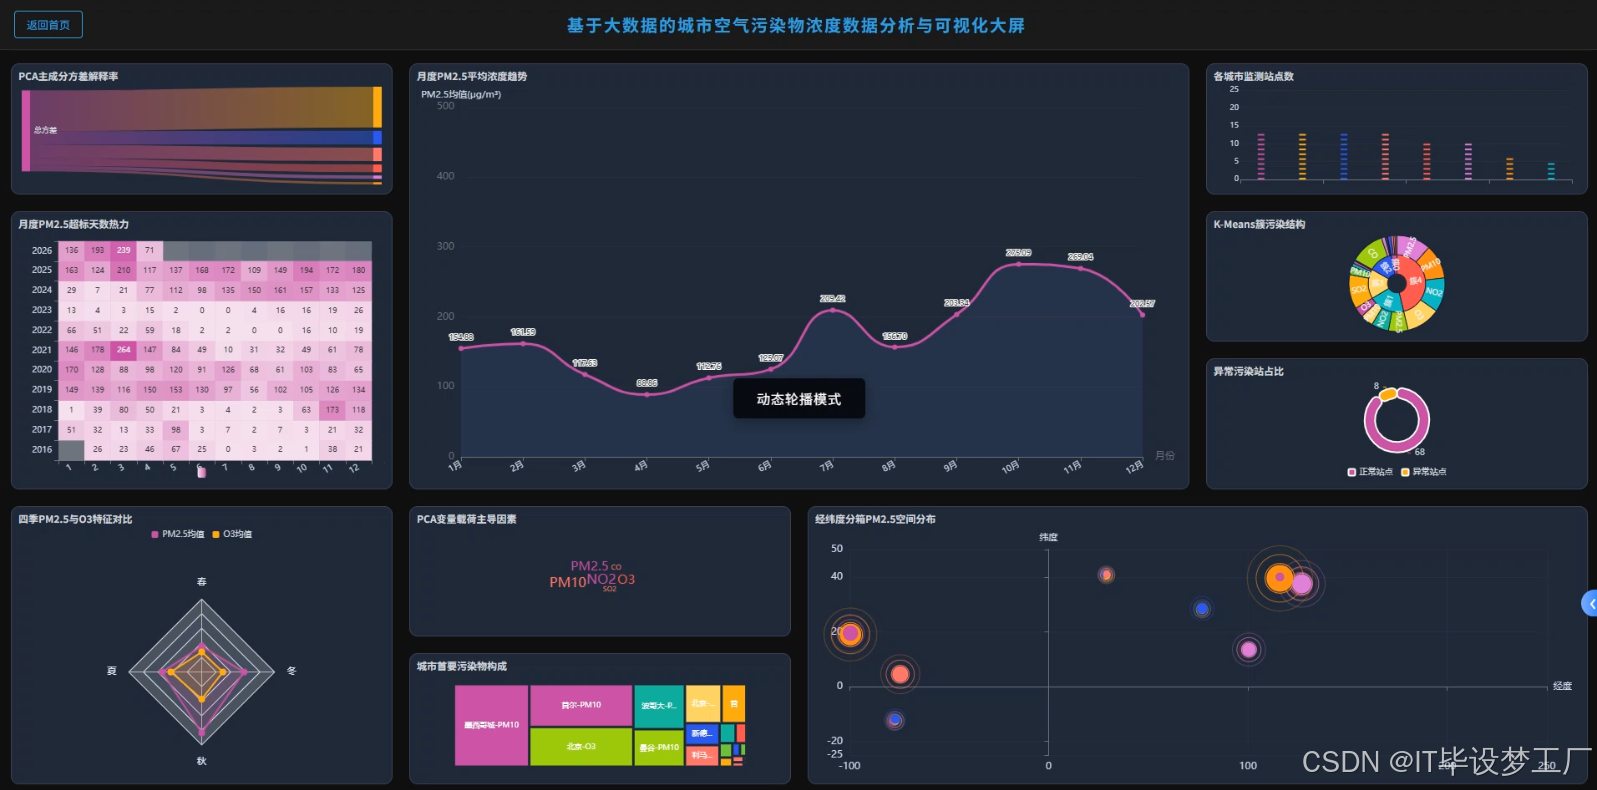
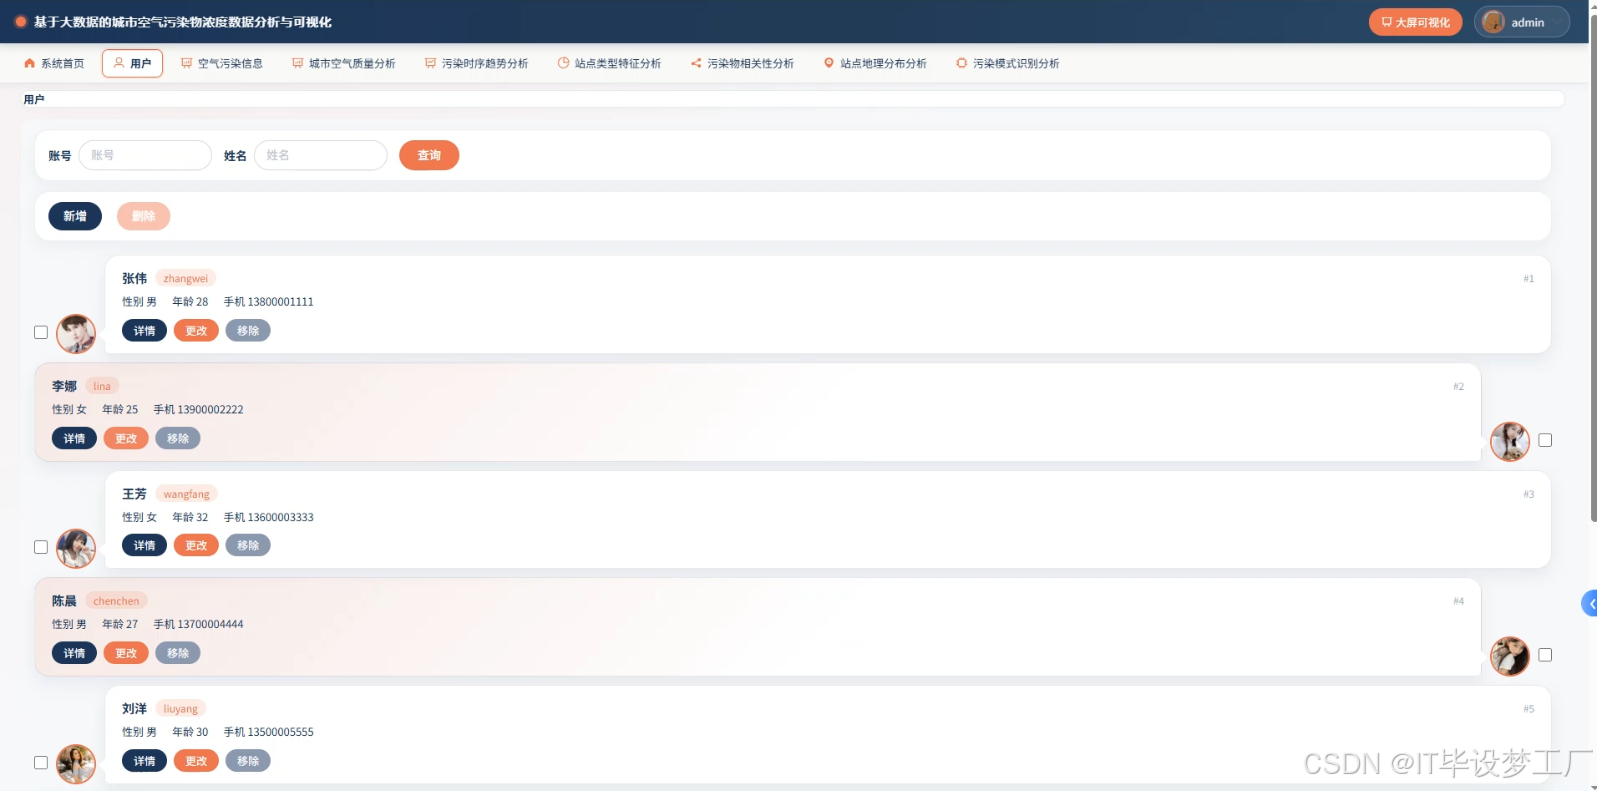
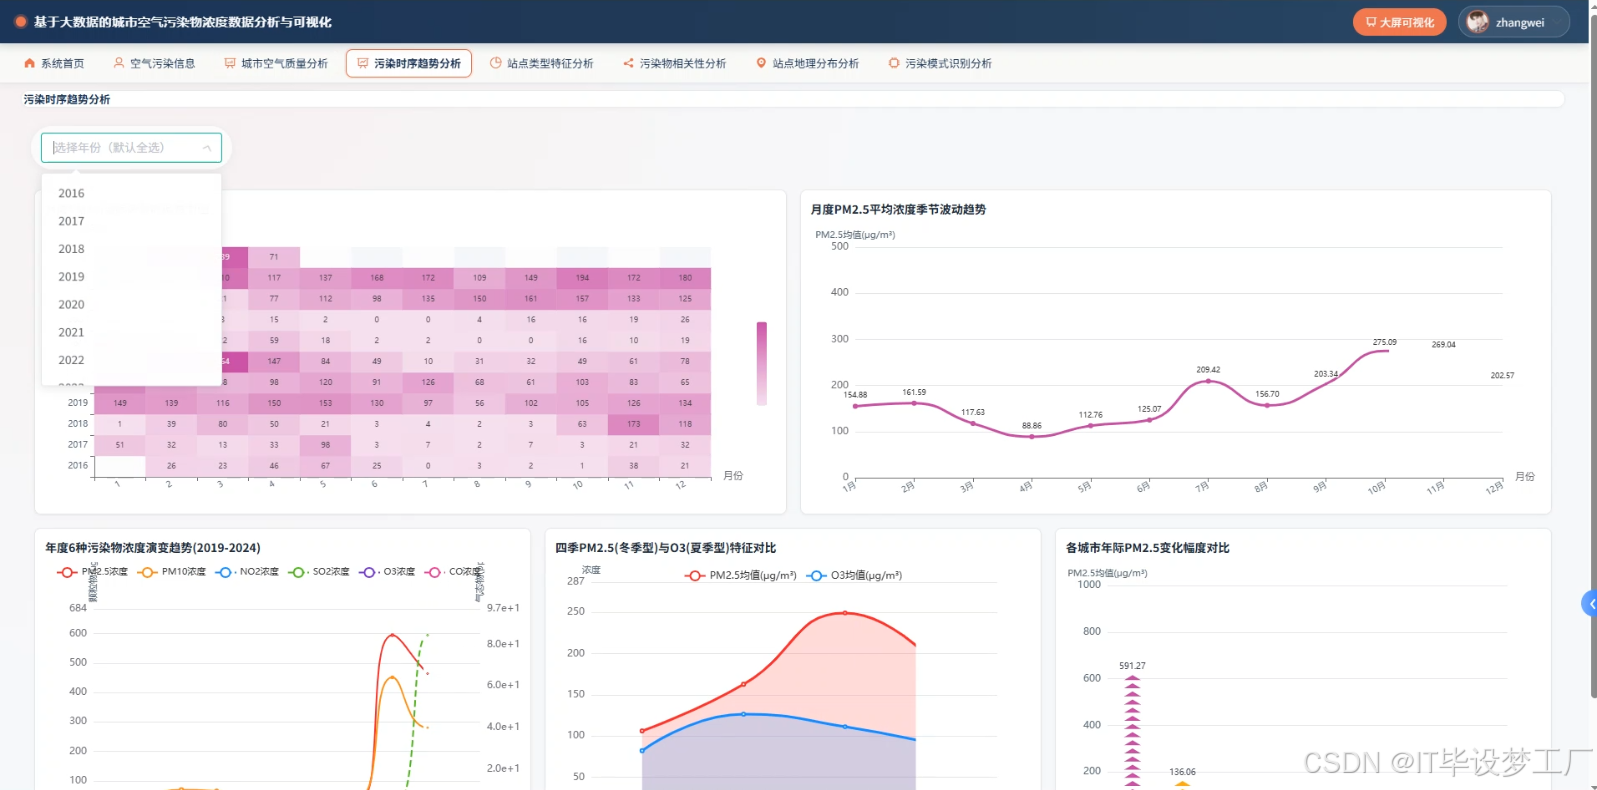
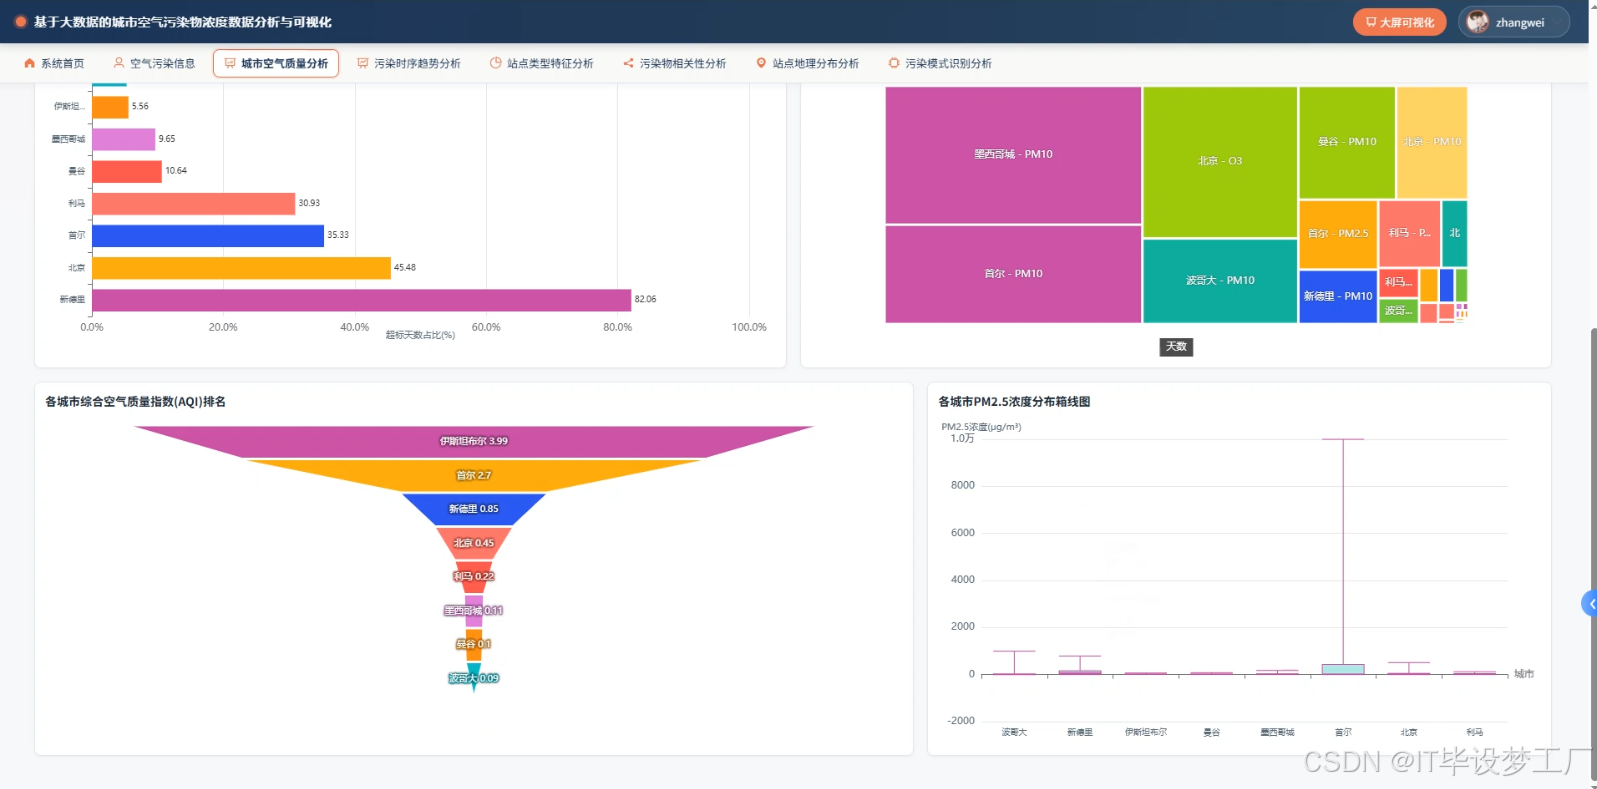
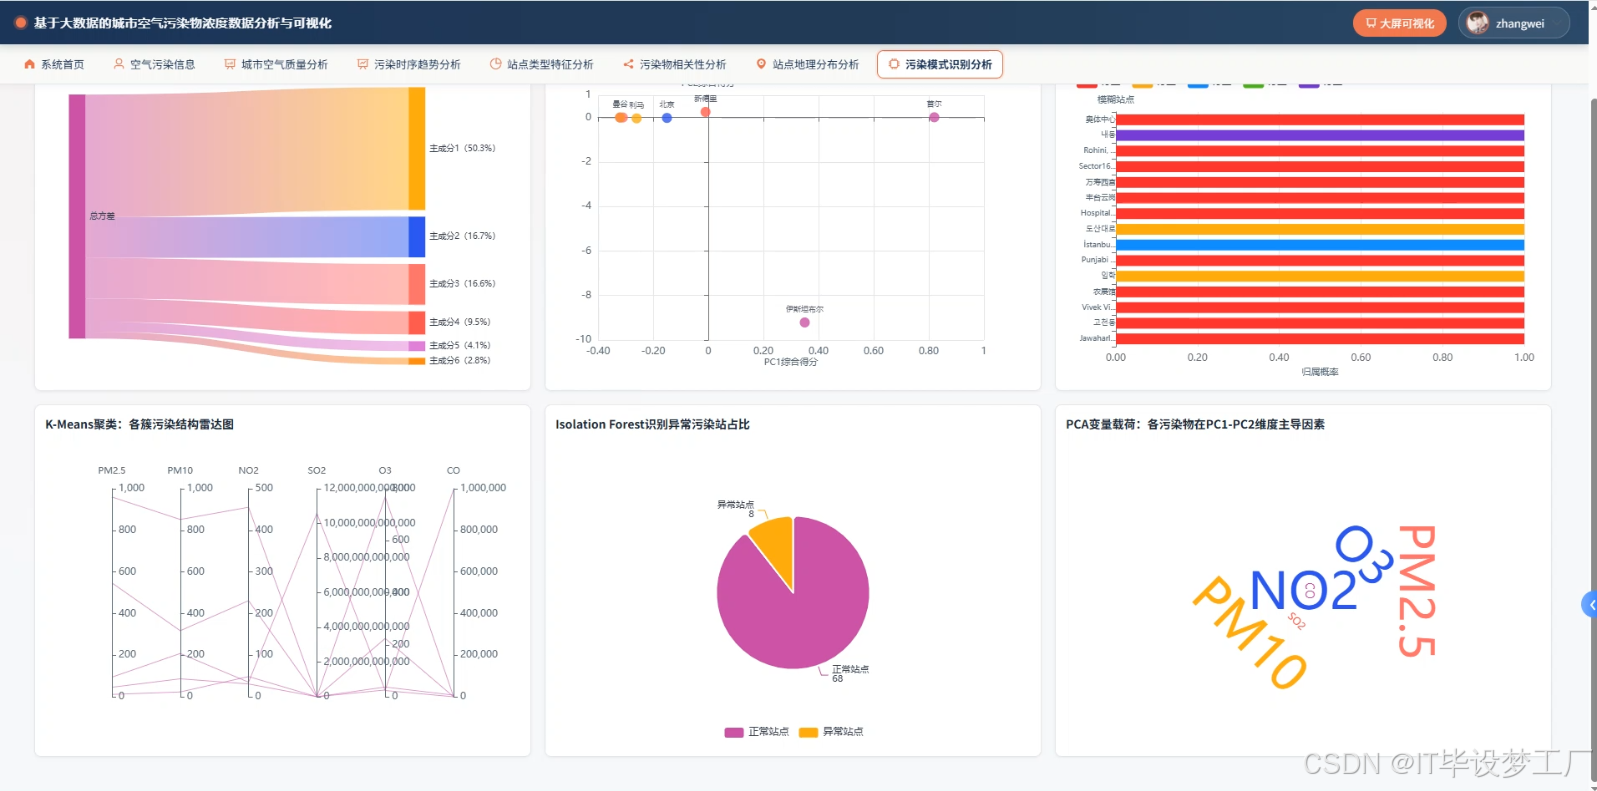
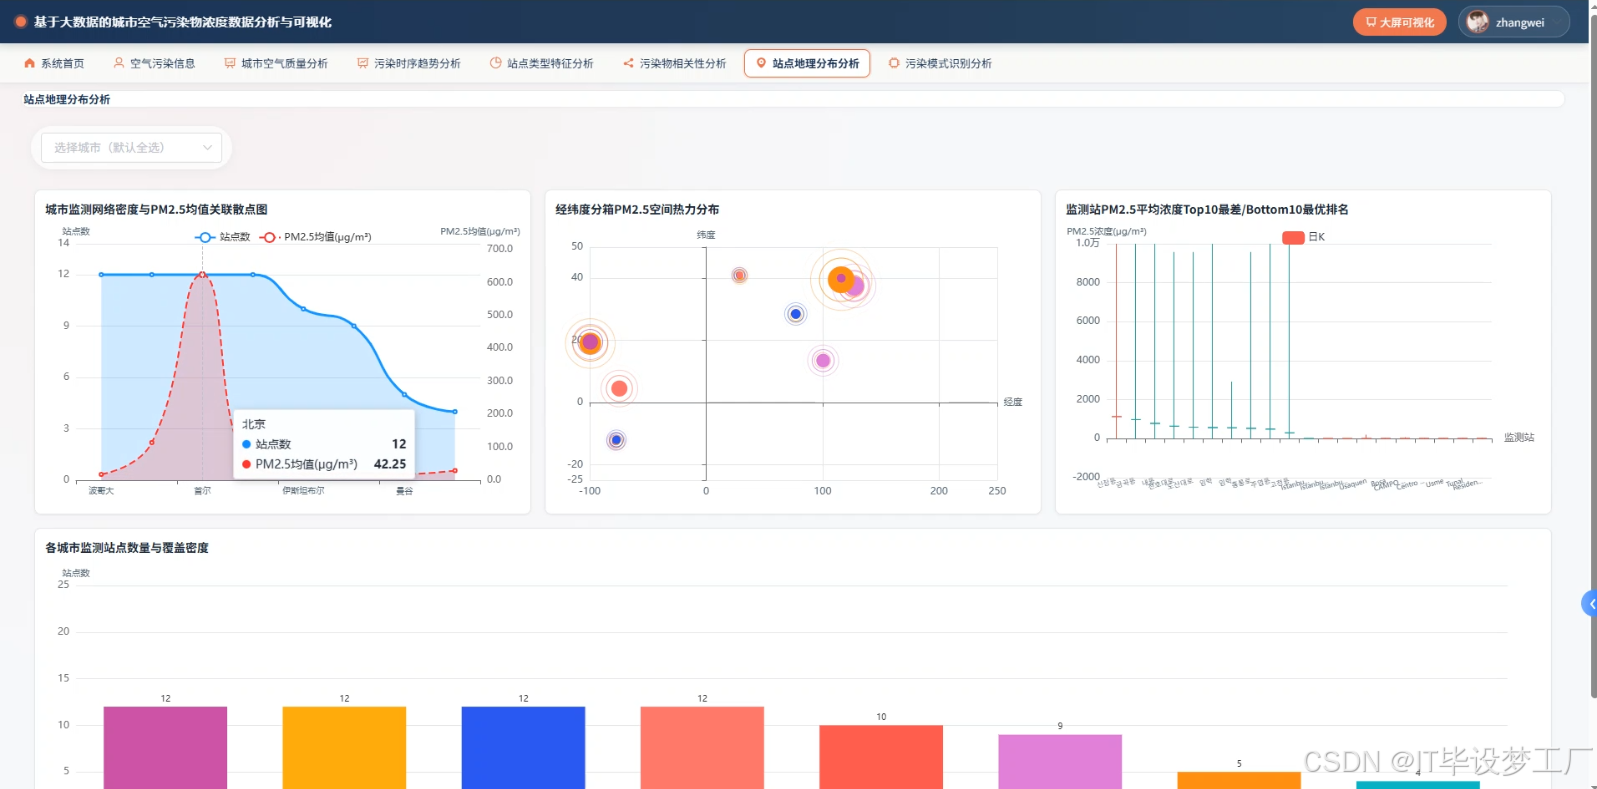
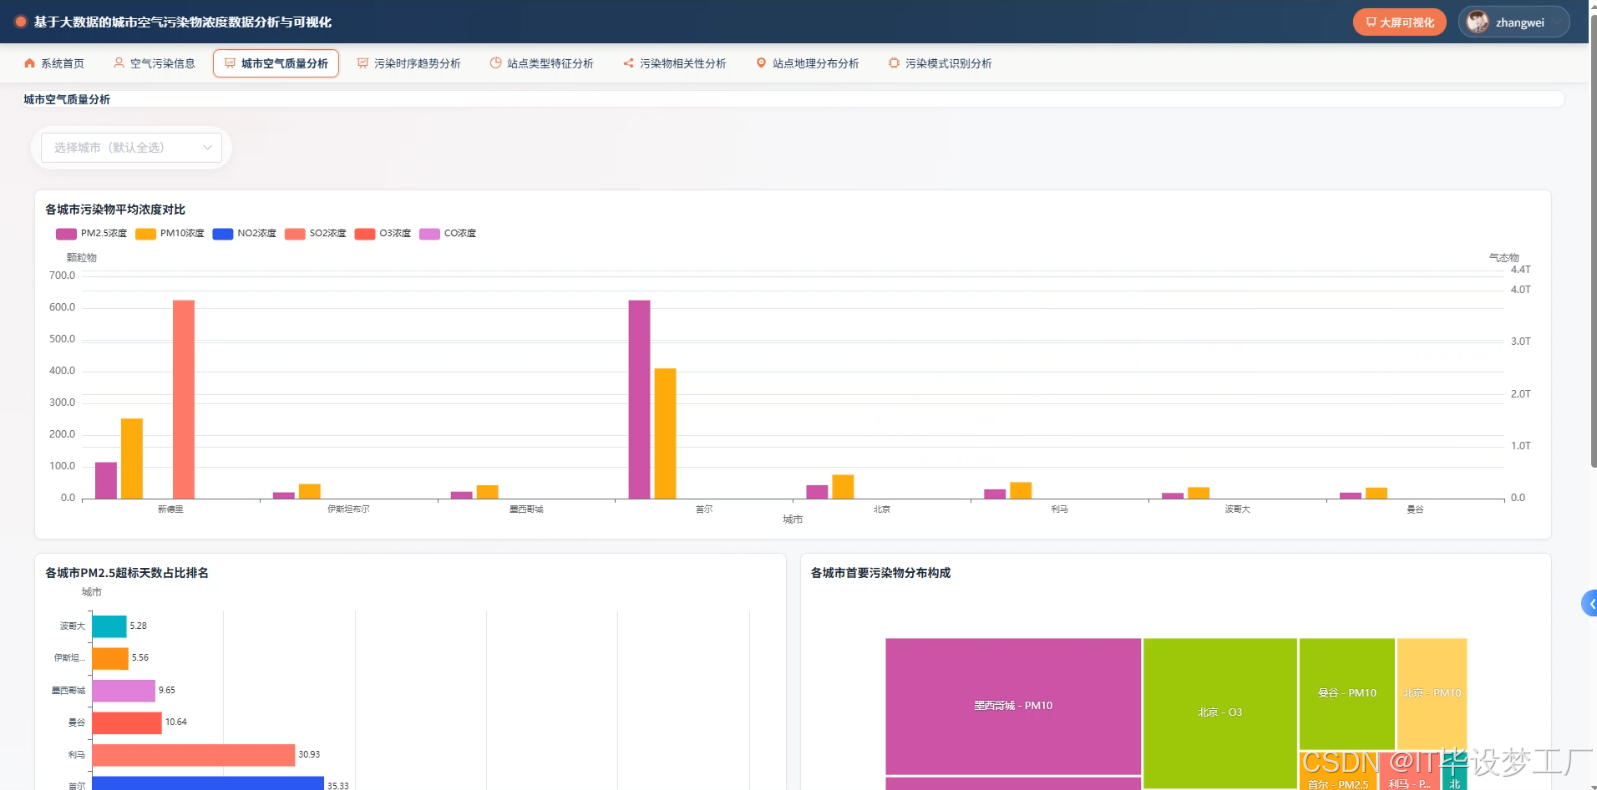
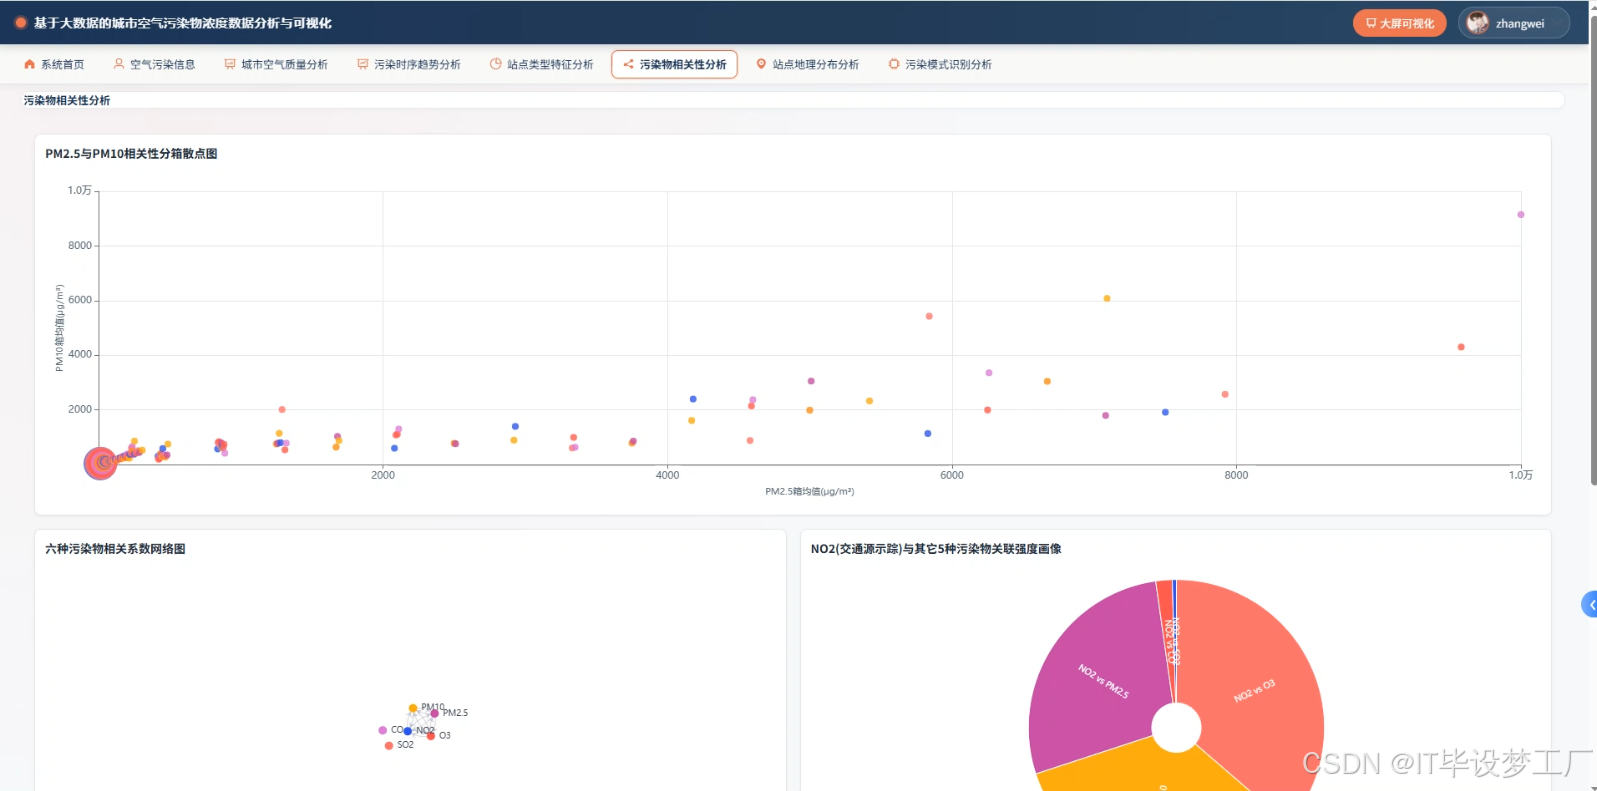
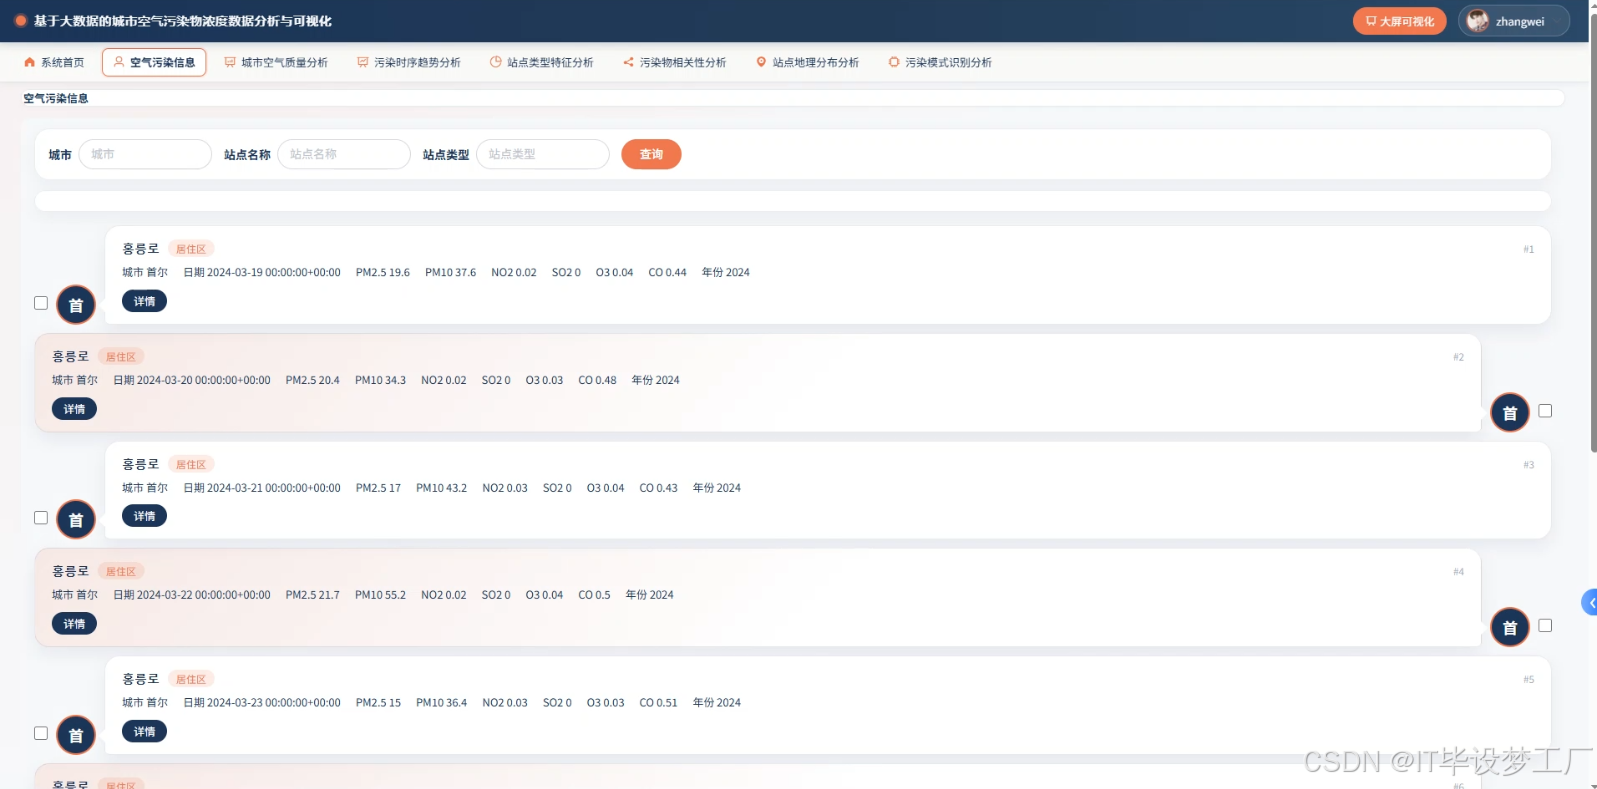
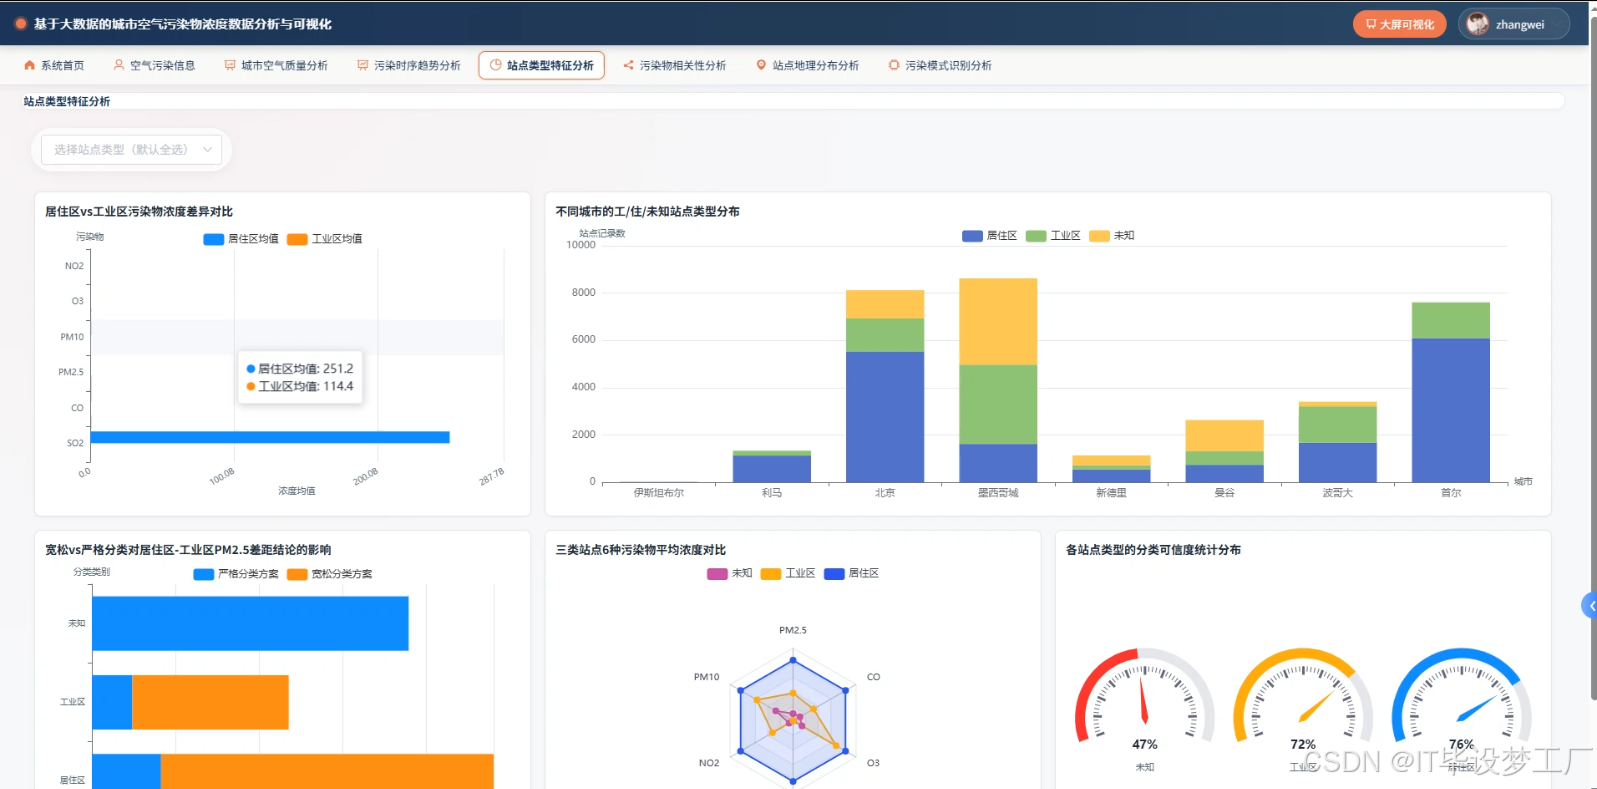
本系统名为《基于大数据的城市空气污染物浓度数据分析与可视化》,主要面向城市空气污染数据展开分析与展示。系统以Hadoop和Spark作为大数据处理核心,通过HDFS完成数据存储,借助Spark SQL、Pandas和NumPy对空气污染信息进行清洗、统计和计算,再把结果交给Django或Spring Boot后端进行接口组织,前端使用Vue、ElementUI、Echarts以及HTML、CSS、JavaScript和jQuery完成页面展示。功能上包含系统首页、大屏可视化、用户管理、空气污染信息、城市空气质量分析、污染时序趋势分析、站点类型特征分析、污染物相关性分析、站点地理分布分析、污染模式识别分析、个人信息和修改密码等模块。用户登录后可以查看不同城市和站点的空气质量情况,也能通过图表观察污染物随时间的变化趋势,比较不同站点类型的污染特征,分析污染物之间的相关程度,并通过地图了解站点分布。系统还尝试对污染模式进行识别,让原本分散的空气污染数据变得更容易理解。整体来说,这个系统把大数据处理、后端接口和可视化展示连在一起,既能完成空气污染数据的分析任务,也能作为一个计算机专业本科毕设项目进行展示和答辩
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的城市空气污染物浓度数据分析与可视化系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, avg, max, min, count, date_format, corr
spark = SparkSession.builder.appName("CityAirPollutionAnalysis").master("local[*]").getOrCreate()
def city_air_quality_analysis(city_name, start_date, end_date):
    df = spark.read.format("csv").option("header", "true").load("hdfs:///air_pollution/data.csv")
    df = df.withColumn("date", date_format(col("monitor_time"), "yyyy-MM-dd"))
    city_df = df.filter((col("city") == city_name) & (col("date") >= start_date) & (col("date") <= end_date))
    result = city_df.groupBy("date").agg(avg("pm25").alias("avg_pm25"), avg("pm10").alias("avg_pm10"), avg("so2").alias("avg_so2"), avg("no2").alias("avg_no2"), avg("co").alias("avg_co"), avg("o3").alias("avg_o3"), max("aqi").alias("max_aqi"), min("aqi").alias("min_aqi"), count("station_id").alias("record_count"))
    result = result.orderBy("date")
    quality_list = result.collect()
    return quality_list
def pollution_time_trend_analysis(city_name, pollutant_type):
    df = spark.read.format("csv").option("header", "true").load("hdfs:///air_pollution/data.csv")
    df = df.withColumn("date", date_format(col("monitor_time"), "yyyy-MM-dd"))
    city_df = df.filter(col("city") == city_name)
    if pollutant_type == "pm25":
        trend_df = city_df.groupBy("date").agg(avg("pm25").alias("avg_value"))
    elif pollutant_type == "pm10":
        trend_df = city_df.groupBy("date").agg(avg("pm10").alias("avg_value"))
    elif pollutant_type == "so2":
        trend_df = city_df.groupBy("date").agg(avg("so2").alias("avg_value"))
    else:
        trend_df = city_df.groupBy("date").agg(avg("pm25").alias("avg_value"))
    trend_df = trend_df.orderBy("date")
    trend_list = trend_df.collect()
    return trend_list
def pollutant_correlation_analysis(city_name):
    df = spark.read.format("csv").option("header", "true").load("hdfs:///air_pollution/data.csv")
    city_df = df.filter(col("city") == city_name)
    corr_pm25_pm10 = city_df.stat.corr("pm25", "pm10")
    corr_pm25_so2 = city_df.stat.corr("pm25", "so2")
    corr_pm25_no2 = city_df.stat.corr("pm25", "no2")
    corr_pm10_so2 = city_df.stat.corr("pm10", "so2")
    corr_so2_no2 = city_df.stat.corr("so2", "no2")
    corr_result = {"pm25_pm10": corr_pm25_pm10, "pm25_so2": corr_pm25_so2, "pm25_no2": corr_pm25_no2, "pm10_so2": corr_pm10_so2, "so2_no2": corr_so2_no2}
    return corr_result
五、论文参考
- 计算机毕业设计选题推荐-基于大数据的城市空气污染物浓度数据分析与可视化系统-论文参考:
六、系统视频
- 基于大数据的城市空气污染物浓度数据分析与可视化系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的城市空气污染物浓度数据分析与可视化|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇