1. redis-cli 的两种连接方式
redis-cli 是Redis客户端工具,有交互式、命令式两种使用方式。
1.1 交互式方式
使用命令 redis-cli -h {host} -p {port} 连接Redis服务,连接成功后,后续所有命令直接在客户端提示符内执行,不需要重复输入redis-cli。
示例:
sql
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379
127.0.0.1:6379> ping
PONG
127.0.0.1:6379> set key hello
OK
127.0.0.1:6379> get key
"hello"
1.2 命令式方式
redis-cli -h {host} -p {port} {command},在一条shell命令里直接执行Redis指令,执行完立刻返回结果,不会进入redis交互终端。
示例:
sql
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379 ping
PONG
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379 set key hello
OK
[root@host ~]# redis-cli -h 127.0.0.1 -p 6379 get key
"hello"
注意:
① 本机127.0.0.1、默认端口6379时,可以省略 -h 和 -p 参数,直接写redis-cli。
② redis-cli是学习Redis的核心工具。
1.3 客户端服务端交互流程
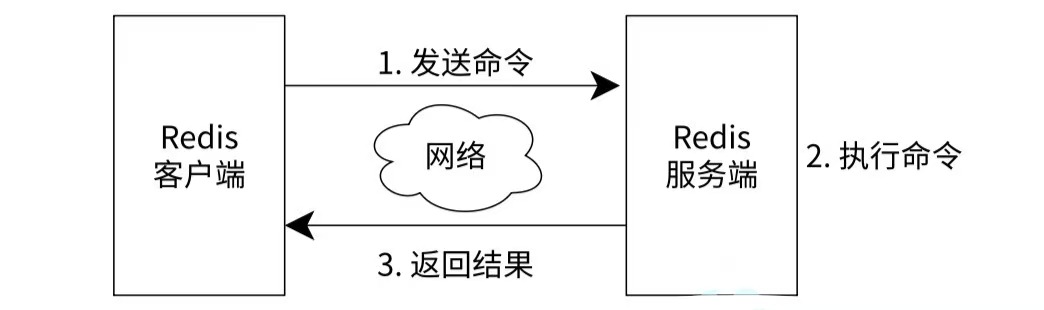
-
Redis客户端 通过网络 发送命令给Redis服务端
-
Redis服务端执行这条命令
-
服务端将执行结果,通过网络返回客户端
2. Redis的8个核心特性
-
速度快
-
基于键值对的数据结构服务器
-
功能丰富
-
简单稳定
-
支持多语言客户端
-
持久化
-
主从复制
-
支持高可用和分布式
补充:Redis不是万能的,部分业务场景不适合使用Redis;读懂源码、结合开发运维是用好Redis的方法。
3. Redis 5种对外数据结构
string(字符串)、list(列表)、hash(哈希)、set(集合)、zset(有序集合)
重点:这5种是对外暴露的数据结构,底层还有多种内部编码实现,对使用者透明。
4. 全局通用命令(所有类型key都能用)
4.1 KEYS
作用:返回所有匹配模式pattern的key,支持通配符匹配
?:匹配单个任意字符
h?llo:匹配 hello、hallo、hxllo
*:匹配0个或多个任意字符
h*llo:匹配 hllo、heeeello
ae:匹配括号内任意一个字符
haello:匹配 hello、hallo,不匹配 hillo
\^e:匹配不是括号内的字符
h\^ello:匹配 hallo、hbllo,不匹配 hello
a-b:匹配a到b范围内字符
ha-bllo:匹配 hallo、hbllo
语法:
sql
KEYS pattern时间复杂度:O(N)
返回值:所有匹配pattern的key列表
示例:
sql
redis> MSET firstname Jack lastname Stuntman age 35
OK
redis> KEYS *name*
1) "firstname"
2) "lastname"
redis> KEYS a??
1) "age"
redis> KEYS *
1) "age"
2) "firstname"
3) "lastname"
⚠️提示:KEYS命令会遍历全部key,数据量大时阻塞Redis,生产环境禁止使用。
4.2 EXISTS
作用:判断一个/多个key是否存在
语法:
sql
EXISTS key [key ...]时间复杂度:O(1)
返回值:存在的key的总数量
示例:
sql
redis> SET key1 "Hello"
OK
redis> EXISTS key1
(integer) 1
redis> EXISTS nosuchkey
(integer) 0
redis> SET key2 "World"
OK
redis> EXISTS key1 key2 nosuchkey
(integer) 2
4.3 DEL
作用:删除指定的key,可以一次性删除多个key
语法:
sql
DEL key [key ...]时间复杂度:O(1)
返回值:成功删除的key的个数
示例:
sql
redis> SET key1 "Hello"
OK
redis> SET key2 "World"
OK
redis> DEL key1 key2 key3
(integer) 2
4.4 EXPIRE
作用:给key设置秒级过期时间(TTL,Time To Live),到期后key自动被删除
语法:
sql
EXPIRE key seconds时间复杂度:O(1)
返回值:1=设置成功;0=设置失败
示例:
sql
redis> SET mykey "Hello"
OK
redis> EXPIRE mykey 10
(integer) 1
redis> TTL mykey
(integer) 10
配套:PEXPIRE 是毫秒版本的过期命令。
4.5 TTL
作用:查询key剩余的过期时间,单位秒
语法:
sql
TTL key时间复杂度:O(1)
返回值:
正数:剩余多少秒过期
-1:key存在,没有设置过期时间
-2:key不存在
示例:
sql
redis> SET mykey "Hello"
OK
redis> EXPIRE mykey 10
(integer) 1
redis> TTL mykey
(integer) 10
配套:PTTL,返回毫秒级剩余过期时间。
过期时间轴逻辑:
-
set key value 创建key
-
expire key n 设置n秒过期
-
可以用get读取value
-
n秒之后,Redis自动淘汰删除该key,exists查询返回不存在
4.6 TYPE
作用:查询key对应的对外数据结构类型
语法:
sql
TYPE key时间复杂度:O(1)
示例:
sql
redis> SET key1 "value"
OK
redis> LPUSH key2 "value"
(integer) 1
redis> SADD key3 "value"
(integer) 1
redis> TYPE key1
"string"
redis> TYPE key2
"list"
redis> TYPE key3
"set"
4.7 OBJECT encoding
作用:查看key底层内部编码
示例:
sql
127.0.0.1:6379> set hello world
OK
127.0.0.1:6379> lpush mylist a b c
(integer) 3
127.0.0.1:6379> object encoding hello
"embstr"
127.0.0.1:6379> object encoding mylist
"quicklist"
5. Redis 数据结构与底层内部编码
核心知识点:TYPE看到的是对外的数据结构;底层有多种内部编码。Redis会自动选择最合适的底层编码,对上层用户无感知。
|--------|---------------------------------|
| 对外数据结构 | 底层内部编码 |
| string | raw、int、embstr |
| hash | hashtable、ziplist |
| list | linkedlist、ziplist(新版quicklist) |
| set | hashtable、intset |
| zset | skiplist、ziplist |
5.1 多内部编码设计的两大好处
-
对外接口不变,底层可升级:底层编码可以优化迭代,上层命令完全不用改动。例如Redis3.2推出quicklist,替换旧list底层实现,用户不需要修改代码。
-
适配不同场景,节省内存:小数据使用ziplist节省内存;数据量大自动切换成hashtable/skiplist提升性能,整个切换过程用户无感知。
6. Redis单线程架构
6.1 引出单线程模型
现在开启了三个redis-cli客户端同时执行命令。
客户端1设置一个字符串键值对:
127.0.0.1:6379> set hello world客户端2对counter做自增操作:
127.0.0.1:6379> incr counter客户端3对counter做自增操作:
127.0.0.1:6379> incr counter我们已经知道从客户端发送的命令经历了:发送命令、执行命令、返回结果三个阶段,其中我们重点关注第2步。我们所谓的Redis是采用单线程模型执行命令的是指:虽然三个客户端看起来是同时要求Redis去执行命令的,但微观角度,这些命令还是采用线性方式去执行的,只是原则上命令的执行顺序是不确定的,但一定不会有两条命令被同步执行。可以想象Redis内部只有一个服务窗口,多个客户端按照它们到达的先后顺序被排队在窗口前,依次接受Redis的服务,所以两条incr命令无论执行顺序,结果一定是2,不会发生并发问题,这个就是Redis的单线程执行模型。
• 图2-3:宏观上同时要求服务的客户端
宏观上,3个客户端是同时请求Redis服务的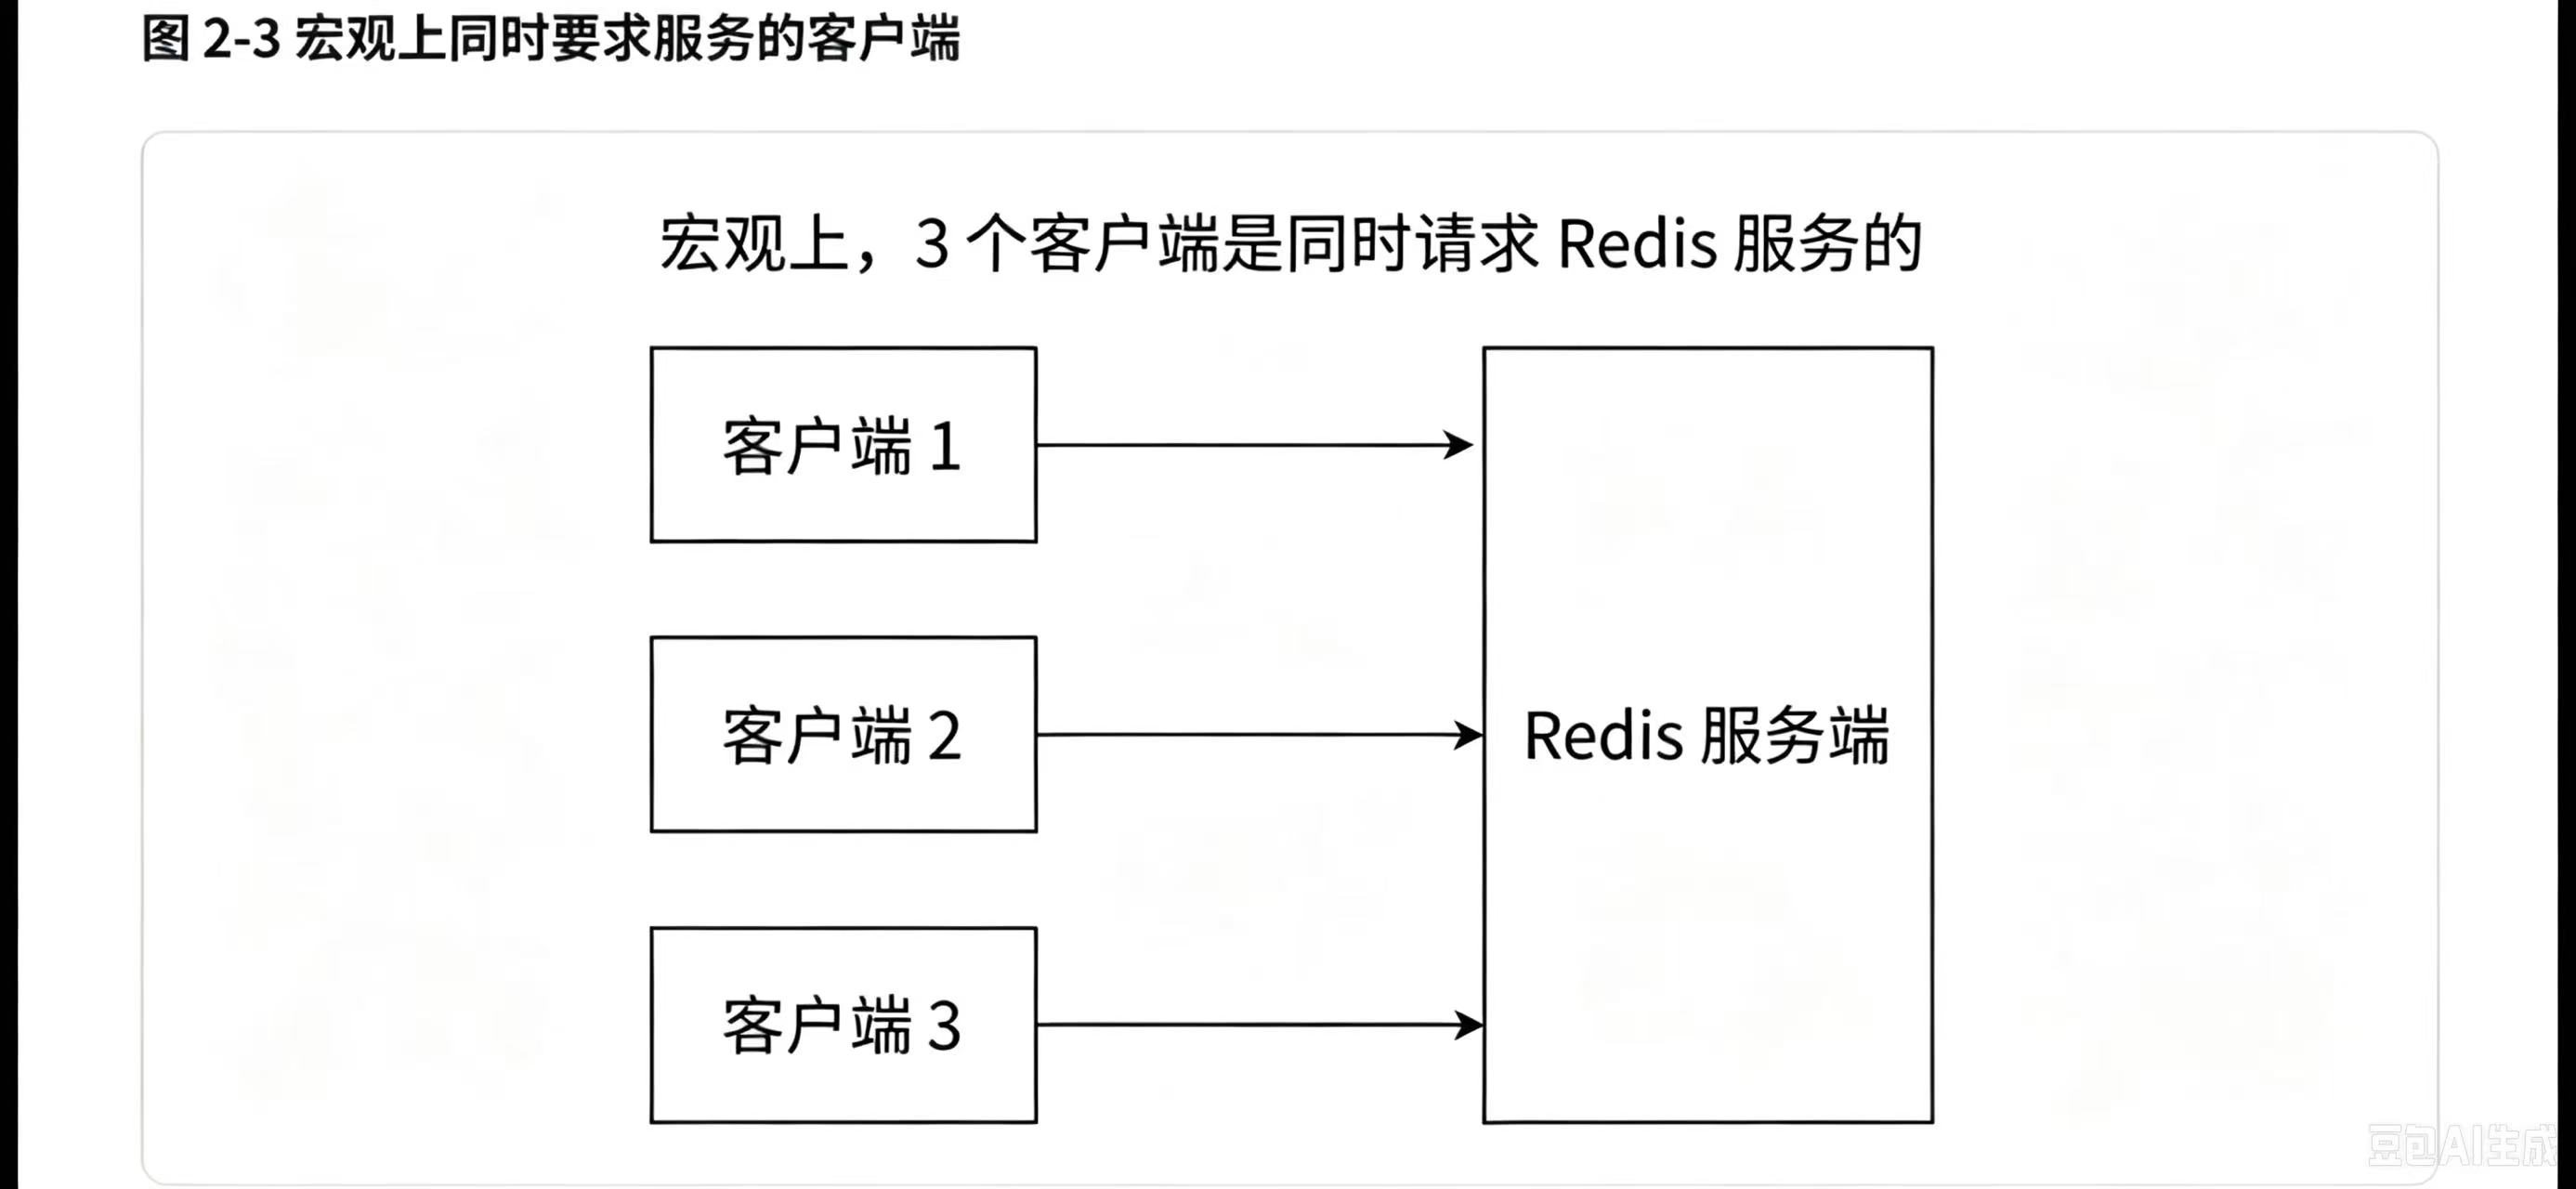
• 图2-4:微观上客户端发送命令的时间有先后次序的
微观上,客户端是有先后次序的,虽然顺序不确定
客户端a、客户端b、客户端c在时间轴上,请求间隔很短,例如:1ms
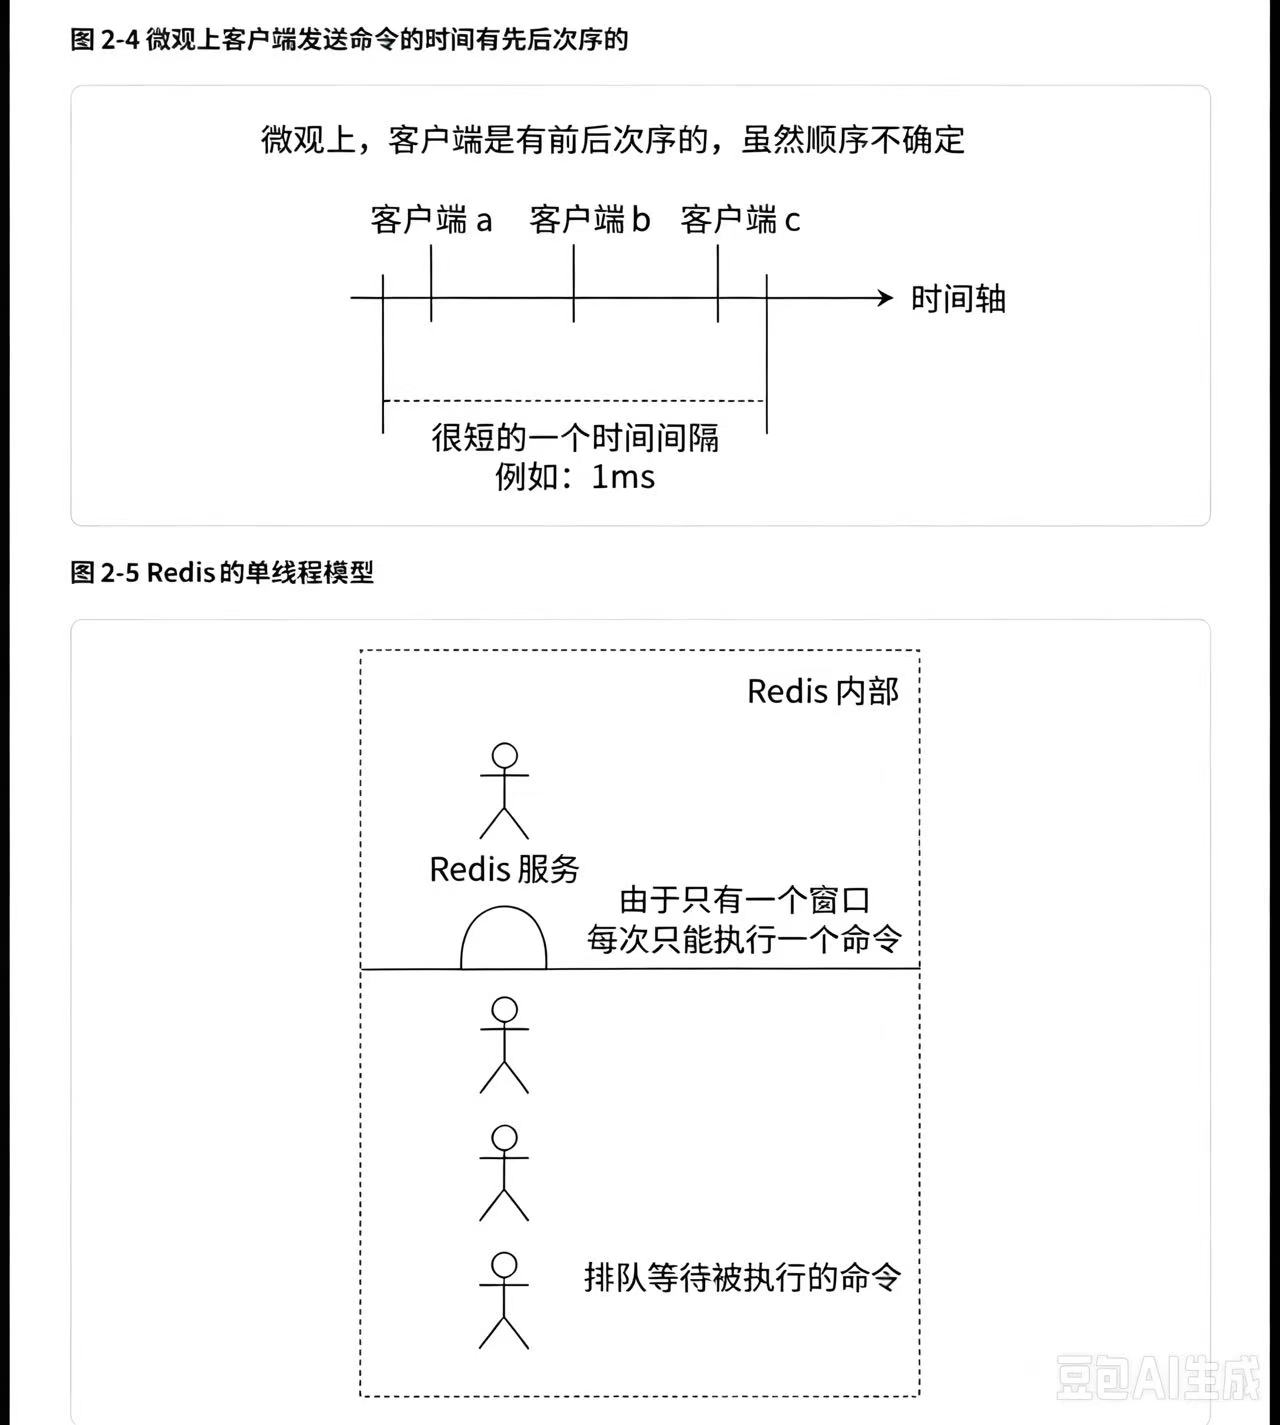
• 图2-5:Redis的单线程模型
Redis内部,Redis服务只有一个窗口,每次只能执行一个命令,其余命令排队等待被执行。
6.2 为什么单线程还能这么快
通常来讲,单线程处理能力要比多线程差,例如有10 000公斤货物,每辆车的运载能力是每次200公斤,那么要50次才能完成;但是如果有50辆车,只要安排合理,只需要依次就可以完成任务。那么为什么Redis使用单线程模型会达到每秒万级别的处理能力呢?可以将其归结为三点:
a. 纯内存访问。Redis将所有数据放在内存中,内存的响应时长大约为100纳秒,这是Redis达到每秒万级别访问的重要基础。
b. 非阻塞IO。Redis使用epoll作为I/O多路复用技术的实现,再加上Redis自身的事件处理模型将epoll中的连接、读写、关闭都转换为事件,不在网络I/O上浪费过多的时间。
c. 单线程避免了线程切换和竞态产生的消耗。单线程可以简化数据结构和算法的实现,让程序模型更简单;其次多线程避免了在线程竞争同一份共享数据时带来的切换和等待消耗。
图2-6 Redis 使用I/O多路复用模型
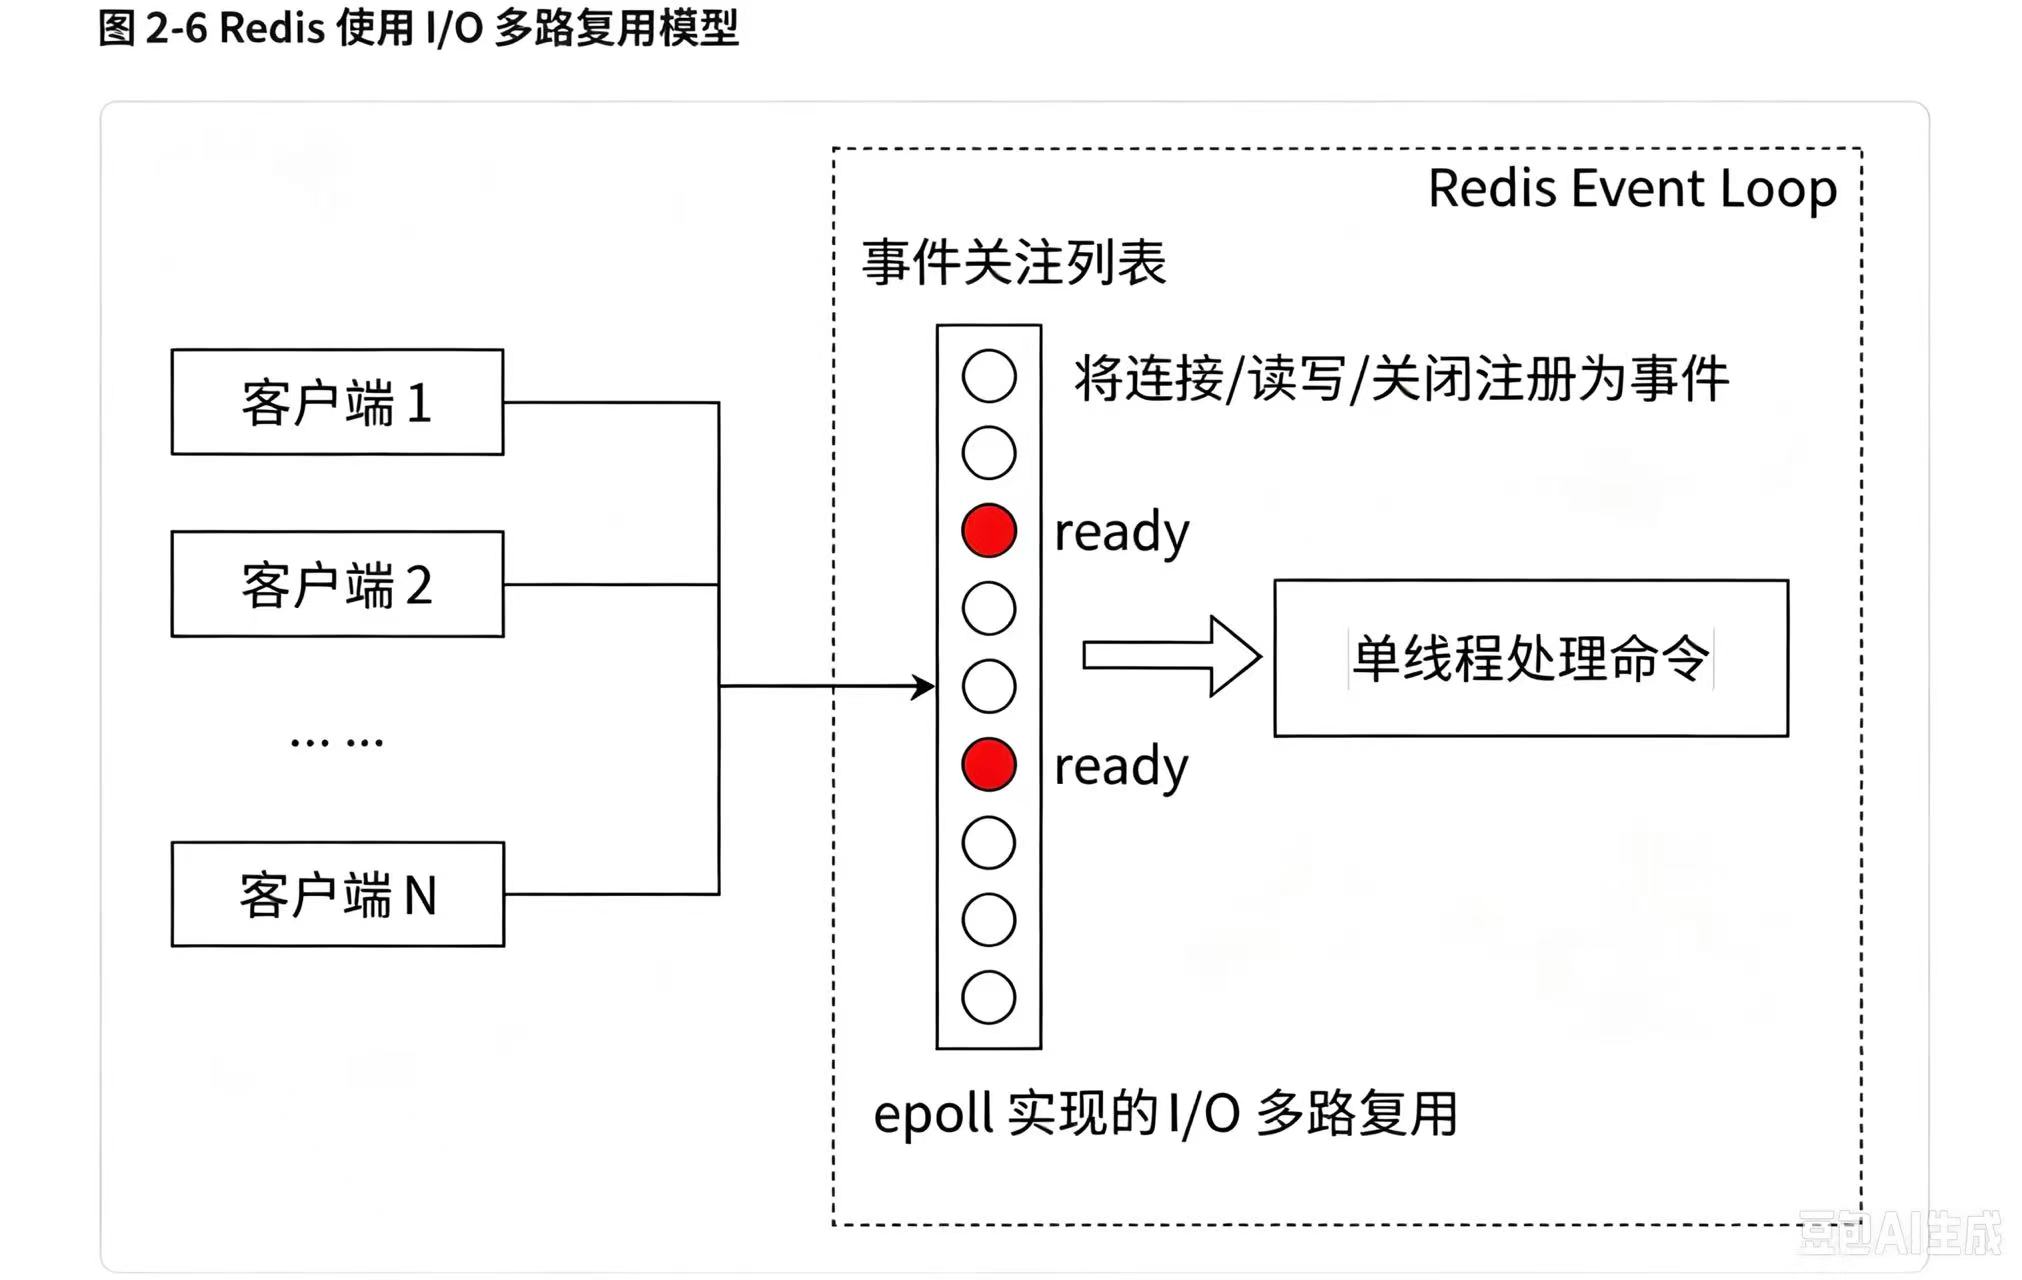
Redis Event Loop:客户端连接注册到事件关注列表,epoll实现I/O多路复用,事件ready后交给单线程处理命令。
⚠️ 单线程致命缺陷:对于单个命令的执行时间有要求。如果某个命令执行过长,会导致其他命令全部处于等待队列中,迟迟等不到响应,造成客户端的阻塞,对于Redis这种高性能的服务来说是非常严重的,所以Redis是面向快速执行场景的数据库。
7. String 字符串
字符串类型是Redis最基础的数据类型,关于字符串需要特别注意:
-
首先Redis中所有的键的类型都是字符串类型,而且其他几种数据结构也都是在字符串类似基础上构建的,例如列表和集合的元素类型是字符串类型,所以字符串类型能为其他4种数据结构的学习奠定基础。
-
字符串类型的值实际可以是字符串,包含一般格式的字符串或者类似JSON、XML格式的字符串;数字,可以是整型或者浮点型;甚至是二进制流数据,例如图片、音频、视频等。不过一个字符串的最大值不能超过512 MB。
💡由于Redis内部存储字符串完全是按照二进制流的形式保存的,所以Redis是不处理字符集编码问题的,客户端传入的命令中使用的是什么字符集编码,就存储什么字符集编码。
图2-7 字符串数据类型示例
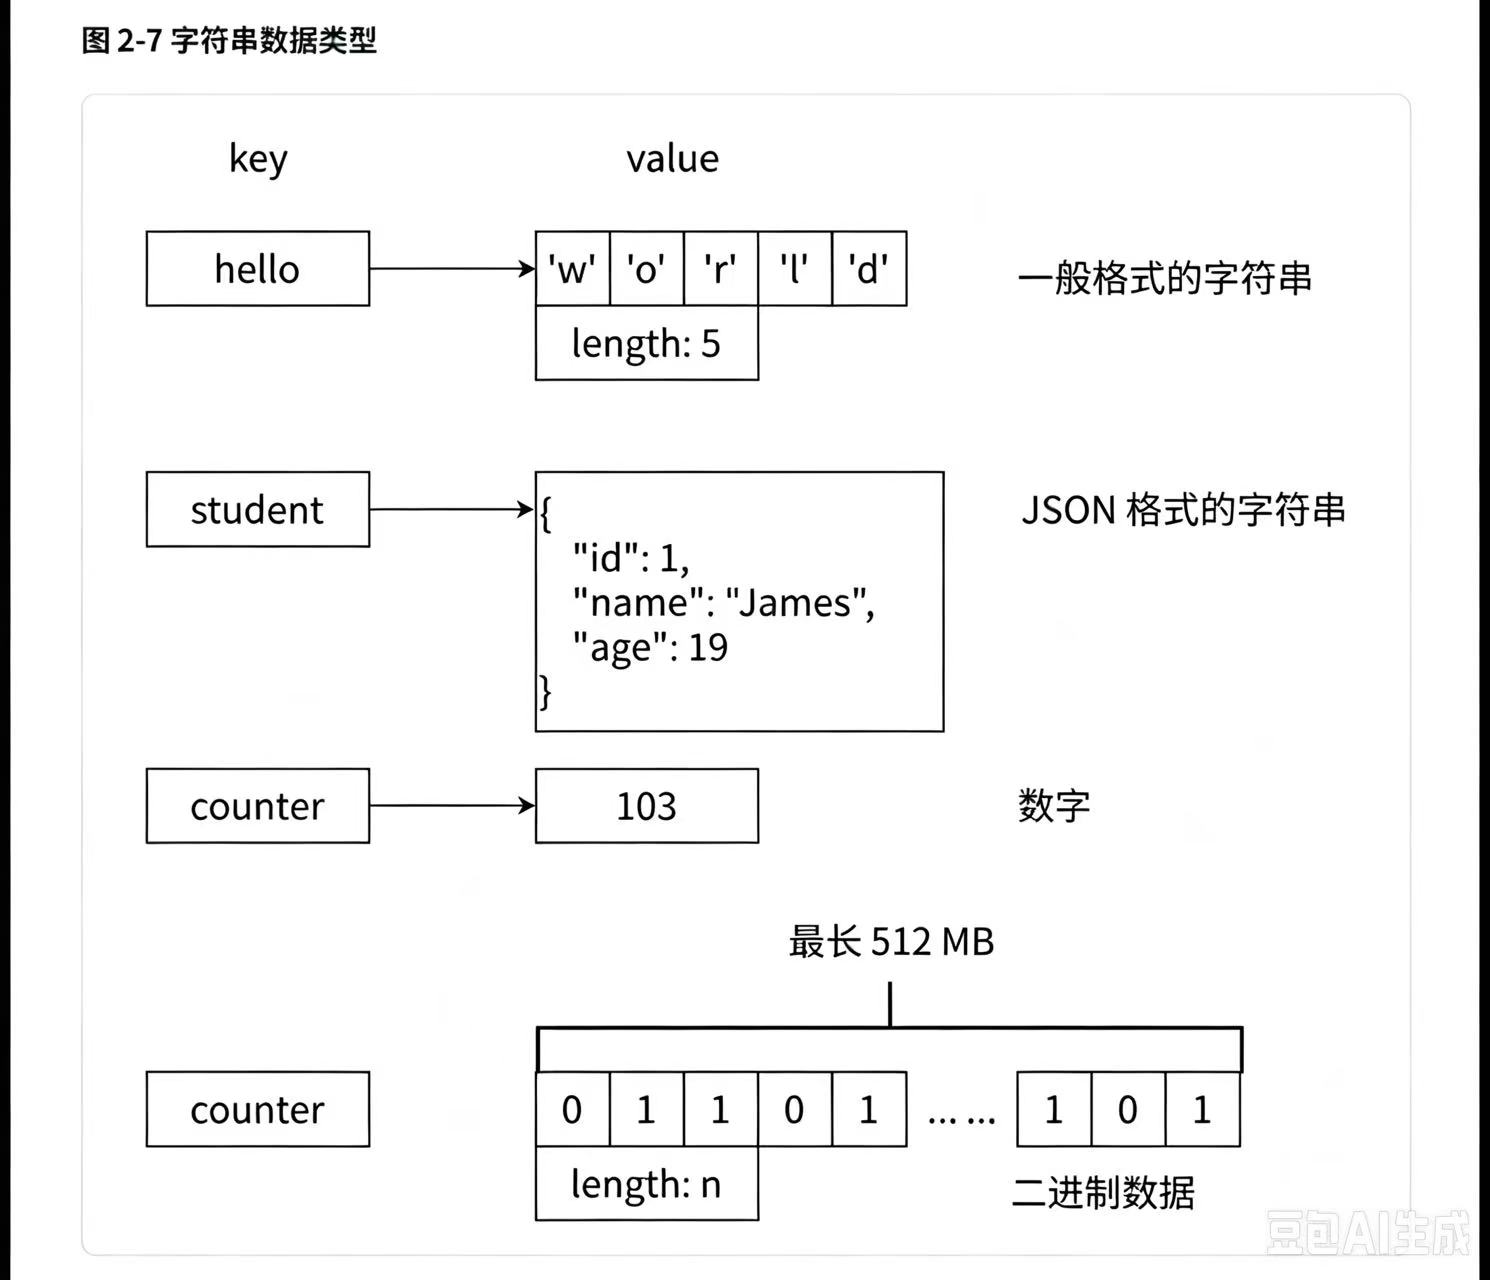
• key:hello → value:"world",普通字符串,length=5
• key:student → value:JSON字符串 {"id":1,"name":"James","age":19}
• key:counter → value:103,数字
• key:counter → 二进制数据流,最长512MB
7.1 常见命令
SET
将string类型的value设置到key中。如果key之前存在,则覆盖,无论原来的数据类型是什么。之前关于此key的TTL也全部失效。
语法:
SET key value [expiration EX seconds|PX milliseconds] [NX|XX]命令有效版本:1.0.0之后
时间复杂度:O(1)
选项:
• EX seconds --- 使用秒作为单位设置key的过期时间。
• PX milliseconds --- 使用毫秒作为单位设置key的过期时间。
• NX --- 只在key不存在时才进行设置,即如果key之前已经存在,设置不执行。
• XX --- 只在key存在时才进行设置,即如果key之前不存在,设置不执行。
注意:由于带选项的SET命令可以被 SETNX、SETEX、PSETEX 等命令代替,所以之后的版本中,Redis可能进行合并。
返回值:
• 如果设置成功,返回 OK。
• 如果由于SET指定了NX或者XX但条件不满足,SET不会执行,并返回 (nil)。
示例:
1 redis> EXISTS mykey
2 (integer) 0
3 redis> SET mykey "Hello"
4 "OK"
5 redis> GET mykey
6 "Hello"
7 redis> SET mykey "World" NX
8 (nil)
9 redis> DEL mykey
10 (integer) 1
11 redis> EXISTS mykey
12 (integer) 0
13 redis> SET mykey "World" XX
14 (nil)
15 redis> GET mykey
16 (nil)
17 redis> SET mykey "World" NX
18 OK
19 redis> GET mykey
20 "World"
21 redis> SET mykey "Will expire in 10s" EX 10
22 OK
23 redis> GET mykey
24 "Will expire in 10s"
25 redis> GET mykey  # 10秒之后
26 (nil)
GET
获取key对应的value。如果key不存在,返回 nil。如果value的数据类型不是string,会报错。
语法:
GET key命令有效版本:1.0.0之后
时间复杂度:O(1)
返回值: key对应的value,或者nil当key不存在。
示例:
1 redis> GET nonexisting
2 (nil)
3 redis> SET mykey "Hello"
4 "OK"
5 redis> GET mykey
6 "Hello"
7 redis> DEL mykey
8 (integer) 1
9 redis> EXISTS mykey
10 (integer) 0
11 redis> HSET mykey name Bob
12 (integer) 1
13 redis> GET mykey
14 (error) WRONGTYPE Operation against a key holding the wrong kind of value
MGET
一次性获取多个key的值。如果对应的key不存在或者对应的数据类型不是string,返回 nil。
语法:
MGET key [key ...]命令有效版本:1.0.0之后
时间复杂度:O(N) N是key数量
返回值: 对应value的列表
示例:
1 redis> SET key1 "Hello"
2 "OK"
3 redis> SET key2 "World"
4 "OK"
5 redis> MGET key1 key2 nonexisting
6 1) "Hello"
7 2) "World"
8 3) (nil)
MSET
一次性设置多个key的值。
语法:
MSET key value [key value ...]命令有效版本:1.0.1之后
时间复杂度:O(N) N是key数量
返回值: 永远是OK
示例:
1 redis> MSET key1 "Hello" key2 "World"
2 "OK"
3 redis> GET key1
4 "Hello"
5 redis> GET key2
6 "World"
图2-8 多次get vs单次mget
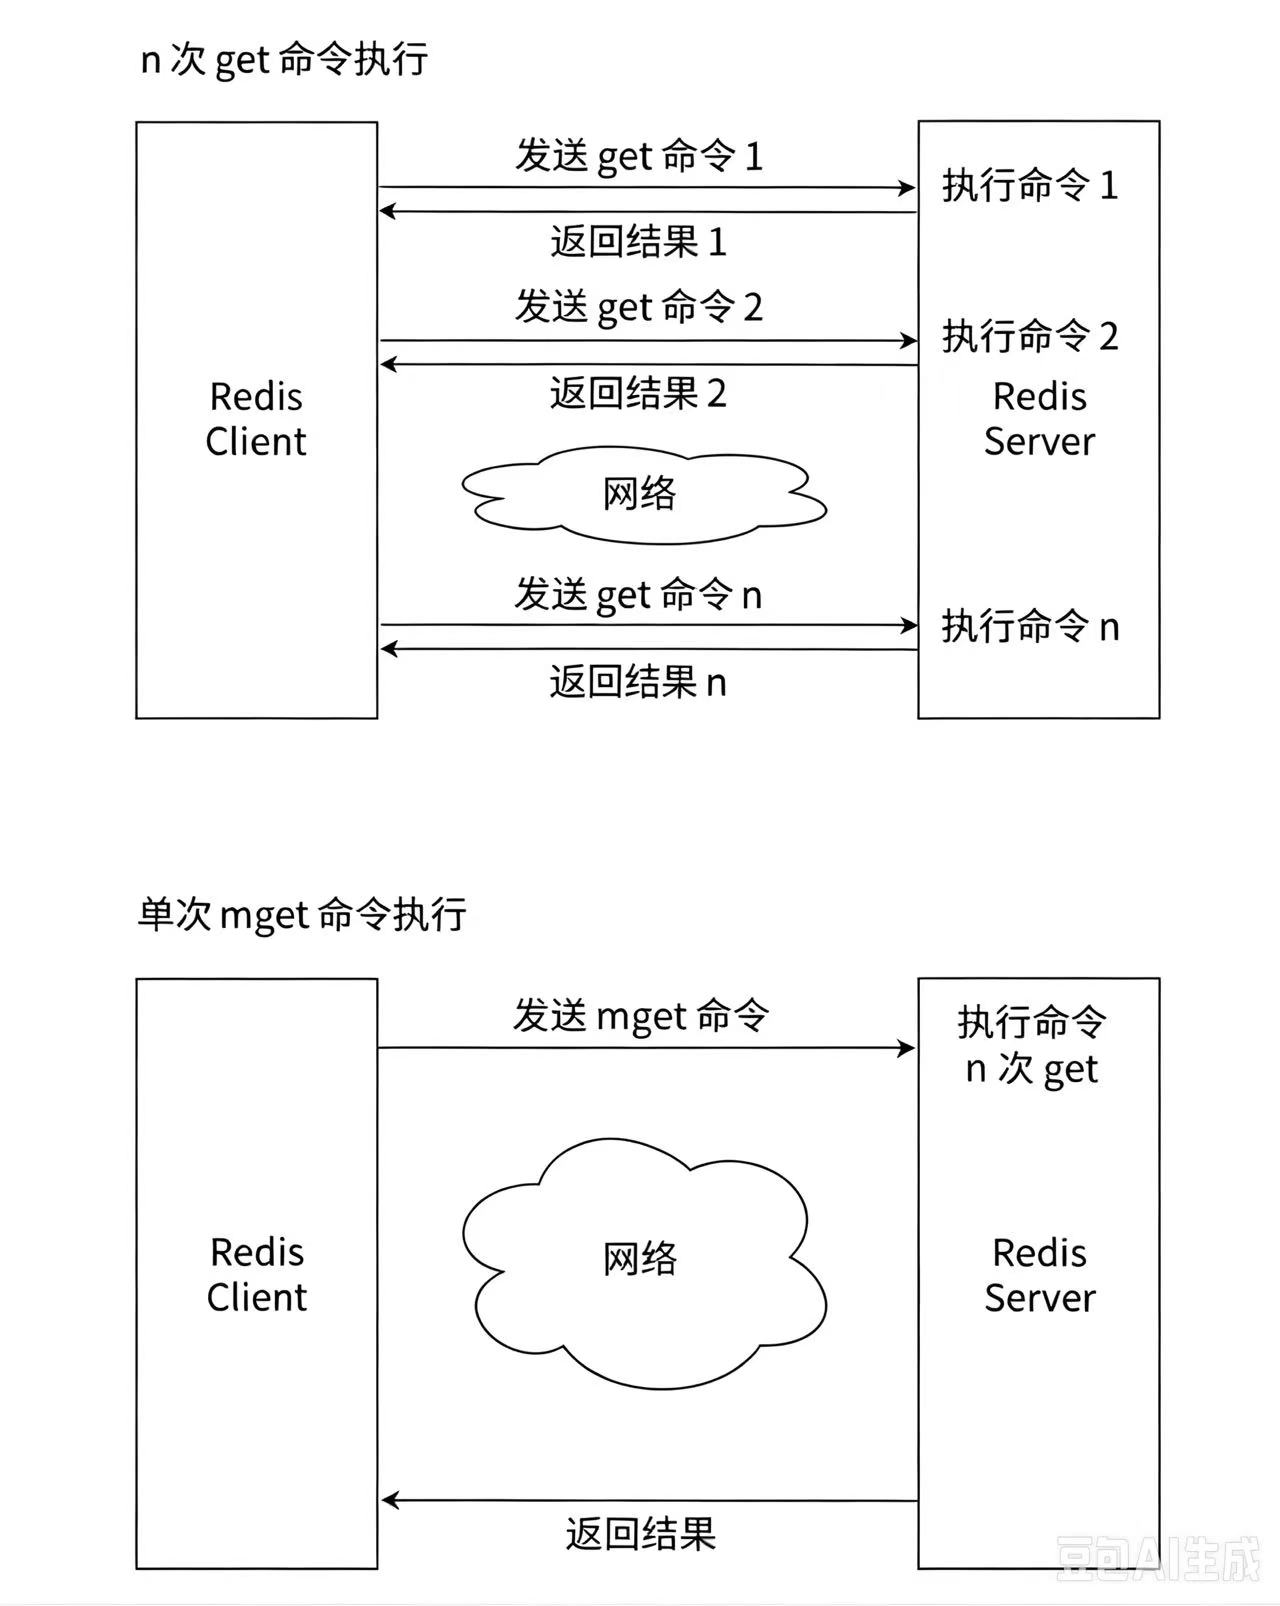
• n次get:客户端和服务器来回n次网络交互,多次往返。
• 单次mget:一次发送、一次返回,减少网络RTT耗时。
例子对比:假设网络耗时1毫秒,命令执行时间耗时0.1毫秒
• 1000次get:1000\times1 + 1000\times0.1 = 1100 毫秒
• 1次mget 1000个键:1\times1 + 1000\times0.1 = 101 毫秒
✅要点:批量操作减少网络往返,提升性能;但批量key数量不能无限大,否则命令执行太久阻塞Redis。
SETNX
设置key-value但只允许在key之前不存在的情况下。
语法:
SETNX key value命令有效版本:1.0.0之后
时间复杂度:O(1)
返回值: 1表示设置成功。0表示没有设置。
示例:
1 redis> SETNX mykey "Hello"
2 (integer) 1
3 redis> SETNX mykey "World"
4 (integer) 0
5 redis> GET mykey
6 "Hello"
图2-9 SET、SETNX 和 SET XX 的执行流程
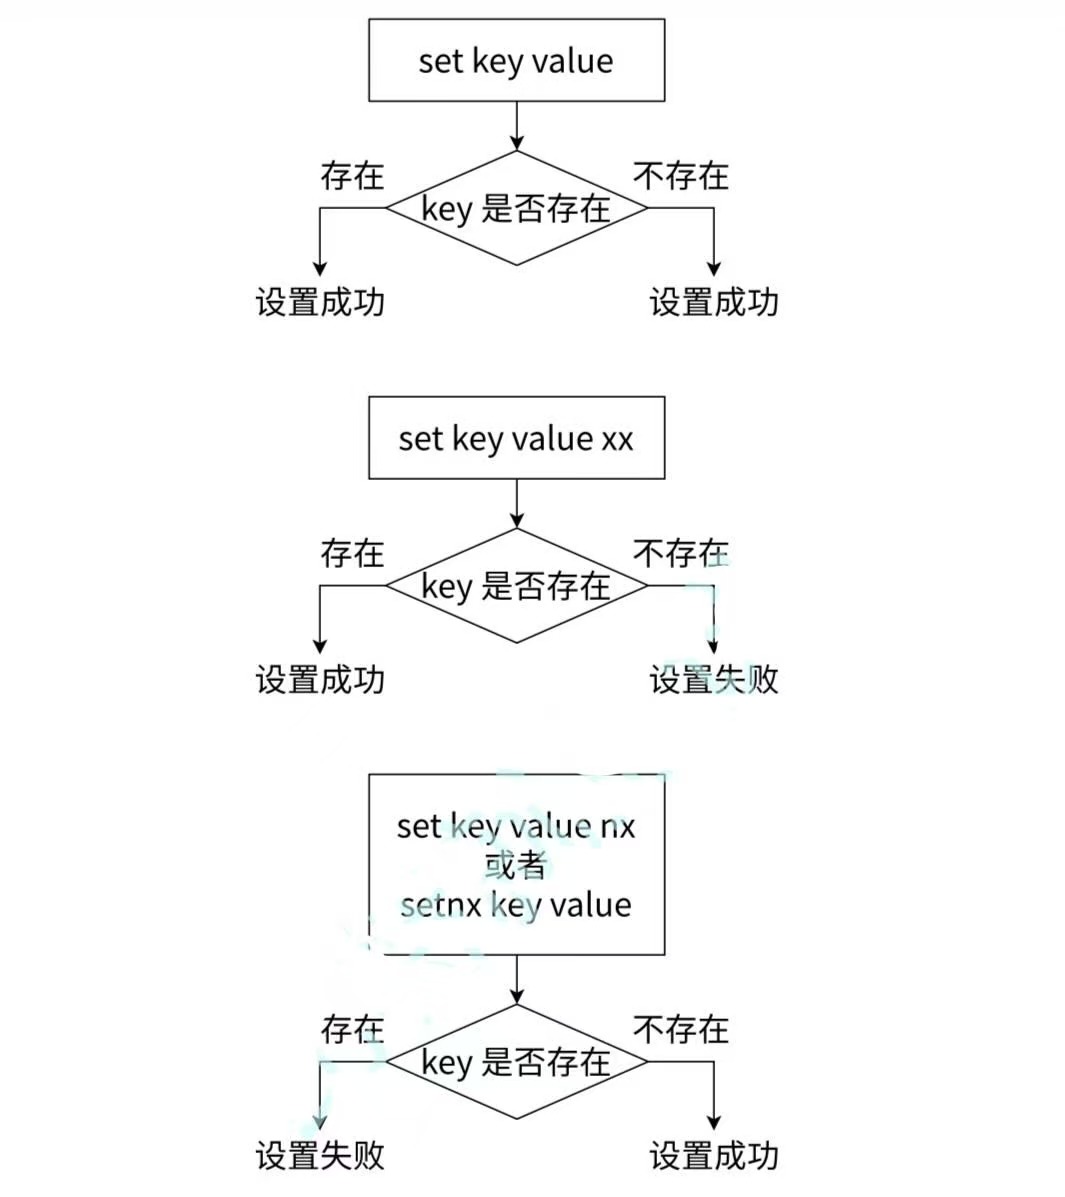
-
SET key value:key存在/不存在,都设置成功
-
SET key value XX:key存在则设置成功;不存在则失败
-
SET key value NX / SETNX:key不存在设置成功;存在设置失败
7.2 计数命令
INCR
将key对应的string表示的数字加一。如果key不存在,则视为key对应的value是0。如果key对应的string不是一个整型或者范围超过了64位有符号整型,则报错。
语法:
INCR key命令有效版本:1.0.0之后
时间复杂度:O(1)
返回值: integer类型的加完后的数值。
示例:
1 redis> EXISTS mykey
2 (integer) 0
3 redis> INCR mykey
4 (integer) 1
5 redis> SET mykey "10"
6 "OK"
7 redis> INCR mykey
8 (integer) 11
9 redis> SET mykey "234293482390480948029348230948"
10 "OK"
11 redis> INCR mykey
12 (error) value is not an integer or out of range
13 redis> SET mykey 'not a number'
14 "OK"
15 redis> INCR mykey
16 (error) value is not an integer or out of range
INCRBY
将key对应的string表示的数字加上对应的值。如果key不存在,则视为key对应的value是0。如果key对应的string不是一个整型或者范围超过了64位有符号整型,则报错。
语法:
INCRBY key decrement命令有效版本:1.0.0之后
时间复杂度:O(1)
返回值: integer类型的加完后的数值。
示例:
1 redis> EXISTS mykey
2 (integer) 0
3 redis> INCRBY mykey 3
4 (integer) 3
5 redis> SET mykey "10"
6 "OK"
7 redis> INCRBY mykey 3
8 (integer) 13
9 redis> INCRBY mykey "not a number"
10 (error) ERR value is not an integer or out of range
11 redis> SET mykey "234293482390480948029348230948"
12 "OK"
13 redis> INCRBY mykey 3
14 (error) value is not an integer or out of range
15 redis> SET mykey 'not a number'
16 "OK"
17 redis> INCRBY mykey 3
18 (error) value is not an integer or out of range
DECR
将key对应的string表示的数字减一。如果key不存在,则视为key对应的value是0。如果key对应的string不是一个整型或者范围超过了64位有符号整型,则报错。
语法:
DECR key命令有效版本:1.0.0之后
时间复杂度:O(1)
返回值: integer类型的减完后的数值。
示例:
1 redis> EXISTS mykey
2 (integer) 0
3 redis> DECR mykey
4 (integer) -1
5 redis> SET mykey "10"
6 "OK"
7 redis> DECR mykey
8 (integer) 9
9 redis> SET mykey "234293482390480948029348230948"
10 "OK"
11 redis> DECR mykey
12 (error) value is not an integer or out of range
13 redis> SET mykey 'not a number'
14 "OK"
15 redis> DECR mykey
16 (error) value is not an integer or out of range
DECRBY
将key对应的string表示的数字减去对应的值。如果key不存在,则视为key对应的value是0。如果key对应的string不是一个整型或者范围超过了64位有符号整型,则报错。
语法:
DECRBY key decrement命令有效版本:1.0.0之后
时间复杂度:O(1)
返回值: integer类型的减完后的数值。
示例:
1 redis> EXISTS mykey
2 (integer) 0
3 redis> DECRBY mykey 3
4 (integer) -3
5 redis> SET mykey "10"
6 "OK"
7 redis> DECRBY mykey 3
8 (integer) 7
9 redis> DECRBY mykey "not a number"
10 (error) ERR value is not an integer or out of range
11 redis> SET mykey "234293482390480948029348230948"
12 "OK"
13 redis> DECRBY mykey 3
14 (error) value is not an integer or out of range
15 redis> SET mykey 'not a number'
16 "OK"
17 redis> DECRBY mykey 3
18 (error) value is not an integer or out of range
INCRBYFLOAT
将key对应的string表示的浮点数加上对应的值。如果对应的值是负数,则视为减去对应的值。如果key不存在,则视为key对应的value是0。如果key对应的不是string,或者不是一个浮点数,则报错。允许采用科学计数法表示浮点数。
语法:
INCRBYFLOAT key increment命令有效版本:2.6.0之后
时间复杂度:O(1)
返回值: 加/减完后的数值。
示例:
1 redis> SET mykey 10.50
2 "OK"
3 redis> INCRBYFLOAT mykey 0.1
4 "10.6"
5 redis> INCRBYFLOAT mykey -5
6 "5.6"
7 redis> SET mykey 5.0e3
8 "OK"
9 redis> INCRBYFLOAT mykey 2.0e2
10 "5200"
知识点:很多存储系统和编程语言内部使用CAS机制实现计数功能,会有一定的CPU开销,但在Redis中完全不存在这个问题,因为Redis是单线程架构,任何命令到了Redis服务端都要顺序执行。
7.3 其他命令
APPEND
如果key已经存在并且是一个string,命令会将value追加到原有string的后边。如果key不存在,则效果等同于SET命令。
语法:
APPEND KEY VALUE命令有效版本:2.0.0之后
时间复杂度:O(1).追加的字符串一般长度较短,可以视为O(1).
返回值: 追加完成之后string的长度。
示例:
1 redis> EXISTS mykey
2 (integer) 0
3 redis> APPEND mykey "Hello"
4 (integer) 5
5 redis> GET mykey
6 "Hello"
7 redis> APPEND mykey " World"
8 (integer) 11
9 redis> GET mykey
10 "Hello World"
GETRANGE
返回key对应的string的子串,由start和end确定(左闭右闭)。可以使用负数表示倒数。-1代表倒数第一个字符,-2代表倒数第二个,其他的与此类似。超过范围的偏移量会根据string的长度调整成正确的值。
语法:
GETRANGE key start end命令有效版本:2.4.0之后
时间复杂度:O(N). N为 start,end 区间的长度. 由于string通常比较短,可以视为是O(1)
返回值: string类型的子串
示例:
1 redis> SET mykey "This is a string"
2 "OK"
3 redis> GETRANGE mykey 0 3
4 "This"
5 redis> GETRANGE mykey -3 -1
6 "ing"
7 redis> GETRANGE mykey 0 -1
8 "This is a string"
9 redis> GETRANGE mykey 10 100
10 "string"
SETRANGE
覆盖字符串的一部分,从指定的偏移开始。
语法:
SETRANGE key offset value命令有效版本:2.2.0之后
时间复杂度:O(N), N为value的长度.由于一般给的value比较短,通常视为O(1).
返回值: 替换后的string的长度。
示例:
1 redis> SET key1 "Hello World"
2 "OK"
3 redis> SETRANGE key1 6 "Redis"
4 (integer) 11
5 redis> GET key1
6 "Hello Redis"
STRLEN
获取key对应的string的长度。当key存放的类似不是string时,报错。
语法:
STRLEN key命令有效版本:2.2.0之后
时间复杂度:O(1)
返回值: string的长度。或者当key不存在时,返回0。
示例:
1 redis> SET mykey "Hello world"
2 "OK"
3 redis> STRLEN mykey
4 (integer) 11
5 redis> STRLEN nonexisting
6 (integer) 0
7.4 命令小结
|----------------------------------|------------------------|-----------------------|
| 命令 | 执行效果 | 时间复杂度 |
| set key value key value... | 设置key的值是value | O(k), k是键个数 |
| get key | 获取key的值 | O(1) |
| del key key ... | 删除指定的key | O(k), k是键个数 |
| mset key value key value ... | 批量设置指定的key和value | O(k), k是键个数 |
| mget key key ... | 批量获取key的值 | O(k), k是键个数 |
| incr key | 指定的key的值+1 | O(1) |
| decr key | 指定的key的值-1 | O(1) |
| incrby key n | 指定的key的值 +n | O(1) |
| decrby key n | 指定的key的值 -n | O(1) |
| incrbyfloat key n | 指定的key的值 +n(浮点数) | O(1) |
| append key value | 指定的key的值追加value | O(1) |
| strlen key | 获取指定key的值的长度 | O(1) |
| setrange key offset value | 覆盖指定key的从offset开始的部分值 | O(n),n是字符串长度,通常视为O(1) |
| getrange key start end | 获取指定key的从start到end的部分值 | O(n),n是字符串长度,通常视为O(1) |
7.5 String 内部编码
- Redis字符串有3种内部编码,Redis会根据值的类型和长度自动选择:
int:8字节长整型,存储数字形式的字符串。
embstr:≤39字节的短字符串,内存一次性分配,节省开销。
raw:>39字节的长字符串。
- 查看key对应的编码命令:object encoding key
示例:set key 6379 → object encoding key 返回 "int"
示例:set key "hello" → object encoding key 返回 "embstr"
7.6 典型使用场景
场景1:缓存(Cache)【Redis + MySQL】
架构:Web服务 + Redis缓存层 + MySQL存储层;热点数据放Redis,减轻MySQL压力,提升查询速度。
访问流程:
① 先从Redis查询数据;
② 缓存命中hit:Redis查到,直接返回结果,不访问MySQL;
③ 缓存未命中miss:查询MySQL,将查询结果写入Redis,再返回数据。
缓存伪代码逻辑:根据uid拼接redis的key,先get;空则查MySQL,拿到数据序列化后set进Redis,设置过期时间,防止缓存雪崩。
Redis键名规范:推荐格式 业务名:对象名:唯一标识:属性,例:vs:user_info:6379;
注意:key不宜过长,过长会降低Redis性能。Redis没有表、字段的概念,key只是字符串。
场景2:计数器 Counter
适用场景:视频播放量、点赞数等高频计数;使用incr命令实现原子自增。
实现思路:用户播放视频,执行incr video:vid,Redis快速计数;异步把计数同步到底层数据库。
注意:生产环境计数系统额外要考虑防刷、多维度统计、持久化、高可用等问题。
场景3:分布式共享Session(会话存储)
问题:分布式Web集群,负载均衡会把用户请求分发到不同服务器;Session存在单机内存会导致用户反复登录。
解决方案:把Session统一存入Redis集中管理。无论请求打到哪台Web服务器,都从Redis读写登录会话信息。
场景4:手机短信验证码 + 接口限流
功能:存储验证码,同时限制短信发送频率(例:1分钟最多5次)。
限流逻辑:
key:shortMsg:limit:+手机号,设置过期时间1分钟,用nx首次创建;
重复请求执行incr计数;计数超过阈值,拒绝发送短信。
验证码存储:validation:+手机号,存储6位验证码,设置过期时间(例如5分钟)。
验证码校验逻辑:get取出Redis中保存的验证码,和用户输入对比,一致则验证成功。
7.7 配套核心命令回顾(String)
set key value:设置键值,key存在则覆盖,不存在新建。
set key value xx:仅key已经存在才可以修改,不存在则失败。
set key value nx(等价setnx):仅key不存在才设置,常用于分布式锁、验证码限流首次创建。
set key value ex 秒数:设置key同时添加过期时间。
incr key:对存储的数字字符串做原子+1。
get key:读取字符串value。
补充要点:String是Redis最基础的数据类型,value最大512MB,可以存普通文本、JSON字符串、二进制数据。
批量查询:mget k1 k2 k3,一次网络往返获取多个key,相比多次get,减少网络RTT耗时。
8. Hash结构概念
Redis的Hash,外层是Redis的key,value内部又是一组field-value映射。
对比String存储对象:String方案要创建多个key(user:1:name、user:1:age);Hash只需要1个key,内部用多个field存储对象的各个属性。
区分概念:Redis整体是key-value;Hash内部的映射叫field-value,这里的value是field对应的值,和Redis外层key的value不是同一概念。
8.1 Hash常用命令
1)HSET
• 作用:设置hash中指定field的值
• 语法:HSET key field value field value ...
• 版本:2.0.0后支持
• 时间复杂度:插入一组field O(1);插入N组field O(N)
• 返回值:成功添加的字段个数
redis> HSET myhash field1 "Hello"
(integer) 1
redis> HGET myhash field1
"Hello"
2)HGET
• 作用:获取hash中指定field的值
• 语法:HGET key field
• 版本:2.0.0后支持
• 时间复杂度:O(1)
• 返回值:字段对应的值,不存在返回nil
 redis> HSET myhash field1 "foo"
(integer) 1
redis> HGET myhash field1
"foo"
redis> HGET myhash field2
(nil)
3)HEXISTS
• 作用:判断hash内是否存在指定field
• 语法:HEXISTS key field
• 版本:2.0.0后支持
• 时间复杂度:O(1)
• 返回值:1=存在,0=不存在
redis> HSET myhash field1 "foo"
(integer) 1
redis> HEXISTS myhash field1
(integer) 1
redis> HEXISTS myhash field2
(integer) 0
4)HDEL
• 作用:删除hash中指定的field,可以一次性删多个
• 语法:HDEL key field field ...
• 版本:2.0.0后支持
• 时间复杂度:删1个O(1),删N个O(N)
• 返回值:本次成功删除的字段数量
redis> HSET myhash field1 "foo"
(integer) 1
redis> HDEL myhash field1
(integer) 1
redis> HDEL myhash field2
(integer) 0
5)HKEYS
• 作用:获取hash里全部field(字段名)
• 语法:HKEYS key
• 版本:2.0.0后支持
• 时间复杂度:O(N),N是field总数
• 返回值:所有字段名列表
redis> HSET myhash field1 "Hello"
(integer) 1
redis> HSET myhash field2 "World"
(integer) 1
redis> HKEYS myhash
1) "field1"
2) "field2"
6)HVALS
• 作用:获取hash里全部value
• 语法:HVALS key
• 版本:2.0.0后支持
• 时间复杂度:O(N),N是field总数
• 返回值:所有字段对应的值列表
redis> HSET myhash field1 "Hello"
(integer) 1
redis> HSET myhash field2 "World"
(integer) 1
redis> HVALS myhash
1) "Hello"
2) "World"
7)HGETALL
• 作用:一次性获取hash内所有field+value
• 语法:HGETALL key
• 版本:2.0.0后支持
• 时间复杂度:O(N),N是field总数
• 返回值:成对返回字段和对应的值
⚠️注意:当hash内field数量很大时,HGETALL一次性读取全部数据会阻塞Redis;只需要部分字段优先用HMGET;必须遍历全部字段推荐HSCAN渐进遍历。
redis> HSET myhash field1 "Hello"
(integer) 1
redis> HSET myhash field2 "World"
(integer) 1
redis> HGETALL myhash
1) "field1"
2) "Hello"
3) "field2"
4) "World"
8)HMGET
• 作用:批量获取hash多个field的值
• 语法:HMGET key field field ...
• 版本:2.0.0后支持
• 时间复杂度:单个字段O(1),多个字段O(N)
• 返回值:按顺序返回对应字段的值,不存在返回nil
redis> HSET myhash field1 "Hello"
(integer) 1
redis> HSET myhash field2 "World"
(integer) 1
redis> HMGET myhash field1 field2 nofield
1) "Hello"
2) "World"
3) (nil)
9)HLEN
• 作用:获取hash中field的总个数
• 语法:HLEN key
• 版本:2.0.0后支持
• 时间复杂度:O(1)
• 返回值:字段数量
redis> HSET myhash field1 "Hello"
(integer) 1
redis> HSET myhash field2 "World"
(integer) 1
redis> HLEN myhash
(integer) 2
10)HSETNX
• 作用:仅当field不存在时,设置field-value;如果field已存在,设置失败
• 语法:HSETNX key field value
• 版本:2.0.0后支持
• 时间复杂度:O(1)
• 返回值:1设置成功,0设置失败
redis> HSETNX myhash field "Hello"
(integer) 1
redis> HSETNX myhash field "World"
(integer) 0
redis> HGET myhash field
"Hello"
11)HINCRBY
• 作用:对hash内field对应的整数做增减
• 语法:HINCRBY key field increment
• 版本:2.0.0后支持
• 时间复杂度:O(1)
• 返回值:增加之后字段的新值
redis> HSET myhash field 5
(integer) 1
redis> HINCRBY myhash field 1
(integer) 6
redis> HINCRBY myhash field -1
(integer) 5
redis> HINCRBY myhash field -10
(integer) -5
12)HINCRBYFLOAT
• 作用:HINCRBY的浮点数版本,对浮点数值增减
• 语法:HINCRBYFLOAT key field increment
• 版本:2.6.0后支持
• 时间复杂度:O(1)
• 返回值:运算之后的新浮点值
redis> HSET mykey field 10.50
(integer) 1
redis> HINCRBYFLOAT mykey field 0.1
"10.6"
redis> HINCRBYFLOAT mykey field -5
"5.6"
redis> HSET mykey field 5.0e3
(integer) 0
redis> HINCRBYFLOAT mykey field 2.0e2
"5200"
8.2 Hash内部编码(两种)
- ziplist(压缩列表)
满足两个条件时启用:
① hash内field数量小于hash-max-ziplist-entries,默认512个
② 所有field对应的value都小于hash-max-ziplist-value,默认64字节
特点:紧凑连续存储,节省内存。
127.0.0.1:6379> hmset hashkey f1 v1 f2 v2
OK
127.0.0.1:6379> object encoding hashkey
"ziplist"- hashtable(哈希表)
不满足ziplist条件时自动切换:field数量超过512,或者任意一个value大于64字节,就转为hashtable
特点:读写效率更高,时间复杂度O(1),内存占用更大。
cpp
127.0.0.1:6379> hset hashkey f3 "one string is bigger than 64 bytes ..."
OK
127.0.0.1:6379> object encoding hashkey
"hashtable"
8.3 Hash使用场景:缓存对象(用户信息)
适合存储对象,例如用户信息:user:1作为redis key,内部field为name、age、city等属性。
伪代码:
cpp
UserInfo getUserInfo(long uid) {
    // 根据 uid 得到 Redis 的 key
    String key = "user:" + uid;
    // 尝试从 Redis 中获取对应的值
    userInfoMap = Redis 执行命令: hgetall key;
    // 如果缓存命中(hit)
    if (value != null) {
        // 将映射关系还原为对象形式
        UserInfo userInfo = 利用映射关系构建对象(userInfoMap);
        return userInfo;
    }
    // 如果缓存未命中(miss)
    // 从数据库中,根据 uid 获取用户信息
    UserInfo userInfo = MySQL 执行 SQL: select * from user_info where uid = <uid>
    // 如果表中没有 uid 对应的用户信息
    if (userInfo == null) {
        响应 404
        return null;
    }
    // 将缓存以哈希类型保存
    Redis 执行命令: hmset key name userInfo.name age userInfo.age city userInfo.city
    // 写入缓存,为了防止数据腐烂(rot),设置过期时间为 1 小时(3600 秒)
    Redis 执行命令: expire key 3600
    // 返回用户信息
    return userInfo;
}
Hash与关系数据库区别
① Hash是稀疏结构:不同key可以拥有不一样的field;关系型数据库表结构固定,新增列所有行都要分配该列,哪怕是null。
② Redis Hash不支持复杂联表、聚合查询;关系数据库擅长复杂SQL查询。
8.4 三种缓存存储用户信息方案对比
方案1:原生String类型,一个属性一个key
cpp
set user:1:name James
set user:1:age 23
set user:1:city Beijing
✅优点:简单,单独修改某个属性灵活
❌缺点:key数量太多,用户数据分散,聚合性差,工程上基本不用
方案2:序列化String(JSON字符串)
cpp
set user:1 序列化后的用户对象字符串✅优点:整体读写方便,内存利用率高
❌缺点:序列化/反序列化有开销;只修改单个属性不灵活,需要取出整个对象修改再写回
方案3:Hash类型(推荐)
cpp
hmset user:1 name James age 23 city Beijing✅优点:直观,局部更新/读取单个字段灵活
❌缺点:需要关注ziplist和hashtable的编码转换,极端场景内存消耗会变大