这是 RocketMQ 系列的第五篇。前四篇围绕「一条消息的生命周期」走完了生产→存储→消费,本篇横向展开------那些普通消息满足不了的场景,RocketMQ 是怎么解决的。顺序消息、延迟消息、事务消息,每一种背后都是一套精巧的设计。
一、为什么需要特殊消息
前四篇讲的「普通消息」------轮询投递、立即可消费------已经能覆盖大多数业务。但有三类需求,普通消息搞不定:
- 有严格顺序要求:证券交易撮合,出价相同的单子必须按「先出价先成交」处理,消息乱序业务就出错。
- 要定时/延迟投递:下单 30 分钟未支付自动关闭,不能一下单就关,也不能靠轮询数据库去查。
- 要和本地事务绑定:支付成功后要同时更新订单、发货、加积分、清购物车,要么全成功、要么全不执行。
这三种需求,对应 RocketMQ 的三种特殊消息:顺序消息、延迟/定时消息、事务消息。下面逐个讲透。
二、顺序消息
1. 普通消息为什么乱序
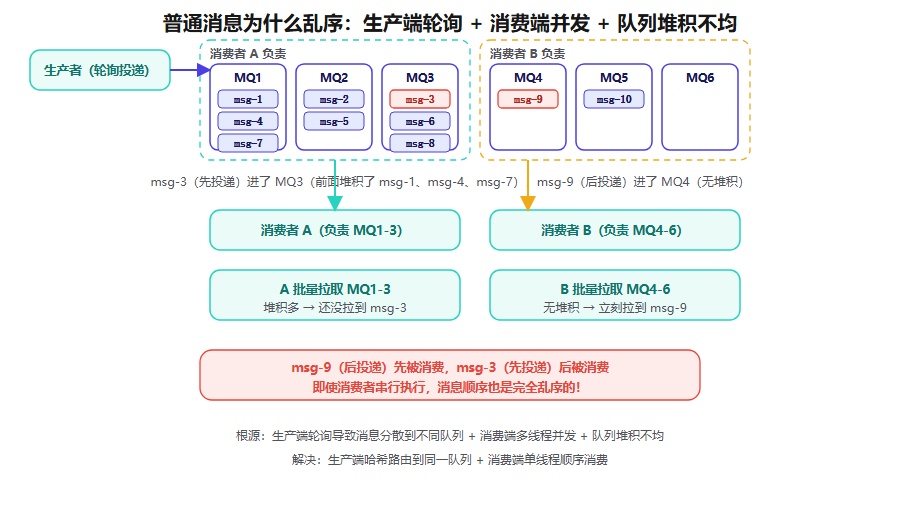
先看普通消息为什么满足不了「先出价先成交」这类需求。问题出在两个环节都无序,而且这两个环节叠加在一起,即使消费者串行执行,消息顺序也是完全乱的。
生产端无序 :生产者按轮询策略投递(第二篇讲过),内部维护一个原子计数器,每发一条消息 计数器 % 队列数量 决定进哪个队列。同一支股票的两笔出价,计数器值不同,取模结果不同,就可能分别进了 MQ3 和 MQ4。消息一分散到不同队列,它们的相对顺序就失去了保障------因为不同队列是独立存储、独立被消费的,Broker 和消费者都不知道「MQ3 里的 msg-3 和 MQ4 里的 msg-9 谁先谁后」。
消费端无序 :消费者拉取消息后,并不是逐条串行处理,而是批量拉取 + 多线程并发消费 。具体来说,消费者从自己负责的多个队列里批量拉回一批消息,然后丢进一个线程池并行处理------线程池里有几个工作线程,就有几条消息同时被消费。哪条消息被哪个线程拿到、哪个线程先执行完,完全取决于 JVM 的线程调度,和消息的投递顺序没有任何关系。即使你把线程池大小设为 1(退化成串行),由于消息是从多个队列里混合拉取的,拉取顺序本身就取决于各队列的堆积情况,仍然无法保证全局有序。
再加上队列分布不均:假设 6 个队列、2 个消费者,A 负责 MQ1-3,B 负责 MQ4-6。出价者 A 的消息进了 MQ3,出价者 B 的消息进了 MQ4。如果 MQ3 前面堆积了消息,A 批量拉取时还没拉到出价者 A 的消息;而 MQ4 没堆积,B 一下就拉到了出价者 B 的消息------先出价的反而后消费,撮合规则被打破。
整个乱序链路见下图:
2. 解决思路:同时解决两端无序
要让同一支股票的出价严格按顺序消费,必须同时解决两个问题:
- 生产端 :同一支股票的出价必须进同一个队列,且按出价顺序落盘。
- 消费端 :同一个队列里的消息必须按顺序消费,不能并发。
3. 生产端:哈希路由 + 同步发送 + 分布式锁
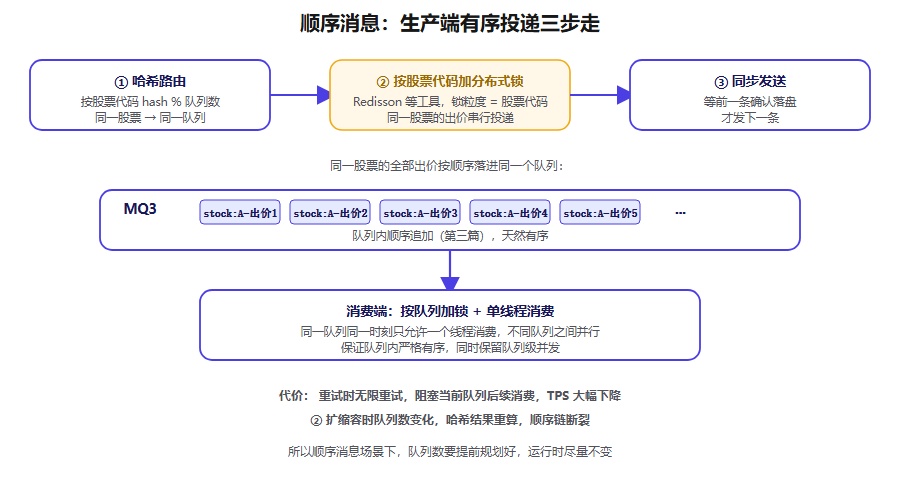
第一步:哈希路由 。不再用轮询,改用 MessageQueueSelector,按股票代码做哈希,算出目标队列下标。同一支股票的出价永远进同一个队列------这个队列内部是顺序追加的(第三篇讲过),天然有序。
第二步:同步发送 。必须用同步发送(第二篇),不能用异步。原因不是网络顺序的问题,而是刷盘失败时的行为差异 :同步发送时,Broker 必须等消息真正落盘才返回 ack,如果落盘失败,生产者立刻知道、可以重试,顺序不会乱。但异步发送不一样------Broker 收到消息就返回 ack,生产者以为成功了继续发下一条,如果此时 Broker 后台刷盘失败(磁盘满了、IO 异常),这条消息就丢了,但生产者已经发了后续的消息。丢掉的这条消息的「位置」空了出来,后续消息的顺序就全乱了。同步发送把「落盘成功」作为发送成功的前提,从根本上杜绝了这种情况。
第三步:分布式锁(或单线程池) 。这一步容易被忽略------生产者通常是多节点并发部署 的,即使哈希到同一个队列,多个线程同时投递,CPU 调度 (线程 A 拿到时间片开始发送,但还没发完就被操作系统切换走,线程 B 拿到时间片先发了)、网络抖动(线程 A 的消息在网络中延迟,线程 B 的消息先到 Broker)都可能让后发出的消息先落盘。解决办法:
- 单线程池投递:同一支股票的出价由一个线程串行投递,简单但吞吐受限。
- 分布式锁 (推荐):用 Redisson 等工具,按股票代码加锁。同一支股票的出价必须拿到锁才能投递,其他股票的出价不受影响。锁的粒度按业务场景定------股票场景锁的是「股票代码」,订单场景锁的是「订单号」。
生产端有序投递的完整链路:
4. 消费端:按队列加锁 + 单线程消费
存储端不需要额外处理------队列内顺序追加,天然有序(第三篇)。问题在消费端:多线程并发消费会打乱顺序。
RocketMQ 的做法:按队列加锁,单线程消费队列内的消息。
- 每个队列同一时刻只允许一个消费者线程消费(客户端内部加锁)。
- 但不同队列之间仍然并行------消费 MQ1 的同时也能消费 MQ2,只要每个队列内部有序就行。
这里要解释一下为什么「队列间可以并发」而不破坏顺序。顺序消息保证的是同一支股票的出价有序 ,而同一支股票的出价通过哈希路由进了同一个队列 。不同队列里的消息属于不同的股票,它们之间本来就没有顺序关系------股票 A 的出价和股票 B 的出价谁先谁后,业务根本不关心。所以只要每个队列内部有序 ,全局来看同一支股票的出价就是有序的,不同队列之间完全可以并行消费,互不干扰。这就是「分区有序」的含义------不是全局所有消息有序,而是按分区(队列)维度各自有序。
这样既保证了顺序,又保留了队列级别的并发,吞吐不至于太低。
5. 顺序消息的代价
顺序消息不是免费的,有两个明显的代价:
- 重试阻塞整个队列 :消费失败时,不能像普通消息那样丢进重试队列(%RETRY%)------因为重试队列是独立的 Topic,消息一进去就脱离了原来的顺序。所以顺序消息的重试是无限重试 ,阻塞当前队列的后续消费,直到这条消息消费成功。TPS 会大幅下降,这是用性能换顺序的无奈之举。
- 扩缩容破坏顺序 :队列数量一变,哈希结果全部重算------原来哈希到 MQ1 的股票,扩容后可能哈希到 MQ2,顺序链断了。所以顺序消息场景下,队列数要提前规划好,运行时尽量不变。
三、定时/延迟消息
1. 典型场景
- 延迟消息:电商下单后 30 分钟未支付自动关闭。不能一下单就关,也不能靠定时任务轮询数据库。
- 定时消息:分布式调度场景,每天 5 点执行文件清理、每隔 2 分钟触发一次消息推送。传统基于数据库的定时调度在分布式下性能差、实现复杂。
两者本质原理一样,都是「消息不是立刻可见,到了指定时间才投递」,一起讲。
2. 实现原理:闹钟机制
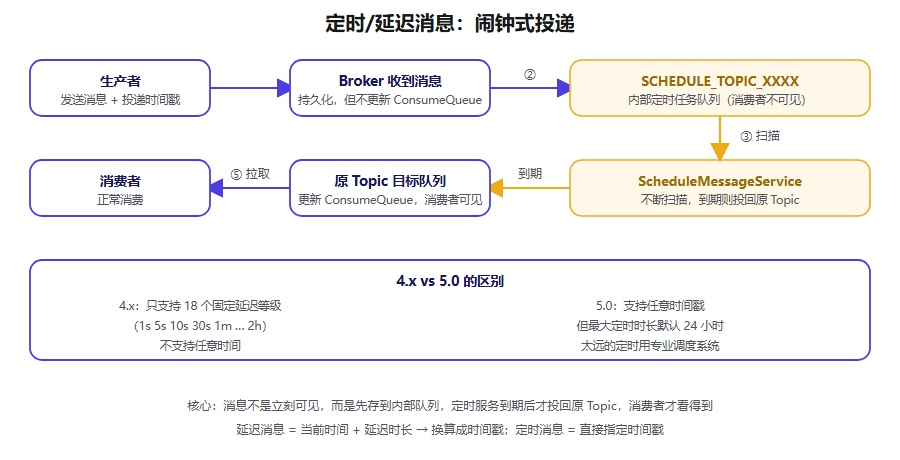
核心思路类似闹钟:生产者指定一个「投递时间」,Broker 收到后不立刻投递给消费者 ,而是先存到一个内部的定时任务队列,由定时服务(ScheduleMessageService)扫描,到期后再投回原 Topic 的目标队列,消费者这才看得到。
时间怎么指定? 用毫秒级的 Unix 时间戳:
- 定时消息 :指定一个绝对时间点。比如当前 17:30,希望 19:20 投递,定时时间就是
2022-06-09 19:20:00,转成时间戳1654773600000。 - 延迟消息 :指定一个相对时长。比如当前 17:30,希望 1 小时后投递,换算成定时时刻就是
2022-06-09 18:30:00,转成时间戳1654770600000。
3. 投递流程
整个流程分四步:
- 生产者发送定时/延迟消息,消息里带上目标投递时间戳。
- Broker 收到后,不更新原 Topic 的 ConsumeQueue (消费者看不到),而是把消息投到内部的
SCHEDULE_TOPIC_XXXX队列。 - 定时服务(ScheduleMessageService)不断扫描 这个内部队列------默认每秒扫描一次 ,发现某条消息的投递时间到了,就把它改写回原 Topic 的目标队列,更新 ConsumeQueue。
- 消费者拉取时,才能看到这条消息,正常消费。
4. 延迟等级与 5.0 的改进
4.x 版本 :只支持 18 个固定延迟等级,不支持任意时间。等级表如下:
| 等级 | 延迟时长 | 等级 | 延迟时长 |
|---|---|---|---|
| 1 | 1s | 10 | 6m |
| 2 | 5s | 11 | 7m |
| 3 | 10s | 12 | 8m |
| 4 | 30s | 13 | 9m |
| 5 | 1m | 14 | 10m |
| 6 | 2m | 15 | 20m |
| 7 | 3m | 16 | 30m |
| 8 | 4m | 17 | 1h |
| 9 | 5m | 18 | 2h |
第四篇讲重试时用的就是这套等级------重试从第 3 级(10s)开始逐级递增。
5.0 版本 :支持任意时间戳 的定时/延迟消息,不再受 18 个等级限制。但有一个约束:定时时长最大默认 24 小时,不允许超过这个数------太远的定时任务应该用专业的调度系统(如 XXL-Job),不该压在 MQ 上。
四、事务消息
1. 为什么需要事务消息
以电商支付场景为例:用户支付成功后,要同时做四件事------更新订单状态、新增物流记录、变更用户积分、清空购物车。这四件事要么全成功、要么全不执行。
传统方案有两个坑:
XA 分布式事务:把四个调用封装成一个大事务,结果一致性有保障。但多分支环境下资源锁定范围大、并发度低,下游分支越多性能越差。
普通消息 + 本地事务:把订单变更作为本地事务,剩下的通过普通消息通知下游。但两头很难一致:
- 消息发成功了,订单没执行成功 → 需要回滚整个事务,但消息已经出去了。
- 订单执行成功了,消息没发成功 → 下游收不到通知,需要额外补偿才能发现不一致。
- 消息发送超时未知 → 不知道是该回滚订单还是提交订单变更。
2. 事务消息的核心思路
RocketMQ 的事务消息解决的是**「本地事务成功 消息一定投出」**这个一致性问题。它不保证消费端的结果------消费端的可靠性仍靠第四篇讲的幂等。
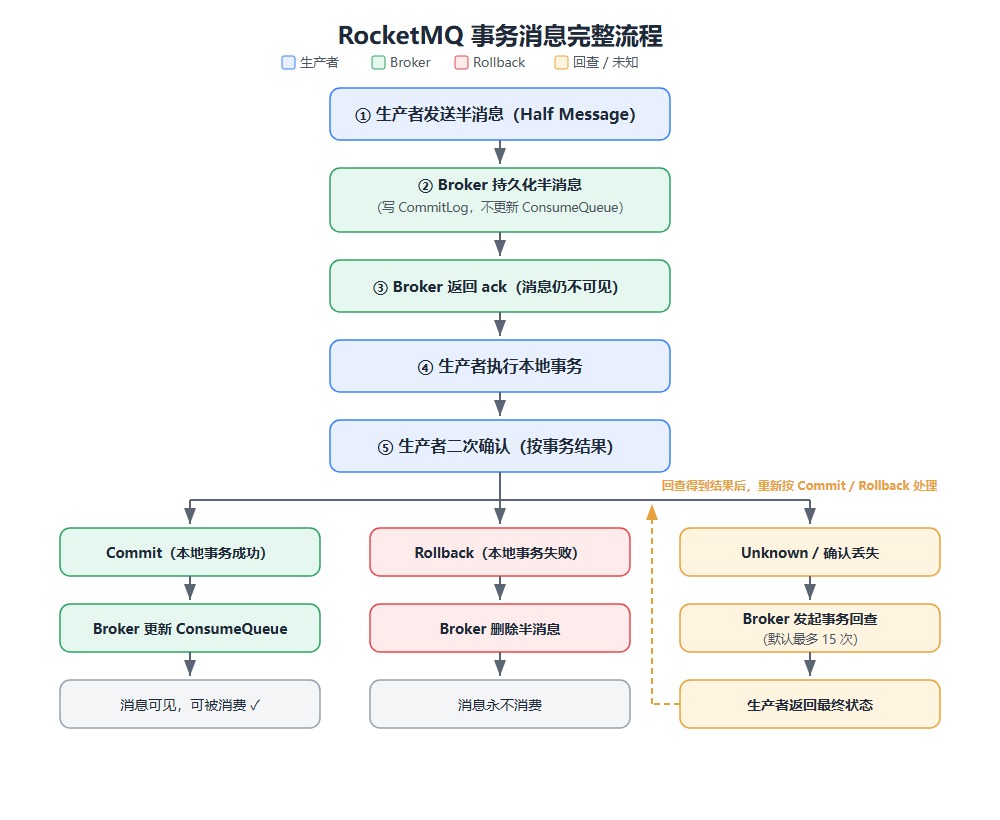
核心流程分四步,用一张图看清楚:
3. 分步讲解
第一步:发送半消息(Half Message)
生产者向 Broker 发送一条半消息 。Broker 持久化成功,返回 ack------但注意,此时没有更新 ConsumeQueue ,消息对消费者不可见。这条消息就叫「半消息」,意思是「只写了一半,还不确定要不要投递」。
第二步:执行本地事务
生产者收到 ack 后,开始执行自己的本地事务(比如更新订单状态为「已支付」)。本地事务有两种结果:成功 (Commit)或失败(Rollback)。
第三步:二次确认
生产者根据本地事务的结果,向 Broker 发送二次确认:
- Commit :本地事务成功了,Broker 把半消息变为可见消息------更新 ConsumeQueue,消费者可以拉取消费了。
- Rollback :本地事务失败了,Broker 删除这条半消息,不做任何操作。消息永远不会被消费,一致性得到保障。
第四步:事务回查(兜底机制)
第三步的二次确认可能丢失(网络波动),或者生产者返回了 Unknown (不确定本地事务状态)。这时 Broker 不能干等------它有一个事务回查机制:
- 经过固定时间后,Broker 向生产者集群中的任意一个实例发起消息回查。
- 生产者收到回查后,检查本地事务的最终状态(比如查订单表,看这笔订单到底支付成功没有)。
- 根据检查结果,再次提交 Commit 或 Rollback。
- 回查有最大次数限制 (默认 15 次 ),每次间隔默认 60 秒 。超过最大次数仍未确认,Broker 默认回滚这条半消息。
4. 事务超时
还有一个兜底:半消息被发送到 Broker 后,如果在指定时间内 (事务超时时间,默认 1 小时 )Broker 始终无法确认提交或回滚状态,消息默认被回滚。防止半消息无限期挂在 Broker 上。
5. 事务消息的边界
最后强调一点:事务消息只保障「本地事务」和「消息投递」的一致性。它不管消费端的结果------消费者消费失败、消费超时,事务消息不负责。消费端的可靠性,仍然要靠第四篇讲的幂等消费、重试机制来兜底。
对一致性要求极高的场景(比如金融类核心账务),事务消息的最终一致性可能不够,需要用传统的 XA 方案。这是取舍,不是缺陷。
五、消息过滤
1. Tag 过滤
这个前面其实已经讲过了(第四篇),这里收拢一下完整链路:
- Broker 端粗筛:ConsumeQueue 索引里存了 Tag 的 HashCode(第三篇的 20 字节结构),Broker 拉取消息时先用 HashCode 粗筛,把明显不匹配的过滤掉。
- 客户端精筛:拉回来的消息,客户端再做精确的 Tag 匹配,只把符合订阅关系的消息交给业务。
两层过滤配合,既减少了网络传输(Broker 端就过滤掉一批),又保证了准确性(客户端精筛兜底)。
2. SQL92 过滤
Tag 过滤只能做「等于」匹配,如果业务需要更复杂的条件------比如「金额大于 100 且来源是 APP 的消息」------就要用 SQL92 过滤。
SQL92 过滤允许消费者在订阅时写 SQL 表达式,按消息的属性字段做条件筛选。比如:
sql
amount > 100 AND source = 'APP'Broker 端会解析这个表达式,拉取消息时按属性过滤。
代价:SQL92 过滤比 Tag 过滤重------Broker 需要解析 SQL、读取消息属性、逐条计算,CPU 开销更大。所以只在 Tag 过滤不够用时才上 SQL92,能不用就不用。
3. 两者取舍
| Tag 过滤 | SQL92 过滤 | |
|---|---|---|
| 匹配方式 | 等于 | 表达式(>、<、AND、OR...) |
| 过滤位置 | Broker 端 HashCode 粗筛 + 客户端精筛 | Broker 端按属性计算 |
| 性能 | 轻,几乎无额外开销 | 重,Broker 需要解析 SQL |
| 适用场景 | 简单分类(如按业务类型分) | 复杂条件(如按金额范围、来源组合筛选) |
小结
这一篇讲了三种特殊消息和消息过滤:顺序消息 用「哈希路由 + 同步发送 + 分布式锁」解决生产端无序,用「按队列加锁 + 单线程消费」解决消费端无序,代价是重试阻塞和扩缩容破坏顺序;定时/延迟消息 用「SCHEDULE_TOPIC 中转 + 定时服务扫描」实现闹钟式投递,4.x 只有 18 个固定等级,5.0 支持任意时间戳(最大 24h);事务消息 用「半消息 + 本地事务 + 二次确认 + 事务回查」保障本地事务与消息投递的一致性,回查默认 15 次、间隔 60s、超时 1h 默认回滚;消息过滤有 Tag(轻)和 SQL92(重)两种,按需选用。
下一篇是系列的收官篇------可靠性全景,把第一篇的「四大问题」(消息丢失、重复消费、消息堆积、顺序问题)逐一收口,输出一张完整的可靠性 checklist。