摘要
虚拟细胞模型旨在预测细胞群体对扰动的应答;但对照组与处理组细胞为非配对群体样本,这给学习扰动特异性效应带来很大困难。本文提出条件传输模型SCALE。该模型将细胞视作无序集合,无需细胞层面一一匹配即可预测处理后的细胞群体。模型采用集合感知共享编码器与条件DiT主干网络学习隐空间传输,直接以终点作为监督信号,无需辅助的差值损失函数。在遗传扰动、化学扰动、发育扰动、免疫扰动多类任务中,SCALE可以还原基因表达变化、应答方向以及群体结构。在存在强烈细胞系效应的CRISPR数据集上,SCALE在7项评价指标上均优于对比方法;并且可以保持各靶点基因表征相互区分,不会坍缩至同一表征区域。SCALE还可以对细胞因子做优先级排序,预测能够产生差异化免疫激活与炎症应答的候选因子。利用来自3名供体的配对外周血单个核细胞(PBMC)样本开展实验,证实了上述预测得到的应答差异。综上,SCALE能够基于非配对群体样本实现扰动特异性预测,可用于实验候选方案优先级筛选。
#虚拟细胞 #扰动预测 #条件传输 #单细胞基础模型 #BioNeMo #非配对群体 #细胞因子 #多基准测试
结果
SCALE通过学习非配对单细胞终点之间的传输,精准还原扰动特异性应答
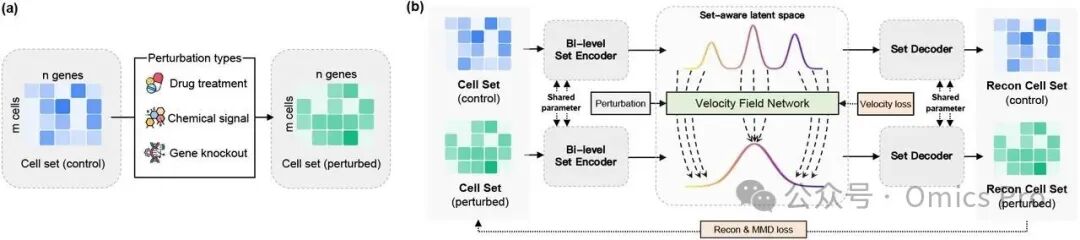
图1 SCALE总览
a:预测任务;b:模型架构
(a) 群体层面预测任务:实验分别测得对照组、处理组细胞群体;模型输入对照组群体与扰动条件,预测处理后群体,不假设细胞之间一一配对。
(b) SCALE模型架构:将无序群体映射至低维集合感知隐空间,预测扰动后的终点群体。训练系统支持大规模数据集,评估环节检验模型预测结果是否具备扰动特异性。
注:该学习得到的传输路径仅用于连接对照组、处理组终点,并非真实生物学轨迹,原始数据没有中间时间点,也没有追踪单个细胞处理前后的变化。
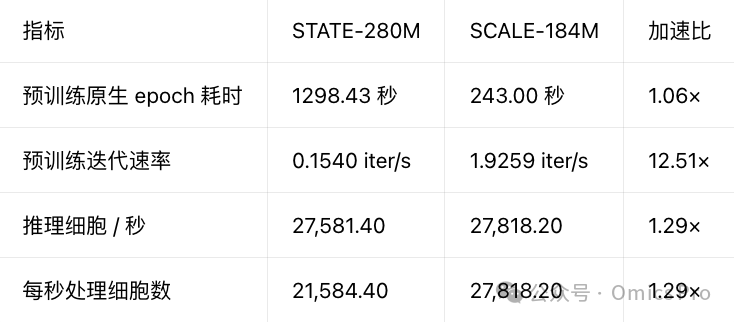
表1 基于BioNeMo的SCALE系统训练与推理速度
训练速度使用各框架自身定义的epoch;推理速度以处理细胞数做归一化,并与STATE模型对比。
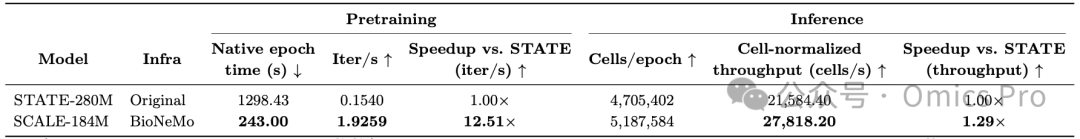
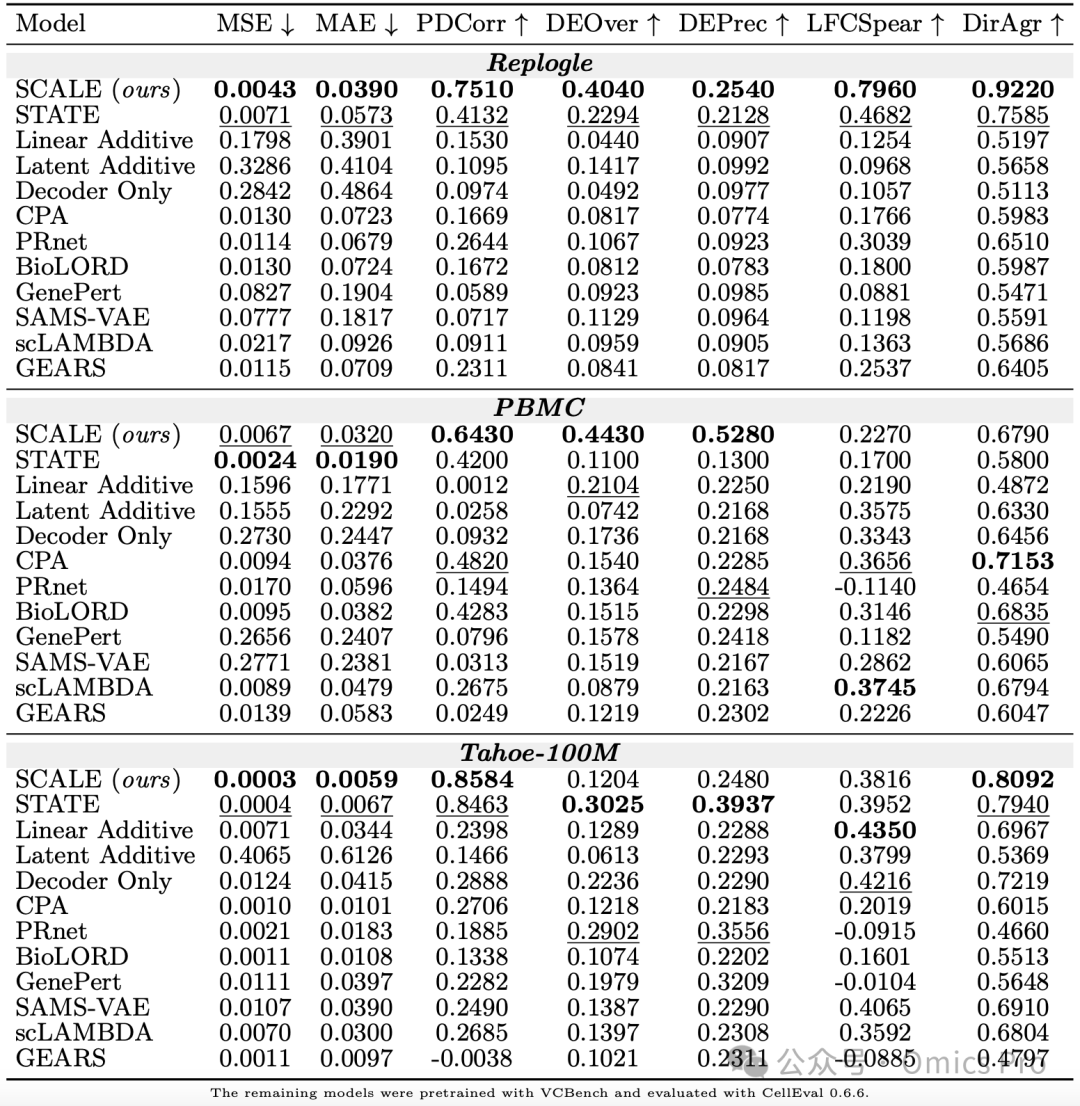
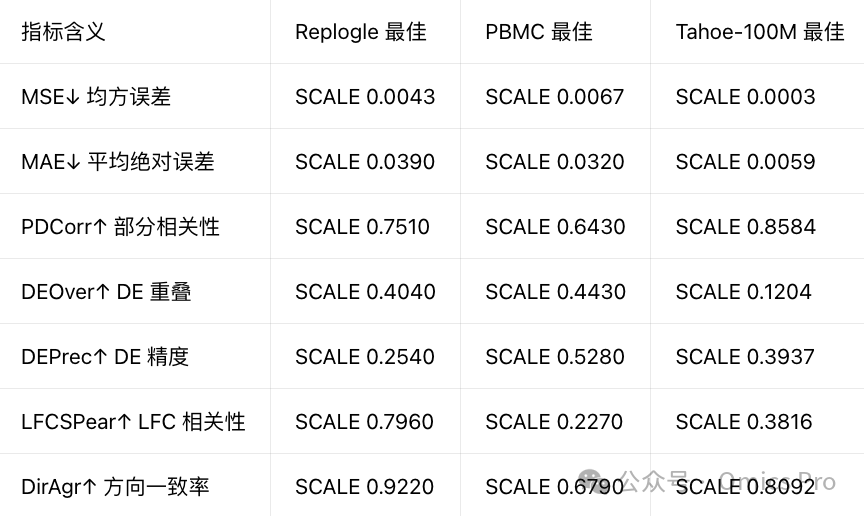
表2 3套数据集、7项指标扰动基准测试结果
加粗代表数据集内最优,下划线代表次优;MSE、MAE指标越小越好;其余指标越大越好。本表融合公开的CellEval结果,以及使用CellEval 0.6.6重新评估的VCBench预测结果;各行预测流水线、条件集合不完全一致,表注释标明每项结果来源。
SCALE在强细胞系偏移下,还原靶点特异性CRISPR应答
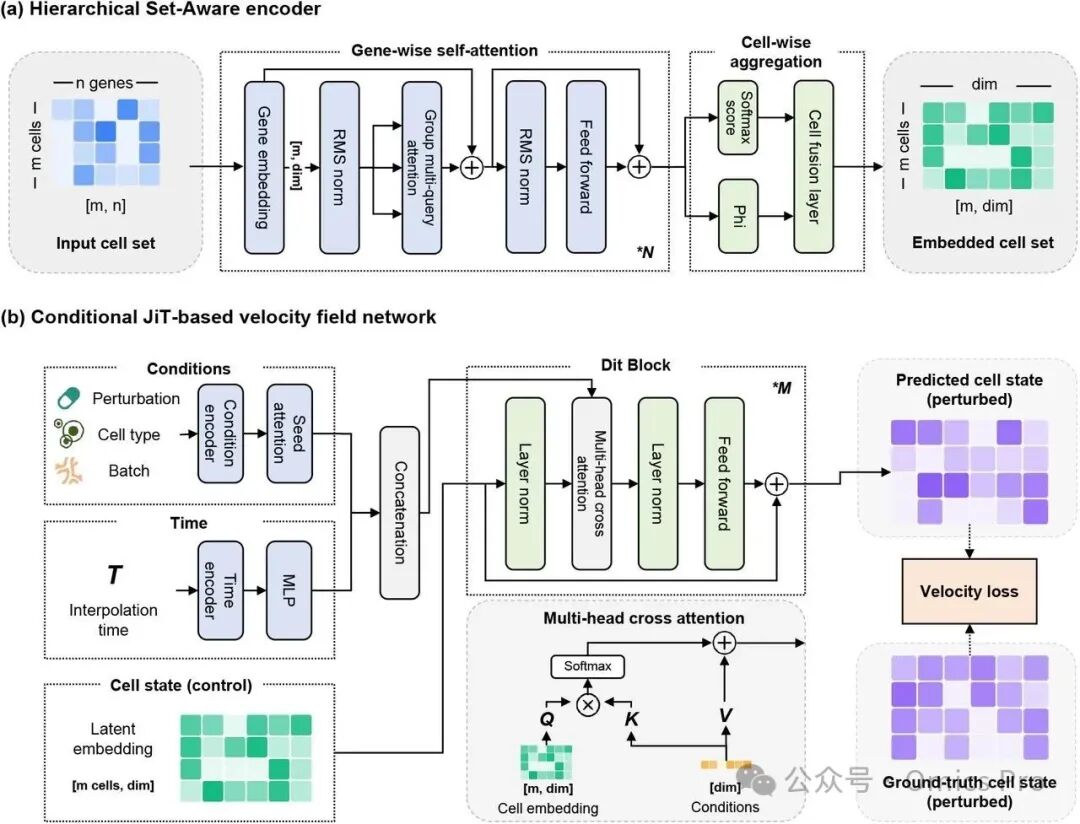
图2 SCALE可还原剔除细胞系均值效应后的基因特异性CRISPR应答
a‑d任务与细胞系结构;e‑i靶点特异性应答还原;j跨细胞系应答空间覆盖度;k隐表征扩散范围
(a) Replogle‑CRISPR任务:在4种人类细胞系上,预测靶基因诱导的表达谱。
(b) 数据划分:训练集、验证集、测试集内的扰动与对应对照组。
(c) 处理组细胞数量:每个细胞系下每种扰动的细胞数,点代表中位数。
(d) 表达谱主要按细胞系区分:主成分图按细胞系、扰动状态着色。
(e) 基因特异性应答与方向:SCALE与STATE的残差皮尔逊相关系数、Direction@100;标注中位数。
(f) 预测应答幅度:不同扰动强度分组下,预测与实测应答范数的log₂比值;0代表幅度相等。
(g) 超越均值应答的准确度:相较于细胞系均值、扰动均值预测中更优一者的提升幅度;正值代表靶点特异性预测效果更好。
(h) 共有应答与细胞系特异性应答:跨细胞系取平均的应答皮尔逊相关系数、各细胞系相对该均值偏差的皮尔逊相关系数、经过log(1+x)变换的应答组分误差;每个点代表至少在3个细胞系测得的靶基因。
(i) Top‑K应答基因重叠度:随选取基因数量增加,跨细胞系的差异基因重叠中位数。
(j) 分细胞系的应答空间覆盖度:log₂倍数变化向量PCA空间内,实测密度轮廓,以及SCALE、STATE预测结果50%、90%等高线;标注条件数量与全条件KDE的RMSE(数值越低越好)。
(k) 隐表征扩散范围:256个条件的2维隐空间投影;STATE的致密区域在插图放大展示。整体比较单元为每条扰动条件,不是单个细胞或单个基因。低维应答、隐空间投影仅用于描述性展示,不能直接证明完整处理组细胞分布被完全复原。
SCALE在跨细胞系、药物组合、不同剂量条件下保留药物应答特异性
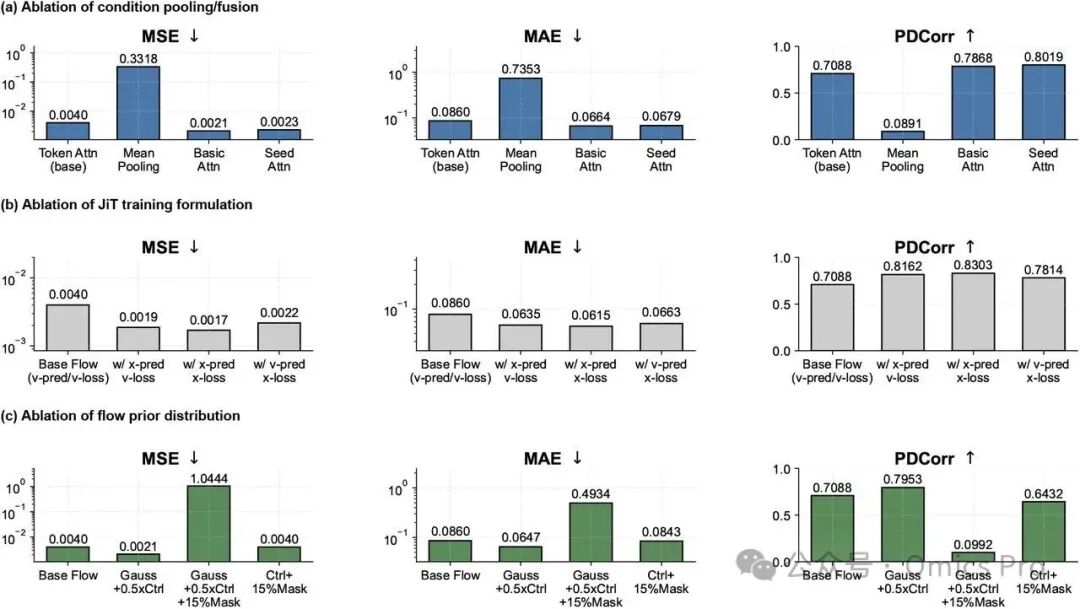
图3 跨细胞系、药物组合、剂量的药物应答预测
a‑e跨细胞系迁移;f‑j训练集未见过的药物组合;k‑q高剂量预测
(a‑e) 单药从训练细胞系迁移至留出测试细胞系任务。
(b,c) 不同模型的条件级Δ皮尔逊相关、top100差异基因重叠度。
(d) MCF7代表性低维应答图;红点落在实测应答区域之外。
(e) 在不同实测效应强度分组下,SCALE、STATE、scLAMBDA的Δ皮尔逊相关。
(f‑j) 训练仅使用单药,测试未见过的药物组合。
(f) 任务设计,本矩阵不等同于后续5对组合独立分析。
(g) 5对组合数据集实测细胞的UMAP图,展示训练、验证、测试组合,附带部分分子结构;无模型预测结果。
(h) 6种模型的配对级Δ皮尔逊相关,以及SCALE相对直接加性基线的提升。
(i) top50基因总体RMSE与平均绝对误差。
(j) 3组代表性配对,实测基因层面差值对比SCALE与直接加性预测结果。
(k‑q) 高剂量预测:训练剂量10 nM、100 nM,验证集1 µM,测试集留出10 µM。
(l) 各模型在10 µM测试条件下的条件级Δ皮尔逊相关。
(m) 代表性低维应答图,附带top50基因MAE、斯皮尔曼相关。
(n‑p) 3种药物‑细胞系组合:不同剂量下实测效应、SCALE在10 µM的预测结果,top50基因平均绝对误差。
(q) 代表性基因‑剂量变化曲线;阴影标记留出的10 µM测试终点。每条匹配扰动条件为统计单元,不是单个细胞。低维图仅用于描述,不能证明完整处理组细胞分布得到复原。
详细总结
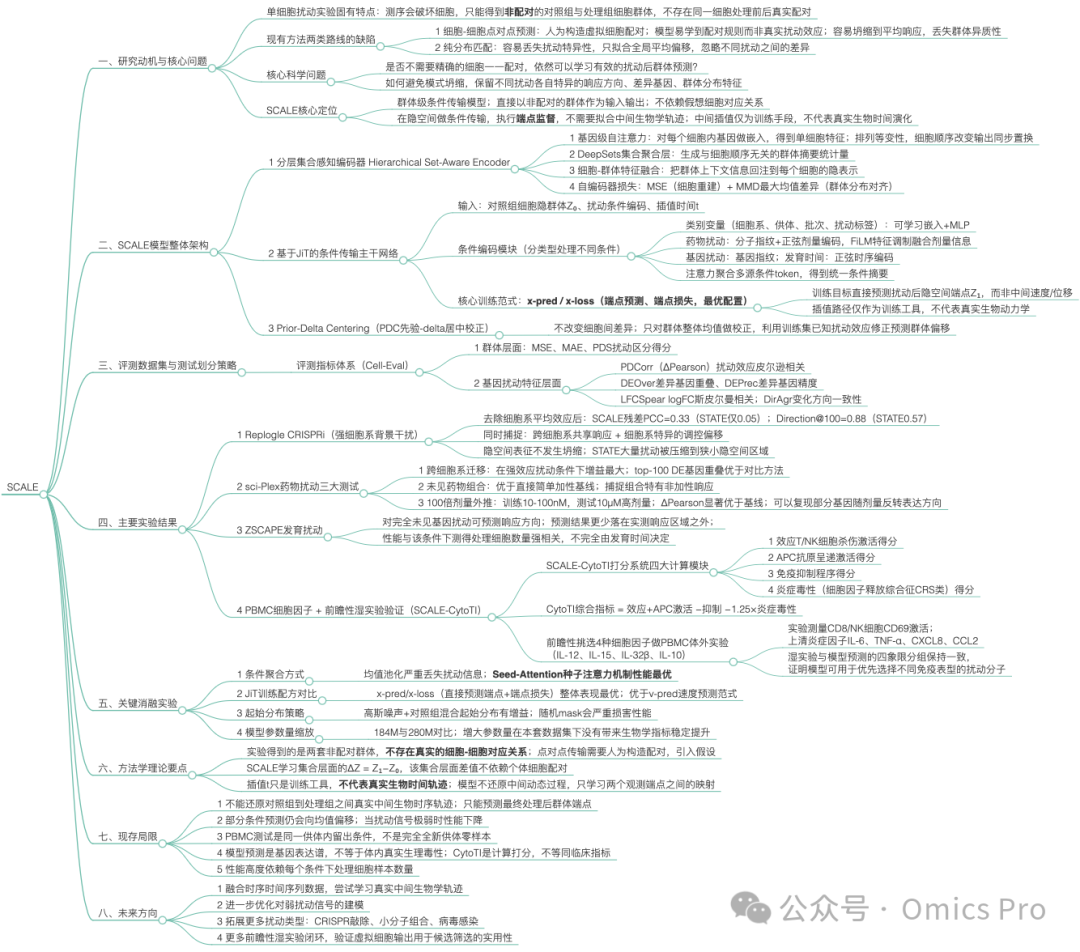
思维导图
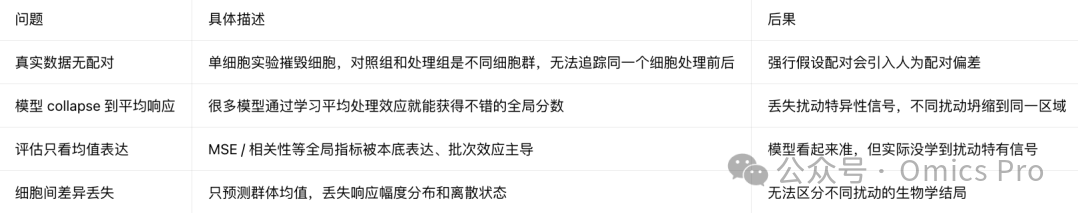
要解决的核心问题
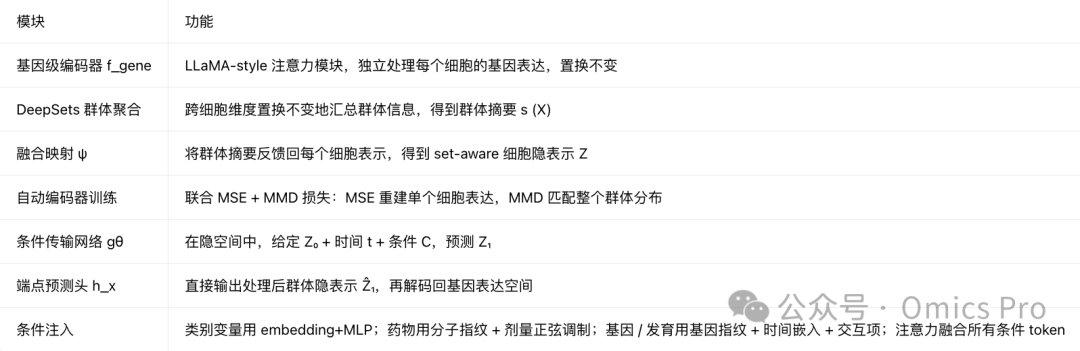
网络结构
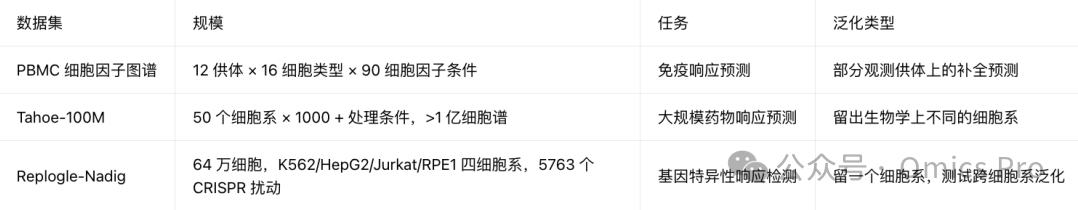
3大基准数据集
训练效率对比
BioNeMo框架
3数据集7指标总览
Table 2,粗体为最优
各任务关键发现
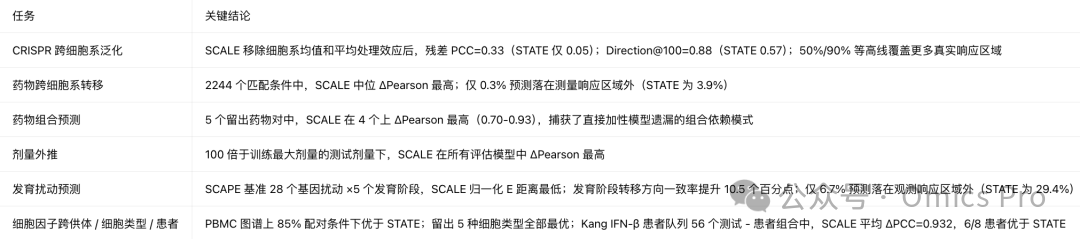
实验结果
参考
SCALE: Scalable Conditional Atlas-Level Endpoint transport for virtual cell perturbation prediction
https://www.biorxiv.org/content/10.64898/2026.03.17.712536v1
注:AI辅助创作,如有不当欢迎指出。内容仅供参考,不构成任何建议。