前言:Agent 会聊天,但不会查你的日志
让 AI Agent 参与故障排查,是 AIOps 落地里最自然的场景:值班同学对着对话窗口说一句"帮我看看 192.168.1.10 昨天上午有没有 error",Agent 就该自己去查日志、聚合统计、给出结论。但要做到这一点,后端必须把查询能力"翻译"成大模型能理解、能调用的工具------这就是 MCP(Model Context Protocol)要解决的问题。
MCP 是 Anthropic 于 2024 年底开源的模型上下文协议,如今已成为 AI Agent 接入外部系统的事实标准:服务端把能力声明成一个个"工具"(Tool),客户端(Claude Desktop、各类 Agent 平台、IDE 插件)通过统一的协议发现并调用它们。对 Java 后端来说,Spring AI 已经提供了完整的 MCP Server 支持,几个注解就能把一个 Service 方法变成 Agent 可调用的工具。
但"能调通"和"好用"之间隔着一条鸿沟。大模型不会读你的代码,它只看你写在注解里的几十字描述;它的训练数据有时间截止点,会把"5 月 6 日"解析成错的年份;它还会自作聪明地把你示例里的字段映射当成规则。这些坑,我们在日志平台的 MCP 服务(内部模块 log-mcp,SSE 协议对外)上全部踩过一遍。
本文就把这套实践完整拆开:场景与工具拆分 → Spring AI 接入 → 7 条工具设计原则 → 核心代码 → 4 个真实踩坑案例 → 上线前 Checklist 。文中代码可以直接对照落地,底层检索 DSL 的写法可以参考我之前的《Elasticsearch 日志检索 DSL 实战:时间范围查询、字段去重、分钟级统计与最新日志获取》,平台整体架构见《云原生日志采集与检索架构实战》。
一、场景:把"查日志"拆成 Agent 能驾驭的 5 个工具
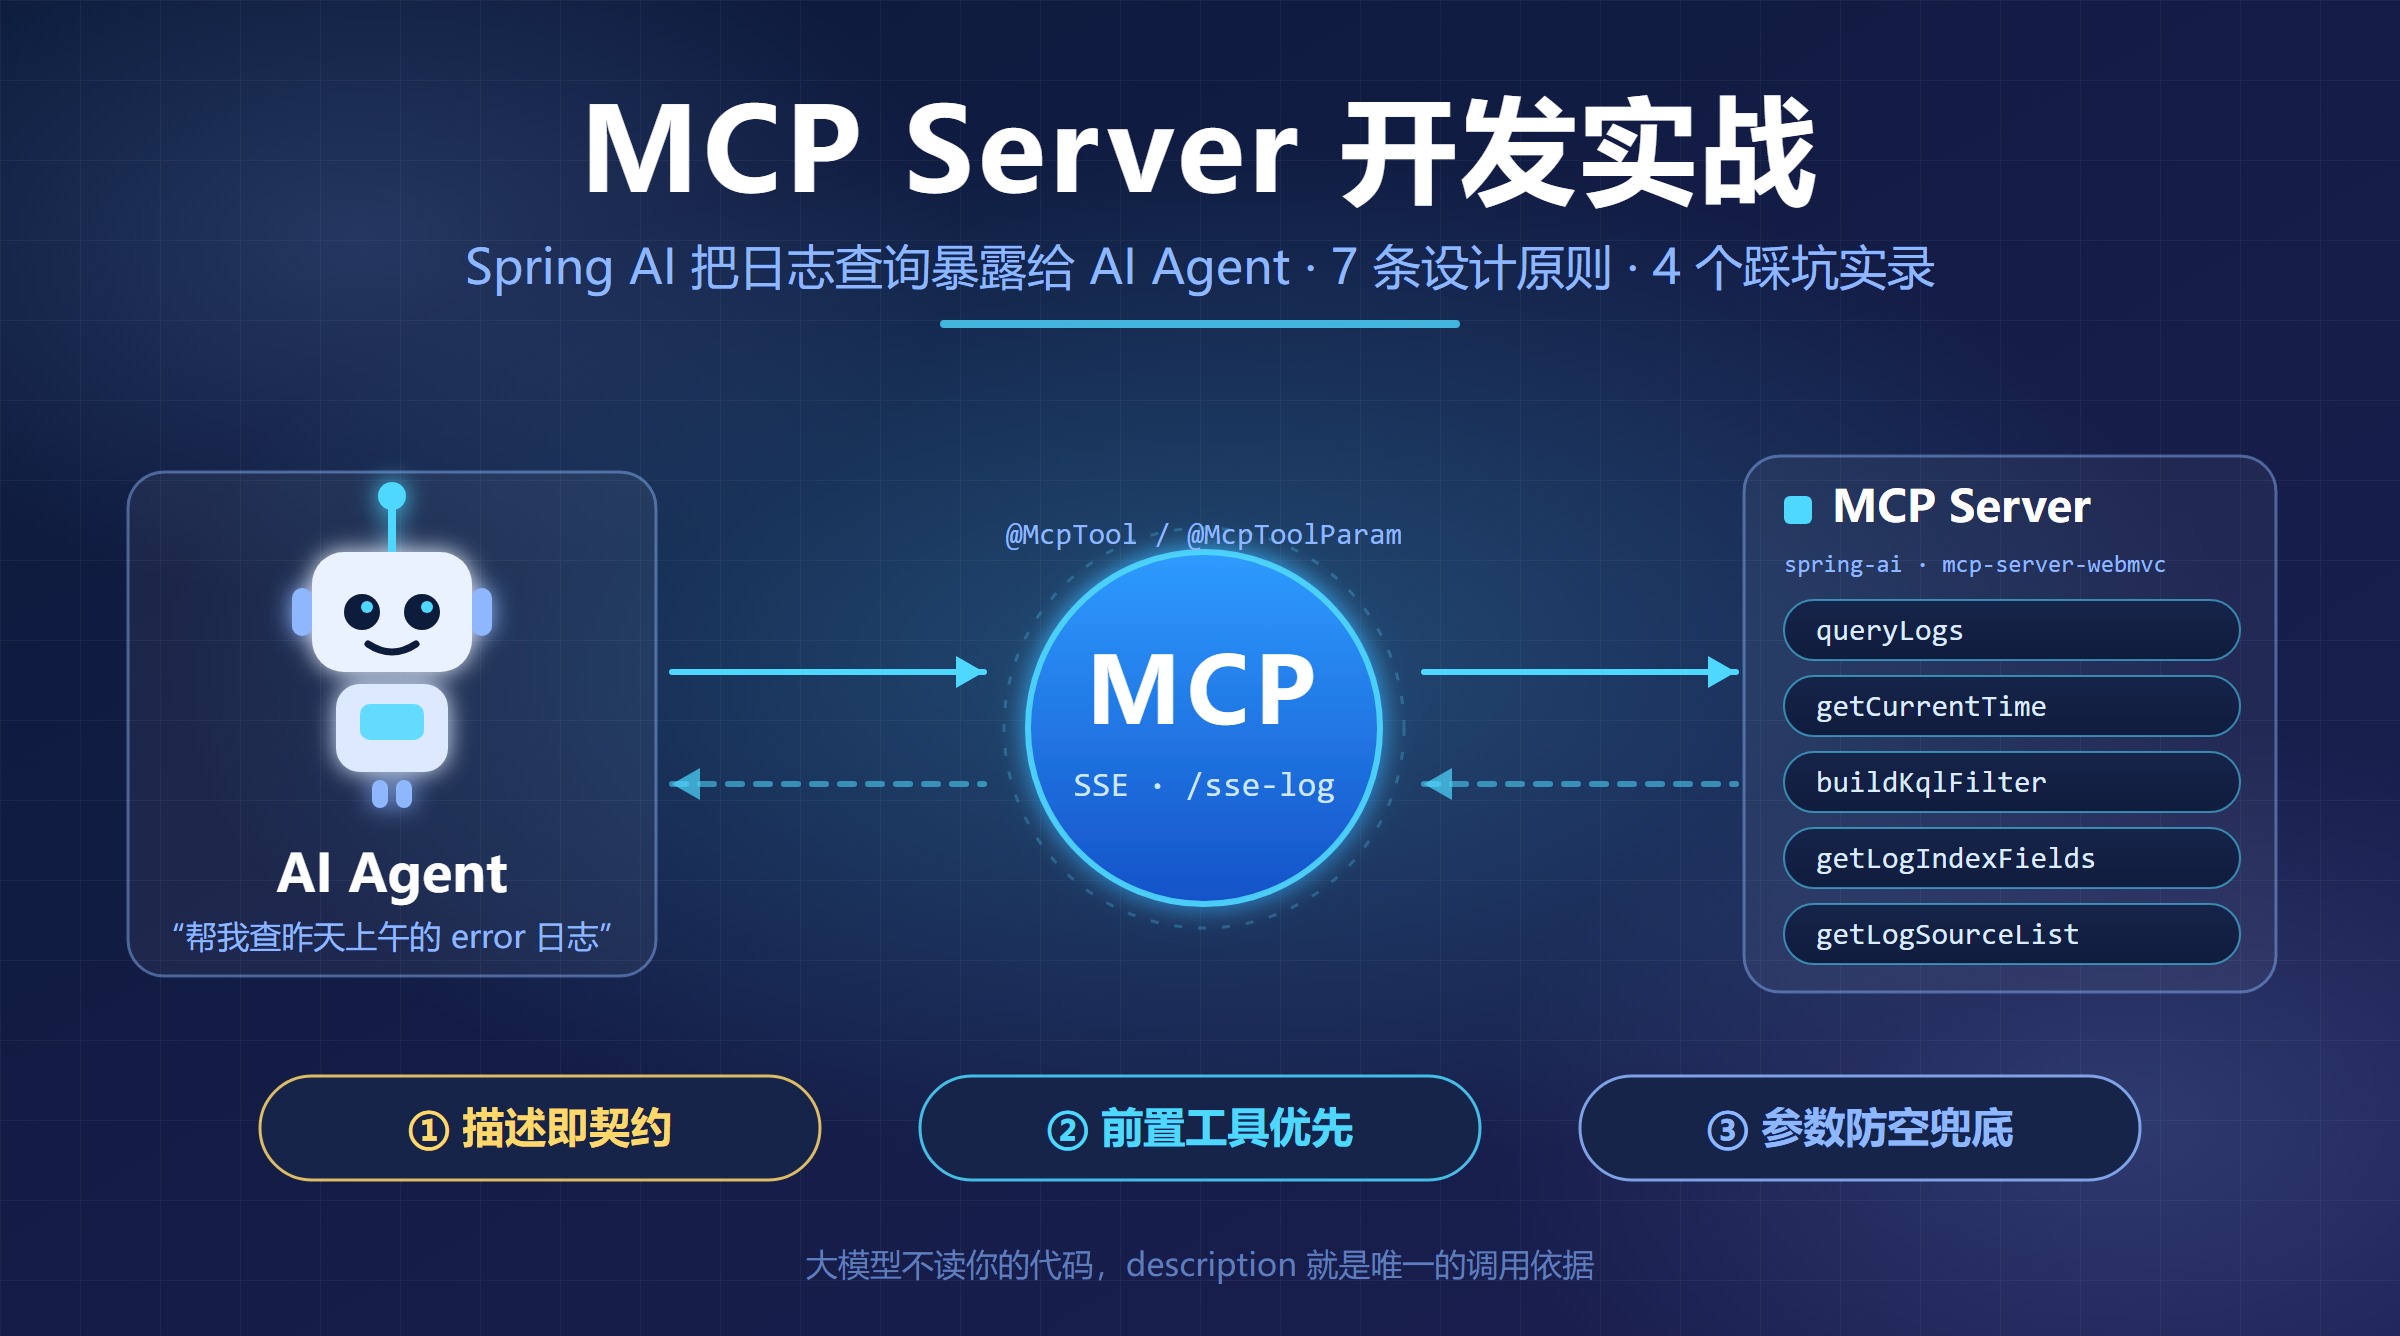
我们的日志平台承载着多套系统的日志检索,人用的查询界面背后是一套 ES 检索服务。要做 Agent 入口时,第一反应可能是"暴露一个大而全的查询接口"------这恰恰是灾难的开始(原因见原则 1)。最终的拆分方案是 5 个工具:
| 工具 | 分类 | 职责 |
|---|---|---|
queryLogs |
核心工具 | 执行日志内容查询,返回结构化结果 |
getCurrentTime |
前置工具 | 提供当前系统时间基准 |
buildKqlFilter |
前置工具 | 把 KQL 关键词表达式转成 filter_query JSON |
getLogIndexFields |
辅助工具 | 获取索引可用字段列表 |
getLogSourceList |
辅助工具 | 获取日志来源列表 |
三类工具的定位:
- 核心工具:必调,完成主逻辑,一次对话里通常只调它;
- 前置工具:核心工具的依赖,Agent 必须先调它们才能正确组装参数(时间基准、过滤条件);
- 辅助工具:按需调用,帮 Agent 确认"字段存不存在""有哪些日志来源"这类不确定信息。
一次典型调用的完整链路是:getCurrentTime(对齐时间)→ getLogIndexFields(确认字段)→ buildKqlFilter(组装过滤条件)→ queryLogs(查询)→ 格式化返回。工具间的依赖顺序不是靠 Agent 猜,而是全部写死在 description 里(原则 4)。
二、五分钟接入:Spring AI MCP Server
2.1 Maven 依赖
xml
<!-- Spring AI 的 MCP 服务端 starter(WebMVC 版本) -->
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-mcp-server-webmvc</artifactId>
</dependency>
@McpTool / @McpToolParam 注解来自 spring-ai-community 的 mcp-annotations 模块,随 starter 一并引入,无需额外配置。
2.2 配置文件
yaml
# application-mcp.yaml
spring:
  ai:
    mcp:
      server:
        protocol: sse          # 通信协议:SSE(Server-Sent Events)
        sse-endpoint: /sse-log # SSE 端点路径,外部 AI 平台通过此地址连接
两个配置项的取舍:
| 配置项 | 值 | 说明 |
|---|---|---|
protocol |
sse |
外部 AI 平台通过 HTTP 长连接订阅工具列表和调用结果,适合服务端单向推送场景 |
sse-endpoint |
/sse-log |
自定义端点路径,避免与同主机上其他 MCP 服务冲突 |
2.3 启动类扫描
确保启动类的 @ComponentScan(或 @SpringBootApplication 的默认扫描)能覆盖到 MCP 工具所在的包(如 com.example.logmcp),并通过 spring.profiles.include 或自动扫描让 application-mcp.yaml 生效。之后外部平台访问 http://<host>:<port>/sse-log 建立 SSE 连接,就能发现并调用本服务暴露的全部 MCP 工具。
2.4 核心注解速览
java
@McpTool(description = "...")        // 标记方法为 MCP 工具
@McpToolParam(description = "...") // 标记参数,向大模型说明含义与格式两个注解看起来朴素,但后文会反复强调:description 是大模型调用你工具的唯一依据,它的每一个字都在参与"编程"。
三、7 条工具设计原则
原则 1:原子化,最小单元
每个 MCP 工具只干一件事,且干到极致。 不要把多个职责塞进一个工具里。
java
// ❌ 错误:一个工具既查日志又查字段又查来源,大模型无法判断该传哪些参数
@McpTool(description = "查询日志、字段、来源...")
public String queryEverything(...) { ... }

// ✅ 正确:拆分为独立工具,每个工具职责单一
@McpTool(description = "查询系统日志...") public String queryLogs(...) { ... }
@McpTool(description = "获取日志索引字段列表...") public String getLogIndexFields(...) { ... }
@McpTool(description = "获取日志来源列表...") public String getLogSourceList(...) { ... }
好处非常实际:
- 大模型调用意图清晰,不会传错参数;
- 工具描述简洁,token 占用少,大模型更容易理解;
- 便于独立测试、独立复用;
- 失败时定位问题快------哪个工具出错一目了然。
原则 2:描述即契约
大模型只能看到你写在 @McpTool 和 @McpToolParam description 里的文字,它不会读你的代码。description 就是唯一的调用依据,怎么强调都不过分。
一个真实的反面教材------为了"方便",在描述里列举了常用字段:
java
// ❌ 错误:给出字段列表,暗示大模型可以自行推断映射
"常用字段包括:level(日志级别)、host_ip(目标IP)、raw_message(日志内容)..."
大模型看到后会自行联想:用户说"错误日志" → 自动映射为 level: ERROR。结果查询不到数据,因为底层对无字段关键词默认走 raw_message 全文匹配,而该字段的真实取值未必是大写。正确做法是把规则写死、把兜底行为讲明白:
java
// ✅ 正确:明确规则,禁止推断
"用户没有明确指定'字段名:值'格式时,只传纯关键词,不要擅自推断字段。"
"无字段的关键词会自动匹配日志全文(raw_message),无需也不应额外指定字段。"
原则 3:前置工具优先
大模型存在训练数据截止日期,对"当前时间"的认知可能是错的。用户说"查 5 月 6 日的日志",大模型完全可能解析成上一年或训练数据里的默认年份。
必须提供 getCurrentTime 前置工具,并在所有涉及时间的工具描述中反复强调:
java
@McpTool(description = "...Agent必须先调用 getCurrentTime 获取当前系统时间作为基准,"
+ "再解析生成 yyyy-MM-dd HH:mm:ss.SSS 格式的时间参数。")注意一个细节:不要在 description 里写死具体年份(如"当前是 2026 年"),到明年它就变成新的错误来源。
原则 4:执行顺序显性化
工具间存在依赖时(A 必须在 B 之前调用),必须在 description 中写明步骤编号,靠大模型自己推断调用顺序是不可靠的:
java
// ✅ 正确:明确步骤依赖
"如果用户提到了字段概念但没用'字段:值'格式,必须先完成第4步调用 getLogIndexFields,"
+ "确认后再调用 buildKqlFilter 构建 KQL。"
原则 5:参数防空兜底
下游服务可能对入参 Map 的 value 直接调用 .toString(),传入 null 就是裸 NPE------而且这发生在 Agent 调用链的最深处,报错信息对大模型毫无可读性。MCP 层组装参数时,必须保证所有参数都有非 null 默认值:
java
// ✅ 正确:无条件 put,空值用默认值填充
queryParam.put("logId", "ALL");
queryParam.put("field", "log_time");
queryParam.put("order", "log_time desc");
queryParam.put("hostIp", StringUtils.hasText(hostIp) ? hostIp : "");
queryParam.put("system", StringUtils.hasText(systemCode) ? systemCode : "");
queryParam.put("filter_query", StringUtils.hasText(filterQuery) ? filterQuery : "");
queryParam.put("logSource", StringUtils.hasText(logSource)
        ? Collections.singletonList(logSource) : Collections.emptyList());
queryParam.put("tag", Collections.emptyList());
queryParam.put("tenantCode", "system");
原则 6:工具分类清晰
在对外文档(SKILL 文档,见第六节)里给工具打上"核心 / 前置 / 辅助"标签,帮大模型理解调用优先级:核心必调,前置先行,辅助按需。分类本身就是一种提示工程。
原则 7:描述与文档三方一致
@McpTool description、@McpToolParam description、SKILL 文档(SKILL-xxx.md)必须保持三方一致,任何一方更新后其他两方同步修改。不一致的后果很隐蔽:大模型从文档学到一套规则、从工具描述学到另一套,行为随机分裂------这次遵守那次违反,排查起来极其折磨。
四、核心工具完整实现
4.1 最简单的工具:getCurrentTime
java
package com.example.logmcp;

import com.example.logmcp.util.McpLogToolHelper;
import lombok.extern.slf4j.Slf4j;
import org.springaicommunity.mcp.annotation.McpTool;
import org.springframework.stereotype.Service;

@Slf4j
@Service
public class McpCurrentTimeService {

    @McpTool(description = "获取当前系统时间。当用户查询涉及相对时间或自然语言描述的时间时,"
                    + "Agent应先调用此工具获取当前时间作为基准,再解析用户意图。\n"
                    + "例如用户说'5月6日上午9点',Agent应先获取当前时间,"
                    + "再推断准确的年份并生成 yyyy-MM-dd HH:mm:ss.SSS 格式的时间参数。\n"
                    + "返回格式:yyyy-MM-dd HH:mm:ss.SSS")
    public String getCurrentTime() {
        String currentTime = McpLogToolHelper.getCurrentTime();
        log.info("MCP获取当前时间:currentTime={}", currentTime);
        return currentTime;
    }
}
注意 description 里的写法:给了一个具体的自然语言例子("5月6日上午9点"),并把期望的输出格式写在最后。举例子比讲道理有效得多,这是写给大模型看的 few-shot。
4.2 核心工具:queryLogs
java
@Slf4j
@Service
public class McpLogQueryService {

    @Autowired
    private ILogRetrievalService logRetrievalService;

    @McpTool(description = "查询系统日志。当用户想查看日志、排查故障、分析系统问题时调用。\n"
                    // 前置依赖说明
                    + "如果用户查询涉及相对时间或自然语言描述的时间,"
                    + "Agent必须先调用 getCurrentTime 获取当前系统时间作为基准,"
                    + "再解析生成 yyyy-MM-dd HH:mm:ss.SSS 格式的时间参数。\n"
                    // 参数约束
                    + "hostIp 和 systemCode 至少提供一个。\n"
                    // 过滤条件依赖说明
                    + "如需对日志内容进行过滤,请先调用 buildKqlFilter 工具"
                    + "将自然语言转换为 filterQuery,再传入本工具。\n"
                    // 字段查询依赖说明
                    + "如果用户查询涉及特定字段条件(如'ERROR级别''状态码500'),"
                    + "且该字段不是 queryLogs 已知参数(如 hostIp、systemCode、logSource),"
                    + "必须先调用 getLogIndexFields 获取可用字段列表,确认字段存在后再构建过滤条件。\n"
                    // 日志来源依赖说明
                    + "如果用户想按日志来源筛选,可先调用 getLogSourceList 获取可用来源列表,再传入 logSource 参数。\n"
                    + "pageSize 最大限制为 100 条。")
    public String queryLogs(
            @McpToolParam(description = "目标IP地址,如 192.168.1.1") String hostIp,
            @McpToolParam(description = "系统编码,映射到system字段过滤。若Agent已通过CMDB查得编码则直接传入") String systemCode,
            @McpToolParam(description = "开始时间,格式 yyyy-MM-dd HH:mm:ss.SSS,如 2026-05-06 00:00:00.000") String startTime,
            @McpToolParam(description = "结束时间,格式 yyyy-MM-dd HH:mm:ss.SSS,如 2026-05-06 23:59:59.999") String endTime,
            @McpToolParam(description = "日志内容过滤条件,filter_query JSON 格式。\n"
                    + "由 buildKqlFilter 工具将 KQL 表达式转换得到,直接传入即可。\n"
                    + "如不填则查询所有日志内容。") String filterQuery,
            @McpToolParam(description = "页码,从1开始,不填默认为1") Integer pageNum,
            @McpToolParam(description = "每页返回条数,不填默认为50,最大不超过100") Integer pageSize,
            @McpToolParam(description = "日志来源筛选,如 /var/log/nginx/access.log。不填则查询所有来源。\n"
                    + "可从 getLogSourceList 获取该时间段内的可用来源列表。") String logSource
    ) {
        // 参数校验:失败时返回可读的错误提示,而不是抛异常
        if (!StringUtils.hasText(hostIp) && !StringUtils.hasText(systemCode)) {
            return "请提供IP地址或系统编码至少一项。";
        }
        if (!StringUtils.hasText(startTime) || !StringUtils.hasText(endTime)) {
            return "请提供查询时间范围(开始时间和结束时间)。";
        }

        int currentPage = (pageNum != null && pageNum > 0) ? pageNum : 1;
        int currentSize = (pageSize != null && pageSize > 0) ? pageSize : 50;
        if (currentSize > 100) {
            currentSize = 100;
        }

        Map<String, Object> queryParam = buildQueryParam(hostIp, systemCode,
                startTime, endTime, filterQuery, currentPage, currentSize, logSource);

        LogPageResult result;
        try {
            result = logRetrievalService.logQuery(queryParam);
        } catch (Exception e) {
            log.error("MCP日志查询异常", e);
            return "日志查询发生异常:" + e.getMessage();
        }

        return McpLogToolHelper.formatResult(result, currentPage, currentSize);
    }

    /**
     * 组装查询参数 ------ 所有参数必须设置非 null 默认值(原则 5)
     */
    private Map<String, Object> buildQueryParam(String hostIp, String systemCode,
                                                 String startTime, String endTime,
                                                 String filterQuery, int from, int size,
                                                 String logSource) {
        Map<String, Object> queryParam = new HashMap<>();

        queryParam.put("logId", "ALL");
        queryParam.put("field", "log_time");
        queryParam.put("from", from);
        queryParam.put("size", size);
        queryParam.put("order", "log_time desc");  // 带字段的排序,避免歧义
        queryParam.put("hostIp", StringUtils.hasText(hostIp) ? hostIp : "");
        queryParam.put("system", StringUtils.hasText(systemCode) ? systemCode : "");
        queryParam.put("startTime", startTime);
        queryParam.put("endTime", endTime);
        queryParam.put("filter_query", StringUtils.hasText(filterQuery) ? filterQuery : "");
        queryParam.put("logSource", StringUtils.hasText(logSource)
                ? Collections.singletonList(logSource) : Collections.emptyList());
        queryParam.put("tag", Collections.emptyList());
        queryParam.put("tenantCode", "system");

        return queryParam;
    }
}
值得注意的三个细节:
- description 里用注释分段(前置依赖/参数约束/依赖说明),源码可读,大模型读到的也是分好段的规则;
- 参数校验失败返回中文提示而非抛异常------这段文字会直接回到大模型上下文里,它读到"请提供IP地址或系统编码至少一项"后会自己补参数重试;
- 异常兜底拼上
e.getMessage(),让大模型有机会理解失败原因并换个方式重试。
4.3 辅助类:McpLogToolHelper
java
public class McpLogToolHelper {

    /** 获取默认开始时间(当天 00:00:00.000) */
    public static String getDefaultStartTime() {
        return LocalDate.now().format(DateTimeFormatter.ofPattern("yyyy-MM-dd")) + " 00:00:00.000";
    }

    /** 获取默认结束时间(当天 23:59:59.999) */
    public static String getDefaultEndTime() {
        return LocalDate.now().format(DateTimeFormatter.ofPattern("yyyy-MM-dd")) + " 23:59:59.999";
    }

    /** 获取当前系统时间(精确到毫秒) */
    public static String getCurrentTime() {
        return LocalDateTime.now().format(DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss.SSS"));
    }
}
五、KQL 转换工具:把"描述即契约"用到极致
buildKqlFilter 负责把自然语言风格的关键词表达式(KQL)转成底层检索服务需要的 filter_query JSON。它是"大模型擅自推断字段"问题的主战场,description 的写法非常有代表性:
java
@Slf4j
@Service
public class McpKqlConverterService {

    @McpTool(description = "将自然语言风格的关键词查询表达式(KQL)转换为 filter_query JSON 格式。"
                    + "当用户查询涉及日志内容过滤条件时,Agent应先调用此工具生成 filterQuery,再传入 queryLogs 进行查询。\n"
                    + "\n"
                    // ⚠️ 核心约束必须写在最前面
                    + "【重要规则】\n"
                    + "1. 用户没有明确指定\"字段名:值\"格式时(如只说\"错误日志\"\"查timeout\"),"
                    + "只传纯关键词,不要擅自推断字段。"
                    + "无字段的关键词会自动匹配日志全文(raw_message),无需也不应额外指定字段。\n"
                    + "2. 只有用户明确说了\"字段:值\"格式(如\"level: ERROR\")时,才保留字段名。\n"
                    + "3. 如果用户提到了字段概念但没用\"字段:值\"格式(如\"按级别查ERROR\"\"按IP查192.168\"),"
                    + "必须先调用 getLogIndexFields 获取真实字段名,确认字段存在后再构建 KQL。\n"
                    + "\n"
                    + "KQL 语法规则:\n"
                    + "1. 关键词直接用单词,如:error, exception, timeout\n"
                    + "2. '和/且/并且' 用 and 连接:error and exception\n"
                    + "3. '或/或者' 用 or 连接:error or warn\n"
                    + "4. '不包含/不是' 用 not:not timeout\n"
                    + "5. 含空格的关键词用双引号:\"connection refused\"\n"
                    + "6. 多个条件组合:error and exception and timeout\n"
                    + "\n"
                    // ⚠️ 示例只展示纯关键词写法,不要展示带字段的示例
                    + "自然语言 → KQL 示例:\n"
                    + "• '查包含error和exception的日志' → error and exception\n"
                    + "• '查不包含timeout的' → not timeout\n"
                    + "• '查connection refused相关' → \"connection refused\"\n"
                    + "• '查有NullPointerException的' → NullPointerException")
    public String buildKqlFilter(
            // ⚠️ 参数描述同样避免带字段的示例
            @McpToolParam(description = "KQL 查询表达式,由Agent从用户自然语言中提取关键词和逻辑关系后转换。"
                    + "只传纯关键词,不要擅自添加字段。例如:error and exception、not timeout、NullPointerException 等。"
            ) String kqlExpression
    ) {
        // KQL → filter_query JSON 的转换逻辑(词法分析 + 布尔组合),略
    }
}
这段 description 的三处心机:
- 【重要规则】放在最前面------大模型对 description 开头的内容注意力最强;
- 语法规则用编号穷举,六条覆盖全部合法写法,不留给猜测空间;
- 示例刻意只给纯关键词形态,没有一个带字段的示例------你展示什么,大模型就模仿什么。
六、配套 SKILL 文档:给 Agent 的"使用说明书"
工具 description 负责"单点规则",跨工具的完整流程则写在 SKILL 文档里(多数 Agent 平台支持挂载技能文档,与 MCP 工具描述互补)。我们的 SKILL-log-query.md 核心是这份执行步骤:
markdown
## 执行步骤

1. **解析用户意图**:从用户输入中提取关键参数信息(IP、系统编码、时间范围、
   关键词过滤条件、日志来源等)。
2. **获取时间基准**:如果用户时间描述涉及相对时间或自然语言(如"5月6日""上午9点"
   "最近半小时"),**必须先调用 `getCurrentTime` 获取当前系统时间作为基准**,
   再据此推断准确的年份并解析为 `yyyy-MM-dd HH:mm:ss.SSS` 格式。
3. **转换过滤条件(可选)**:如果用户提供了自然语言风格的关键词过滤条件,
   调用 `buildKqlFilter` 将 KQL 表达式转换为 `filter_query` JSON。
   - **规则**:用户没有明确指定`字段名:值`格式时,只传纯关键词,**不要擅自推断字段**。
     无字段的关键词会自动匹配日志全文(raw_message)。
   - 如果用户提到了字段概念但没用`字段:值`格式,**必须先完成第4步调用
     `getLogIndexFields` 获取真实字段名**,确认后再调用 `buildKqlFilter` 构建 KQL。
4. **获取字段辅助(可选)**:如果用户查询涉及特定字段条件(如"ERROR级别""状态码500"),
   且该字段不是 `queryLogs` 已知参数(如 hostIp、systemCode、logSource),
   先调用 `getLogIndexFields` 获取可用字段名和类型,确认字段存在后再构建过滤条件。
5. **获取日志来源(可选)**:如果用户想按日志来源筛选,先调用 `getLogSourceList`
   获取可用来源列表。
6. **组装参数并查询**:将解析/转换后的参数组装,调用 `queryLogs` 执行日志查询。
7. **返回结果**:将查询到的日志列表格式化后返回给用户。
注意步骤 3 和步骤 4 的交叉引用写法------"必须先完成第4步"这类显式编号,就是原则 4 的落地。
七、踩坑实录:4 个真实案例
案例 1:大模型时间解析错误
现象:用户说"查 5 月 6 日的日志",大模型传了错误的年份,查了个寂寞。
根因:大模型训练数据有截止日期,默认年份停留在训练语料的"最近一年"。
修复 :提供 getCurrentTime 前置工具;在所有时间相关工具的 description 中强调"必须先调用 getCurrentTime 获取当前系统时间作为基准";不在 description 里写死具体年份。
案例 2:大模型擅自推断字段
现象 :用户说"查错误日志",大模型给 buildKqlFilter 传了 level: ERROR,结果一条都查不到。
根因:早期版本的工具 description 里列举了"常用字段",大模型看到字段名就自行联想映射,完全无视底层默认走全文匹配的事实。
修复:删掉 description 里的"常用字段列表";删掉所有带字段的 KQL 示例;写明规则"用户没指定字段名:值格式时,只传纯关键词";写明兜底行为"无字段的关键词会自动匹配 raw_message"。
案例 3:下游服务 NPE
现象 :queryLogs 调用检索服务时偶发空指针,Agent 收到一长串 Java 堆栈,无法自我修复。
根因 :下游服务对入参 Map 的 value 直接 .toString(),value 为 null 或 key 缺失即 NPE。
修复 :MCP 层 buildQueryParam 对所有参数无条件 put,null 一律替换为 Collections.emptyList() 或 ""。原则 5 由此而来。
案例 4:工具描述与文档不一致
现象:Agent 行为不稳定,同一句话有时遵守规则有时不遵守。
根因 :@McpTool description、@McpToolParam description、SKILL 文档三方内容漂移------改了代码忘了同步文档,大模型从两个渠道学到两套规则。
修复:建立修改 checklist,任何一方变更时同步更新另外两方。
八、最佳实践 Checklist
新增或修改 MCP 工具前,逐条确认:
- 描述是否足够明确? 大模型能否仅凭 description 正确调用?
- 是否有前置依赖? 若有,是否在 description 中明确说明调用顺序?
- 时间参数是否要求先调 getCurrentTime? 涉及时间的工具都要写。
- 是否列举了误导性字段/示例? 避免大模型自行推断。
- 参数是否有非 null 默认值? 防止下游 NPE。
- 返回值是否格式化? 返回给大模型的文本应清晰、结构化。
- 三方描述是否一致?
@McpTool、@McpToolParam、SKILL 文档是否同步? - 是否提供了错误提示? 参数校验失败时,返回明确的错误信息而非抛异常。
结语
MCP 把"后端接口"升级成了"大模型的 API",但协议只解决了通信问题,好不好用取决于你写给大模型的那几十字 description。回头看这 7 条原则,本质上都是在回答同一个问题:当一个不会读代码、没有常识、只有上下文的调用方来使用你的服务时,契约应该怎么写? 原子化降低选择难度,描述即契约消除歧义,前置工具补齐时间基准,参数兜底守住失败底线。
把这套思路迁移到其他场景(查监控指标、执行运维工单、检索知识库)是一样的打法:先拆工具,再写"给大模型看的说明书",最后用真实对话回灌调优。
你在 MCP 工具的 description 上踩过什么坑?欢迎在评论区交流------特别是"大模型不按套路传参"的案例,攒得多了我整理一篇进阶篇。