
【作者主页】Francek Chen
【专栏介绍】⌈ ⌈ ⌈大数据技术原理与应用 ⌋ ⌋ ⌋专栏系统介绍大数据的相关知识,分为大数据基础篇、大数据存储与管理篇、大数据处理与分析篇、大数据应用篇。内容包含大数据概述、大数据处理架构Hadoop、分布式文件系统HDFS、分布式数据库HBase、NoSQL数据库、云数据库、MapReduce、Hadoop再探讨、数据仓库Hive、Spark、流计算、Flink、图计算、数据可视化,以及大数据在互联网领域、生物医学领域的应用和大数据的其他应用。
【GitCode】专栏资源保存在我的GitCode仓库:https://gitcode.com/Morse_Chen/BigData_principle_application。
文章目录
-
- 一、传统数据仓库面临的挑战
- [二、Hive 简介](#二、Hive 简介)
- [三、Hive 与 Hadoop 生态系统中其他组件的关系](#三、Hive 与 Hadoop 生态系统中其他组件的关系)
- [四、Hive 与传统数据库的对比分析](#四、Hive 与传统数据库的对比分析)
- [五、Hive 在企业中的部署和应用](#五、Hive 在企业中的部署和应用)
-
- [(一)Hive 在企业大数据分析平台部署框架中的应用](#(一)Hive 在企业大数据分析平台部署框架中的应用)
- [(二)Hive 在一些公司的应用](#(二)Hive 在一些公司的应用)
- 小结
一、传统数据仓库面临的挑战
随着大数据时代的全面到来,传统数据仓库面临的挑战主要包括以下几个方面。
(1)无法满足快速增长的海量数据存储需求。目前企业数据增长速度非常快,动辄几十 TB 的数据,已经大大超出了 Oracle/DB2 等传统数据仓库的处理能力。这是因为传统数据仓库大都基于关系数据库,关系数据库横向扩展性较差,纵向扩展性有限。
(2)无法有效处理不同类型的数据。传统数据仓库通常只能存储和处理结构化数据,但是,随着企业业务的发展,企业中部署的系统越来越多,数据源的数据格式越来越丰富,很显然,传统数据仓库无法处理如此众多的数据类型。
(3)计算和处理能力不足。由于传统数据仓库建立在关系数据库基础之上,因此,会存在一个很大的痛点,即计算和处理能力不足,当数据量达到 TB 量级后,传统数据仓库基本无法获得好的性能。
二、Hive 简介
Hive 是一个构建在 Hadoop 之上的数据仓库工具,在 2008 年 8 月开源。Hive 在某种程度上可以看作用户编程接口,其本身并不存储和处理数据,而是依赖 HDFS 来存储数据,依赖 MapReduce(或者 Tez、Spark)来处理数据。Hive 定义了简单的类似 SQL 的查询语言---HiveQL,它与大部分 SQL 语法兼容。
当采用 MapReduce 作为执行引擎时,HiveQL 语句可以快速实现简单的 MapReduce 任务,这样用户通过编写的 HiveQL 语句就可以运行 MapReduce 任务,不必编写复杂的 MapReduce 应用程序。对于 Java 开发工程师而言,不必把大量精力花费在记忆常见的数据运算与底层的 MapReduce Java API 的对应关系上;对于数据库管理员,可以很容易地把原来构建在关系数据库上的数据仓库应用程序移植到 Hadoop 平台上。所以说,Hive 是一个可以有效、合理、直观地组织和使用数据的分析工具。
现在,Hive 作为 Hadoop 平台上的数据仓库工具,应用已经十分广泛,主要是因为它具有的特点非常适合数据仓库应用程序。首先,当采用 MapReduce 作为执行引擎时,Hive 把 HiveQL 语句转换成 MapReduce 任务后,采用批处理的方式对海量数据进行处理。数据仓库存储的是静态数据,构建于数据仓库上的应用程序只进行相关的静态数据分析,不需要快速响应给出结果,而且数据本身也不会频繁变化,因而很适合采用 MapReduce 进行批处理。其次,Hive 本身提供了一系列对数据进行抽取、转换、加载的工具,可以存储、查询和分析存储在 Hadoop 中的大规模数据。这些工具能够很好地满足数据仓库各种应用场景,包括维护海量数据、对数据进行挖掘、形成意见和报告等。
三、Hive 与 Hadoop 生态系统中其他组件的关系
图1描述了当采用 MapReduce 作为执行引擎时,Hive 与 Hadoop 生态系统中其他组件的关系。HDFS 作为高可靠的底层存储方式,可以存储海量数据。MapReduce 对这些海量数据进行批处理,实现高性能计算。Hive 架构在 MapReduce、HDFS 之上,其自身并不存储和处理数据,而是分别借助于 HDFS 和 MapReduce 实现数据的存储和处理,用 HiveQL 语句编写的处理逻辑,最终都要转换成 MapReduce 任务来运行。Pig 可以作为 Hive 的替代工具,它是一种数据流语言和运行环境,适用于在 Hadoop 平台上查询半结构化数据集,常用于 ETL 过程的一部分,即将外部数据装载到 Hadoop 集群中,然后转换为用户需要的数据格式。HBase 是一个面向列的、分布式的、可伸缩的数据库,它可以提供数据的实时访问功能,而 Hive 只能处理静态数据,主要是 BI 报表数据。就设计初衷而言,在 Hadoop 上设计 Hive,是为了减少复杂 MapReduce 应用程序的编写工作,在 Hadoop 上设计 HBase 则是为了实现对数据的实时访问,所以,HBase 与 Hive 的功能是互补的,它实现了 Hive不能提供的功能。
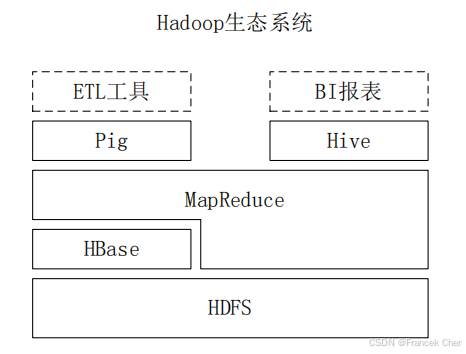
图1 Hive与Hadoop生态系统中其他组件的关系
四、Hive 与传统数据库的对比分析
Hive 在很多方面和传统的关系数据库类似,但是它的底层依赖的是 HDFS 和 MapReduce,所以在很多方面又有别于传统数据库。
表1 Hive与传统数据库的对比
| 对比项目 | Hive | 传统数据库 |
|---|---|---|
| 数据插入 | 支持批量导入 | 支持单条和批量导入 |
| 数据更新 | 不支持 | 支持 |
| 索引 | 支持 | 支持 |
| 分区 | 支持 | 支持 |
| 执行延迟 | 高 | 低 |
| 扩展性 | 好 | 有限 |
在数据存储方面,传统数据库一般依赖于本地文件系统,Hive 则依赖于分布式文件系统 HDFS。在索引方面,传统数据库可以针对多个列构建复杂的索引,大幅度提升数据查询性能,而 Hive 没有传统数据库中键的概念,它只能提供有限的索引功能,使用户可以在某些列上创建索引,从而加速一些查询操作。Hive 中给一个表创建的索引数据,会被保存在另外的表中。在分区方面,传统的数据库提供分区功能来改善大型表和具有各种访问模式的表的可伸缩性、可管理性,以及提高数据库效率;Hive 也支持分区功能,Hive 表是以分区的形式进行组织的,根据"分区列"的值对表进行粗略的划分,从而加快数据的查询速度。在执行引擎方面,传统数据库依赖自身的执行引擎,Hive 则依赖于 MapReduce、Tez 和 Spark 等执行引擎。在执行延迟方面,传统数据库中的 SQL 语句的延迟一般少于 1 秒,而 HiveQL 语句的延迟会达到分钟级。因为 Hive 构建在 HDFS 与 MapReduce 之上,所以,相对传统数据库,Hive 的延迟会比较高。在扩展性方面,传统数据库很难实现横向扩展,纵向扩展的空间也很有限;相反,Hive 的开发和运行环境是基于 Hadoop 集群的,所以具有较好的横向可扩展性。在数据规模方面,传统数据库一般只能存储有限规模的数据,Hive 则可以支持大规模的数据存储。
五、Hive 在企业中的部署和应用
(一)Hive 在企业大数据分析平台部署框架中的应用
Hadoop 除了广泛应用到云计算平台上实现海量数据计算外,还在很早之前就被应用到了企业大数据分析平台的设计与实现。当前企业中部署的大数据分析平台,除了依赖于 Hadoop 的基本组件 HDFS 和 MapReduce 外,还结合使用了 Hive、Pig、HBase 与 Mahout,从而满足不同业务场景的需求。图2描述了企业实际应用中一种常见的大数据分析平台部署框架。
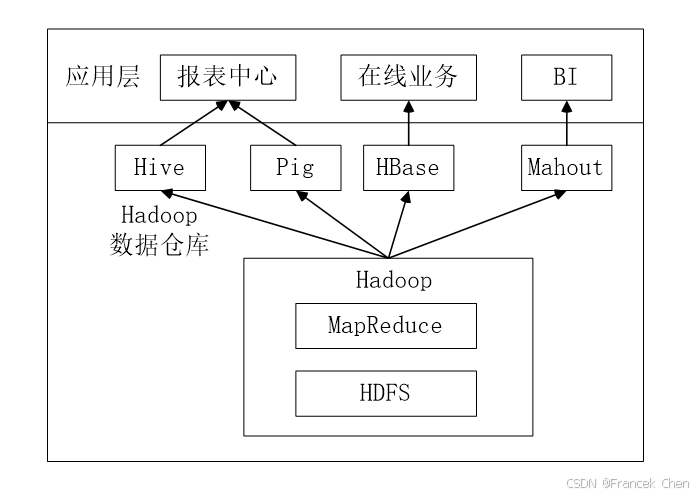
图2 企业实际应用中一种常见的大数据分析平台部署框架
在这种部署框架中,Hive 和 Pig 主要应用于报表中心。其中,Hive 用于报表分析,Pig 用于报表中数据的转换工作。因为 HDFS 不支持随机读写操作,而 HBase 正是为此开发的,可以较好地支持实时访问数据,所以,HBase 主要用于在线业务。Mahout 提供了一些可扩展的机器学习领域的经典算法的实现,旨在帮助开发人员更加方便快捷地创建商务智能(Business Intelligence,BI)应用程序,所以,Mahout 常用于 BI。
(二)Hive 在一些公司的应用
在一些公司,随着网站使用量的增加,网站上需要处理和存储的日志和维度数据激增。继续在 Oracle 系统上实现数据仓库,其性能和可扩展性已经不能满足需求,于是,一些公司开始使用Hadoop。图3展示了一些公司的数据架构的基本组件以及这些组件间的数据流。
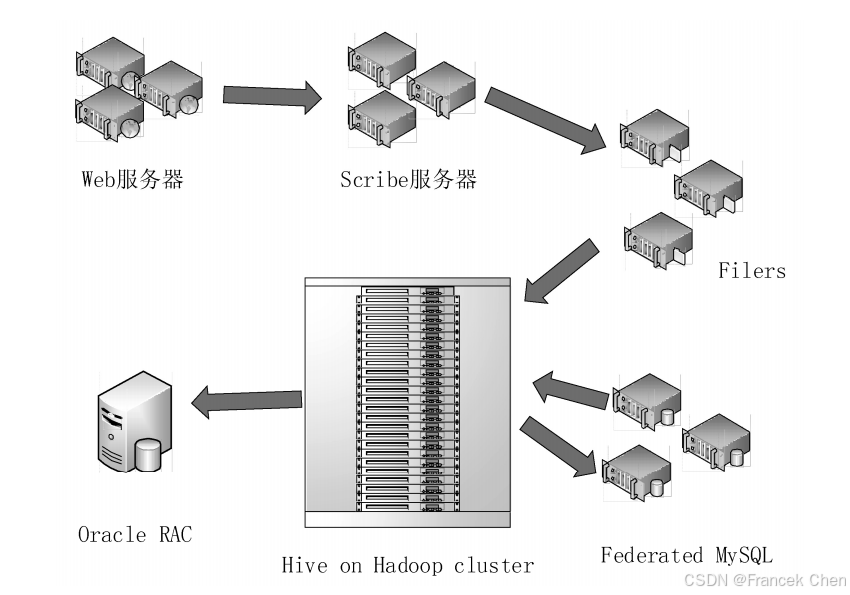
图3 一些公司的数据仓库架构的基本组件以及这些组件间的数据流
如图3所示,数据处理过程如下:首先,由 Web 服务器及内部服务(如搜索后台)产生日志数据,然后,Scribe 服务器把几百个甚至上千个日志数据集存放在几个甚至几十个网络文件服务器(Filers)上。网络文件服务器上的大部分日志文件被复制并存放在 HDFS 中。维度数据每天也从内部的 MySQL 数据库复制到这个 HDFS 中。然后,Hive 为 HDFS 收集的所有数据创建一个数据仓库,用户可以通过编写 HiveQL 创建各种概要信息、报表和历史数据分析。同时,内部的 MySQL 数据库也可以从中获取处理后的数据,并把需要实时联机访问的数据存放在 Oracle 实时应用集群上,这里的实时应用集群(Real Application Clusters,RAC)是 Oracle 的一项核心技术,可以在低成本服务器上构建高可用性数据库系统。
小结
传统数据仓库基于关系数据库,面临三大挑战:无法满足海量数据存储需求、无法有效处理多种数据类型、计算和处理能力不足。Hive 是构建在 Hadoop 之上的数据仓库工具,自身不存储和处理数据,而是依赖 HDFS 存储、MapReduce 等处理数据。它定义了类 SQL 的 HiveQL 语言,可将查询转换为 MapReduce 任务,适合批处理静态数据。与 Hadoop 生态中,HDFS 负责存储、MapReduce 负责计算、Pig 可作替代工具、HBase 实现实时访问,与 Hive 功能互补。与传统数据库相比,Hive 在数据更新、索引、执行延迟和扩展性等方面存在明显差异。在企业中,Hive 主要用于报表分析和数据仓库构建。
欢迎 点赞👍 | 收藏⭐ | 评论✍ | 关注🤗
