【LLM】第六章:大模型的创建与调用
说明:本章的环境安装在第一章已经进行了详细的说明了。需要环境搭建好,才好运行本篇的代码。
官方参考文档:
英文文档:Models - Docs by LangChain
中文文档:https://docs.langchain.org.cn/oss/python/langchain/models
一、本章要讲解的内容
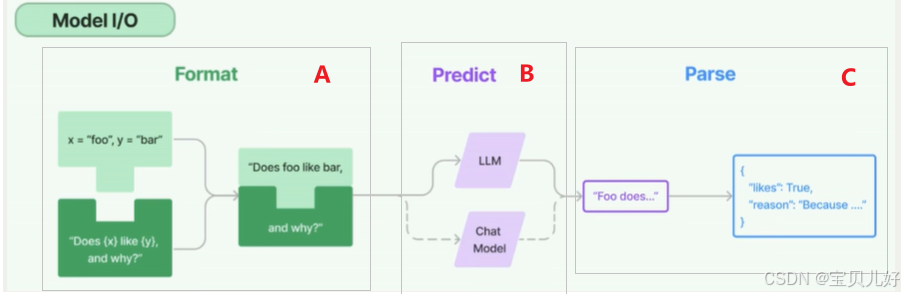
上图是我们和大模型交互的流程,分A、B、C三部分:
A是将要喂入大模型的提示词 ,是对提示词进行格式封装的,也称为提示词模板 ,后面我们会单独章节讲这部分。
B是大模型本模,也叫基座,可以是补全模型也可以是对话模型,当然目前都以对话模型 为主。本篇章的模型创建和调用,讲的就是这部分。
C是大模型的输出 ,因为大模型本身的输出格式,不一定是用户想要的输出格式,比如我们想让大模型输出字符串格式或者json格式或者其他指定的格式,那此时就得把大模型的输出进一步解析 (Parse)才能得到我们想要的特定输出格式。这部分内容也是后面章节会单独讲。
二、创建大模型的途径
(一)通过大模型提供商渠道
大模型提供商一般会提供两种 访问方式:一种是专用SDK,一种是OpenAI兼容接口。
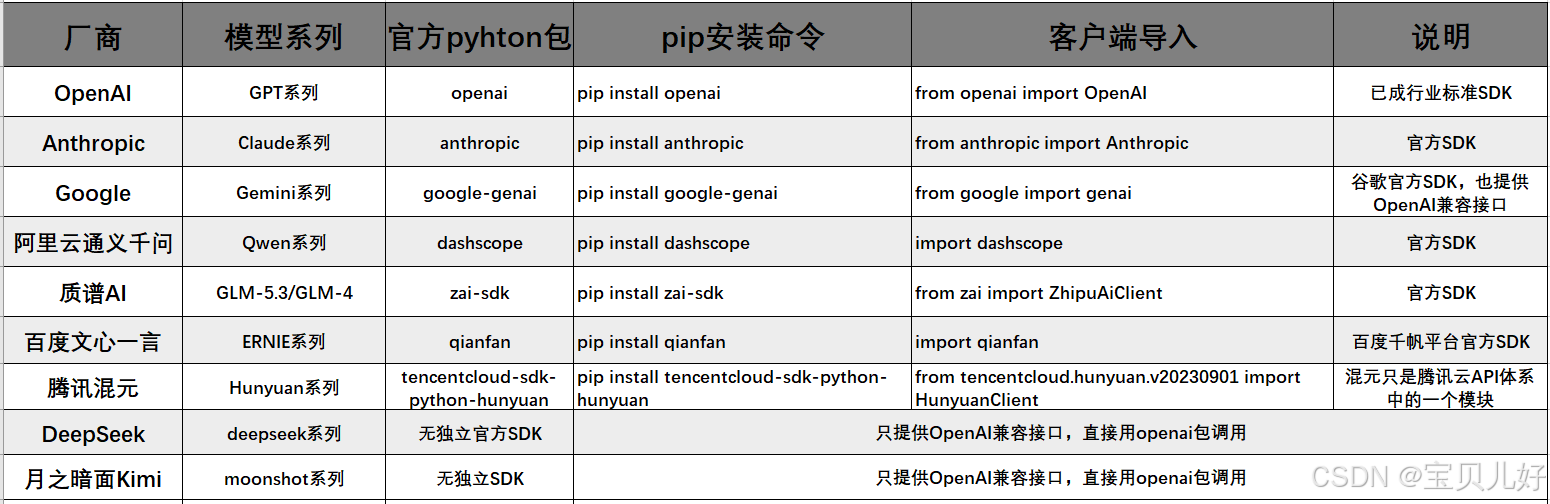
专用SDK 是模型提供商自己开发的、专供自己大模型的一套定制API格式,也叫厂商原生适配器 ,需要用户单独安装,支持厂商独有参数和独有特性。因为各家各模的代码不一样,需要的依赖也不一样,所以对用户来说模型切换成本高,后期维护成本大。
OpenAI是第一个做大模型API的,全世界已经有海量工具、框架都是基于它的接口写的,比如langchain、langgraph、LlamaIndex、各种Agent、RAG项目、第三方客户端等。后来的 大模型提供商,想无缝接入这个生态,一般还会提供一个OpenAI兼容接口。
下面是OpenAI的原生接口: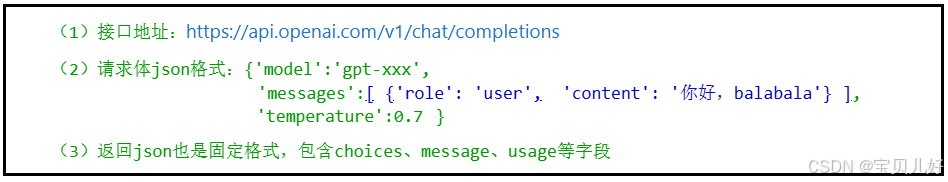
后来的大模型提供商会模仿OpenAI的接口规范,比如http协议格式、请求体的JSON结构、字段名称、返回格式等,和OpenAI几乎一模一样。这样开发者 直接用ChatOpenAI类 ,仅需修改model_name + api key + base_url这3个参数,就可以切换不同模型:
llm = ChatOpenAI(api_key="xxx", base_url="xxxx", model="xxx")
优点 :一是降低了用户接入成本,二是模型提供商的模型可以无缝接入整个OpenAI生态,所有现成项目不用大改,就能跑不同的大模型。三是,所有不同厂商的不同模型都用统一的ChatOpenAI接口调用,还不会出现额外依赖,简单方便。
国内的通义、质谱、DeepSeek、文心一言等都提供这种兼容接口。一些工具和框架,比如langchain、Ollama也提供OpenAI兼容接口。
缺点:一套代码切换所有模型,用户势必会拿不到某些模型的独有参数,比如有些模型的一些高级参数reasoning字段就会缺失,因为OpenAI协议里没有这些字段,用户自然就拿不到,但用厂商的SDK就可以拿到。
(二)通过线上大模型服务平台
线上大模型服务平台是提供大模型API服务的平台 。平台整合了多家大模型提供商 的多种模型。用户使用时只需要注册、充值、创建API-Key,就可以用API-Key和URL来调用平台提供的相应的模型的服务了。下图是几个主要的大模型服务平台:
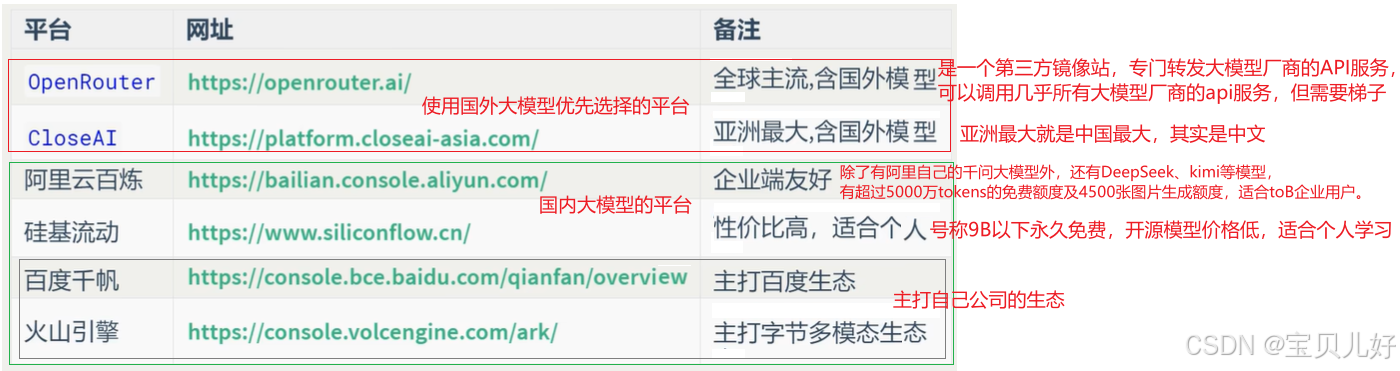
说明:每个平台配置时,都需要模型名、api-key、base-url。每个平台各有优劣点,看你自己的情况选择。
三、从langchain框架中初始化大模型
因为本系列的目标是基于langchain搭建智能体,所以这里重点讲一下如何用langchain的模型类初始化大模型。LangChain作为智能体搭建框架,是大模型与应用层的中间层,统一调用各类大模型是langchain的一个基本功能。
(一)langchain框架中的模型包分两类:
1、官方合作伙伴独立包,比如langchain-openai、lingchain-ollama、langchain-deepseek等,这些包是由langchain和模型提供商共同维护的,是一个个单独的pip包,安装时pip install langchain-xxx, 导入时from langchain_xxx import Chatxxx。这类包因为有模型提供商的支持,所以更新快、支持厂商全部新特性。
2、社区包,就是模型官方没有和langchain合作,是在langchain社区贡献而来的包,没有单独的pip包,全部放在langchain-community里面。比如国内的质谱、通义千问的大模型都是放在langchain-community中。所以我们要导这些模型时就要从langchain_community.chat_models中导入,这类模型一般都更新的比较慢。
所以,从langchain框架中导入大模型,要么是from langchain_xxx import Chatxxx,
要么是from langchain_community.chat_models import Chatxxx.
因为现在基本都是对话模型了,所以接口的名称一般都是比如ChatOpenAI、ChatAnthropic、ChatDeepSeek、ChatOllama、ChatHunyuan、ChatTongyi、ChatZhipuAI等。我们可以用这些类实例化具体的模型。
彩蛋:langchain的社区网址是:langchain_community | LangChain Reference ,社区生态非常丰富,里面有很多很多非常非常有用的类,慢慢找找会有很多惊喜。
(二)主要模型包介绍
langchain框架中的模型类,其实是langchain官方封装的适配器 ,适配langchain自己的消息、流式、LCEL统一接口,是一个"壳",不全等价于模型厂商的原生SDK,有的依赖厂商SDK,有的是自己手写的http请求,有的还需要额外安装依赖,比如:
1、ChatOpenAI (langchain-openai,独立包)底层依赖OpenAI的官方SDK,langchain做了一层封装。
此外,ChatOpenAI也是一个通用的模型调用接口,任何厂商任何模型可以用它试试。原因在二(一)中已经详细讲解了。
2、ChatAnthropic(langchain-ChatAnthropic,独立包)底层依赖Ahthropic SDK,langchain做了一层封装。
3、ChatDeepSeek(langchain-deepseek,独立包)是langchai与DeepSeek合作维护的langchain专属适配器,内部封装了http请求,所以这个类直接发http请求大模型API,不依赖官方SDK。
4、ChatZhipuAI (社区包)内部手写了http请求+pyjwt做鉴权,相当于写了一个简易的谱SDK,依赖langchain-community + pyjwt。不需要安装质谱官方SDK了。也所以后面我们使用ChatZhipuAI类的时候,如果你的ptjwt版本较高,会触发hmac警告。如果你不想要警告,就用质谱官方的SDK。那你要安装zai-sdk,from zai import ZhipuAiClient导入质谱模型。
5、ChatTongyi 内部就没有自己写http请求代码,而是直接调用阿里云的dashscope SDK,dashscope去发http请求。
说明:阿里云百炼,又叫Model Studio,旧名叫灵积DashScope。dashscope是官方的Python SDK。
源码逻辑:ChatTongyi类-->调用dashscope-->阿里云服务器返回结果-->langchain再把结果包装成AIMessage。
所以如果我们用ChatTongyi类调用千问模型就得安装dashscope包,pip install dashscope,不安装就会报导入错误,程序跑不起来:
6、ChatHunYuan(社区包)底层调用腾讯混元官方SDK,langchain做了一层封装。用这个类就必须要安装混元SDK包。
(三)示例1:初始化deepseek的一个模型,并调用测试
我们在第一章搭建环境时,就已经安装了langchain-deepseek==1.0.1包,在 langchain_community | LangChain Reference 网址中搜索chatdeepseek,就可以找到ChatDeepSeek类的文档和示例。
我们要从langchain_deepseek包中导入ChatDeepSeek类,实例化一个deepseek公司的大模型,第一步得去deepseek官网:https://www.deepseek.com 注册-登录-创建API key,拿着密钥才能调用。
(1)从deepseek官网首页中的"接口文档"进入DeepSeek API 文档:首次调用 API | DeepSeek API Docs ,从中可见下图右边的表格信息。我们实例化模型并调用需要填写的参数值就是从这里找的,如下左图: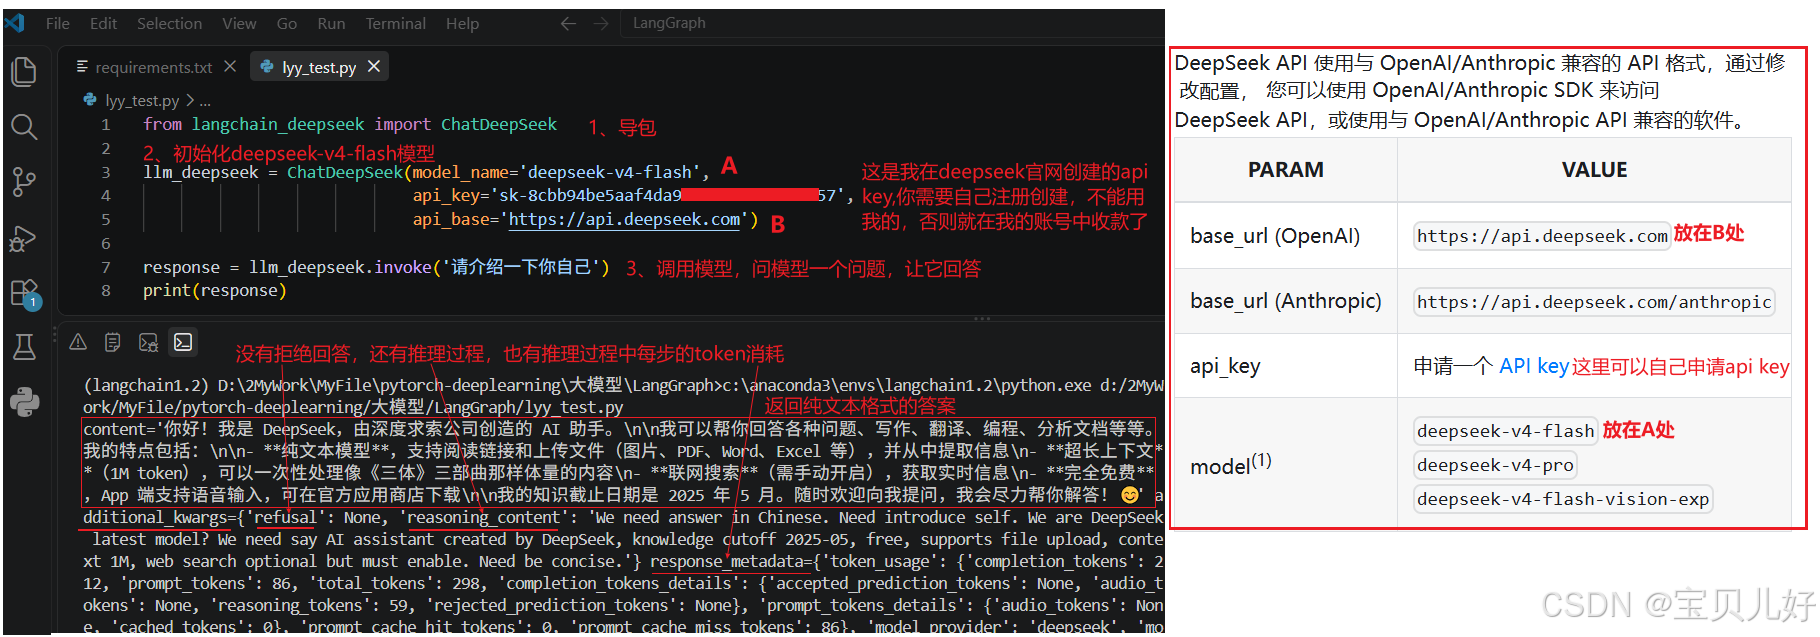
(2)但是上左图中,把api key都明文写在开发脚本中,这是大忌,别人用你的api key就是从你的deepseek账户中扣token费用的!所以我们都用下面方式开发: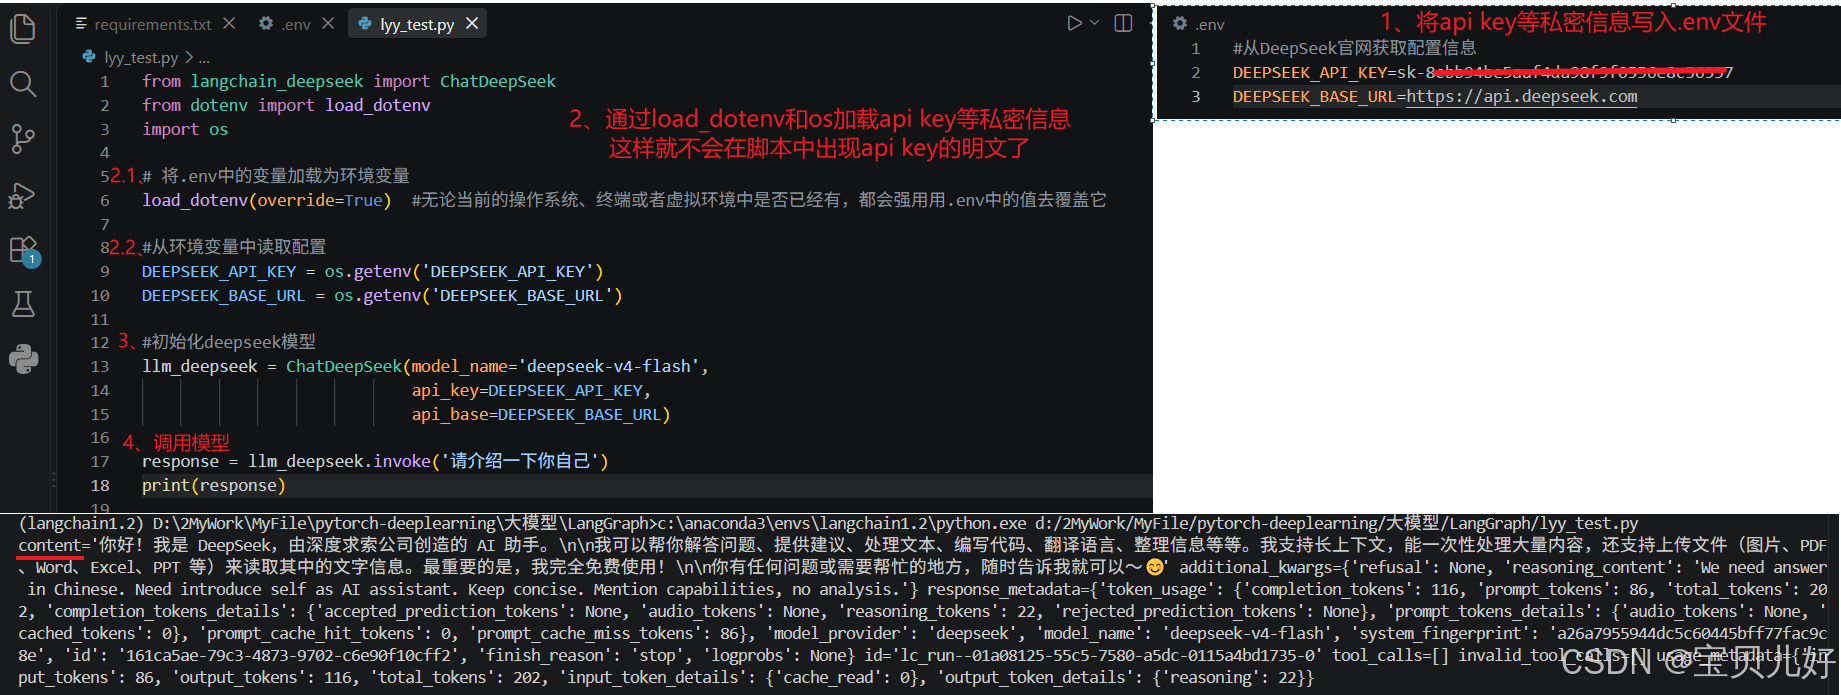
(3)其实ChatDeepSeek类的源码 中是已经内置 了参数api_key 的值,默认读环境变量DEEPSEEK_API_KEY;参数api_base 的值,默认读环境变量DEEPSEEK_API_BASE;参数model_name 没有默认值,必须手动传参。所以我们只要在.env配置文件中确保key值和url值的名称是DEEPSEEK_API_KEY和DEEPSEEK_API_BASE,然后用load_dotenv加载到环境变量中即可。代码如下所示: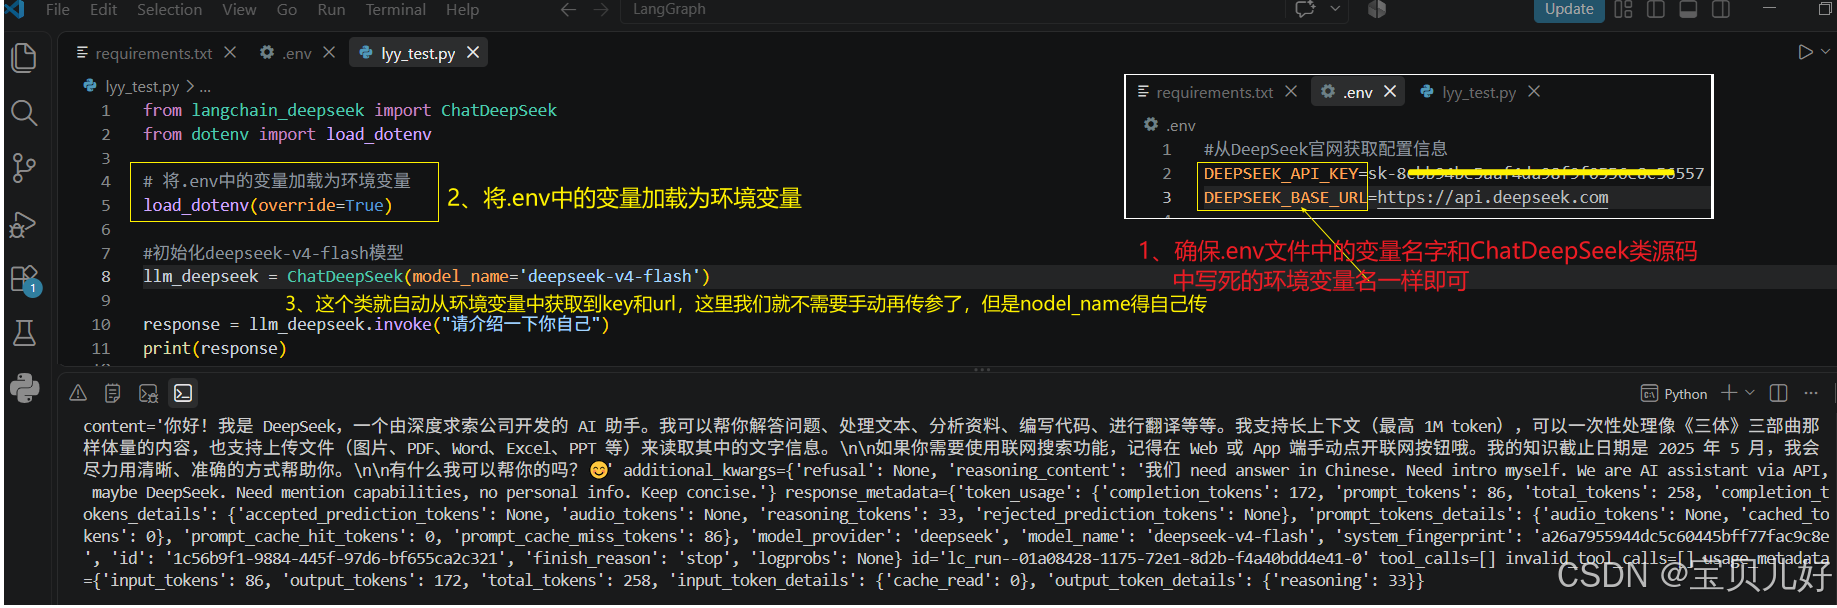
说明:此次我请求了3次,花了不到1分钱: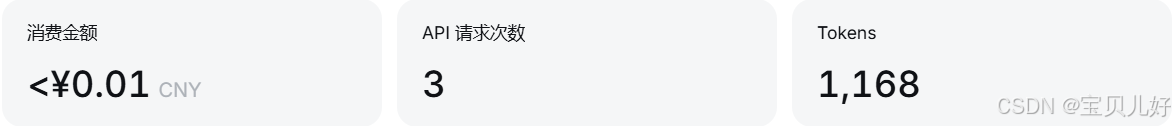
(四)示例2:调用质谱模型
质谱的模型都放在langchain-community中,所以我们需要从langchain_community.chat_models中调质谱的大模型。
(1)其他和deepseek一样,都是要先去官网 智谱丨BigModel 平台 注册登录申请api key,然后拿着api key去调用: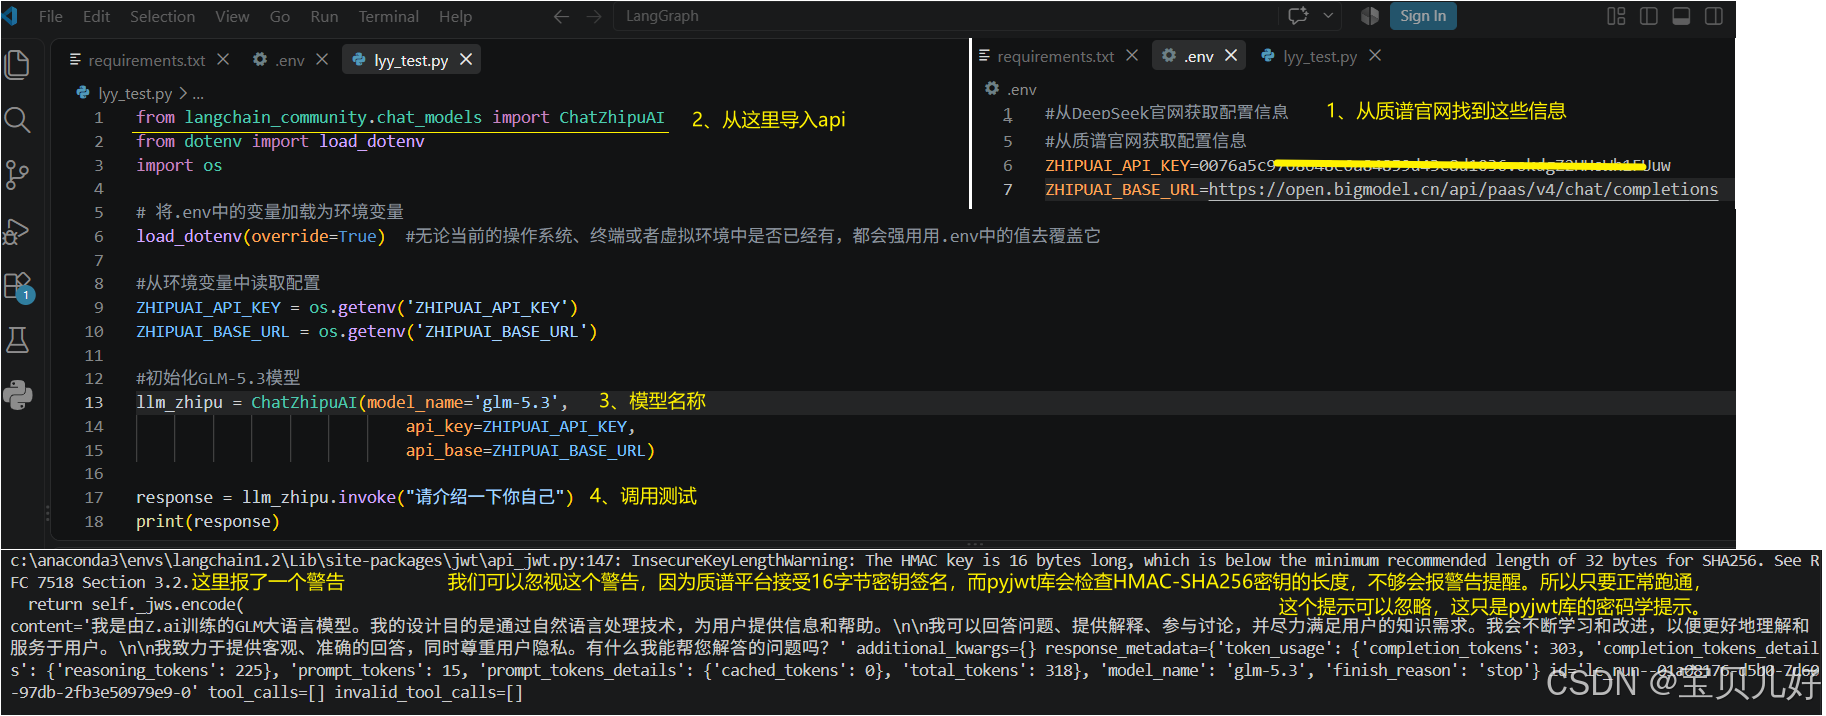
(2)从上面代码中我们可以看到,ChatZhipuAI类是从langchain_community.chat_models包中导出来的,同样ChatZhipuAI类的源码中也有参数api_key和api_base的默认读取逻辑,所以质谱的模型也可以通过更简单的方式初始化和调用: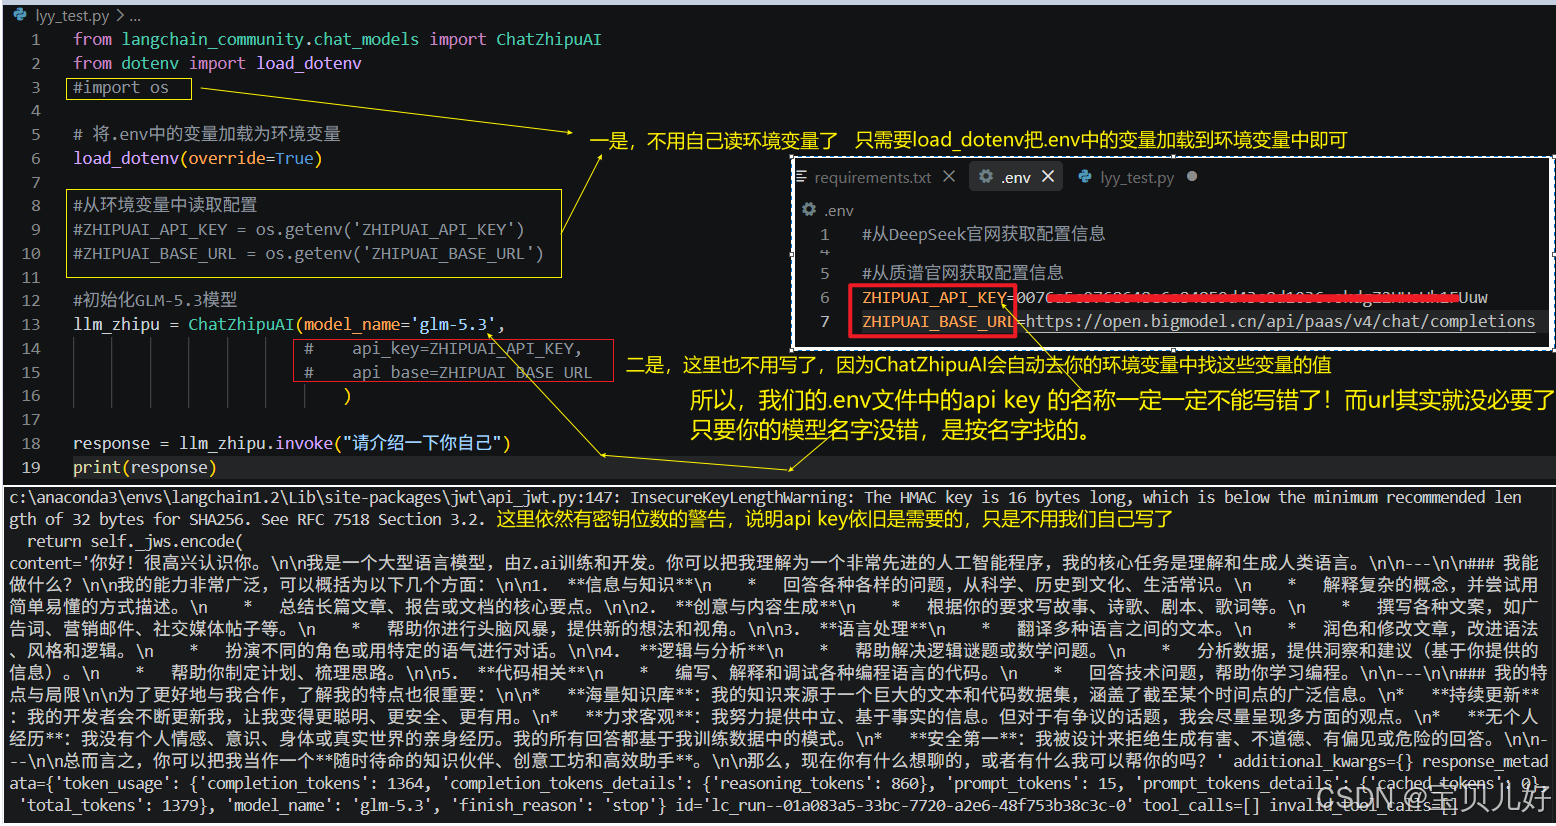
(五)示例3:千问模型
1、用langchain-community中的ChatTongyi
(1)langchain-community中的ChatTongyi类也是从从阿里云百炼平台 调用千问模型的,所以我们先得去阿里云百炼官网:大模型服务平台百炼控制台 ,注册登录获取api-key、base-url,并且写到.env文件中:
(2)因为langchain-community中的ChatTongyi类,内部没有写http请求代码,而是直接调用阿里云百炼平台 的dashscope这个SDK,来发http请求。也就干活的其实就是dashscope,所以我们还得安装dashscope包:pip install dashscope
(3)初始化模型并调用测试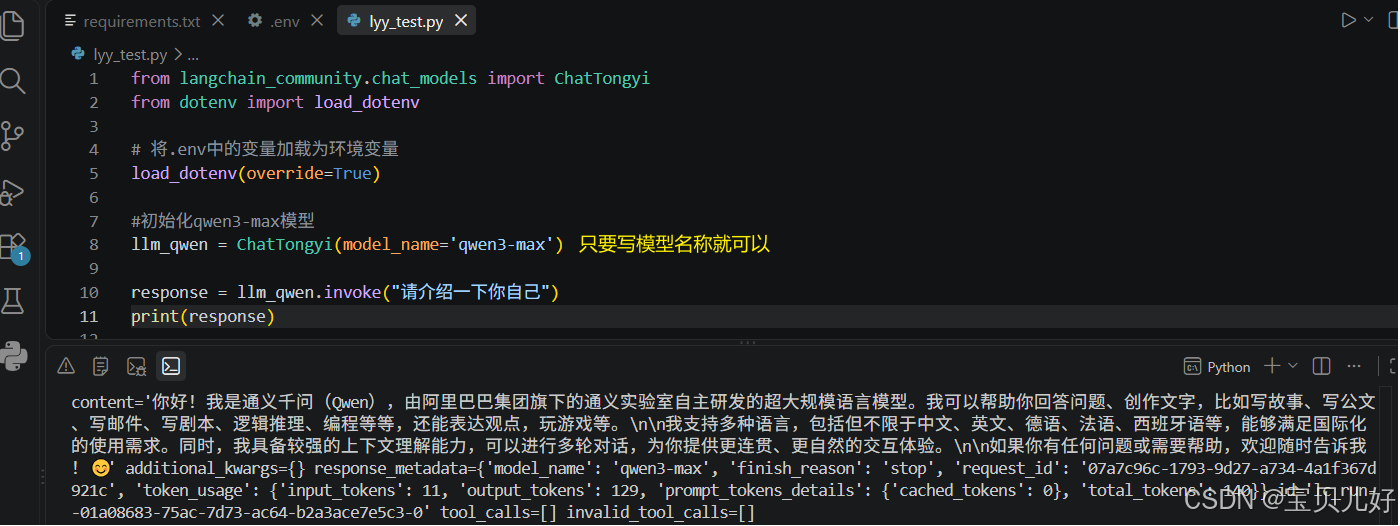
2、用OpenAI通用接口调千问模型
这种方式就不用安装dashscope,但是模型的输入和输出和方法1中的格式会有所不一样:
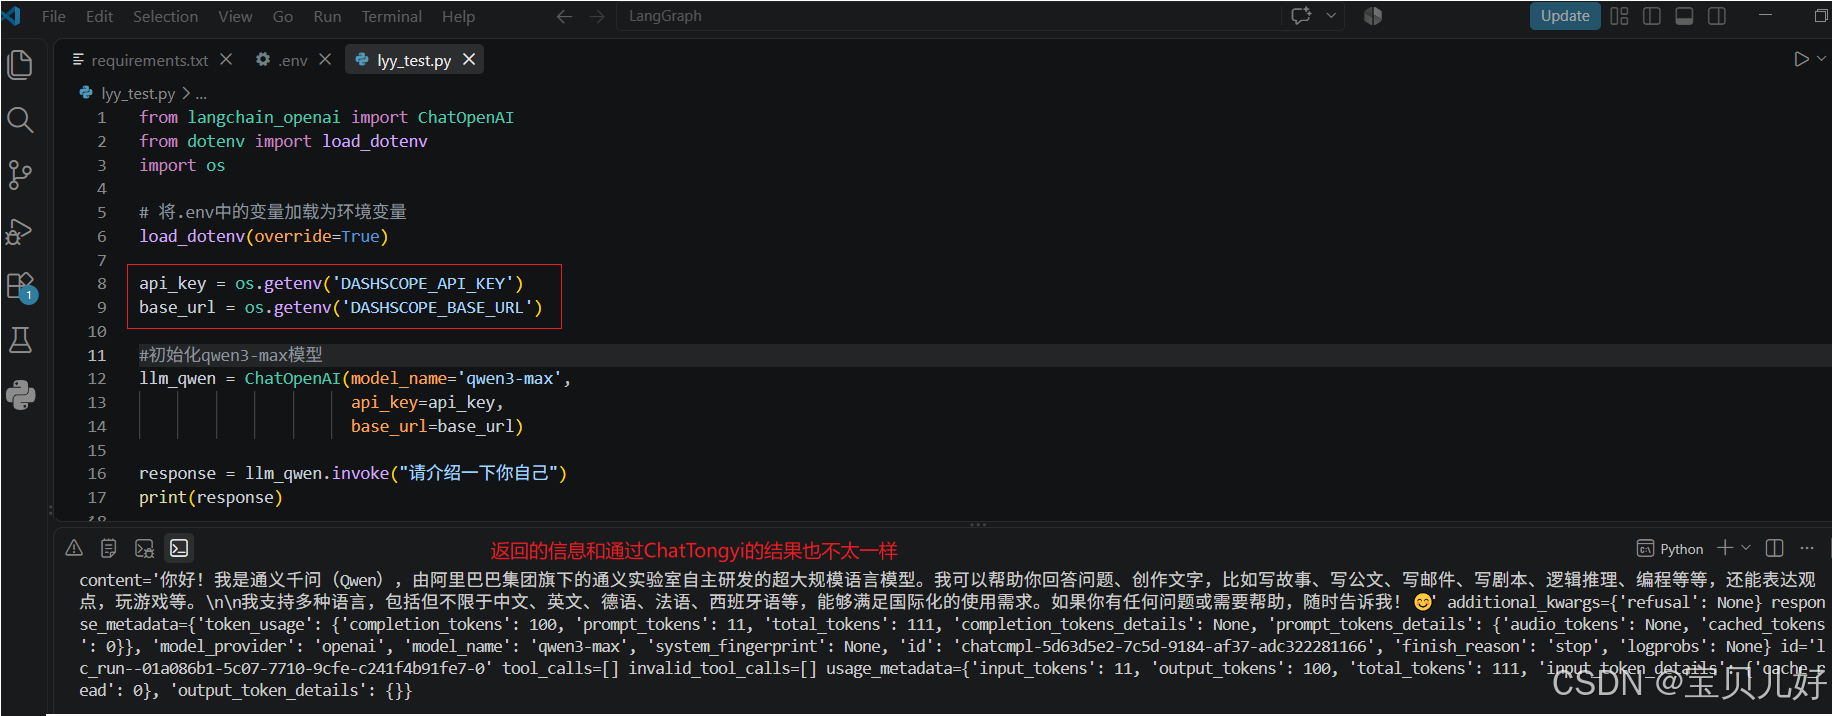
说明:ChatOpenAI也会自动读取环境变量,但它只读变量名叫OPENAI_API_KEY的变量值,所以你的.env文件中就没有这个变量名和变量值,所以ChatOpenAI就无法拿到OPENAI_API_KEY而报错。所以此时我们得用os.getenv()手动将DASHSCOPE_API_KEY和DASHSCOPE_BASE_URL传给OPENAI_API_KEY的参数,就可以正常跑通了。
三、从langchain框架中初始化平台大模型
除了模型提供商的包,langchai还有一些中转平台包,我们可以通过中转平台调用大模型,比如:
(1)ChatOpenRouter (独立包)
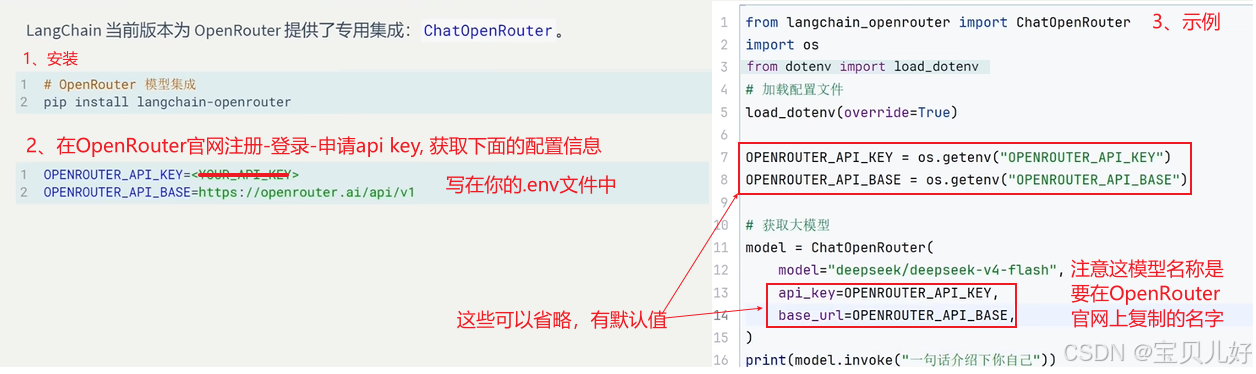
OpenRouter是目前知名度最高的大模型中转平台,可以调用国内外顶尖的闭源模型,但由于政策原因,国内无法直接调用,得曲线实现。
(2)CloseAI平台
提供OpenAI、Claude、Gemini等模型接口的代理访问。适合国内网络访问、支付和接口统一管理等问题,常用于大模型应用开发、教学演示和测试环境。在langchain中没有CloseAI的专用集成,可以通过langchain的ChatOpenAI 兼容接口调用。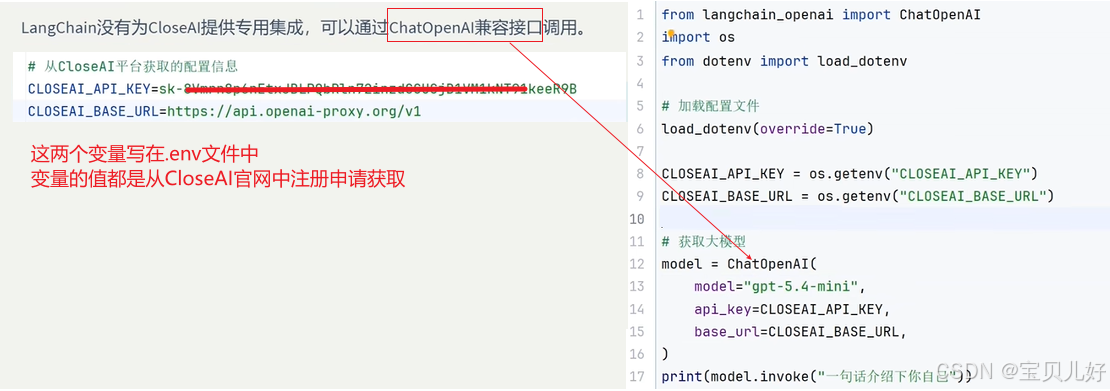
四、langchain统一接口:init_chat_model()
init_chat_model()是langchain1.x中推出的用于初始化聊天模型的统一接口 ,只要是langchain支持的模型都可以处理,它会根据模型名称自动选择对应模型类初始化示例。也就是说init_chat_model()是我们前面讲的ChatOpenAI、ChatAnthropic、ChatDeepSeek、ChatOllama、ChatHunyuan、ChatTongyi、ChatZhipuAI等模型类的又一层封装。使用init_chat_model()可以进一步简化模型切换操作,仅需修改模型字符串即可,语法更简单。
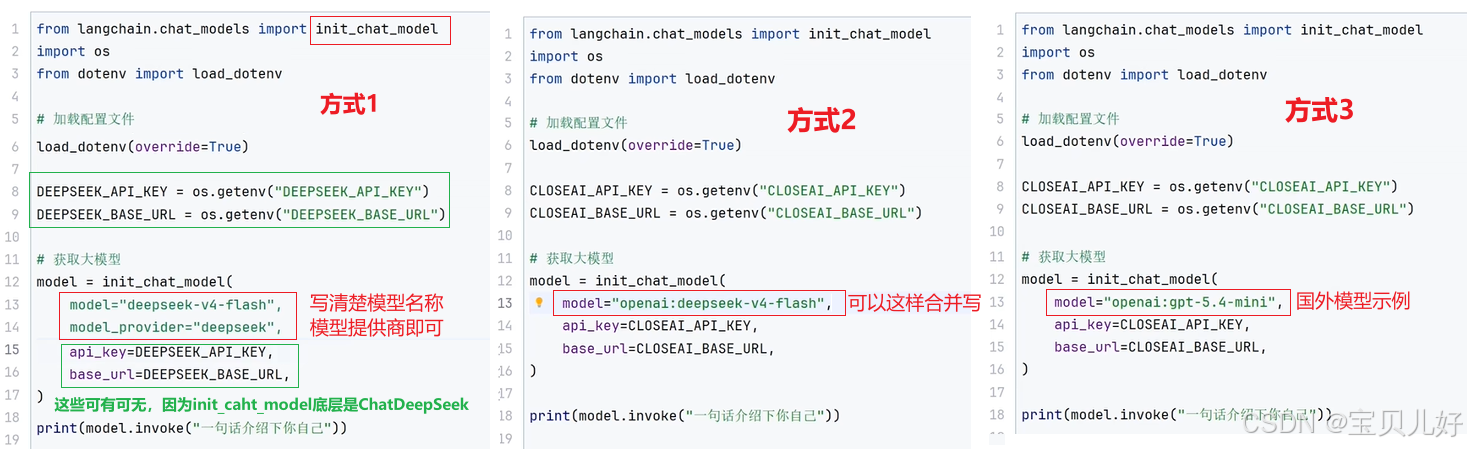
(1)model_provider表示模型的提供者,支持的providers有:anthropic, anthropic_bedrock, azure_ai, azure_openai, bedrockbedrock_converse, cohere, deepseek, fireworks, google_anthropic_vertex, google_genai, google_vertexaigrog, huggingface, ibm, mistralai, nvidia, ollama, openai, openrouter, perplexity, toghter, upstage, xai。
(2)如果model_provider='openai',会自动加载langchain-openai的依赖包,底层调用ChatOpenAI类。
(3)如果model_provider='deepseek',会自动加载langchain-deepseek的依赖包,底层调用Chatdeepseek类。
五、langchain调用本地部署的大模型
langchain也支持使用Ollama、vLLM等框架启动的本地大模型。 要本地下载和安装Ollama,然后从Ollama官网再下载大模型到本地。这样在本地通过Ollama就可以和"你下载到本地的大模型"进行对话了。就是通过Ollama将大模型部署到本地,然后通过langchain来调用。
因为我本地没有Ollama,所以这里就截图演示:
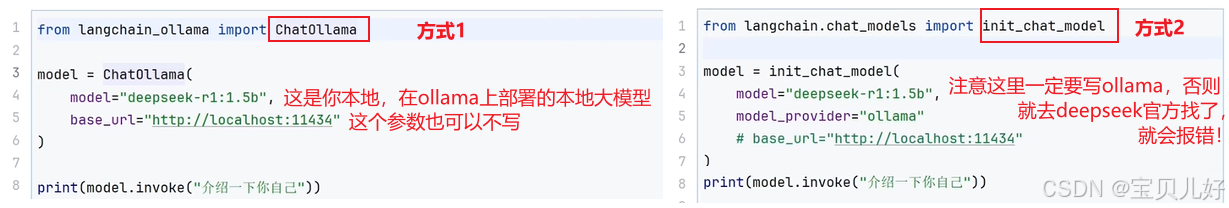
这样就不用api key,也不用花钱了。但模型幻觉会很大,效果很差!
六、模型初始化的其他知识点碎碎念
(一)获取模型的配置信息 + 用rich库打印模型输出的友好格式
langchain1.1及更高版本可以通过profile属性 查看模型的配置信息,也就是模型画像,但这取决于langchain在集成模型厂商的服务时是否声明了能力画像。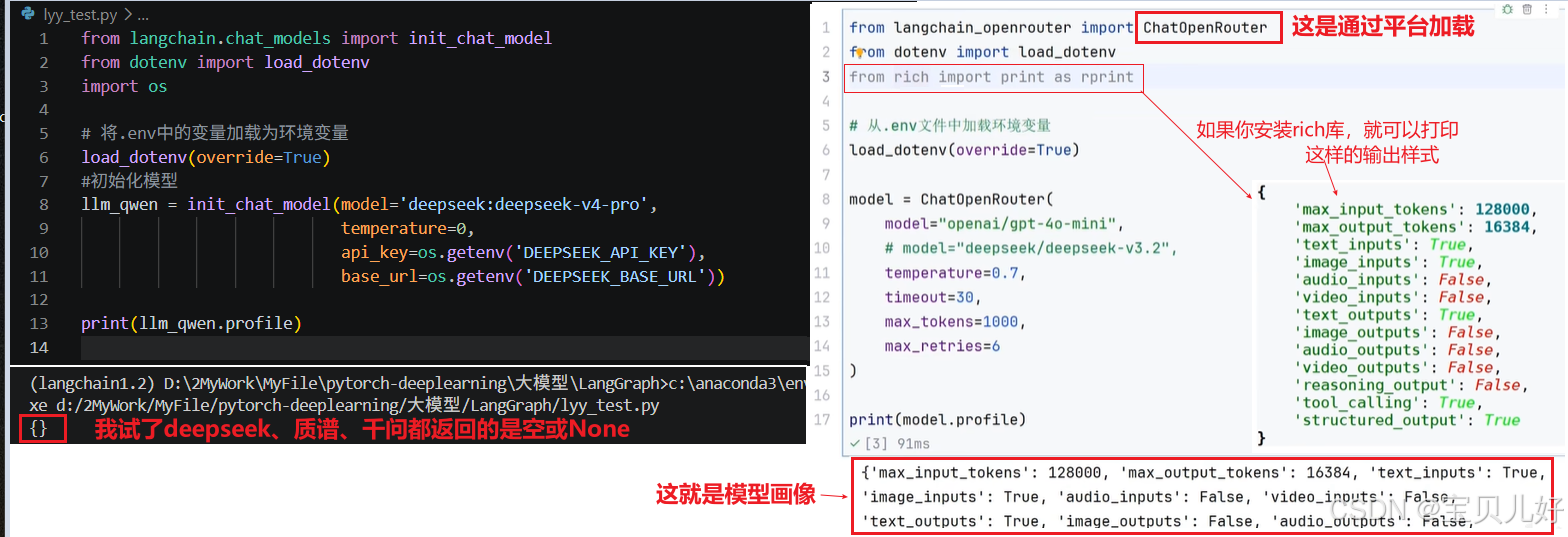
(二)模型初始化的参数说明
1、常用参数
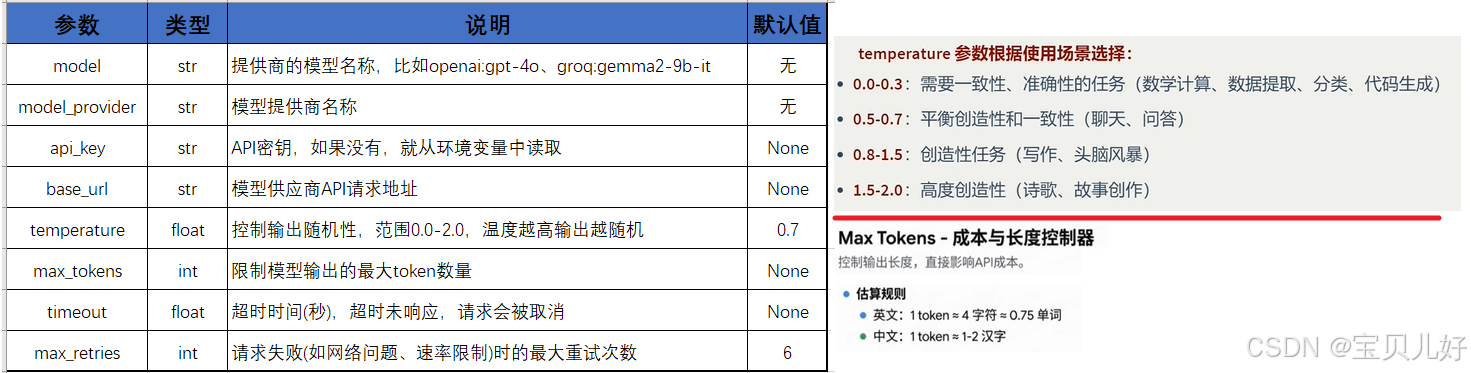
下面展示一个提取信息的示例: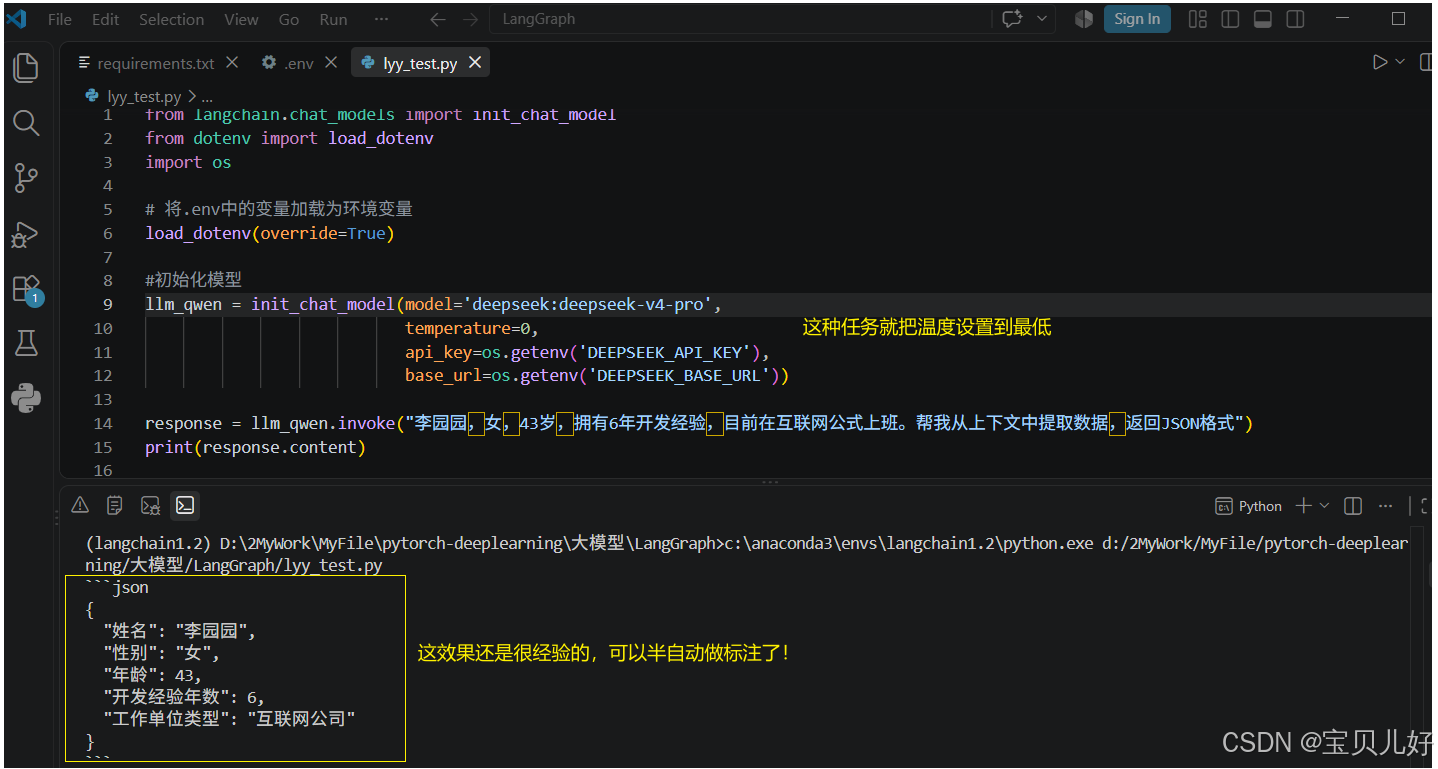
2、如何获取模型的完整参数 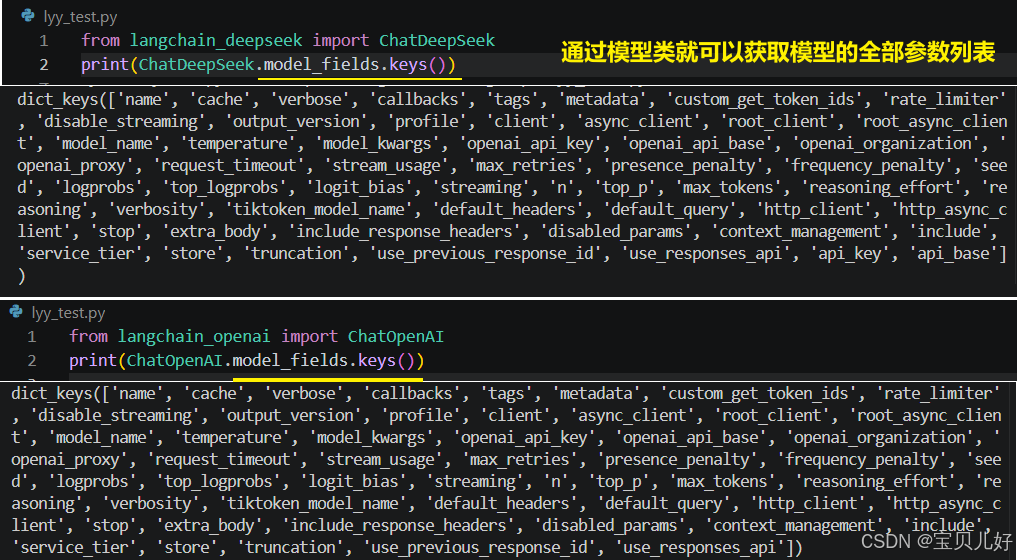
3、全部参数介绍
因为官方文档和源码注释没有给出完整的参数列表,下面的总结是以ChatDeepSeek为例总结的:
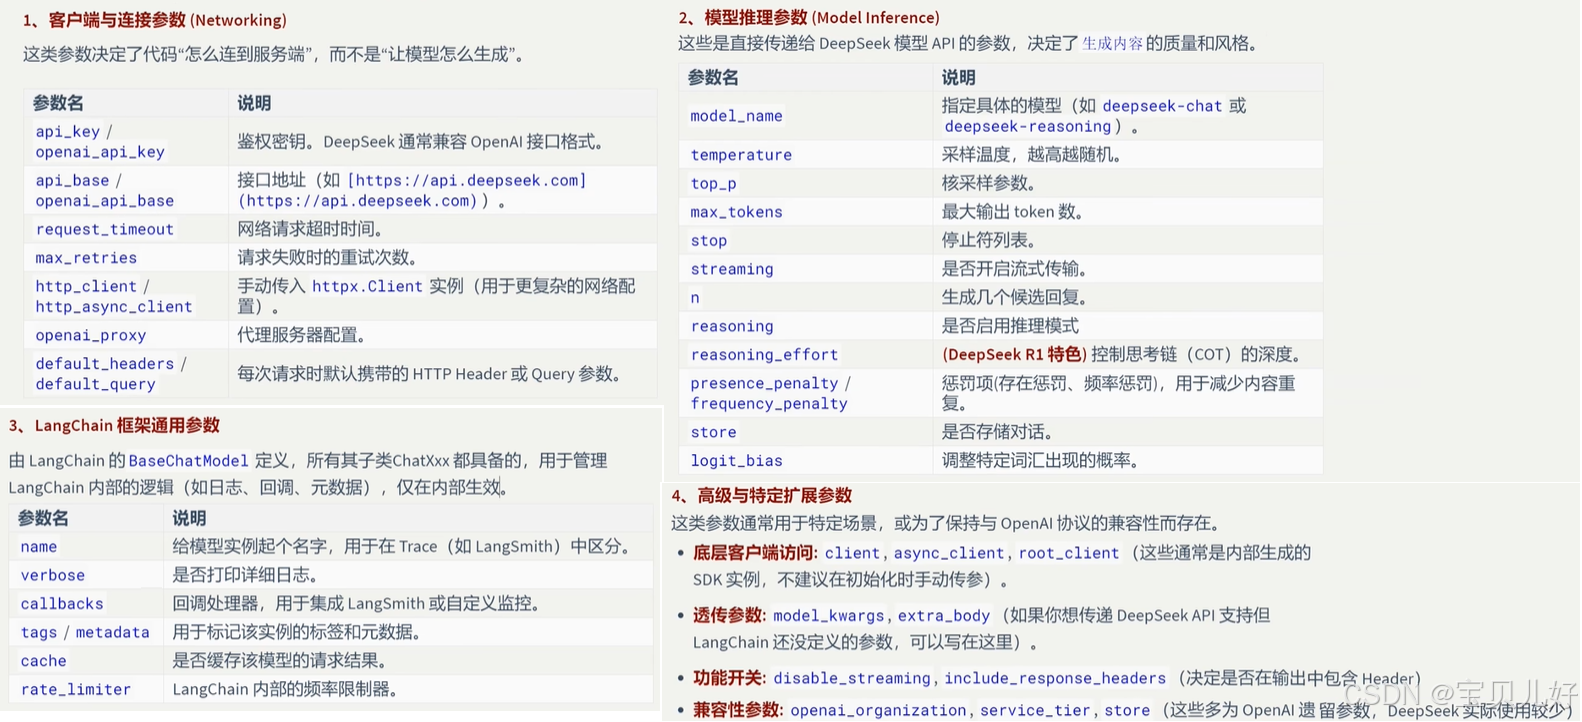
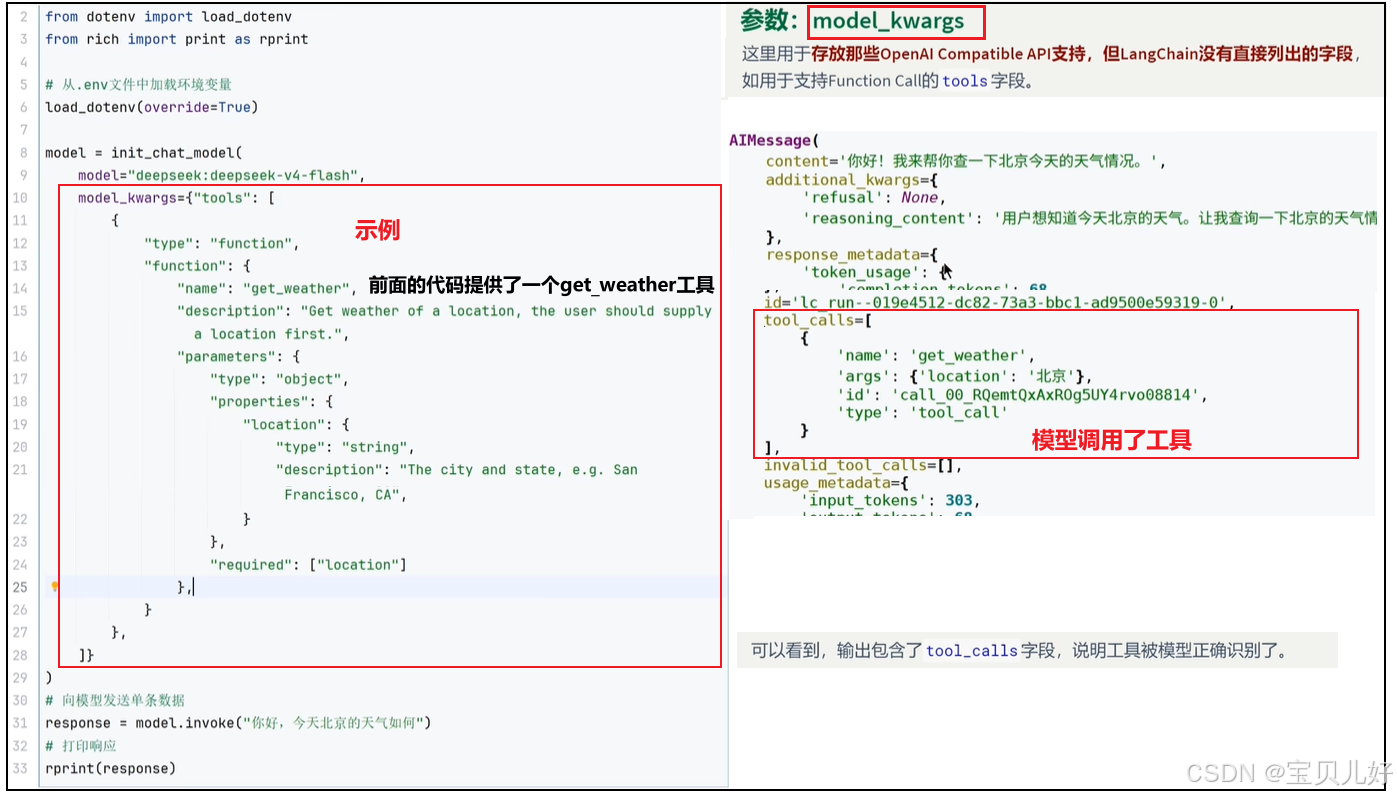
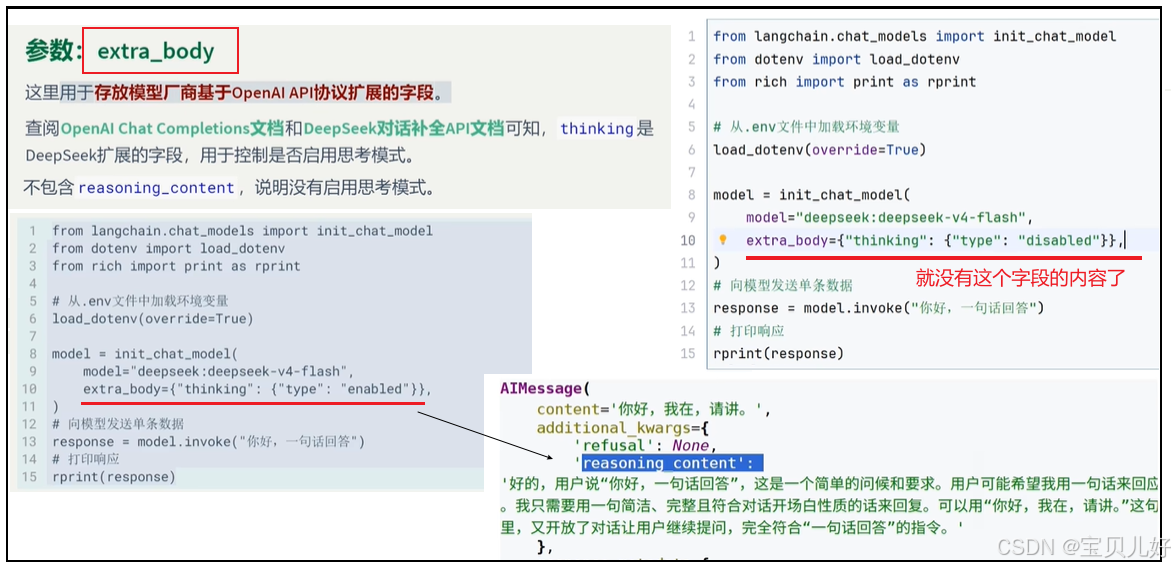
记住常见参数及用法即可,如果需要精细控制模型输出,可以查阅PenAI和特定模型供应商的官方文档,通过model_kwargs或extra_body传递。下面是两个示例:
七、模型调用方式
模型初始化(创建)完毕后,我们就可以调用模型了。langchain提供了6种调用方式:invoke()、stream()、batch()方法、以及它们的异步版本ainvoke()、astream()和abatch()。其中异步版本在八中展开详细讲解。
(一)invoke()方法
是langchain种最核心的方法,其工作模式是阻塞式 ,就是程序会等待模型完全生成整个响应后,再一次性将结果返回给用户。适用场景:快速测试,不需要保留对话历史的简单生成任务。
所有的调用就是,接受用户的输入 (问题、指令、对话历史等)--发送给LLM大模型--返回模型的响应(文本回复+元数据信息):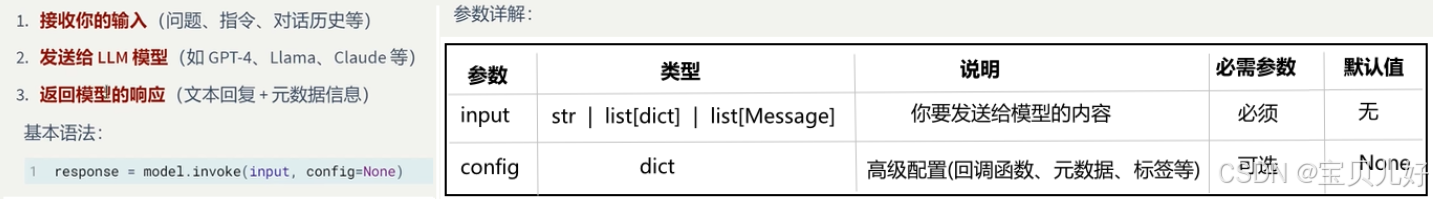
1、input参数
input参数支持文本输入、字典列表、消息对象列表。前面我们展示的例子都是文本输入。下面我展示一下字典列表和消息对象列表:
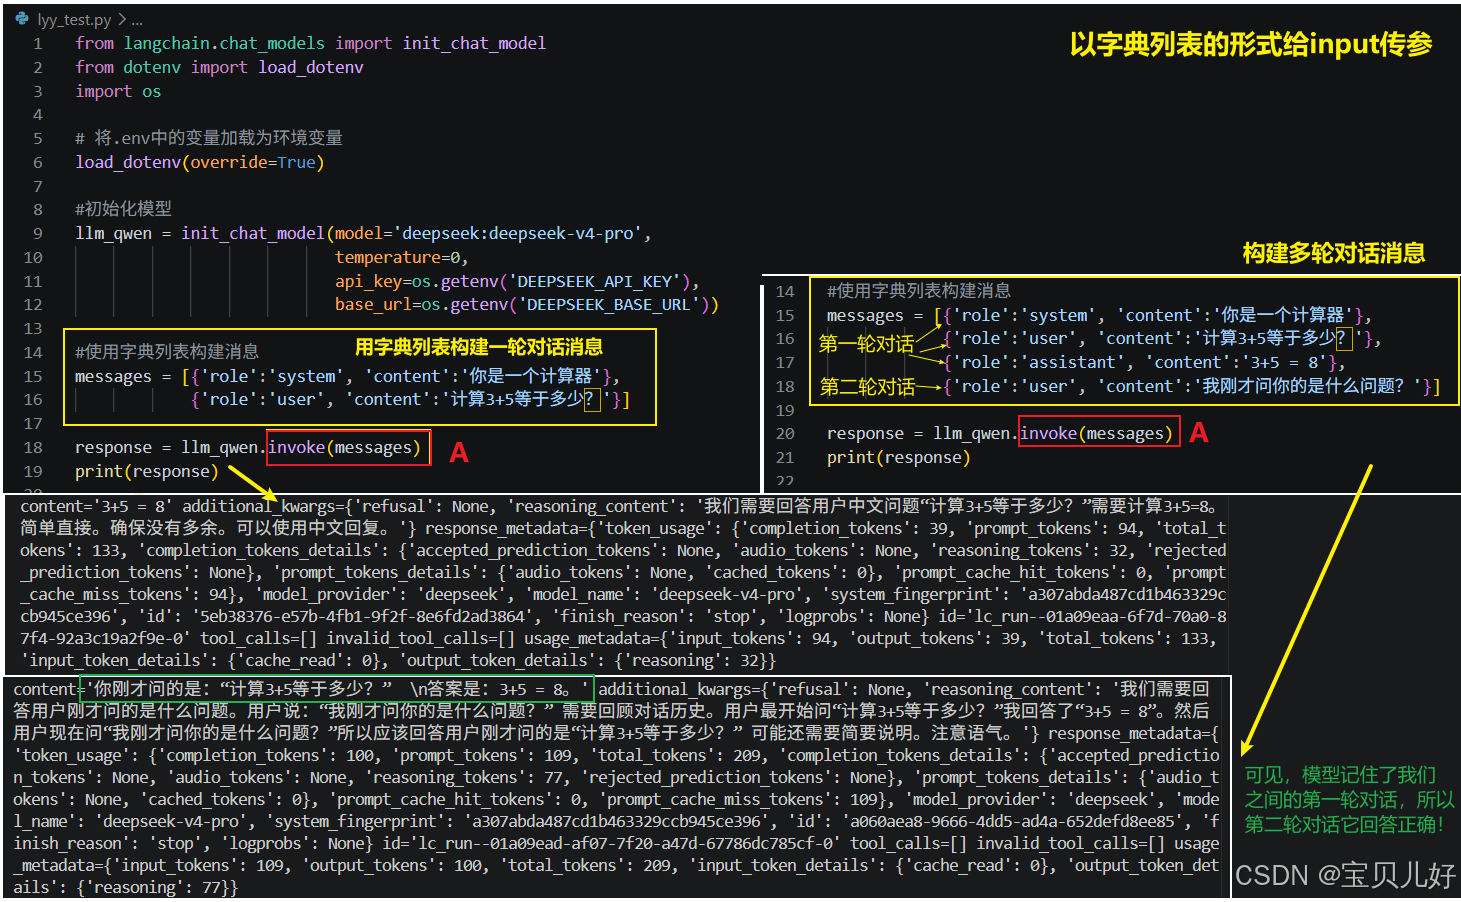
说明:
(1)上图A处也可以换成stream()方法。
(2)以字典列表的形式给input参数传参,可以组织多轮对话,一起喂入大模型,这样大模型的回答就会带有之前对话的记忆了!如果你是一轮一轮的和大模型对话,就像上左图代码,那大模型就不会记得你上一轮对话说的啥,模型会失忆!不会记录你的历史谈话!
(3)推荐在生成环境中使用这种方式,因为JSON兼容、易于序列化和网络传输。
除了字典列表构建输入LLM的消息外,langchain还封装了消息类:SystemMessage、HumanMessage、AIMessage,我们可以使用这些消息类给input传参: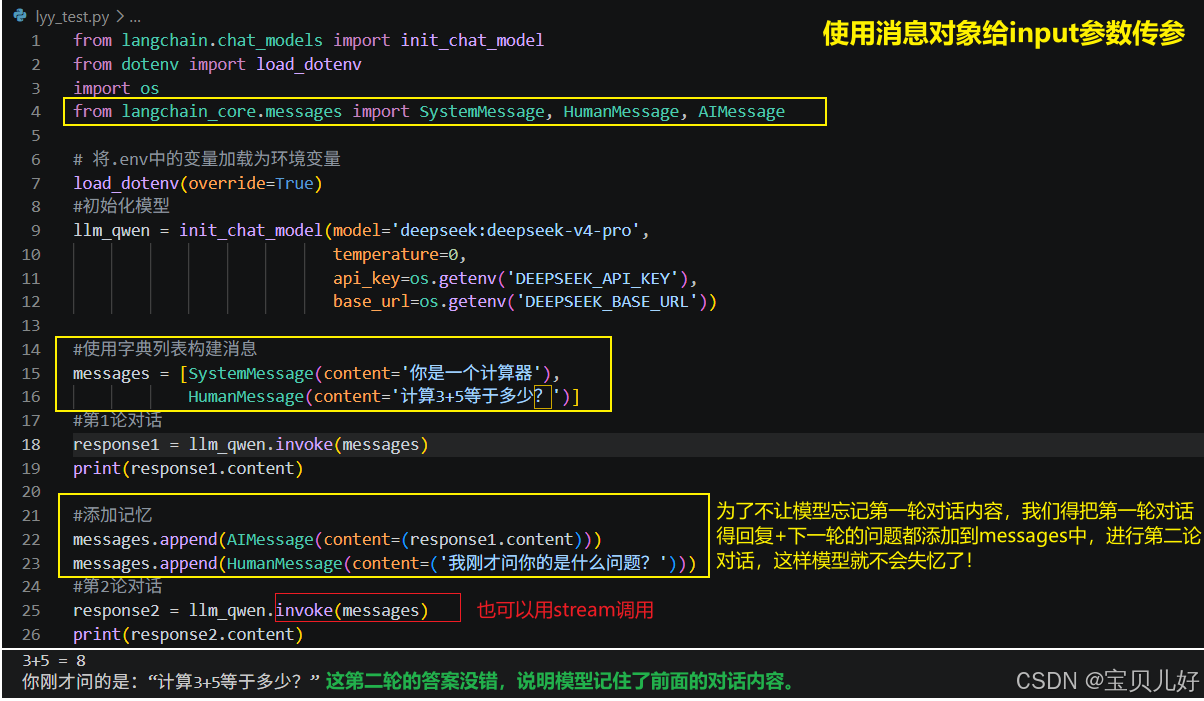
2、config参数
我们在初始化模型时介绍了很多参数,其实如果你初始化时没有 固定相关参数,那你在调用模型时,可以用config参数来固定这些参数,也是可以的,这样就为应用带来极大的灵活性和可维护性。
关于config中可配参数的解释参考:config | langchain_core | LangChain Reference
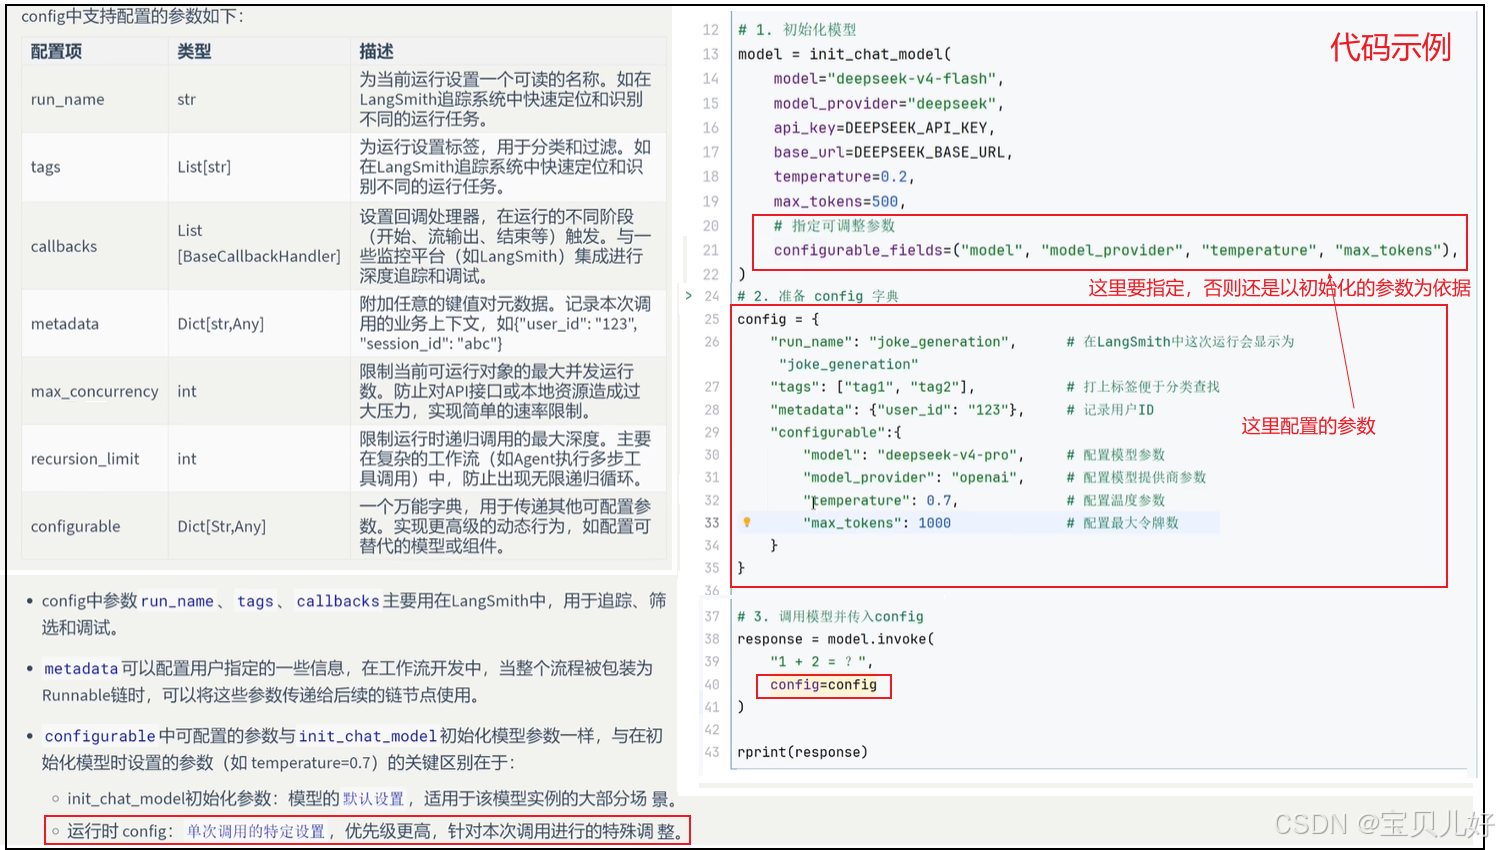
意思就是如果config中配置了相关参数,就以config为主,但是初始化中要指定一下;如果config没有配置,就以模型初始化中的参数为主。
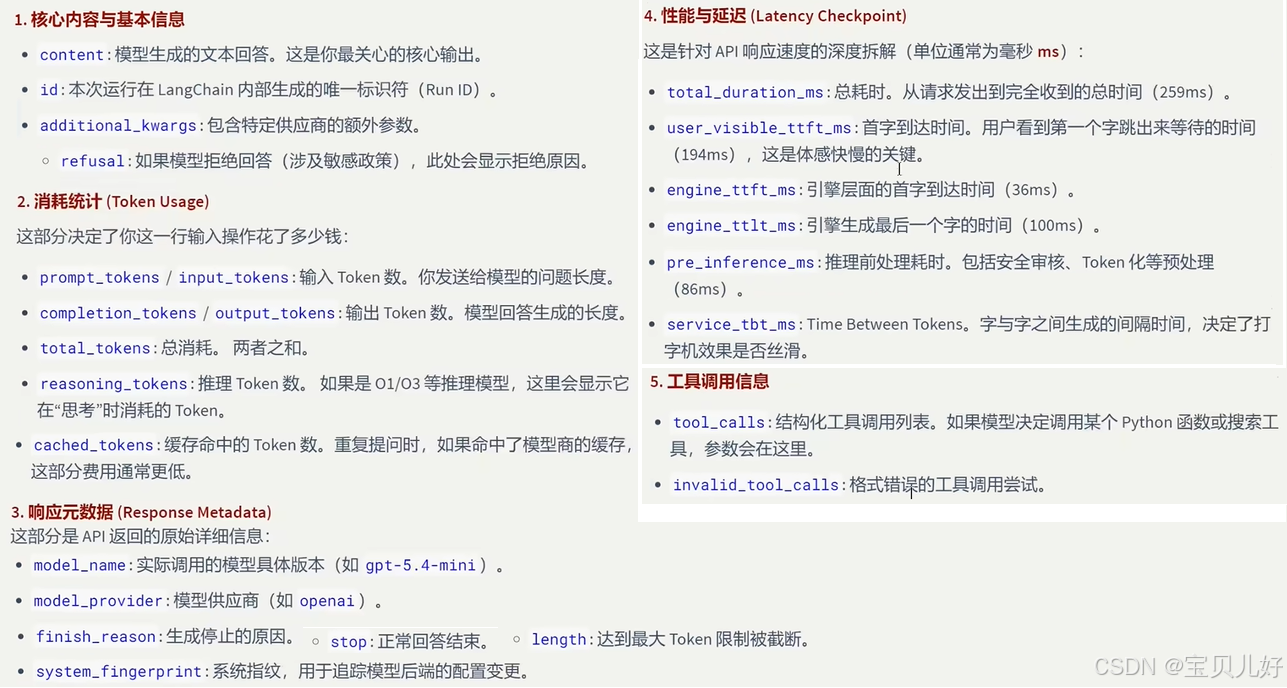
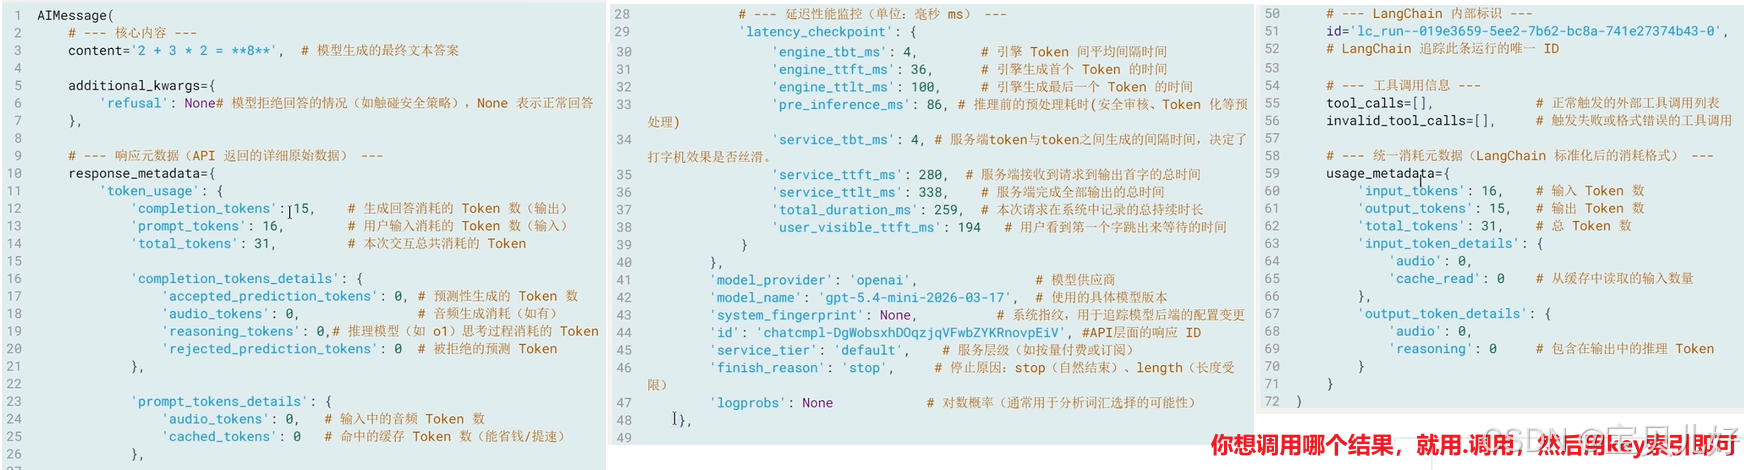
3、模型返回值介绍
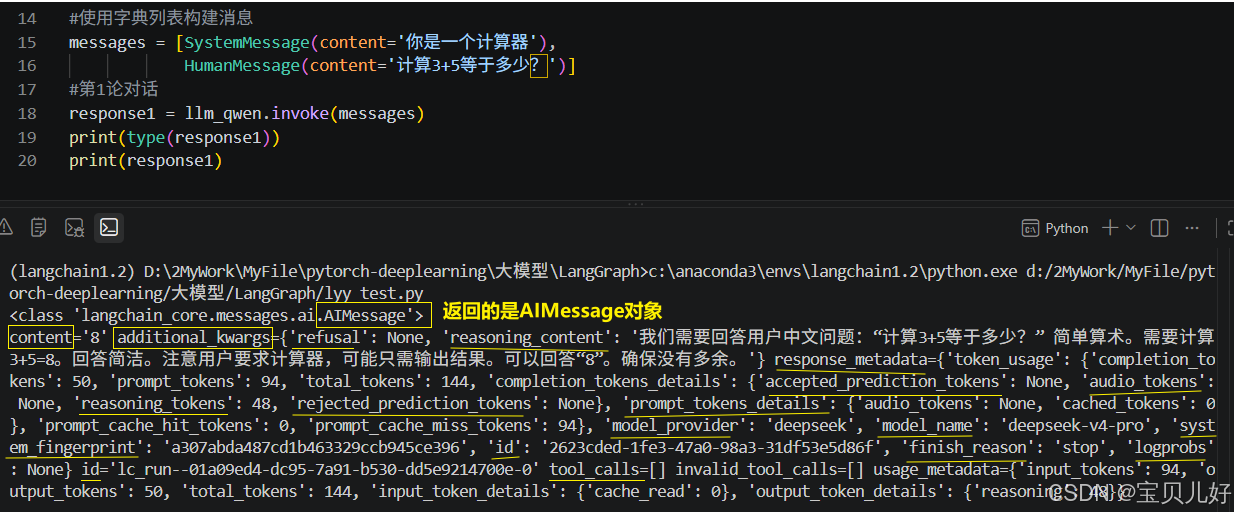
因为每家的每种大模型的具体返回都不一样,你调用的接口不一样,返回也会不一样,所以大家作一个参考:
(二)stream()方法
流式输出,实时返回每个token,就是实时返回响应片段,而不需要等待完整输出。
stream方法返回一个迭代器iterator,可以通过循环来实时处理每一个新生成的chunk内容块。适用于聊天机器人、长文本生成、需要提升用户体验的交互应用。比如豆包、deepseek都用的是流式输出,一个个token往出蹦。可实时展示模型思考过程。
如果用户输入的信息较多,等待的时间较长,用流式输出,用户就可以看到一点点的输出层,就可以判断是否是网络不稳定还是服务器繁忙导致等待较长时间。流式输出依赖于模型提供商是否支持。早期的模型是都没有支持流式输出模式,也没有支持工具调用的,但现在的大模型基本都支持了。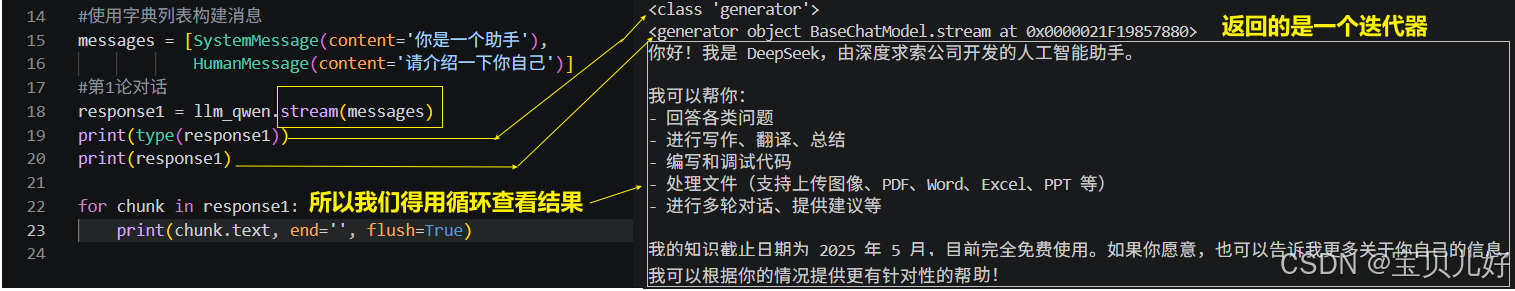
(三)batch()方法
批量调用 ,batch()方法允许一次性请求多个输入的高并发场景,模型会在后台并行处理,然后返回所有结果的列表。
批量调用能大幅减少网络往返开销和等待时间,显著提升性能、降低成本。适用文档摘要、批量问答、数据预处理、多样本分类等场景。
批量调用分:一次性接受所有响应和按完成顺序接受响应: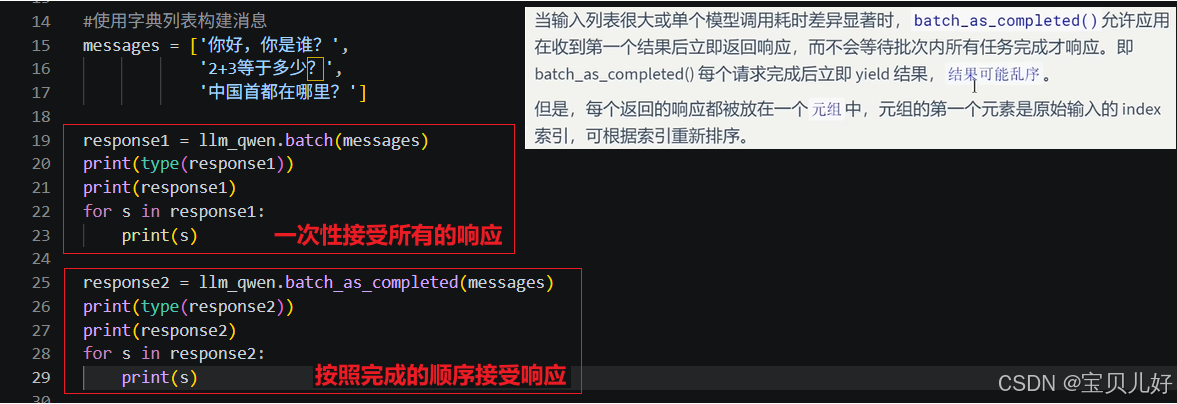
八、异步调用
(一)python异步编程相关知识点
1、I/O密集性任务、同步编程、异步编程
我们知道cpu的速度>内存>磁盘>网路,当程序需要磁盘读写或者网络收发时,cpu资源此时是空闲的,这就造成资源浪费。异步编码就是把这个时间点的cpu资源也进行充分利用的编程。
在同步编程中,当我们的程序中出现大量的文件操作、网络通讯、数据库读写等操作时,就会出现:
- 等待网络请求返回数据
- 等待磁盘读写完成
- 等待数据库查询结果
在这些等待的时间片中,程序呈阻塞状态,CPU处于空闲状态 ,cpu无法见空插针的去执行其他任务,造成资源浪费、效率低下。
异步编程:cpu在等待I/O的空闲时间碎片中,可以去处理其他任务,提高cpu利用率。
所以,当你的程序中有很多I/O操作时,或者要求高并发、高性能的应用时,通过异步编程可以极大提升程序的并发能力和资源利用率。下面用一个小例子对比一下同步编程和异步编程的区别: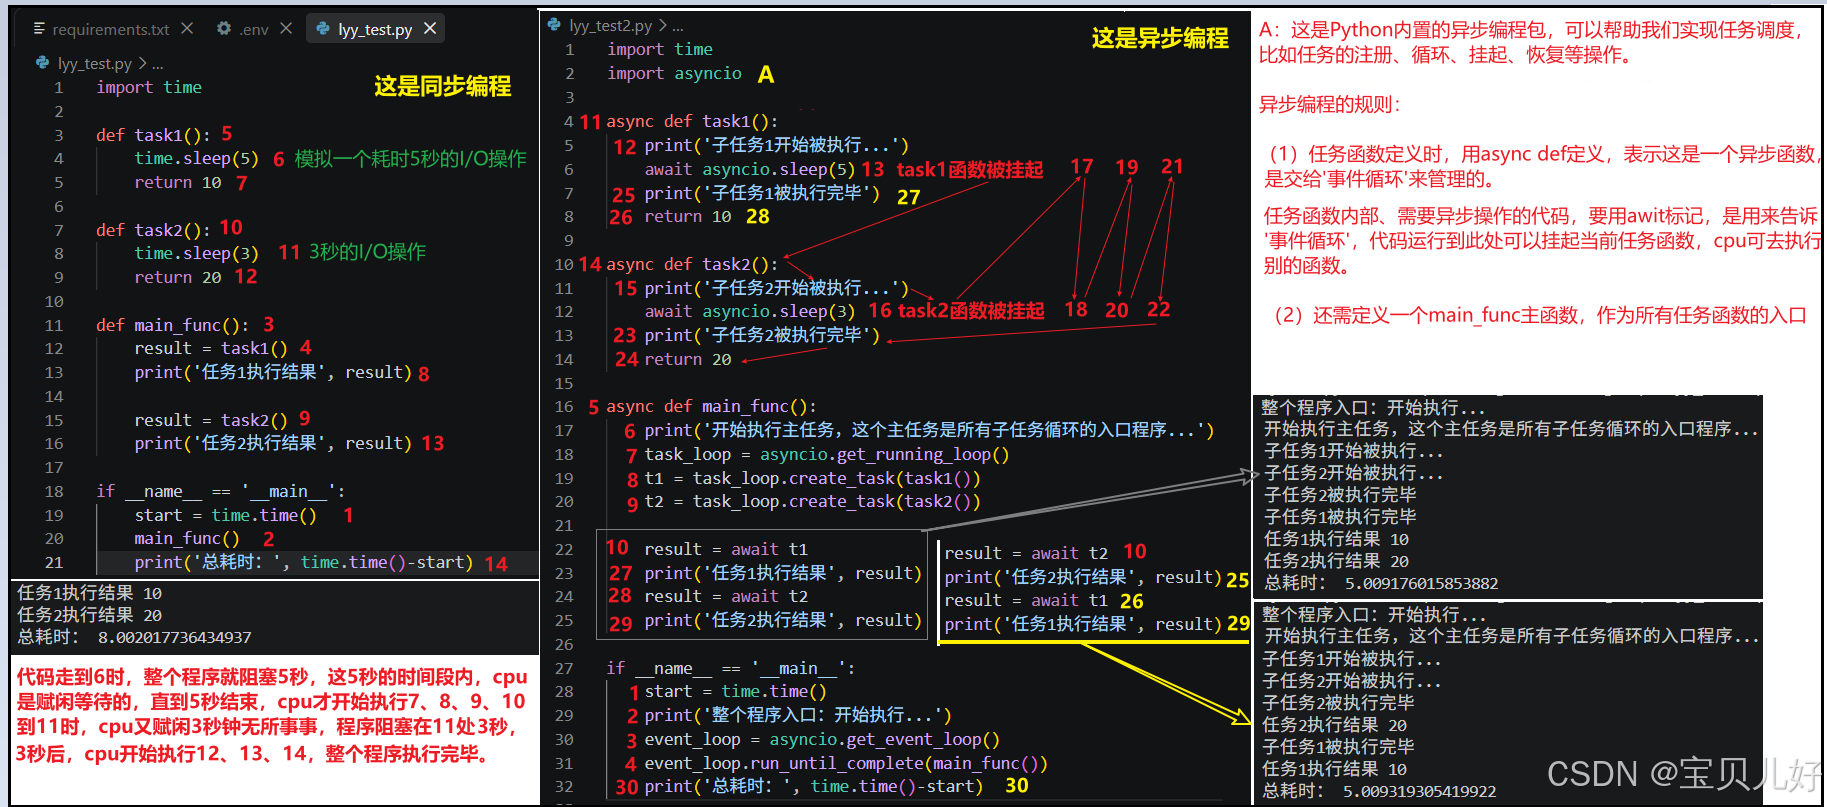
2、异步编程的实现原理
从上面的小示例中可见,相同任务,同步编程得执行8秒,异步编程执行5秒。为什么?因为上图中13跳到14,然后cpu一直在13和16之间横跳,一旦发现13或者16谁执行完毕了,就执行接下来的代码,所以在5秒的时间内就把task1和task2全部执行完毕了。所以整个程序运行时间节省了很多。
那asyncio模块是如何实现这种操作的呢?asyncio是通过事件循环(Event Loop) 来实现的。工作流程是:
(1)首先,创建一个事件循环。就是上图中的代码3和代码4 。
(2)然后,将需要循环的任务函数 注册到事件循环中。就是上图中的代码7、8、9 。
(3)最后,启动事件循环,开始调度和执行各个任务。
通过这套机制,我们可以让程序遇到I/O等待时,不会空耗资源,提升程序整体的执行效率。
3、异步编程规则
为了让事件循环 正确的识别和调度任务,我们编写异步代码时要遵循以下规则:
(1)需要导入asyncio包。
(2.1)任务函数 是这个函数里面有需要I/O的代码行 。或者说任务函数是我想实现循环 的函数。就是上例中的task1和task2函数。
(2.2)定义任务函数时,要用async def定义,async是关键字,表示这是一个异步函数,是要交给事件循环 来调度的。
(2.3)任务函数内部,需要异步操作的代码,要用await标记,await是和async呼应的关键字,是用来告诉事件循环,代码运行到此处可以挂起当前函数,cpu可以去干别的事情,这个函数先暂停执行。
(2.4)任务函数也叫协程对象 ,还叫异步函数。
(3.1)事件循环 是在整个程序入口处 写的。比如上例中的代码3和代码4,就生成一个事件循环。如果没有代码4就会报:RuntimeError: no running event loop
(3.2)事件循环首先会启动一个主任务,比如上例中的代码4中的main_func任务。main_func是主任务,功能是注册多个子任务。也就是同.create_task把协程对象注册到循环中。
(4.1)所以,要想任务函数进行循环,还得编写一个主任务 函数(指的就是main_func函数,当然你可以取别的名字),作为所有任务函数的入口。就是在主任务函数中注册 所有的任务函数,就是上图中的代码7、8、9。
(4.2)主任务函数也得用async def定义。
(4.3)将主任务函数作为参数传递给事件循环(代码4)。
(5)理论上讲,在一个线程里面是可以创建多个事件循环的,但是一般情况下,一个线程里面我们都是创建一个事件循环。
要事件循环,是因为我们要往事件循环里面注册任务。怎么注册?.create_task,返回一个任务,这个任务是task类型的,就是事件循环中管理的任务的类型,写调用的形式,而且必须是一个协程对象。所以就是把一个携程对象包装成一个task类型的对象,然后添加到(注册)事件循环中。携程对象就是我们写的异步函数。
基于这个规则,上面的示例还可以简化成:
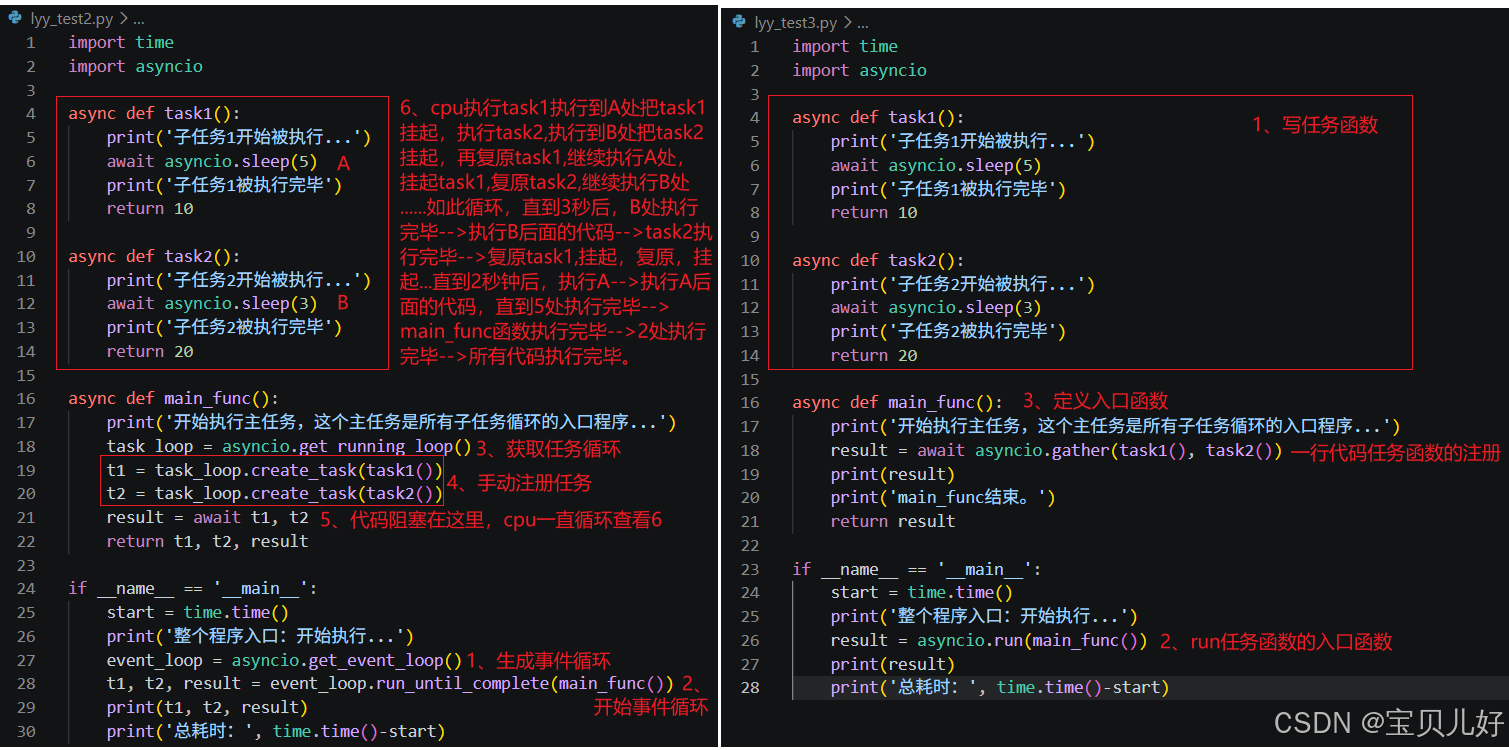
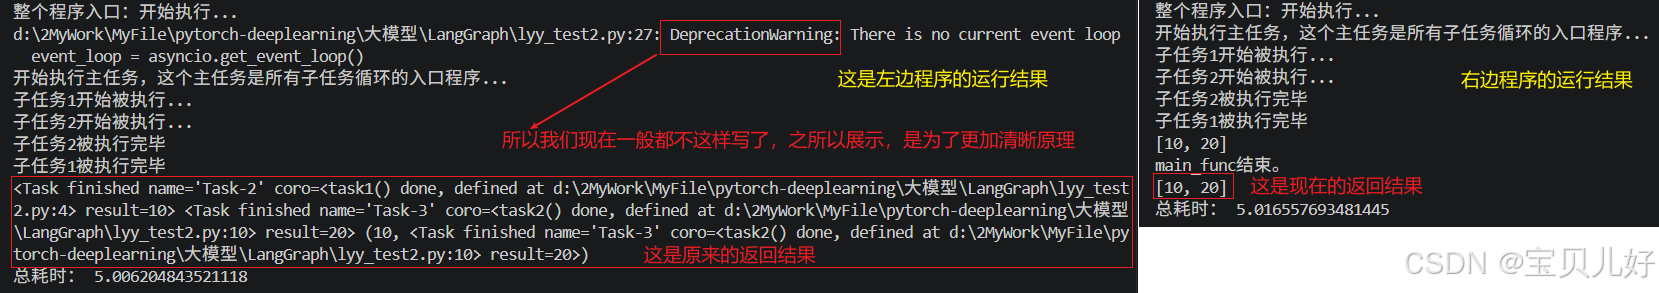
上左图中的t1,t2对象的类型是task对象 类型。
上左图的写法现在已经deprecated了,现在我们一般都是用上右图的写法,先启动一个任务的入口,在任务的入口中使用gather函数,将多个子任务放入循环。其实也显而易见,上右图是对上左图的进一层包装,让异步逻辑开发的时候更简洁一些,其实原理还是上左图。
4、async关键字的细节
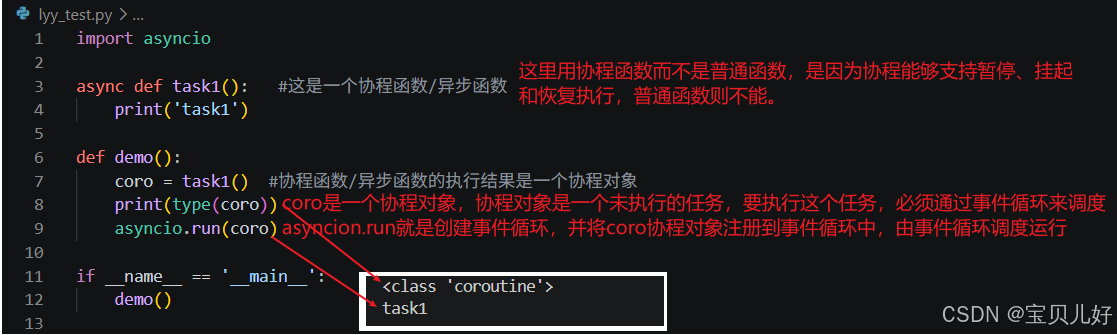
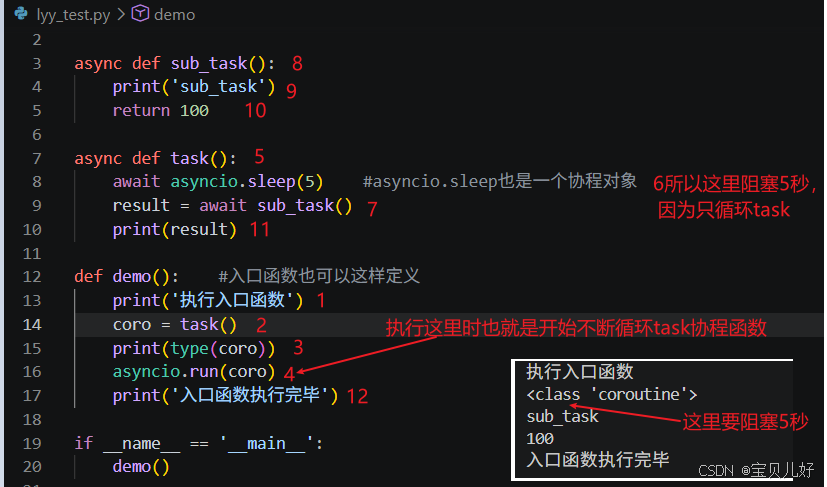
在python中,async关键字主要用于定义异步函数/协程函数,这种函数可以执行非阻塞操作,通过await实现,并允许在等待某些任务完成时,程序继续执行其他任务。使用async定义异步函数/协程函数如下示例:
5、await关键字的细节
在Python中,await关键字主要用在async def定义的协程函数中,用于暂停协程的执行,直到异步操作完成,然后继续执行后续代码。
await关键字后面只能跟coroutine、future、task对象,如果跟的是其他对象,就会报错:TypeError:xxx can't be used in 'await' expression。
Awaitable(可等待)是各大类别,里面有三兄弟,就是coroutine、future、task(继承自future,是future的子类)。
由于事件循环本身就是在单线程中执行的,如果await后面是一个等待对象时,事件循环会单独开启一个新线程,新线程执行等待的任务。此时事件循环本身这个任务就不阻塞了,就可以正常循环了。所以await+等待对象的类型,是事件循环判断是继续执行当前任务,还是循环到下一个任务的依据: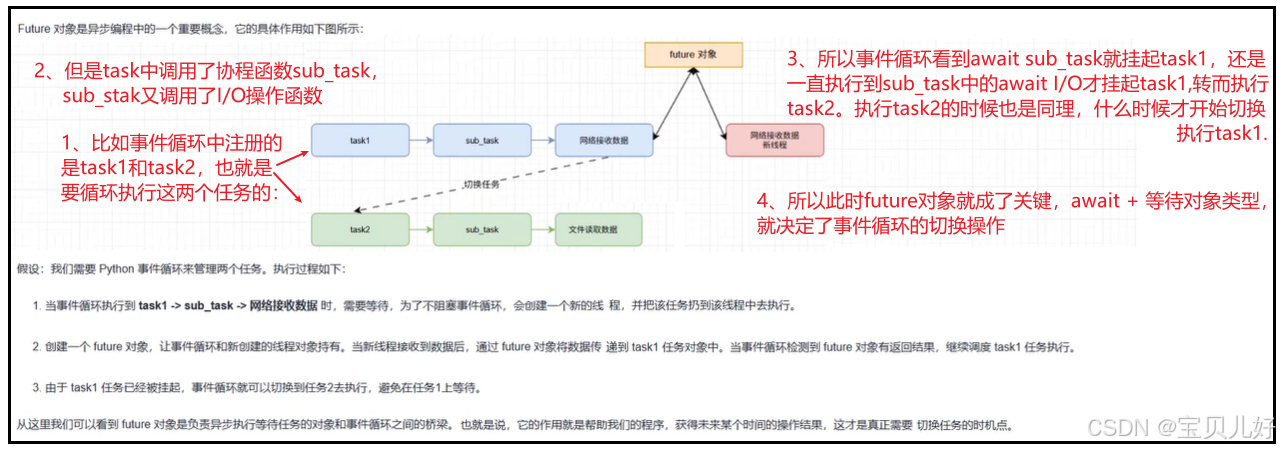
(1)当await后面跟的是协程对象时,事件循环暂停当前协程执行,继续执行await后面的协程对象中的代码,此时是不会从task01切换到task02:
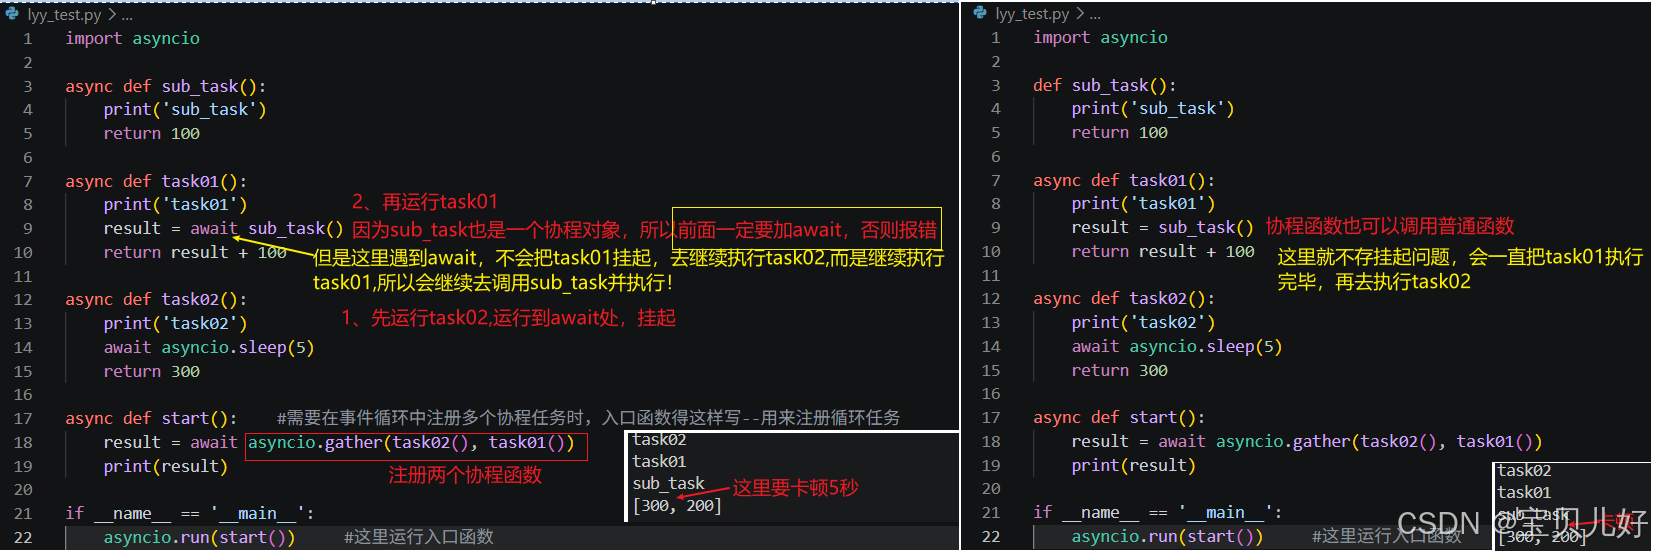
说明:asyncio.sleep(5)返回的也是协程对象 ,但是asyncio.sleep源码中写死了它是一个可等待对象,所以执行task02,执行到await asyncio.sleep(5)时会去循环task01。但是在执行task01时,执行到await sub_task()时,不会切换去执行task02,而是继续执行sub_task,直到执行完毕task01,才切换去执行task02。
(2)当await后面跟的是future对象或task对象时,事件循环就切换当前协程执行,循环到下一个协程执行: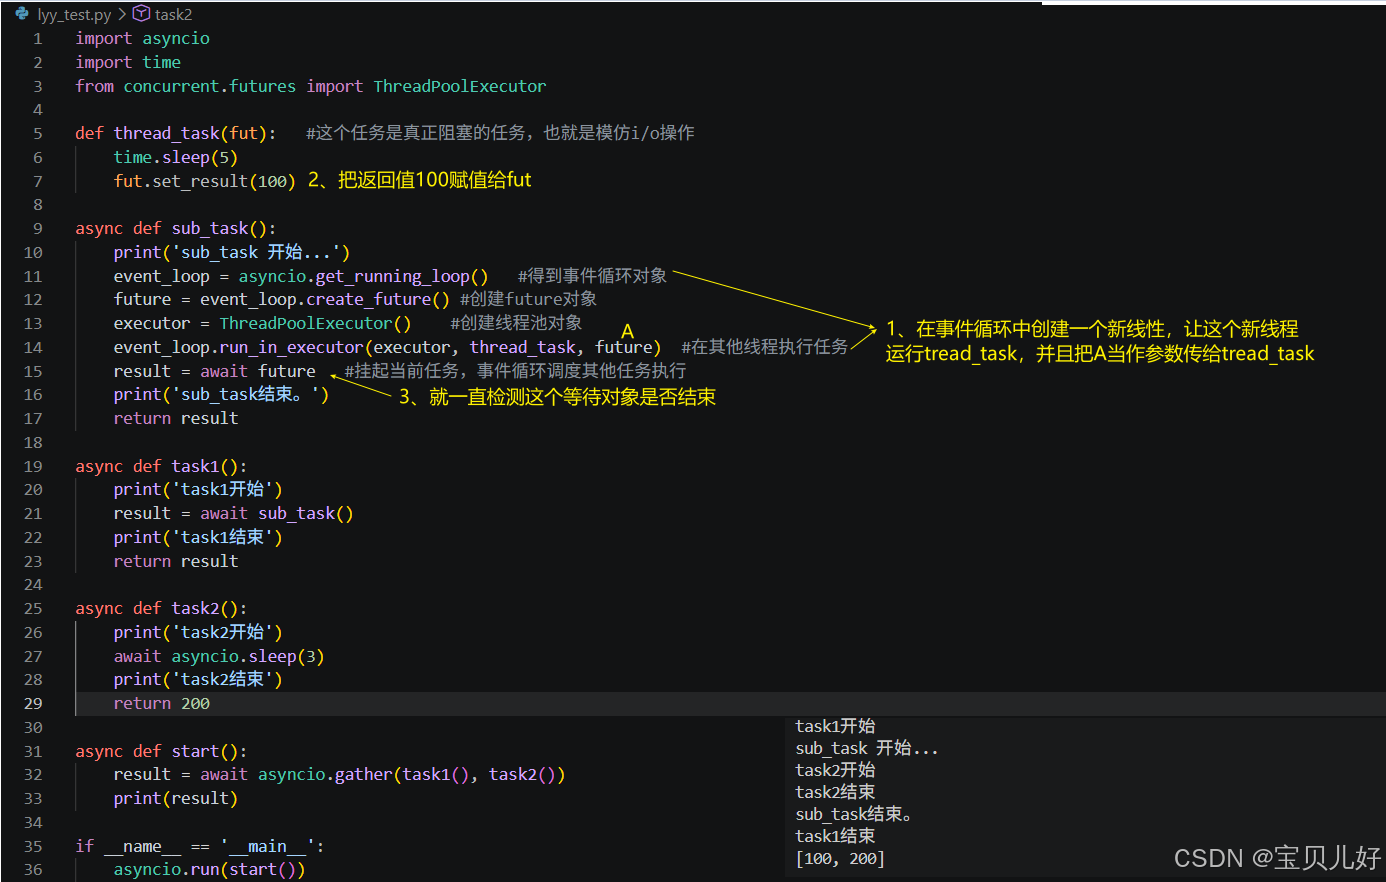
6、小结
异步编程是一种在单线程中实现并发执行的技术,它通过"事件循环"来调度任务,遇到需要等待的操作时(比如网络请求或文件读写),就把控制权交给其他任务,自己等结果再回来继续处理。这样就避免了cpu空闲干等的情况,大大提升了运行效率。
与多线程不同,异步不靠开启多个线程,而是通过切换任务来充分利用资源。
多线程是操作系统级的并发机制,需要操作系统介入,是一个重量级的调度方式。而基于事件循环的pyton异步编程是基于Python解释器层面的并发机制,是一种轻量级的调度方式。
所以通俗来说:异步编程就是让单线程也能干多件事,高效不阻塞。凡是要等待的操作,我们都应该考虑是否使用await、是否用异步库实现。
(二)langchain中的异步调用方式
1、langchain提供了3种调用方式:ainvoke()、astream()和abatch()方法。下面我用一个例子展示一下ainvoke: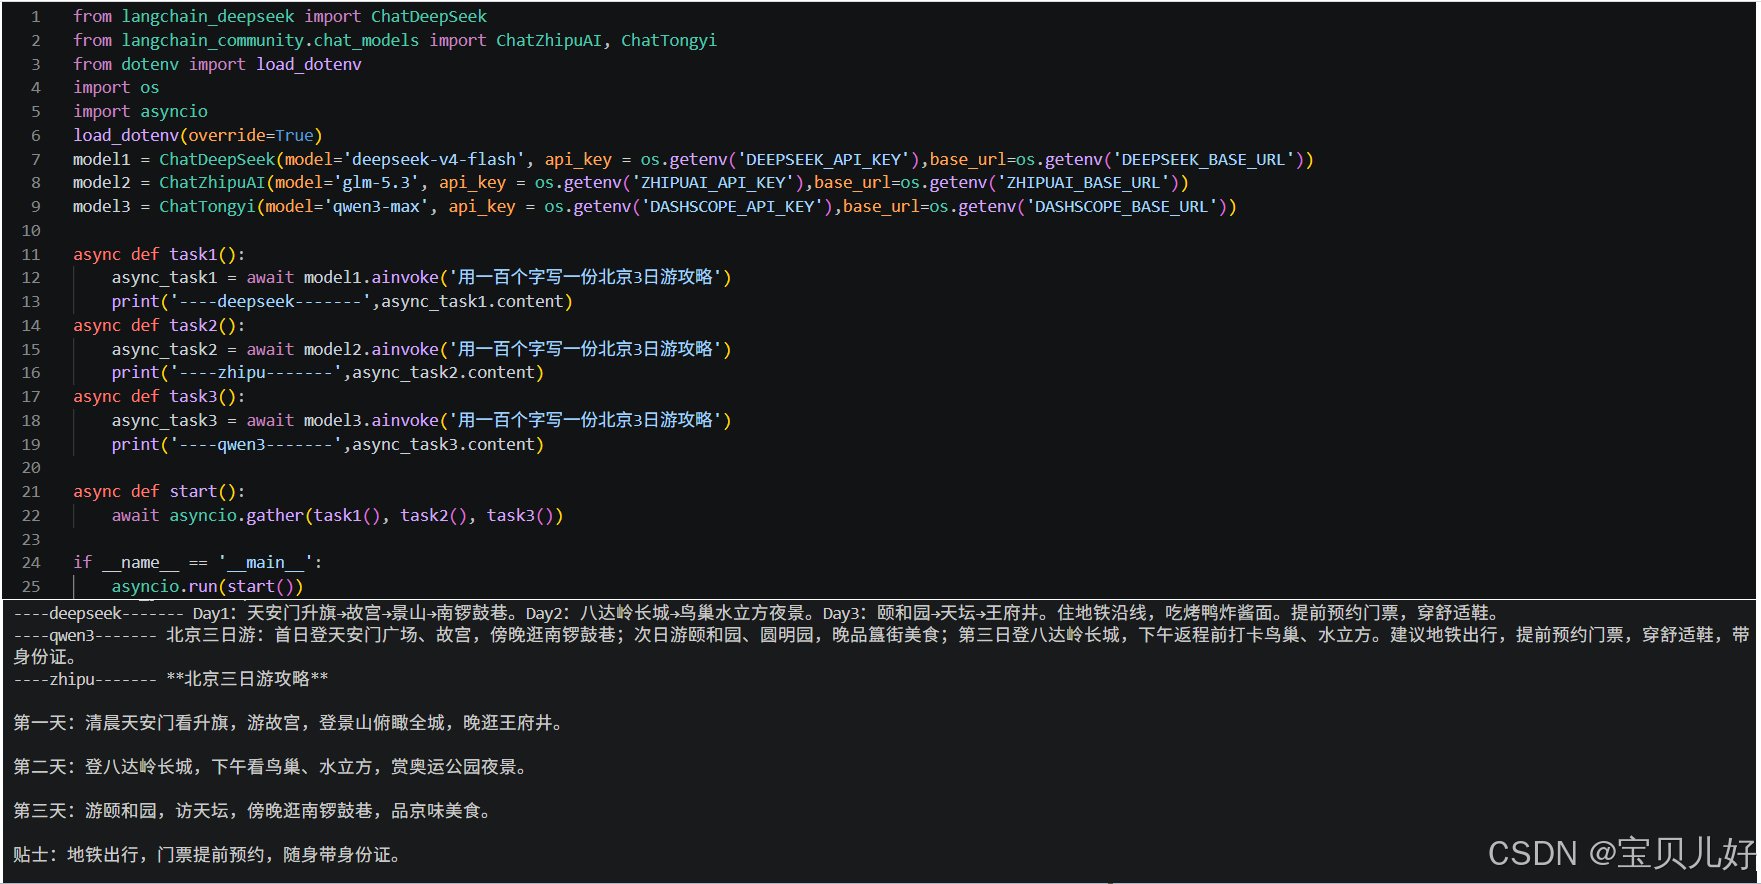
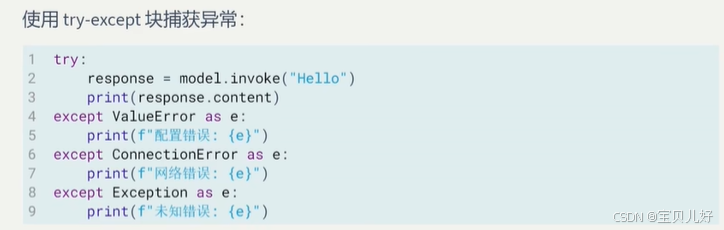
2、如何处理API调用失败