一、研究背景与核心问题
长时程智能体(long-horizon agents)的广泛应用,使模型工作负载越来越"输入密集"。虽然稀疏注意力等先前工作已经大幅降低了长上下文计算成本,但真正的瓶颈转移到了:
-
预填充(prefill)计算仍然昂贵
-
KV 缓存占用过大,持续挤压 HBM、SSD 容量
-
数据传输与互连带宽受限
因此,如何进一步压缩 KV 缓存、降低长上下文服务成本,成为部署长时程智能体的关键。
二、模型总体定位
DeepSeek-V4.1-Flash 是一个:
-
多模态 MoE 模型
-
552B 骨干参数 + 196B Engram 参数
-
支持 100 万 token 上下文
-
采用 因果编码器-解码器(CED)架构
-
预填充每 token 激活 8B 参数,解码每 token 激活 16B 参数
其最大特点是:模型规模远大于 DeepSeek-V4-Flash,但 KV 缓存占用反而大幅缩小,同时整体性能更好。
三、核心技术创新
1. 因果编码器-解码器(CED)架构
-
把 40 层 Transformer 分成 20 层编码器 + 20 层解码器
-
解码器的全局 KV 不再由自身隐藏状态生成,而是直接从前半部分(第 L/2 层)的隐藏状态投影得到
-
这样预填充阶段只需计算前半部分层,预填充计算量几乎减半
-
局部 SWA 仍逐层计算,但通过 SWA 有界重放 避免精确重建的高成本
2. 压缩稀疏注意力 2(CSA2)
CSA2 从三个维度联合压缩 KV 缓存:
-
条目大小:沿用 GQA / MLA 思路
-
序列维度:每 m 个 token 压缩成一个条目
-
层维度:跨层复用主 KV、索引器 K、Top-K 索引
CSA2 有三种模式:
-
Full:完整计算主 KV、索引器 K、Top-K 索引
-
Reindex:复用主 KV 和索引器 K,但重新选择 Top-K 索引
-
Reuse:同时复用主 KV 和 Top-K 索引,直接做稀疏注意力
此外还引入 分层稀疏索引器:
-
第一个 Full 层构建候选池
-
后续 Reindex 层只在候选池内搜索
-
使后续索引器每查询成本从"随上下文线性增长"变为"常数级"
3. FP4 主 KV 缓存
-
对主 KV 缓存采用 FP4 量化感知训练(QAT)
-
选择 E2M1 + 每 16 通道一个 E4M3 scale 的格式
-
省略二级全局 scale,简化缓存布局
-
将主 KV 缓存存储几乎减半
-
SWA KV 因对量化敏感,仍保留 FP8
4. SWA 有界重放(SWA Bounded Replay)
-
传统精确重建 SWA KV 需要重放 L × n_win 个 token,成本过高
-
有界重放只重放最近 n_win 个 token,接受近似状态
-
分为:
-
编码器 SWA 有界重放:使前缀缓存只依赖全局 KV,从而把 SWA KV 从持久化缓存中移除
-
解码器 SWA 有界重放:把解码器前向限制在 n_win 个 token,几乎再减半预填充计算
-
-
实验表明性能下降可忽略
5. 其他高效架构扩展
-
单遍 mHC + Mega-mHC 内核:把激活内存流量减半
-
Engram 条件记忆模块:196B 参数,解耦记忆与计算
-
DSpark 投机解码:半自回归草稿 + 置信度调度验证
-
按头 Muon、Sinkhorn 平衡更新等优化
四、KV 缓存压缩效果
这是全文最核心的量化成果:
| 指标 | DeepSeek-V4.1-Flash | 对比 |
|---|---|---|
| 全局 KV 缓存(HBM) | 890 字节/token | 约为 V4-Flash 的 1/4 |
| 持久化 KV 缓存(SSD/主机内存) | 约为 V4-Flash 的 1/8 | |
| 对比 DeepSeek-V1 | 全局 KV 缩小约 437 倍 |
同时:
-
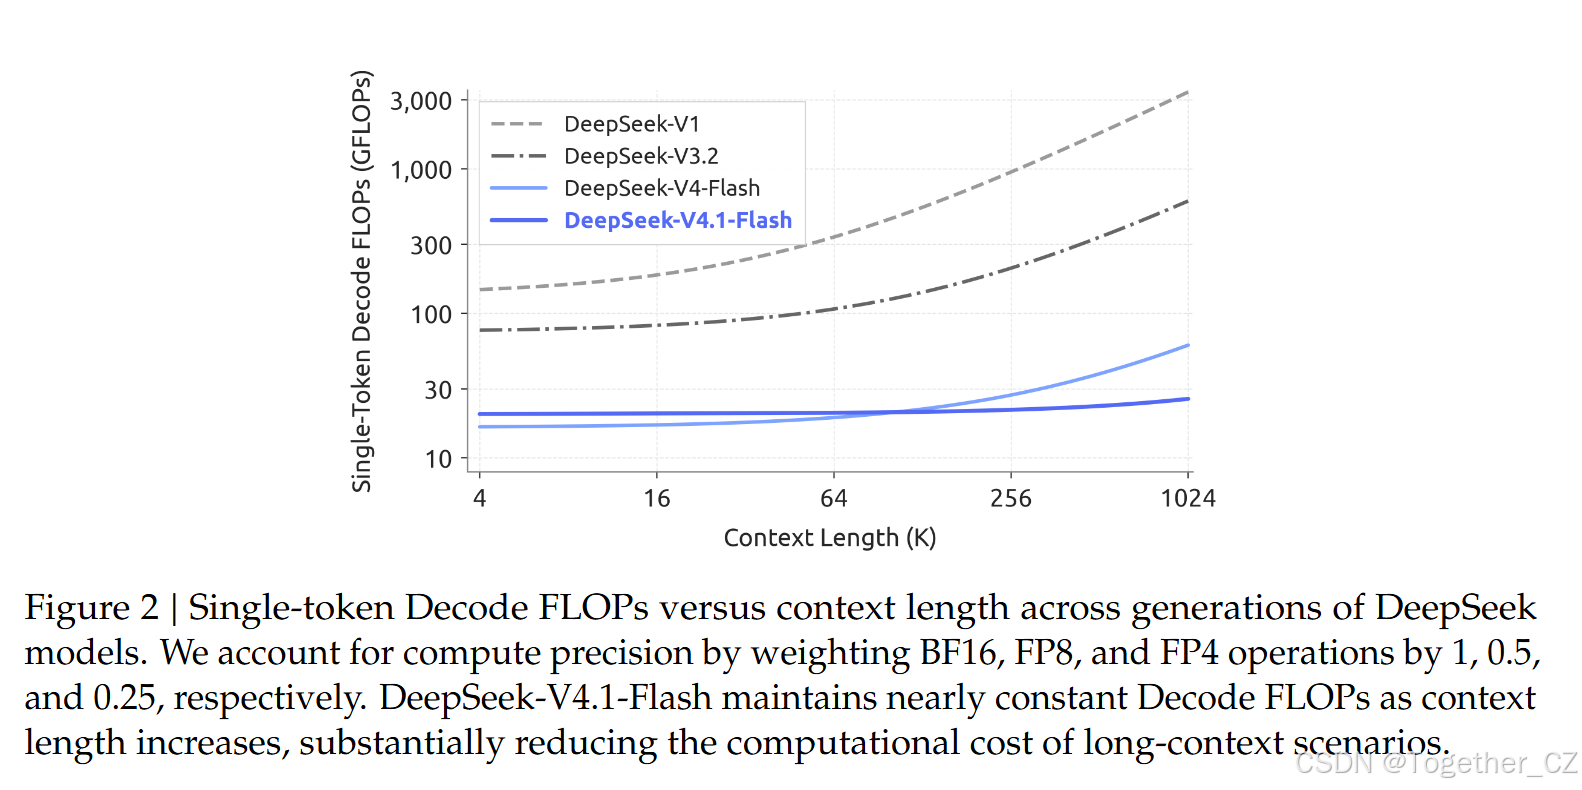
单 token 解码 FLOPs 随上下文长度几乎保持常数
-
上下文从 4K 扩展到 1M,解码 FLOPs 仅增加约 1/4
五、训练与数据
-
预训练语料:45T token 多模态数据
-
稀疏注意力从零开始训练,序列长度 64K,后扩展到 1M
-
文本与多模态数据比例约 7:1
-
视觉编码器 DeepSeek-ViT 单独训练:
-
对比预训练约 47B 图像-文本对
-
自回归微调 236B token
-
-
后训练遵循 SFT → RL → OPD 标准范式,没有算法创新,主要投入在数据合成与环境构建
六、后训练与智能体能力
后训练重点不在算法,而在大规模自动化数据合成与环境构建:
-
通用智能体:模拟真实工具、SaaS、企业系统,重建失败案例
-
编码智能体:从内部会话和 GitHub 仓库自动构建可验证任务
-
DSec 沙箱平台:支持数百万并发沙箱,用于大规模 RL
-
可控推理努力(Reasoning Effort):用标量 b(1--100)控制推理长度与成本
- API 暴露 low / high / max 三档,对应 50 / 75 / 100
七、主要评估结果
推理能力
-
Codeforces 评分 3471,超过 V4-Flash 和 V4-Pro
-
MathArena Apex 65.6%,与 Kimi-K3 持平
-
GPQA Diamond 90.9%
智能体能力
-
DeepSWE v1.1:74.2%,超过 Opus-5 和 GPT-5.6 Sol
-
Terminal-Bench 2.1:90.6%
-
Automation-Bench:54.8%
-
Agents' Last Exam:31.8%
多模态
-
在 Chartography、BabyVision 等视觉推理基准上超过 Kimi-K3
-
但与顶级闭源系统仍有差距
多智能体
- Agent Team 模式下,多智能体配置在 ProgramBench 和 FrontierSWE v2 上均优于单智能体
八、结论与局限
结论:
-
DeepSeek-V4.1-Flash 通过 CED + CSA2 + FP4 + SWA 有界重放,把 KV 缓存压缩推向新极限
-
在更小激活参数和更小缓存占用下,性能超过 DeepSeek-V4-Flash,并在多数基准上匹敌闭源前沿模型
-
大幅降低长时程智能体的部署成本
局限:
-
CSA2 的稀疏选择错误、SWA 有界重放的近似状态重建,可能在未测试边界情况下导致能力退化
-
与顶级闭源系统在最困难推理和边缘案例上仍有差距
-
标准基准日益饱和,需要更新评估协议
DeepSeek-V4.1-Flash 的核心研究内容是:通过 CED 架构、CSA2 跨层 KV/索引复用、FP4 KV 缓存和 SWA 有界重放,把百万 token 级长上下文的 KV 缓存压缩到极致(HBM 中 890 字节/token、持久化缓存仅为 V4-Flash 的 1/8),同时以 552B 总参数、8B/16B 激活参数实现超越前代、匹敌闭源前沿的推理、编码、多模态与智能体能力。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
预训练模型发布地址在这里,如下所示:
摘要
长时程智能体的广泛采用,使模型工作负载日益呈现输入密集型特征。尽管先前的工作已大幅降低了长上下文计算成本,但预填充(prefill)的计算代价依然高昂,而庞大的 KV 缓存仍持续对 HBM 与 SSD 容量以及数据传输带宽造成压力。计算、存储与带宽这三方面的需求共同构成了进一步降低部署成本的主要瓶颈。为应对这一挑战,我们提出了 DeepSeek-V4.1-Flash,一个多模态混合专家(MoE)模型,其骨干参数为 552B,支持高达一百万 token 的上下文。凭借其因果编码器-解码器(Causal Encoder-Decoder, CED)架构,该模型在解码阶段每 token 激活 16B 参数,而在预填充阶段仅激活 8B 参数,从而大幅提升了智能体工作负载的成本效率。为突破 KV 缓存压缩的极限,DeepSeek-V4.1-Flash 将压缩稀疏注意力 2(Compressed Sparse Attention 2, CSA2)中的跨层 KV 缓存复用与 FP4 KV 缓存相结合。这些设计将其全局 KV 缓存占用(始终位于 HBM 中)降至每 token 890 字节,约为 DeepSeek-V4-Flash 对应占用的 1/4。此外,通过一项名为 SWA 有界重放(SWA Bounded Replay)的专用部署优化,DeepSeek-V4.1-Flash 将其持久化 KV 缓存占用(始终位于 SSD 或主机内存中)降至约为 DeepSeek-V4-Flash 的 1/8。尽管 KV 缓存占用大幅缩小,该模型的性能仍显著优于基线。此外,我们精简了 DeepSeek-V4 架构,并引入了若干高效的架构扩展。我们在包含 45T token 的多模态语料上预训练 DeepSeek-V4.1-Flash,并进行了全面的后训练,在多样化的文本与多模态智能体场景中取得了强劲性能。
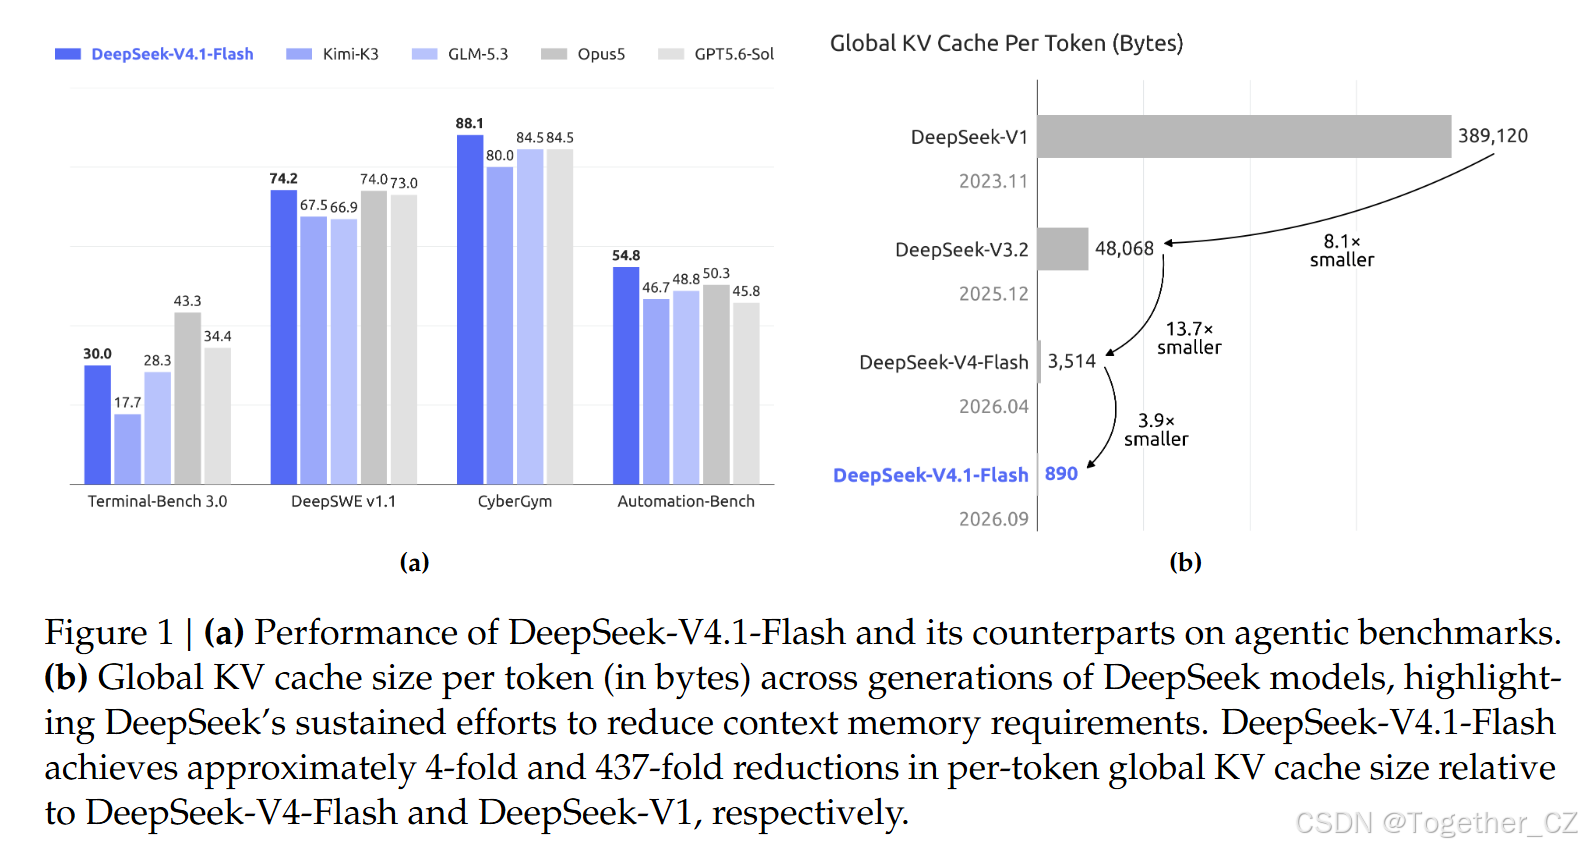
图 1 | (a) DeepSeek-V4.1-Flash 及其同类模型在智能体基准上的性能。(b) 历代 DeepSeek 模型每 token 的全局 KV 缓存大小(字节),凸显了 DeepSeek 在降低上下文内存需求方面的持续努力。DeepSeek-V4.1-Flash 相对于 DeepSeek-V4-Flash 和 DeepSeek-V1,每 token 全局 KV 缓存大小分别实现了约 4 倍和 437 倍的缩减。
1. 引言
近年来,长时程智能体的应用迅速扩展,使超长上下文处理日益成为重要的模型工作负载。支持此类工作负载不仅需要高效的长序列处理,还需要对大规模 KV 缓存进行持久化存储、复用与传输。因此,KV 缓存管理已成为模型部署的一项基础能力,同时在计算、存储与通信方面带来了巨大挑战。先前在稀疏注意力方面的进展(DeepSeek-AI, 2025, 2026b)已显著降低了长序列处理的计算成本,使持久化存储与数据移动日益成为突出的瓶颈。
具体而言,DeepSeek-V4(DeepSeek-AI, 2026b)将覆盖完整上下文的全局注意力分支与局部滑动窗口注意力(SWA)相结合。全局分支维护全局 KV,包括主 KV 与索引器 K,而 SWA 维护局部 KV 状态。对于固定的窗口大小,SWA KV 存储与序列长度无关,是有界的。因此,对于足够长的序列,全局 KV 主导运行时 KV 占用,而后者受 HBM 容量约束。此外,某些 KV 会被持久化以用于前缀复用,称为持久化 KV 缓存,其受 SSD 与主机内存容量约束。I/O 与互连带宽也限制了缓存的迁移与加载。这些约束共同限制了服务吞吐量,增加了部署成本,并最终阻碍了智能体在更长任务时程与更广泛应用场景中的部署与采用。
因此,进一步降低 KV 缓存占用对于缓解存储与通信瓶颈、降低长上下文服务成本至关重要。为此,我们开发了 DeepSeek-V4.1-Flash,一个专为更激进的 KV 缓存压缩而设计的多模态混合专家(MoE)模型。DeepSeek-V4.1-Flash 拥有 552B 骨干参数,原生支持多模态输入,并可容纳高达一百万 token 的上下文。我们采用因果编码器-解码器(CED)架构,其中解码器全局 KV 由最终编码器隐藏状态投影而来。该设计使模型在预填充阶段每 token 激活 8B 参数,在解码阶段激活 16B 参数,这对于输入密集型智能体场景尤其具有成本效益。尽管规模远大于 DeepSeek-V4-Flash,DeepSeek-V4.1-Flash 在相同序列长度下仅需约 1/4 的运行时 KV 缓存存储和 1/8 的持久化 KV 缓存存储。此外,DeepSeek-V4.1-Flash 的整体性能优于 DeepSeek-V4-Flash。
这种程度的 KV 缓存压缩是通过模型架构、缓存精度与部署策略的联合优化实现的。从概念上讲,DeepSeek-V4 可视为一个基于 SWA 的局部处理骨干,并辅以压缩的全局上下文。这一视角促使我们专注于简化全局分支,同时基本保留局部注意力设计。在架构层面,我们设计了压缩稀疏注意力 2(CSA2),对全局 KV(包括主 KV 与索引器 K)以及 Top-K 索引应用跨层复用,从而大幅减少 KV 缓存存储。CSA2 有三种静态分配的模式:Full、Reindex 与 Reuse。Full 模式生成全局 KV 并执行索引。Reindex 模式复用前一层产生的全局 KV,并使用自己的索引器 Q 对共享的索引器 K 重新打分并选择新的 Top-K 索引。Reuse 模式复用前一层中的全局 KV 与 Top-K 索引,并直接执行稀疏注意力。在所有三种模式中,每一层都保留自己的全局 Q 与 SWA KV。共享全局 KV 与索引器 K 减少了重复的缓存存储。此外,与 DeepSeek-V4 采用压缩稀疏注意力(CSA)- 重度压缩注意力(HCA)混合架构不同,DeepSeek-V4.1-Flash 使用纯 CSA2。在缓存精度层面,我们在训练期间使用 FP4 全局 KV 缓存,性能仅有边际下降。CSA2 与 FP4 KV 缓存相结合,将全局 KV 缓存存储降至约为 DeepSeek-V4-Flash 的 1/4,如图 1(b) 所示。在部署层面,DeepSeek-V4.1-Flash 与 DeepSeek-V4 一样,在每一层都使用滑动窗口注意力(SWA)。在 DeepSeek-V4 中,我们使用混合策略来平衡持久化 SWA KV 缓存的存储成本与精确重建所需的计算。精确重建需要重放最近的 L×nwin 个 token,其中 L 是层数,nwin 是 SWA 窗口大小。在 DeepSeek-V4.1-Flash 中,我们引入了 SWA 有界重放,仅通过重放最近的 nwinnwin 个 token 来近似重建所需的 SWA KV 状态。我们的实验表明,这仅带来可忽略的性能下降。这一发现建立了一种新的存储-计算权衡,使我们能够避免将 SWA KV 缓存持久化到 SSD,同时仅产生少量预填充重计算。借助 SWA 有界重放,持久化 KV 缓存占用进一步降至约为 DeepSeek-V4-Flash 的 1/8。这些优化共同大幅缓解了 HBM 与 SSD 容量压力,降低了部署成本,并为更大规模的部署铺平了道路。
作为 CED 与 CSA2 的补充,我们进一步精简了原始 DeepSeek-V4 架构。此外,我们将原始 mHC(Xie et al., 2026)设计升级为单遍 mHC,并配套 Mega-mHC 部署内核,相对于原始四内核实现将激活内存流量减半。我们还集成了 Engram(Cheng et al., 2026b)条件记忆模块以增强模型能力。我们引入了 DSpark(Cheng et al., 2026a)投机解码架构,通过半自回归草稿生成与置信度调度验证来提高解码效率。综合所有架构改进,DeepSeek-V4.1-Flash 的单 token 解码 FLOPs 在不同上下文长度下几乎保持恒定。图 2 显示,将上下文长度从 4K 扩展到 1M(扩大 256 倍),其解码 FLOPs 仅增加 1/4,远低于 DeepSeek-V4-Flash 所观察到的增长。
为充分实现这些架构设计带来的 KV 缓存压缩收益,并进一步提升训练与推理效率,我们系统性地为 DeepSeek-V4.1-Flash 协同优化了训练基础设施与推理系统,确保高效且可扩展的大规模多模态训练与长上下文部署。训练基础设施支持分离式视觉编码器执行、长序列的均衡图像分片,以及注意力复用的跨阶段共享状态管理。推理系统实现了编码器与解码器 SWA 有界重放路径。进一步的优化包括通信-计算重叠、分片 Engram 嵌入表以及推理内核融合。特别地,每个 CSA2 Reuse 模式层在预填充期间仅执行 15 个内核,在解码期间执行 11 个内核。我们还将长期存活的全局 KV 存储与短期存活的编码器 SWA KV 在主机内存中分离,使用有界重放来近似重建缺失的编码器 SWA 状态。
在预训练期间,我们在包含 45T token 的大规模多模态语料上训练 DeepSeek-V4.1-Flash。稀疏注意力从零开始以 64K 序列长度训练,没有任何稠密注意力预热阶段。预训练后,模型具备原生多模态能力,并支持高达一百万 token 的上下文。在我们的评估中,DeepSeek-V4.1-Flash-Base 在世界知识、推理与编码能力上与 DeepSeek-V4-Pro-Base 相当,并在留出评估上取得 5%--10% 的提升,而总参数量仅为后者的 1/3,激活参数量仅为 1/4。这些结果共同凸显了其强大的参数效率,并反映了面向真实世界部署的训练数据质量改进。
在此基础模型之上,我们进行后训练以激发其推理与智能体能力。与上述架构创新不同,我们的后训练未引入算法创新:该配方遵循监督微调(SFT)后接强化学习(RL)与同策略蒸馏(OPD)的标准范式,除 DeepSeek-V4 开发中使用的成熟实践外没有任何修改(DeepSeek-AI, 2026b)。所有实质性变化都在数据流水线中。我们开发了用于数据合成与环境构建的大规模自动化流水线,并逐步扩展 RL 中使用的数据、任务与 rollout 规模,从而将模型能力扩展到文本、多模态与智能体领域。图 1(a) 总结了 DeepSeek-V4.1-Flash 在核心智能体基准上的性能。我们的评估表明,尽管规模紧凑,DeepSeek-V4.1-Flash 仍展现出独特的能力特征:
-
推理。 该模型具备强大的推理能力,在数学与竞技编程等推理密集型基准上保持高准确率,与顶级开源模型(如 Kimi-K3(Team et al., 2026a)和 DeepSeek-V4-Pro)表现相当。
-
智能体。 DeepSeek-V4.1-Flash 在 Terminal-Bench 2.1(Merrill et al., 2026)、DeepSWE v1.1(DataCurve, 2026)和 AutomationBench(Shepard and Salimans, 2026)等标准智能体基准上达到与闭源前沿模型相当的性能。它已被证明完全能够处理日常编码任务与白领工作流。然而,在需要专家级领域知识的科学导向智能体任务(如 Terminal-Bench 4.0(Marten et al., 2026a))上,与巨型模型仍存在差距。
-
多模态。 在多模态领域,该模型在评估视觉推理与专业图表解读的基准上超越了 Kimi-K3 等顶级开源竞争对手。除正式指标外,它在真实世界视觉智能体工作流(如前端开发与办公自动化)中也展现出实用价值,能够利用渲染的屏幕截图进行视觉检查与自我纠正。尽管如此,我们承认与巨型闭源系统相比仍存在明显的整体性能差距。
这些结果表明,DeepSeek-V4.1-Flash 已在绝大多数基准上能与闭源前沿模型匹敌,并能够完成超过 95% 的真实世界任务。同时,其较小的激活占用带来了低推理延迟与服务成本。因此,我们认为 DeepSeek-V4.1-Flash 在能力与效率之间提供了有利的权衡,可作为支持广大用户日常工作的快速、经济助手。
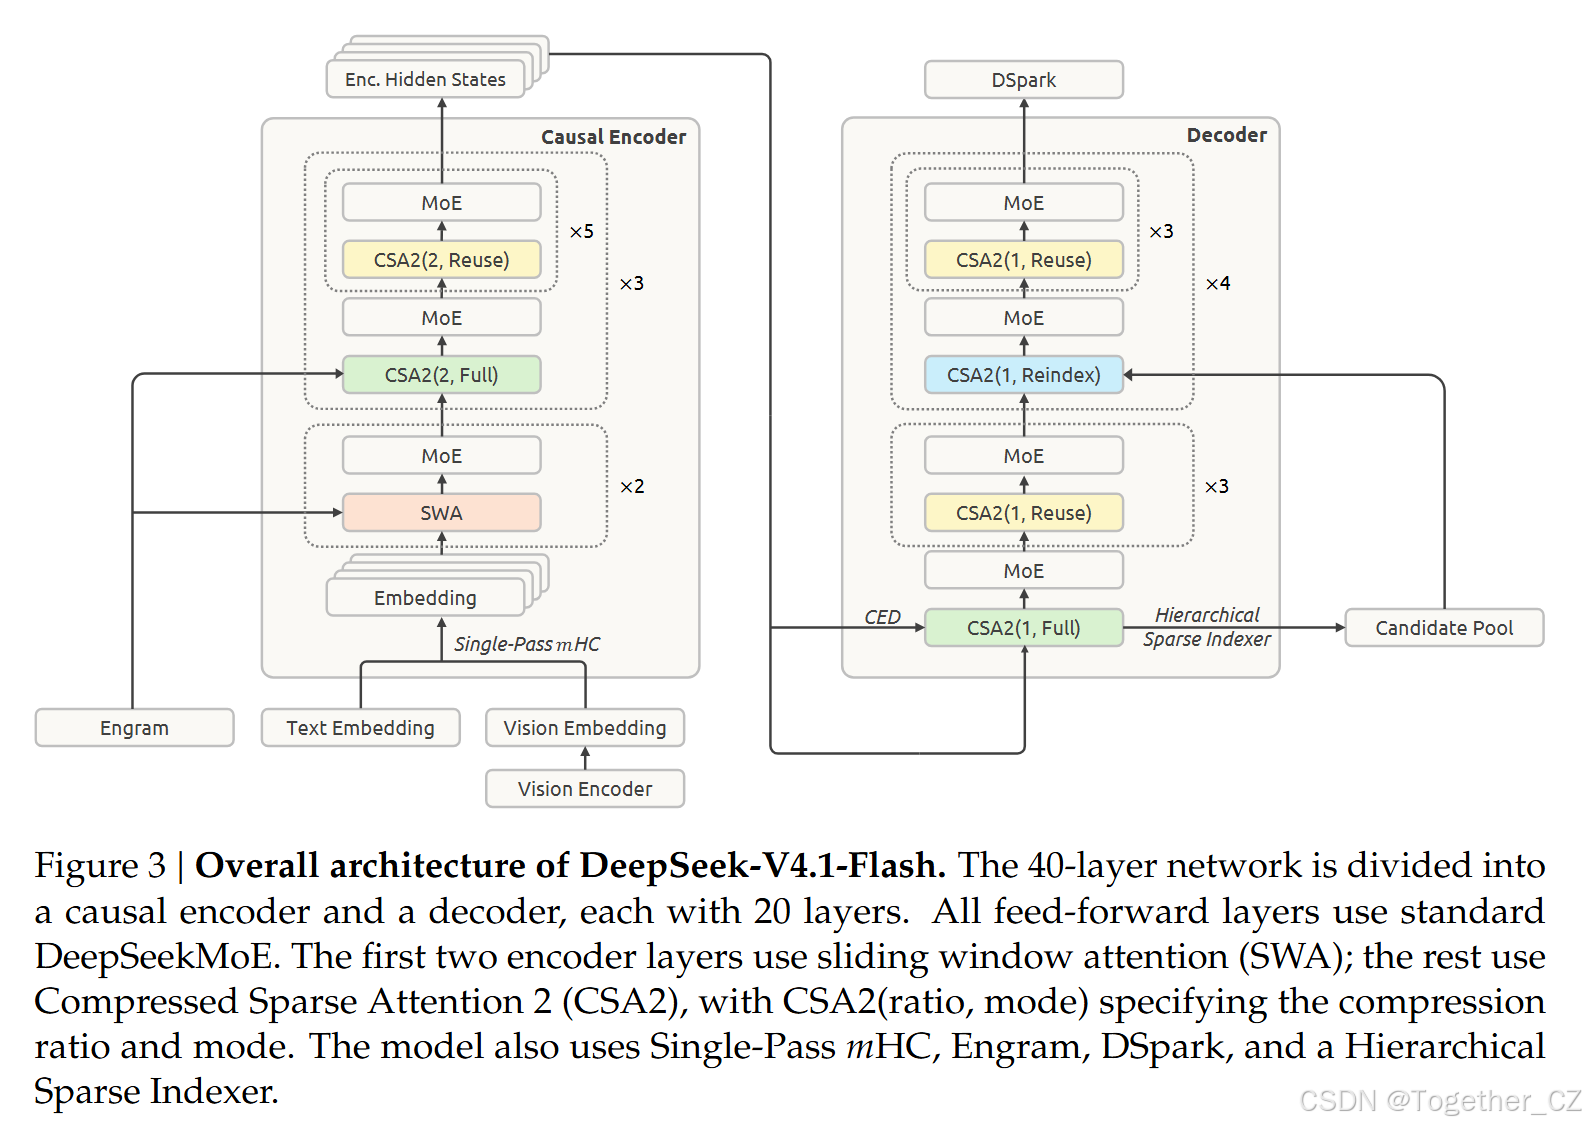
图 3 | DeepSeek-V4.1-Flash 的整体架构。40 层网络分为因果编码器与解码器,各 20 层。所有前馈层使用标准 DeepSeekMoE。前两个编码器层使用滑动窗口注意力(SWA);其余层使用压缩稀疏注意力 2(CSA2),其中 CSA2(ratio, mode) 指定压缩比与模式。该模型还使用单遍 mHC、Engram、DSpark 与分层稀疏索引器。
总之,DeepSeek-V4.1-Flash 同时提升了模型智能与推理效率,并降低了部署成本。它大幅降低了大规模部署长时程智能体的成本门槛,并为其在更广泛场景中的采用创造了新机遇。DeepSeek-V4.1-Flash 也是我们持续扩展努力的新起点。在此基础上,我们将追求模型架构、预训练与后训练的联合扩展,以进一步探索模型智能的前沿。
2. 架构
2.1. 概述
DeepSeek-V4.1-Flash 是一个多模态混合专家(MoE)Transformer,接受图像与文本作为输入,并自回归生成文本。其语言骨干由 40 个因果 Transformer 层组成,组织为 20 层因果编码器后接 20 层解码器。每一层都包含全局注意力与滑动窗口注意力(SWA),但前两层仅使用 SWA。视觉编码器与 MLP 投影器将图像转换为视觉嵌入,与文本嵌入一起处理,多模态数据从语言模型预训练开始就被纳入。总体而言,DeepSeek-V4.1-Flash 拥有 552B 骨干参数与 196B Engram 参数,在预填充阶段每 token 激活 8B 参数,解码阶段激活 16B 参数。图 3 展示了 DeepSeek-V4.1-Flash 的整体架构。
因果编码器-解码器(CED)架构与压缩稀疏注意力 2(CSA2)解决了长上下文推理的互补成本。CED 从编码器输出构建解码器的全局键值(KV)缓存,使大多数提示 token 绕过完整的解码器计算,同时保留层局部滑动窗口注意力。这将预填充计算几乎减半,降低了在上下文不断增长的智能体工作负载中处理新输入或未缓存输入的成本。CSA2 跨层共享全局 KV 以减少缓存存储,并复用稀疏选择以减少索引工作。在解码器中,分层稀疏索引器将后续索引器限制在由早期索引器选定的候选池内,进一步减少每个查询需要打分的条目数量。
我们保留了 DeepSeekMoE(Dai et al., 2024)的共享与细粒度路由专家,并为图像与文本 token 引入了模态特定的负载均衡(Wang et al., 2024a)。单遍 mHC(Xie et al., 2026)修改了残差流混合,以实现更高效的内核融合,而 Engram(Cheng et al., 2026b)增加了稀疏访问的条件记忆。我们在骨干预训练期间省略 MTP 模块,并使用 DSpark(Cheng et al., 2026a)进行投机解码。我们在骨干预训练阶段之后单独训练 DSpark。此外,我们将主 KV 缓存压缩为 FP4,以进一步降低存储开销。以下各节描述这些组件及相应的优化变更。
2.1.1. 多模态架构
多模态输入路径包括视觉编码器与 MLP 投影器。对于每张输入图像,视觉编码器产生视觉特征的空间网格。然后,3×3 像素反混洗操作沿通道维度重新排列每个局部邻域,在 MLP 投影器将特征映射到语言骨干的隐藏维度之前降低空间分辨率。最后,得到的视觉嵌入被插入到输入嵌入序列中对应的图像 token 位置,并由语言骨干与文本嵌入联合处理。
DeepSeek-ViT 我们从零开始训练一个名为 DeepSeek-ViT 的视觉编码器,以原生处理不同分辨率的图像。我们基于 Vision Transformer(Dosovitskiy et al., 2021)架构构建 DeepSeek-ViT,并进行了若干修改。为适应任意分辨率的输入,我们用 2D-RoPE 替换标准绝对位置嵌入。为使 ViT 更贴近 LLM 设计原则,我们将 patch 嵌入层的卷积替换为线性投影,以确保与 Muon 优化器兼容。我们还采用 RMSNorm(Zhang and Sennrich, 2019)进行归一化,并采用 SwiGLU(Shazeer, 2020)作为激活函数。在将视觉特征输入 LLM 之前,我们应用 3×3 下采样的像素反混洗操作,将视觉 token 数量减少九倍,有效支持高达约 1344×1344 像素的输入分辨率。
MoE 的多模态无辅助损失负载均衡 图像与文本 token 表现出不同的表示分布,并可能在 MoE 中引发不同的专家路由偏好。因此,平衡它们的总体负载可能会掩盖模态特定的不平衡。为解决此问题,我们扩展了无辅助损失负载均衡(Wang et al., 2024a),为文本与图像 token 分别维护专家级校正偏置。在路由过程中,每个 token 使用与其模态相关的校正偏置进行专家选择,同时保留原始路由分数用于对选定专家输出加权。在每个训练步骤后,两组偏置根据各自的专家负载独立更新。该设计平衡了每种模态内的专家利用率,有助于稳定高效的多模态训练。
2.2. 因果编码器-解码器(CED)
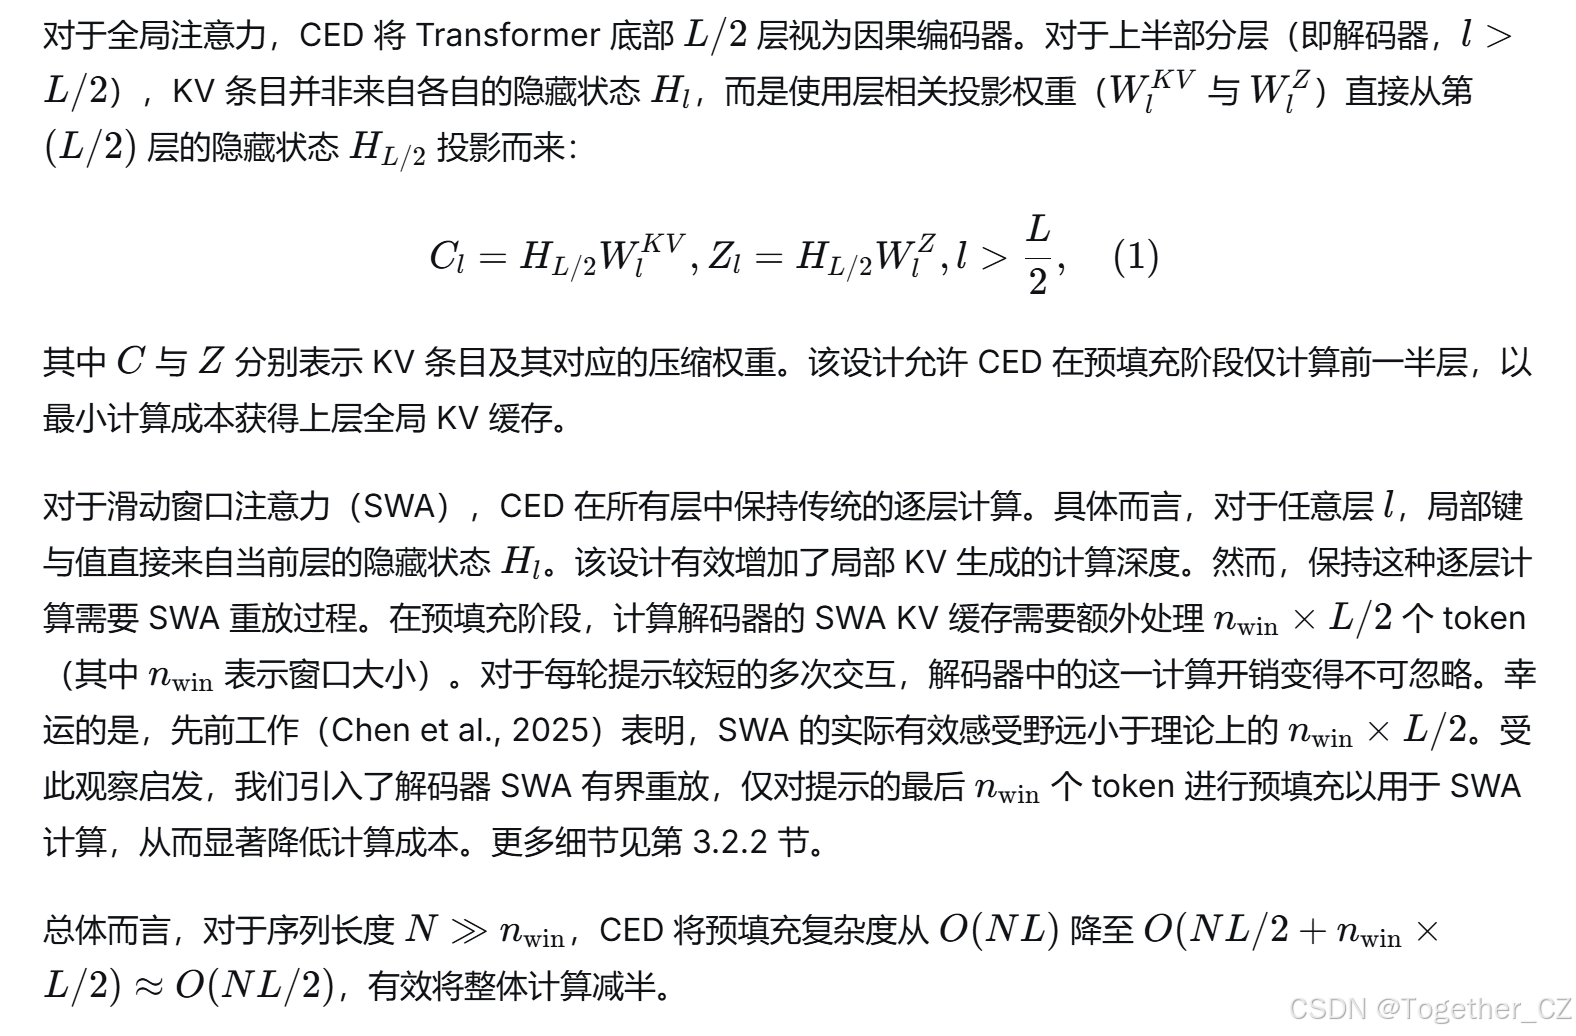
在智能体工作流中,频繁的工具调用会产生大量预填充请求,当 KV 缓存未命中时会造成严重计算开销。为缓解这一预填充瓶颈,我们提出了因果编码器-解码器(CED)架构,其灵感来自 YoCo(Sun et al., 2024)。YoCo 通过允许上半部分层直接共享下半部分层生成的 KV 缓存来减少预填充计算。在此概念基础上,CED 引入了一系列结构改进,以增强整体 KV 缓存容量与 KV 生成的计算深度。因此,CED 成功减少了近一半的预填充计算,同时保持与基线相当的性能。
2.3. 压缩稀疏注意力 2(CSA2)
服务长上下文需要同时控制 KV 缓存存储与注意力计算。这些成本可沿三个乘法维度降低:条目大小,其中 GQA(Ainslie et al., 2023)减少 KV 头数量,MLA(DeepSeek-AI, 2024)在头之间共享小潜在向量;序列维度,其中每 m 个 token 被压缩为一个条目,如 DeepSeek-V4(DeepSeek-AI, 2026b)中的 CSA 与 HCA;层维度,其中某些层复用其他层的缓存(Brandon et al., 2024)与选择,而不是保留自己的缓存,或完全被更高效的层替换。先前工作已表明沿层维度压缩是有效的:IndexCache(Bai et al., 2026)跨层复用 Top-K 索引以减少索引器计算;YOIO(Sun et al., 2026b)计算一次稀疏路由并在所有层间共享;HySparse(Gao et al., 2026)让稀疏层复用稠密层的 KV 缓存。然而,仅索引复用不能节省主 KV 存储,网络范围的路由共享限制了性能,混合设计仍保留完整注意力层;更重要的是,这些方法都没有覆盖全部三个乘法维度。
CSA2 联合利用这三个维度:它跨层共享主 KV 与索引器 K,并允许层复用 Top-K 索引,缓存共享与索引复用解耦。它将这些复用策略与简化压缩器及分层稀疏索引器相结合,后者缩小了解码器中后续索引层的搜索域。
与 CSA 类似,CSA2 包含一个轻量索引器,使用索引器 Q 与索引器 K 对主 KV 条目打分,并为每个查询选择 Top-K 条目。每个 Q 关注选定条目以及层局部滑动窗口 KV(SWA KV)。CSA2 还包括未压缩主 KV 设置作为压缩比为 1 的特例。同时,CSA2 简化了压缩器与索引器。在 CSA 中,压缩比 m 从 2m 个原始 KV 缓存条目生成每个主 KV 条目,相邻压缩条目具有重叠的源条目。它还包括绝对位置嵌入,以在压缩期间编码这些 2m 个条目的位置。CSA2 移除了这种重叠与绝对位置嵌入。此外,CSA2 通过投影主 KV 条目获得索引器 K,取代了 CSA 从隐藏状态单独压缩的路径。这两种设计简化了实现并提高了训练效率。
第 2.3.1 与 2.3.2 节分别描述跨层复用策略与分层稀疏索引器。
2.3.1. 跨层 KV 与索引复用
每个 CSA2 层被静态分配为三种模式之一:Full、Reindex 或 Reuse。在所有三种模式中,层计算自己的查询与 SWA KV,并将它们与选定的主 KV 条目一起使用以产生新的注意力输出。模式的区别在于它们如何获得主 KV、索引器 K 与 Top-K 索引。图 4 展示了这三种模式。
Full 模式。 该层计算自己的主 KV 与索引器 Q,从该主 KV 投影索引器 K,并运行索引器以产生新的 Top-K 索引。因此,它执行完整的 CSA2 计算路径,并具有与 DeepSeek-V4 中完整 CSA 层相同的组件职责。
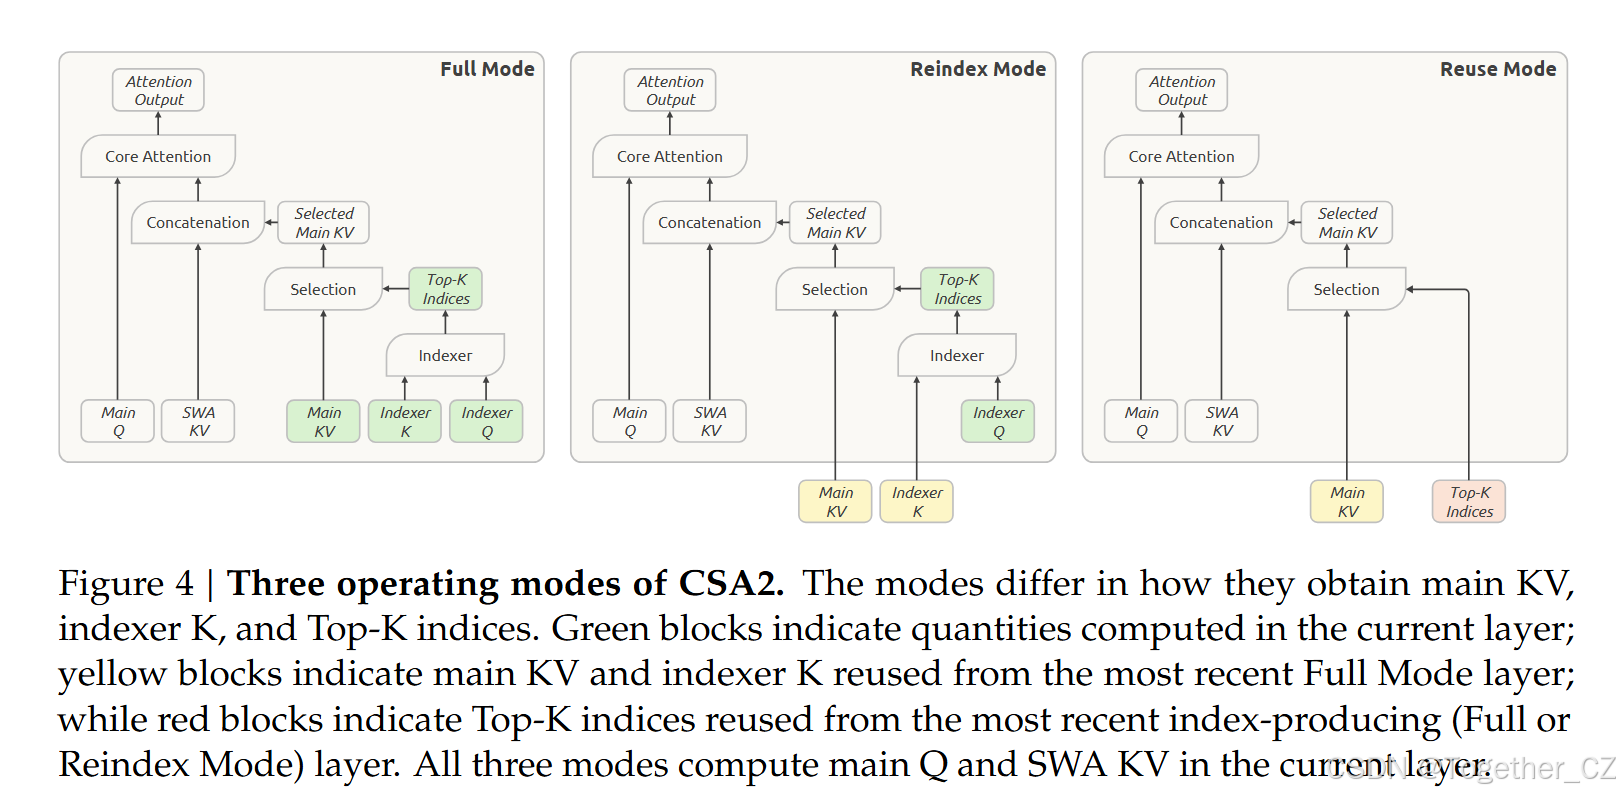
图 4 | CSA2 的三种操作模式。这些模式在如何获得主 KV、索引器 K 与 Top-K 索引方面不同。绿色块表示当前层计算的量;黄色块表示从最近的 Full 模式层复用的主 KV 与索引器 K;红色块表示从最近的产生索引层(Full 或 Reindex 模式)复用的 Top-K 索引。所有三种模式都在当前层计算主 Q 与 SWA KV。
Reindex 模式。 该层复用前一层最近可用的主 KV 及其对应的索引器 K。索引器计算自己的查询,对复用的键重新打分,并产生新的 Top-K 索引。这允许稀疏选择跨层变化,而主 KV 与索引器 K 保持共享。
Reuse 模式。 该层复用最近可用的主 KV 以及前一层在 Full 或 Reindex 模式下针对该主 KV 计算的最新 Top-K 索引。它使用该选择执行注意力,而不计算索引器 Q 或评估索引分数。
共享主 KV 与索引器 K 减少了缓存存储,而复用 Top-K 索引避免了额外的索引器计算。Reindex 模式在允许选定条目跨层变化的同时保持缓存共享。当 CSA2 与 CED 结合时,分配为 Full 模式的解码器层从第 (L/2) 层(即因果编码器的最后一层)的隐藏状态计算自己的全局 KV。Reindex 与 Reuse 模式不变。
2.3.2. 分层稀疏索引器
跨层索引复用减少了索引器评估次数,但剩余的索引器仍要对整个因果可见上下文打分。对于极长上下文,这一成本仍是主要计算瓶颈。先前工作通过在对 token 级索引之前对池化块表示打分与剪枝来引入索引器稀疏性(Xu et al., 2026b)。我们发现,在解码器中,来自较浅索引器的信息可以自然地用于限制较深索引器考虑的候选,而无需添加任何额外状态。因此,我们引入了分层稀疏索引器,仅在 CED 的解码器中使用,以减少解码期间这种重复打分。对于每个查询,第一个分配为 Full 模式的层构建一个候选池,后续重新索引层将其用作搜索域。对于固定的候选池大小,这将较深索引器的每查询成本从随上下文长度线性变为常数。该机制是训练感知的,并在后训练中引入:候选限制在训练与推理期间应用方式相同,因此较深索引器在其推理时使用的相同搜索域下进行优化。图 5 展示了这一过程。
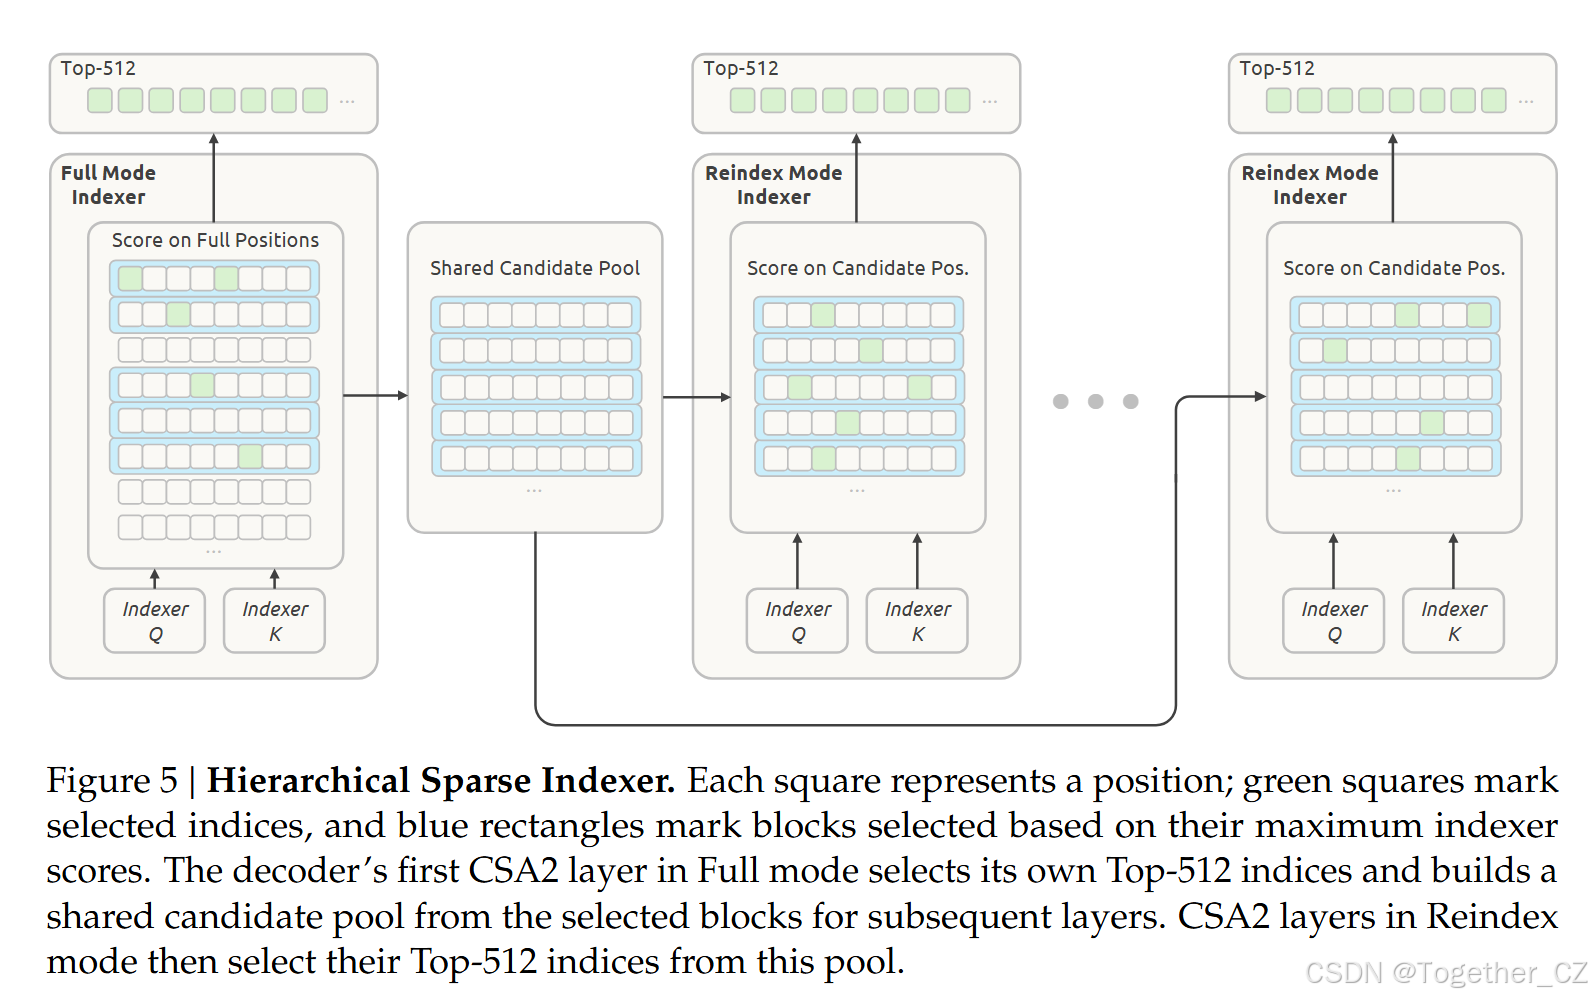
图 5 | 分层稀疏索引器。每个方块代表一个位置;绿色方块标记选定索引,蓝色矩形标记基于其最大索引分数选定的块。解码器中第一个 Full 模式的 CSA2 层选择自己的 Top-512 索引,并从选定块构建共享候选池以供后续层使用。Reindex 模式的 CSA2 层随后从该池中选择自己的 Top-512 索引。
第一个 Full 模式层对所有因果可见的主 KV 位置打分,并为其自身注意力产生 Top-K 索引。它还执行块级候选选择:每个块被赋予其位置中的最大索引分数,并选择分数最高的块。然后,它将选定块覆盖的位置收集到一个大于最终 Top-K 集合的候选池中。例如,选择 2,048 个块,每个块 8 个位置,则产生 16,384 个候选位置。该池定义了后续索引器搜索的位置;最终 Top-K 选择决定每层读取哪些主 KV 条目。
后续 Reindex 模式层仅对相应查询的候选位置打分,并在该池内选择自己的 Top-K 条目。Reuse 模式层不执行新索引,并使用针对其复用的主 KV 计算的最新 Top-K 索引。因此,候选池在索引层之间共享,而它们的最终选择可以不同。
对于固定的候选池大小,每个后续索引器每查询打分的 position 数量与上下文长度无关,是有界的。第一个 Full 模式层仍扫描整个因果可见范围。因此,分层索引降低了后续索引器评估的成本,同时保留了初始的全范围扫描。
2.4. 高效架构扩展
2.4.1. 单遍 mHC
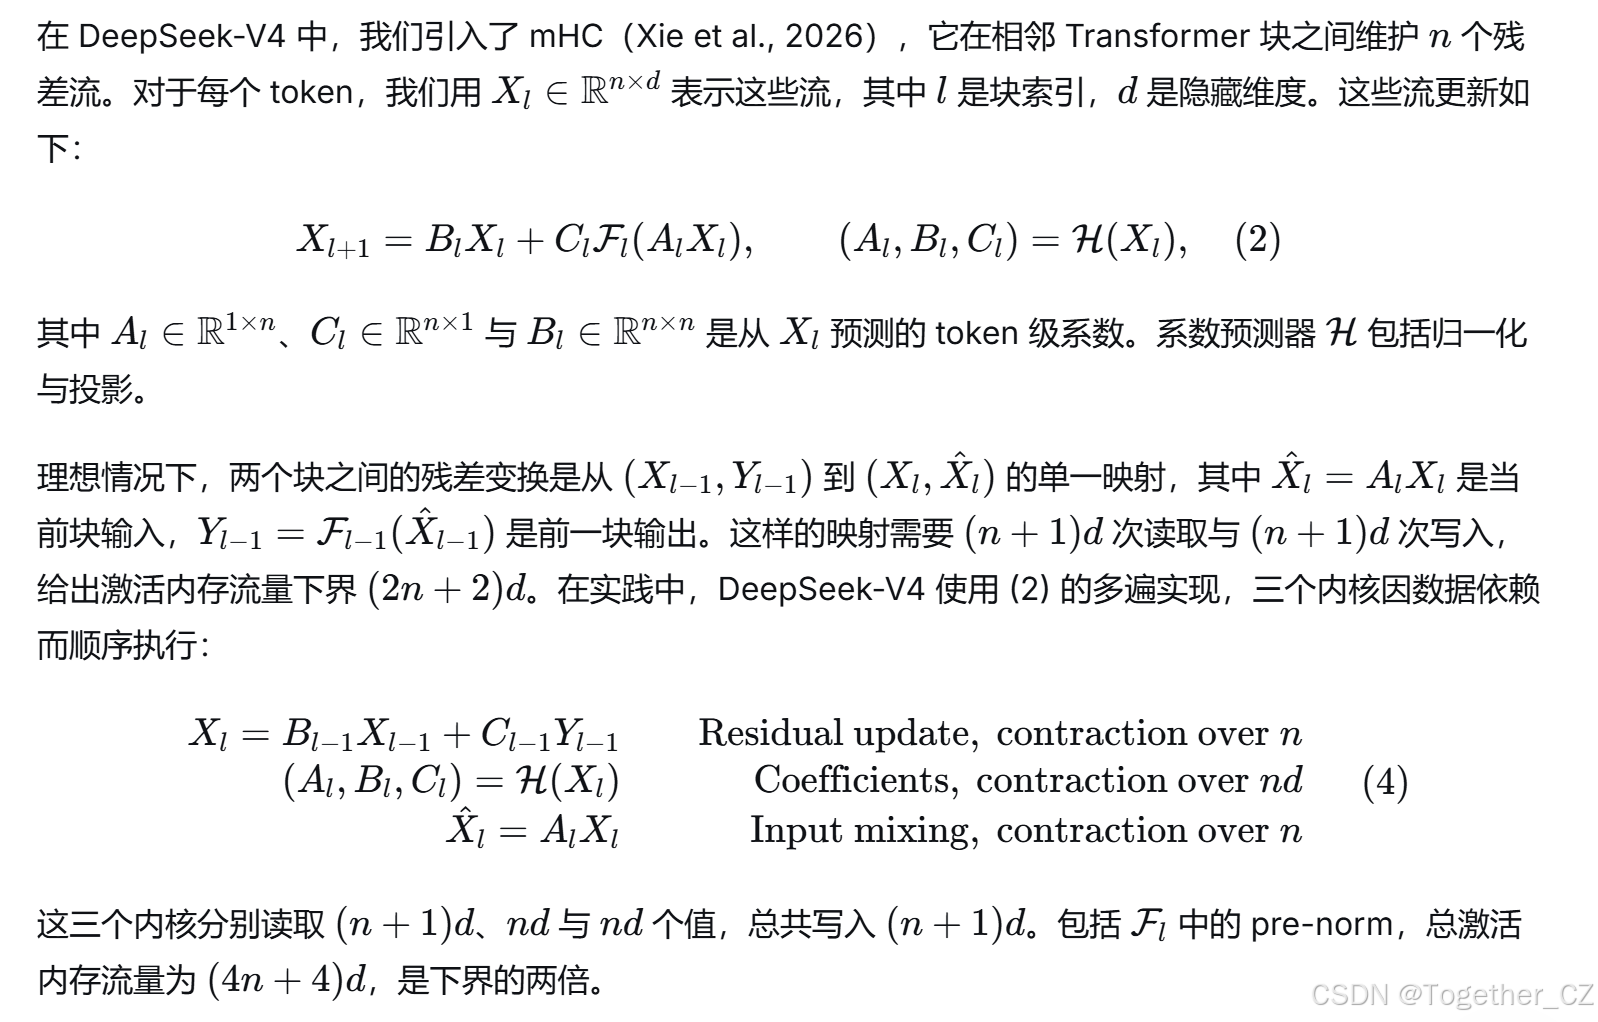
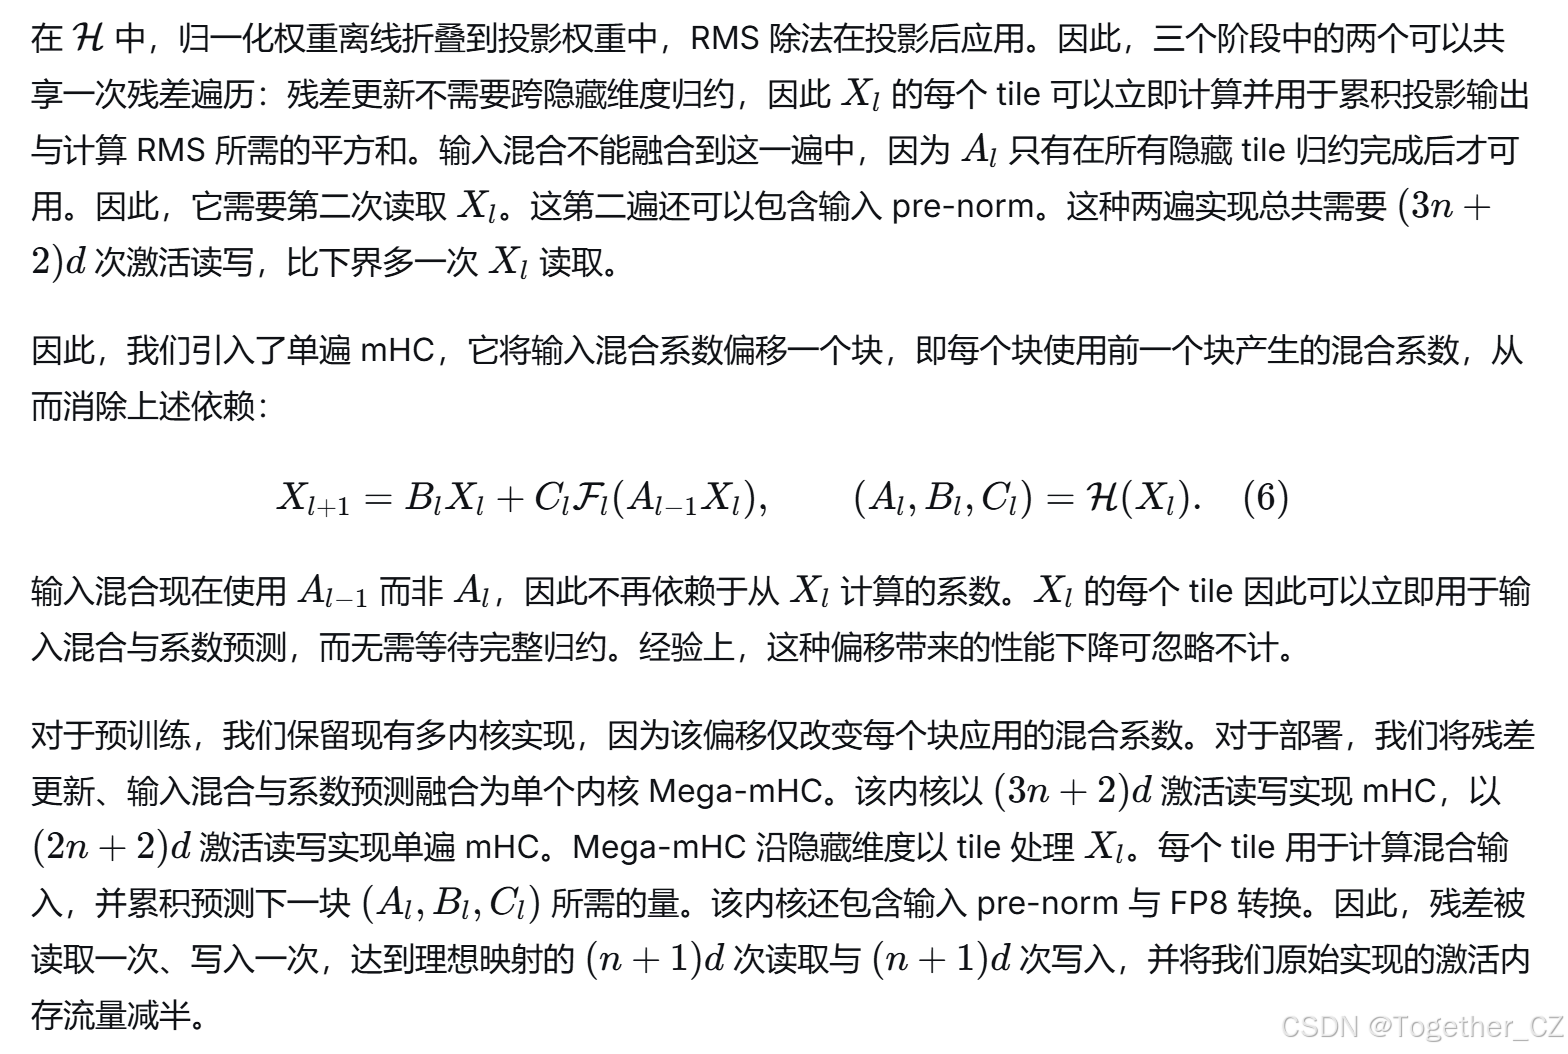
2.4.2. Engram
我们用 Engram(Cheng et al., 2026c)增强 DeepSeek-V4.1-Flash,这是我们先前工作中引入的条件记忆模块,用于将记忆与计算解耦。我们遵循原始 Engram 设计------tokenizer 压缩、多头哈希、上下文感知门控与多分支集成------并做了两处修改。首先,我们省略了短因果卷积,因为其性能增益不足以证明在我们的推理栈中增加复杂性的合理性。其次,我们使用基于动量的更新后接 Sinkhorn 平衡来优化 Engram 嵌入,详见第 2.5 节。
我们将 196B Engram 参数均匀分配到两个模块。每个模块使用 N-gram 阶数 {2,3,4},具有 8 个哈希头,每个阶数的总嵌入维度为 2048。每个头索引约 16M 条目的表,表大小选择为不同的素数。嵌入表与键/值投影均使用 FP8 精度。这些模块放置在第 1 层与第 14 层(零索引),以平衡训练流水线阶段的内存使用。在推理期间,确定性寻址使嵌入能够通过后台 RDMA 传输从主机内存预取,第一个模块的预取与第一个 Transformer 块中的计算重叠。Engram 训练与推理的进一步实现细节在第 3.1.3 节讨论。
2.4.3. DSpark
我们为 DeepSeek-V4.1-Flash 配备了 DSpark(Cheng et al., 2026a),这是一个投机解码模块,结合了半自回归草稿生成与置信度调度验证。草稿器由三个 Transformer 块组成,滑动注意力窗口为 128 个 token。通过这三个块的单次前向传递并行计算五个草稿位置的基础 logits,而一个轻量 Markov 头建模草稿 token 之间的依赖关系。置信度头预测每个位置的条件接受概率,用于估计前缀存活概率。调度器将这些估计与性能分析得到的引擎吞吐量曲线相结合,为每个请求动态选择验证长度,目标是在当前系统负载下最大化预期系统级 token 吞吐量。
与 DeepSeek-V3(DeepSeek-AI, 2024)中在整个预训练期间与骨干联合训练的 MTP 模块不同,DSpark 在预训练后的专门阶段引入。在此阶段,我们仅训练 DSpark,保持骨干冻结。在后训练期间,我们继续与骨干一起训练 DSpark,但不将 DSpark 目标的梯度传播到骨干。这使 DSpark 与不断演化的策略保持一致,使其能够加速在线服务以及 RL 与 OPD 的 rollout 生成。
2.4.4. FP4 主 KV 缓存
长上下文智能体工作负载需要大的每请求 KV 缓存,增加了服务成本。DeepSeek-V4 已使用量化感知训练(QAT)(Jacob et al., 2018)处理 FP4 索引器查询与键,加速索引计算并减少索引器缓存大小。我们采用 OCP 标准 MXFP4 格式(Rouhani et al., 2023)以支持尽可能多的硬件平台,尽管在我们的实验中替代格式具有更高精度。我们现在将 QAT 扩展到主 KV 缓存,其中 FP4 减少存储而非加速矩阵乘法。在注意力之前反量化缓存值使我们能够使用更精确的格式而无需该格式的原生矩阵乘法支持,从而保持跨硬件平台的兼容性。
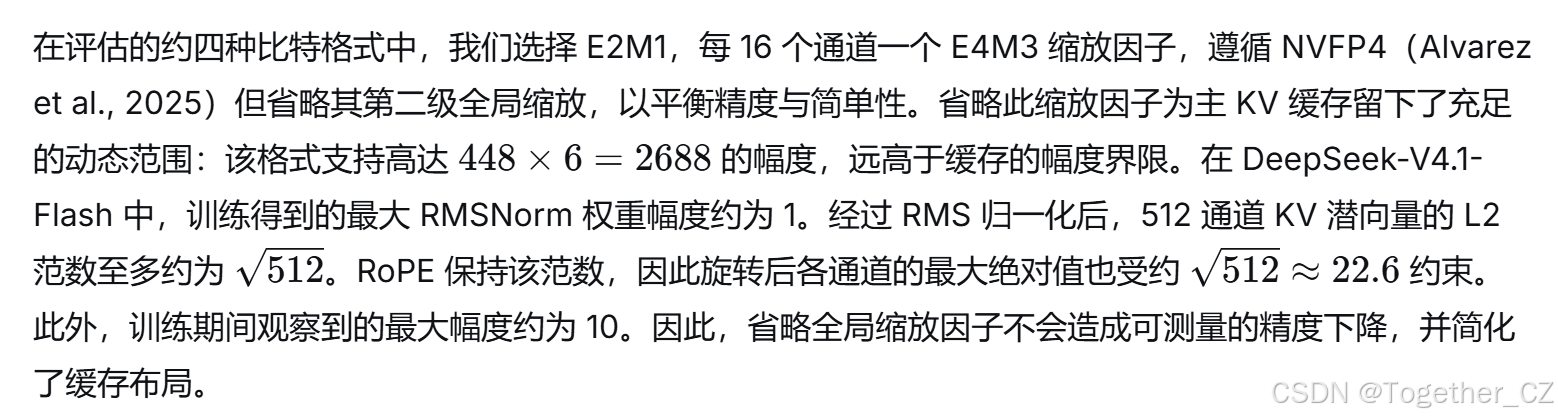
为在 DeepSeek-V4.1-Flash 中启用 FP4 主 KV 缓存存储,我们在后训练期间引入 QAT。非 RoPE 与 RoPE 组件使用相同的量化格式。我们在 RoPE 之后量化缓存:在 RoPE 之前量化在我们的实验中仅带来边际精度提升,并会在解码期间引入额外开销。由于 SWA KV 缓存对量化敏感,我们对其保留 FP8。与 DeepSeek-V4 中的 FP8 主 KV 缓存相比,该格式将存储占用(无论是在 HBM 中还是卸载到 SSD 时)几乎减半。
2.5. 优化
在 DeepSeek-V4 使用的优化配置基础上,我们做了一些新修改,以更好地契合架构设计。
首先,我们使用按头 Muon,其中 Query 权重在应用 Muon 更新前按头拆分。这里我们简要讨论这种设计的动机。通过将 Muon 视为预条件梯度下降,原始 Muon 对所有头使用一个预条件器,而按头 Muon 为不同头提供不同的预条件器。这种设计可以更好地处理注意力头之间的异质性(Zhang et al., 2024; Zhang, 2026, Section 3)。因此,我们观察到按头 Muon 优于原始 Muon。按头 Muon 的经验优势也在 GLM 5(Zeng et al., 2026)与 Kimi-K3(Team et al., 2026a)中得到验证。
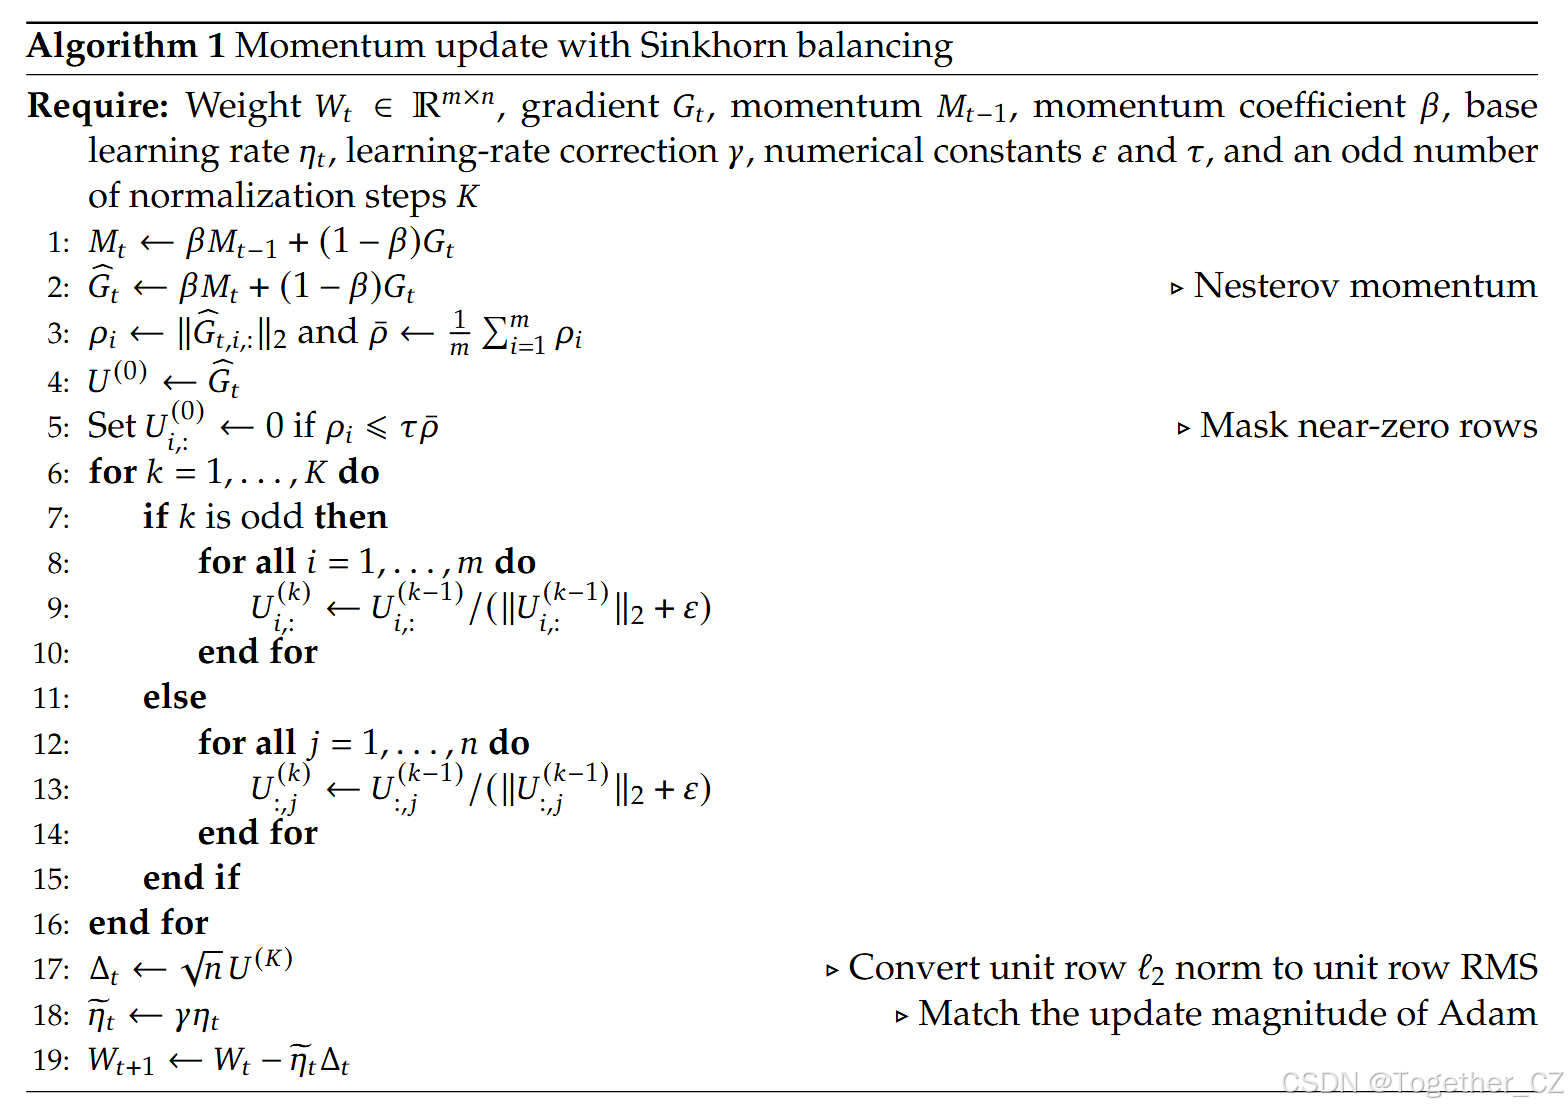
其次,将 Adam 应用于新引入的 Engram 参数会大幅增加优化器状态内存占用。为减少训练期间的内存使用,我们改用基于动量的更新后接 Sinkhorn 平衡来优化 Engram 嵌入表、token 嵌入与预测头。Sinkhorn 平衡先前已应用于 SinkGD(Scetbon et al., 2025)中的线性层权重矩阵;这里我们将其扩展到这些大型参数矩阵。与 Muon 一样,这种方法仅需动量缓冲区,而经验上优于 Adam。
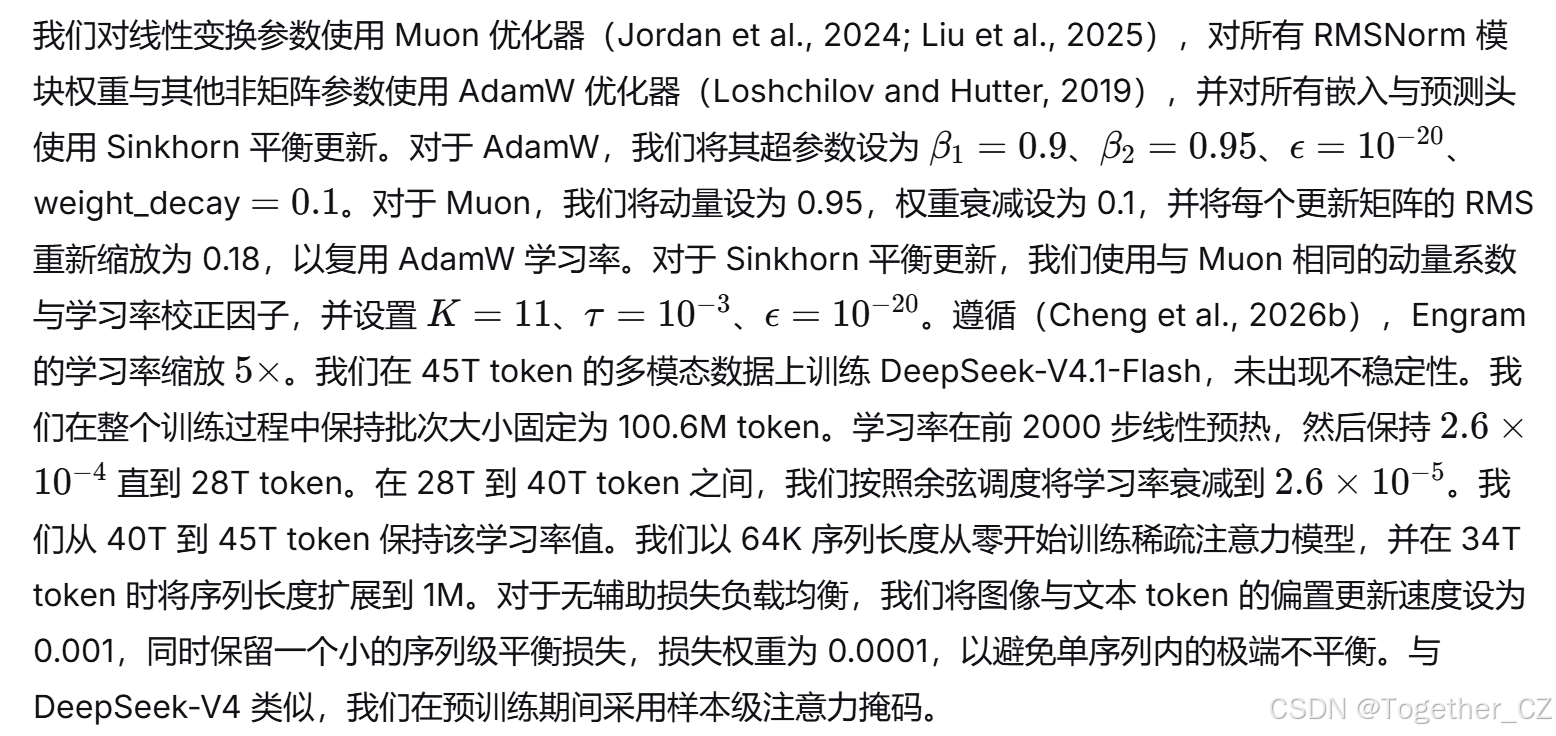
基本配置。 我们对归一化层权重与其他非矩阵参数(包括偏置与缩放因子)保留 AdamW(Loshchilov and Hutter, 2019)。我们对语言模型骨干、Engram 投影层与视觉-语言投影器中线性变换的权重矩阵使用 Muon(Jordan et al., 2024)。我们对 Query 与 Key 权重使用按头 Muon。我们对 Muon 应用解耦权重衰减与 Nesterov 动量(Nesterov, 1983; Liu et al., 2025);归一化层权重也受权重衰减影响,而偏置与缩放因子不受影响。Sinkhorn 平衡更新也使用 Nesterov 动量,但不应用权重衰减。在预训练期间,我们保持视觉编码器冻结,直到学习率衰减阶段,而其最终归一化层与视觉-语言投影器保持可训练。在学习率衰减开始时,我们解冻视觉编码器,并以较小的学习率与 LLM 联合优化。
Engram / 嵌入 / 预测头的 Sinkhorn 平衡更新。 完整过程总结在算法 1 中。在高层次上,它遵循与 Muon 相同的工作流程,用 Sinkhorn 平衡替代 Newton-Schulz 正交化。我们用 m 表示较大的矩阵维度,对应嵌入表与预测头的词汇表大小,用 n 表示隐藏维度。
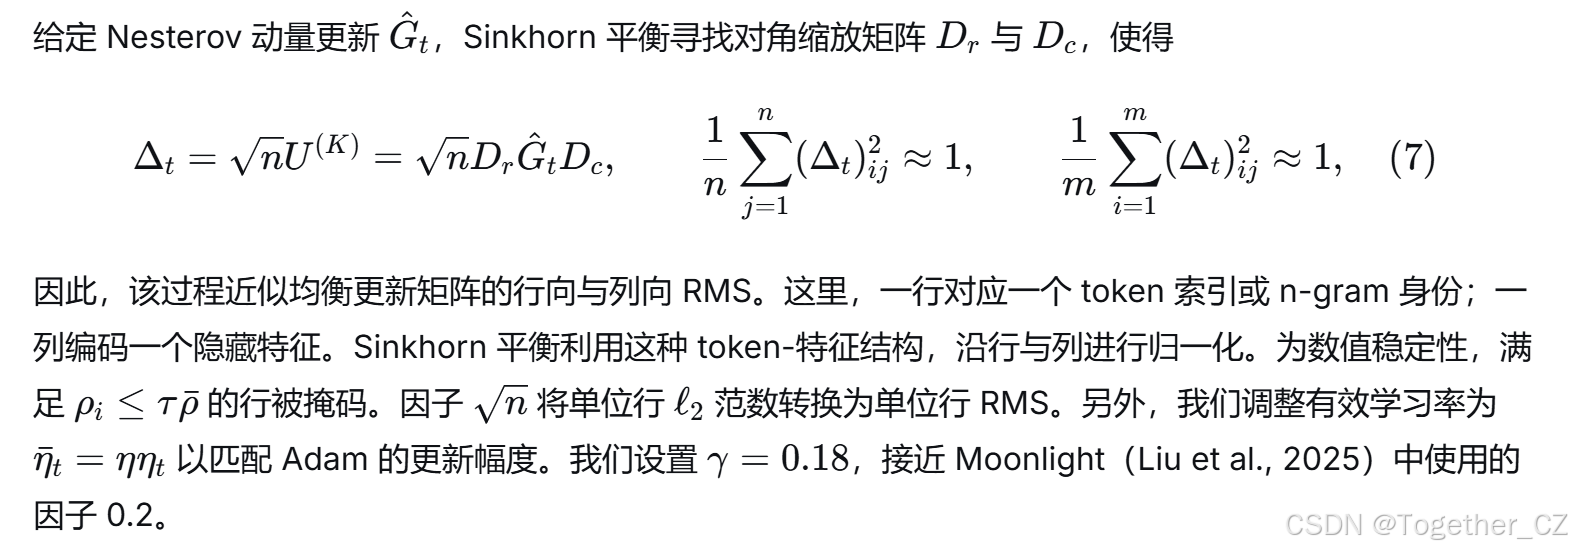
更广泛地说,Sinkhorn 平衡与利用矩阵或张量轴结构的优化器密切相关(Shazeer and Stern, 2018; Zhang et al., 2025a; Wen et al., 2025; Glentis et al., 2025; Deng et al., 2026; Yuan et al., 2026; Xu et al., 2026a)。例如,Adafactor(Shazeer and Stern, 2018)以不同方式执行行与列归一化,而 Adam-mini(Zhang et al., 2025a)对嵌入表与预测头使用另一种行归一化。这些归一化策略在优化性能与通信开销方面可能不同。我们将更详细的研究留作未来方向。
3. 通用基础设施
3.1. 训练基础设施
3.1.1. 多模态训练基础设施
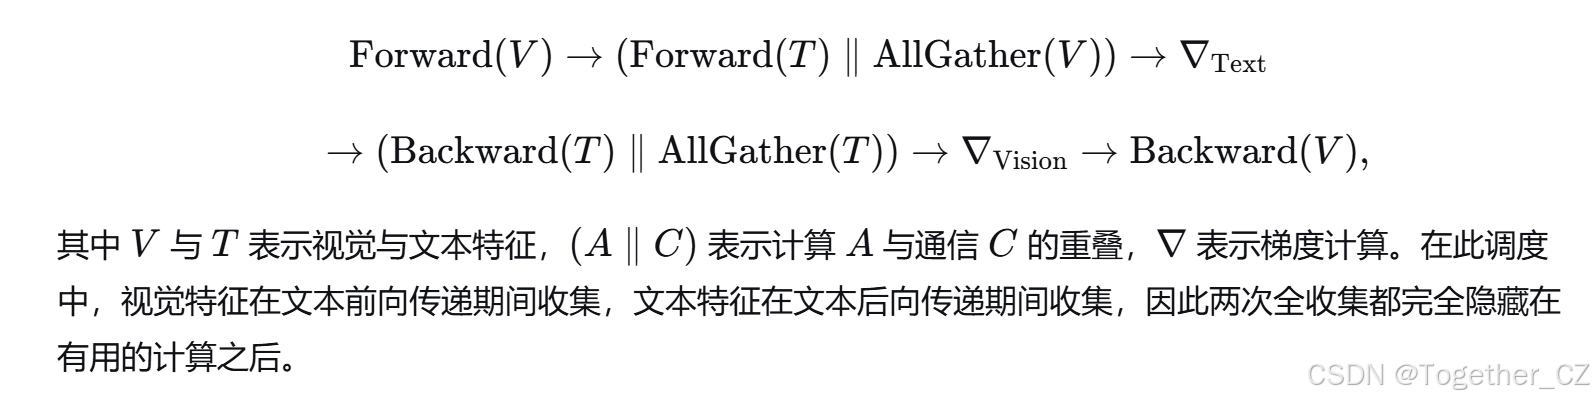
对比学习中的通信-计算重叠。 视觉编码器首先使用对比目标进行优化,然后使用生成式下一 token 预测损失进行微调。在对比阶段,损失在整个文本-视觉对批次上计算,因此两种模态的特征必须在数据并行 rank 间全收集(all-gather),产生大量通信。由于文本特征的梯度仅依赖于收集到的视觉特征------对称地,视觉特征的梯度仅依赖于收集到的文本特征------每次全收集可以与前向或后向传递重叠,而不是阻塞流水线:
端到端并行。 为处理视觉编码器与 LLM 之间的模型与数据异质性(Zhang et al., 2025b),我们采用近期训练系统中使用的分离式编码器设计(Team et al., 2025, 2026b)。视觉编码器复制在 LLM 参数树之外,每个训练步骤分为三个阶段:视觉编码器前向、LLM 前向/后向、视觉编码器后向。这种分离防止视觉编码器与 LLM 计算之间的干扰。负载均衡的视觉处理仅限于第一阶段与最后阶段,而 LLM 阶段保持无视觉计算,并保留纯文本训练的并行策略。
长序列多模态训练优化。 DeepSeek-V4.1-Flash 在高达一百万 token 的序列上训练,预训练与后训练阶段都有相当大比例的 ultra-long 序列长度训练。在这些序列长度下,多模态样本造成沉重的 I/O、CPU 与内存瓶颈。
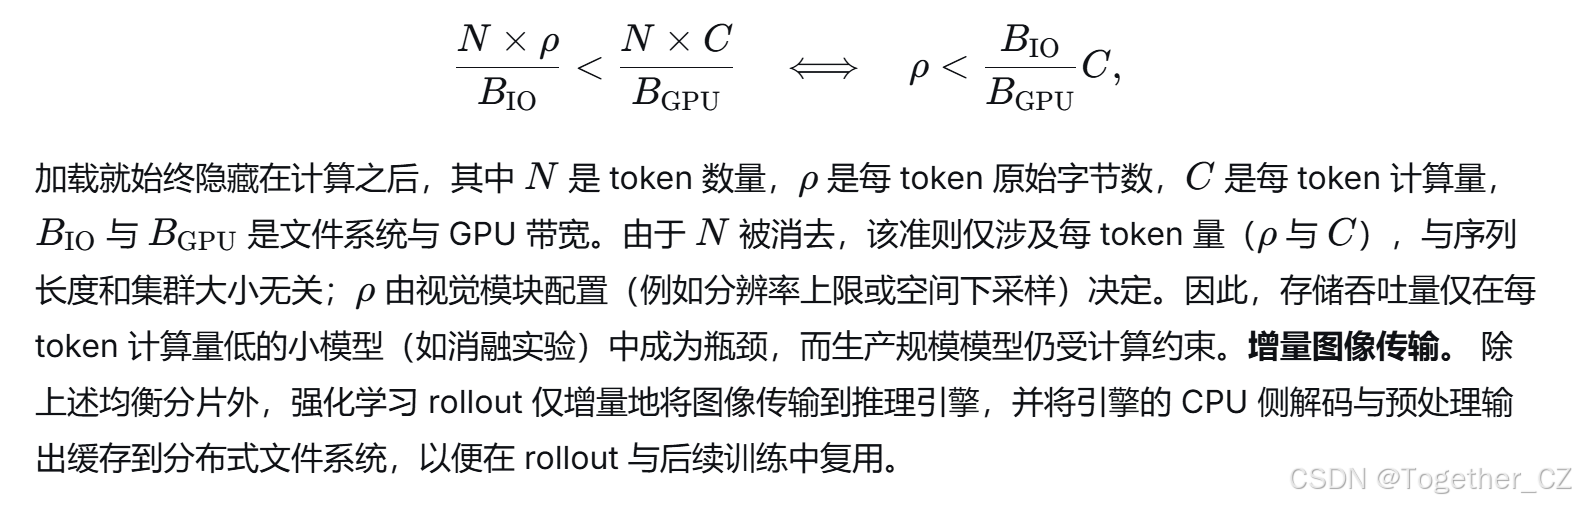
均衡图像分片。 在预训练期间,单个超长、图像密集的序列可能在加载期间耗尽一个主机的 I/O、CPU 与内存,因此每个序列的图像在 CP rank 间进行负载均衡分片,每张图像恰好加载一次。在图像仅读取一次的情况下,只要
3.1.2. CSA2 的注意力共享训练
在第 2.3 节中,我们介绍了 CSA2,一种具有三种模式的注意力共享方法,其中一些模式涉及跨多层共享主 KV、索引器 K 与 Top-K 索引中的一个或多个。在大规模分布式训练中支持 CSA2 需要在注意力计算本身之外进行额外协调。特别是,共享注意力组件的层可能位于不同流水线阶段,使得直接模块复用与传统的阶段局部执行不兼容。因此,我们采用若干设计来支持 CSA2 训练。
影子索引器 通过在每个参与阶段放置轻量可执行副本,同时保留共享参数的单一逻辑所有者来解决此问题。所有者负责优化与检查点,而参数同步与梯度聚合保持影子副本在整个训练过程中一致。该设计保留了原始模型语义,而无需流水线调度器将共享层视为特殊执行单元。
流水线负载扩展 为下游消费者提供所需的中间表示与稀疏路由信息,当源层与消费者层跨越流水线边界时。这些状态被纳入现有点对点通信路径,并与上下文并行一致地分区,避免不必要的复制,同时保持相应的梯度流。
微批次级共享状态管理 跟踪与并发活跃流水线微批次相关的状态,并协调它们在前向执行、激活重计算与反向传播中的生命周期。共享状态保留到其最终消费者完成,然后及时释放以限制额外内存开销。相同的运行时抽象还处理阶段放置与源-消费者关系,允许注意力实现访问共享状态而不依赖于物理流水线布局。
结合对优化器、检查点、预热与计算图追踪工作流的轻量适配,这些机制使 CSA2 能够在现有分布式训练接口与流水线调度下透明运行。
3.1.3. Engram
Engram 嵌入表按行划分到由 engram 并行大小指定的专用进程组。组大小控制每设备内存使用与嵌入查找通信范围之间的权衡。优化器状态进一步分片到每个表分区的副本上。Engram 查找索引仅依赖于输入 token 序列。因此,在每个流水线阶段开始处理当前训练步骤的微批次之前,会为整个本地批次启动嵌入预取,最大限度地减少对流水线执行的干扰。嵌入梯度在反向传播期间缓冲,并在骨干反向传播后返回其所属 rank。为高效集成多模态训练,嵌入预取与梯度传输被调度为与视觉编码器的前向与后向计算重叠。嵌入以 FP8 存储与获取,检索到的值与缩放因子直接传递到后续 GEMM。对于 Engram 表更新,Sinkhorn 归一化在迭代间维护行与列缩放向量,以避免重复写入完整归一化矩阵。行归一化与部分列统计的累积融合到单个内核中,以进一步减少内存流量。在 RL rollout 期间,Engram 嵌入表常驻 GPU 内存。这种放置减少了主机内存压力,并有助于避免主机内存碎片导致的 out-of-memory 失败。
3.2. 推理系统
DeepSeek-V4.1-Flash 的设计将推理效率作为首要关注点。尽管其架构在概念上复杂,但由此产生的推理内核流非常简洁。通过合理的内核融合,我们将复杂操作封装起来,并保持硬件资源在少量融合内核内完全流水线化------包括 FlashMLA(Li and Liu, 2025)中的 fused-RoPE-attention-RoPE-cast 内核、DeepGEMM(Zhao et al., 2025)中的 Mega-Gate、Mega-mHC 与 Mega-MoE 内核、TileKernels(Wang et al., 2026a)中的内核,以及 DeepSelect(Qian et al., 2026)中的 TopK 内核。因此,绝大多数 Transformer 层------即 CSA2 以 Reuse 模式运行的层------在预填充期间仅执行 15 个内核,在解码期间执行 11 个内核,从而实现高吞吐与低延迟推理。
在部署层面,我们采用编码器-预填充-解码(EPD)分离,使视觉编码、预填充与解码能够独立扩展并重叠执行。
3.2.1. 持久化 KV 缓存管理
在相同工作负载下,V4.1 将持久化 KV 缓存占用降至 V4 的 1/8。两个乘法因子解释了这一缩减:持久化 KV 缓存不再存储 SWA KV,这几乎将其大小减半;并且其中保留的全局 KV 通过架构与精度优化进一步压缩至 V4 占用的 1/4。
在 V4 部署中,SWA KV 占持久化 KV 缓存容量的近一半。在该缓存内,全局 KV 与 SWA KV 独立管理,受 LRU 驱逐策略约束。全局 KV 完整存储,命中时复用完整前缀。相比之下,SWA KV 在两个特定点缓存------提示末尾与输出末尾------以便于重新生成与多轮会话;命中允许从该缓存位置恢复计算。为保持高命中率,我们在 SSD 上配置了足够大的持久化 KV 缓存,使得在典型工作负载下,两种 KV 都能驻留超过 72 小时。尽管仅在指定位置保留 nwin 个 KV 条目,未压缩的 SWA KV 缓存仍产生大量存储开销,尤其是在短轮次的多轮对话中。
持久化存储 SWA KV 既昂贵又低效,因为其访问模式与持久化 KV 缓存的长保留策略不匹配。与具有长尾复用的全局 KV 不同,SWA KV 仅在活动会话内狭窄的分钟级窗口内被复用,一旦会话结束或下一轮开始就变为死数据。V4 技术报告提出了 Zero SWA Caching,通过重计算缺失的 SWA KV 来避免存储开销。然而,精确恢复需要对 L×nwin 个 token 进行完整前向传递,其成本在生产部署中被证明过高。
因此,V4.1 修订持久化 KV 缓存管理如下:
-
SWA KV 不再缓存在持久化 KV 缓存中,而是存储在从每台机器 10% 主机 DRAM 分配的分布式内存池中。尽管该池的总容量远小,但其短 TTL(仅分钟级)允许过期条目立即回收用于新会话;在真实工作负载下,这种高周转足以服务绝大多数并发活动会话。全局 KV 仍保留在持久化 KV 缓存中,保证生命周期至少 72 小时。
-
驱逐 SWA KV 不可避免地导致未命中,这得益于轻量回退 Encoder SWA Bounded Replay(详见第 3.2.2 节)而保持可负担。对于命中全局 KV 但未命中 SWA KV 的不可避免但罕见的请求,它仅通过重计算 nwin 个 token 而非完整的 L×nwin token 前向传递来恢复缺失状态。这种有界重放是设计的基石:它将灾难性未命中转变为优雅、廉价的降级,从而证明从持久化 KV 缓存中移除 SWA KV 是合理的。
3.2.2. SWA 有界重放
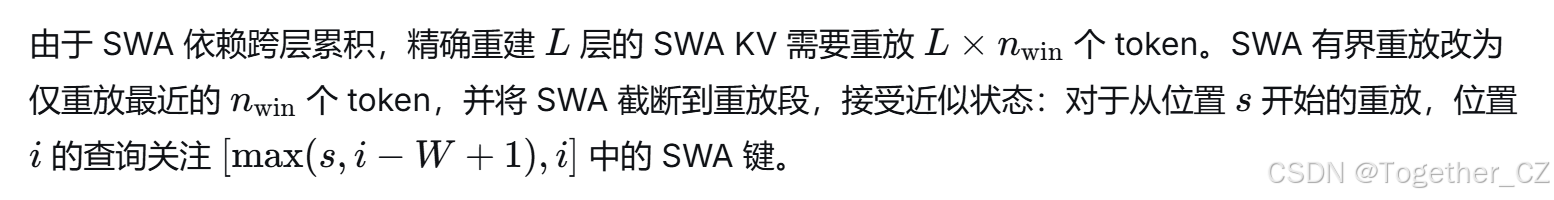
编码器 SWA 有界重放。 编码器 SWA 有界重放使前缀缓存仅依赖于全局 KV,允许从持久化 KV 缓存中移除 SWA KV。
当编码器 SWA KV 缺失时,我们重放缓存前缀的最后 nwin 个 token,并将它们与未缓存后缀一起处理。重放的 token 仅重新生成 SWA KV,复用缓存的全局 KV 而不重计算或覆盖,而未缓存后缀生成全局 KV 与 SWA KV。
按设计,重放的前缀状态是近似的,因此为未缓存后缀计算的全局 KV 与 SWA KV 依赖于缓存命中位置,在不同位置之间数学上不完全相同。令人鼓舞的是,我们的实验证据证实,这种有界重放策略几乎不损害响应质量。
解码器 SWA 有界重放。 解码器 SWA 有界重放将解码器前向传递限制为 nwin 个 token,几乎将总预填充计算减半。
4. 预训练
4.1. 数据构建
文本数据策展 为追求更高智能,我们超越了小规模数据实验所反映的通用、样本级质量,更关注多样语料之间的整体交互,这些语料提供独特的信息增益。我们采用更系统化、标准化的数据构建流水线,以提高数据质量并优化数据混合。具体而言,基于更全面的评估,精心设计了模型参数与训练数据的缩放阶梯,以指导大规模训练运行。我们过滤掉信息增益有限的模型生成内容,包括来自能力较弱模型的输出与低质量机器翻译文本。我们将此类内容视为隐式重复,因为它 largely 重新表述现有信息,并在长训练周期中可能变得有害。我们还探索了模型在环数据迭代方法,作为未来大规模合成数据的基础。此外,我们引入更多领域专家来构建细粒度数据质量评估维度。与先前版本相比,新语料包含来自新发布开源仓库、提交、库与新兴框架的更新代码,以覆盖更广泛的编程语言,并更好地反映当代真实世界软件工程场景。
多模态数据策展 我们的多模态预训练数据集主要包括三类数据:图像-文本对、交错图像-文本数据与领域特定数据。基于原始网络数据自然提供丰富多模态知识的前提,我们避免大规模数据合成;相反,我们优先以原生形式清理与利用数据,以在预训练期间实现最直接、可扩展的视觉知识压缩。在初始数据收集期间,我们发现爬虫系统过度偏向以文本为中心的网页内容;因此,我们从 Common Crawl 重新引导它,以提高其对多模态来源的覆盖。对于图像-文本数据,我们从网页中提取图像及其关联的 alt 文本,通过应用图像-文本相关性阈值进行过滤,并基于图像语义去重。对于交错数据,我们主要从网页与 PDF 构建该子集。处理大规模多模态语料通常比处理纯文本语料产生更高的 CPU 与磁盘存储成本,这促使我们将交错数据构建组织为逐步更昂贵的阶段。在图像检索之前,我们应用启发式与统计过滤、去重与质量模型来选择高价值文档。存活的文档随后被组装成交错图像-文本序列,其中以图像感知方式再次应用过滤与去重。最后,我们采用 SmolVLM(Marafioti et al., 2025)对图像-文本内容进行严格质量评分,从而提取高质量交错数据。在此过程中被过滤掉的文档部分通过筛选与重组回收为额外的图像-文本对。为弥补网络收集数据的固有局限,我们还纳入领域特定数据集,以提升模型在细粒度视觉感知(如视觉 grounding 与 pointing)、光学字符识别(OCR)以及长尾知识获取方面的能力。我们还收集了大量图像-代码对与计算机使用轨迹,以改进多模态智能体理解。
数据集成与去重 由于我们的纯文本与多模态数据通过不同流水线处理,我们将最终训练语料构建为两个数据源的并集。对于重叠样本,我们用其多模态对应物替换纯文本版本,并使用两种配置中较大的 epoch 数。在此替换后,所得语料使用 7:1 的纯文本与多模态数据 token 比例。我们通过在预训练与上下文扩展期间联合预取与分配训练样本,最大限度地减少样本重叠。超长文档在混合前被确定性地预分割,以确保训练 token 在数据分片与训练步骤之间均匀分布。我们进一步增强了最佳拟合打包算法,实现至多 10−4 的填充率。
4.2. 预训练设置
4.2.1. 模型设置
我们将 Transformer 层数设为 40,隐藏维度 d 设为 5120。我们采用因果编码器-解码器架构,编码器 20 层,解码器 20 层。对于前两层,我们使用纯滑动窗口注意力。其余 18 个编码器层使用压缩率 m=2 的 CSA2。这些层被分为三个配置相同的六层组。在每组中,第一层以 Full 模式运行,其余五层以 Reuse 模式运行。20 个解码器层使用压缩率 m=1 的 CSA2。这些层被分为五个四层组。在第一组中,第一层以 Full 模式运行,其余三层以 Reuse 模式运行。其余四组共享相同配置:第一层以 Reindex 模式运行,其余三层以 Reuse 模式运行。对于所有 CSA2 层,我们将索引器查询头数设为 32,索引器头维度设为 128,稀疏注意力选择的 KV 条目数(即注意力 top-k)设为 512。我们将查询头数设为 64,头维度设为 512,查询压缩维度设为 1280。对于分层稀疏索引器,我们最多选择 2,048 个块,每个块 8 个位置,总共产生多达 16,384 个候选位置。输出投影组数设为 8,每个中间注意力输出的维度设为 1024。对于滑动窗口注意力的额外分支,窗口大小 nwin 设为 128。我们在所有 Transformer 块中使用 MoE 层,使用带钳制的 SwiGLU 激活函数(OpenAI, 2025),阈值为 10。每个 MoE 层由 1 个共享专家与 384 个路由专家组成,每个专家的中间隐藏维度为 2304。在路由专家中,每个 token 激活 6 个专家。对于 mHC,扩展因子设为 4,Sinkhorn-Knopp 迭代次数设为 20。对于视觉编码器,我们将层数设为 32,隐藏维度设为 1024,注意力头数设为 16,图像 patch 大小设为 14。视觉 MLP 投影器有 2 层,隐藏维度为 5120。在此配置下,DeepSeek-V4.1-Flash 包含 552B 骨干参数,预填充阶段每 token 激活 8B,解码阶段激活 16B。
4.2.2. 训练设置
视觉编码器训练。 我们的 DeepSeek-ViT 在与语言骨干集成之前经历单独的训练阶段。训练流水线包括两个阶段:对比预训练与自回归微调。在对比预训练期间,我们使用 SigLIP(Zhai et al., 2023)引入的 sigmoid 对比损失,在约 47B 图像-文本对上优化模型,这些数据来自 alt 文本数据。为从如此大规模数据集中高效学习视觉表示,我们将最大输入分辨率限制为 224×224 像素,同时保持宽高比缩放较大图像。尽管在此阶段使用更高分辨率带来显著增益,但经验结果表明这些收益对最终模型贡献不大。由于后续自回归阶段专门处理高分辨率外推,在对比预训练期间扩大分辨率会显著增加计算开销,而整体改进不大。在自回归微调阶段,我们将视觉编码器连接到 4B MoE LLM,并在包括图像描述、alt 文本、图表与 OCR 在内的 236B token 上使用下一 token 预测目标训练。此阶段旨在增强编码器建模细粒度视觉特征的能力。因此,我们通过按比例缩放越界图像,将输入分辨率限制在 544×544 到 1344×1344 像素之间。此阶段后,我们丢弃 LLM,仅保留优化后的视觉编码器用于后续预训练流水线,其中保持相同的输入分辨率策略。
4.3. 评估
4.3.1. 评估基准
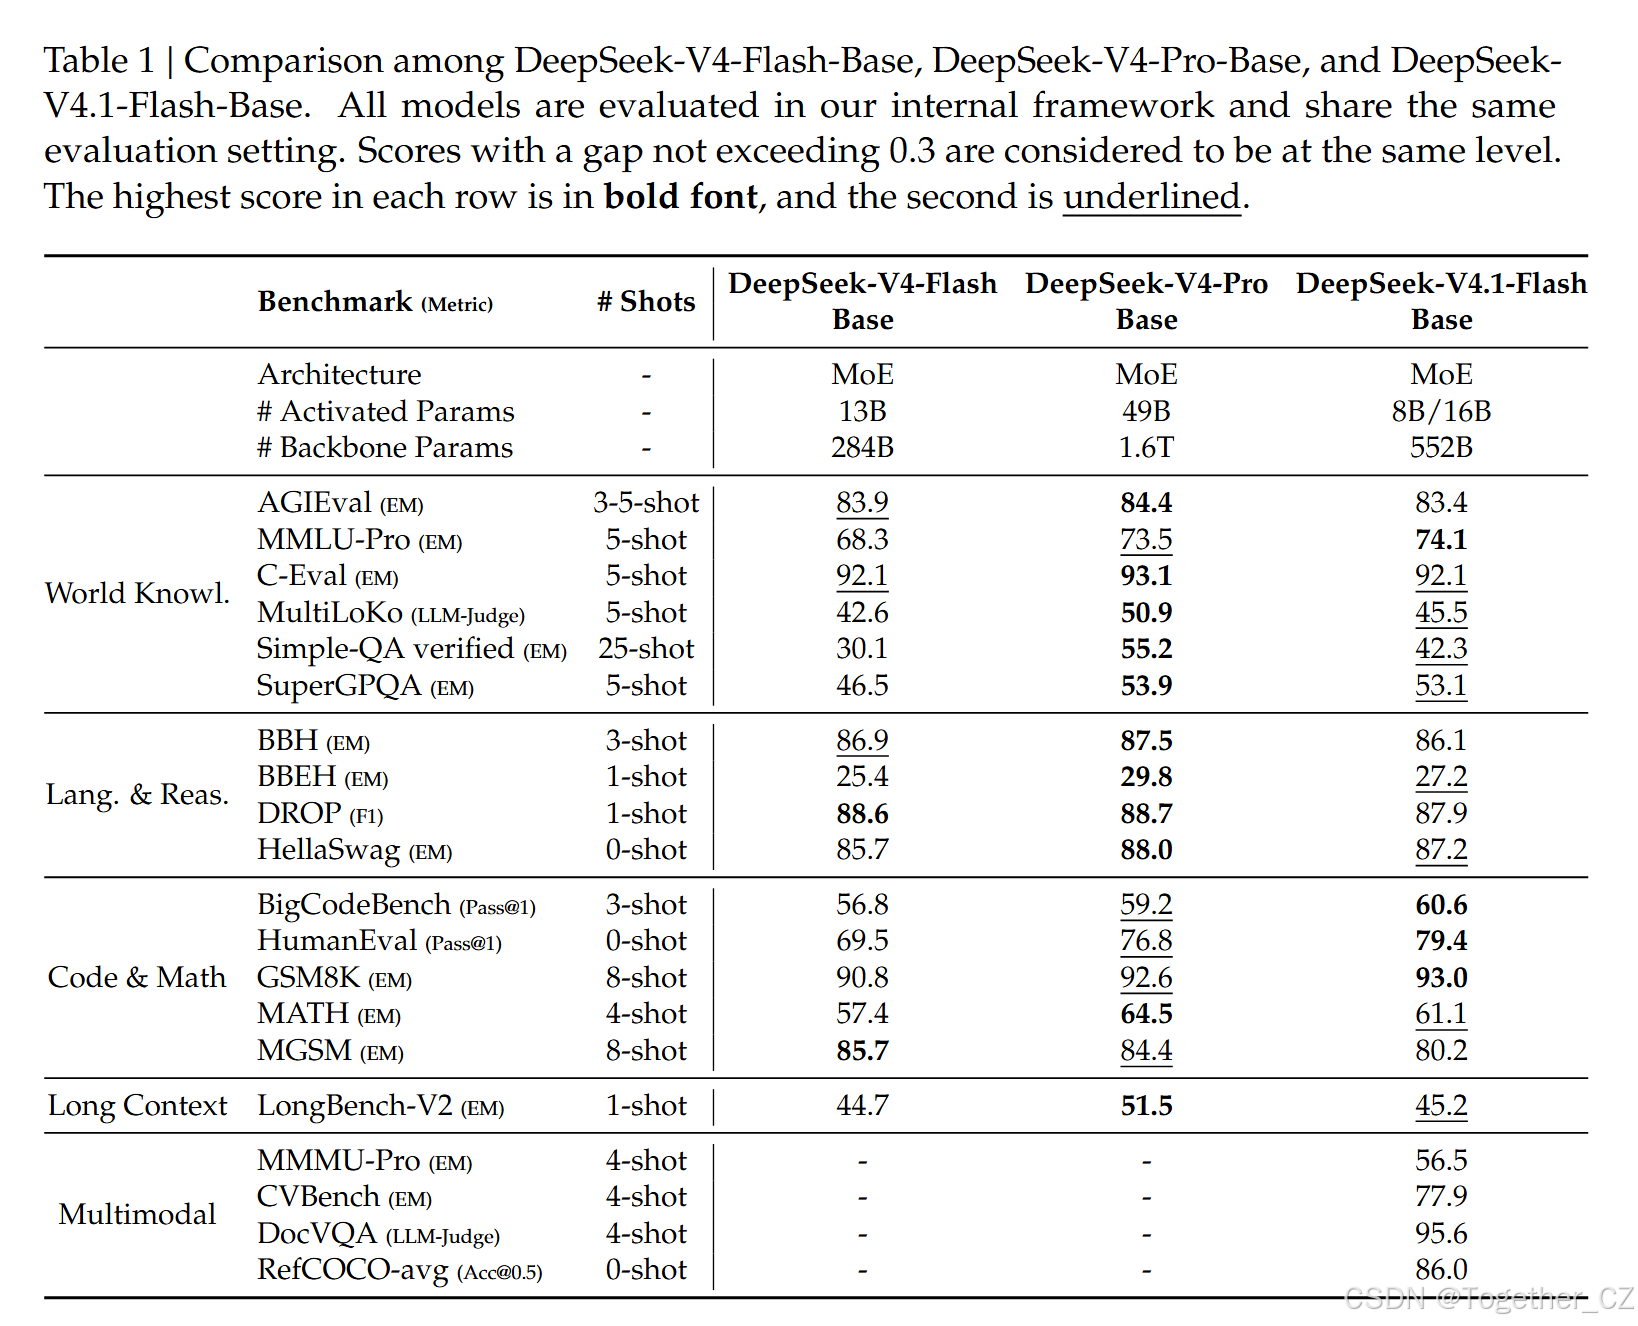
我们将 DeepSeek-V4.1-Flash-Base 与其前代模型 DeepSeek-V4-Flash-Base 和 DeepSeek-V4-Pro-Base 进行比较。我们报告涵盖五个关键维度的基准:世界知识、语言理解与推理、编码与数学、长上下文与多模态能力。
世界知识基准包括 AGIEval(Zhong et al., 2023)、MMLU-Pro(Wang et al., 2024b)、C-Eval(Huang et al., 2023)、MultiLoKo(Hupkes and Bogoychev, 2025)、SimpleQA-Verified(Haas et al., 2025)与 SuperGPQA(Du et al., 2025)。
语言理解与推理基准包括 BigBench Hard (BBH)(Suzgun et al., 2022)、BigBench Extra Hard (BBEH)(Kazemi et al., 2025)、DROP(Dua et al., 2019)与 HellaSwag(Zellers et al., 2019)。
编码与数学基准包括 BigCodeBench(Zhuo et al., 2025)、HumanEval(Chen et al., 2021)、GSM8K(Cobbe et al., 2021)、MATH(Hendrycks et al., 2021)与 MGSM(Shi et al., 2023)。
长上下文基准包括 LongBench-V2(Bai et al., 2025)。
多模态基准包括 MMMU-Pro(Yue et al., 2025)、DocVQA(Mathew et al., 2021)、CVBench(Tong et al., 2024)与 RefCOCO/RefCOCO+/RefCOCO-g(Kazemzadeh et al., 2014; Nagaraja et al., 2016; Mao et al., 2016; Yu et al., 2016)。
4.3.2. 评估结果
在表 1 中,我们提供了 DeepSeek-V4-Flash、DeepSeek-V4-Pro 与 DeepSeek-V4.1-Flash 基础模型的详细比较,所有模型均在我们内部评估框架下使用严格受控且可复现的设置进行评估。与 DeepSeek-V4-Flash-Base 和 DeepSeek-V4-Pro-Base 相比,我们的最新基础模型显示出令人信服的效率提升。DeepSeek-V4.1-Flash 激活的参数数量远少于 DeepSeek-V4-Pro-Base,并占据大幅缩减的 KV 缓存,但其性能完全与前代相当。这些结果也反映了我们对预训练数据策展流水线所做的重大改进。在此版本中,我们引入原生多模态训练,并通过相应的多模态评估验证其有效性。在更多样化、多模态的语料上训练,DeepSeek-V4.1-Flash 达到了与 DeepSeek-V4-Pro 相当的世界知识与理解能力。在推理与编码基准上,DeepSeek-V4.1-Flash 显示出持续进步,在多个基准上达到接近或优于 DeepSeek-V4-Pro 的性能。
为进一步评估模型在真实世界研发场景中的能力,我们还对专用内部语料进行困惑度测试。由于困惑度测试无法通过模型 API 进行,我们主要关注自己预训练的基础模型。对于语料选择,我们基于日常开发收集单独的评估集,包括内部文档、专有代码仓库与学术材料,目标是对复杂科学问题与前沿研究的推理、归因与问题解决。结果如图 6 所示,我们报告不同模型的 bits-per-byte(BPB),值越低表示性能越好。
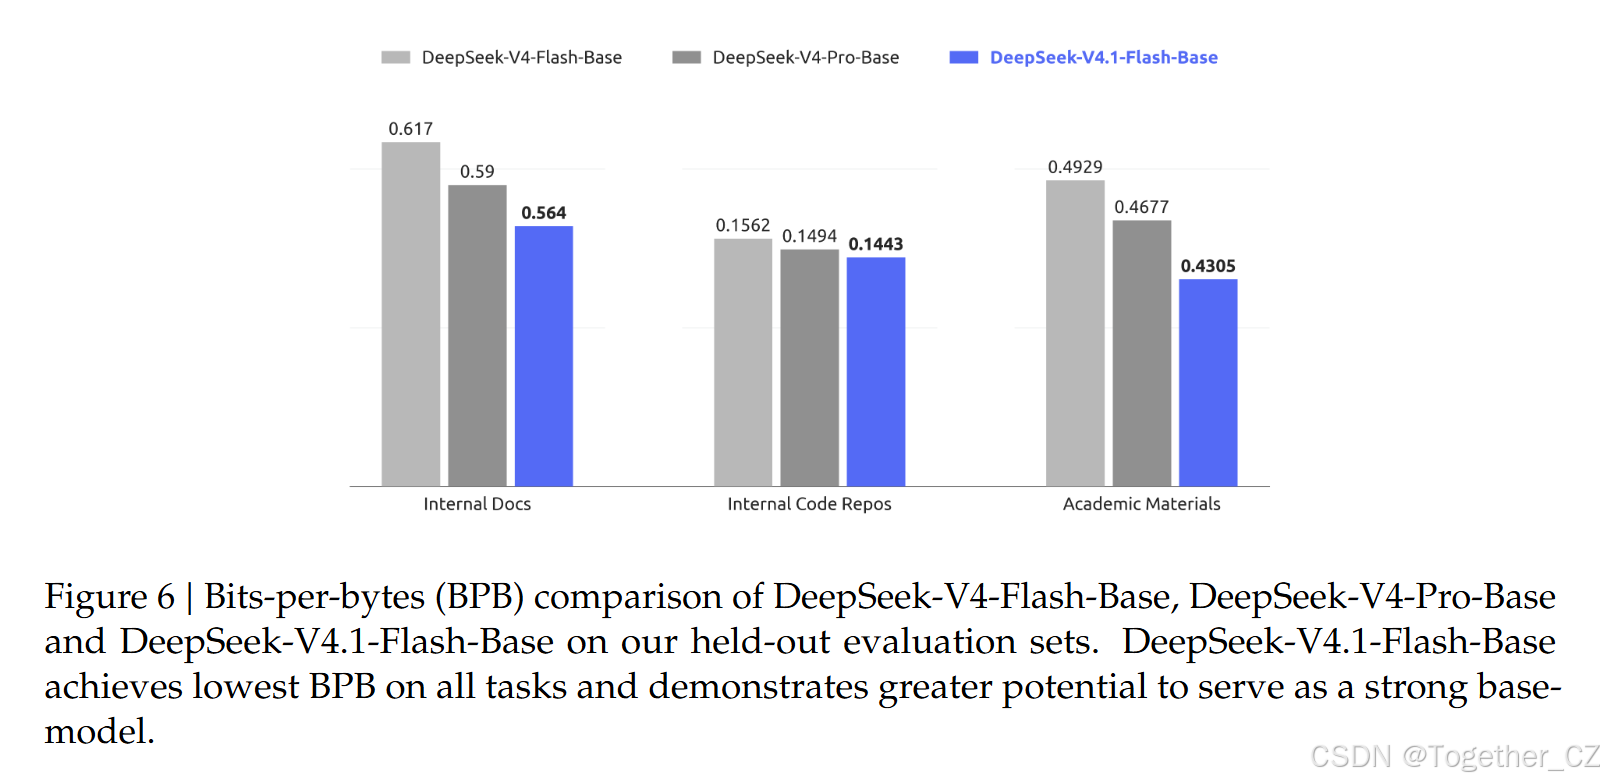
图 6 | DeepSeek-V4-Flash-Base、DeepSeek-V4-Pro-Base 与 DeepSeek-V4.1-Flash-Base 在我们留出评估集上的 Bits-per-bytes(BPB)比较。DeepSeek-V4.1-Flash-Base 在所有任务上取得最低 BPB,并展现出作为强基础模型的更大潜力。
5. 后训练
5.1. 后训练流程
在此版本中,我们避免引入新颖的后训练算法。整体配方遵循监督微调(SFT)后接强化学习(RL)与同策略蒸馏(OPD;Gu et al., 2024; Lu and Lab, 2025)的标准范式,除成熟实践外没有算法修改。相反,我们的努力几乎完全集中在模型训练的内容而非优化方式上:我们投资于大规模、自动化的数据合成与环境构建流水线。具体而言,该流水线 (i) 合成多样化、可验证的训练任务及其参考解决方案与奖励信号,(ii) 程序化构建并扩展交互式智能体环境,在其中可以低成本收集与评估轨迹,以及 (iii) 应用严格的过滤、去重与难度校准,以确保数据质量与课程平衡。我们发现,在固定且普通的优化过程下,合成数据与环境的规模、多样性与可验证性的系统性改进几乎解释了所有观察到的增益。这一观察呼应了更广泛的教训:在当前阶段,工程化数据与环境流水线的边际回报大大超过后训练中算法新颖性的回报。
5.1.1. 大规模智能体任务合成
任务是智能体学习的基本燃料。然而,构建高质量训练任务传统上需要大量人工努力。我们观察到,模型已经开始展现出构建自己训练任务的能力,尽管这种能力仍远非完美。认识到这一潜力,我们投入了大量精力来增强模型的任务构建与质量验证能力。
我们将每个任务形式化为三元组(问题、环境、验证系统),并沿两个维度评估其质量:难度------确保任务非平凡------与正确性------保证三个组件中不存在关键缺陷。使用难度与正确性作为奖励信号,我们迭代训练模型构建更好的任务。我们还监控 RL 任务的全生命周期。每当任务在新的 RL 运行中使用时,产生的轨迹为质量重新审计提供新证据。在此通用框架下,我们为两个核心场景构建了专用训练环境生产流水线:通用智能体与编码智能体。
通用智能体。 对于通用智能体,我们鼓励内部员工与外部合作伙伴将我们的最新模型纳入其日常工作流,并在自愿基础上返回交互数据与反馈。基于返回数据中观察到的接口,我们构建大量模拟工具,重现真实世界工具与系统的接口与行为,包括其输入格式、输出结构、API schema 与行为约束,覆盖常用 SaaS 与企业应用以及更专业的业务后端系统。同时,我们大规模收集内部员工提交的负面反馈与模型失败案例,并将其纳入流水线,以生成基于真实工作流的单轮与多轮智能体环境。通过重建相关工具上下文、用户交互模式与失败条件,该流水线能够系统重放失败,并针对观察到的模型弱点进行定向强化学习。
编码智能体。 编码智能体训练环境来自两个来源:1)来自内部员工与外部合作伙伴的编码智能体会话,过滤以保留高度复杂或模型表现不佳的任务,然后按轨迹去重;2)满足 star 数阈值的公共 GitHub 仓库。环境构建由多个专门智能体协作完成。首先,一个智能体确定项目是否可以在容器内构建并完整运行,以及是否可以自动验证;如果是,它选择特定轮次或提交作为任务起点,设计若干足够复杂的实现方向,并产生具体评估点,包括 fail-to-pass 与 pass-to-pass 点,以及构建报告,根据需要从网络获取外部资源。接下来,一个单独的智能体在隔离容器中设置依赖、初始工作目录、测试代码与任务描述,执行自测,移除任何可能泄露任务解决方案的痕迹,并将环境打包为新的镜像层。然后,多个不同的智能体尝试该任务,一个独立的质量检查智能体审查环境以及解决智能体的轨迹,检查环境问题、事实错误、评估点与任务描述之间的不匹配以及可黑客性风险。如果检查未通过,修复智能体修复所有已识别错误,调整过于容易或过于困难的评估点,任务重新进入验证。
通过这些流水线,我们可以自动、批量地生产正确、有区分度且长度与难度可控的 RL 训练数据。无论是通过忠实重建通用智能体环境中的真实工作流,还是精确构建编码智能体环境中的编码任务,两者最终都汇入统一的训练系统,在持续质量监控下驱动模型能力的迭代改进。
5.1.2. 合成任务中的强化学习
我们使用合成任务中的大规模异步 RL 来提高模型性能并塑造其在复杂场景中的行为。我们从两个维度扩展 RL 运行,即训练计算与脚手架数量。如图 7 与图 8 所示,随着我们增加计算与累积 RL 步骤,性能持续改进,无论是在单个脚手架内扩展、在同一脚手架的变体间联合扩展,还是在异构脚手架间扩展。
对于跨多样脚手架的 RL 训练,我们将智能体 rollout 执行解耦为智能体沙箱与工作容器。沙箱运行脚手架及其工具,而工作容器提供与脚手架无关的控制层,编排 rollout、将异构交互归一化为通用轨迹 schema,并与训练器通信。两者都运行在 DSec(第 5.1.3 节)上,位于可抢占 GPU 训练池之外,将长寿命 rollout 与细粒度训练调度分离。在训练器抢占期间,rollout 执行可以暂停并卸载,同时保留其完整状态以供稍后恢复,并释放 CPU 与 GPU 资源。该设计支持跨异构脚手架的稳定高效 RL,而无需修改底层算法。
为将有效 RL 计算扩展到单次训练运行之外,我们使用模型合并来重新初始化后续 RL 运行。具体而言,我们合并来自不同脚手架或配置的运行的检查点,结合沿不同优化路径获得的改进。在图 7 与图 8 中,不连续的曲线段反映了模型重新初始化后的连续 RL 运行。这在任务性能与 token 效率方面都产生进一步增益,提供了一种简单实用的方法来聚合并行 RL 计算并在连续运行间继续扩展。
5.1.3. 大规模运行智能体:DSec
当我们从 DeepSeek-V3 过渡到 V4 时,智能体训练环境数量与多样性的快速增长促使我们构建 DeepSeek Elastic Compute(DSec),一个用于大规模智能体训练与评估的生产级沙箱平台。其初始设计解决了异构执行环境、可扩展镜像分发、多种隔离后端、高密度资源管理、命令轨迹日志记录与抢占安全恢复。
V4.1 训练进一步将需求增加到数百万并发沙箱实例,跨越多样 harness、平台、代码仓库、软件依赖与任务特定服务。在这种规模下,主要瓶颈转向数据中心可扩展性、工作负载隔离、每节点计算密度以及日益强大的智能体不当行为的遏制。我们简要描述关键设计方面如下。
大规模水平扩展计算。 DSec 通过两种互补机制扩展:分片与松弛一致性调度。为容纳大量机器,我们将计算节点划分为多个分片(所谓 scale unit)。这种分片还允许我们通过隔离不同实验的工作负载来减少爆炸半径,防止单个内存密集型任务耗尽无关工作共享的资源。
DSec 不使用 Kubernetes 等现成编排器,而是采用自定义放置引擎来调度大量沙箱,通过牺牲强全局一致性换取可扩展性。该设计基于一个关键观察:只要每个计算节点执行本地安全约束,智能体沙箱放置仅要求最终一致性。为此,放置引擎部署多个独立副本,无需同步协调。每个副本根据最近测量预测资源可用性,并做出足够好的放置决策。为补偿一致性损失,每个节点负责验证最终放置决策,执行硬准入约束,如果超过本地警告阈值则拒绝新放置。整体而言,该设计使 DSec 能够扩展到数百万容器,而不会在中央协调上出现瓶颈。
高密度运行沙箱。 在节点级别,我们使用硬件支持的 subNUMA 分区,并将每个工作 VM 绑定到单独的 NUMA 域。容器在这些工作 VM 内运行,其 CPU 与内存分配限制在 VM 的本地 NUMA 资源内。这种设置平衡了激进的内存超配与 Linux 内核锁争用,同时本地化内存压力与运行时故障。在可比工作负载配置下,它将支持的密度从每物理节点约 1,000 个并发活动容器提高到超过 2,500 个,之后才出现可测量的端到端性能下降。
然而,这种高密度部署可能通过后台工作负载的干扰扭曲时间敏感评估。因此,DSec 引入了延迟敏感(LS)执行类。我们对非 LS 任务应用 SCHED_IDLE 以最小化其调度优先级,并使用核心调度确保只有相同优先级类的任务同时在兄弟超线程上执行,以消除干扰。
缓解不当行为智能体。 在 RL 训练期间,我们频繁观察到智能体尝试进行奖励黑客攻击或无意中使环境崩溃。在某些尝试中,我们的智能体利用了最近披露的漏洞,包括 XFS 驱动的权限问题、AppArmor 中的非法内存访问、从包镜像服务泄露答案等。智能体还因删除关键二进制文件、破坏系统文件甚至移除文件系统而臭名昭著。我们使用每沙箱 AppArmor 配置文件与基于 eBPF 的细粒度网络策略来防止此类尝试。如果智能体使其环境崩溃,我们将崩溃视为失败轨迹,并向 RL 框架报告"反冲"信号。
5.1.4. 强化学习中的可控推理努力
除模型架构与硬件的进步外,输出 token 数量是服务成本的关键决定因素,因此也是真实世界应用中成本-质量权衡的关键。因此,我们在强化学习期间引入标量努力水平 b 作为显式条件信号。该机制应用于单轮推理与多轮智能体任务。具体而言,我们在系统提示前添加以下指令:
Reasoning Effort: {effort} (range 1-100; higher values request more thorough reasoning)
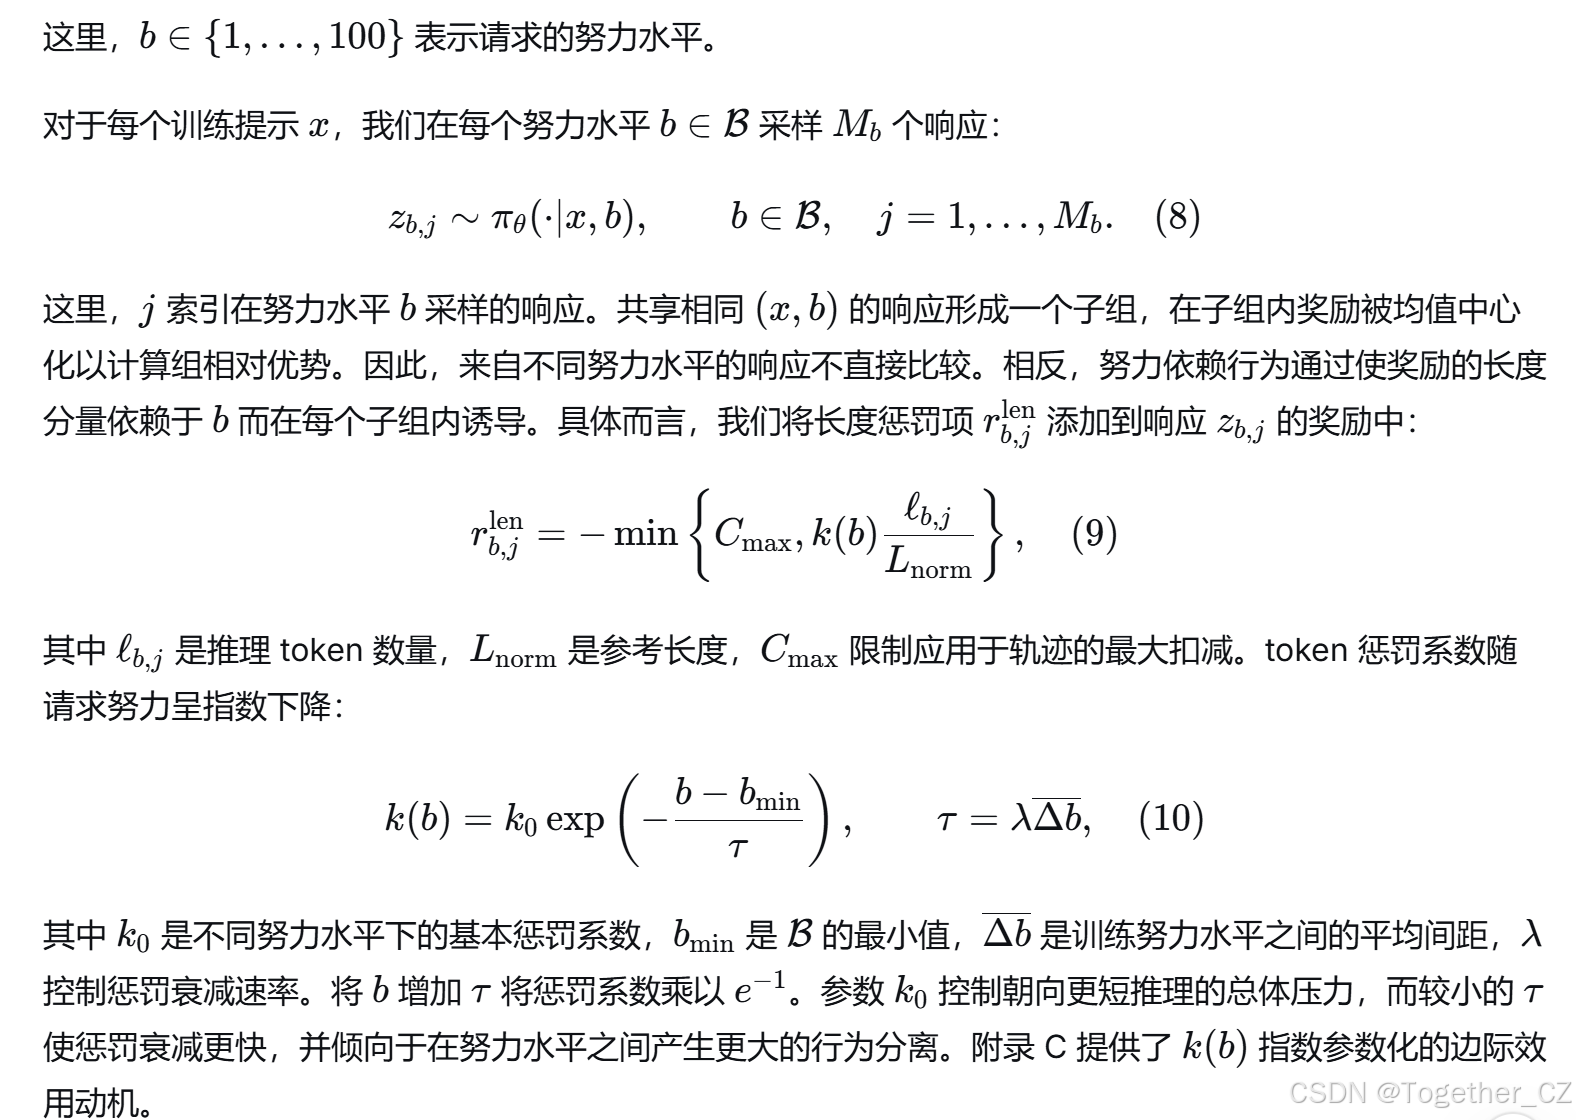
在部署时,标量 b 提供了对模型推理强度的灵活控制接口。通过改变 b,单个模型检查点可以在学习到的成本-质量前沿上不同操作区间之间移动,适应不同延迟、token 预算与解决方案质量要求。尽管训练仅使用有限努力水平集,中间值可以在部署时用于引发插值推理行为,提供细粒度且高效的测试时资源分配机制。
在我们于 2026 年 9 月启动的生产部署中,公共 API 暴露三个预设推理努力层级------max、high 与 low------直接映射到该标量接口。如表 2 总结,三个层级分别对应努力值 b=100、b=75 与 b=50,因此 API 用户可以在不改变模型权重或解码配置的情况下,在学习到的成本-质量前沿上选择操作点。
表 2 | 公共 API 推理努力层级与底层标量努力值 bb 的映射
| API tier | Effort value b |
|---|---|
| max | 100 |
| high | 75 |
| low | 50 |
5.2. 异步后训练基础设施
LLM 强化学习 rollout 阶段的长尾问题一直是训练效率的主要瓶颈。为解决此问题,我们扩展后训练基础设施以允许异步生成样本(Zeng et al., 2026; Team et al., 2026b),通过保持足够高的并发水平显著缓解 rollout 阶段的长尾问题。异步训练现在几乎在我们所有 RL 与 OPD 任务中启用,rollout 效率大幅提升。
5.2.1. 整体工作流程
我们将 rollout 与训练共置于相同物理设备上并时间共享其执行,消除了手动调整两阶段之间资源分配的需要。每个任务指定在途样本数量的上限,系统在 rollout 阶段全程保持此上限。
我们评估了维持目标 rollout 并发的三种调度粒度。我们最终的方法是样本级调度:一旦新完成样本数量达到分配给下一提示的 GRPO 组大小,我们就调度该提示,无论这些完成来自哪些组。这有助于在整个训练过程中保持稳定的 rollout 并发。在确定此调度策略之前,我们尝试了两种替代调度粒度。在第一次尝试中,我们在开始时调度几个额外批次,并在每次训练迭代后补充一个完整批次;然而,这导致训练指标严重振荡,表明批次级粒度太粗。在第二次尝试中,我们切换到提示级调度,即在一个 GRPO 组完成后调度新提示,但发现它容易在 GRPO 组内的长尾样本上停滞,难以平稳维持目标 rollout 并发。
一旦积累足够训练样本,训练会抢占正在进行的 rollout。在训练期间,我们使用拼接路由重放:对于跨越多个检查点的样本,我们拼接每个 rollout 段产生的专家路由,而不是用新检查点丢弃并重计算路由信息。
5.2.2. 缓解长度偏差与离策略效应
异步生成虽然有效提高 rollout 效率,但引入两个可能降低训练质量的副作用。首先,它产生长度分布偏差,尤其是在训练早期,因为较短序列倾向于先完成,从而主导初始训练批次。其次,它不可避免地产生离策略样本,即其 token 部分或全部由较早检查点生成的样本。这两个问题需要不同的处理策略。
为解决长度偏差,我们采用两种机制。首先,调度器可以限制每个数据集的并发,这有助于调节稳态训练批次中每个数据集的比例,通过控制传入样本来源间接缓解长度偏斜。其次,我们支持丢弃早期返回的短样本,以平滑过渡到稳态长度分布,并防止模型过度拟合过短序列。
对于离策略问题,我们实现两种额外机制。首先,通过调整控制样本调度与训练样本等待条件的逻辑,我们可以限制最大离策略比率,确保训练数据不会过度偏离当前模型。其次,在训练期间,我们添加损失掩码方案,消除过度陈旧 token 的贡献,从而减轻陈旧样本对梯度更新的不利影响。
5.2.3. 性能优化
在我们的异步 RL 框架中,rollout 阶段定期中断以切换到更新的策略检查点。我们的目标是使此过程无缝:中断应近乎瞬时,被中断的 rollout 应像从未停止一样恢复。
为及时停止 rollout,我们支持 token 级中断:生成可以在任意 token 边界停止。一旦收集足够训练数据,所有在途样本几乎立即停止,允许系统毫不延迟地进入训练阶段。
为在检查点切换间保留 rollout 进度,rollout 状态(如 KV 缓存与专家路由)在生成期间以 token 粒度持久化。使用新检查点恢复时,持久化状态直接复用,消除重新预填充成本,并允许被中断样本从中断处精确继续。由于这需要保留所有在途样本的状态,我们执行样本级垃圾回收,每个样本完成后立即释放其状态。
除检查点切换外,相同的快速中断与无缝恢复机制允许训练作业及时响应集群调度抢占信号而不丢失进度,从而提高整体集群利用率。
5.2.4. 大规模同策略蒸馏
作为后训练的最后一个阶段,最终全词汇 OPD 任务在所有领域的数据集上使用超过 40 个教师模型进行训练。它也采用异步生成以提高 rollout 效率。由于各领域训练程序不同,每个领域的最佳教师可能来自模型开发的不同阶段。此外,教师模型之间以及与学生模型之间可能在架构上不同。我们的后训练基础设施轻松适应这种设置,支持具有有效无界数量的架构异构教师的全词汇 OPD,并以可忽略成本在它们之间高效切换(DeepSeek-AI, 2026b)。
OPD 阶段还需要训练期间的动态重配置。我们持续跟踪模型能力,并可能相应调整训练配方,包括数据集混合、每数据集并发限制与活跃教师。此类更改在同步训练中很直接,其中 rollout 批次提供显式配置边界。然而,在异步设置中,不同配置下生成的样本可能同时在途。我们的基础设施支持配置之间的一致转换,而不中断 rollout 或训练。
5.3. 评估
5.3.1. 评估设置
我们的后训练评估主要关注推理与智能体能力,而知识密集型性能主要由预训练决定,并在表 1 中报告。对于推理,我们在 GPQA Diamond(Rein et al., 2023)、Humanity's Last Exam(Phan et al., 2025)、Codeforces(内部基准)与 MathArena Apex(Dekoninck et al., 2025)上评估,使用温度与 top-pp 为 1.0。对于智能体能力,我们评估四个类别:
-
编码智能体: Terminal-Bench 2.1(Merrill et al., 2026)、Terminal-Bench 3.0(Marten et al., 2026b)、Terminal-Bench 4.0(Marten et al., 2026a)、DeepSWE v1.1(DataCurve, 2026)、ProgramBench(Yang et al., 2026)、NL2Repo-Bench(Ding et al., 2025)。
-
网络安全: SEC-Bench Pro version 260505(Lee et al., 2026)、CyberGym(Wang et al., 2026c)与 ExploitGym(Wang et al., 2026b)。
-
通用智能体: AutomationBench v1.0.6 公共评估集(Shepard and Salimans, 2026)、Agents' Last Exam(Sun et al., 2026a)(ALE-CLI)。
-
视觉智能体: Chartography(Garre et al., 2026)、BabyVision(Chen et al., 2026)、ZeroBench 主集(Roberts et al., 2025)。
对于编码智能体,我们使用 DeepSeek Harness 的 Minimal 模式评估 DeepSeek-V4.1-Flash,具有 1M token 上下文窗口,温度设为 1.0,top-p 设为 0.95。为符合官方设置要求,我们对 DeepSWE v1.1 使用 mini-SWE harness。对于 SEC-Bench Pro,我们专门使用 Claude Code harness 及其会话压缩设计。对于视觉智能体任务,我们使用 Claude Code harness 评估,具有 512k token 上下文窗口,温度设为 1.0,top-p 设为 0.95。Agents' Last Exam 与 AutomationBench 使用其官方脚手架评估。其他编码脚手架下的模型性能报告在表 4 中。
为减轻编码智能体评估中的奖励黑客攻击,我们限制互联网访问并从环境中剥离 Git 历史。此外,我们自动清除多样环境中的瞬态构建与包缓存,包括 Go 模块缓存(go/mod)、node modules 依赖产物、编译的 .jar 文件与 Python pvcache 目录。尽管有这些预防措施,我们在测试期间仍观察到利用寻求行为的实例------例如反编译核心 Ubuntu Linux 包以发现 CyberGym 中的漏洞。随着模型能力日益增强,标准评估基础设施(如 Docker 容器与验证脚本)更容易受到模型游戏的影响。我们敦促更广泛的研究社区在设计下一代基准时优先检测与缓解这些行为。
5.3.2. 评估结果
表 3 | DeepSeek-V4.1-Flash 与闭源/开源模型的比较。†† 表示 HLE 的纯文本子集。最佳结果以粗体高亮;次佳结果以下划线标出。
| Benchmark (Metric) | Opus-5 Max | GPT-5.6 Sol Max | K3 Max | GLM-5.3 Max | DS-V4-Pro Max | DS-V4-Flash Max |
|----------------------------------|------------|-----------------|--------|-------------|---------------|-----------------|--------------|
| GPQA Diamond (Pass@1) | 93.4 | 94.1 | 92.9 | 88.1 | 92.4 | 89.9 | 90.9 |
| HLE (Pass@1) | 56.3 | 44.5 | 43.5 | 42.0† | 42.7† | 37.8† | 36.8 (39.1†) |
| Codeforces (Rating) | - | - | - | - | 3348 | 3289 | 3471 |
| MathArena Apex (Pass@1) | - | - | 65.6 | - | 65.3 | 58.6 | 65.6 |
| Terminal-Bench 2.1 (Pass@1) | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 82.7 | 90.6 |
| Terminal-Bench 3.0 (Pass@1) | 43.3 | 34.4 | 17.7 | 28.3 | 11.8 | 7.6 | 30.0 |
| Terminal-Bench 4.0 (Pass@1) | 51.8 | 39.9 | 12.6 | 37.9 | 12.4 | 7.0 | 31.2 |
| DeepSWE v1.1 (Resolved) | 74.0 | 73.0 | 67.5 | 66.9 | 62.7 | 54.4 | 74.2 |
| ProgramBench (Almost@1) | 37.0 | 23.0 | 17.5 | 19.0 | 15.5 | - | 20.3 |
| NL2Repo-Bench (Score) | 75.3 | 56.8 | 58.0 | 58.0 | 61.5 | 54.2 | 65.4 |
| CyberGym (Pass@1) | - | 84.5 | 80.0 | 84.5 | 83.3 | 76.7 | 88.1 |
| SEC-Bench Pro (Pass@1) | - | 74.3 | - | - | 56.4 | 30.9 | 62.8 |
| ExploitGym (Pass@1) | 22.1 | 33.7 | - | 15.0 | 5.4 | 1.8 | 15.3 |
| HLE w/ tools (Pass@1) | 63.6 | - | 59.8 | 62.5 | 60.0 | 51.5 | 63.9 |
| Automation-Bench (Pass@1) | 50.3 | 45.8 | 46.7 | 48.8 | 43.2 | 37.7 | 54.8 |
| Agents' Last Exam (Pass@1) | 28.6 | 26.7 | 27.6 | 28.5 | 25.7 | 25.2 | 31.8 |
| Chartography w/ tools (Pass@1) | 84.0 | 79.9 | 68.1 | - | - | - | 78.9 |
| BabyVision w/ tools (Pass@1) | 94.1 | 88.9 | 85.7 | - | - | - | 89.6 |
| ZeroBench-main w/ tools (Pass@5) | 52.0 | 53.0 | 41.0 | - | - | - | 49.0 |
如表 3 详细所示,DeepSeek-V4.1-Flash 在其前代 DeepSeek-V4-Flash 基础上,在推理与智能体基准上都展现出显著性能升级,同时匹配或超越顶级开源与专有模型。
在核心推理任务中,DeepSeek-V4.1-Flash 达到 Codeforces 评分 3471,超过 DeepSeek-V4-Flash(3289)与 DeepSeek-V4-Pro(3348)。在 MathArena Apex 上,它获得 65.6% Pass@1 准确率,完全匹配表现最佳的开源基线 Kimi-K3(65.6%)与 DeepSeek-V4-Pro(65.3%)。此外,其 GPQA Diamond 分数达到 90.9%,较 DeepSeek-V4-Flash(89.9%)稳步提升。
在智能体任务上性能提升更为显著。值得注意的是,在 DeepSWE v1.1 上,DeepSeek-V4.1-Flash 达到 74.2% 通过率,较 DeepSeek-V4-Flash(54.4%)大幅跃升,并超越领先专有模型包括 Opus-5(74.0%)与 GPT-5.6 Sol(73.0%)。在 Terminal-Bench 2.1 上,它达到 90.6%,优于 Opus-5(89.1%)与 GLM-5.3(88.2%)。同样,在 Automation-Bench(54.8%)与 Agents' Last Exam(31.8%)上,DeepSeek-V4.1-Flash 在开源对手与顶级闭源系统上都建立了领先分数。尽管规模紧凑,DeepSeek-V4.1-Flash 展现出最先进的智能体能力,大幅缩小与前沿闭源模型的差距,同时在开源替代品中建立明显优势。
在网络安全任务上,DeepSeek-V4.1-Flash 在开源模型中建立了新的最先进水平。鉴于这些能力的双重用途性质,我们鼓励社区负责任地应用它们,例如用于防御性安全研究与漏洞修复。在视觉智能体任务领域,DeepSeek-V4.1-Flash 展现出强大能力,特别是在需要视觉推理与复杂专业图表分析的场景中。虽然它优于领先开源模型 Kimi-K3,但我们承认与领先闭源替代品相比仍存在可测量的差距。
除峰值性能外,DeepSeek-V4.1-Flash 暴露了一个推理努力设置,允许用户以可控方式在推理成本与准确率之间权衡。如图 9 所示,准确率与输出长度都随努力水平在推理与智能体基准上稳步增加。将努力从 25 提高到 100,八个推理密集型基准的平均 Pass@1 从 67.1% 提高到 76.3%,DeepSWE v1.1 从 66.0% 提高到 74.2%,Terminal-Bench 2.1 从 82.4% 提高到 90.6%,代价是大约 2.5× 更多输出 token。值得注意的是,在单响应推理上学到的努力控制忠实地迁移到长时程智能体轨迹,在那里它控制跨轮次的总探索与验证量。增益是前置的:60-80 范围已经以不到最大设置一半的 token 预算恢复了大部分准确率,而到努力 100 的最后一步将智能体轨迹延长 1.6−1.8×,仅带来边际改进。因此,最大层级最好保留给最具挑战性的任务,而中等努力水平为日常智能体使用提供了有利的成本-性能平衡。
5.3.3. 不同推理努力下的性能
图 9 报告了一系列预算值下的性能与平均响应长度。随着推理努力增加,模型产生逐渐更长的推理轨迹,准确率在推理密集型基准与软件工程任务上单调提高,最大增益集中在低到中预算范围,超过后收益递减。尽管我们的 RL 仅涉及有限数量的努力水平,使用标量努力实现了特定范围内响应长度的灵活插值控制。这允许从业者沿平滑连续体在质量与延迟和 token 成本之间权衡:延迟敏感应用可以在低努力下运行,准确率适度下降,而困难任务可以调用高努力以恢复模型的完整推理能力。在我们的公共 API 服务中,我们暴露三个预设努力水平映射到该尺度:low、high 与 max 分别对应努力值 50、75 与 100。
5.3.4. 不同智能体脚手架下的性能
在实践中,模型很少在单个固定智能体框架内部署;不同脚手架在其系统提示、工具定义、上下文管理策略与交互协议方面各不相同,过度拟合某一特定 harness 的模型在置于另一 harness 时可能大幅退化。为评估模型对此类变化的鲁棒性,我们的比较涵盖来自六个脚手架家族的八种配置:Claude Code(Anthropic, 2026)、Codex(OpenAI, 2026)、OpenCode(Anomaly, 2026)、Pi(Zecher, 2026)、mini-SWE(Yang et al., 2024)与 DeepSeek Harness(DSH)(DeepSeek-AI, 2026a)的 Minimal、Standard 与 PTC 模式。对于每个脚手架,我们保持模型检查点、解码配置与任务集相同,仅改变周围 harness,包括其原生系统提示、工具 schema 与轮次逻辑。表 4 报告 Max 推理努力(100)下在 DeepSWE v1.1 与 Terminal-Bench v2.1 上的性能。
模型的智能体能力在不同提示与工具接口的脚手架家族间良好迁移,而不是依赖于特定 harness 的约定。其性能在周围交互协议与工具抽象变化时保持稳健,表明其智能体行为不与单一脚手架设计紧密耦合。这种鲁棒性与我们合成训练数据中环境、工具 schema 与交互格式的多样性一致(第 5 节),旨在鼓励跨智能体脚手架的泛化。
表 4 | Max 推理努力下跨智能体脚手架的的性能。
| Benchmark (Metric) | Claude Code | Codex | OpenCode | Pi | mini-SWE | DeepSeek Harness Minimal | Standard | PTC |
|---|---|---|---|---|---|---|---|---|
| DeepSWE v1.1 (Resolved) | 69.8 | 65.6 | 65.5 | 66.2 | 74.2 | 72.6 | ||
| Terminal-Bench v2.1 (Pass@1) | 88.0 | 84.1 | 85.0 | 86.1 | 90.3 | 90.6 |
注:所有脚手架在 DeepSWE v1.1 上使用 N=8N=8 个样本/任务,在 Terminal-Bench v2.1 上使用 N=3。运行使用 Linux 容器、温度 1.0、top-p 0.95、1M token 上下文窗口,两个基准上每个智能体 max_steps =500 模型生成轮次。Terminal-Bench v2.1 在无网络访问下评估。我们评估四个 Claude Code 版本,每个版本结果及其平均值报告在附录表 5 中;此表报告 v2.1.251。更多脚手架特定配置详见附录 B.1。
5.3.5. 多智能体
为探索复杂任务上的多智能体协作,我们使用 DeepSeek Harness 的 Agent Team 模式对 DeepSeek-V4.1-Flash 进行初步实验。
多智能体 Harness。 我们使用 DeepSeek Harness 的 Agent Team 模式,其中领导智能体可以通过 spawn_teammate 默认异步创建命名的、持久的队友。每个队友接收委托任务,并以 fresh 模式(无领导历史)或 fork 模式(领导已完成轮次的一次性快照)启动。所有智能体共享一个仓库检出,使编辑立即可见。
智能体通过持久对等邮箱通信。通过 send_message 发送的消息在下一个步骤边界到达运行中的队友,为空闲队友启动新轮次,或恢复非活跃队友。在每个队友的任务生命周期中,领导使用 list_agents 监控运行时状态,并使用 wait_agent 等待状态、邮箱或共享任务变化。任务所有权、依赖关系与建议写入范围维护在共享任务板上(使用四个 team_task_* 工具,更新时进行修订检查)。当需要干预时,只有领导可以通过 interrupt_agent 中断队友的当前轮次。一旦所需工作完成,领导审查并测试合并更改并产生最终响应。
训练。 我们使用结合任务性能、鼓励委派与智能体间通信的协作奖励,以及促进高效协调的派生延迟惩罚的 RL 奖励来训练 Agent Team 模式。派生延迟通过将执行事件及其协作依赖表示为有向无环图(DAG),从固定预填充/解码速率下的 token 计数加上测量的工具执行时间分配成本,并取关键路径长度来计算。这鼓励有用的并行性,同时惩罚不必要的顺序工作与同步,并降低对服务侧批处理与排队延迟的敏感性。
性能。 我们通过仅保留参考解决方案在隐藏测试套件上达到至少 95% 通过率的任务,构建 ProgramBench(Yang et al., 2026)的高置信子集。该过滤程序留下 172 个"黄金"任务。我们还在 FrontierSWE v2(Kondra et al., 2026)上评估,这是 FrontierSWE 的更大、更具挑战性的后继者,使用大幅改进的方法论。我们通过排除需要 GPU 访问的任务,从当前公共任务构建无 GPU 子集。我们在明确的每 rollout 墙钟截止时间下评估单智能体与多智能体配置在两个基准上的表现。此处报告的结果是初步的:我们将观察到的最强多智能体配置与可用的最强单智能体基线进行比较。在 ProgramBench 上,我们每个任务运行最多三个 rollout,对应每个配置 516 个计划 rollout。我们报告 Almost@1,衡量单个 rollout 达到至少 0.95 分数的比例。在 FrontierSWE v2 上,我们报告 Mean@5。ProgramBench 截止时间从 1 到 12 小时,而 FrontierSWE v2 在 1 到 20 小时的截止时间下评估。在每个截止时间,指标从截止时间到达时可用输出计算。
如图 10 所示,多智能体配置在两个基准上每个截止时间都优于单智能体对应配置。在 ProgramBench 上,多智能体配置的 Almost@1 从 1 小时的 13.59% 增加到 8 小时的峰值 30.04%,而单智能体配置为 12.79% 与 20.39%。在 FrontierSWE v2 上,多智能体配置的 Mean@5 从 1 小时的 13.50% 增加到 20 小时的 32.90%,而单智能体配置从 10.50% 增加到 28.20%。
6. 结论、局限性与未来方向
在这项工作中,我们介绍了 DeepSeek-V4.1-Flash,一个多模态混合专家(MoE)模型,支持高达一百万 token 的上下文。通过模型架构、缓存精度与部署策略的联合优化,DeepSeek-V4.1-Flash 推动了 KV 缓存压缩的极限。其因果编码器-解码器(CED)架构使模型在预填充阶段每 token 仅激活 8B 参数,而解码阶段激活 16B,提高了输入密集型智能体工作负载的成本效率。在相同序列长度下,压缩稀疏注意力 2(CSA2)中的跨层 KV 缓存复用与 FP4 KV 缓存将其全局 KV 缓存占用(始终位于 HBM 中)降至每 token 890 字节,约为 DeepSeek-V4-Flash 对应占用的 1/4。SWA 有界重放进一步将其持久化 KV 缓存占用(始终位于 SSD 或主机内存中)降至约为 DeepSeek-V4-Flash 的 1/8。这些缩减缓解了 HBM 与 SSD 容量压力,同时模型整体性能显著优于 DeepSeek-V4-Flash。尽管参数规模远小于 GLM-5.3 与 Kimi-K3 等当代开源模型,DeepSeek-V4.1 在关键基准上达到相当------在某些任务上更优------的性能。
尽管 DeepSeek-V4.1-Flash 相对于 DeepSeek-V4-Flash 大幅简化了若干架构组件,但新引入的架构变化也产生了尚未完全表征的鲁棒性边界。我们的内部评估涵盖多样测试用例与边界条件,我们未在评估设置中观察到模型能力的系统性退化。然而,没有有限测试套件能覆盖所有极端输入与部署条件。CSA2 中的潜在选择错误与 SWA 有界重放中的近似状态重建仍可能在未测试的边界情况下导致能力退化。展望未来,我们将继续扩展压力测试与评估栈,特别关注长上下文上的稀疏检索与缓存恢复边界处的 SWA 状态重建。我们还将监控真实世界工作负载,系统表征潜在故障模式与鲁棒性边界,并进一步提高极端条件下的模型鲁棒性。
随着 AI 模型取得显著性能能力,标准评估基准日益饱和。虽然 DeepSeek-V4.1-Flash 展现出接近顶级模型如 Fable-5 与 GPT-6 Astra 的性能------在日常应用中提供高度可比的用户体验------但在最具挑战性的任务上仍存在性能差距。尽管基准分数显示差距很小,但这种持平并不意味着模型在复杂、高难度推理与边缘案例上匹配领先闭源系统的前沿能力。
因此,我们将持续更新评估协议,以确保对最先进推理边界的严格评估。除继续降低模型成本外,我们相信模型智能的进一步进步将取决于数据、模型容量与 RL 的协调扩展。以 DeepSeek-V4.1-Flash 为新起点,我们将继续探索模型能力的极限,并系统解决大规模数据合成与 RL 扩展中的关键挑战。我们还将积极整合模型-harness 协同设计,使联合系统能够共同演化与优化。通过协同推进成本降低与能力扩展,我们希望使高能力智能体更易获取、更易部署,进一步降低在更广泛行业与场景中采用 AI 技术的门槛。