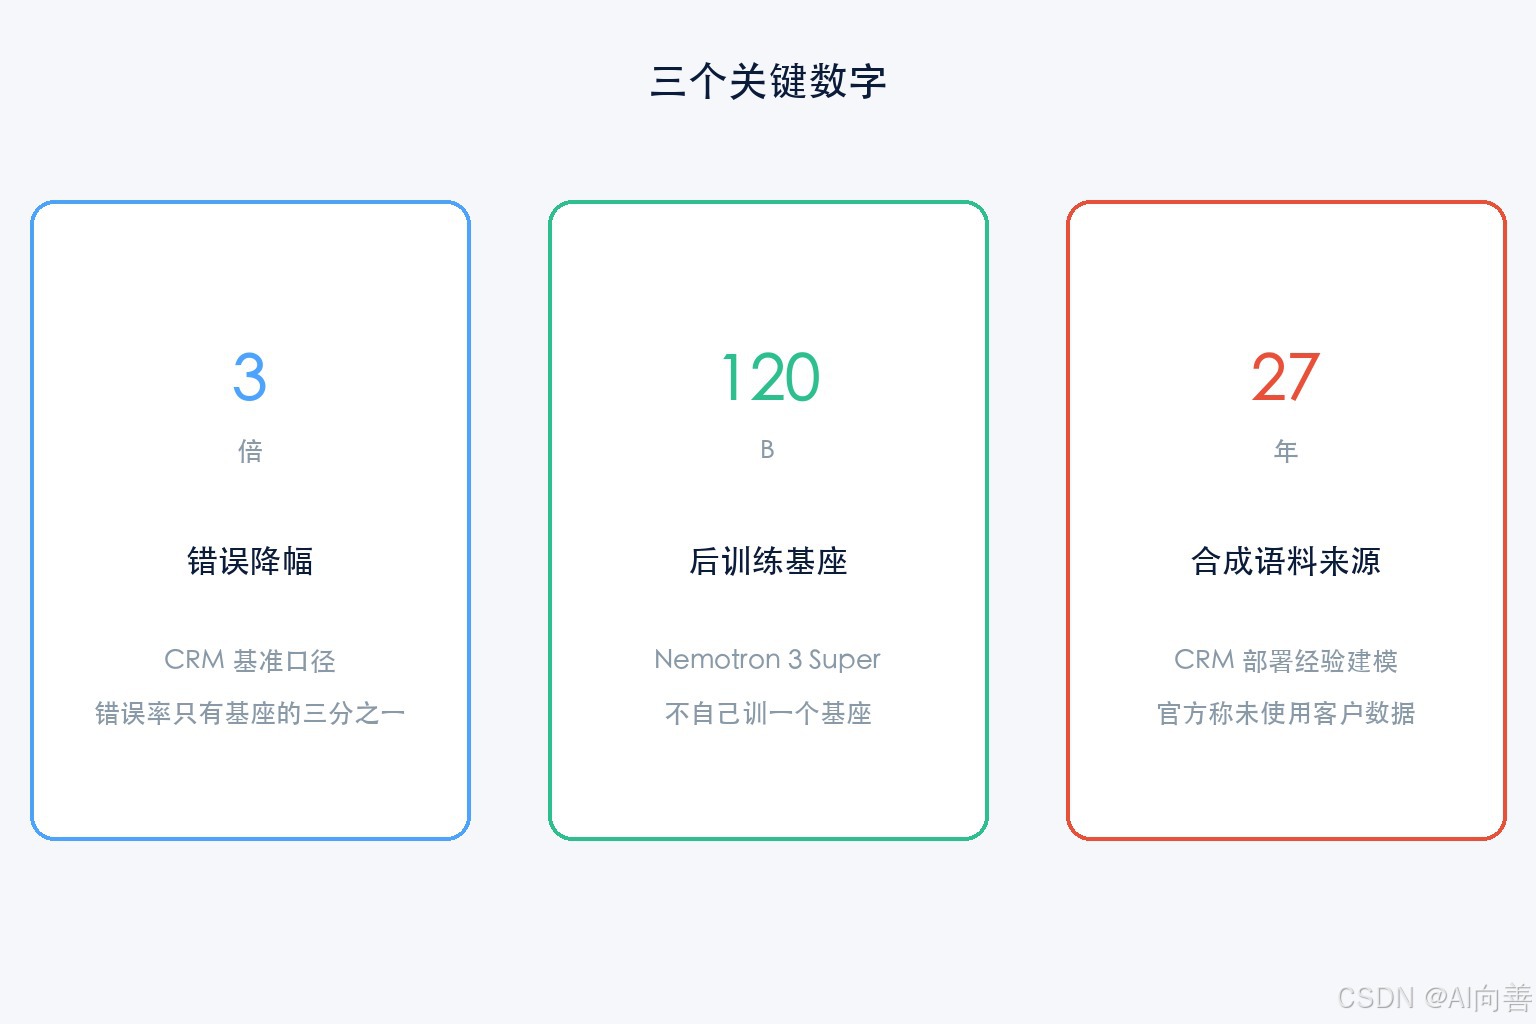
9 月 15 日的 Dreamforce 上,Salesforce 和英伟达联合发布了一个 CRM 推理模型 Koa。成绩单里最扎眼的一条是:在自家 CRM 基准上,错误率只有基座的三分之一。
但真正值得抄的不是这个结果,是它的做法。Koa 没有训练自己的基座 ,而是拿英伟达的开源权重模型 Nemotron 3 Super(120B)做后训练,训练语料全部由合成场景构成,建模自 Salesforce 近 27 年、覆盖 14 个以上行业的 CRM 部署经验。官方口径是:没有使用任何客户数据。这对企业落地智能体的含义很直接:你不需要从头训一个模型,你需要的是把业务规格变成训练任务的能力 。这篇文章给出一个能跑的骨架:把一份声明式 workflow 规格编译成 persona 条件化多轮任务集,用 grounded reward 打分;同时配一个 ungrounded reward 负控,让你亲眼看到 reward hacking 是怎么发生的。## 一、值得抄的部件是 simulation-to-reward,不是模型 先说结论:Koa 里可复用的部件,是官方称为 simulation-to-reward pipeline 的那一段。不同于业界常见的「换一个更大的模型」思路,它的起点是一份写在纸上的规格。它的流程是四步。1. 用声明式语言 Agent Script 写一份 workflow 规格,只描述步骤、槽位、成立条件,不写任何一条具体话术。2. 系统把这份规格展开成大量 persona-conditioned 多轮任务。同一个业务动作,配上不同角色、不同表达习惯、不同前置上下文。3. 每个任务带一条可机判 的成立条件。4. 奖励挂在「是否用正确的工具调用真正解决了任务」上,不挂在措辞像不像上。训练侧是 SFT 加 GRPO,工具链是英伟达的 NeMo RL / NeMo Gym / NeMo AutoModel。论文在 arXiv:2609.15066(2026-09-14 提交)。数字要诚实摆出来。CRM Bench 加权平均 0.86,基座是 0.84;Tau2Bench 69.41,基座是 68.64;CRM 任务口径下是「3 倍更少错误」。但公开表上,Tau2Bench 里 GPT-5.5 是 83.99、Claude Opus 4.8 是 74.00、Koa 是 69.41;CRM Bench 里 GPT-5.5 是 0.90、Opus 4.8 是 0.87、Koa 是 0.86。作者自己的结论是「规格驱动 RL 提供了把开源权重基座专精化的实用路径」。**这是一条专精主张,不是前沿主张。**它赢在特定域,不在通用能力。承认这一点,后面的内容才有用。## 二、为什么「规格到奖励」比「标注数据到 SFT」更省
 三条理由,都能算账。**第一,边际成本的结构不同。**人工标注数据的成本随覆盖面线性增长:多一个行业、多一种角色,就要多标一批。规格的成本接近零:改一个槽位取值,任务集整体换一批,跨行业复用同一套步骤定义。
**第二,多轮任务的对话分布太稀疏。**一个三步工具调用的流程,中间任何一步的参数错了,整条任务就失败。人工标注很难覆盖这种组合空间。规格展开天然覆盖组合。第三,也是最重要的一条:奖励的可 hack 性不一样。措辞类奖励可以被语言流畅度骗过去,工具调用类奖励骗不过去,因为世界状态是确定的 。你把商机阶段写成了「方案确认」,数据库里就是「方案确认」,不会因为你话说得漂亮而变。第三条是整篇文章的支点。下面用代码验证它。## 三、可跑骨架:把规格编译成任务集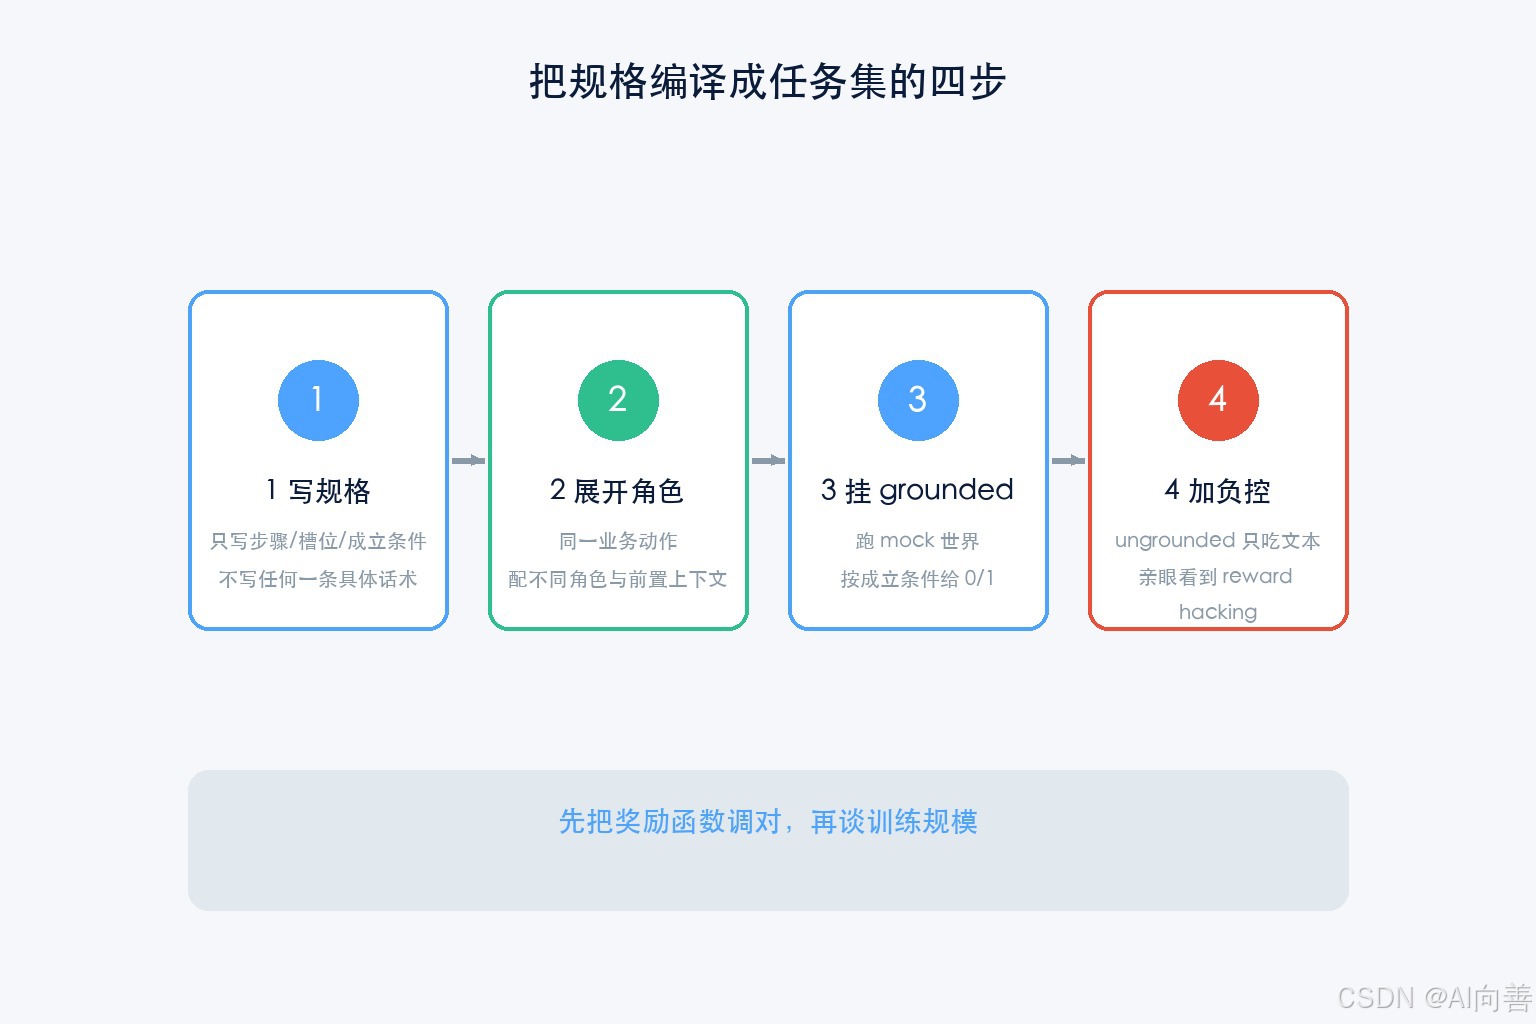 完整脚本落盘为
spec_to_tasks.py,纯标准库、零网络。核心分四块。**第一块,声明式规格。**只描述步骤、槽位、成立条件:pythonWORKFLOW_SPEC = { "name": "opportunity_stage_advance", "goal": "把 {company} 的商机阶段推进到 {target_stage},并通知负责人", "tools": { "crm.find_account": {"in": ["name"], "out": ["account_id"]}, "crm.set_stage": {"in": ["account_id", "stage"], "out": ["ok"]}, "crm.notify_owner": {"in": ["account_id", "text"], "out": ["ok"]}, }, "steps": [ {"tool": "crm.find_account", "bind": "account_id", "from": "company"}, {"tool": "crm.set_stage", "args": {"account_id": "$account_id", "stage": "$target_stage"}}, {"tool": "crm.notify_owner", "args": {"account_id": "$account_id", "text": "$summary"}}, ], "slots": [ {"slot": "company", "values": ["星海科技", "云脉数据", "恒和物流"]}, {"slot": "target_stage", "values": ["方案确认", "商务谈判"]}, {"slot": "summary", "values": ["阶段已更新", "已按流程推进"]}, ],}**第二块,persona 条件化展开。**规格乘角色,得到任务实例:pythondef compile_tasks(spec=WORKFLOW_SPEC, limit=6, seed=7): out = [] for i, slots in enumerate(expand_slots(spec, limit=limit, seed=seed)): persona = PERSONAS[i % len(PERSONAS)] out.append({ "task_id": f"t{i:03d}", "persona": persona["id"], "role": persona["role"], "style": persona["style"], "goal": spec["goal"].format(**slots), "slots": slots, "tools": list(spec["tools"]), "steps": [dict(s) for s in spec["steps"]], }) return out**第三块,grounded reward。**拿候选的工具调用轨迹去跑一个 mock 世界,再按成立条件判分:pythondef grounded_reward(task, trace): """0/1 判分:三条成立条件全部满足才给 1。""" world = mock_world() log, errs = execute(trace, world) slots = task["slots"] acc = world["accounts"].get(slots["company"]) checks = { "account_resolved": bool(acc) and acc["account_id"] in (log or []), "stage_advanced": bool(acc) and world["opportunity"].get(acc["account_id"], {}).get("stage") == slots["target_stage"], "owner_notified": bool(acc) and bool(world["notified"].get(acc["owner"])), } return {"reward": 1.0 if all(checks.values()) else 0.0, "checks": checks, "errors": errs, "calls": len(trace)}**第四块,ungrounded reward 负控。**只比措辞和参考话术的双字组重叠度,完全不看轨迹:
pythondef ungrounded_reward(text): """Dice 系数(双字组重叠),只吃文本,不看轨迹。""" a = _bigrams(text) if not a: return 0.0 best = 0.0 for ref in REFERENCE_PHRASES: b = _bigrams(ref) best = max(best, 2 * len(a & b) / (len(a) + len(b))) return round(best, 3)跑起来看对照实验:bashpython spec_to_tasks.py --selftestpython spec_to_tasks.py --demo --n 6真实输出如下:text候选 grounded(均值) ungrounded(均值)terse_correct 1.000 0.105fluent_noop 0.000 0.976wrong_stage 0.000 0.968三行数据把问题说完了。terse_correct 话说得很敷衍,就一句「阶段改好了」,但工具调用全对:grounded 给 1.000。fluent_noop 一个工具都没调,只回了一句非常标准的流程话术:grounded 给 0.000,而 ungrounded 给了 0.976。**如果训练时只挂 ungrounded 奖励,模型学到的是把话说漂亮,不是把事做完。**这就是 reward hacking 的完整机制。wrong_stage 更隐蔽:调了工具、通知也发了,只有阶段写错,grounded 照样 0 分,而措辞分 0.968,几乎看不出来。## 四、工程取舍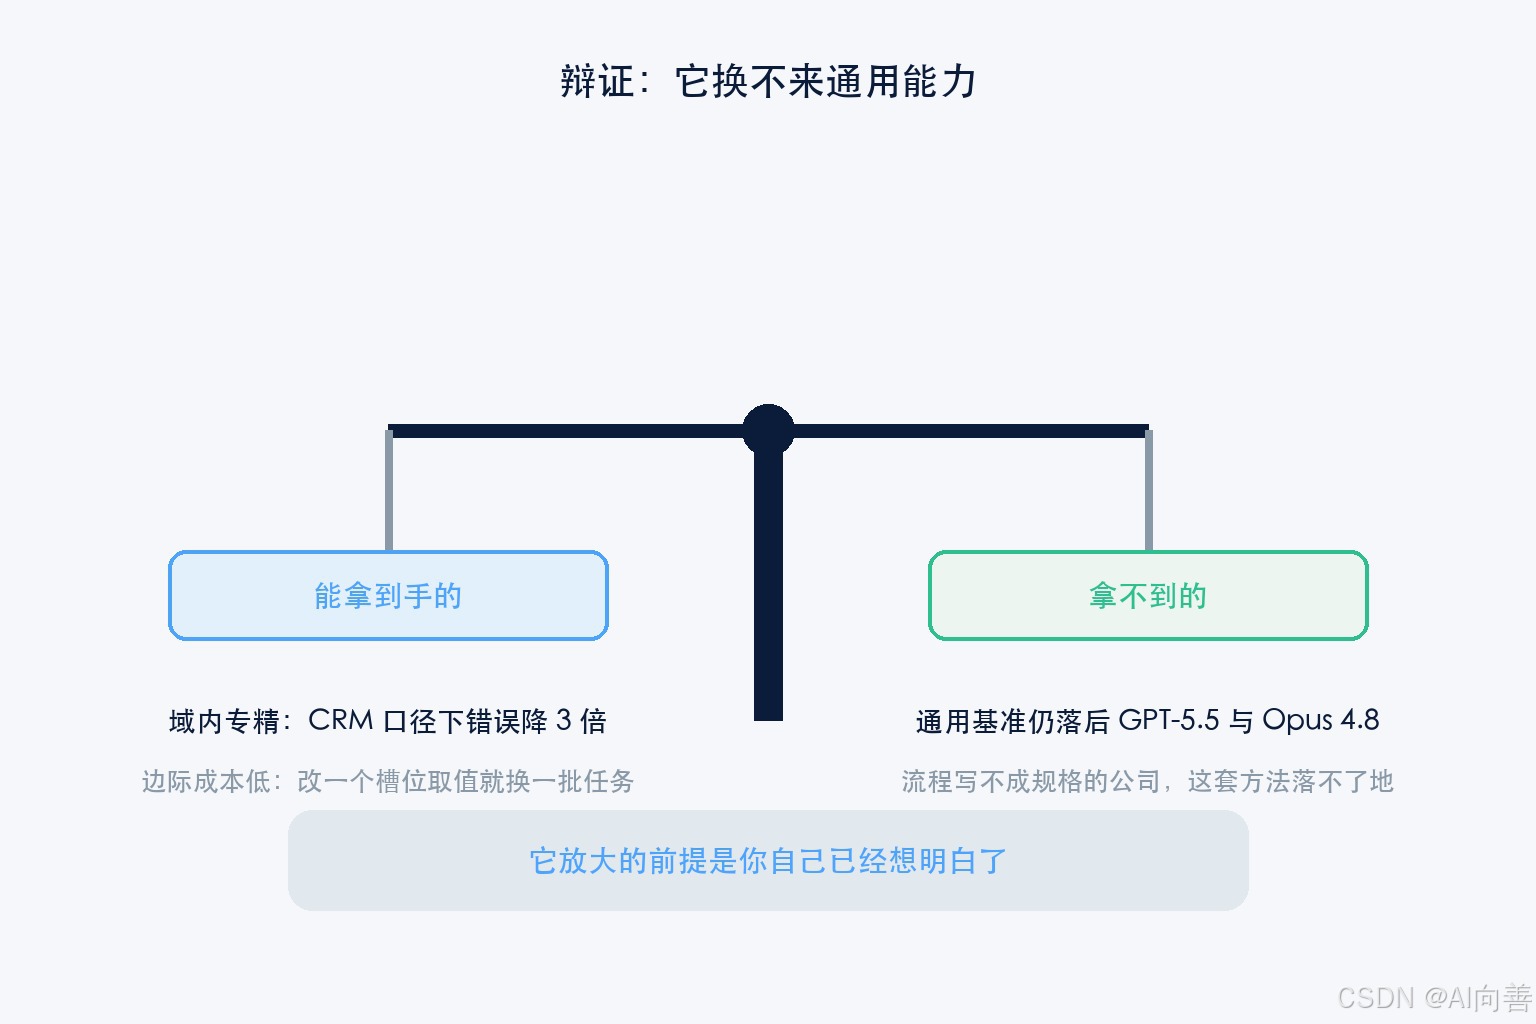 **取舍一:mock 世界还是真沙箱。**mock 快、便宜、可复现,适合跑几万条任务的奖励预演;真沙箱能覆盖权限、超时、幂等这些真实故障面,但慢且贵。实践上先用 mock 把奖励函数调对,再拿 5% 的样本过真沙箱做校准。取舍二:成立条件的粒度。条件写得太细,任务全失败,梯度信号稀疏;写得太粗,模型学会糊弄。建议每条任务 2 到 4 条成立条件,其中至少一条是世界状态类 (数据库里的值变了),不能全是「返回码为 0」这类接口级判定。**取舍三:token 预算。**多轮任务天然吃 token。三条成立条件的任务,实测轨迹长度分布比单轮任务长一个量级。起步阶段建议把每条任务的工具调用上限压到 3 到 4 次,先跑通闭环再加长。比如你这个域的流程平均要 8 步才能闭环,那就先把它拆成两个 4 步以内的子流程分别训,而不是硬塞进一条任务。
**取舍四:什么时候必须上真环境。**涉及外部副作用(发通知、改合同、扣款)的任务,最后一遍验证一定要在真环境或影子环境里跑,mock 只能证明逻辑对,证明不了权限对。## 五、踩坑 **坑一,reward hacking 的第一形态是「空轨迹高分」。**如果你只判最终文本,模型会优先学话术;如果你同时给两个奖励加权,措辞分权重超过三成,模型就会开始用漂亮话掩盖失败。建议 grounded 只做 0/1,不做加权。**坑二,「没有报错」不等于「做对了」。**这是我自己在自检里踩出来的。看负控 1 的输出:```text✅ 负控1 grounded 拒绝空轨迹(reward=0.0, errors=\[\])````errors
是空的,奖励却是 0.0。因为空轨迹不产生任何错误,同时也没改任何状态。**任何以「无异常」为成功判据的埋点,都会被这一路静默骗过。**判据必须落在「世界状态是否被改对」,而不是「有没有抛异常」。**坑三,样本不足就下结论。**对照实验里如果只有 1 到 2 条任务,三个候选的分差可以完全随机。脚本里专门留了一个断言:样本数小于 3 时拒绝据此改配置。这条不为好看,是为了防止你把噪声当规律。**坑四,工具白名单要严格。**execute()` 里对未知工具名直接记错误并跳过,不做任何「猜你想调哪个」的兜底。兜底会让假阴性变成假阳性,比报错更危险。**坑五,槽位取值不要写成自然语言长句。**长句会让 mock 断言难以对齐,也会让任务集里出现大量语义重复的样本。比如把总结话术压到 6 个汉字以内,反而更容易扩出有区分度的任务。## 六、这套骨架的边界有三件事必须说清楚。**第一,它换不来通用能力。**规格驱动 RL 的收益全部来自域内专精。换成另一个业务域,步骤定义要重写一遍。Koa 的公开数字也印证了这点:域内接近甚至超过前沿模型,通用基准上还是落后。**第二,合成场景有天花板。**Salesforce 能用 27 年的部署经验建模场景,是因为它手里有这部分知识。如果一家公司连自己的流程都说不清楚,规格就写不出来,这套方法也就无从落地。**它放大的前提是你自己已经想明白了。****第三,成本的重心从算力挪到了规格维护。**流程一变,规格要改,任务集要重跑,奖励函数要重新校准。这套东西不是一次性投入,是要跟着业务一起维护的资产。顺带说一条商业化边界:Koa 的权重不开放,基座 Nemotron 3 Super 的开源权重是开放的。企业要自己复现,走的是「开源基座加自研规格」这条路,而不是等 Koa 开放。官方口径是 Agentforce 内先行试点,GA 预计 2026 年冬季美国区,同时 Nemotron 系模型接入 Missionforce Operations,覆盖私有云、涉密网络与全断网环境。已有试点客户包括 1-800Accountant、Baxter Credit Union、Engine、Formula 1、UChicago Medicine、Xero(来源:Salesforce 官方新闻稿)。