目录
- 前言
- 一、问题定义:人工补几篇文档,永远补不过上游的出料速度
- 二、核心方案:六段流水线,把"补粮"从人等料变成流水线自己跑
-
- 流水线六段阶段表
- [① 采集:料从哪来、谁准进](#① 采集:料从哪来、谁准进)
- [② 清洗:脏料不进城,四道闸默认全开](#② 清洗:脏料不进城,四道闸默认全开)
- [③ 切片:按文档类型分层切,别迷信"固定 token 数一把梭"](#③ 切片:按文档类型分层切,别迷信“固定 token 数一把梭”)
- [④ 向量化:文本变成能检索的向量,真实模型藏在接口后](#④ 向量化:文本变成能检索的向量,真实模型藏在接口后)
- [⑤ 版本/血缘/权限:每份料有号、来路可溯、谁可见](#⑤ 版本/血缘/权限:每份料有号、来路可溯、谁可见)
- [⑥ 双链路:离线批量买"一致",在线增量买"新鲜"](#⑥ 双链路:离线批量买“一致”,在线增量买“新鲜”)
- 三、代码实战:一个可离线跑的数据流水线最小实现
- 四、踩坑记录:这三个坑,每个都真付过费
-
- [4.1 手补一篇料花半天,第二天又来三篇](#4.1 手补一篇料花半天,第二天又来三篇)
- [4.2 全量重建撞上在线增量,索引里新旧混着](#4.2 全量重建撞上在线增量,索引里新旧混着)
- [4.3 切片贪省事按固定字符数硬切,把保修条款切两半](#4.3 切片贪省事按固定字符数硬切,把保修条款切两半)
- [五、选型对比:三条路线、工具现状、7 问清单](#五、选型对比:三条路线、工具现状、7 问清单)
-
- [5.1 大表:文档流水线三条路线](#5.1 大表:文档流水线三条路线)
- [5.2 副表:可落地的工具现状(2026 已核实)](#5.2 副表:可落地的工具现状(2026 已核实))
- [5.3 可复用 checklist:RAG 数据工程底座 7 问](#5.3 可复用 checklist:RAG 数据工程底座 7 问)
- [六、总结 + 下一篇预告](#六、总结 + 下一篇预告)
- [附录 A:流水线六段 × 输入输出 × 常见坑 × 校验规则完整表](#附录 A:流水线六段 × 输入输出 × 常见坑 × 校验规则完整表)
- [附录 B:切片策略与量级推导](#附录 B:切片策略与量级推导)
- [附录 C:真实工具对接片段(版本已核实,2026-09)](#附录 C:真实工具对接片段(版本已核实,2026-09))
- [附录 D:demo 确定性向量化桩与去重指纹的最小算法说明](#附录 D:demo 确定性向量化桩与去重指纹的最小算法说明)
前言
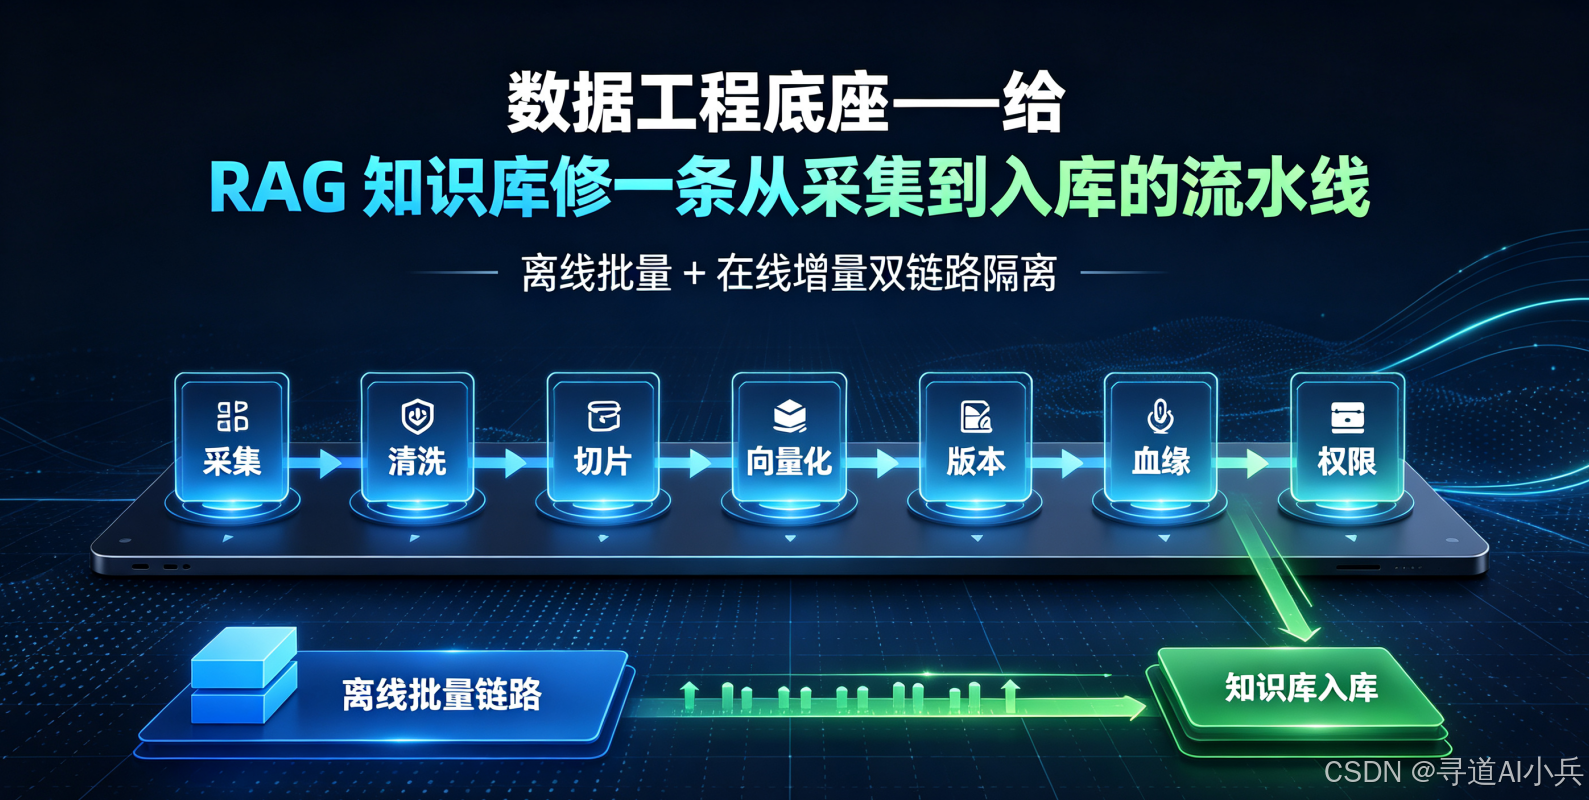
第 11 篇《知识库防腐坏》结尾我写下一句判断:粮仓的地基,在第 12 篇。写完那天晚上,我亲手给这句话补了个注脚。巡检报出库里缺 X200 的保修页,我心想补一份文档能有多难:上官网扒 PDF、下载、转文本、肉眼比对有没有重复、手动切成段、跑一遍向量化脚本入库。等我抬头看表,半天没了;更糟的是我忘了记这是哪个版本、这些切片是从哪份料切出来的。第二天打开待补清单,上面又多了三条。那一刻我盯着那张越补越长的单子认了:问题不在我手慢------手再快,也快不过上游出料的速度。 我缺的从来不是这一批料,是一条从文档采集、清洗、切片、向量化,到数据版本管理、数据血缘、权限,再到离线批量更新和在线增量更新双链路隔离的数据工程底座 。粮仓的地基不在巡检管线,这篇把它修起来。
一、问题定义:人工补几篇文档,永远补不过上游的出料速度
第 11 篇把"粮仓会烂、要体检、要换血"讲透了,可它也把一道更硬的活留在了桌上:巡检能报"缺了哪批料",治理能挂起待补清单,换版能留个版本号------可这些料到底从哪来?怎么持续、干净、可追溯地运进粮仓?我踩过三个误区,一个比一个贵。
第一,把"知识库更新"当成一次性任务。 缺了人工补,补完就完,没有流水线。每来一批料都从"下载 PDF"开始重走一遍:扒页面、转文本、找重复、手动切、跑脚本。补料是纯体力活,手速再快也追不上上游的出料速度------这就是"补一篇花半天、第二天又来三条"的根。
第二,离线全量重建和在线增量追加混着跑。 全量重建跑着,增量任务还往同一张索引里塞:重建结束时索引里混着"新策略的旧料 + 旧策略的新料",检索命中忽新忽旧。第 11 篇最恨的"新旧混读",从发布层传染到了数据层,比软下架不彻底还阴。
第三,文档进来无号无痕。 补进来的料没有版本号、没有血缘(这块切片是从哪份原始文档来的)、没有权限标。第 11 篇要换版时找不到"这一版和上一版差在哪",巡检要溯源时翻不到"这份切片是哪份料的第几刀",检索端也没法按租户和密级过滤。一份料进了库却不知道它从哪来、谁能看,等于给未来的自己埋雷。
结论先放这儿:第 11 篇管"发现和处置"(体检、止血、换版纪律),本篇管"料怎么持续、干净、可追溯地运进来"------数据工程底座 = 采集 → 清洗 → 切片 → 向量化 → 版本/血缘/权限 → 双链路,一条流水线走到底,产出的是换版门能直接接住的新版本快照。 别把它读成"文档洗干净再入库"的提醒,也别飘成"数据仓库/大数据平台"的通用科普:它只为 RAG 知识库服务,接的是第 11 篇那张待补清单。
二、核心方案:六段流水线,把"补粮"从人等料变成流水线自己跑
开篇《四大支柱》里那张底层底座图,4.1 数据工程底座给的就是三条原文------"标准化全链路数据流水线:文档采集、清洗、分段切片、向量化、向量入库""数据版本、血缘、权限全生命周期管理,区分结构化业务数据与非结构化文档知识库""离线批量更新、在线实时增量更新双链路隔离,互不干扰线上业务"。这三条就是本篇的主框架上位图,六段流水线是把它们拆开落地。
全文主线一句话:第 11 篇交过来三样东西(待补清单、处置单、版本号)当入口 → ① 采集(料从哪来、谁准进)→ ② 清洗(脏料不进城)→ ③ 切片(怎么切不切坏语义)→ ④ 向量化(文本怎么变成能检索的向量)→ ⑤ 版本/血缘/权限(每份料有号、来路可溯、谁可见)→ ⑥ 双链路(批量重建和增量追加别打架)→ 产出可被换版门接住的新版本快照。 知识库不是一座建好就没人喂的静态仓库,是一台需要"进料口"的机器------数据工程底座就是那条把料从源头持续、干净、可追溯地运进粮仓的流水线。
第 11 篇交过来的入口:待补清单(缺了哪批料)+ 处置单(哪批要软下架/合并)+ 版本号(V_k -> V_{k+1})
   │
   ▼
① 采集(料从哪来、谁准进)
      ── 源头清单:爬 / API / 业务系统导出 / 人工上传 / 待补清单(应采未采)
      ── 来源闸:白名单之外的料不进(第 6 篇心智,不可信的料比没有更糟)
      ── 涉密切入:sensitive 标在入口拦,不进流水线(第 6 篇)
   ▼
② 清洗(脏料不进城)------ 四道闸,默认全开、可配可关
      归一(编码/空白/HTML 残渣)→ 脱敏(PII)→ 校验(元数据过 schema 闸,第 7 篇)→ 去重(内容指纹)
   ▼
③ 切片(怎么切不切坏语义)
      按文档类型分层切:政策/条款按语义段切、参数/表格按行/按表切
      每块挂元数据(chunk_id / 父文档 raw_id / 偏移 / version)------ 不硬按字符数切
   ▼
④ 向量化(文本怎么变成能检索的向量)
      embedding(demo 用 hashlib 确定性桩,真实模型藏接口后)→ 批量算 → 向量入库(真实向量库藏接口后)
   ▼
⑤ 版本 / 血缘 / 权限(每份料有号、来路可溯、谁可见)
      版本表:版本号不可变,改料只能出新版本(呼应第 11 篇"知识库不能 UPDATE")
      血缘表:哪份原始文档 -> 哪块切片 -> 哪个向量(谁改的、什么时候)
      权限表:租户 / 密级标签,检索端按权限过滤
   ▼
⑥ 双链路(离线批量 vs 在线增量,隔离、别打架)
      离线批量:全量重建(低峰窗口,独立版本命名空间,过第 2 篇检索回归 + 第 11 篇换版门)
      在线增量:新料追加(准实时,只 append,不碰全量索引)
      ── 两条链路写同一份元数据表,但各自隔离写入,重建时在线追加不污染重建结果
   ▼
产出:一个可发布的新版本快照 V_{k+1}(version_id + 切片清单 + 血缘 + ACL)
      → 交给第 11 篇换版门 / 第 3 篇灰度上线 ------ 地基把料运进来,发布纪律负责把它送上线
流水线六段阶段表
六段各回答一个问题、各拦一类脏东西、各产一组可观测指标。这张表可以直接抄成你们数据流水线的建设清单:
| 阶段 | 回答的问题 | 输入 → 输出 | 拦的是什么/兜的是什么 | 产出可观测指标 |
|---|---|---|---|---|
| ① 采集 | 料从哪来、谁准进? | 源头清单 + 待补清单 → 待清洗的原始文档 | 拦来源白名单外的料、入口就拦未脱敏涉密文档(第 6 篇);兜"人肉下载、每批料从头手工走一遍" | 采集成功率、应采未采数(缺料清单) |
| ② 清洗 | 脏料怎么不进城? | 原始文档 → 归一化干净文档 | 拦编码乱码/HTML 残渣/未脱敏 PII/必填元数据缺失/重复(第 7 篇 schema 闸) | 脱敏命中数、校验失败数、去重率 |
| ③ 切片 | 怎么切才不切坏语义? | 干净文档 → 带元数据的切片 | 拦跨句/跨表切断(把"保修 12 个月"切两半)、超长块(挤爆检索上下文) | 切块数、超长块占比、平均块长 |
| ④ 向量化 | 文本怎么变成能检索的向量? | 切片 → 向量 + 索引条目 | 拦空文本、编码失败、维度不一致(换模型时新旧向量不可比) | 向量化成功率、批量耗时 |
| ⑤ 版本/血缘/权限 | 每份料有号、来路可溯、谁可见? | 向量 + 元数据 → 版本表 / 血缘表 / 权限表 | 拦无版本号、血缘断裂(切片回溯不到父文档)、越权可见 | 版本覆盖率、血缘完整率 |
| ⑥ 双链路 | 批量重建和增量追加怎么不打架? | 全量快照/单条新料 → 新版本 | 拦离线批量与在线增量互踩、增量重跑全量、重建期间新旧混读 | 增量延迟、重建时长、链路隔离校验 |
① 采集:料从哪来、谁准进
源头清单(爬虫/API/业务系统导出/人工上传)加上第 11 篇递过来的待补清单------用户问过、库里没有的料,是采集优先级最高的清单,用户已经用脚投过票了。采集段干两件事:一是把待补清单变成采集任务,二是设来源白名单闸:白名单之外的料不进,sensitive 标在入口就拦。 这是整条流水线唯一能在源头拦"来源不可信/涉密"的闸------不可信的料比没有更糟,它会在末端以幻觉、越权可见的形式被召回,漏过入口闸,后面清洗切片向量化全白搭。采集段顺手把版本号和血缘起点打上:没 doc_id/version/密级/来源的料,后面的版本表、血缘表、权限表全填不起来。
② 清洗:脏料不进城,四道闸默认全开
清洗做四道:归一(编码/空白/HTML 残渣)→ 脱敏(PII)→ 校验(元数据过 schema 闸,第 7 篇)→ 去重(内容指纹)。每道可开关、可配规则,但默认全开------把"干净"当默认值,把"放行脏料"当需要理由的例外。
这道闸我得单独拎出来说:清洗是整条流水线最贵的一段,也偏偏是唯一能在源头拦下脏料的一段------它贵,是因为它替后面每一段挡了刀。 很多人把清洗当"顺手去掉 HTML tag",其实归一要处理各种编码和残渣、脱敏要跑 PII 识别、校验要维护元数据规则、去重要比指纹,每道都是算力成本加规则维护成本。但清洗是源头过滤,第 11 篇的防腐坏巡检是末端治理------一份脏料在源头拦掉只要几毫秒,漏进库之后要靠巡检扫出来、软下架、再换版清,那是十倍的账。有个被反复引用的口径说数据准备和清洗要吃掉数据工作者 25%~80% 的时间------Anaconda 摸底约 38%~45%、CrowdFlower 称 60%~80%,口径宽、别拿一个数当铁律,但方向一致:清洗就是最费人的那一段。我认这道闸的贵,因为让脏料进城的账,第 11 篇的巡检已经替我算过一遍了。代价也得说清:清洗会误杀------正文里有用的表格被当 HTML 残渣清掉、正常文本被去重规则合并、长文档被校验规则拒收。我认,源头过滤永远比末端治理便宜。这个取舍的代码落点是 demo 的断言②------同内容进两次只留一份,去重就是源头过滤的具象化。
③ 切片:按文档类型分层切,别迷信"固定 token 数一把梭"
切片粒度是个真取舍:切粗(块大)上下文完整但检索不精准,一个块里塞了好几个主题,召回时连着无关内容一起喂给模型、挤占上下文窗口;切细(块小)检索精准但丢上下文,一句话被切掉半截、一个表格被切散。最常见的懒办法是"按固定字符数硬切",简单但最蠢:它会把"整机保修 12 个月"从中间切断------"整机保修"和"12 个月"落进两个块,检索只召回半句,模型答"保修"却答不出几个月。
切片没有一个万能切法,按文档类型分层切。 政策/条款类按语义段(一个条款/一节)切、参数/表格类按行/按表切、长叙述类按段落加滑窗重叠切,重叠加一点保证边界不丢信息。2026 年的公开口径也站这一边:基线是递归切约 512 token、10%~20% overlap,块大小跟着查询类型走------事实型 query 用 256~512 token、分析/多跳 512~1024、整段理解 1024~2048。overlap 那条最有分歧,有研究说无收益,产业指南仍建议小 overlap,我建议小 overlap 起步、拿自己数据做消融,别站队。每块必须挂元数据(chunk_id/父文档 raw_id/偏移/version)------不挂元数据的切片,第 11 篇巡检溯源时就是一笔糊涂账。这个取舍的代价是:分层切要维护多种切法,复杂度和调试成本比"一把梭"高,而且"这份文档算哪类"本身要判断,判错了切法也错。我认,因为切坏的账比多维护几种切法贵得多------切坏了,用户拿到的是半截答案,排查还得从头翻切片日志。
④ 向量化:文本变成能检索的向量,真实模型藏在接口后
切好的块批量算 embedding、向量入库。这一段在 demo 里用 hashlib 做了个确定性伪向量当桩,真实 embedding 模型藏在接口后------桩换来换去,流水线逻辑一行不改(同第 8 篇"生产换 SDK、打点一行不改"的替换心智)。真实维度是 3072/1536/1024 三档(text-embedding-3-large、text-embedding-3-small、BGE-M3),换 embedding 模型或换维度是最贵的一次变更:新旧向量不可比,要么整版重 embedding、要么用对齐适配层映射,两条都走换版不原地改(第 11 篇换版纪律在向量维度的落点------维度是个旋钮,换维度 = 换版本)。
⑤ 版本/血缘/权限:每份料有号、来路可溯、谁可见
三张表撑起这一段。版本表 :版本号不可变,改料只能出新版本,呼应第 11 篇"知识库不能 UPDATE、只能换版本"------版本一旦建成就不能覆盖,这是纪律的代码化,不是靠自觉。血缘表 :哪份原始文档 → 哪块切片 → 哪个向量、谁改的、什么时候;第 11 篇换版要对账"这版和上版差在哪"、巡检要溯源"这块切片从哪份料来",靠的都是它。权限表:租户/密级标签,检索端按权限过滤------越权可见是事故,不是小问题。这段的代码落点是 demo 的断言④(血缘可溯)和断言⑥(版本不可变)------血缘按版本各留一行、版本号不可覆盖,都是断言钉出来的。
⑥ 双链路:离线批量买"一致",在线增量买"新鲜"
很多人纠结"我到底该用全量重建还是增量更新",这是个伪问题。两条链路解决两个问题:在线增量 解决"料要新鲜"(新 FAQ 当天能查到),离线批量解决"库要一致"(换切片策略/换 embedding/大范围治理,影响全库的必须整版重算)。正确的做法是两条都建、各走各的:新料攒批走在线增量追加(只 append、准实时、不碰全量索引),结构性变更走离线批量重建(独立版本命名空间、过门才上)。增量不是"省掉全量重建"的偷懒,是"重算成本随变更率缩放"的经济账------一个有代表性的账是 5 万文档语料、每天 500 条变更,只重 embedding 那 500 条,比全量重建便宜约 100 倍、秒级生效;反过来,结构性变更走批量是因为 1M 文档语料批量 embedding 约 24~48 小时。
代价是双链路本身的复杂度:两条链路写同一份元数据表要防并发(离线重建期间在线追加要么被挡、要么落到下一版,绝不能混进正在重建的这版)、增量久了会和全量索引漂移要定期对齐、删改文档的增量还要处理"标记删除"(增量只 append,删除得另走一条)。我认这个代价,因为单走一条更糟:只走在线增量 → 结构性变更没法整版重算、库会越来越飘;只走离线批量 → 新料要等下一个重建窗口,用户问的新款永远查不到。
双链路决策表(可以直接抄成"什么时候走哪条链路"的判断):
| 变更类型 | 走哪条链路 | 为什么 | 代价/注意 |
|---|---|---|---|
| 新料入库(新增文档,不改旧的) | 在线增量追加 | 只 append、准实时、不动全量索引 | 增量易和全量索引漂移,要定期对齐;删改文档增量还要标记删除 |
| 结构性变更(换切片策略/换清洗规则) | 离线批量重建 | 影响全库,必须整版重算、过门才上 | 慢、窗口长、算力大单,放低峰窗口 |
| 换 embedding 模型/向量维度 | 离线批量重建 | 新旧向量不可比,必须整版重 embedding | 最贵的一条,要么整版重算、要么用对齐适配层,都走换版不原地改 |
| 大范围治理(第 11 篇处置单批量落地) | 离线批量重建 | 攒批换版,不与线上增量抢资源 | 和第 11 篇换版纪律对齐,过检索回归 + 影子验证才发 |
| 高频小批新料(客服 FAQ 天天更) | 在线增量追加 | 攒条数阈值后小批追加,准实时 | 别一条一条追、攒批追(呼应第 10 篇"攒批才灌"的节奏心智) |
三、代码实战:一个可离线跑的数据流水线最小实现
先说清楚 demo 为什么自包含:第 8/9/10/11 篇的 demo 都嵌在各自文章里,磁盘上没有那些文件,mini_data_pipeline.py 不 import 任何不存在的东西。数据工程底座的核心------来源闸、清洗四道、切片边界、确定性向量化、版本/血缘/权限表、双链路隔离、导出 bundle------全是纯数据加纯函数的活,唯一碰外部世界的是"真实数据源/真实文档解析器/真实 embedding/真实向量库",全都藏在可替换的接口后。demo 只用标准库:元数据表用 sqlite3,确定性向量化桩用 hashlib,不 import openai/requests/numpy/langchain 任何一个,不调 API、不花钱、离线可跑、能断言。
mock 数据刻意埋了活靶子:1 篇来源白名单外、1 篇涉密、1 组重复、1 篇缺必填元数据、1 份会被"固定字符数硬切"切坏的保修条款(含手机号和邮箱供脱敏段命中)。release/mini_data_pipeline.py:
python
"""
迷你数据工程底座:对一批 mock 原始文档跑通 采集 -> 清洗 -> 切片 -> 向量化 ->
版本/血缘/权限 -> 双链路 六段流水线,产出一个能被第 11 篇换版门接住的新版本快照。
纯标准库、无第三方依赖、不调 API、离线可跑(元数据表用标准库 sqlite3,向量化用
标准库 hashlib 做的确定性桩)。

依赖安装:无(Python >= 3.10,只用到标准库 sqlite3 / hashlib / json / math / re / datetime)
运行:python mini_data_pipeline.py / python test_mini_data_pipeline.py
(Windows 控制台打印中文若报 GBK 编码错:PowerShell 用 $env:PYTHONUTF8=1; python mini_data_pipeline.py,
 cmd 用 set PYTHONUTF8=1 && python mini_data_pipeline.py)

主线一句话:第 11 篇交过来的三样东西(待补清单 / 处置单 / 版本号)当入口 ->
① 采集(料从哪来、谁准进:来源白名单闸 + 涉密拦截)
-> ② 清洗四道(归一 / 脱敏 / 校验 / 去重)
-> ③ 切片(按结构边界切,不把一句话切两半)
-> ④ 向量化(确定性桩,真实 embedding 藏在接口后)
-> ⑤ 版本 / 血缘 / 权限(sqlite3 三张表:versions / lineage / acl)
-> ⑥ 双链路(离线批量重建 + 在线增量追加,重建期间的增量落 pending 隔离区)
-> 产出 ReleaseBundle(version_id + 切片 + 血缘 + ACL),交给换版门 / 灰度上线。

四个"为什么"是整份代码的骨架:
1. 为什么采集入口是唯一能拦"不可信 / 涉密"的闸:来源白名单外的料、sensitive=True 的料
   在 ingest() 就被拒,不进流水线------不可信的料比没有更糟(第 6 篇心智),漏过入口闸,
   后面清洗 / 切片 / 向量化全白搭。
2. 为什么清洗要做四道且默认全开:源头过滤永远比末端治理便宜。一份脏料在源头拦掉只要
   几毫秒,漏进库之后要靠第 11 篇的巡检扫出来、软下架、再换版清------那是十倍的账。
3. 为什么切片按结构边界而不按固定字符数:固定长度硬切会把"整机保修 12 个月"从中间切断,
   "整机保修"和"12 个月"落进两个块,检索只召回半句,模型答"保修"答不出几个月。
4. 为什么双链路要隔离:离线全量重建和在线增量写同一份元数据表,重建窗口内到货的新料
   绝不能混进正在重建的这版(否则重建出来的版本里新旧策略混着,比不重建更乱)。

mock 数据刻意埋活靶子:1 篇来源闸外、1 篇涉密、1 组重复、1 篇缺必填元数据、
1 份会被"固定长度硬切"切坏的保修条款。"采集拦 2 篇 / 去重丢 1 篇 / 校验拒 1 篇 /
条款完整切块 / 双链路隔离 / 导出 V2"是对这份 mock 数据的确定性结论,
不是对真实流水线的承诺------真实拦截率取决于你的文档生命周期和源头质量(量级锚点见文章附录 B)。
"""
import datetime
import hashlib
import json
import math
import re
import sqlite3
from dataclasses import dataclass


# ---------- 数据契约 ----------

@dataclass
class RawDoc:
    """一篇刚从源头采进来的原始文档------还没清洗,所以内容可能是脏的(带 HTML 残渣、
    空白噪声、PII),也带着"能不能进流水线"的准入标:source 要过白名单、sensitive 得是 False。
    为什么原始文档就得带全这些元数据:没 doc_id / version / 密级 / 来源的料,后面的版本表、
    血缘表、权限表全填不起来------采集段就得把"该有的字段"钉住(第 7 篇 schema 闸往上游前移)。"""
    raw_id: str
    source: str
    content: str
    doc_id: str = ""
    version: str = ""
    tenant: str = "tenant-default"
    level: str = "internal"
    product_key: str = ""
    sensitive: bool = False
    fetched_at: str = ""


@dataclass
class CleanDoc:
    """清洗后的干净文档:内容已归一 + 脱敏,content_fingerprint 已算好(去重和换版对账共用)。
    raw_id 一路带到这儿、带到切片、带到血缘表------这就是"每份料有号有痕"的那根线。"""
    raw_id: str
    doc_id: str
    source: str
    content: str
    fingerprint: str
    version: str = ""
    tenant: str = "tenant-default"
    level: str = "internal"
    product_key: str = ""
    pii_hits: int = 0


@dataclass
class Chunk:
    """一块切片:chunk_id(= 父文档 raw_id + 起始偏移,确定性、可复现)、raw_id(回指父文档)、
    offset(在归一化正文里的起点)、text、version。切片必须挂元数据,否则第 11 篇巡检要溯源时
    翻不到"这块切片是哪份料的第几刀"。"""
    chunk_id: str
    raw_id: str
    text: str
    offset: int
    doc_id: str = ""
    version: str = ""
    tenant: str = "tenant-default"
    level: str = "internal"


@dataclass
class ReleaseBundle:
    """一个可发布的新版本快照:version_id + 切片清单 + 血缘 + ACL + 版本指纹。
    这就是丢给第 11 篇换版门 / 第 3 篇灰度上线的输入------数据流水线的产出物形态。"""
    version_id: str
    chunks: list
    lineage: dict
    acl: dict
    fingerprint: str = ""


# ---------- ① 采集:来源白名单闸 + 涉密拦截 ----------

def ingest(sources, whitelist):
    """采集入口的唯一一道闸:来源白名单 + 涉密拦截。
    为什么采集段必须拦:来源不可信的料比没有更糟(第 6 篇心智)------它会在末端以幻觉、
    越权可见的形式被召回;涉密料入口就拦,漏过去后面全是账,而且账要还很多次。
    为什么返回拒收清单而不是直接丢:哪篇被拦、为什么被拦要能对账(第 8 篇观测的采集段落点)。"""
    passed, rejected = [], []
    for s in sources:
        if s.source not in whitelist:
            rejected.append({"raw_id": s.raw_id, "reason": "source_not_whitelisted",
                             "detail": f"来源 {s.source} 不在白名单 {sorted(whitelist)}"})
            continue
        if s.sensitive:
            rejected.append({"raw_id": s.raw_id, "reason": "sensitive_blocked",
                             "detail": "涉密 / 未脱敏文档在采集入口拦截,不进流水线"})
            continue
        passed.append(s)
    return passed, rejected


# ---------- ② 清洗四道:归一 / 脱敏 / 校验 / 去重 ----------

_HTML_TAG_RE = re.compile(r"<[^>]+>")
_WS_RE = re.compile(r"[ \t ]+")
_NL_RE = re.compile(r"\n{2,}")


def normalize(text):
    """清洗第 1 道:归一------去 HTML 残渣、压空白、统一换行。
    为什么归一要放最前面:噪音不归一,后面去重和检索会被空格 / tag 差异骗出"假不重复",
    同一篇料换个格式就当成两份,召回位白白被占。"""
    if not text:
        return ""
    t = _HTML_TAG_RE.sub(" ", text)
    t = t.replace("\r\n", "\n").replace("\r", "\n")
    t = _WS_RE.sub(" ", t)
    t = _NL_RE.sub("\n", t)
    return t.strip()


_PATTERNS = [
    (re.compile(r"1[3-9]\d{9}"), lambda m: m.group()[:3] + "****" + m.group()[-4:]),
    (re.compile(r"\b\d{17}[\dXx]\b"), lambda m: m.group()[:6] + "********" + m.group()[-4:]),
    (re.compile(r"[\w.+-]+@[\w-]+\.[\w.-]+"), lambda m: "***@" + m.group().split("@", 1)[1]),
]


def mask_pii(text):
    """清洗第 2 道:PII 脱敏(手机号 / 身份证 / 邮箱打码),返回 (脱敏后文本, 命中数)。
    为什么脱敏放在清洗段、而不是检索端再防:源头脱一次,后面切片 / 向量化 / 血缘全拿到
    脱敏后的文本,不用在每个下游再防一遍。demo 用正则占位,生产换 PII 识别模型
    (第 6 篇 OWASP 护栏 + 第 8 篇 PII 纪律的落点)。命中数是清洗段的观测指标。"""
    hits = 0
    for pat, repl in _PATTERNS:
        text, n = pat.subn(repl, text)
        hits += n
    return text, hits


def validate_meta(meta, required):
    """清洗第 3 道:必填元数据校验(第 7 篇 schema 闸的落点),返回 (是否过关, 缺失字段)。
    为什么缺元数据的料要直接拒收:没 doc_id / version / 密级 / 来源的料,后面的版本表、
    血缘表、权限表全填不起来------先补元数据再谈防腐坏(第 11 篇体检表的上游)。"""
    missing = [k for k in required if not str(meta.get(k, "")).strip()]
    return (not missing), missing


def content_fingerprint(text):
    """清洗第 4 道(辅助):内容指纹 = 归一化文本的 sha256 前缀。
    去重靠它(同内容进两次只留一份),"这一版和上一版差在哪"也靠它(第 11 篇换版对账)。"""
    return hashlib.sha256((text or "").encode("utf-8")).hexdigest()[:16]


def dedup(clean_docs):
    """清洗第 4 道:内容指纹去重,返回 (保留, 丢弃)。指纹相同只留先到的一份。
    为什么在源头去重:重复料会在检索 top-k 里挤满召回位,第 11 篇实测过------去重前
    answer correctness 0.57、去重后 0.76。源头拦掉一份,末端就少一次挤占。"""
    seen, kept, dropped = {}, [], []
    for d in clean_docs:
        if d.fingerprint in seen:
            dropped.append((d, seen[d.fingerprint]))
        else:
            seen[d.fingerprint] = d
            kept.append(d)
    return kept, dropped


def clean_one(raw_doc, required):
    """对单篇原始文档走清洗的前三道(归一 / 脱敏 / 校验),返回 (CleanDoc 或 None, 缺失字段, 脱敏命中)。
    为什么抽出来单用:在线增量和离线批量必须共用同一套清洗口径------两条链路清洗标准不一致,
    增量料就成了整个库的木桶短板。"""
    masked, hits = mask_pii(normalize(raw_doc.content))
    meta = {"doc_id": raw_doc.doc_id, "source": raw_doc.source,
            "version": raw_doc.version, "level": raw_doc.level}
    ok, missing = validate_meta(meta, required)
    if not ok:
        return None, missing, hits
    cd = CleanDoc(raw_id=raw_doc.raw_id, doc_id=raw_doc.doc_id, source=raw_doc.source,
                  content=masked, fingerprint=content_fingerprint(masked),
                  version=raw_doc.version, tenant=raw_doc.tenant, level=raw_doc.level,
                  product_key=raw_doc.product_key, pii_hits=hits)
    return cd, [], hits


# ---------- ③ 切片:按结构边界切,不硬切 ----------

# 切点只允许落在句末标点(。!?;换行)和句内停顿(,、)之后------这是"不把一句话切两半"的第一层保证。
_BOUNDARY_RE = re.compile(r"[。!?;\n,、]")


def _clauses_with_offsets(text):
    """把正文切成不可再分的语义单元(子句),并记下每个子句在文本里的真实起点。
    为什么先切子句再打包:只要切点永远落在标点上,任何一整句(或一整段条款)就不会被
    从中间撕开------固定字符数硬切做不到这点,它只认长度不认标点。"""
    clauses, start = [], 0
    for m in _BOUNDARY_RE.finditer(text or ""):
        seg = (text or "")[start:m.end()]
        if seg.strip():
            clauses.append((start, seg))
        start = m.end()
    tail = (text or "")[start:]
    if tail.strip():
        clauses.append((start, tail))
    return clauses


def _buf_len(buf):
    return sum(len(t) for _, t in buf)


def _mk_chunk(doc, buf):
    offset = buf[0][0]
    text = "".join(t for _, t in buf).strip()
    # chunk_id 由父文档 + 起始偏移拼成:确定性、可复现,两层相同的料切出的块 id 一致
    chunk_id = f"{doc.raw_id}#{offset}"
    return Chunk(chunk_id=chunk_id, raw_id=doc.raw_id, text=text, offset=offset,
                 doc_id=doc.doc_id, version=doc.version, tenant=doc.tenant, level=doc.level)


def chunk_by_structure(doc, max_chars=140, min_chars=40):
    """切片段:把子句贪心打包成块,超长才按边界滑窗重叠,绝不从句子中间切。
    为什么带一点重叠:相邻块交界处的子句信息两边都留一份,跨块追问时上下文不丢。
    为什么尾部超短块并进上一块:半句话独立成块 = 检索召回到一句没有主语的残句。
    反面教材见 naive_fixed_chunk()------它把"整机保修 12 个月"从中间切断。"""
    clauses = _clauses_with_offsets(doc.content)
    if not clauses:
        return []
    packed, buf = [], []
    for off, cl in clauses:
        if buf and _buf_len(buf) + len(cl) > max_chars:
            packed.append(buf)
            carry = buf[-1]                       # 重叠:把上一块尾部子句带进新块
            buf = [carry] if len(carry[1]) + len(cl) <= max_chars else []
        buf.append((off, cl))
    if buf:
        packed.append(buf)
    # 尾块太短就并回上一块,不单独成块
    if len(packed) >= 2 and _buf_len(packed[-1]) < min_chars:
        packed[-2].extend(packed.pop())
    return [_mk_chunk(doc, b) for b in packed]


def naive_fixed_chunk(text, size):
    """反面教材:固定字符数硬切。它只认长度不认标点,会把"整机保修 12 个月"从中间切断。
    放在这里不是为了用,是为了让测试拿它当对照------证明"切坏条款"是真实发生的事,
    不是危言耸听。"""
    return [text[i:i + size] for i in range(0, len(text), size)]


# ---------- ④ 向量化:确定性桩,真实模型藏接口后 ----------

def embed_deterministic(text, dim=64):
    """确定性伪向量:同一文本永远得到同一向量(可复现、可断言),不同文本向量不同。
    为什么用确定性桩:离线可跑、零依赖、不花钱、能断言;真实 embedding 换进来时,
    流水线逻辑一行不改(同第 8 篇"生产换 SDK、打点一行不改"的替换心智)。
    demo 用 64 维是为打印紧凑;生产是 3072 / 1536 / 1024 三档(见文章附录 C)。"""
    digest = hashlib.sha256((text or "").encode("utf-8")).digest()
    need = (dim // len(digest)) + 1
    raw = (digest * need)[:dim]
    vals = [(b - 127.5) / 127.5 for b in raw]
    norm = math.sqrt(sum(v * v for v in vals)) or 1.0
    return [v / norm for v in vals]


def _vector_id(text):
    """向量 id:由切片文本确定性推出。生产里这个 id 由向量库分配,demo 用它把
    "哪块切片 -> 哪个向量"这条血缘钉住。"""
    return "vec_" + hashlib.sha256((text or "").encode("utf-8")).hexdigest()[:12]


# ---------- ⑤ 版本 / 血缘 / 权限:sqlite3 三张表 ----------

def _now_iso():
    return datetime.datetime.now(datetime.timezone.utc).isoformat()


def _fingerprint_chunks(chunks):
    h = hashlib.sha256()
    for c in chunks:
        h.update(c.text.encode("utf-8"))
        h.update(b"\x1f")
    return h.hexdigest()[:16]


def _chunk_to_json(ch):
    return json.dumps({"chunk_id": ch.chunk_id, "raw_id": ch.raw_id, "text": ch.text,
                       "offset": ch.offset, "doc_id": ch.doc_id, "version": ch.version,
                       "tenant": ch.tenant, "level": ch.level}, ensure_ascii=False)


def _chunk_from_json(s):
    d = json.loads(s)
    return Chunk(chunk_id=d["chunk_id"], raw_id=d["raw_id"], text=d["text"], offset=d["offset"],
                 doc_id=d["doc_id"], version=d["version"], tenant=d["tenant"], level=d["level"])


class MetaStore:
    """元数据底座:sqlite3 三张表,把"每份料有号、来路可溯、谁可见"钉死。

    - versions:版本号 + 创建时间 + 版本指纹 + immutable + 状态。版本一旦建成就不可覆盖,
      改料只能出新版本(呼应第 11 篇"知识库不能 UPDATE 只能换版本")。
    - lineage:(version_id, chunk_id) -> 父文档 raw_id -> 向量 id -> 创建时间。
      主键带上 version_id,是为了让同一块内容在两个版本里各留一行、互不覆盖------出 V2
      不会把 V1 的血缘冲掉,换版对账才查得到"这版和上版差在哪"。第 11 篇巡检要溯源
      "这块切片从哪份料来",靠的也是它。(demo 把切片正文寄存在 payload 字段里,好让
      export 自包含;生产里正文在向量库 / 对象存储,lineage 只留 id。)
    - acl:版本 -> 租户 / 密级,检索端按权限过滤。

    为什么这三张表用 sqlite3 而不是真数据库:demo 要离线可跑、能断言。生产就是
    「DVC 管数据版本 + OpenLineage / Marquez 管血缘 + 一张 ACL 表」,纪律一条不改(附录 C)。"""

    def __init__(self, path=":memory:"):
        self.conn = sqlite3.connect(path)
        self.conn.row_factory = sqlite3.Row
        self.serving_version = None      # 当前对外服务的版本(发布指针)
        self.rebuilding = False          # 是否处在离线重建窗口
        self.pending = []                # 重建窗口内到货的在线增量隔离区
        self._init_schema()

    def _init_schema(self):
        cur = self.conn.cursor()
        cur.executescript(
            """
            CREATE TABLE IF NOT EXISTS versions(
                version_id  TEXT PRIMARY KEY NOT NULL,
                created_at  TEXT,
                fingerprint TEXT,
                immutable   INTEGER DEFAULT 1,
                state       TEXT DEFAULT 'staging'
            );
            CREATE TABLE IF NOT EXISTS lineage(
                version_id TEXT,
                chunk_id   TEXT,
                raw_id     TEXT,
                vector_id  TEXT,
                created_at TEXT,
                payload    TEXT,
                PRIMARY KEY(version_id, chunk_id)
            );
            CREATE TABLE IF NOT EXISTS acl(
                version_id TEXT,
                tenant     TEXT,
                level      TEXT,
                PRIMARY KEY(version_id, tenant)
            );
            """
        )
        self.conn.commit()

    # ---- 版本表 ----
    def put_version(self, version_id, chunks, *, state="staging", created_at=None):
        """写一个新版本。版本一旦存在就不可覆盖------重复写同一 version_id 直接报错。
        "版本不可变"是代码里的硬约束,不是靠人自觉的纪律口号(第 11 篇换版纪律在数据层的落点)。"""
        if not (version_id or "").strip():
            raise ValueError("version_id 不能为空:版本号是每份料进库的身份,空号就是没身份")
        cur = self.conn.cursor()
        if cur.execute("SELECT 1 FROM versions WHERE version_id=?", (version_id,)).fetchone():
            raise ValueError(f"版本 {version_id} 已存在且不可变:改料只能出新版本")
        created_at = created_at or _now_iso()
        fp = _fingerprint_chunks(chunks)
        cur.execute("INSERT INTO versions(version_id, created_at, fingerprint, immutable, state)"
                    " VALUES (?,?,?,?,?)", (version_id, created_at, fp, 1, state))
        for ch in chunks:
            cur.execute("INSERT OR REPLACE INTO lineage"
                        "(version_id, chunk_id, raw_id, vector_id, created_at, payload)"
                        " VALUES (?,?,?,?,?,?)",
                        (version_id, ch.chunk_id, ch.raw_id, _vector_id(ch.text), created_at,
                         _chunk_to_json(ch)))
        self.conn.commit()
        return fp

    def set_serving(self, version_id):
        """把新版本切成 serving(发布指针切过去):旧 serving 降为 retained,只读保留、可回滚。
        为什么旧版本不删:回滚 = 指针指回旧版,零重建。"""
        cur = self.conn.cursor()
        if self.serving_version and self.serving_version != version_id:
            cur.execute("UPDATE versions SET state='retained' WHERE version_id=?", (self.serving_version,))
        cur.execute("UPDATE versions SET state='serving' WHERE version_id=?", (version_id,))
        self.serving_version = version_id
        self.conn.commit()

    def get_version(self, version_id):
        row = self.conn.execute("SELECT * FROM versions WHERE version_id=?", (version_id,)).fetchone()
        return dict(row) if row else None

    def list_versions(self):
        return [dict(r) for r in self.conn.execute("SELECT * FROM versions ORDER BY created_at, version_id")]

    # ---- 血缘表 ----
    def append_chunk(self, chunk, version_id):
        """在线增量:把单块新料 append 到 serving 版本的 lineage。只 append、不重算全库------
        增量买的是"新鲜",不该触发一次全量重建(取舍点③)。"""
        if not (version_id or "").strip():
            raise ValueError("version_id 不能为空:增量料必须落到一个真实版本上,先重建出 serving 版本再追加")
        self.conn.execute(
            "INSERT OR REPLACE INTO lineage"
            "(version_id, chunk_id, raw_id, vector_id, created_at, payload) VALUES (?,?,?,?,?,?)",
            (version_id, chunk.chunk_id, chunk.raw_id, _vector_id(chunk.text),
             _now_iso(), _chunk_to_json(chunk)))
        self.conn.commit()

    def lineage_of(self, version_id, chunk_id):
        """按 (版本号, 切片号) 精确查血缘------同一块内容在两个版本里各有一行,互不覆盖。
        这是版本不可变能被验证的前提:出 V2 不会把 V1 的血缘冲掉。"""
        row = self.conn.execute(
            "SELECT raw_id, version_id, created_at FROM lineage WHERE version_id=? AND chunk_id=?",
            (version_id, chunk_id)).fetchone()
        return (row["raw_id"], row["version_id"], row["created_at"]) if row else None

    def get_lineage(self, chunk_id):
        """回溯一块切片:能查回父文档 raw_id + 所属 version_id + 创建时间。
        优先返回当前 serving 版本的血缘(检索就是对着 serving 版本做的),
        查不到再退到最近建的那版。第 11 篇换版要对账、巡检要溯源,都靠这条链。"""
        row = None
        if self.serving_version:
            row = self.conn.execute(
                "SELECT raw_id, version_id, created_at FROM lineage"
                " WHERE chunk_id=? AND version_id=?", (chunk_id, self.serving_version)).fetchone()
        if row is None:
            row = self.conn.execute(
                "SELECT raw_id, version_id, created_at FROM lineage WHERE chunk_id=?"
                " ORDER BY created_at DESC LIMIT 1", (chunk_id,)).fetchone()
        return (row["raw_id"], row["version_id"], row["created_at"]) if row else None

    def chunks_of(self, version_id):
        rows = self.conn.execute(
            "SELECT payload FROM lineage WHERE version_id=? ORDER BY rowid", (version_id,))
        return [_chunk_from_json(r["payload"]) for r in rows]

    # ---- 权限表 ----
    def set_acl(self, version_id, tenant, level):
        """给版本标租户 / 密级,检索端按权限过滤------越权可见是事故,不是小问题。"""
        self.conn.execute("INSERT OR REPLACE INTO acl(version_id, tenant, level) VALUES (?,?,?)",
                          (version_id, tenant, level))
        self.conn.commit()

    def get_acl(self, version_id):
        return {r["tenant"]: r["level"]
                for r in self.conn.execute("SELECT tenant, level FROM acl WHERE version_id=?",
                                           (version_id,))}

    # ---- 双链路隔离区 ----
    def stage_pending(self, chunk):
        """重建窗口内到货的在线增量落这儿:既不进正在重建的那一版,也不丢------
        重建完成、切换之后,增量再对齐到新版(取舍点③的代码落点)。"""
        self.pending.append(chunk)

    def drain_pending(self):
        """重建完成、serving 切到新版之后,把隔离区的增量对齐到当前 serving 版本。
        这一步是显式的、有账可查的------对齐发生在切换之后,不发生在重建之中。"""
        n = len(self.pending)
        for ch in self.pending:
            self.append_chunk(ch, self.serving_version)
        self.pending = []
        return n

    # ---- 导出 ----
    def export_bundle(self, version_id):
        """产出一个可发布的新版本快照:version_id + 切片清单 + 血缘 + ACL + 版本指纹。
        这就是交给第 11 篇换版门 / 第 3 篇灰度的输入------把第 11 篇那张待补清单
        闭环成"一个可发布的新版本"。"""
        ver = self.get_version(version_id)
        if ver is None:
            raise KeyError(f"版本 {version_id} 不存在")
        chunks = self.chunks_of(version_id)
        lineage = {c.chunk_id: self.lineage_of(version_id, c.chunk_id) for c in chunks}
        return ReleaseBundle(version_id=version_id, chunks=chunks, lineage=lineage,
                             acl=self.get_acl(version_id), fingerprint=ver["fingerprint"])


# ---------- ⑥ 双链路:离线批量重建 + 在线增量追加 ----------

def offline_rebuild(docs, store, version_id, *, cfg=None, during=None):
    """离线批量:全量重算 -> 落独立版本命名空间 -> 过门后切 serving。
    为什么重建期间要隔离在线增量:两条链路写同一份元数据表,但重建窗口里到货的新料
    绝不能混进正在重建的这版------否则重建出来的版本里新旧策略混着,比不重建更乱。
    为什么单开一个 version_id:重建产物是新版本,不是原地改老版本(版本不可变)。
    `during` 是给测试用的钩子,模拟"重建窗口里夹进来的在线增量"。"""
    cfg = cfg or {}
    max_chars = int(cfg.get("max_chars", 140))
    min_chars = int(cfg.get("min_chars", 40))
    dim = int(cfg.get("dim", 64))
    store.rebuilding = True
    try:
        if during is not None:
            during()                                   # 重建窗口内的在线增量:必落 pending
        chunks = []
        for d in docs:
            chunks.extend(chunk_by_structure(d, max_chars=max_chars, min_chars=min_chars))
        for ch in chunks:                              # 向量化段:真实 embedding 藏在此接口后
            embed_deterministic(ch.text, dim=dim)
        store.put_version(version_id, chunks)          # 版本/血缘表
        store.set_serving(version_id)                  # 过门后切 serving(门在 run_pipeline 外)
        return {"version_id": version_id, "chunks": len(chunks), "vectors": len(chunks), "dim": dim}
    finally:
        store.rebuilding = False


def online_append(doc, store, *, cfg=None):
    """在线增量:单条 / 攒批只 append、准实时、绝不重算全库。
    重建窗口内到货的料落 pending 隔离区------两条链路写同一份元数据表,但各自隔离写入,
    重建期间的增量不污染重建结果。返回 (切出的块, 每块落在哪儿)。"""
    cfg = cfg or {}
    chunks = chunk_by_structure(doc, max_chars=int(cfg.get("max_chars", 140)),
                                min_chars=int(cfg.get("min_chars", 40)))
    landed = []
    for ch in chunks:
        if store.rebuilding:
            store.stage_pending(ch)
            landed.append("pending")
        else:
            store.append_chunk(ch, store.serving_version)
            landed.append("appended")
    return chunks, landed


# ---------- 编排 ----------

def run_pipeline(raw_docs, whitelist, store, cfg=None):
    """六段编排:把"料怎么从源头一路工程化地运进粮仓"走成一个函数。
    每段各回答一个问题、各拦一类脏东西(对应正文那张"流水线六段阶段表")。"""
    cfg = dict(cfg or {})
    required = tuple(cfg.get("required_meta", ("doc_id", "source", "version", "level")))
    version_id = cfg.get("version_id", "V2")

    # ① 采集:来源白名单闸 + 涉密拦截
    passed, rejected = ingest(raw_docs, whitelist)

    # ② 清洗四道:归一 -> 脱敏 -> 校验 -> 去重(默认全开)
    cleaned, meta_rejected, pii_hits = [], [], 0
    for rd in passed:
        cd, missing, hits = clean_one(rd, required)
        pii_hits += hits
        if cd is None:
            meta_rejected.append({"raw_id": rd.raw_id, "missing": missing})
            continue
        cleaned.append(cd)
    kept, dropped = dedup(cleaned)

    # ③④⑤⑥ 离线批量重建:切片 -> 向量化 -> 版本/血缘/权限 -> 双链路隔离
    rebuild = offline_rebuild(kept, store, version_id, cfg=cfg, during=cfg.get("during"))
    store.set_acl(version_id, "tenant-default", "internal")
    for tenant, level in (cfg.get("acl") or {}).items():
        store.set_acl(version_id, tenant, level)
    bundle = store.export_bundle(version_id)

    return {
        "ingested": len(passed),
        "rejected": rejected,
        "cleaned": len(cleaned),
        "meta_rejected": meta_rejected,
        "pii_hits": pii_hits,
        "deduped": len(dropped),
        "kept": len(kept),
        "rebuild": rebuild,
        "pending_during_rebuild": len(store.pending),
        "version_id": version_id,
        "bundle": bundle,
        "store": store,
    }


# ---------- mock 数据 + 确定性结论 ----------

def build_mock_sources():
    """一批 mock 原始文档,刻意埋活靶子:1 篇来源闸外、1 篇涉密、1 组重复、
    1 篇缺必填元数据、1 份会被"固定长度硬切"切坏的保修条款(含 PII 供脱敏段命中)。"""
    warranty = (
        "X200 官方保修政策(2026 版)。适用机型:X200 标准版与 X200 Pro。"
        "整机保修 12 个月,自购买之日起算。屏幕等易损部件保修 6 个月,"
        "电池保修 24 个月且容量低于 80% 可免费更换。非人为损坏可享 2 年延保服务,"
        "需在官网激活并保留购机凭证。保修范围不含进水、进液与私自拆修。"
        "售后热线 13800138000,客服邮箱 service@x200.example.com。"
        "常见问题:保修期从什么时候开始算?从购买之日(发票日期)起算。"
        "常见问题:延保怎么激活?在官网激活页面绑定 IMEI,需在购机 30 天内完成。"
    )
    x80 = "X80 参数:屏幕 6.5 英寸,电池 5000mAh,内存 8GB,存储 256GB,售价 3999 元,支持 5G。"
    return [
        RawDoc(raw_id="RAW-X200-W", source="official", content=warranty,
               doc_id="X200-W-2026", version="v1", product_key="X200", level="public"),
        RawDoc(raw_id="RAW-X80-A", source="official", content=x80,
               doc_id="X80-SPEC", version="v1", product_key="X80"),
        RawDoc(raw_id="RAW-X80-B", source="official", content=x80,
               doc_id="X80-SPEC", version="v1", product_key="X80"),          # 同内容第二份:去重靶子
        RawDoc(raw_id="RAW-X200-INT", source="official", content="X200 内部成本与供应商名单......",
               doc_id="X200-COST", version="v1", product_key="X200",
               sensitive=True, level="secret"),                               # 涉密靶子
        RawDoc(raw_id="RAW-BLOG-01", source="random_blog", content="某博客转载的 X200 保修说法......",
               doc_id="X200-BLOG", version="v1", product_key="X200"),          # 来源闸外靶子
        RawDoc(raw_id="RAW-X220-W", source="official", content="X220 保修政策:整机保修 24 个月。",
               doc_id="X220-W-2026", version="", product_key="X220"),          # 缺 version:校验靶子
    ]


def build_demo():
    """跑全流程,打印六段每段的收 / 拦 / 放行。下面这些数字是对这份 mock 数据的
    确定性结论,不是对真实流水线的承诺------真实拦截率取决于你的文档生命周期和源头质量。"""
    sources = build_mock_sources()
    whitelist = {"official", "crm_export"}
    required = ("doc_id", "source", "version", "level")
    store = MetaStore()
    # 重建窗口里到货的一篇新品政策:先清洗,再模拟它在重建进行中追加
    late = RawDoc(raw_id="LATE-X210", source="official",
                  content="X210 新品保修政策:整机保修 18 个月,电池保修 12 个月。",
                  doc_id="X210-W-2026", version="v1", product_key="X210")
    late_clean, _, _ = clean_one(late, required)

    s = run_pipeline(sources, whitelist, store, {
        "version_id": "V2",
        "required_meta": required,
        "during": lambda: online_append(late_clean, store),
    })
    # 时序要看清:先记下"重建刚完成、增量还没对齐"时的状态,再做对齐
    rows_at_release = len(store.chunks_of("V2"))
    staged = len(store.pending)
    contained = "LATE-X210" in {c.raw_id for c in store.chunks_of("V2")}
    aligned = store.drain_pending()                    # 切换之后,增量再对齐到新版
    rows_after = len(store.chunks_of("V2"))

    print("== 数据工程底座:采集 -> 清洗 -> 切片 -> 向量化 -> 版本/血缘/权限 -> 双链路 ==")
    print(f"① 采集:收 {s['ingested']} 篇;拦 {len(s['rejected'])} 篇 "
          f"({', '.join(r['reason'] for r in s['rejected'])})")
    print(f"② 清洗:脱敏命中 {s['pii_hits']} 处 | 元数据校验拒 {len(s['meta_rejected'])} 篇 "
          f"| 去重丢 {s['deduped']} 篇(留 {s['kept']} 篇进库)")
    print(f"③ 切片:切成 {s['rebuild']['chunks']} 块(按结构边界,条款不被切两半)")
    print(f"④ 向量化:{s['rebuild']['vectors']} 个确定性向量(dim={s['rebuild']['dim']},真实 embedding 藏接口后)")
    print(f"⑤ 版本/血缘/权限:versions {len(store.list_versions())} 行 | "
          f"lineage {rows_at_release} 行 | acl {store.get_acl('V2')}")
    print(f"⑥ 双链路:重建期间追加 1 篇落 pending {staged} 块、"
          f"{'未混进' if not contained else '污染了'} V2;切换后对齐 {aligned} 块,V2 现 {rows_after} 行")
    print(f"产出:ReleaseBundle({s['version_id']}) 切片 {len(s['bundle'].chunks)} 块、"
          f"血缘 {len(s['bundle'].lineage)} 条、ACL {s['bundle'].acl},指纹 {s['bundle'].fingerprint}")
    print("\n确定性结论:采集拦 2 篇(1 来源闸外 + 1 涉密)、校验拒 1 篇、去重丢 1 篇、"
          "条款完整切块、双链路隔离(V2 不含重建期间的增量)、导出 V2。")


if __name__ == "__main__":
    import sys
    try:
        sys.stdout.reconfigure(encoding="utf-8")
    except Exception:
        pass
    build_demo()
跑 python mini_data_pipeline.py,六段每段的收/拦/放行清清楚楚:
== 数据工程底座:采集 -> 清洗 -> 切片 -> 向量化 -> 版本/血缘/权限 -> 双链路 ==
① 采集:收 4 篇;拦 2 篇 (sensitive_blocked, source_not_whitelisted)
② 清洗:脱敏命中 2 处 | 元数据校验拒 1 篇 | 去重丢 1 篇(留 2 篇进库)
③ 切片:切成 3 块(按结构边界,条款不被切两半)
④ 向量化:3 个确定性向量(dim=64,真实 embedding 藏接口后)
⑤ 版本/血缘/权限:versions 1 行 | lineage 3 行 | acl {'tenant-default': 'internal'}
⑥ 双链路:重建期间追加 1 篇落 pending 1 块、未混进 V2;切换后对齐 1 块,V2 现 4 行
产出:ReleaseBundle(V2) 切片 3 块、血缘 3 条、ACL {'tenant-default': 'internal'},指纹 <16 位十六进制>
读一遍这个输出,六段的主线就出来了:6 篇料进来,采集拦掉 2 篇(1 篇来源闸外、1 篇涉密),清洗四道又拒掉 1 篇缺元数据的、去重丢掉 1 篇重复的,剩 2 篇真料进库;切成 3 块、算了 3 个确定性向量;版本/血缘/权限各落表;双链路那段最关键------重建窗口里追加的那篇 X210 落进了 pending 隔离区,没有混进 V2,等切换完成、增量对齐之后它才进库。这些数字是对这份 mock 数据的确定性结论,不是对真实流水线的承诺:真实拦截率取决于你的文档生命周期和源头质量。
接着看 7 个断言。release/test_mini_data_pipeline.py:
python
"""
7 个断言锁死"数据工程底座不是'文档洗干净再入库'的提醒,是一条能落地的进料流水线":
来源闸 + 涉密在采集入口拦 / 同内容进两次只留一份 / 条款不被切两半 /
血缘可溯 / 双链路不互相污染 / 版本不可变 / export_bundle 接住换版门。
纯标准库 + assert:
    python test_mini_data_pipeline.py
    # 或 pytest test_mini_data_pipeline.py
"""
from mini_data_pipeline import (
    MetaStore, RawDoc, ReleaseBundle, build_mock_sources, chunk_by_structure,
    clean_one, dedup, naive_fixed_chunk, ingest, offline_rebuild, online_append,
    run_pipeline,
)

WHITELIST = {"official", "crm_export"}
REQUIRED = ("doc_id", "source", "version", "level")


def _prepared_docs():
    """走一遍采集 + 清洗,给出进库的干净文档------测试各断言复用同一份输入。"""
    passed, rejected = ingest(build_mock_sources(), WHITELIST)
    cleaned = []
    for rd in passed:
        cd, missing, _ = clean_one(rd, REQUIRED)
        if cd is not None:
            cleaned.append(cd)
    kept, dropped = dedup(cleaned)
    return kept, rejected, dropped


def test_source_gate_and_sensitive_blocked_at_ingest():
    """断言①:来源闸 + 涉密拦截在采集入口生效(第 6 篇心智在源头落地)。
    白名单外的来源、sensitive=True 的料被 ingest() 拦在流水线外、不进 raw_docs;
    拒收清单里能对账到"哪篇为什么被拦"------采集入口是唯一能拦不可信 / 涉密料的闸。"""
    passed, rejected = ingest(build_mock_sources(), WHITELIST)
    passed_ids = {d.raw_id for d in passed}
    assert "RAW-BLOG-01" not in passed_ids          # 来源闸外的料没进流水线
    assert "RAW-X200-INT" not in passed_ids         # 涉密料没进流水线
    reasons = {r["raw_id"]: r["reason"] for r in rejected}
    assert reasons["RAW-BLOG-01"] == "source_not_whitelisted"
    assert reasons["RAW-X200-INT"] == "sensitive_blocked"
    assert len(rejected) == 2
    # 拒收不是静默丢弃:每条拒收带 raw_id + reason + detail,可对账
    assert all(r["detail"] for r in rejected)


def test_dedup_same_content_kept_once():
    """断言②:同一份内容进两次只留一份(源头去重,对应取舍点①)。
    两份内容指纹相同的文档,dedup() 后只留一份------垃圾进垃圾出,能在源头拦就拦。"""
    kept, _rejected, dropped = _prepared_docs()
    x80 = [d for d in kept if d.product_key == "X80"]
    assert len(x80) == 1                            # 同内容两份只留一份
    assert len(dropped) == 1
    # 丢的那份和留的那份指纹相同(是同一份内容,不是两条不同料)
    assert dropped[0][0].fingerprint == dropped[0][1].fingerprint


def test_chunk_never_splits_clause():
    """断言③:条款不被切断(对应取舍点②)。chunk_by_structure() 把"整机保修 12 个月"
    完整落在一块里、不跨块;对照组证明"按固定字符数硬切"确实会把它切两半。"""
    kept, _, _ = _prepared_docs()
    doc = next(d for d in kept if d.raw_id == "RAW-X200-W")
    chunks = chunk_by_structure(doc, max_chars=140, min_chars=40)
    assert len(chunks) >= 2                          # mock 正文够长,确实切成了多块
    # 有块同时含"整机保修"和"12 个月"------这句话完整落在一块里
    assert any("整机保修" in c.text and "12 个月" in c.text for c in chunks)
    # 没有任何块把这句话拆开:一个块里有"整机保修"就必然也有"12 个月"
    for c in chunks:
        assert ("整机保修" in c.text) == ("12 个月" in c.text)
    # 对照组:固定字符数硬切,恰好从"整机保修"和"12 个月"中间下刀,把它切两半
    text = doc.content
    idx = text.index("整机保修 12 个月")
    naive = naive_fixed_chunk(text, idx + len("整机保修"))
    half = [s for s in naive if "整机保修" in s and "12 个月" not in s]
    assert half, "对照组应当证明硬切会把条款切两半"


def test_lineage_traceable():
    """断言④:血缘可追溯。任意一块切片 get_lineage(chunk_id) 能回溯到父文档 raw_id +
    所属 version_id + 创建时间------第 11 篇巡检要溯源、换版要对账"这版差在哪",靠这张血缘表。"""
    store = MetaStore()
    s = run_pipeline(build_mock_sources(), WHITELIST, store, {"version_id": "V2", "required_meta": REQUIRED})
    bundle = s["bundle"]
    assert len(bundle.chunks) >= 2
    for ch in bundle.chunks:                         # 每一块都能回溯
        lin = store.get_lineage(ch.chunk_id)
        assert lin is not None
        raw_id, version_id, created_at = lin
        assert raw_id == ch.raw_id                   # 切片的父文档对得上
        assert version_id == "V2"
        assert created_at
    x200 = next(c for c in bundle.chunks if c.raw_id == "RAW-X200-W")
    assert store.get_lineage(x200.chunk_id)[0] == "RAW-X200-W"


def test_dual_link_isolation():
    """断言⑤:离线批量 + 在线增量双链路不互相污染(对应取舍点③)。重建启动后 online_append
    落 pending 隔离区,offline_rebuild 出的新版本不含重建期间追加的料;切换之后增量再对齐。"""
    kept, _, _ = _prepared_docs()
    store = MetaStore()
    late = RawDoc(raw_id="LATE-X210", source="official",
                  content="X210 新品保修政策:整机保修 18 个月,电池保修 12 个月。",
                  doc_id="X210-W-2026", version="v1", product_key="X210")
    late_clean, _, _ = clean_one(late, REQUIRED)

    offline_rebuild(kept, store, "V2", during=lambda: online_append(late_clean, store))

    v2_ids = {c.raw_id for c in store.chunks_of("V2")}
    assert "LATE-X210" not in v2_ids                 # 重建期间追加的料没污染 V2
    staged = len(store.pending)
    assert staged >= 1                               # 它落在隔离区、没丢
    # 切换之后对齐:增量才进 serving 版本
    aligned = store.drain_pending()
    assert aligned == staged                         # 对齐数 = 隔离区条数
    assert store.pending == []
    v2_ids_after = {c.raw_id for c in store.chunks_of("V2")}
    assert "LATE-X210" in v2_ids_after               # 对齐后增量进了 V2


def test_version_immutable():
    """断言⑥:版本不可变(呼应第 11 篇"知识库不能 UPDATE 只能换版本")。出 V2 后,
    V1 在 versions 表里只读保留、内容指纹不变;想改料只能再出下一个版本。"""
    kept, _, _ = _prepared_docs()
    store = MetaStore()
    offline_rebuild(kept, store, "V1")
    fp1 = store.get_version("V1")["fingerprint"]
    offline_rebuild(kept, store, "V2")
    v1 = store.get_version("V1")
    assert v1 is not None                            # 旧版本只读保留
    assert v1["immutable"] == 1
    assert v1["fingerprint"] == fp1                  # 指纹不变
    assert v1["state"] == "retained"                 # 降级为保留态,仍可回溯 / 回滚
    assert store.get_version("V2")["state"] == "serving"
    # V1 的血缘也没被 V2 冲掉:同一块内容在两个版本里各留一行
    cid = store.chunks_of("V1")[0].chunk_id
    assert store.lineage_of("V1", cid)[1] == "V1"
    # 想原地改 V1:直接报错------版本不可变是硬约束,不是纪律口号
    try:
        store.put_version("V1", [])
        raise AssertionError("V1 不该被覆盖:版本不可变")
    except ValueError:
        pass


def test_export_bundle_catches_release_gate():
    """断言⑦:产出能被第 11 篇换版门接住(闭环待补清单)。export_bundle() 输出带
    version_id + 切片 + 血缘 + ACL 的 ReleaseBundle,结构上就是换版门 / 灰度上线要的输入。"""
    store = MetaStore()
    s = run_pipeline(build_mock_sources(), WHITELIST, store, {"version_id": "V2", "required_meta": REQUIRED})
    b = s["bundle"]
    assert isinstance(b, ReleaseBundle)
    assert b.version_id == "V2"
    assert len(b.chunks) >= 2
    assert b.fingerprint                             # 版本指纹:换版对账用
    # 血缘齐:每块切片都有回溯记录,且能对回父文档
    assert len(b.lineage) == len(b.chunks)
    assert all(b.lineage[c.chunk_id][0] == c.raw_id for c in b.chunks)
    # ACL 齐:检索端能按权限过滤
    assert "tenant-default" in b.acl and b.acl["tenant-default"]
    # 换版门能拿到"这版从哪来":切片 -> 父文档 -> 版本,一条链闭合
    assert {c.raw_id for c in b.chunks} == {"RAW-X200-W", "RAW-X80-A"}


if __name__ == "__main__":
    import sys
    try:
        sys.stdout.reconfigure(encoding="utf-8")
    except Exception:
        pass
    test_source_gate_and_sensitive_blocked_at_ingest()
    test_dedup_same_content_kept_once()
    test_chunk_never_splits_clause()
    test_lineage_traceable()
    test_dual_link_isolation()
    test_version_immutable()
    test_export_bundle_catches_release_gate()
    print("全部 7 个断言通过:来源闸拦料 / 去重 / 切片不切坏边界 / 血缘可溯 / "
          "双链路不污染 / 版本不可变 / bundle 接住换版门")
跑 python test_mini_data_pipeline.py,全绿。7 个断言对应六段的六条承诺,其中两条最有分量:
断言③用对照组把"切坏条款"钉死了。 它不只检查 chunk_by_structure 把"整机保修 12 个月"完整落在一块里,还拿 naive_fixed_chunk 在"整机保修"和"12 个月"中间下刀,断言硬切确实切出了半截------把踩坑记录里那个"用户问整机保修多久、模型答'提供保修服务'"的场景,压缩成了两行可复现的断言。想亲手验证这刀很容易:把切块逻辑换成固定字符数硬切、并让刀正好落在整机保修和 12 个月之间(测试里的 naive_fixed_chunk 就是这么切 48 个字符的),断言③当场红。
断言⑤是取舍点③的代码证据。 offline_rebuild 带着 during 钩子(模拟重建窗口里夹进来的在线增量)跑完,断言新版本 V2 里没有 LATE-X210 这篇料、但隔离区里有 ,等 drain_pending() 对齐之后才进 V2。双链路隔离不是口号------重建期间增量必须落隔离区,切换之后才对齐,一条断言把"重建反而把库搅乱"那条路堵死。
四、踩坑记录:这三个坑,每个都真付过费
4.1 手补一篇料花半天,第二天又来三篇
症状:第 11 篇巡检报缺 X200、X210、X220 三款新品政策,我一条条上官网下载、转文本、手动入库,一天过去了;第二天待补清单又涨了三条,而且我漏了记版本号------补进来的料没打 doc_id、没打版本、没有血缘,第 11 篇要换版时根本找不到"这版和上版差在哪"。
排查:根因不是我手速慢,是我没有采集链路。每批料都从"下载 PDF"重走一遍,而且没人管版本和血缘------料进来了,身份是空的。这就像往仓库里搬货不进台账:货是搬进来了,可你查不到它是谁搬的、哪一批、和上一批差在哪。
修复:建采集段,把待补清单变成采集任务、入口设来源闸、采集即打版本号与血缘。demo 里 ingest() 顺手把 doc_id/version/密级/来源钉住,就是这条教训的落点。教训:缺的不是这一批料,是能把料持续运进来的流水线------补料靠手,永远补不过上游的出料速度。
4.2 全量重建撞上在线增量,索引里新旧混着
症状:某次我跑全量重建(换了切片策略),重建跑了两小时,期间在线增量任务还在往索引里追加新料。重建结束时索引里混着"新策略的旧料 + 旧策略的新料",检索命中忽新忽旧,比第 11 篇的"软下架不彻底"更阴------那个至少还能看出旧料没下架,这个是同一批料策略都混了,肉眼根本看不出来。
排查:根因是两条链路共用一张索引、互相没隔离。离线批量重建期间,在线增量要么被挡、要么落到下一版,绝不能混进正在重建的这版。我当时把它当成"两个任务各跑各的",其实它们共用一张索引,物理上就没法各跑各的。
修复:双链路隔离------重建时设一个 rebuilding 开关,在线追加落独立隔离区 pending,重建完成、过门、切换之后,增量再对齐到新版。demo 里 offline_rebuild 的 rebuilding 开关加 drain_pending() 就是这条。教训:双链路不是两条流水线的简单叠加,是"重建期间增量不污染"的隔离纪律------省掉隔离,重建反而把库搅得更乱。
4.3 切片贪省事按固定字符数硬切,把保修条款切两半
症状:用户问"X200 整机保修多久",模型答"提供保修服务"------没说几个月。我一开始以为是把关不严,翻日志才发现模型没答错,是它拿到的料就是半句。
排查切片日志:那句"整机保修 12 个月"被从中间切断,"整机保修"落在块 A、"12 个月"落在块 B,检索按得分只召回了块 A,数字在块 B 没被召回。根因就是固定字符数硬切,不管语义边界------它只认长度不认标点,切到哪儿算哪儿。
修复:按文档类型分层切,条款按语义段完整切,边界对齐不切坏一句话;重建后过第 2 篇检索回归确认召回没退化。demo 里 chunk_by_structure 只在下标点上切、naive_fixed_chunk 专门留给测试当反面教材,就是这条。教训:切片不是"把长文切短",是"按语义边界切块"------硬切省下的调试时间,会用检索召半句、答半截还回来。
五、选型对比:三条路线、工具现状、7 问清单
5.1 大表:文档流水线三条路线
| 方案 | 建设成本 | 六段覆盖 | 与 RAG 的贴合度 | 维护成本 | 适用规模 |
|---|---|---|---|---|---|
| 散装脚本(每个数据源一个脚本,跑完拉倒) | 最低,随手写 | 基本只覆盖采集/清洗,切片随手切、无版本无血缘无双链路 | 低:每来一批料重走一遍,切块语义没约束 | 低但会崩:料一多、源一多就散架,改了哪份料查不到 | 几十份文档、临时验证 |
| 通用 ETL/大数据平台(数仓路线) | 高:一套调度 + 数仓建模 | 采集/清洗强,切片/向量化/向量库不是主场 | 低:为结构化数据设计,管不了非结构化切块语义 | 中高:为表设计,硬塞文档当表处理会很别扭 | 结构化数据为主、非结构化只是附属 |
| 专用数据流水线(本篇 demo 就是最小实现) | 中:六段一次性搭好、按需开关 | 六段全覆盖:采集/清洗/切片/向量化/版本血缘/双链路 | 高:专为"非结构化文档 → 可检索知识库"服务 | 中:规则/策略可版本化,问题可对账到段 | 文档量大且更新频繁,把数据底座当基础设施 |
结论:散装脚本是"一次性打补丁",通用数仓是"用大炮打蚊子",专用数据流水线是"为 RAG 知识库量身定做的进料口"。 缺料要靠采集段,脏料要靠清洗段,召回精度要靠切片段,一致性要靠双链路------这四件事通用数仓都不管,散装脚本都管不好。小团队别被"六段"吓住:它可以渐进搭------先跑通采集 + 清洗 + 切片(料能干净入库),版本/血缘和双链路随规模补,不必一上来就上全套调度框架。
5.2 副表:可落地的工具现状(2026 已核实)
| 环节 | 工具/版本 | 选型定位 |
|---|---|---|
| 解析(采集上游) | Unstructured 0.23.1/0.24.0(Apache-2.0,25~64+ 文档格式转结构化 Element,partition 策略 auto/fast/hi_res/ocr_only) | 多格式 + 富元数据场景主推;备选 LlamaParse(商业)、Docling、PyMuPDF |
| 清洗/切片 | LangChain/LlamaIndex 的 text splitter、Unstructured 的 chunking(basic/by_title/by_similarity) | 生态胶水层;demo 里的 chunk_by_structure 生产就换成这层 |
| 向量化 + 入库 | embedding 模型(3072/1536/1024 三档)+ 向量库 Qdrant(alias 原子切)/Milvus 3.0(轻量 Snapshot)/pgvector(MVCC) | demo 的 embed_deterministic 换成 embedding、MetaStore 的向量侧换成向量库 |
| 版本/血缘 | DVC 3.67.1 管数据版本 + OpenLineage spec 2-0-2 + Marquez 0.50.0 管血缘 | demo 的 versions/lineage 两表的生产化落点 |
| 双链路 | 批处理框架 vs 流式/CDC | offline_rebuild → 批处理任务、online_append → 增量任务 |
| 编排 | Apache Airflow 3.3.1/Dagster 1.13.21/Prefect 3.8.5 | Airflow 是存量默认(重)、Dagster 血缘内建(对版本/血缘段最顺手)、Prefect 轻量 Python 优先(管增量任务顺手) |
一句话收口:demo 里 MetaStore(sqlite3)的 versions/lineage/acl 三张表,生产就是"DVC 管数据版本 + OpenLineage/Marquez 管血缘 + 一张 ACL 表";offline_rebuild/online_append 就是批处理任务 vs 增量任务;解析换 Unstructured、编排换 Airflow/Dagster/Prefect------流水线六段的逻辑一行不改。 换的始终是接口后面那层实现,编排骨架一行不动。
5.3 可复用 checklist:RAG 数据工程底座 7 问
- 料从哪来、有没有采集链路(还是人肉下载)? 没有 → 先建采集,别的都白搭。
- 采集入口有没有来源闸和涉密拦截? 没有 → 不可信的料会以幻觉形式进库,涉密料会越权可见。
- 清洗的脱敏/校验/去重做了几道? 一道没有 → 脏料直通检索端。
- 切片按不按文档类型分层、会不会把一句话切两半? 硬切 → 召回半句、答半截。
- 每份料有没有版本号 + 血缘(切片能回溯到父文档)? 没有 → 第 11 篇换版时找不到"这版差在哪"。
- 权限(租户/密级)在入库时标了吗、检索端按权限过滤吗? 没有 → 越权可见是事故。
- 离线批量 + 在线增量是两条链路还是混着跑、重建期间隔离了吗? 混着跑 → 重建把库搅得更乱。
六、总结 + 下一篇预告
回到第 11 篇那张待补清单。同样一张清单,这次不用手补了:料从采集段进来、清洗段拦掉脏的、切片段按语义切、向量化段批量入库、版本/血缘/权限段给每份料上号上痕上权限、双链路各走各的,产出 V_{k+1} 交给第 11 篇换版门。清单还是那张清单,但它从"我一天补不动的体力活",变成了"流水线自己会跑的进料口"。第 11 篇给的是"粮仓会烂、要体检要换血"的运营纪律,本篇给的是"补粮的流水线"------纪律解决"烂了怎么办",地基解决"料怎么持续运进来"。
但料运进来了,问题还没完。我把 4.1 那三条都拆进了这条流水线------第一条(标准化全链路数据流水线)是采集、清洗、切片、向量化四段,第二条(数据版本、血缘、权限全生命周期管理)是版本/血缘/权限那段,第三条(离线批量更新、在线实时增量更新双链路隔离)是双链路那段。可这三条管住的还只是数据这一层:模型版本怎么管、Prompt/数据/模型三者的版本怎么对齐、整条 LLM 应用的编排、评测、发布、运维怎么串成一条流水线,是数据这条线之上、更大的那张网。开篇里 4.2 就是那张网(LLMOps 的上位图)。下一篇《LLMOps 不完全指南》:数据底座是地基,LLMOps 是地基建起来之后,怎么把整栋楼管起来。粮仓的地基在本篇,楼怎么盖,在第 13 篇。
附录 A:流水线六段 × 输入输出 × 常见坑 × 校验规则完整表
正文那张"流水线六段阶段表"是给建设清单用的,这版给运维定规则、定观测口径。观测指标口径一律标"方向性/自己数据"------真实拦截率取决于你的文档生命周期和源头质量。
| 阶段 | 输入 → 输出 | 校验规则(可配可开关) | 常见坑 | 观测指标(方向性) |
|---|---|---|---|---|
| ① 采集 | 源头清单 + 待补清单 → 原始文档 | 来源白名单;sensitive 标拦截;必填元数据预检 | 白名单外来源混入;涉密料漏过入口;人肉下载无采集链路 | 采集成功率、应采未采数 |
| ② 清洗 | 原始文档 → 干净文档 | 归一去 HTML/压空白;PII 脱敏;元数据 schema 闸;指纹去重 | 归一漏编码残渣导致"假不重复";脱敏在检索端重复做;缺元数据入库 | 脱敏命中数、校验失败数、去重率 |
| ③ 切片 | 干净文档 → 带元数据切片 | 按标点边界切;超长滑窗重叠;尾块并入上一块;每块挂 chunk_id/raw_id/offset/version | 固定长度硬切切坏条款;块过大稀释检索信号;块过小丢上下文 | 切块数、超长块占比、平均块长 |
| ④ 向量化 | 切片 → 向量 + 索引条目 | 空文本拦截;维度一致性校验(换模型时旧新不可比) | 换 embedding 原地改导致检索空间不一致;维度不一致静默腐蚀 | 向量化成功率、批量耗时 |
| ⑤ 版本/血缘/权限 | 向量 + 元数据 → 三张表 | 版本号不可覆盖;血缘必须回溯到父文档;ACL 必填 | 无版本号换版对不了账;血缘断裂溯源不到;越权可见 | 版本覆盖率、血缘完整率 |
| ⑥ 双链路 | 全量快照/单条新料 → 新版本 | 重建期间增量落隔离区;旧版本只读保留;删除另走标记删除 | 重建与增量互踩;增量重跑全量;重建期间新旧混读 | 增量延迟、重建时长、链路隔离校验 |
附录 B:切片策略与量级推导
正文只留了白话"按文档类型分层切、别硬切",这里给量级锚点(2026 检索,公开口径,方向性,落到你的业务自己重算)。
- 切片粒度 :2026 基线是递归切约 512 token、overlap 10%~20%(微软/Azure 建议约 512 token + 10%~15% overlap 起步;Google Vertex AI RAG 默认 1024 token + 256 token overlap)。更关键的一条是块大小跟着查询类型走:事实型 query("保修多久")用 256~512 token、分析/多跳 512~1024、整段理解 1024~2048。这就是"别迷信固定 token 数一把梭"的量化依据。
- 上下文悬崖约 2.5k token:有 2026 研究说响应质量在约 2500 token 上下文之后骤降------切块过大会稀释检索信号、让模型 cherry-pick 无关行;过小(如 50 token)会切断上下文、破坏代词消解。别走两头极端。
- overlap 有分歧:有学术研究(2026-01)发现 overlap 无收益且增加索引成本,实践派称之过度设计、默认 0 overlap;产业/产品指南仍普遍建议小 overlap。稳妥口径是小 overlap 起步、拿自己数据做消融,别站队、别编死一个"最佳 overlap"。
- semantic chunking 不是自动更好:每 1 万字文档多 200~300 次 embedding 调用、成本更高,2026 基准下还跑输 recursive------所以本篇的"按结构切 + 分层"比"上语义切"更务实。
- 全量重建时长:沿用第 11 篇已核实的量级------1M 文档语料批量 embedding 约 24~48 小时、50M 向量优化后约 1~2 天、100M 朴素方案可达数月。这就是"结构性变更走离线批量、放低峰窗口"的代价账。
- 增量重算收益:一个有代表性的账是 5 万文档语料、每天 500 条变更,只重 embedding 那 500 条,比全量重建便宜约 100 倍、秒级生效------增量不是省掉全量重建的偷懒,是"重算成本随变更率缩放"的经济账。
- 增量延迟:CDC/流式增量方向性是秒级到分钟级,离线批量是小时到天级;具体延迟是"自己数据"。
附录 C:真实工具对接片段(版本已核实,2026-09)
demo 的六段逻辑一行不改,把两端换成真实工具即可。下面按段给对接方向。
python
# 解析:Unstructured 0.23.1/0.24.0(已核实),把多格式文档转成结构化 Element。
# 生产里 ingest() 的上游就是从这儿来的------不是人肉下载 PDF,是有连接器 + 解析器。
#   from unstructured.partition.auto import partition
#   elements = partition(filename="x200_warranty.pdf", strategy="hi_res")
#   # 每个 element 带 metadata(页码 / 文件类型 / 章节),正好喂给清洗段的元数据 schema 闸

# 版本 / 血缘:DVC 3.67.1 管数据版本("Git for data"),OpenLineage spec 2-0-2 + Marquez 0.50.0 管血缘。
# demo 里 MetaStore 的 versions 表 -> DVC;lineage 表 -> OpenLineage 事件 + Marquez 后端。
#   dvc add docs/            -> 生成 docs.dvc(md5 指针),git commit
#   dvc repro                -> 只重跑变更 stage(对应"增量重算随变更率缩放")
#   dvc checkout <rev>       -> 文档表回到上个版本,配合向量库 alias 回滚

# 向量化 / 入库:embedding 换成真模型(3072/1536/1024 三档),向量库换成 Qdrant/Milvus/pgvector。
# demo 的 embed_deterministic -> 真 embedding;MetaStore 的向量侧 -> 向量库。
#   text-embedding-3-large 3072 维(Matryoshka 可降到 256~3072);3-small 1536;BGE-M3 1024(开源多语)。
#   Matryoshka 降维 3072 -> 1024 只损失约 2%~4% 质量、存储省 67% ------
#   维度是存储/质量之间的一个旋钮,但换维度 = 换版本,不原地改(第 11 篇换版纪律)。

# 编排:Airflow 3.3.1 / Dagster 1.13.21 / Prefect 3.8.5。
#   offline_rebuild -> 一个批处理 DAG(低峰窗口跑);online_append -> 一个增量任务(准实时)。
# 血缘内建优先 Dagster;存量团队用 Airflow;轻量 Python 优先用 Prefect。一句话收口:MetaStore(sqlite3)的三张表生产化就是「DVC + OpenLineage/Marquez + 一张 ACL 表」,offline_rebuild/online_append 就是批处理任务 vs 增量任务,解析换 Unstructured、编排换 Airflow/Dagster/Prefect------六段逻辑一行不改。
附录 D:demo 确定性向量化桩与去重指纹的最小算法说明
demo 用的是纯标准库够用的确定性近似,不是真实 embedding,也不是精确语义去重。
- 内容指纹 :
content_fingerprint= 归一化文本的 sha256 前 16 位十六进制。它管两件事------去重(同内容进两次只留一份)和换版对账("这版和上版差在哪")。为什么用哈希而不是相似度判重:demo 要的是"同一份内容"的精确去重,哈希最快最确定;真实生产里"同义改写"("保修期一年"vs"保修 12 个月")哈希抓不到,得换 embedding 相似度。 - 确定性伪向量 :
embed_deterministic(text, dim=64)把文本 sha256 摘要的字节铺满dim个分量、归一化成单位向量。同一文本永远得到同一向量(可复现、可断言),不同文本向量不同。为什么"确定性桩"够用:它证明的是流水线结构(切片 → 向量 → 血缘 → 入库)跑得通、可复现,不是向量质量;真实 embedding 换进来,逻辑一行不改。demo 用 64 维只为打印紧凑,生产是 3072/1536/1024 三档。 - 切片边界 :
_BOUNDARY_RE只认句末标点(。!?;换行)和句内停顿(,、),子句先切出来、再贪心打包成块------所以任何一整句(或一整段条款)不会被从中间撕开。naive_fixed_chunk是反面教材,它只认长度不认标点,会把"整机保修 12 个月"切两半。为什么带一点重叠:相邻块交界处的子句两边都留一份,跨块追问时上下文不丢。尾部超短块并进上一块,避免半句话独立成块。 - 版本不可变为什么要靠主键 :
lineage的主键是(version_id, chunk_id)------同一块内容在两个版本里各留一行、互不覆盖。如果只拿chunk_id当主键,出 V2 时会把 V1 的血缘冲掉,换版对账就成了空话。版本不可变不只是versions表拒绝覆盖,也是血缘表能按版本各留一份。 - 双链路隔离的最小实现 :
MetaStore.rebuilding是真假值开关,online_append见它为真就落pending隔离区,offline_rebuild结束后由drain_pending()显式对齐。为什么隔离区要显式对齐、不自动混进去:对齐发生在切换之后,有账可查;自动混进去就等于把重建期间的新料算进重建结果,那是把库搅乱的根源。
🎯 更多专栏系列文章可以查看博客主页📑 👍 若文章对你有所触动,恳请点赞 ⭐ 关注 ⭐ 收藏