目录
- 前言
- [一、HttpRequest 与 Response 的设计思想](#一、HttpRequest 与 Response 的设计思想)
- [1.1、从 TCP 数据到 HTTP 请求对象](#1.1、从 TCP 数据到 HTTP 请求对象)
- [1.2、为什么需要 HttpResponse](#1.2、为什么需要 HttpResponse)
- [1.3、HttpRequest 与 HttpResponse 到底应该保存什么](#1.3、HttpRequest 与 HttpResponse 到底应该保存什么)
- 1.4、为什么不直接使用一个字符串保存整个请求
- [HttpRequest 与 Response 的代码实现](#HttpRequest 与 Response 的代码实现)
- [2.1、HttpRequest 的代码实现](#2.1、HttpRequest 的代码实现)
- 2.2、HttpResponse的代码实现
- 结语
前言
在前面的文章中,我们已经完成了 Reactor 服务器的核心部分,并通过 TcpServer 将 EventLoop、Acceptor、Connection 等模块串联起来,使我们的服务器具备了高并发处理 TCP 连接与网络 IO 的能力。
随后,我们又补充了一个简单的 Util 工具类,将字符串分割、文件读写、URL 编解码、HTTP 状态码查询、MIME 类型查询以及路径安全校验等常用功能提取出来,为后续 HTTP 协议层的实现提供一些基础支持。
到这里,我们实际上已经把 HTTP 服务器所需要的两块基础设施准备得差不多了:
- SERVER 模块:负责建立连接、监听事件、接收数据、发送数据;
- Util 模块:负责提供 HTTP 协议处理过程中需要使用的一些通用工具。
但是问题也随之出现了。
我们的 Connection 从网络中读取到的究竟是什么?
答案很简单:一串字节。
例如客户端向服务器发送一个最简单的 HTTP GET 请求:
text
GET /index.html HTTP/1.1
Host: www.example.com
Connection: keep-alive
对于 TCP 层来说,它根本不知道什么叫 GET,也不知道什么叫 /index.html,更不知道 Host 是一个什么东西。
TCP 只负责把这些数据从客户端可靠地传输到服务器。
也就是说,在我们目前的服务器中,数据到达 Connection 之后,本质上还是一段原始的网络数据:
text
字节流
    ↓
Connection
    ↓
Buffer
    ↓
HTTP 协议解析
而从 HTTP 协议开始,我们真正关心的已经不再是这些原始字节,而是:
- 请求方法是什么?
- 请求访问的资源是什么?
- HTTP 版本是什么?
- 请求头有哪些?
- 查询参数有哪些?
- 请求正文是什么?
这就产生了一个非常现实的问题:
我们总不能让后面的业务代码自己从一大串字符串中寻找 GET、Host、Content-Length,再自己解析 /index.html 和查询参数吧?
如果真的这样做,那么随着 HTTP 功能不断增加,业务代码很快就会变成一堆字符串处理代码。
因此,我们需要在网络层和业务层之间增加一层抽象:
将 HTTP 请求从一段原始数据,转换成一个能够被程序直接理解的 C++ 对象。
这就是 HttpRequest 存在的意义。
下面是本文的整体结构导览:
Reactor 服务器核心
Util 工具类
HttpRequest 设计
HttpResponse 设计
代码实现
结语
一、HttpRequest 与 Response 的设计思想
1.1、从 TCP 数据到 HTTP 请求对象
在前面的文章中,我们一直在强调一个问题:
不同层次应该负责不同的事情。
Connection 负责连接以及网络数据的收发,Buffer 负责数据的缓冲,而 HTTP 协议层则应该负责理解这些数据究竟代表什么。
我们可以把整个过程简单理解成:
text
客户端
   ↓
HTTP请求
   ↓
TCP
   ↓
Connection
   ↓
Buffer
   ↓
HTTP协议解析
   ↓
HttpRequest
   ↓
业务代码
其中最关键的一步,就是:
text
HTTP请求
   ↓
HttpRequest
例如客户端发送:
text
GET /search?q=C%2B%2B HTTP/1.1
Host: www.example.com
Connection: keep-alive
HTTP 协议解析完成之后,我们希望得到的不是一堆零散的字符串,而是一个结构清晰的对象:
text
HttpRequest

_method   = "GET"
_path     = "/search"
_version  = "HTTP/1.1"

_params
    q → "C++"

_headers
    Host       → "www.example.com"
    Connection → "keep-alive"

_body = ""
这就是我们要设计出来的 HttpRequest 的作用,我们给它的定位是:存储 HTTP 请求信息要素,提供简单的功能性接口。
这样一来,后面的业务代码就不需要再关心 HTTP 报文具体是如何排列的。
它只需要:
cpp
request._method
request._path
request.GetHeader("Host")
request.GetParam("q")
就可以直接获取自己关心的信息。
这其实就是我们在设计协议层对象时最重要的一个思想:
把"协议格式"与"业务数据"分离。
HTTP 解析代码负责理解协议格式,而 HttpRequest 负责保存解析之后的数据。
这样一来,业务代码面对的就不再是一堆复杂的 HTTP 报文,而是一个普通的 C++ 对象。
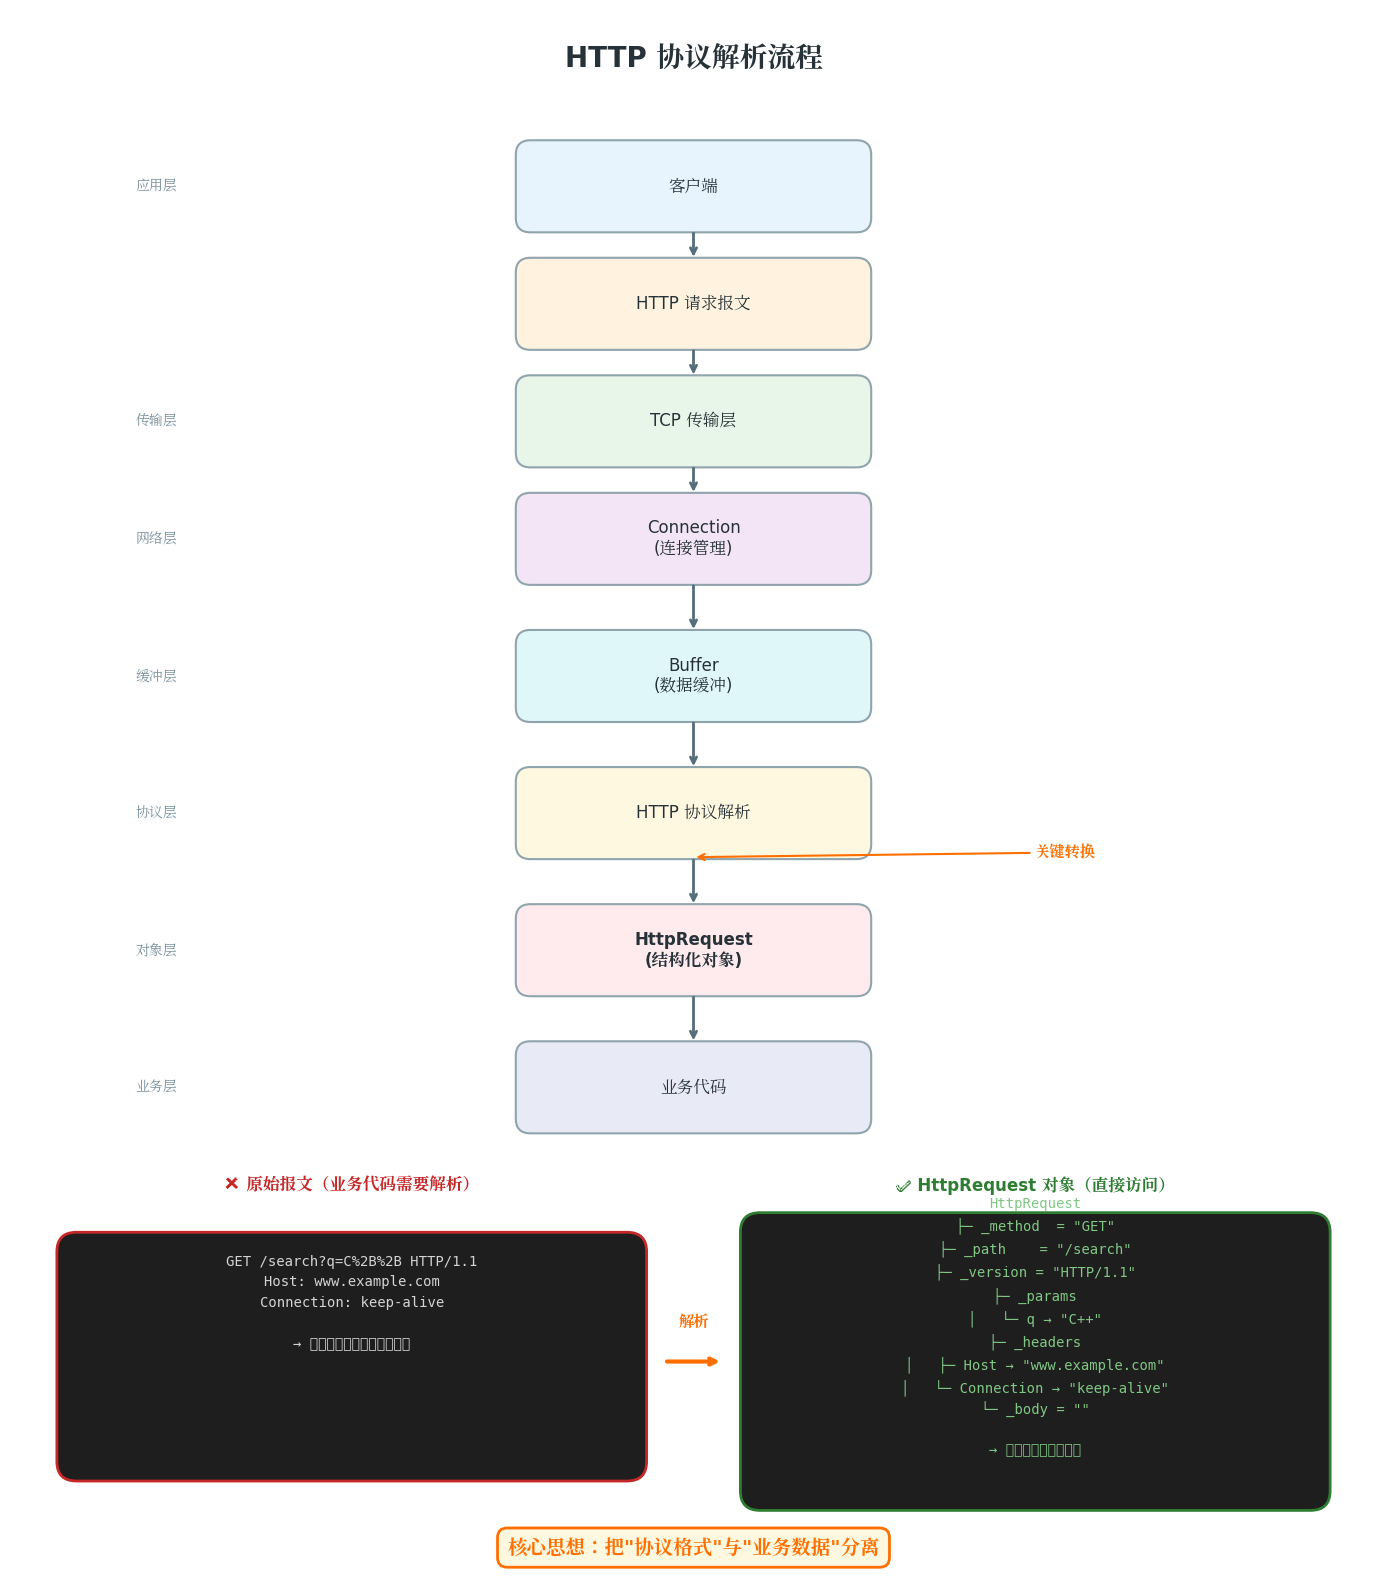
下面是 HTTP 请求从原始字节流到业务代码的完整流转过程:
客户端发送 HTTP 请求
TCP 传输
Connection 接收字节流
Buffer 缓冲数据
HTTP 协议解析
HttpRequest 对象
业务代码处理
1.2、为什么需要 HttpResponse
既然客户端发过来的是 HTTP 请求,那么服务器处理完成之后,自然还需要返回一个 HTTP 响应。
例如:
text
HTTP/1.1 200 OK
Content-Type: text/html
Content-Length: 12
Connection: keep-alive

Hello World!
和请求一样,这实际上也只是一段需要按照 HTTP 协议格式组织起来的数据。
如果没有专门的对象,我们可能需要在业务代码里手动拼接:
text
HTTP/1.1
+
200
+
OK
+
Content-Type
+
Content-Length
+
Connection
+
正文
这同样非常麻烦。
更重要的是,业务代码真正关心的其实不是:
"HTTP 响应报文应该怎么拼字符串?"
业务代码真正关心的是:
"我要返回什么状态码?"
"我要返回什么内容?"
"这个内容是什么类型?"
"我要不要进行重定向?"
所以,我们同样需要一个对象,把这些业务层想表达的信息保存下来:
text
HttpResponse

_status = 200

_headers
    Content-Type → text/html

_body = "Hello World!"
最后再由 HTTP 协议层负责把这个对象重新组织成标准的 HTTP 响应报文:
text
HttpResponse
     ↓
HTTP协议组织
     ↓
HTTP响应报文
     ↓
Connection
     ↓
客户端
于是整个 HTTP 通信过程就形成了一个非常清晰的闭环:
text
                    HTTP协议层

客户端
  ↓
HTTP请求报文
  ↓
解析
  ↓
HttpRequest
  ↓
业务处理
  ↓
HttpResponse
  ↓
组织
  ↓
HTTP响应报文
  ↓
客户端可以看到,HttpRequest 和 HttpResponse 实际上就是连接 HTTP 协议解析 与上层业务逻辑之间的桥梁。
下面是 HTTP 请求与响应的完整闭环流程:
HTTP 请求报文
解析
业务处理
组织
返回
客户端
HTTP 协议层
HttpRequest
HttpResponse
HTTP 响应报文
1.3、HttpRequest 与 HttpResponse 到底应该保存什么
在真正开始写代码之前,我们还需要思考一个问题:
一个 HTTP 请求,到底有哪些信息值得保存?
对于一个基础的 HTTP 服务器而言,我们首先需要关注以下几个部分:
text
HTTP Request
├── 请求方法 Method
├── 资源路径 Path
├── 协议版本 Version
├── 请求头 Headers
├── 查询字符串 Params
└── 请求正文 Body
因此,我们可以在 HttpRequest 中设计对应的数据成员:
cpp
std::string _method;
std::string _path;
std::string _version;
std::string _body;

std::unordered_map<std::string, std::string> _headers;
std::unordered_map<std::string, std::string> _params;
除此之外,在后续实现路由的时候,我们还可能需要从资源路径中提取正则表达式匹配结果,因此还需要保存:
cpp
std::smatch _matches;这样,一个 HTTP 请求在协议层面需要保存的主要信息就基本齐全了。
而对于响应来说,我们需要保存的信息则更加简单:
text
HTTP Response
├── 状态码 Status
├── 响应头 Headers
├── 响应正文 Body
└── 重定向信息
对应到代码中,就是:
cpp
std::string _redirect_url;

std::string _body;

std::unordered_map<std::string, std::string> _headers;
这里其实可以发现一个很有意思的地方:
Request 和 Response 并不是简单的"HTTP 报文字符串"。
它们更像是对 HTTP 报文进行了一次结构化抽象。
HTTP 报文原本是:
text
字符串 + 字符串 + 字符串 + ...经过协议层处理之后,变成:
text
HttpRequest
    ↓
结构化的数据

HttpResponse
    ↓
结构化的数据
这一步非常重要。
因为从这一刻开始,我们的业务代码终于可以摆脱 HTTP 报文的具体格式,开始以更加自然的方式处理请求。
下面是 HttpRequest 与 HttpResponse 各自保存的数据结构对比:
HttpResponse
状态码 Status
响应头 Headers
响应正文 Body
重定向信息
HttpRequest
请求方法 Method
资源路径 Path
协议版本 Version
请求头 Headers
查询字符串 Params
请求正文 Body
1.4、为什么不直接使用一个字符串保存整个请求
看到这里可能有人会产生一个疑问:
既然 HTTP 本身就是一段字符串,那我直接把整个请求保存到 std::string 里,然后业务代码需要什么再解析不就行了吗?
当然可以。
但这样做实际上会让协议解析工作不断向业务层泄漏。
例如业务代码需要获取请求方法:
text
自己找第一行
    ↓
找到第一个空格
    ↓
截取 GET
需要获取请求参数:
text
自己寻找 ?
    ↓
截取 query string
    ↓
按照 & 分割
    ↓
按照 = 分割
    ↓
URL Decode
需要获取请求头:
text
自己寻找 \r\n
    ↓
分割每一行
    ↓
寻找 :
    ↓
保存 key/value
如果每一个业务处理函数都需要重复完成这些工作,那么我们的 HTTP 协议层实际上就失去了意义。
所以我们希望做到的是:
HTTP 协议层负责"解析",业务层负责"使用"。
例如:
cpp
if (request._method == "GET")
{
    // 处理GET请求
}
或者:
cpp
std::string name = request.GetParam("name");业务代码只需要知道:
"我要获取 name 参数。"
而不需要知道:
"name 参数到底位于 URL 的哪一部分,我应该怎么找到
?,又应该怎么处理&和=。"
这就是协议封装带来的价值。
HttpRequest 与 Response 的代码实现
明确了 HttpRequest 与 HttpResponse 的作用之后,接下来就可以真正开始实现它们。
2.1、HttpRequest 的代码实现
根据以上的讲解,其实我们就已经了解了 HttpRequest 类的基本组成:
c++
class HttpRequest
{
public:
    std::string _method;  // 请求方法
    std::string _path;    // 请求的资源路径
    std::string _version; // 请求的协议版本
    std::string _body;    // 请求的正文内容

	std::smatch _matches; // 资源路径的正则提取数据

    std::unordered_map<std::string, std::string> _headers; // 用来存储头部字段的数据
    std::unordered_map<std::string, std::string> _params;  // 用来存储查询字符串的数据

public:
    HttpRequest() : _version("HTTP/1.1") {} // 构造函数,这里需要初始化一下版本号,因为在后面 httpserver 中其实会用到,到时候再细讲
    // 插入头部字段
    void SetHeader(const std::string &key, const std::string &val);
    // 判断是否存在指定头部字段
    bool HasHeader(const std::string &key)const;
    // 获取指定头部字段的值
    std::string GetHeader(std::string &key)const;

    // 插入查询字符串
    void SetParam(std::string &key, std::string &val);
    // 判断是否有某个指定的查询字符串
    bool HasParam(std::string &key)const;
    // 获取指定的查询字符串
    std::string GetParam(std::string &key)const;

    // 获取正文长度
    size_t ContentLength()const;
    // 判断是否是短链接
    bool close()const;
};
这里构造函数默认初始化版本号为 1.1,是因为后面 server 代码里可能会用到,比如到时候如果获取
变量部分唯一要关注的就是 match,它的作用就是保存我们使用正则库的接口获得的各种信息。
其中接口看着数量不少,实际上很多功能与目标都是重复的,比如六个接口加起来就是分别对头部字段与查询字符串进行插入、判断存在以及获取的操作。代码的具体实现一定是具有高度重复的!
以头部字段的相关操作为例,插入功能无非就是调用哈希表自带的insert,而判断以及获取功能都是先调用哈希表自带的find接口,获取迭代器,如果没有获取到就说明不存在,获取到了就返回真,返回迭代器对应的second就行了。
c++
// 插入头部字段
    void SetHeader(const std::string &key, const std::string &val)
    {
        _headers.insert(std::make_pair(key,val));
    }
    // 判断是否存在指定头部字段
    bool HasHeader(const std::string &key) const
    {
        auto it=_headers.find(key);
        if(it==_headers.end())
        {
            return false;
        }
        return true;//存在返回真,不存在返回假
    }
    // 获取指定头部字段的值
    std::string GetHeader(const std::string &key)const
    {
        auto it=_headers.find(key);
        if(it==_headers.end())
        {
            return "";//不存在返回空串
        }
        return it->second;
    }
而查询字符串的操作则与头部字段的操作具有高度重复性,因为其目的类似,参数类似,存储的容器一样:
c++
// 插入查询字符串
    void SetParam(const std::string &key,const std::string &val)
    {
        _params.insert(std::make_pair(key, val));
    }
    // 判断是否有某个指定的查询字符串
    bool HasParam(const std::string &key) const
    {
        auto it = _params.find(key);
        if (it == _params.end())
        {
            return false;
        }
        return true; // 存在返回真,不存在返回假
    }
    // 获取指定的查询字符串
    std::string GetParam(const std::string &key) const
    {
        auto it = _params.find(key);
        if (it == _params.end())
        {
            return ""; // 不存在返回空串
        }
        return it->second;
    }
最后两个接口,一个是获取正文的长度,这是一个字段。另外一个是判断是否为短链接,实际上也是去寻找Connection字段,我们都会通过上面的HasHeader,与GetHeader接口来判断获取。
c++
// 获取正文长度
    size_t ContentLength() const
    {
        // Content-Length: 1234\r\n
        bool ret = HasHeader("Content-Length");
        if (ret == false)
        {
            return 0;
        }
        std::string clen = GetHeader("Content-Length");
        return std::stol(clen);
    }
    // 判断是否是短链接
    bool close() const
    {
        if(HasHeader("Connection")==true&&GetHeader("Connection")=="keep-alive")
        {
            return false;//keep-alive是长连接
        }
        return true;
    }
看得出来,其实现是非常简单以及公式化的代码,我们主要的难度还是在理解上面。
最后,其实我们还应该加一个接口,用来在每一次 Request 之后,给它重置,以免被上一次的信息所影响,那么怎么重置呢?
对于大部分的变量类型,内部都自带了一个clear接口,但是对于match,并没有clear来给他使用,所以这里其实可以在函数内部定义一个临时变量match,随后二者swap一下就可以了。
c++
	//重置接口
    void ReSet()
    {
        _method.clear();
        _path.clear();
        _version = "HTTP/1.1";
        _body.clear();
        std::smatch match;
        _matches.swap(match);
        _headers.clear();
        _params.clear();
    }
2.2、HttpResponse的代码实现
至于 HttpResponse,其特点是要考虑重定向的可能,所以我们会有专门的类成员变量去记录是否启用重定向以及重定向的 URL 信息。
至于其他变量也是根据响应信息所包含的内容而定的,比如响应码,最直观的表达了本次响应的结果类型,以及响应正文,响应头部信息。
c++
class HttpResponse
{
public:
    int _statu;                                             // 状态码
    std::string _body;                                     // 响应正文
    bool _redirect_flag;                                   // 重定向标识
    std::string _redirect_url;                             // 重定向的目的url
    std::unordered_map<std::string, std::string> _headers; // 保存的响应头部字段信息

public:
    HttpResponse();
    HttpResponse(int statu);
    // 重置对象
    void Reset();
    // 设置报头字段
    void SetHeader(std::string &key, std::string &val);
    // 判断是否有某个指定的头部字段
    bool HasHeader(std::string &key);
    // 获取某个指定的头部字段
    std::string GetHeader(std::string &key);
    // 设置响应正文
    void SetContent(std::string &body, std::string &type);
    // 设置重定向目的url
    void SetRedirect(std::string &url, int statu = 302);
    // 判断是不是短链接
    bool close();
};
我们这次给 Response 重载了构造函数,一个是默认的构造,另外一个是带参的构造函数。
其中,带参的构造函数可以手动设置该次响应的状态码。
而获取头部字段的几个接口中,其目的与代码实现与之前的 Request 代码具有高度重复性,偷懒可以直接复制粘贴。在构造函数中,只有重定向标识与状态码需要我们进行一个初始化操作,其他变量的值都是自己设置的。
c++
    HttpResponse() : _redirect_flag(false), _statu(200) {}
    HttpResponse(int statu) : _redirect_flag(false), _statu(statu) {}
    // 重置对象
    void Reset()
    {
        _statu = 200;
        _body.clear();
        _redirect_flag = false;
        _redirect_url.clear();
        _headers.clear();
    }
    // 设置报头字段
    void SetHeader(const std::string &key, const std::string &val)
    {
        _headers.insert(std::make_pair(key, val));
    }

    // 判断是否有某个指定的头部字段
    bool HasHeader(const std::string &key)
    {
        auto it = _headers.find(key);
        if (it == _headers.end())
        {
            return false;
        }
        return true; // 存在返回真,不存在返回假
    }
    // 获取某个指定的头部字段
    std::string GetHeader(const std::string &key)
    {
        auto it = _headers.find(key);
        if (it == _headers.end())
        {
            return ""; // 不存在返回空串
        }
        return it->second;
    }
而设置响应正文则有点不一样,我们不止要改变 Body,还要记得在头部字段中添加该正文的类型,比如 HTML 之类的。
c++
    // 设置响应正文
    void SetContent(const std::string &body, const std::string &type)
    {
        _body = body;
        SetHeader("Content-Type", type);
    }
    // 设置重定向目的url
    void SetRedirect(const std::string &url, int statu = 302)
    {
        _redirect_flag = true;
        _redirect_url = url;
        _statu = statu;
    }
    // 判断是不是短链接
    bool close() const
	{
	    std::string connection = GetHeader("Connection");

	    // HTTP/1.1 默认长连接
	    if (_version == "HTTP/1.1")
	    {
	        if (connection == "close")
	        {
	            return true;
	        }

	        return false;
	    }

	    // HTTP/1.0 默认短连接
	    if (_version == "HTTP/1.0")
	    {
	        if (connection == "keep-alive")
	        {
	            return false;
	        }

	        return true;
	    }

	    return true;
	}
对于判断长短链接,如果发送的请求信息不包含连接类型,那我们就要通过协议来判断。一般来说,像浏览器发送的连接,协议版本 1.1 默认是长连接。
具体代码:
c++
class HttpRequest
{
public:
    std::string _method;  // 请求方法
    std::string _path;    // 请求的资源路径
    std::string _version; // 请求的协议版本
    std::string _body;    // 请求的正文内容

    std::smatch _matches; // 资源路径的正则提取数据

    std::unordered_map<std::string, std::string> _headers; // 用来存储头部字段的数据
    std::unordered_map<std::string, std::string> _params;  // 用来存储查询字符串的数据

public:
    HttpRequest() : _version("HTTP/1.1") {} // 构造函数,这个其实初不初始化都无所谓,因为后面也能获得,最常用的就是1.1版本,就默认构造一个1.1呗
    void ReSet()
    {
        _method.clear();
        _path.clear();
        _version = "HTTP/1.1";
        _body.clear();
        std::smatch match;
        _matches.swap(match);
        _headers.clear();
        _params.clear();
    }

    // 插入头部字段
    void SetHeader(const std::string &key, const std::string &val)
    {
        _headers.insert(std::make_pair(key, val));
    }
    // 判断是否存在指定头部字段
    bool HasHeader(const std::string &key) const // 只读操作,不应该修改
    {
        auto it = _headers.find(key);
        if (it == _headers.end())
        {
            return false;
        }
        return true; // 存在返回真,不存在返回假
    }
    // 获取指定头部字段的值
    std::string GetHeader(const std::string &key) const
    {
        auto it = _headers.find(key);
        if (it == _headers.end())
        {
            return ""; // 不存在返回空串
        }
        return it->second;
    }

    // 插入查询字符串
    void SetParam(const std::string &key, const std::string &val)
    {
        _params.insert(std::make_pair(key, val));
    }
    // 判断是否有某个指定的查询字符串
    bool HasParam(const std::string &key) const
    {
        auto it = _params.find(key);
        if (it == _params.end())
        {
            return false;
        }
        return true; // 存在返回真,不存在返回假
    }
    // 获取指定的查询字符串
    std::string GetParam(const std::string &key) const
    {
        auto it = _params.find(key);
        if (it == _params.end())
        {
            return ""; // 不存在返回空串
        }
        return it->second;
    }

    // 获取正文长度
    size_t ContentLength() const
    {
        // Content-Length: 1234\r\n
        bool ret = HasHeader("Content-Length");
        if (ret == false)
        {
            return 0;
        }
        std::string clen = GetHeader("Content-Length");
        return std::stol(clen);
    }
    bool close() const
	{
	    std::string connection = GetHeader("Connection");

	    // HTTP/1.1 默认长连接
	    if (_version == "HTTP/1.1")
	    {
	        if (connection == "close")
	        {
	            return true;
	        }

	        return false;
	    }

	    // HTTP/1.0 默认短连接
	    if (_version == "HTTP/1.0")
	    {
	        if (connection == "keep-alive")
	        {
	            return false;
	        }

	        return true;
	    }

	    return true;
	}
};

class HttpResponse
{
public:
    int _statu;                                            // 状态码
    std::string _body;                                     // 响应正文
    bool _redirect_flag;                                   // 重定向标识
    std::string _redirect_url;                             // 重定向的目的url
    std::unordered_map<std::string, std::string> _headers; // 保存的响应头部字段信息

public:
    HttpResponse() : _redirect_flag(false), _statu(200) {}
    HttpResponse(int statu) : _redirect_flag(false), _statu(statu) {}
    // 重置对象
    void Reset()
    {
        _statu = 200;
        _body.clear();
        _redirect_flag = false;
        _redirect_url.clear();
        _headers.clear();
    }
    // 设置报头字段
    void SetHeader(const std::string &key, const std::string &val)
    {
        _headers.insert(std::make_pair(key, val));
    }

    // 判断是否有某个指定的头部字段
    bool HasHeader(const std::string &key)
    {
        auto it = _headers.find(key);
        if (it == _headers.end())
        {
            return false;
        }
        return true; // 存在返回真,不存在返回假
    }
    // 获取某个指定的头部字段
    std::string GetHeader(const std::string &key)
    {
        auto it = _headers.find(key);
        if (it == _headers.end())
        {
            return ""; // 不存在返回空串
        }
        return it->second;
    }
    // 设置响应正文
    void SetContent(const std::string &body, const std::string &type)
    {
        _body = body;
        SetHeader("Content-Type", type);
    }
    // 设置重定向目的url
    void SetRedirect(const std::string &url, int statu = 302)
    {
        _redirect_flag = true;
        _redirect_url = url;
        _statu = statu;
    }
    // 判断是不是短链接
    bool close()
    {
        // 没有Connection字段,或者有Connection但是值是close,则都是短链接,否则就是长连接
        if (HasHeader("Connection") == true && GetHeader("Connection") == "keep-alive")
        {
            return false;
        }
        return true;
    }
};
由此可见,两个类型的代码具有高度相似性,其作用也基本一样,只不过一个是为了处理发送来的报文信息,一个是为了方便处理发送过去的响应信息。
结语
到这里,我们就完成了 HttpRequest 和 HttpResponse 两个类的设计与实现。
回顾这一部分,我们实际上并没有做什么特别复杂的事情。HttpRequest 主要负责将客户端发送过来的 HTTP 请求信息进行结构化保存,而 HttpResponse 则负责保存服务器准备返回给客户端的响应信息。
从整个服务器的角度来看,它们所处的位置可以概括为:
text
原始 HTTP 数据
     ↓
HTTP Parser
     ↓
HttpRequest
     ↓
业务处理
     ↓
HttpResponse
     ↓
HTTP Serializer
     ↓
原始 HTTP 数据
这样一来,我们就把原本杂乱的 HTTP 字符串转换成了两个更加容易操作的 C++ 对象。上层业务不需要再关心 HTTP 报文具体应该如何解析和组织,而 HTTP 协议层也不需要关心业务代码究竟要如何处理这个请求。
这其实也是我们在整个服务器项目中一直在做的事情:
让不同模块各司其职,通过清晰的接口连接起来。
前面的 EventLoop、Channel、Poller 解决的是如何监听和分发 IO 事件 ;Connection 和 Buffer 解决的是如何管理网络连接以及收发数据 ;而现在的 HttpRequest 和 HttpResponse,则开始解决如何理解这些网络数据。
下面是整个服务器项目中各模块的分工协作关系:
协议层
HttpRequest
HttpResponse
网络层
Connection
Buffer
事件驱动层
EventLoop
Channel
Poller