文章目录
- [一、DataFrame 简介](#一、DataFrame 简介)
- [二、DataFrame 基本语法](#二、DataFrame 基本语法)
-
- [2.1 DataFrame 的创建](#2.1 DataFrame 的创建)
- [2.2 DataFrame 的属性](#2.2 DataFrame 的属性)
- [2.3 DataFrame 数据访问](#2.3 DataFrame 数据访问)
- [三、DataFrame 常用函数](#三、DataFrame 常用函数)
- [四、DataFrame 案例](#四、DataFrame 案例)
一、DataFrame 简介
DataFrame 是 Pandas 最核心的 二维表格型数据结构,由行索引 (index)、列名 (columns) 和值组成。可理解成多张 Series 共用一套行索引拼接而成,类似 Excel 表格。特点如下:
- 二维结构,有行、列两个维度标签
- 每一列可以是不同数据类型(数值、字符串等)
- 支持快速筛选、分组、聚合、缺失值处理
- 可以从字典、列表、Series、csv 等多种来源创建
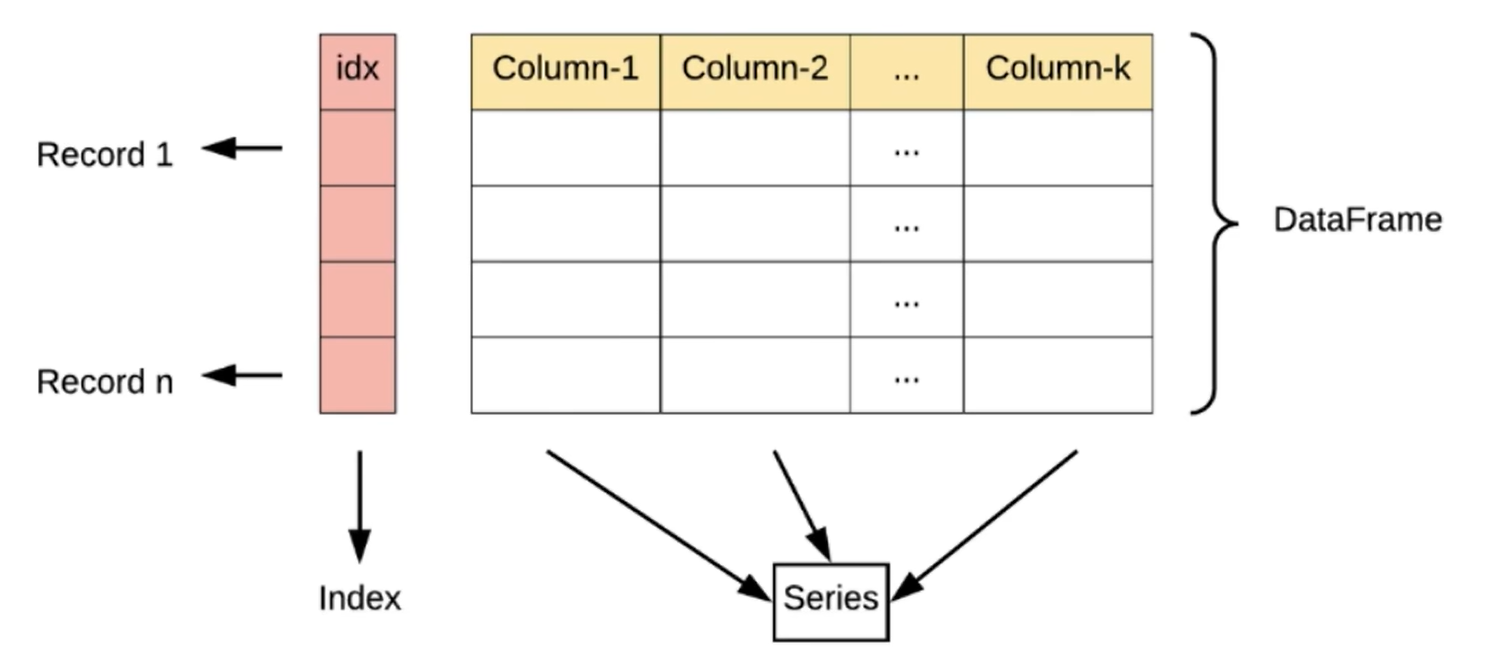
注:DataFrame 的每一列本质上就是一个 Series;后文演示默认引入 Pandas:import pandas as pd
二、DataFrame 基本语法
2.1 DataFrame 的创建
通过series创建:
python
s1 = pd.Series([1, 2, 3, 4, 5])
s2 = pd.Series([6, 7, 8, 9, 10])
df = pd.DataFrame({'第一列': s1, '第二列': s2})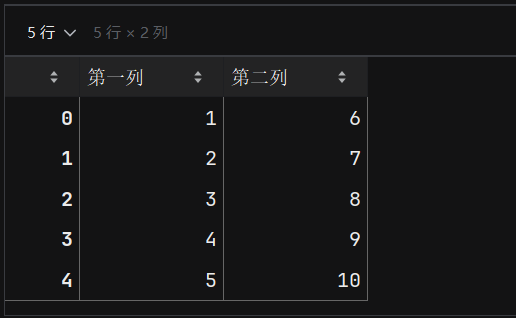
通过列表创建:
python
data_list = [
    [101, "Alice", 1200],
    [102, "Bob", 300],
    [103, "Charlie", 800]
]
df = pd.DataFrame(data_list, columns=["用户ID", "姓名", "金额"])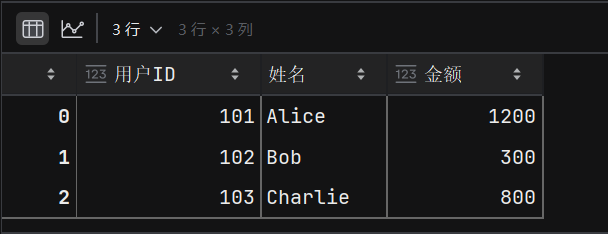
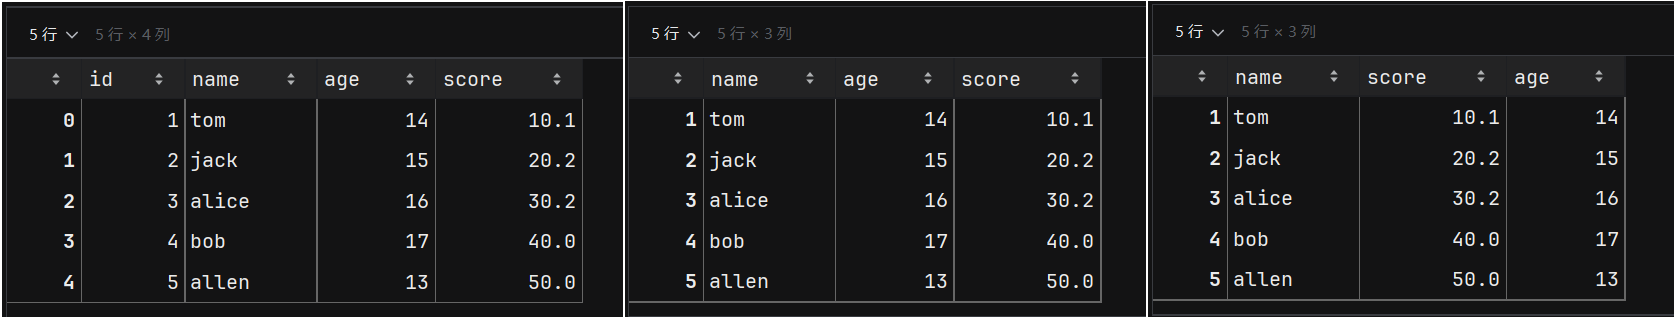
通过字典创建:
python
df = pd.DataFrame({
    "id": [1, 2, 3, 4, 5],
    "name": ["tom", "jack", "alice", "bob", "allen"],
    "age": [14, 15, 16, 17, 13],
    "score": [10.1, 20.2, 30.2, 40.0, 50]
})
df = pd.DataFrame(
    {
        "name": ["tom", "jack", "alice", "bob", "allen"],
        "age": [14, 15, 16, 17, 13],
        "score": [10.1, 20.2, 30.2, 40.0, 50]
    },
    index=[1, 2, 3, 4, 5]
)
df = pd.DataFrame(
    {
        "name": ["tom", "jack", "alice", "bob", "allen"],
        "age": [14, 15, 16, 17, 13],
        "score": [10.1, 20.2, 30.2, 40.0, 50]
    },
    index=[1, 2, 3, 4, 5],
    columns=["name", "score", "age"]  # 通过columns修改列的位置
)
2.2 DataFrame 的属性
| 属性 | 说明 | 属性 | 说明 |
|---|---|---|---|
index |
DataFrame的行索引 | loc[] |
显式索引,按行列标签索引或切片 |
values |
DataFrame的值 | iloc[] |
隐式索引,按行列位置索引或切片 |
dtypes |
DataFrame的元素类型 | at[] |
使用行列标签访问单个元素 |
shape |
DataFrame的形状 | iat[] |
使用行列位置访问单个元素 |
ndim |
DataFrame的维度 | T |
行列转置 |
size |
DataFrame的元素个数 | ||
columns |
DataFrame的列标签 |
示例代码1:
python
df = pd.DataFrame(
    {
        "name": ["tom", "jack", "alice", "bob", "allen"],
        "age": [14, 15, 16, 17, 13],
        "score": [10.1, 20.2, 30.2, 40.0, 50]
    },
    index=[1, 2, 3, 4, 5],
    columns=["name", "score", "age"]  # 通过columns修改列的位置
)

print('行索引:', df.index)    # Index([1, 2, 3, 4, 5], dtype='int64')
print('列标签:', df.columns)  # Index(['name', 'score', 'age'], dtype='str')
print('值:', df.values)
# [['tom' 10.1 14]
#  ['jack' 20.2 15]
#  ['alice' 30.2 16]
#  ['bob' 40.0 17]
#  ['allen' 50.0 13]]

print('维度:', df.ndim)        # 2
print('形状:', df.shape)       # (5, 3)
print('元素个数:', df.size)    # 15
print('数据类型:', df.dtypes)  # dtype: object
# name         str
# score    float64
# age        int64

print('转置:', df.T)
print('转置后的行索引:', df.T.index)    # Index(['name', 'score', 'age'], dtype='str')
print('转置后的列表签:', df.T.columns)  # Index([1, 2, 3, 4, 5], dtype='int64')
代码示例2:
python
# 获取行
print(df.loc[4])  # 显式
# name      bob
# score    40.0
# age        17
# Name: 4, dtype: object
print(df.iloc[3])  # 隐式,同上

# 获取列
print(df.loc[:, 'name'])  # 显示
# 1      tom
# 2     jack
# 3    alice
# 4      bob
# 5    allen
print(df.iloc[:, 0])  # 隐式,同上
代码示例3:
python
# 单个元素
print(df.at[3, 'score'])  # 显式 30.2
print(df.iat[2, 1])       # 隐式
print(df.loc[3, 'score']) # 显式
print(df.iloc[2, 1])	  # 隐式
代码示例4:
python
# 获取某列 扩展
print(df['name'])
# 1      tom
# 2     jack
# 3    alice
# 4      bob
# 5    allen
# Name: name, dtype: str

print(type(df['name']))    # <class 'pandas.Series'>
print(df.name)
print(type(df.name))       # <class 'pandas.Series'>
print(df[['name']])
print(type(df[['name']]))  # <class 'pandas.DataFrame'>
# 获取多列
print(df[['name', 'score']])注:df['name'] / df.name:单层方括号,取一列,返回 Series(一维);
df[['name']]:双层方括号,传入列名列表,返回 DataFrame(二维表格)
2.3 DataFrame 数据访问
python
# 查看部分数据
print(df.head())  # 默认前5行
#     name  score  age
# 1    tom   10.1   14
# 2   jack   20.2   15
# 3  alice   30.2   16
# 4    bob   40.0   17
# 5  allen   50.0   13

print(df.tail())  # 默认后5行
print(df.head(1))  # 前1行
print(df.tail(2))  # 后2行

# 使用布尔索引筛选
print(df[df.score > 30])
print(df[(df.score > 30) & (df.age > 16)])
print(df[(df['score'] > 30) & (df['age'] > 16)])

# 随机抽样
print(df.sample())
print(df.sample(3)) # 随机取三条注:df[布尔序列]:筛选出符合布尔序列对应的全部行
三、DataFrame 常用函数
| 方法 | 说明 | 方法 | 说明 |
|---|---|---|---|
head() |
查看前 n 行数据,默认 5 行 | max() |
最大值 |
tail() |
查看后 n 行数据,默认 5 行 | var() |
方差 |
isin() |
判断元素是否包含在参数集合中 | std() |
标准差 |
isna() |
判断是否为缺失值(如 NaN 或 None) | median() |
中位数 |
sum() |
求和,自动忽略缺失值 | mode() |
众数(可返回多个) |
mean() |
平均值 | quantile(q) |
分位数,q 取 0~1 之间 |
min() |
最小值 | describe() |
常见统计信息(count、mean、std、min、25%、50%、75%、max) |
示例代码1:
python
df = pd.DataFrame(
    {
        "name": ["tom", "jack", "alice", "bob", "allen"],
        "age": [14, 15, 16, 17, 13],
        "score": [10.1, 20.2, 30.2, 40.0, 50]
    },
    index=[1, 2, 3, 4, 5],
    columns=["name", "score", "age"]  # 通过columns修改列的位置
)

print(df.head())  # 查看前 n 行数据,默认 5 行
print(df.tail())
print(df.head(1))
print(df.tail(2))

print(df.isin(['jack', 17]))  # 查看 jack 和 17 元素是否包含在参数集合中
print(df.isna())  # 判断是否为缺失值

print(df['score'].sum())  # 某一列的总和
print(df.score.max())     # 最大值
print(df.score.min())     # 最小值
print(df.score.mean())    # 平均值
print(df.score.median())  # 中位数
print(df.mode())          # 众数
print(df.score.std())     # 标准差
print(df.score.var())     # 方差
print(df.score.quantile(0.25))  # 分位数
print(df.describe()) # 描述性信息| 方法 | 说明 | 方法 | 说明 |
|---|---|---|---|
value_counts() |
每个唯一值的出现次数 | sort_values() |
按值排序 |
count() |
非缺失值数量 | replace() |
替换值 |
duplicated() |
是否重复 | nlargest() |
返回某列最大的n条数据 |
drop_duplicates() |
去除重复项 | nsmallest() |
返回某列最小的n条数据 |
sample() |
随机抽样 | cumsum() |
返回累计和 |
replace() |
替换值 | cummax() |
返回累计最大值 |
sort_index() |
按索引排序 | cummin() |
返回累计最小值 |
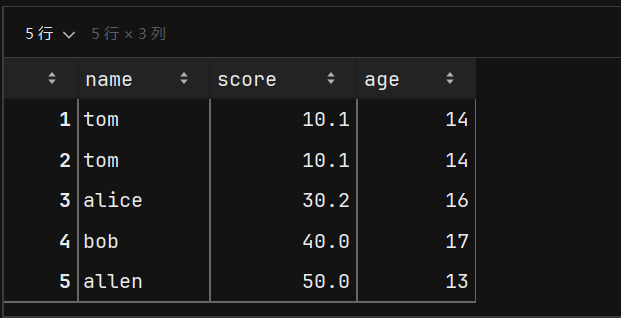
python
df = pd.DataFrame(
    {
        "name": ["tom", "tom", "alice", "bob", "allen"],
        "age": [14, 14, 16, 17, 13],
        "score": [10.1, 10.1, 30.2, 40.0, 50]
    },
    index=[1, 2, 3, 4, 5],
    columns=["name", "score", "age"]  # 通过columns修改列的位置
)
示例代码2:
python
print(df.count())  # 统计出现非缺失值的次数
print(df.score.count())
print(df.value_counts())  # 统计出现的次数
# name   score  age
# tom    10.1   14     2
# alice  30.2   16     1
# bob    40.0   17     1
# allen  50.0   13     1
# Name: count, dtype: int64

print(df.drop_duplicates())  # 去重
#     name  score  age
# 1    tom   10.1   14
# 3  alice   30.2   16
# 4    bob   40.0   17
# 5  allen   50.0   13

print(df.duplicated())  # 检查是否重复
# 1    False
# 2     True
# 3    False
# 4    False
# 5    False
# dtype: bool
print(df.duplicated(subset=['score']))  # 只检查某一列是否重复,结果同上
print(df.sample(2))  # 随机采样
print(df.replace(17, 777))  # 替换值
示例代码3:
python
print(df.sort_index(ascending=False))  # 按照索引排序
print(df.sort_values(by='name', ascending=False))  # 按照值排序
print(df.sort_values(by='score', ascending=False))

# 按照score和age两个维度排序
# 后面设置 ascending=False 表示:先按照score降序,如果score相同,则age降序
print(df.sort_values(by=['score', 'age'], ascending=False))

# 按照score和age两个维度排序
# 后面设置 ascending=[True, False] 表示:先按照score升序,如果score相同,则age降序
df.sort_values(by=['score', 'age'], ascending=[True, False])

# 参照score和age两个标准取最大的2个数据,如果score相同,再参照 age
df.nlargest(2, columns=['score', 'age'])
df.nsmallest(2, columns=['score', 'age']) # 取最小的2个数据
示例代码4:
python
df = pd.DataFrame(
    {
        "name": ["A", "B", "C", "D"],
        "age": [11, 12, 13, 14],
        "score": [10.0, 20.0, 30.0, 40.0]
    },
    index=[1, 2, 3, 4],
    columns=["name", "score", "age"]  # 通过columns修改列的位置
)
print(df.cumsum())  # 累计和
print(df.cummax())  # 累计最大值 从上到下查看直到最大值
print(df.cummin())  # 累计最小值
# print(df.cummin(axis=1)) # axis=1表示按行累计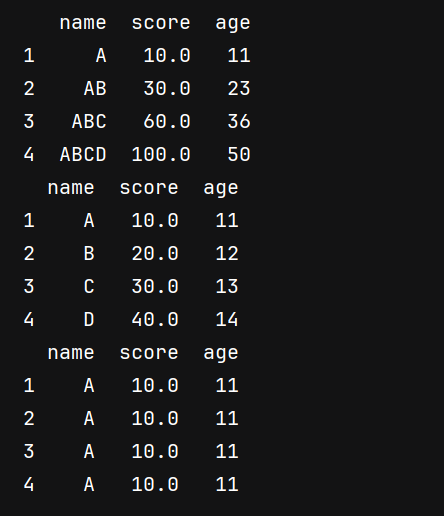
注:axis=0:按列方向纵向运算(默认) ,上下行之间计算;axis=1:按行方向横向运算,左右列之间计算
四、DataFrame 案例
案例1:学生成绩分析
python
'''
案例1:学生成绩分析
场景:某班级的学生成绩数据如下,请完成以下任务:
1.计算每位学生的总分和平均分。
2.找出数学成绩高于90分或英语成绩高于85分的学生。
3.按总分从高到低排序,并输出前3名学生。
'''

data = {
    '姓名': ['张三', '李四', '王五', '赵六', '钱七'],
    '数学': [85, 92, 78, 88, 95],
    '英语': [90, 88, 85, 92, 80],
    '物理': [75, 80, 88, 85, 90]
}
df = pd.DataFrame(data)
print(df)

# 1.计算每位学生的总分和平均分。
print('每位学生的总分:')
df['总分'] = df[['数学', '英语', '物理']].sum(axis=1)  # axis=1 按照行算
df['平均分'] = df[['数学', '英语', '物理']].mean(axis=1)
df['平均分2'] = df['总分'] / 3

# 2.找出数学成绩高于90分或英语成绩高于85分的学生。
df[(df['数学'] > 90) | (df['英语'] > 85)]

# 3.按总分从高到低排序,并输出前3名学生。
r1 = df.sort_values(by=['总分'], ascending=False).head(3)
r2 = df.nlargest(3, columns=['总分'])
print(r1)
print(r2)
注:单层括号获取的是一列Series,双层方括号二列DataFrame,因此不能用 df[['数学', '英语']] 获取多列
案例2:销售数据分析
python
'''
案例2:销售数据分析
场景:某公司销售数据如下,请完成以下任务:
1.计算每种产品的总销售额(销售额=单价x销量)
2.找出销售额最高的产品。
3.按销售额从高到低排序,并输出所有产品信息。
'''

data = {
    '产品名称': ['A', 'B', 'C', 'D'],
    '单价': [100, 150, 200, 120],
    '销量': [50, 30, 20, 40]
}
df = pd.DataFrame(data)
df['总销售额'] = df['单价'] * df['销量']
print(df)
print(df.nlargest(1, columns='总销售额'))
print(df.sort_values(by=['总销售额'], ascending=False))
案例3:电商用户行为分析
python
'''
案例3:电商用户行为分析
场景:某电商平台的用户行数据如下,请完成以下任务:
1.计算每位用户的总消费会领(消费金额=商品单价x购买数量)
2.找出消费金额最高的用户,并输出其所有信息
3.计算所有用户的平均消费金额(保留2位小数)
4.统计电子产品的总购买数量
'''

data = {
    '用户ID': [101, 102, 103, 104, 105],
    '商品单价': [1200, 300, 800, 150, 200],
    '购买数量': [1, 3, 2, 5, 4],
    '用户名': ['Alice', 'Bob', 'Charlie', 'David', 'Eve'],
    '商品类别': ['电子产品', '服饰', '电子产品', '家居', '服饰']
}
df = pd.DataFrame(data)
# 1.每位用户的总消费会领(消费金额=商品单价x购买数量)
df['总消费'] = df['商品单价'] * df['购买数量']
print(df)

# 2.消费金额最高的用户
print(df.nlargest(1, columns=['总消费']))

# 3.所有用户的平均消费金额
print(df['总消费'].mean())

# 4.电子产品的总购买数量
df[df['商品类别'] == '电子产品']['购买数量'].sum()注:df[布尔序列]筛选符合条件的行,返回DataFrame;提取购买数量列得到Series,最后求和。