💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
文章目录
1、研究背景
随着全球汽车保有量持续增长与消费升级,二手车交易市场已成为汽车产业的重要组成部分。巴基斯坦作为南亚地区重要的新兴市场,其二手车市场活跃度不断提升,OLX 等线上交易平台与本地车商目录积累了大量挂牌数据,涵盖品牌、年款、里程、燃料类型、变速方式、排量、组装方式、挂牌城市、证件类型、车主数量等丰富字段。与此同时,印度作为邻国也拥有规模可观的二手车转售数据,两者在车型结构、价格区间与消费偏好上既存在共性又各具特色。传统二手车定价多依赖车商经验判断,缺乏对海量交易数据的系统挖掘,导致价格信息不对称、市场透明度不足。在大数据技术日趋成熟的背景下,利用分布式计算框架对多源异构二手车数据进行整合分析与价值挖掘,成为提升市场效率、辅助买卖双方科学决策的必然趋势,也为本系统的开发提供了现实需求与技术基础。
2、研究目的和意义
本系统旨在构建一套基于大数据技术的二手车价格影响因素分析与可视化全链路程序,以 PySpark 与 Hadoop 为核心技术栈,实现对多源二手车数据的自动化上传、清洗预处理与多维度分析。系统通过 HDFS 完成巴基斯坦宝马挂牌数据、OLX 市场数据、巴基斯坦车目录数据及印度转售数据的统一存储与管理,借助 Pandas 完成字段重命名、缺失值处理、异常值过滤与中英文映射等预处理工作,再运用 Spark SQL 聚合、K-Means 聚类与 FPGrowth 频繁项集挖掘等算法,从品牌、年款、里程、燃料、变速、排量、车主数、组装方式、挂牌城市、证件类型、价格分档与配置共现等维度展开分析。系统期望输出结构化的 CSV 分析结果,揭示影响二手车价格的核心因素与市场结构特征,为车商定价、消费者选购及市场研究提供数据驱动的决策参考。
本系统的开发具有多方面的现实意义与学术价值。在实践层面,系统通过大数据分析揭示二手车价格与品牌、年款、里程、排量、燃料类型、变速方式、车主数量、组装方式、挂牌城市及证件类型等因素之间的关联规律,有助于缓解买卖双方之间的信息不对称问题,提升二手车市场的价格透明度与交易效率,为车商合理定价和消费者理性选购提供量化依据。在技术层面,系统整合了 Hadoop 分布式存储、PySpark 数据处理、K-Means 聚类与 FPGrowth 关联规则挖掘等技术,验证了大数据全链路方案在二手车领域的可行性与有效性,为同类垂直行业的数据分析项目提供了可复用的工程范式。在学术层面,系统对巴基斯坦与印度两个南亚市场的二手车数据进行对比分析,丰富了新兴市场二手车价格研究的实证素材,为后续跨区域市场比较与价格预测建模奠定了数据基础。
3、系统研究内容
本系统的开发内容围绕数据上传、预处理与分析三大模块展开。数据上传模块通过 Hadoop 命令实现 SafeMode 检测、目录创建与文件上传,将四个源文件写入 HDFS 指定目录。预处理模块针对四份数据集分别执行字段重命名、品牌解析、数值转换、负值过滤、年款下限校验与中英文映射,涵盖燃料类型、变速方式、组装方式、证件类型、车况、挂牌城市与车主数量等字段,并将车配置字段规范化为逗号分隔格式,输出四份预处理 CSV 文件。分析模块基于 Spark 实现 18 项分析任务,包括品牌均价、年款均价、里程分档均价、燃料均价、变速均价、车主均价、排量结构、燃料占比、变速占比、组装均价、车况聚类、配置频繁项集、品牌占比、挂牌城市占比、组装占比、证件占比、年款趋势与价格分档占比,每项分析均输出结构化 CSV 结果并记录日志,形成完整的二手车价格影响因素分析与可视化数据支撑体系。
4、系统页面设计
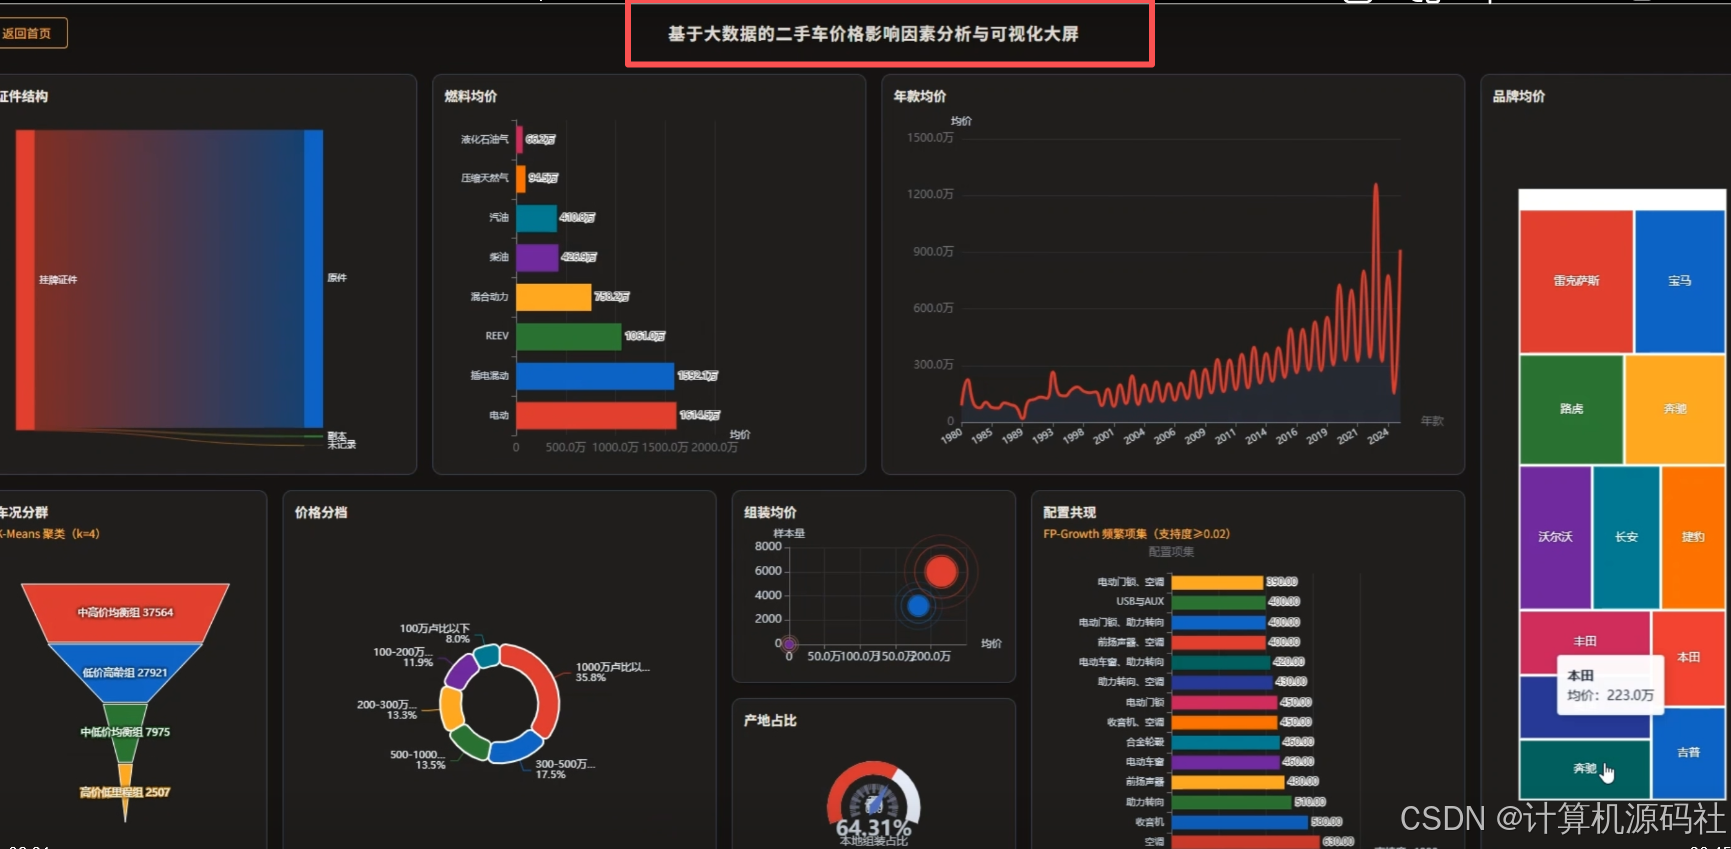
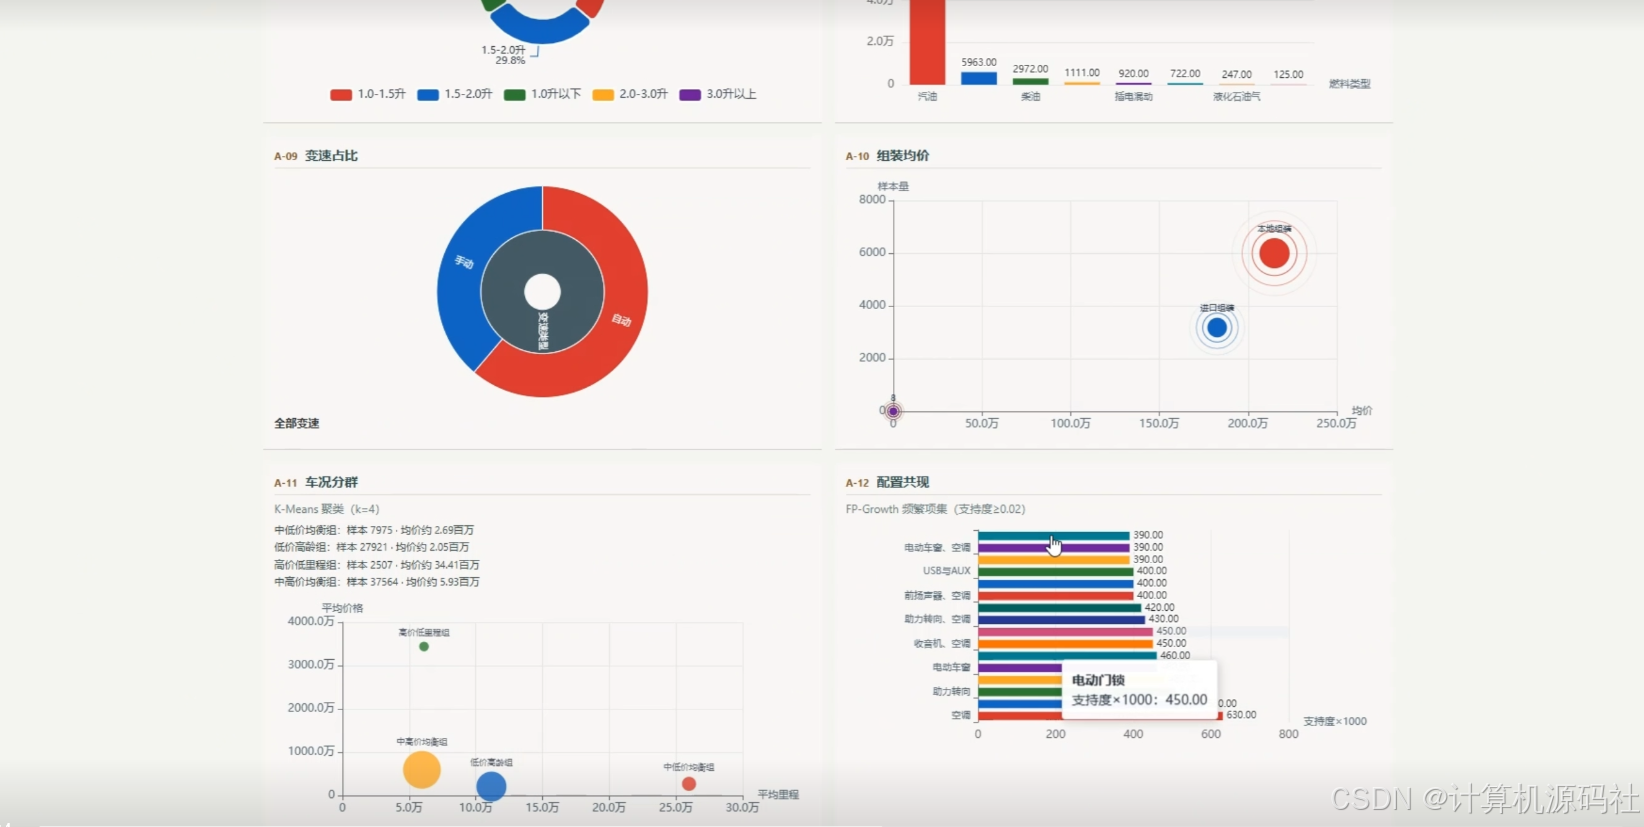
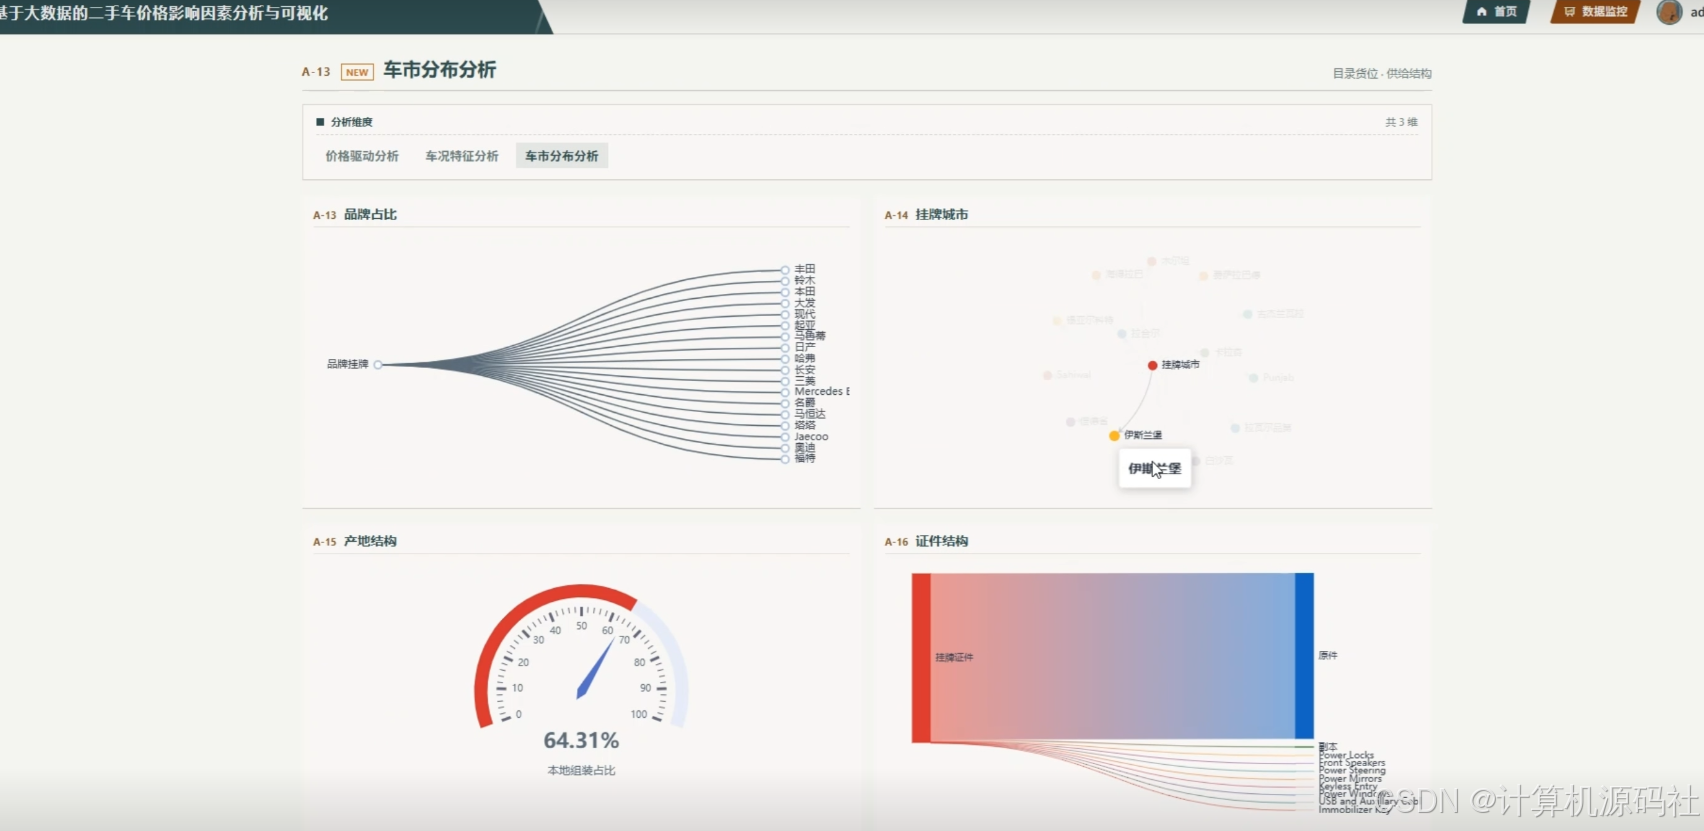
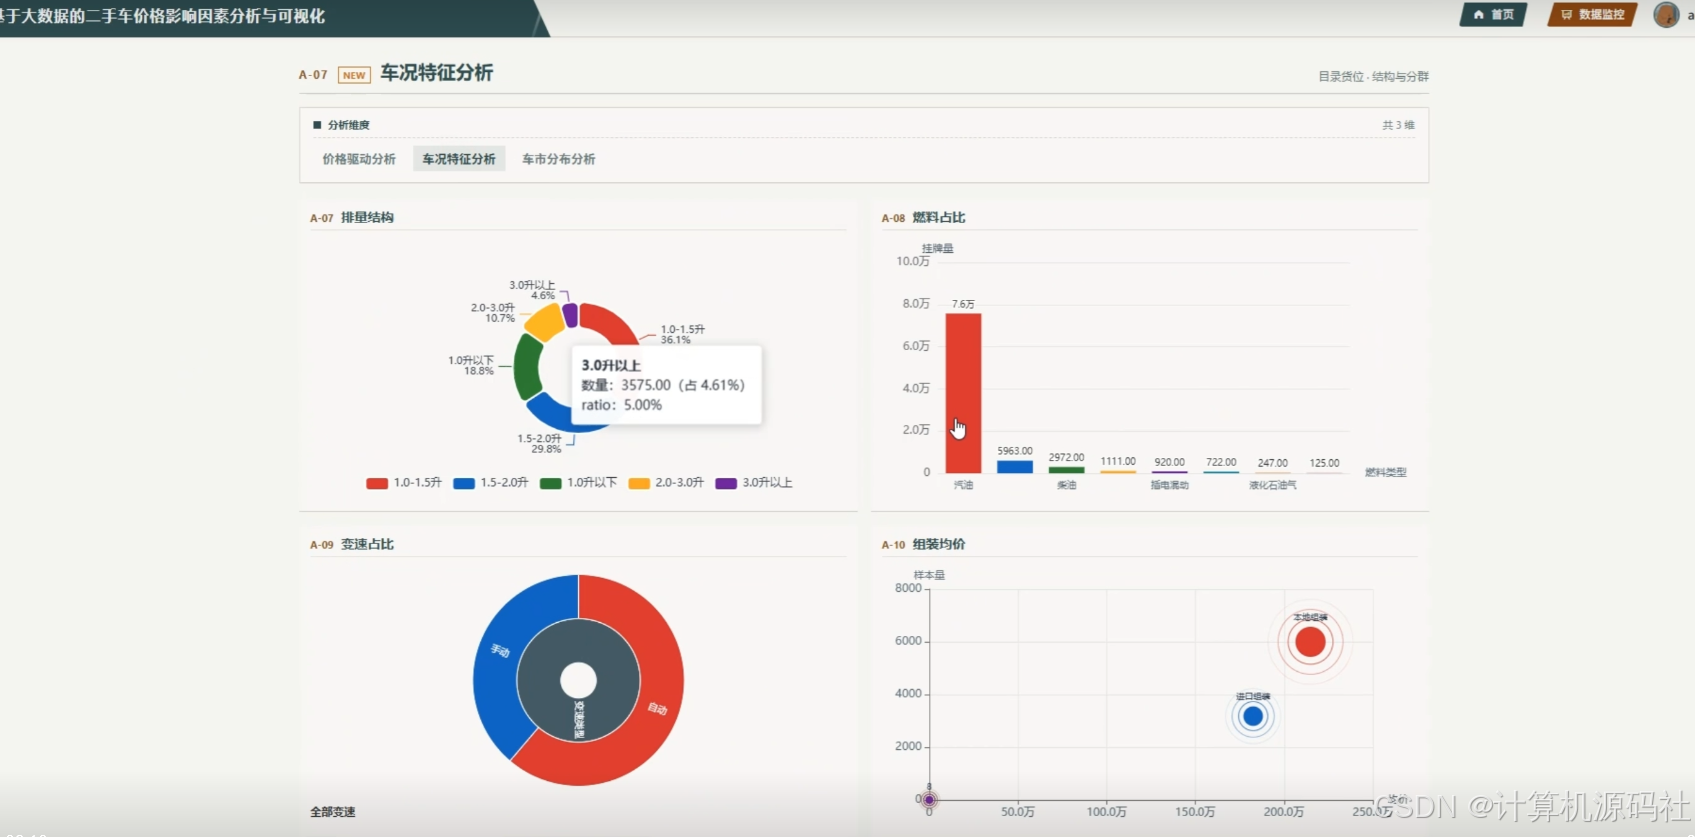
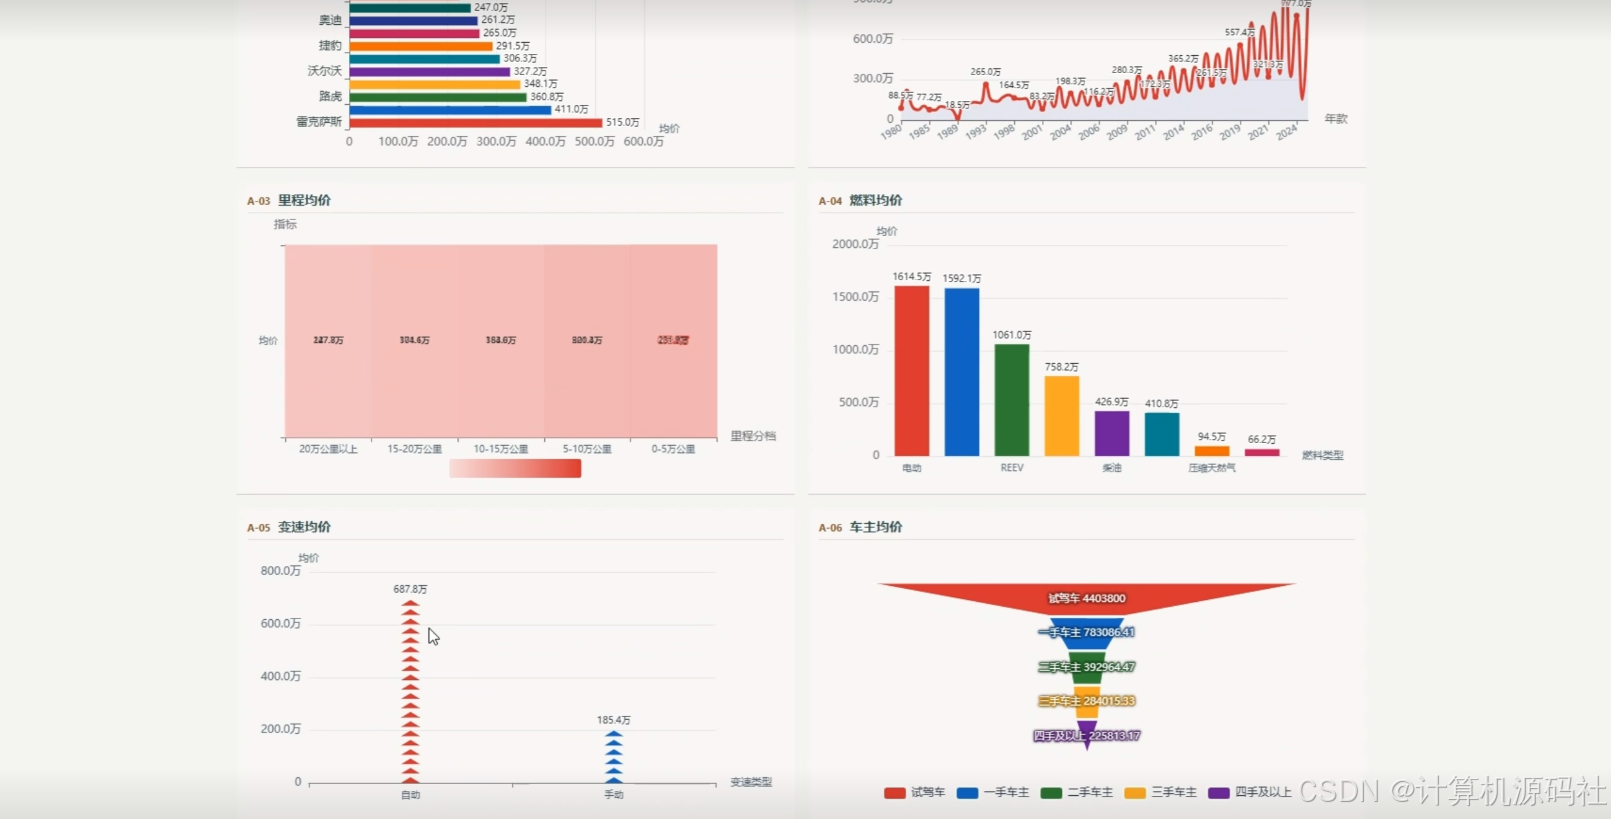
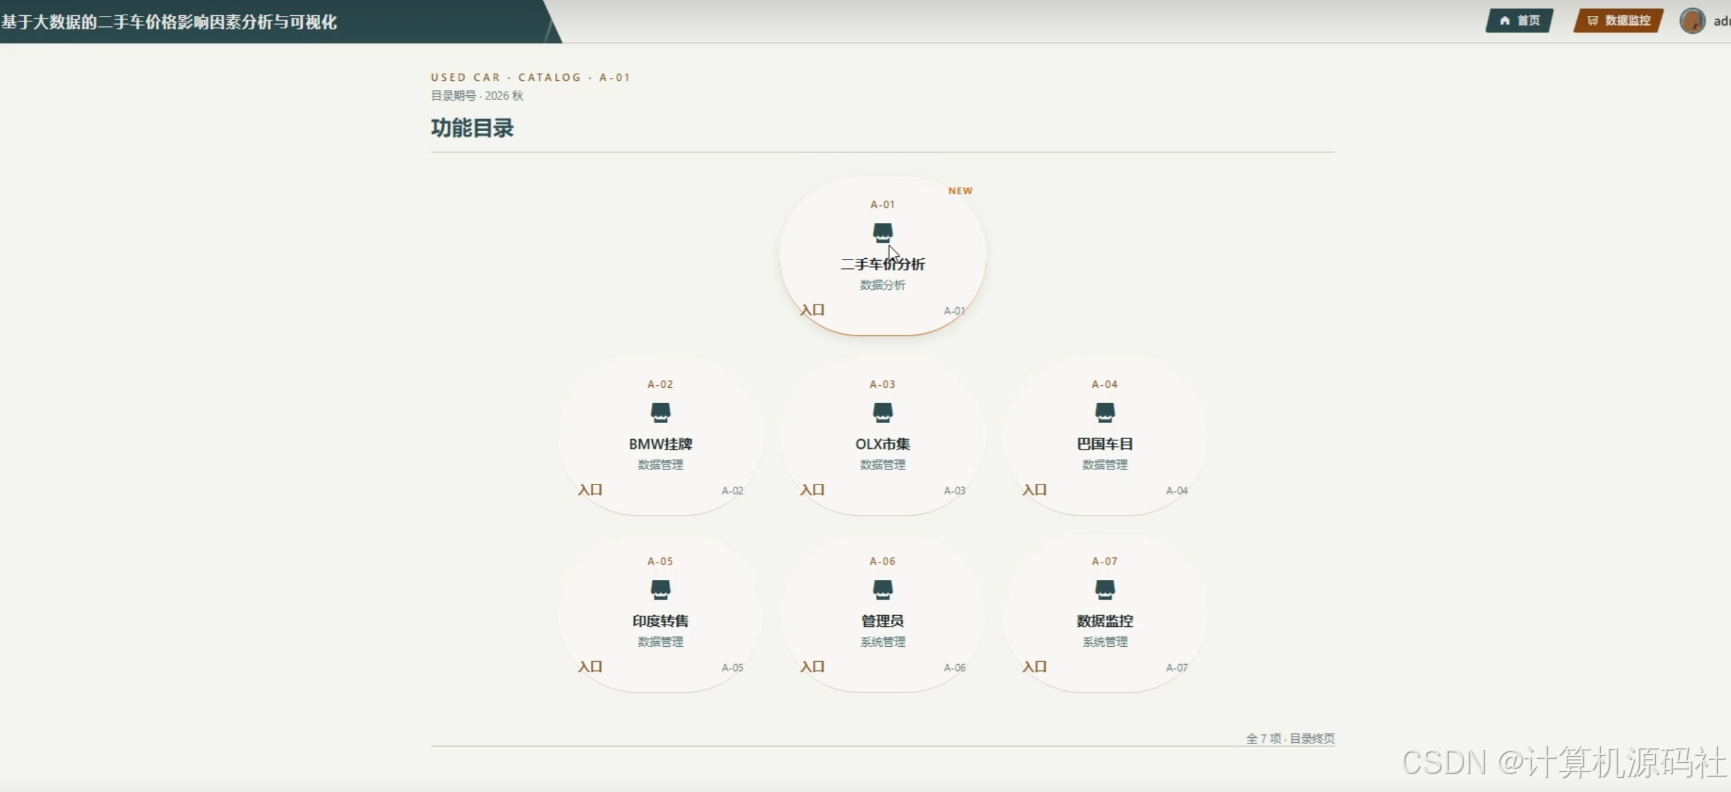
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
1闫常娜,陶冶. 基于Hadoop的二手车市场数据与可视化分析J.信息记录材料,2026,27(6):186-188.DOI:10.16009/j.issn.1009-5624.2026.06.061.
2杜印莹.徐州市二手车市场政府监管存在问题及对策研究D.中国矿业大学,2025.DOI:10.27623/d.cnki.gzkyu.2025.003184.
3张栩梓,黄柳文. 数字化转型背景下二手车营销策略研究分析J.汽车维修与保养,2025,(8):117-119.DOI:10.13825/j.cnki.motorchina.2025.08.022.
4张建胜.WHS传统燃油汽车4S店发展战略研究D.青岛大学,2025.
5喻峥.数字化背景下良品车行营销策略优化研究D.南昌大学,2025.DOI:10.27232/d.cnki.gnchu.2025.002660.
6蒋美佳. 基于Python爬虫技术的汽车之家二手车数据可视化分析J.信息与电脑,2025,37(9):141-145.
7姜瑞天.基于引入演化学习的特征加权stacking模型预测新能源二手车价格D.西南财经大学,2025.DOI:10.27412/d.cnki.gxncu.2025.002144.
8陈萌.当二手车与AI狭路相逢N.中国汽车报,2025-04-14(040). DOI:10.28116/n.cnki.ncqcb.2025.000429.
9张倩.GY银行HK支行二手车分期业务投诉防控策略研究D.华中科技大学,2025.DOI:10.27157/d.cnki.ghzku.2025.006257.
10吕焰文.京九汽车销售服务公司发展战略研究D.华中科技大学,2025.DOI:10.27157/d.cnki.ghzku.2025.005758.
11刘志超.融合预训练语言模型的二手车保值率预测研究D.重庆理工大学,2025.DOI:10.27753/d.cnki.gcqgx.2025.001298.
12陈建兴.ALJ公司认证二手车的客户满意度提升策略研究D.西南财经大学,2025.DOI:10.27412/d.cnki.gxncu.2025.001972.
13李东江. 用DeepSeek赋能汽车后市场的策略与路径初探J.汽车维护与修理,2025,(5):1-9.DOI:10.16613/j.cnki.1006-6489.2025.05.001.
14卢洋.M二手车公司短视频营销策略研究D.哈尔滨工程大学,2025.DOI:10.27060/d.cnki.ghbcu.2025.001299.
15都萌,陆立伟,王伟,等. 互联网业态下新能源二手车鉴定评估与营销创新型人才能力模型探索J.时代汽车,2024,(21):50-52.
16刘蜜.湖南佳驰汽车服务有限公司营销策略优化研究D.湖南大学,2024.DOI:10.27135/d.cnki.ghudu.2024.004920.
17徐建敏.D公司二手车电话营销管理优化研究D.西南大学,2024.DOI:10.27684/d.cnki.gxndx.2024.004278.
18杨相群.基于特征优化的改进Stacking二手车价格预测模型研究D.长春大学,2024.DOI:10.27912/d.cnki.gcdcx.2024.000057.
19杨锦锋.数字化背景下中职《二手车技术状况鉴定》课程资源开发与实践研究D.广西师范大学,2024.DOI:10.27036/d.cnki.ggxsu.2024.000249.
20江乐.二手车价格影响因素研究与预测D.湖北大学,2024.DOI:10.27130/d.cnki.ghubu.2024.000754.
21刘宠.YN二手车平台盈利模式转型及效果研究D.天津财经大学,2023.DOI:10.27354/d.cnki.gtcjy.2023.001049.
22黄军峰,徐炜,李旭龙. 基于大数据分析的二手车发展前景研究J.产业创新研究,2023,(7):62-64.
23周研博,郑成,侯惠芳. 基于Python的二手车交易分析可视化J.信息与电脑(理论版),2022,34(16):21-24.
24余娟.基于数据挖掘技术对二手车交易价格的预测D.中国地质大学(北京),2022.DOI:10.27493/d.cnki.gzdzy.2022.001089.
25张春光.基于Java EE的二手车物流系统的设计与实现D.西安电子科技大学,2020.DOI:10.27389/d.cnki.gxadu.2020.001891.
26潘浩楠.基于梯度提升决策树组合模型的二手车金融用户画像系统D.中国科学院大学(中国科学院人工智能学院),2020.DOI:10.27824/d.cnki.gzkdx.2020.000031.
27徐锐.基于某二手车交易平台的产品个性化推荐方法及其系统D.浙江理工大学,2020.DOI:10.27786/d.cnki.gzjlg.2020.000061.
28张椿琳. 数据智能抢占二手车业务先机J.经营者(汽车商业评论),2019,(12):124-126.
29项淳.上汽通用公司二手车交易管理系统设计与实现D.大连理工大学,2014.
30孙峰.二手车电子商务平台的设计与实现D.北京邮电大学,2010.
6、核心代码
java
def vehicle_condition_clusters_analysis(spark, pak_df):
    logger.info("开始车况分群分析 (K-Means k=4)")
    base = pak_df.filter(
        col('price_pkr').isNotNull()
        & col('model_year').isNotNull()
        & col('mileage').isNotNull()
        & col('engine_capacity').isNotNull()
        & (col('engine_unit') == 'cc')
    )
    row_count = base.count()
    logger.info("聚类有效样本: %d", row_count)

    assembler = VectorAssembler(
        inputCols=['model_year', 'mileage', 'engine_capacity', 'price_pkr'],
        outputCol='features_raw',
        handleInvalid='skip',
    )
    scaler = StandardScaler(inputCol='features_raw', outputCol='features', withStd=True, withMean=True)
    kmeans = KMeans(k=4, seed=42, featuresCol='features', predictionCol='cluster_id')

    assembled = assembler.transform(base)
    scaled = scaler.fit(assembled).transform(assembled)
    model = kmeans.fit(scaled)
    clustered = model.transform(scaled)

    centers = model.clusterCenters()
    center_stats = []
    for idx, center in enumerate(centers):
        center_stats.append({
            'cluster_id': idx,
            'avg_year': float(center[0]),
            'avg_mileage': float(center[1]),
            'avg_engine': float(center[2]),
            'avg_price': float(center[3]),
        })

    center_stats.sort(key=lambda x: x['avg_price'])
    label_pool = ['低价高龄组', '中低价均衡组', '中高价均衡组', '高价低里程组']
    id_to_label = {}
    for rank, item in enumerate(center_stats):
        id_to_label[item['cluster_id']] = label_pool[rank]
        logger.info(
            "簇 %d -> %s | 年款均值 %.0f 里程均值 %.0f 排量均值 %.0f 均价 %.2f",
            item['cluster_id'], label_pool[rank],
            item['avg_year'], item['avg_mileage'], item['avg_engine'], item['avg_price'],
        )

    label_expr = lit('未知')
    for cid, label in id_to_label.items():
        label_expr = when(col('cluster_id') == cid, lit(label)).otherwise(label_expr)

    labeled = clustered.withColumn('cluster_name', label_expr)
    result = (
        labeled.groupBy('cluster_id', 'cluster_name')
        .agg(
            spark_count(lit(1)).alias('cnt'),
            spark_round(spark_avg('model_year'), 2).alias('avg_year'),
            spark_round(spark_avg('mileage'), 2).alias('avg_mileage'),
            spark_round(spark_avg('engine_capacity'), 2).alias('avg_engine'),
            spark_round(spark_avg('price_pkr'), 2).alias('avg_price'),
        )
        .orderBy('cluster_id')
    )
    output_path = str(ANALYSIS_DIR / 'vehicle_condition_clusters.csv')
    write_spark_csv(result, output_path)
logger.info("保存到: %s 成功", output_path)💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询