Claude Code Skill 质量检查实战:用 /skill-doctor + Plugin Evals 找出"看似能用、实际没被调用"的问题
这周建议你把精力从"再做一个新 Skill"切换到"如何验证 Skill 真的有效"。
原因很简单:最近 Claude Code 的更新里,出现了两个正好适合做实操文章的功能------
/skill-doctor(v2.1.261,2026-09-04 发布,官方文档标注需要 v2.1.252 或更高版本)和claude plugin eval(v2.1.269,2026-09-11 发布)。前者告诉你哪些 Skill 从来没被调用过、每个 Skill 每轮花掉你多少上下文;后者让你用固定输入、可重复的方式,验证一个插件到底有没有按预期工作。
这比单纯讲"怎么写 Skill"更有价值。因为很多人真正卡住的不是不会写,而是:
- Skill 写完以后根本没有被调用;
- 规则写了,但 Agent 没按规则执行;
- 装的东西越来越多,上下文越来越长,效果反而变差;
- Plugin 能装上,但没有任何可验证的质量标准。
这篇文章用一套闭环流程把这两件事串起来:先用 /skill-doctor 做存量体检,再用 claude plugin eval 建立质量基线,最后把评测挂进 CI。
一、先理解机制:为什么 Skill 会"装了等于没装"
要修好问题,先得知道钱是怎么花出去的。
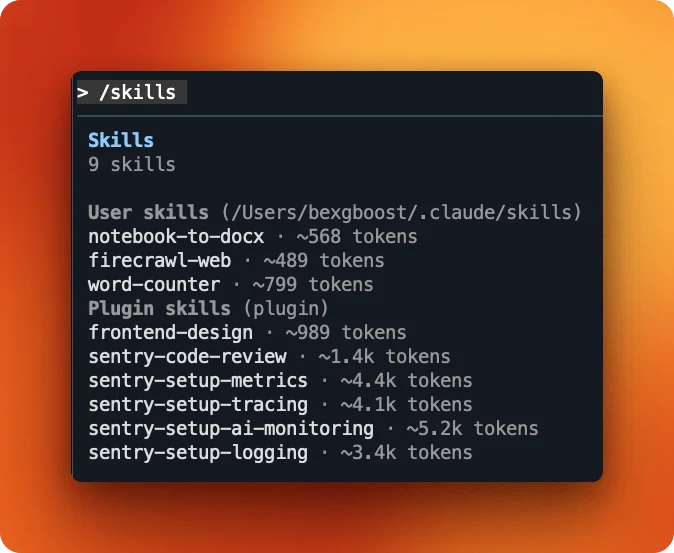
Claude Code 采用**渐进式披露(progressive disclosure)**加载 Skill:会话启动时,只有每个 Skill 的 name + description 会进入系统提示词,形成一份"技能清单"(skill listing);SKILL.md 的正文只在 Skill 被触发的那一刻才加载。听起来很省,但有一个关键事实容易被忽略:
清单里的每一个 Skill,无论用不用,每一轮对话都在消耗上下文。
官方文档明确写了:技能清单的字符预算默认是模型上下文窗口的 1% 。当你的 Skill 多到超出预算时,Claude Code 会开始裁掉部分 Skill 的 description------而且是从你调用次数最少的那些开始裁。description 恰恰是 Claude 决定"要不要用这个 Skill"的唯一依据,描述被裁掉,触发率自然进一步下降,形成恶性循环。
所以"看似能用、实际没被调用"通常有三种根因:
| 根因 | 表现 | 本质 |
|---|---|---|
| description 写得弱 | 明确输入触发词时能跑,自然说法下不触发 | 匹配失败:description 是唯一的匹配依据 |
| 清单超预算被裁描述 | Skill 越装越多后,老 Skill 触发率下降 | 关键词被预算机制丢掉了 |
| 配置性问题 | 显式 /skill-name 都调不起来 |
目录错误、SKILL.md 文件名大小写、frontmatter 写坏、设了 disable-model-invocation: true、会话没重启等 |
前两种是"质量问题",第三种是"安装问题"。/skill-doctor 负责把这两类问题从一堆 Skill 里筛出来,claude plugin eval 负责量化修复效果。
二、实战一:用 /skill-doctor 做存量体检
运行方式
在交互式会话里直接输入:
/skill-doctor几个使用细节(都来自官方文档,踩坑前先看):
- 报告在哪里打开 :交互式会话中,报告会打开在
/plugin管理器的 Stats 标签页;在非交互模式(claude -p)下则直接以文本形式打印。 - 覆盖范围 :只统计你自己装的用户级、项目级、插件级 Skill,不含捆绑技能(bundled skills)和企业下发的技能。
- 远程控制不可用 :从手机或浏览器通过 Remote Control 运行时,会回复
Skill usage reports are not available on this connection.------必须在跑会话的那台机器的终端里执行。 - 它还会顺手列出"最近没用过的插件",这对清理插件级开销同样有用。
读懂报告:一张六列的表
报告的每个 Skill 一行,核心列含义如下:
| 列 | 含义 | 怎么解读 |
|---|---|---|
skill |
Skill 名称(插件来源的显示为 plugin:skill) |
--- |
source |
来源:userSettings(~/.claude/skills/)或插件名 |
决定你去哪里关它 |
context |
该 Skill 在清单里占的上下文成本------每一轮都在付 ;- 表示不在清单中 |
清理的主要目标 |
7d tokens |
最近 7 天本机会话中归因于该 Skill 的 token 量 | 它干了多少活 |
uses |
被调用的次数 | 0 次是重点信号 |
last used |
最近使用时间(never / N days / today) |
排序依据:从未用过的排在最上面 |
决策矩阵:四类 Skill 分别怎么处理
拿到报告后不要急着全删,按四象限处理:
| 情况 | 判断 | 动作 |
|---|---|---|
context 高 + uses = 0 |
纯负债:每轮付钱、从不干活 | 优先关闭。官方建议从上下文成本最高的开始 |
7d tokens 高 + uses 高 |
高消费但物有所值 | 保留,可以考虑精简 SKILL.md 正文 |
uses = 0 但 context 很低 |
暂无成本压力 | 低优先级,观察一个周期再说 |
uses > 0 但表现差 |
被调用了却没帮上忙 | 这是 /skill-doctor 管不到的,交给 plugin eval(见第三节) |
在哪里关
报告会告诉你每个 Skill 该去哪里关:
- 用户/项目级 Skill:在
/skills界面里切换可见性,或直接移走目录; - 插件级 Skill:在
/plugin里管理整个插件; - 想保留但少花钱:在
skillOverrides里把低优先级条目设为"name-only"------只列名字、不带描述,把预算让给别的 Skill; - 预算本身太紧:用
skillListingBudgetFraction(如0.02= 2%)或环境变量SLASH_COMMAND_TOOL_CHAR_BUDGET调整。
和 /doctor 的分工
别混淆这两个命令:/doctor 是整机体检 ------安装健康、PATH、设置文件、慢 hook、CLAUDE.md 去重和瘦身、新版本检查,"找没用的 Skill"只是其中一小项;/skill-doctor 是把"Skill 的使用情况与上下文成本"这一件事单独抽出来的专项报告 。日常维护用 /skill-doctor,搬家、升级、环境出问题时用 /doctor。
⚠️ 一个诚实的提醒:
/skill-doctor记录的是"这个 Skill 有没有跑过 ",而不是"跑了有没有帮助"。一个每周都被调用但产出很差的 Skill,在这张表里看起来完全健康。这就是下一节要解决的问题。
三、实战二:用 claude plugin eval 建立可重复的质量基线
它解决什么问题
在 v2.1.269 之前,验证一个插件只有两条路:claude plugin validate(检查文件语法和 schema------包是好的 ),和手动开几个会话试试看(感觉能用)。前者不管行为,后者不可重复。
claude plugin eval 补上的是行为层:用一组固定的测试用例(case)跑你的插件,用评分器(grader)打分,并且默认再做一组"不装插件"的对照,让你看到插件的真实贡献。
核心概念一句话版:
- Case = 一个真实的用户 prompt + 一个或多个 grader;
- Grader = 对产出的通过/失败检查:比如对回复跑正则、检查某个工具有没有被调用(
tool_used)、检查文件是否被创建(file_exists),或者让另一个模型按评分标准(rubric)打分(llm); - 消融对照(ablation):默认每个 case 跑 3 次带插件 + 3 次不带插件,共 6 次。两者分差 Δ 才是插件真正带来的提升。
最小工作流:四条命令
前提:Claude Code v2.1.269 或更高 ,终端位于插件根目录(含 plugin.json 或 .claude-plugin/plugin.json)。
bash
# 1. 让 Claude 帮你起草评测套件(交互式)
claude plugin eval init
# Claude 会读你的插件,问你"好的结果长什么样",
# 提出应该触发 / 不应该触发的 prompt,设计 grader,
# 试跑一遍确认可用后,把每个 case 写进 evals/ 目录。
# 完成后 /exit 退出该会话。

# 2. 跑整个套件
claude plugin eval .

# 3. 便宜地迭代单个 case(单臂、跑一次------有噪声,只用于快速验证方向)
claude plugin eval . --case <case-name> --runs 1 --ablation none

# 4. 确认修改效果时,回到默认 3 次运行再下结论
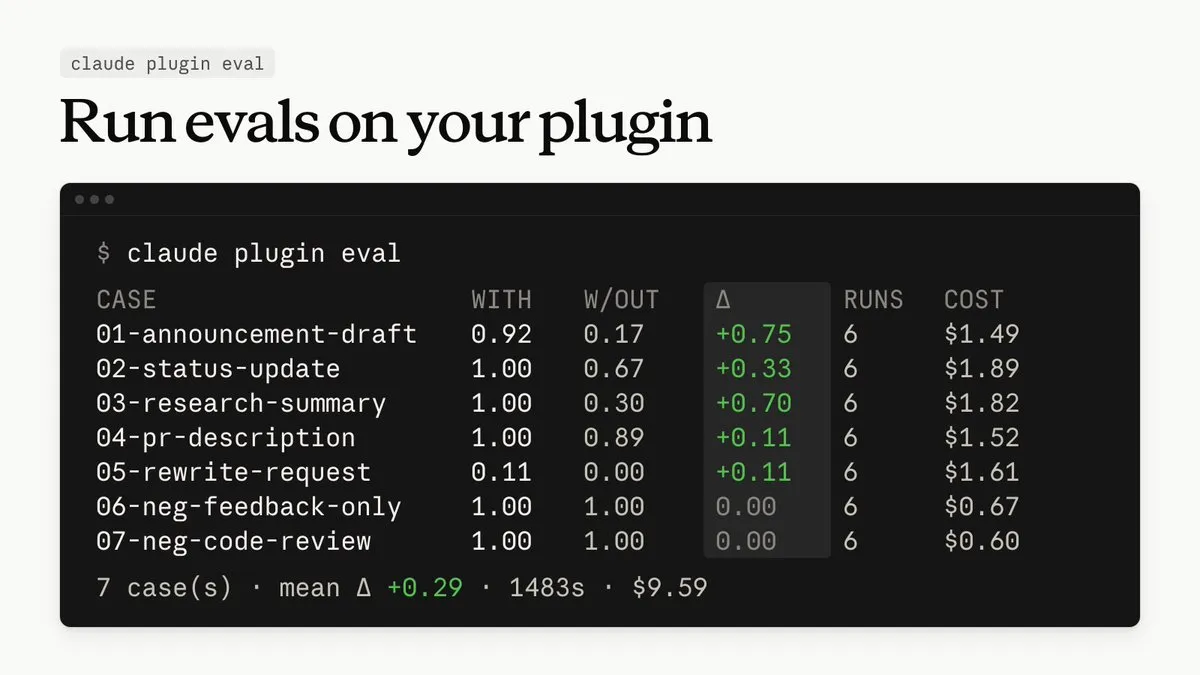
claude plugin eval .跑完会看到这样的汇总表(WITH = 带插件得分,W/OUT = 不带插件得分,Δ = 差值):
CASE        WITH  W/OUT Δ      RUNS COST    NOTES
first-case  1.00  0.33  +0.67  6    $0.41

1 case(s) · mean Δ +0.67 · 74s · $0.41
Report: /Users/you/my-plugin/evals/results/2026-09-10T17-02-11-482Z/report.html
详细报告写在 evals/results/<时间戳>/report.html,里面能看到每个 grader 的判定、判定理由,以及 llm 类 grader 的评委投票和它评审的回复片段。下面这张社区文章的示例图很能说明问题------注意 05-rewrite-request 这一行:
最重要的读数:Δ ≈ 0 意味着什么
官方文档直接点破了新手最常见的发现:
Δ 接近 0,且
tool_used: Skill这个 grader 失败------通常说明在自然说法下,Claude 根本没选你的 Skill。
这就是把"感觉 Skill 没被调用"变成可量化证据 的时刻。修复路径也很明确:重写 Skill 的 description(写清楚具体触发场景和用户真实会用的措辞,而不是只写主题),重跑同一个套件,对比 Δ。
顺便说两个官方文档里的典型坑:
- 所有 grader 都是 0 分但文件明明生成了 :大概率是 grader 的
target指到了files(路径列表)而不是文件内容,改用{ source: file, path: <path> };另外file_exists只统计运行期间新建 的文件,被编辑的已有文件它看不见,这种情况用tool_used检查Edit。 - 汇总表里没有 W/OUT 列 :说明 case 没找到插件,在 case 里加
plugins: ["../.."](从 case 目录指向插件目录的相对路径)。
成本与 CI
两个必须知道的现实约束:
- 评测是真金白银的模型调用 。每次运行、每个
llmgrader 的评委打分,都走你账户的额度或 API 账单(命令会给出按刊例价估算的 COST)。参考量级:社区报道一个 7-case 套件、每 case 6 次运行,总成本约 $9.59。建议把便宜的确定性检查(regex、tool_used、file_exists)放在日常迭代,大套件留给 nightly 或发版前。 - CI 门禁是官方支持的主要场景 。case 就是
evals/下的普通文件,可以随仓库版本管理;用--json输出结果,在流水线里对 Δ 或通过率设阈值,卡住那些"改了插件/换了模型后悄悄退化"的提交。
另外两个实用能力:
- Mock MCP 服务器 :Skill 依赖 MCP 工具时,不必连真实服务。在
evals/mocks/<server>/<tool>.md放 Markdown 文件即可提供假的返回,还能用 frontmatter 里的expect校验 Claude 传参是否正确。 - 自定义评测目录 :
evals/被占用时,在plugin.json里写"experimental": { "evals": "quality/evals" },或用--eval-dir指定。
⚠️ 安全提醒:评测会话会加载插件并运行,插件的 hooks 和 MCP 服务器是以你的身份执行的------只评测你信任的插件。
四、组合拳:一个完整的 Skill 质量闭环
把两个工具串起来,就是一个可以周期性执行的工作流:
写/装 Skill
   │
   ▼
claude plugin eval ──► 量化触发率与行为质量(Δ、grader 判定)
   │                       │
   │                       ├─ Δ≈0 且 Skill 未触发 → 改 description → 重跑
   │                       └─ Δ>0 → 通过,进入日常使用
   ▼
日常使用 1~2 周
   │
   ▼
/skill-doctor ──► 真实环境的使用审计(uses / last used / context)
   │                  │
   │                  ├─ uses=0 且 context 高 → 关闭或 name-only
   │                  ├─ 高频使用 → 保留,考虑精简正文
   │                  └─ 从未触发的插件 → 整个卸载
   ▼
改动了 Skill/插件,或模型升级了
   │
   ▼
CI 里跑 claude plugin eval ──► 防回归,回到第一步两者分工一句话总结:eval 回答"它能不能被正确触发、触发了有没有用"(事前、受控、可重复);/skill-doctor 回答"它在真实使用里到底有没有被用到、成本多少"(事后、真实、按机器统计)。 只用前者,你会漏掉"评测里表现好但真实场景没人这么提问"的 Skill;只用后者,你会分不清"没被调用"是描述问题还是需求根本不存在。
五、动手前的检查清单
- 版本确认:
claude --version,/skill-doctor需要 ≥ v2.1.252,claude plugin eval需要 ≥ v2.1.269 - 在本机终端 (非 Remote Control)跑
/skill-doctor - 按"四象限"处理:高成本低使用优先关,
skillOverrides: "name-only"处理低优先级条目 - 给核心插件建最小评测套件:3~5 个"应该触发"的 prompt + 1~2 个"不应该触发"的负例
- 每个 case 至少配一个
tool_used: Skillgrader------这是"没被调用"问题最直接的探测器 - 迭代用
--runs 1 --ablation none,下结论用默认 3 次运行 - 套件进版本库,CI 用
--json做阈值门禁 - 只评测信任的插件;大套件注意模型调用成本