这篇讲三件事:锁是用来解决什么问题的;PostgreSQL 有哪些锁、怎么加;DevMind 项目里每一把锁锁的是什么、为什么这样锁。最后讲死锁是怎么出现的、怎么避免。
文中所有"会不会等待"的结论,都在本机的 PostgreSQL 17 上用两个连接实际跑过(第 3.6 节有实测结果)。
1. 为什么需要锁
1.1 从前端的一个例子说起
React 里有个老问题:连续调用两次 setCount(count + 1),结果只加了 1。原因是两次调用读到的都是同一个旧的 count。解决办法是写成 setCount(c => c + 1),让 React 按顺序、基于最新值去算。
数据库里是一样的问题,只是"两次调用"变成了"两个同时到达的请求",而且它们跑在不同的连接、不同的进程里。
以 DevMind 为例:每个会话有一个 last_turn_seq 字段,记录已经有几轮。用户新提一个问题,Server 要给新的一轮分配序号 last_turn_seq + 1。如果代码写成"先 SELECT 读出来,在 Python 里加 1,再 UPDATE 写回去",两个请求同时到达时就会出错:
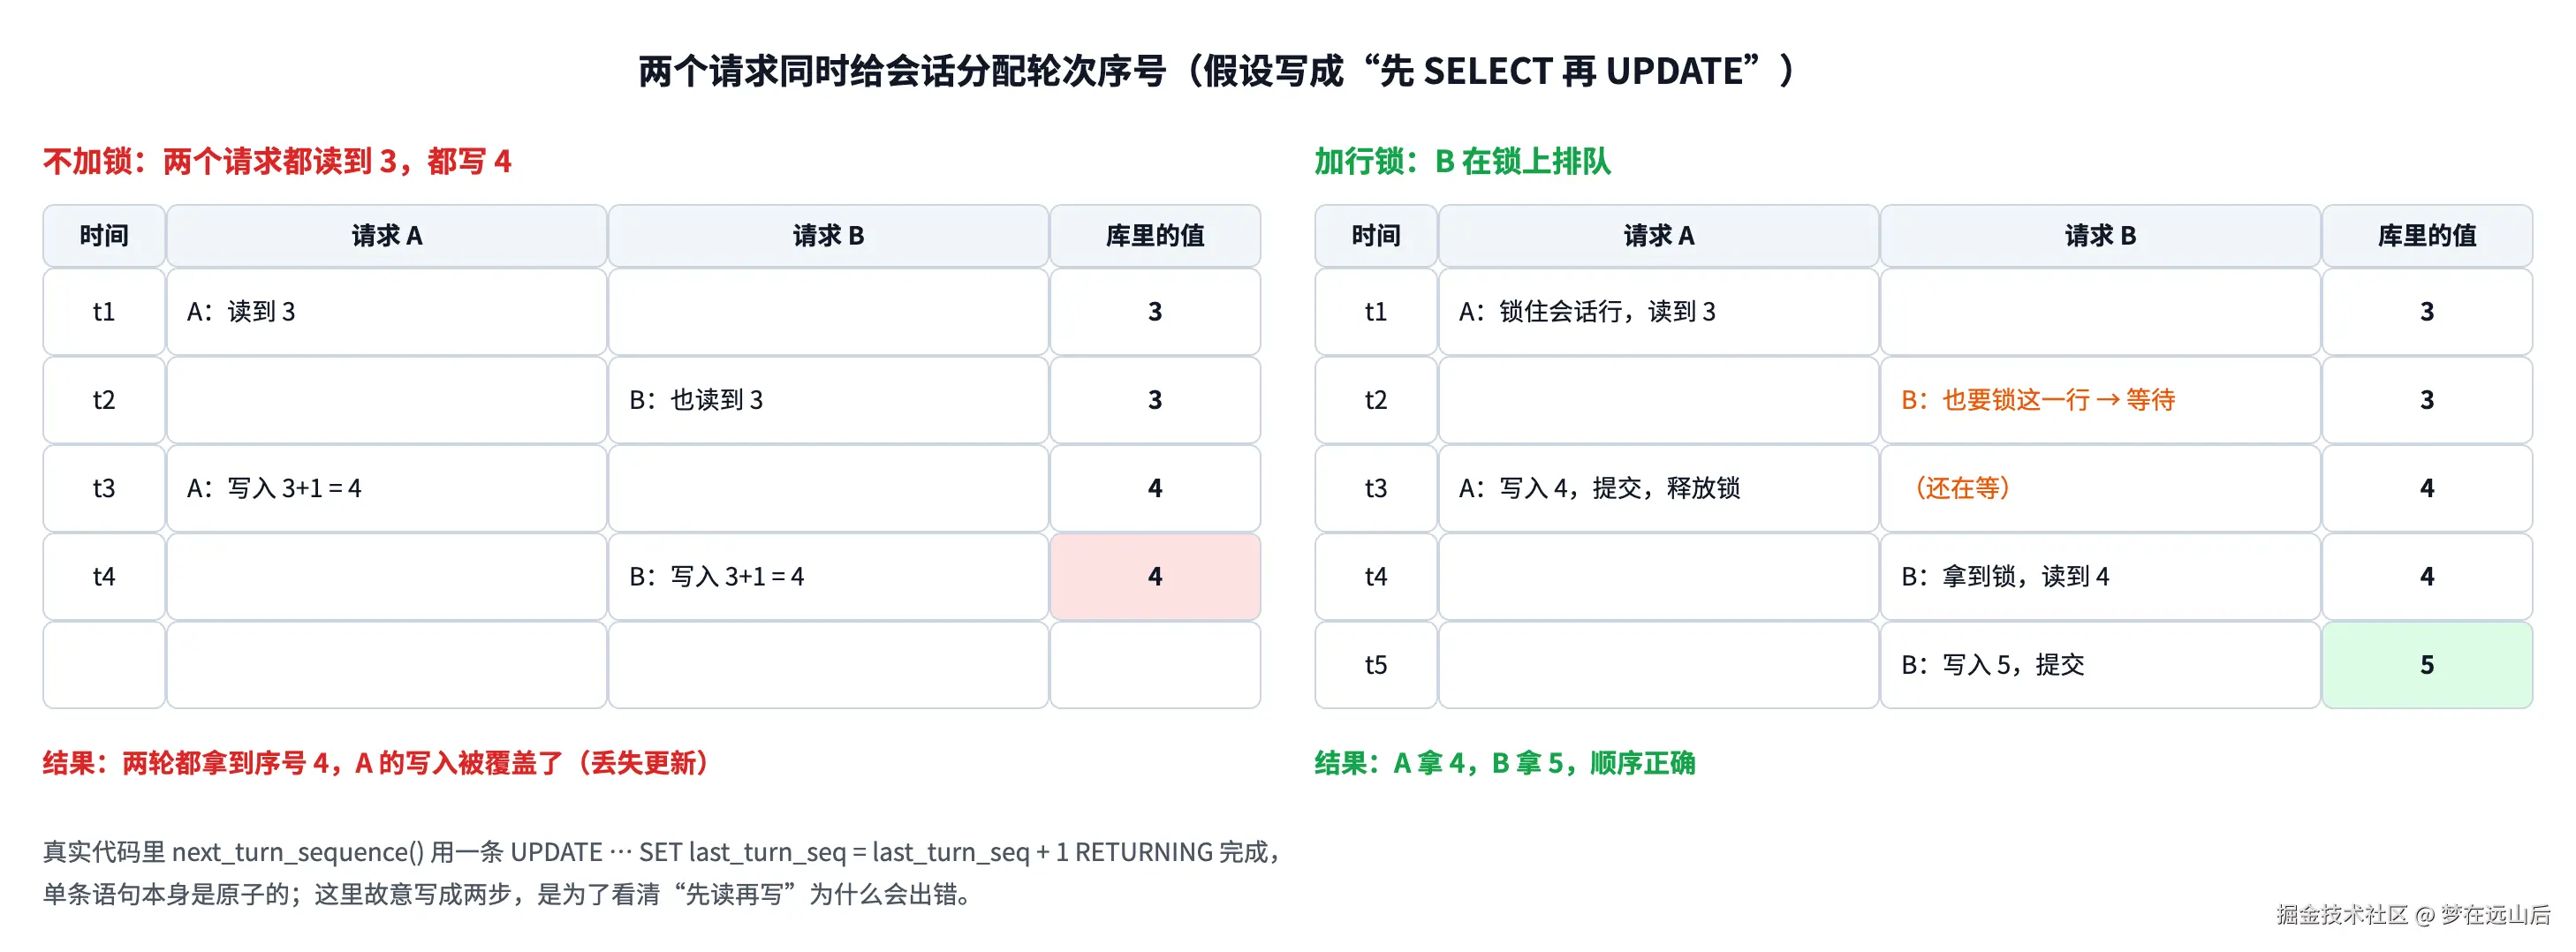
左边这种错误叫丢失更新:B 的写入覆盖了 A 的写入,而 B 写入的值是基于过期数据算出来的。
这类问题有一个共同的模式,叫"先检查、再行动"(check-then-act):
- 读出数据;
- 在程序里判断或计算;
- 根据判断结果写回去。
只要第 1 步和第 3 步之间,别的请求有机会改同一份数据,结果就可能出错。锁的作用,就是让第 1~3 步这段时间里,别人没法插进来改这份数据。
1.2 锁到底是什么
可以把锁想成一张"占用牌":
- 事务要改某行数据之前,先在这行上挂一张牌,写着"我在用";
- 另一个事务也想挂一张冲突的牌,就只能等着,直到前一张牌被摘掉;
- 牌什么时候摘:事务提交或回滚的时候。PostgreSQL 的行锁和表锁都不能在事务中途释放。
所以锁和事务是绑在一起的。不在事务里,锁就没有意义:autocommit 模式下每条语句自己就是一个事务,语句执行完锁就释放了,等于没锁。DevMind 的连接池开启了 autocommit,所以所有要加锁的 Service 方法,都先用 conn.transaction() 开事务(见 4.1)。
1.3 "只允许一个操作"不太准确
很多人对锁的印象是"同一时间只允许一个操作"。在 PostgreSQL 里,这个说法太粗了:
- 锁分很多种,只有互相冲突的两把锁才需要排队,不冲突的可以同时持有;
- PostgreSQL 用 MVCC(多版本并发控制)实现"读不等写,写不等读":一行数据被修改时,旧版本还在,别人读的是旧版本,不需要等。
下图用一行数据举例,看三个事务分别会不会等待:
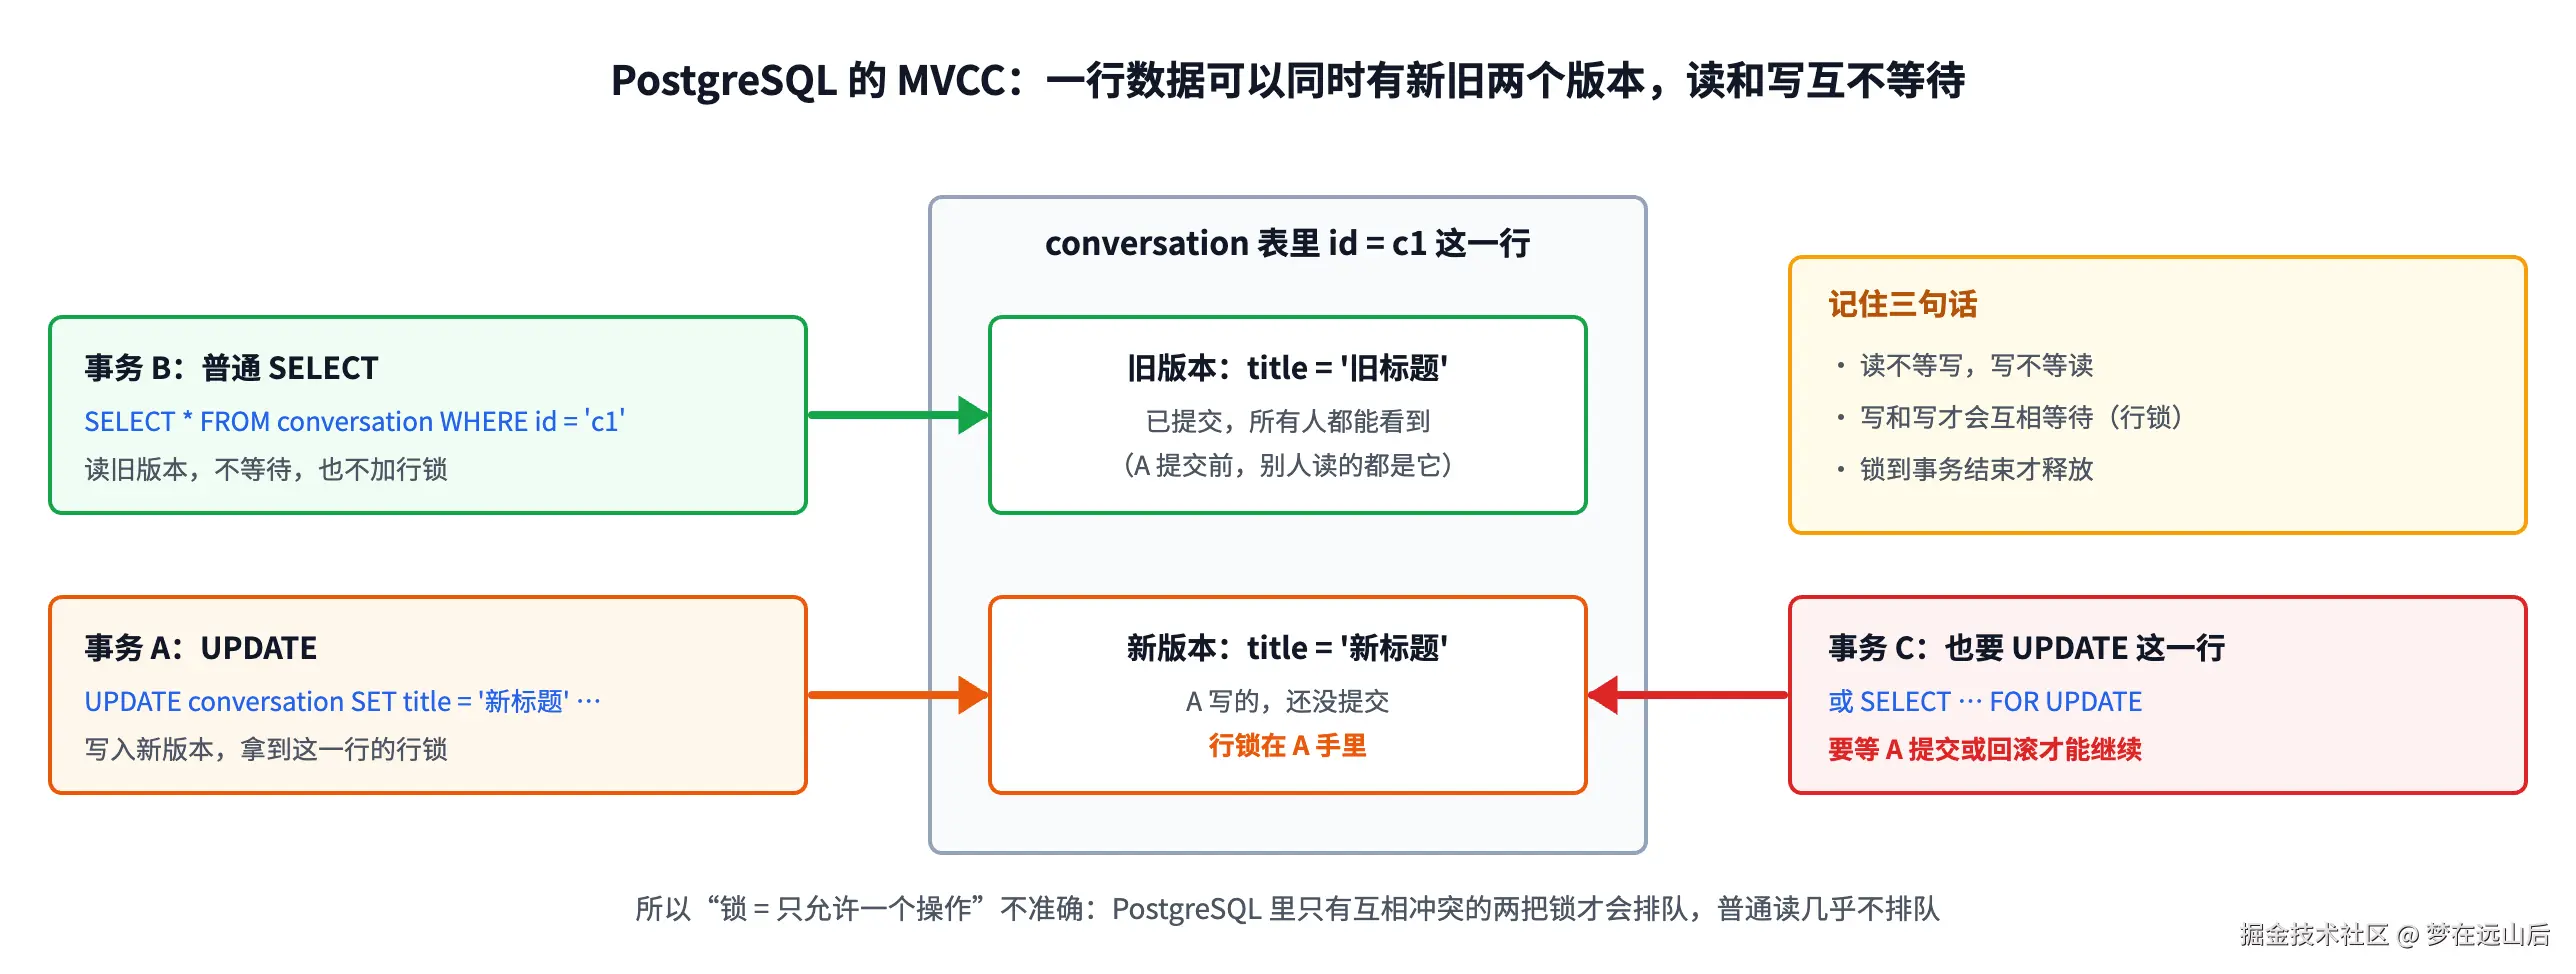
也就是说,大部分时候真正会排队的只有"写和写":两个事务要改同一行。这也是为什么普通的查询接口不需要考虑锁。
2. 锁的几个基本概念
这些概念不是 PostgreSQL 特有的,MySQL 等数据库里也一样。
2.1 共享锁和排他锁
最基础的两种:
| 类型 | 别名 | 含义 | 和谁冲突 |
|---|---|---|---|
| 共享锁 | S 锁、读锁 | 我要读,读的过程中别人不许改 | 排他锁 |
| 排他锁 | X 锁、写锁 | 我要改,别人既不许改,也不许加共享锁 | 所有锁 |
多个事务可以同时持有同一行的共享锁,但排他锁只能有一个。PostgreSQL 的 8 种表锁、4 种行锁,都是在这两种基础上细分出来的:细分得越细,不必要的等待就越少。
2.2 锁的粒度:锁多大一块
| 粒度 | 锁住的范围 | 特点 |
|---|---|---|
| 表锁 | 整张表 | 开销小,但并发差:锁住后整张表都要排队 |
| 行锁 | 某几行 | 并发好,只有改同一行的人才排队 |
| 建议锁 | 一个自定义的数字 | 不和任何表、行关联,含义由程序自己约定 |
粒度越小,能同时干活的事务越多。业务代码里用得最多的是行锁。
2.3 悲观锁和乐观锁
这是两种思路,不是两种具体的锁:
- 悲观锁 :假设一定会有人来抢,先加锁再操作。典型写法是
SELECT ... FOR UPDATE,适合冲突多、或者冲突后代价大的场景。 - 乐观锁 :假设一般不会有人抢,不加锁,写的时候再检查数据有没有被改过。典型写法是加一个
version字段:
ini
-- 读的时候记下 version = 7
UPDATE article SET body = '新内容', version = version + 1
WHERE id = 42 AND version = 7;
-- 影响行数为 0,说明别人已经改过了:提示用户刷新,或者重试还有一种和乐观锁很像的写法,叫条件更新 :把"检查"直接写进 UPDATE 的 WHERE 里,一条语句完成"检查 + 修改"。DevMind 的 claim_queued_run() 就是这样写的(见 4.4)。
2.4 显式加锁和隐式加锁
- 隐式:执行 SQL 时数据库自动加的锁。UPDATE 会自动锁住被改的行,ALTER TABLE 会自动锁住整张表,插入子表时外键检查会自动给父表的那一行加锁。
- 显式 :你在 SQL 里明确写出来的锁,比如
SELECT ... FOR UPDATE、LOCK TABLE、pg_advisory_xact_lock()。
大部分锁是隐式的。死锁经常就出在隐式锁上:代码里看不到,但它确实在等(见 5.2)。
2.5 锁和隔离级别
隔离级别决定"一个事务能看到别的事务的哪些修改",它和锁是两个相关但不同的东西。PostgreSQL 默认是 READ COMMITTED(读已提交):每条语句开始时,看到的是当时已经提交的数据。
对理解锁最重要的一点:在 READ COMMITTED 下,UPDATE 或 SELECT ... FOR UPDATE 如果在某一行上等过锁,拿到锁之后会重新读这一行的最新版本,再判断一次 WHERE 条件。条件不满足了,就当作没匹配到。第 4.4 节的条件更新,正是靠这一点保证只有一个请求能成功。
3. PostgreSQL 有哪些锁
先看全景:
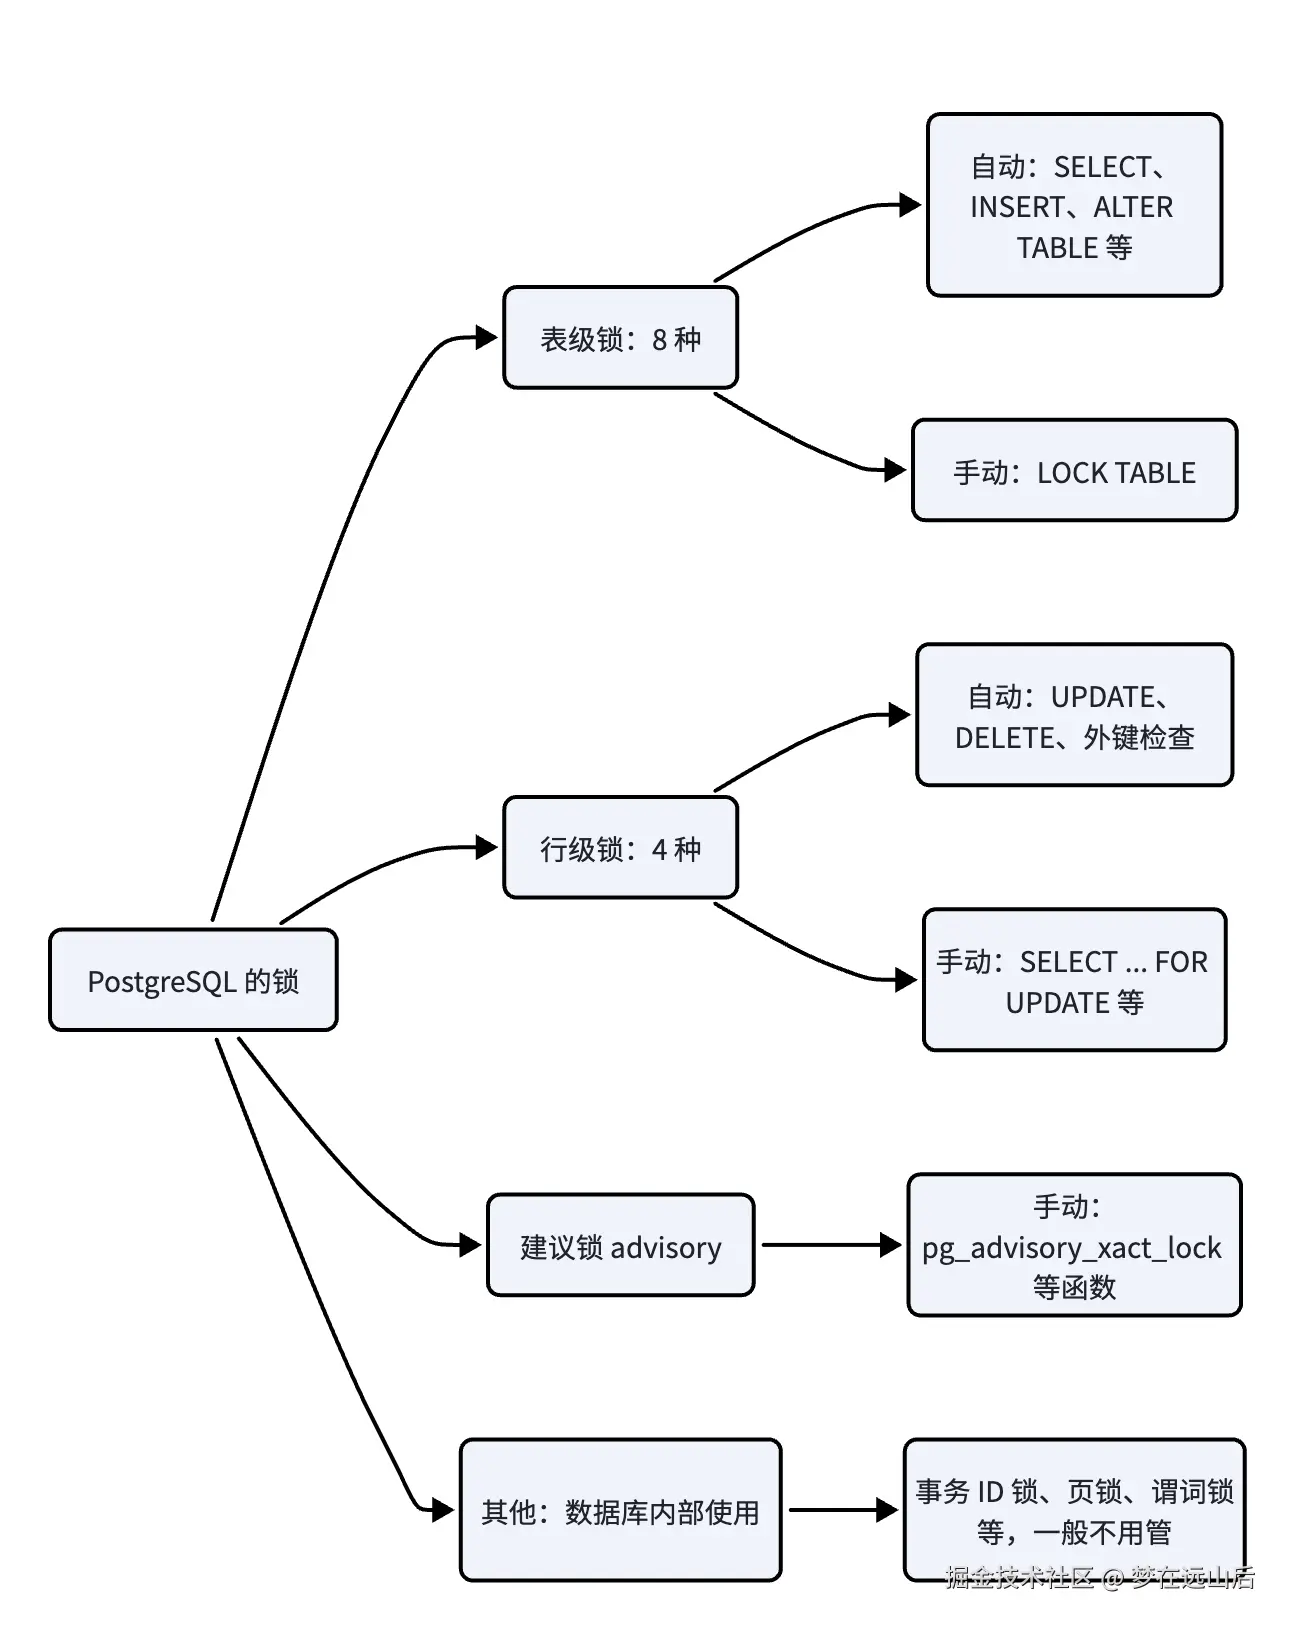
3.1 表级锁:8 种
每条 SQL 执行时,都会自动给涉及的表加一把表级锁。名字里虽然有 ROW,它们都是表级锁,名字是历史原因。下图是它们之间的冲突关系:
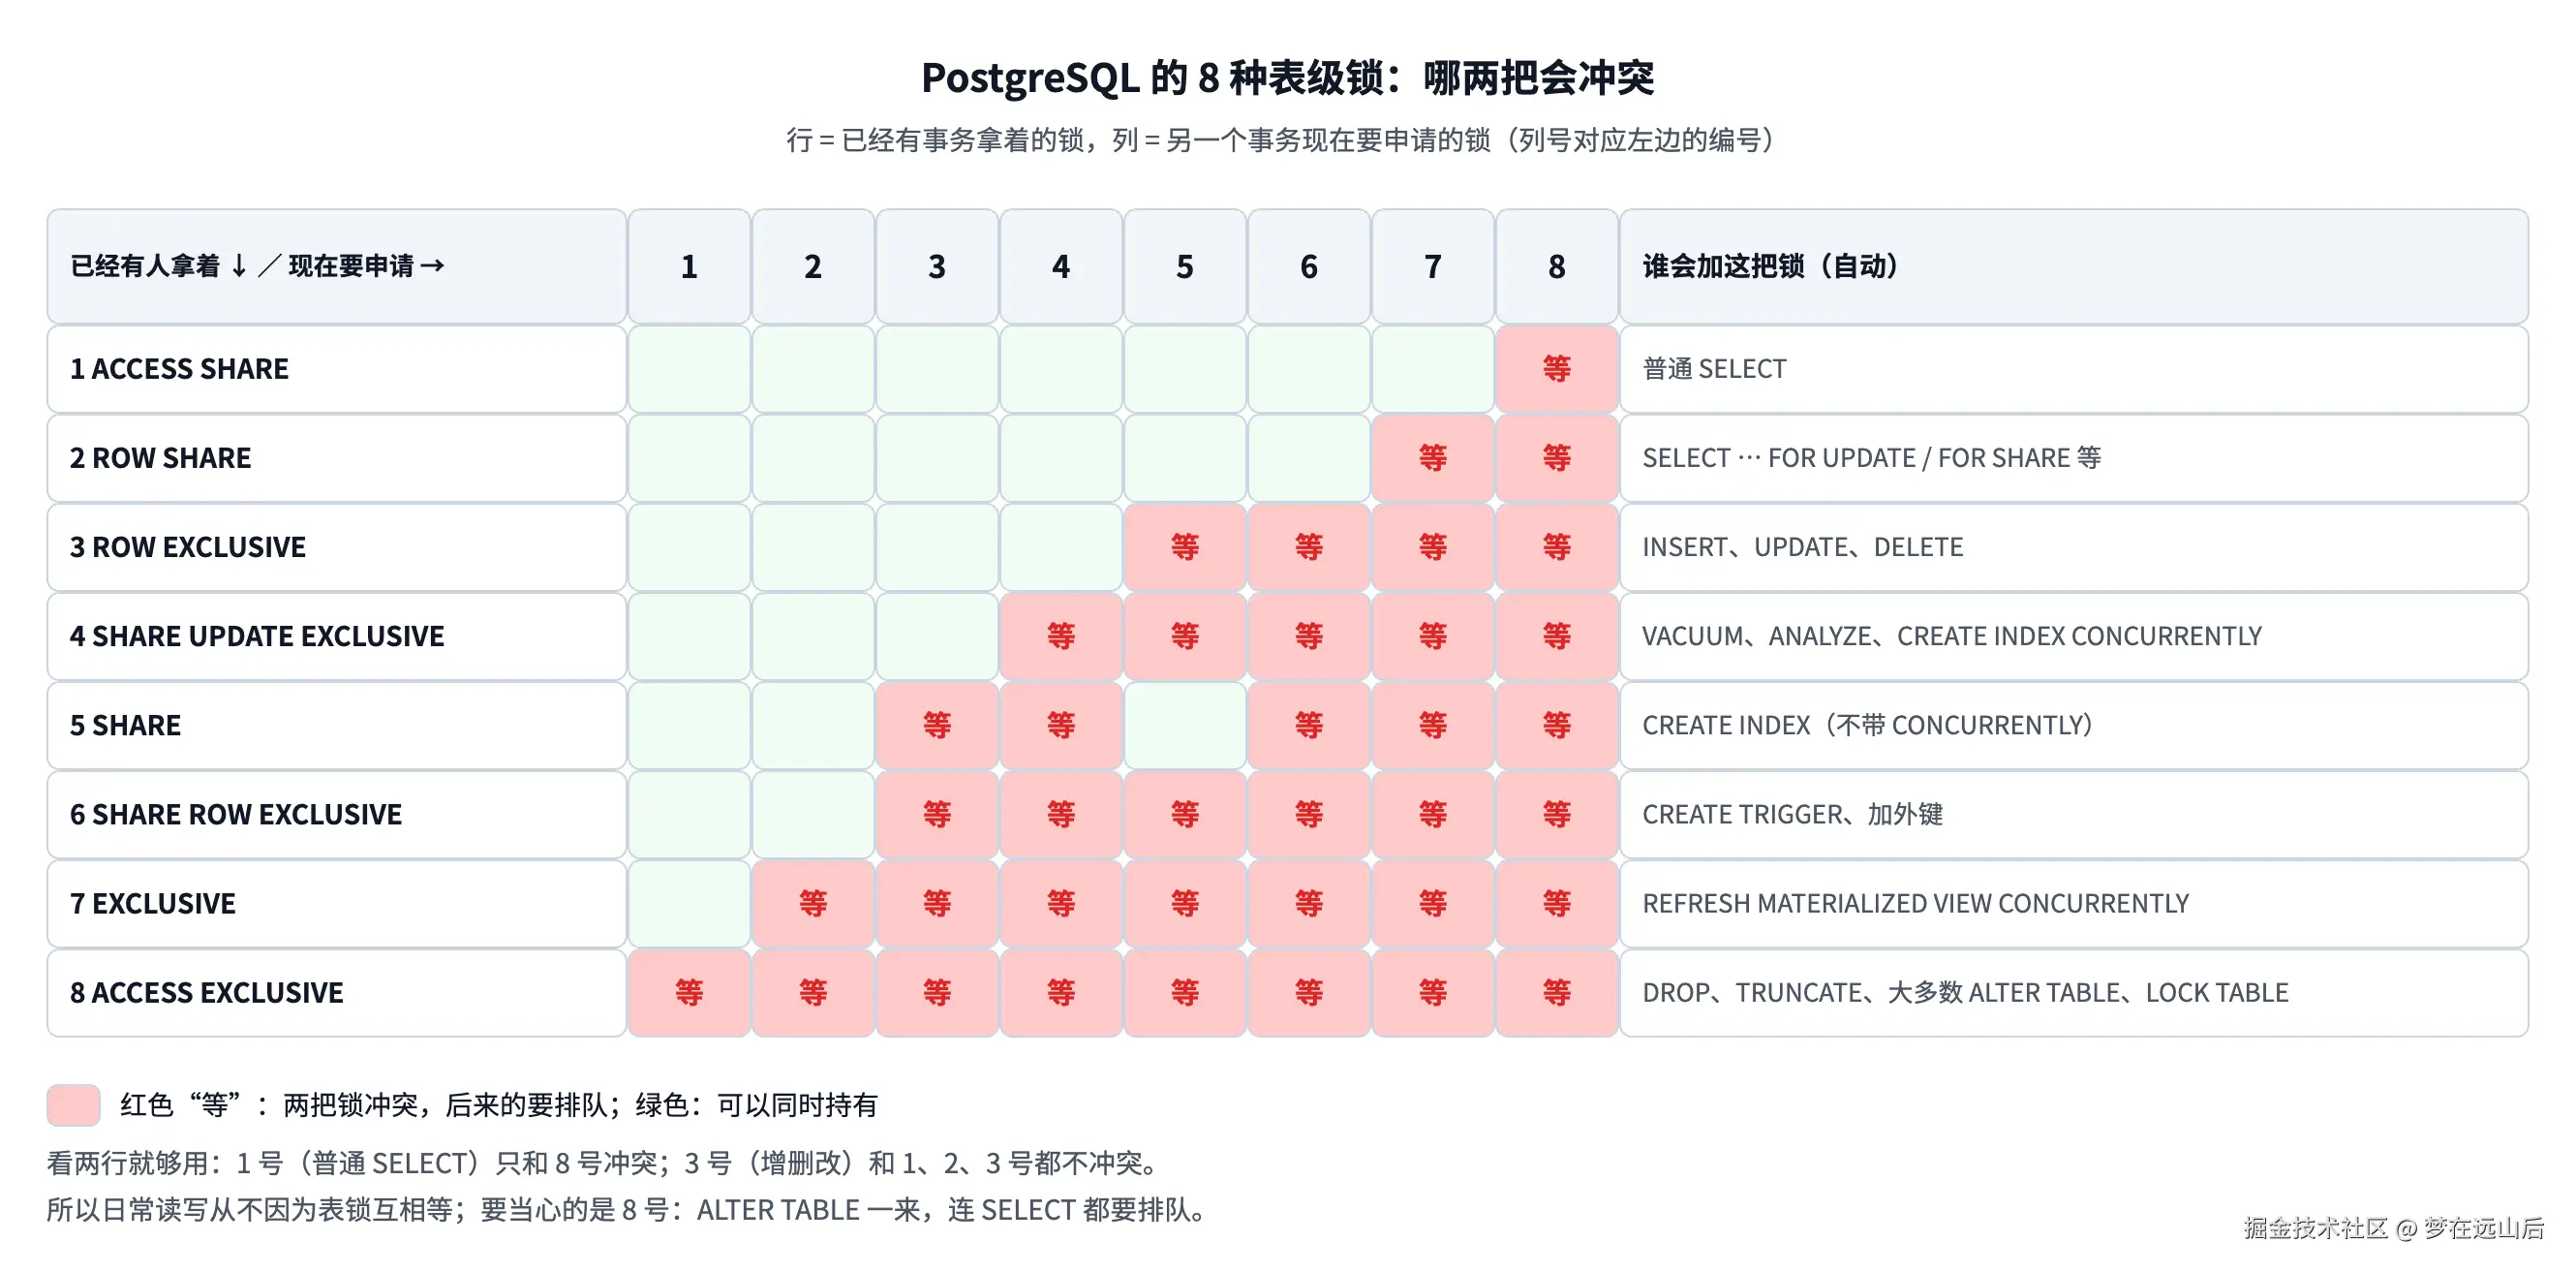
日常开发只需要记住三点:
- 普通 SELECT 加的 ACCESS SHARE,只和 ACCESS EXCLUSIVE 冲突;
- INSERT、UPDATE、DELETE 加的 ROW EXCLUSIVE,彼此之间不冲突。所以两个事务同时改同一张表的不同行,表锁层面不会等;真正的排队发生在行锁上;
- 大多数 ALTER TABLE、DROP、TRUNCATE 加的是 ACCESS EXCLUSIVE,和所有锁冲突,包括普通 SELECT。线上改表结构要特别小心(见 6.4)。
手动加表锁的写法如下,业务代码里很少需要:
sql
BEGIN;
LOCK TABLE conversation IN SHARE ROW EXCLUSIVE MODE;  -- 不写 IN ... MODE 时默认是 ACCESS EXCLUSIVE
-- ...
COMMIT;  -- 表锁到这里才释放
3.2 行级锁:4 种
行级锁锁的是某几行,只和锁同一行的事务冲突。普通 SELECT 不加行锁,所以永远不会在行锁上等待。
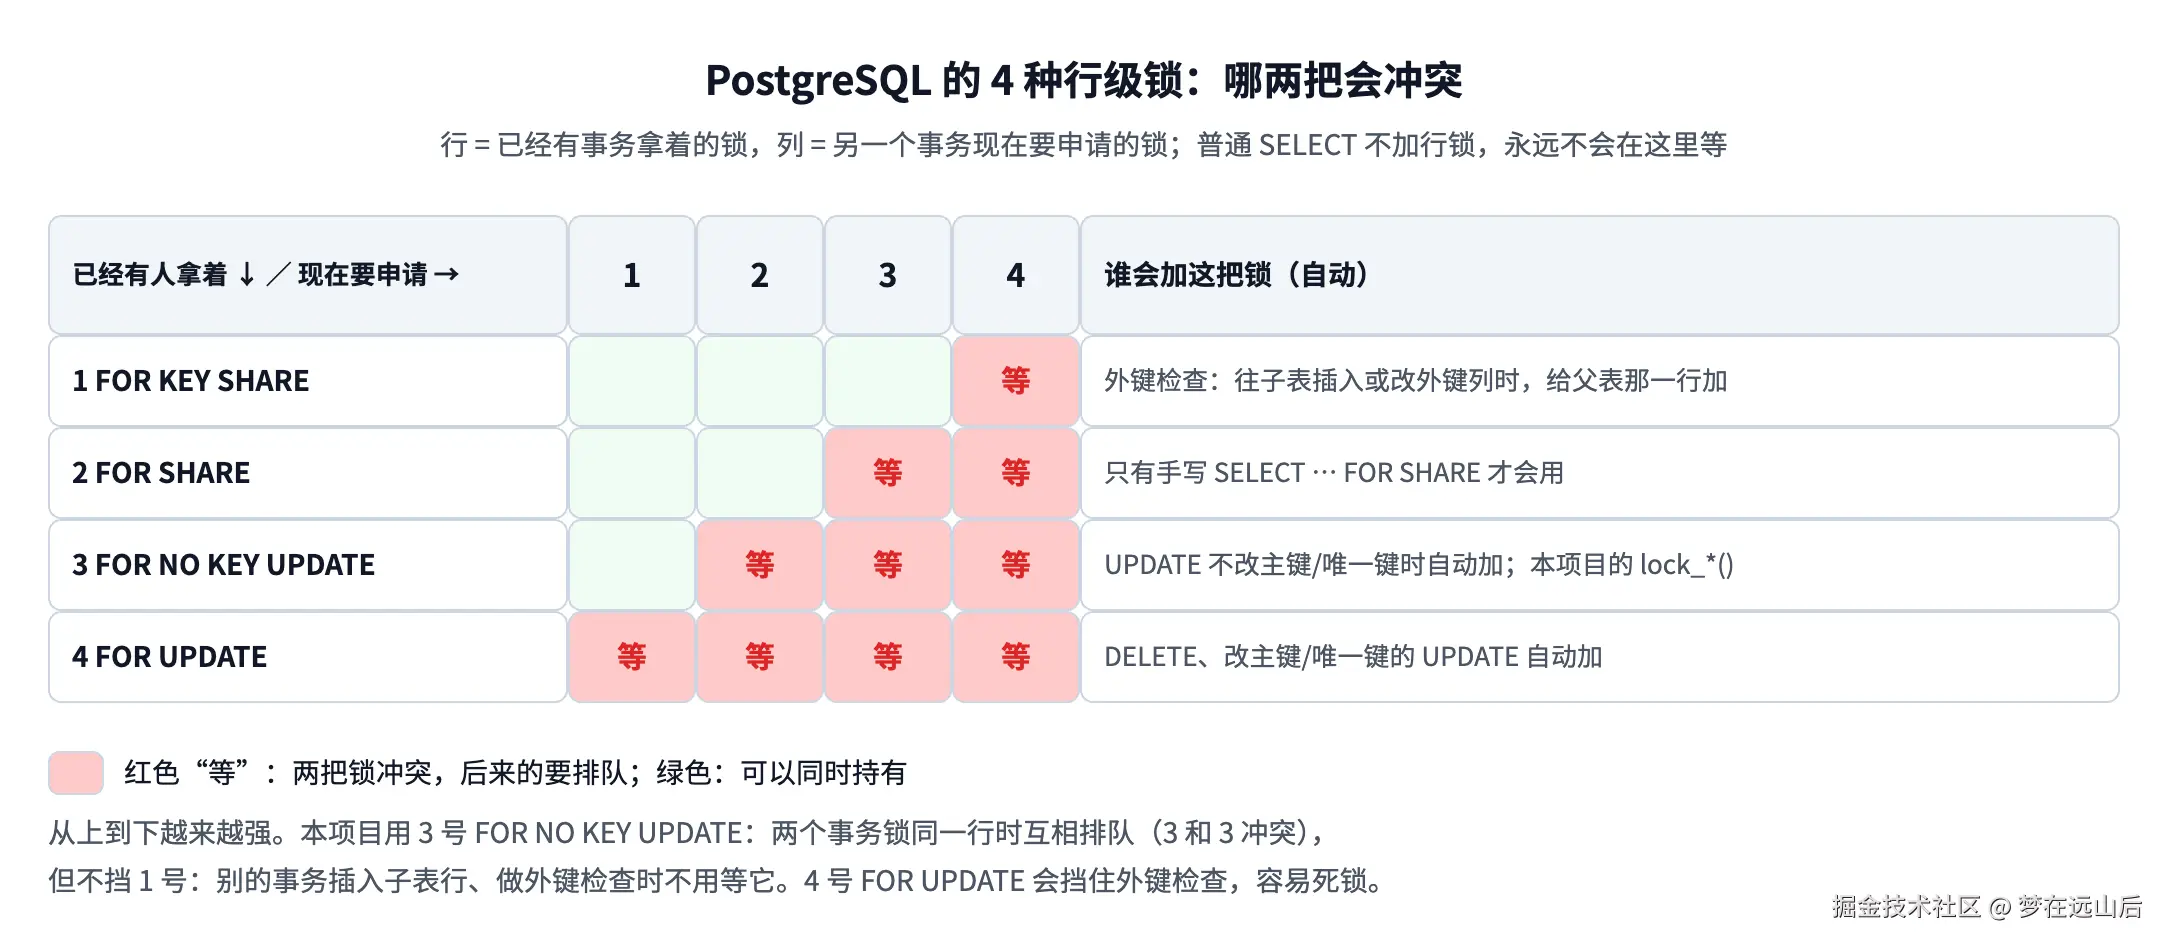
| 行锁 | 自动加的时机 | 手动写法 | 什么时候手动用 |
|---|---|---|---|
| FOR UPDATE | DELETE;UPDATE 改了主键或唯一键 | SELECT ... FOR UPDATE |
要删这一行,或者要改它的主键 |
| FOR NO KEY UPDATE | UPDATE 没改主键和唯一键(最常见) | SELECT ... FOR NO KEY UPDATE |
读出来判断后要改这一行,但不改主键。DevMind 用的就是它 |
| FOR SHARE | 不会自动加 | SELECT ... FOR SHARE |
读的时候不许别人改,但允许别人也来读 |
| FOR KEY SHARE | 外键检查:插入子表行、或改子表的外键列时,给父表那一行加 | SELECT ... FOR KEY SHARE |
很少手动用 |
FOR UPDATE 和 FOR NO KEY UPDATE 的区别,只在于挡不挡 FOR KEY SHARE:
- FOR UPDATE 表示"这一行可能被删掉,或者主键会变",所以别人不能往子表插入指向它的行;
- FOR NO KEY UPDATE 表示"我会改这一行,但主键不变",所以子表照样可以插入指向它的行。
很多教程只讲 FOR UPDATE。如果你不改主键,用 FOR NO KEY UPDATE 更合适,能少很多等待,DevMind 就是因为这个区别出过一次死锁(见 5.2)。
3.3 建议锁:锁一个数字
建议锁不和任何表、任何行关联,锁的是一个 64 位整数,这个数字代表什么由程序自己约定。数据库只保证:同一个数字,同一时刻只有一个事务(或会话)能拿到。
| 函数 | 作用 | 什么时候释放 |
|---|---|---|
pg_advisory_xact_lock(key) |
拿锁,拿不到就等 | 事务结束时自动释放 |
pg_try_advisory_xact_lock(key) |
试一下,拿不到立刻返回 false | 事务结束时自动释放 |
pg_advisory_lock(key) |
会话级锁,拿不到就等 | 必须手动调用 pg_advisory_unlock(key),或者连接断开 |
pg_advisory_lock_shared(key) |
共享版本,多个人可以同时拿 | 同上 |
什么时候用建议锁:要锁的东西还不存在 ,没有行可以锁。比如"同一个幂等键只能创建一次",第一次请求到达时,数据库里还没有这条记录,SELECT ... FOR UPDATE 什么也锁不住。DevMind 的新会话第一问就是这种情况(见 4.2)。
用连接池时,优先用带 xact 的事务级版本。会话级的锁跟着连接走,忘了释放的话,连接回到池子里被别的请求借走,锁还在。
3.4 其他锁
还有一些数据库内部使用的锁,一般不需要主动关心,但排查问题时会在 pg_locks 里看到:
- 事务 ID 锁(transactionid) :每个写数据的事务都会对自己的事务 ID 加排他锁。别的事务等某一行时,实际上是在等"改这一行的那个事务结束",在
pg_locks里表现为等待一个 transactionid 的 ShareLock。第 5.3 节死锁报错里的 "waits for ShareLock on transaction" 就是它; - 页锁、谓词锁(SIReadLock) :前者是内部读写数据页用的,后者只在 SERIALIZABLE 隔离级别下出现,用来检测读写冲突。
3.5 怎么"开启"锁
PostgreSQL 的锁不需要开启什么开关,绝大多数是执行 SQL 时自动加的。需要你做的,是在该加锁的地方显式写出来,并配置好等待策略:
sql
BEGIN;  -- 1. 一定在事务里

-- 2. 显式加行锁:在 SELECT 后面加锁子句
SELECT * FROM conversation WHERE id = 'c1' FOR NO KEY UPDATE;

-- 不想等:拿不到立刻报错(错误码 55P03)
SELECT * FROM conversation WHERE id = 'c1' FOR NO KEY UPDATE NOWAIT;

-- 跳过已被锁住的行:多个 worker 从同一张表里抢任务时常用
SELECT * FROM job WHERE status = 'queued' ORDER BY id LIMIT 1 FOR UPDATE SKIP LOCKED;

-- 3. 建议锁
SELECT pg_advisory_xact_lock(hashtextextended('user-1:key-abc', 0));

COMMIT; -- 4. 提交或回滚时,以上所有锁一起释放和锁有关的几个参数,可以对单个事务设置(SET LOCAL),也可以对整个会话或数据库设置:
| 参数 | 默认值 | 作用 |
|---|---|---|
lock_timeout |
0(一直等) | 等锁超过这个时间就报错放弃,错误码 55P03 |
deadlock_timeout |
1s | 等锁超过这个时间,才开始检查是不是死锁 |
statement_timeout |
0(不限) | 单条语句的总执行时间上限,等锁的时间也算在内 |
idle_in_transaction_session_timeout |
0(不限) | 事务开着却什么也不做,超过这个时间就断开连接 |
sql
BEGIN;
SET LOCAL lock_timeout = '3s';  -- 只对这个事务生效
ALTER TABLE agent_run ADD COLUMN note TEXT;
COMMIT;
3.6 实测结果
下面每一行都是用两个连接实际跑出来的:连接 A 先执行第一列,事务不提交;连接 B 再执行第二列,看它要不要等。
| A 先持有 | B 再执行 | B 要不要等 |
|---|---|---|
SELECT ... FOR UPDATE(id = 1) |
普通 SELECT(id = 1) |
不等 |
UPDATE(id = 1),未提交 |
普通 SELECT(id = 1) |
不等,读到旧值 |
SELECT ... FOR UPDATE(id = 1) |
SELECT ... FOR UPDATE(id = 2) |
不等,不是同一行 |
FOR SHARE |
FOR SHARE |
不等 |
FOR SHARE |
UPDATE 同一行 |
等 |
父表行 FOR UPDATE |
往子表插入一行指向它 | 等(外键检查要 KEY SHARE) |
父表行 FOR NO KEY UPDATE |
往子表插入一行指向它 | 不等 |
父表行 FOR UPDATE |
在另一个事务里第一次 UPDATE 子表行,不改外键列 | 不等(外键列没变,跳过检查) |
父表行 FOR UPDATE |
同一个事务里第二次 UPDATE 同一子表行 | 等(这行是本事务刚改过的,要重新检查外键) |
普通 SELECT,事务未结束 |
ALTER TABLE ... ADD COLUMN |
等 |
UPDATE 某行,未提交 |
CREATE INDEX |
等 |
pg_advisory_xact_lock(42) |
pg_advisory_xact_lock(42) |
等 |
pg_advisory_xact_lock(42) |
锁任意一行 | 不等,建议锁和行锁互不相干 |
某行 FOR UPDATE |
同一行 FOR UPDATE NOWAIT |
立刻报错 could not obtain lock on row |
第 10 行 FOR UPDATE |
SELECT id ... FOR UPDATE SKIP LOCKED |
不等,只返回第 11 行 |
"第一次 UPDATE 子表行"和"第二次 UPDATE 同一子表行"这两行的差别,就是 DevMind 那次死锁的根源,见 5.2。
4. DevMind 里的锁
4.1 项目里用到的并发控制手段
项目里的 SQL 都在 runs/repository.py,Service 在 runs/service.py。用到的手段有五类:
| 手段 | 代码位置 | 防的是什么 |
|---|---|---|
| 事务 | RunService._transaction() |
一组 SQL 要么全成功,要么全回滚;锁也在事务结束时才释放 |
| 建议锁 | lock_idempotency_key() |
同一个幂等键(双击发送、网络重发)的并发请求排队 |
| 行锁 FOR NO KEY UPDATE | lock_conversation()、lock_turn()、lock_run()、lock_interrupt() |
先读、判断、再写的逻辑,判断期间别人不能改 |
| 条件更新、原子更新 | claim_queued_run()、next_turn_sequence() |
一条 UPDATE 完成"检查 + 修改",不需要额外加锁 |
| 唯一约束和部分唯一索引 | 迁移文件 0001、0002 | 最后一道防线:代码漏了加锁,数据库也不会写进重复数据 |
_transaction() 负责借连接、开事务,并把唯一约束冲突转成 409:
python
@asynccontextmanager
async def _transaction(self) -> AsyncGenerator[AsyncConnection, None]:
    """所有写操作共用的事务入口:借连接、开事务,并把唯一约束冲突转换为领域异常。

    @asynccontextmanager 的用法:yield 之前的代码在进入 async with 时执行,
    yield 出去的 conn 就是 as 后面拿到的变量,async with 块结束后再回到 yield 之后。
    `async with A() as conn, conn.transaction():` 等价于两层嵌套的 async with:
    先借连接,再在这个连接上开事务;退出时先提交或回滚事务,再归还连接。

    加锁顺序:所有事务第一把锁都是幂等键(只有准备方法有),之后一律按
    "会话 → 轮次 → 执行 → 中断"的顺序加锁,用不到的层级可以跳过,但不能倒过来。
    两个事务按同样的顺序抢锁,就不会出现"A 等 B、B 等 A"的死锁。

    正常流程下,锁和前置检查已经排除了重复写入;唯一约束是最后一道防线。
    一旦触发(例如以后改代码漏了加锁),返回 409 RUN_CONFLICT,而不是 500。
    """
    try:
        async with self._repo.connection() as conn, conn.transaction():
            yield conn
    except UniqueViolation as exc:
        # 事务已经回滚;约束名写进消息,方便从日志定位是哪条规则被违反
        raise RunConflictError(f"unique constraint violated: {exc.diag.constraint_name}") from exc
4.2 建议锁:新会话的第一问被双击
用户在新会话里提第一个问题,前端连点了两次"发送",两个请求带着同一个幂等键同时到达。这时数据库里还没有会话,也没有执行记录,没有任何一行可以锁。所以先锁"用户 + 幂等键"这个组合:
python
async def lock_idempotency_key(
    self, conn: AsyncConnection, *, user_id: str, idempotency_key: str
) -> None:
    """锁住"用户 + 幂等键"这个组合,同一个键的并发请求在这里排队。

    新会话的第一问还没有会话行可以 FOR UPDATE,所以改锁幂等键本身。
    pg_advisory_xact_lock 是 PostgreSQL 的事务级"建议锁":锁的不是某一行,而是一个整数,
    同一个整数同一时刻只有一个事务能拿到,事务提交或回滚时自动释放。
    hashtextextended 把字符串哈希成 64 位整数;不同的键哈希碰撞的概率极低,
    就算碰上也只是让两个无关请求多排一次队,不影响正确性。
    """
    await conn.execute(
        "SELECT pg_advisory_xact_lock(hashtextextended(%s, 0))",
        (f"{user_id}:{idempotency_key}",),
    )
两个请求同时到达时的过程:
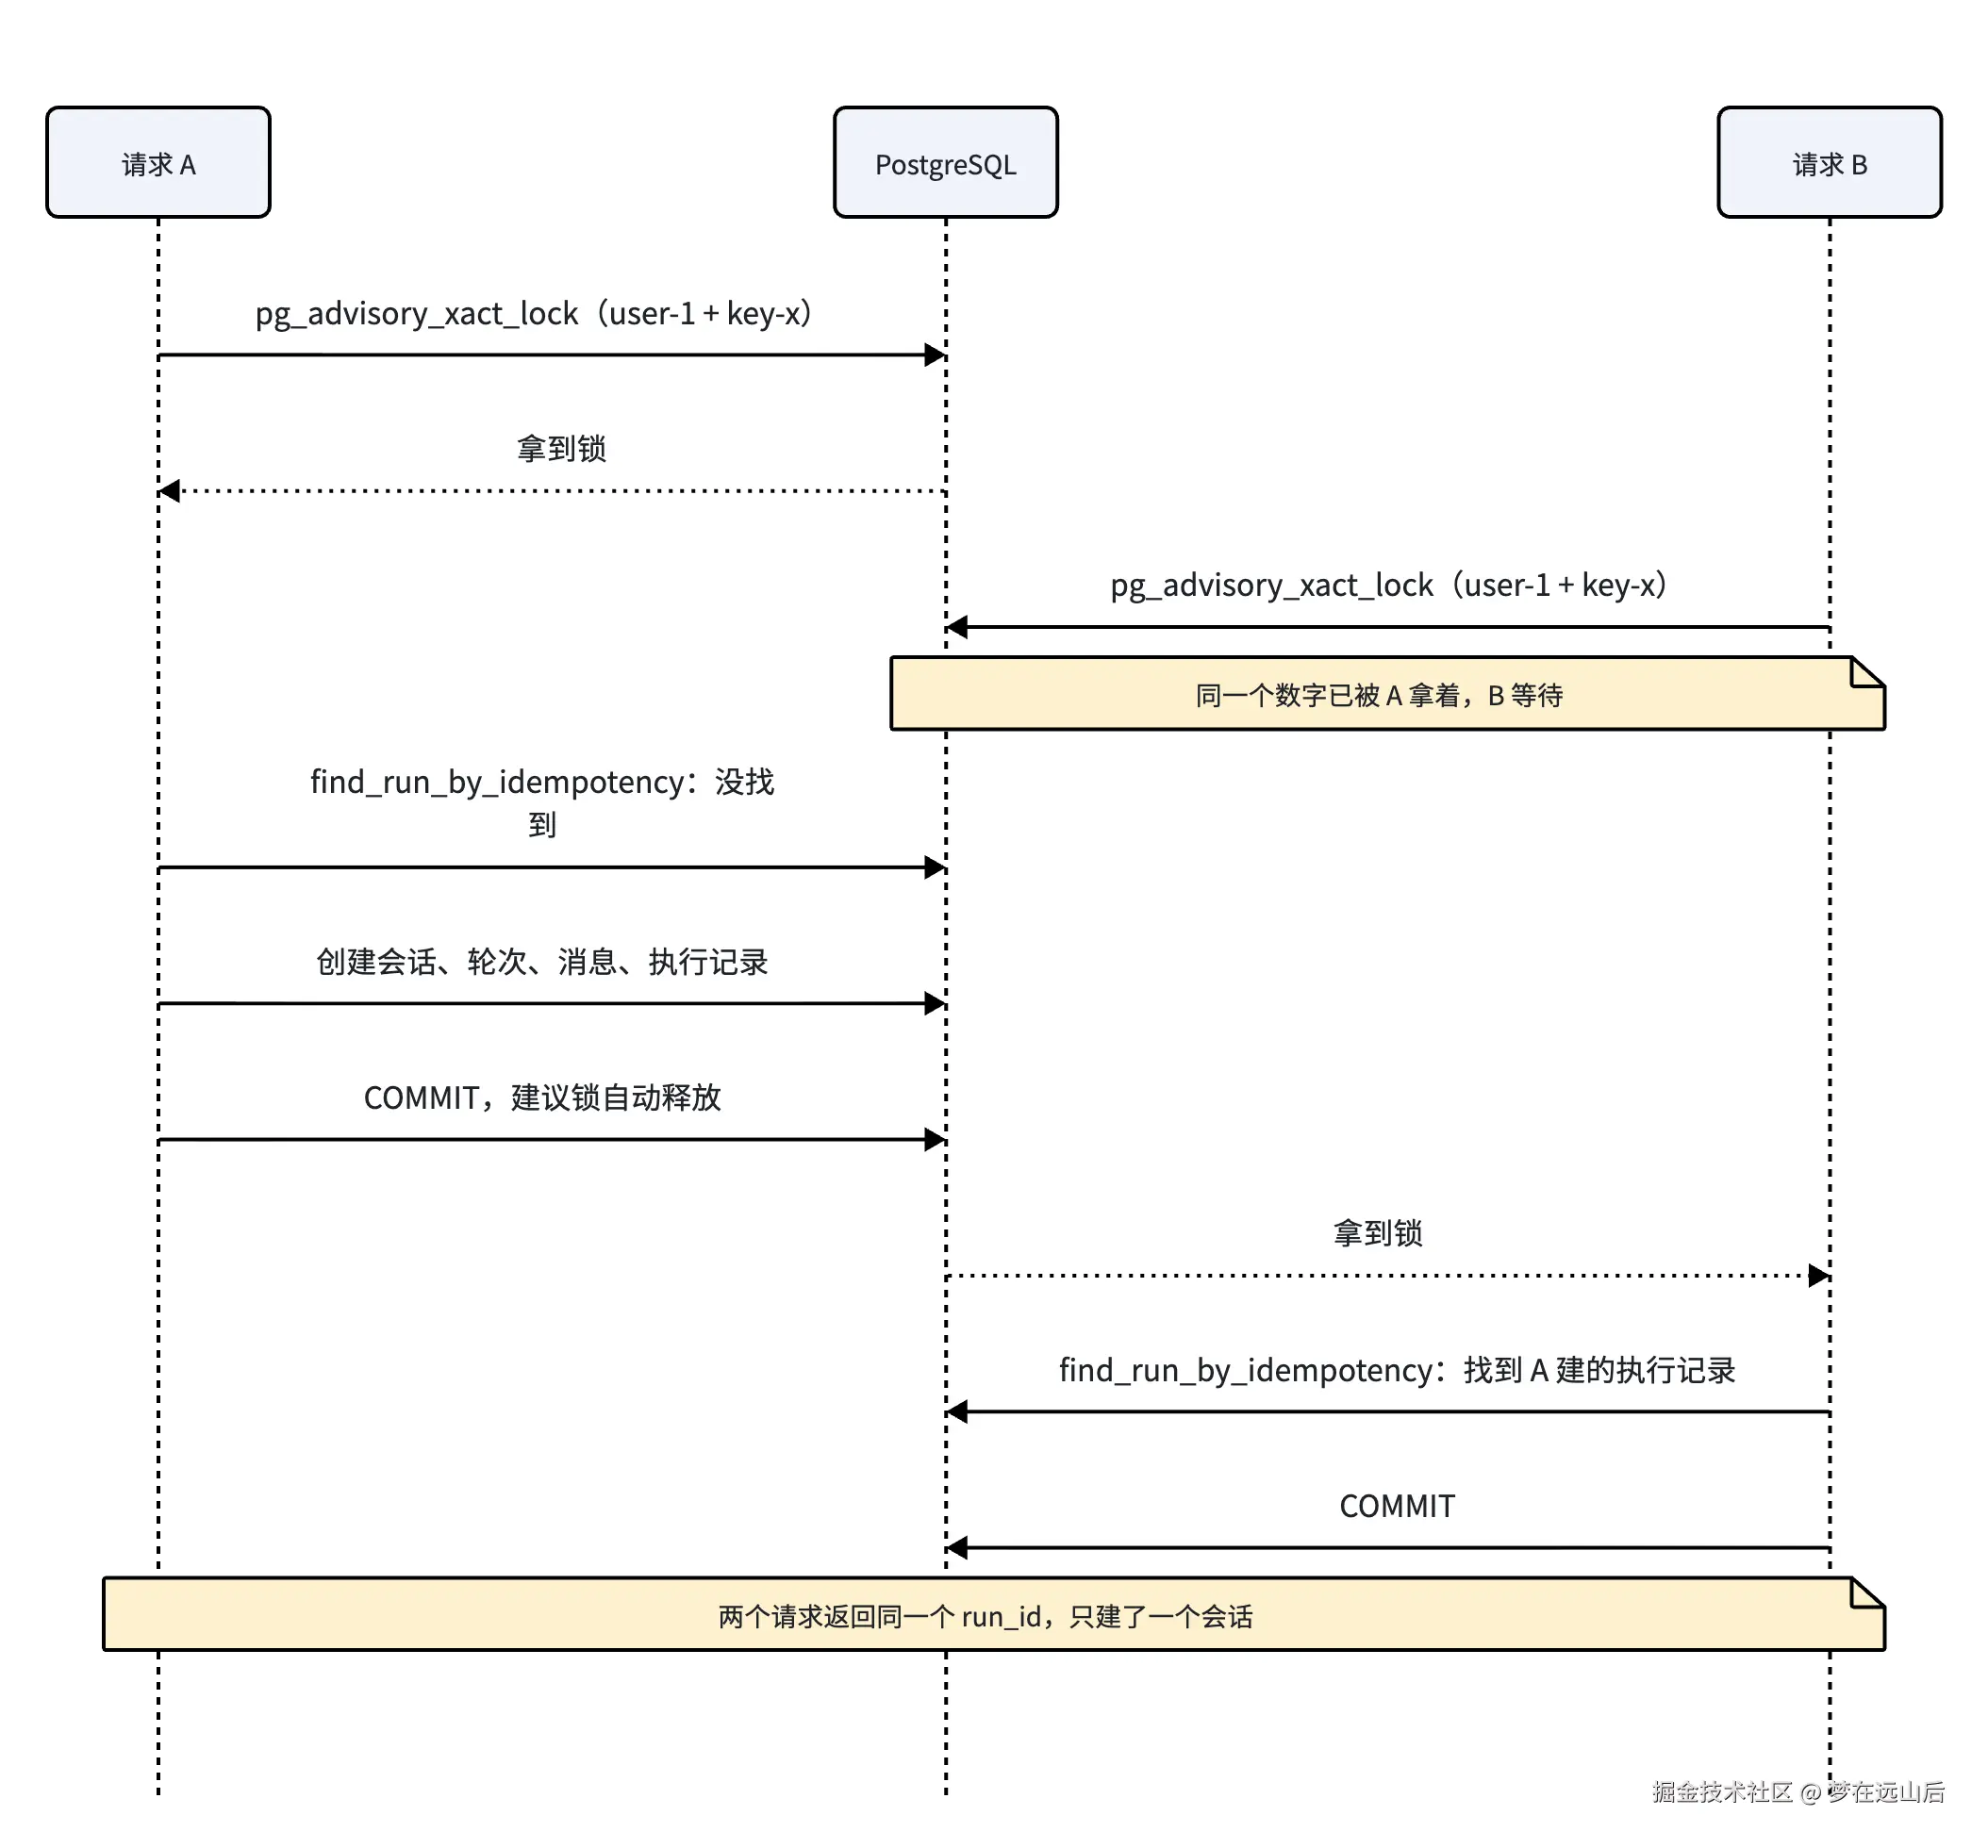
为什么锁要放在"查有没有用过"之前:如果先查再锁,A 和 B 可能同时查到"没用过",然后都去创建。检查必须在锁里面做,这是所有"先检查、再行动"问题的通用解法。
另外还有唯一索引 uq_agent_run_idempotency (user_id, idempotency_key) 兜底:万一锁漏了,第二次插入会违反唯一约束,被 _transaction() 转成 409,而不是写进重复数据。
对应的测试是 tests/test_m4a_runs.py 里的双击发送用例。
4.3 行锁:同一会话里的新问题排队
在已有会话里提问、编辑重跑,都要先锁住会话行:
python
async def lock_conversation(
    self, conn: AsyncConnection, conversation_id: str
) -> ConversationRecord | None:
    """锁住会话行:同一会话的新增轮次、编辑重跑在这里排队,保证 Turn 序号和"最新一轮"不冲突。"""
    cur = await conn.execute(
        """
        SELECT * FROM conversation
        WHERE id = %s AND deleted_at IS NULL
        FOR NO KEY UPDATE
        """,
        (conversation_id,),
    )
    row = await cur.fetchone()
return ConversationRecord.from_row(row) if row else None锁住会话行之后,prepare_new_turn() 在锁里做几件事:
- 检查最新一轮是否还在执行、是否在等审批(
_check_latest_turn_finished()),是就返回 409; next_turn_sequence()把last_turn_seq加 1,拿到新一轮的序号;- 插入轮次、消息、执行记录。
如果不锁会话行,两个请求可能同时通过第 1 步的检查,然后在同一个会话里各开一轮。锁住之后,后到的请求要等前一个提交,再读到的就是最新状态。
这就是第 1.1 节那张图右半边的情况。唯一约束 UNIQUE (conversation_id, sequence_no) 同样作为兜底。
4.4 条件更新:同一个执行只能开始一次
执行接口 /api/agent 拿到 run_id 后,要把这个执行从 queued 改成 running。如果同一个 run_id 的请求被发了两次,只能有一个真正去跑模型:
python
async def claim_queued_run(self, conn: AsyncConnection, run_id: str) -> AgentRunRecord | None:
    """单条条件 UPDATE 原子抢占:只有 queued 的 Run 能变成 running,其余请求拿到 None。

    不能写成"先 SELECT 看是不是 queued,再 UPDATE":两个请求可能同时看到 queued,都去执行。
    把条件写进 UPDATE 的 WHERE 里,数据库保证只有一个请求能命中这一行。
    """
    cur = await conn.execute(
        """
        UPDATE agent_run
        SET status = 'running', started_at = NOW(), updated_at = NOW()
        WHERE id = %s AND status = 'queued'
        RETURNING *
        """,
        (run_id,),
    )
    row = await cur.fetchone()
    return AgentRunRecord.from_row(row) if row else None
这里没有先 SELECT ... FOR UPDATE,因为一条 UPDATE 已经足够:
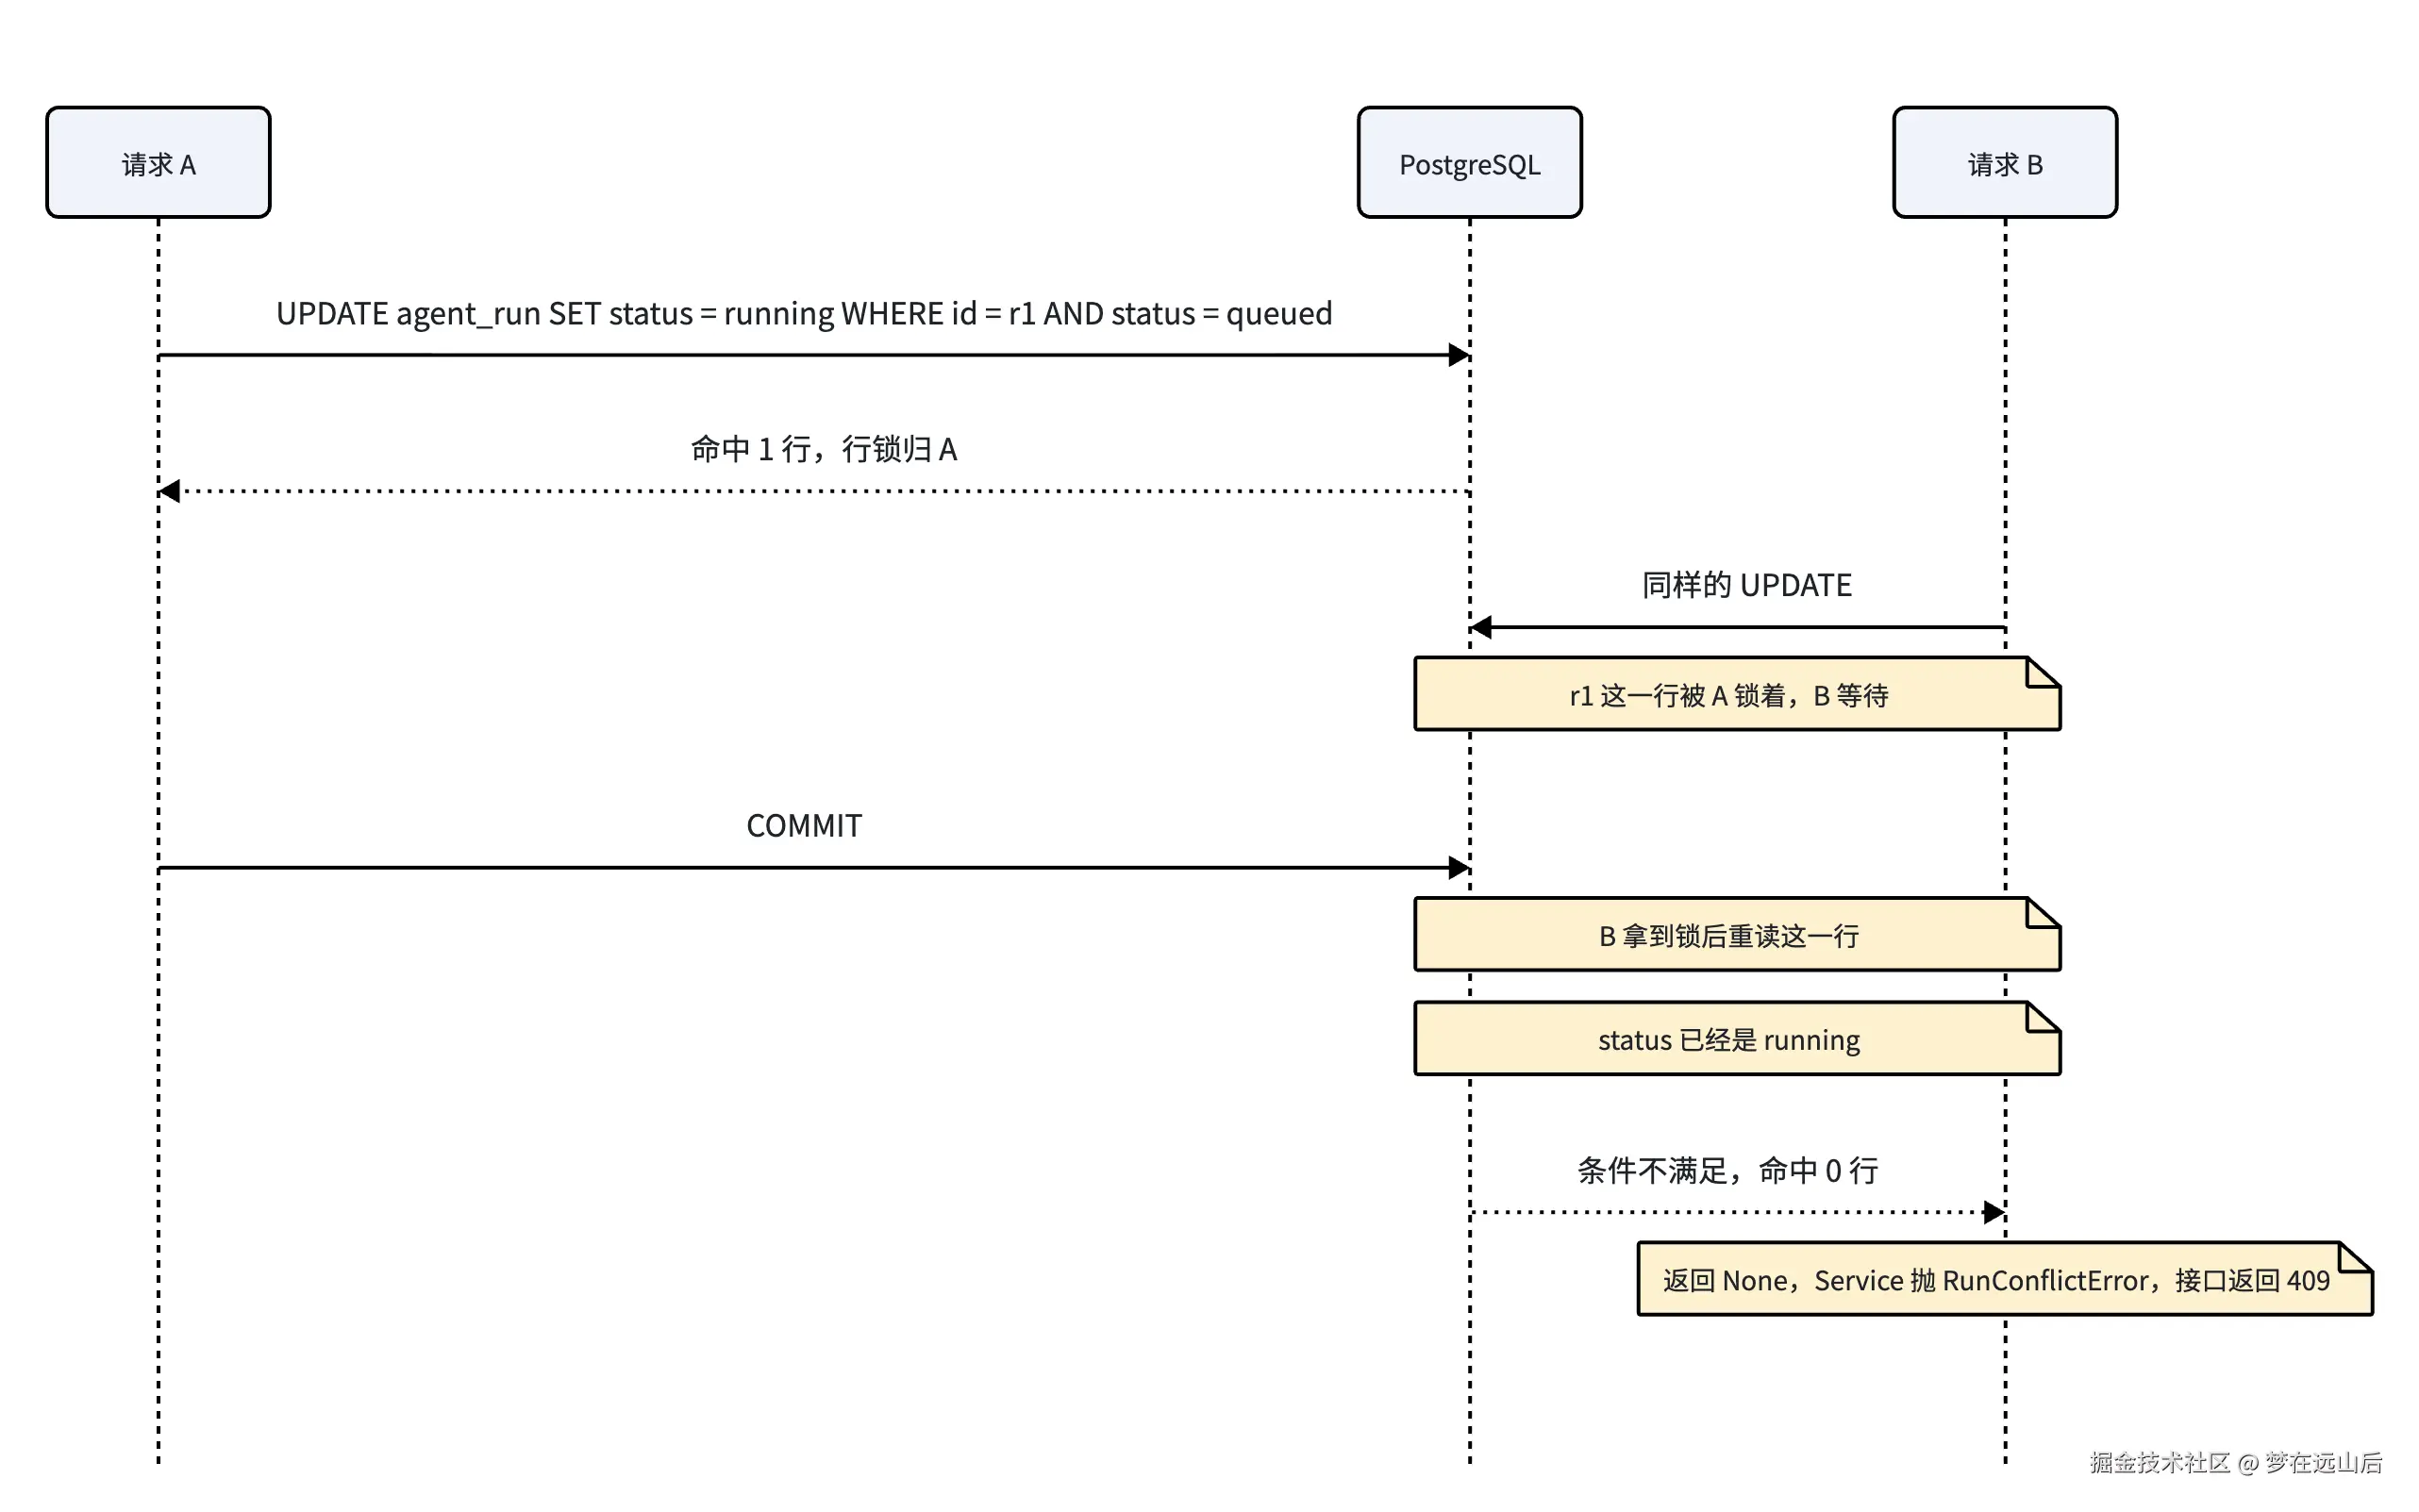
这就是第 2.5 节说的:READ COMMITTED 下,等过锁的 UPDATE 会用最新版本重新判断 WHERE。实测中 B 在 A 提交前一直在等,A 提交后 B 的影响行数是 0。
此外还有部分唯一索引 uq_agent_run_active_graph_thread:同一条 graph_thread_id 同一时刻最多一个 queued 或 running 的执行,避免两个执行同时往 LangGraph 的同一个存档里写。
4.5 行锁:同一张审批卡片只能处理一次
用户对同一张审批卡片连点"允许",或者先点"允许"马上又点"拒绝"。prepare_resume() 按顺序锁住轮次、被中断的执行、中断记录,然后在锁里检查中断还是不是 open:
python
# 3. 由 Interrupt 反查被中断的 Run(来源 Run)和它所在的轮次。先不加锁地读,
#    然后按"轮次 → 执行 → 中断"的统一顺序加锁(见 _transaction 的说明)
found = await self._repo.get_interrupt(conn, interrupt_id)
if found is None:
    raise InterruptNotFoundError(interrupt_id)
source = await self._repo.get_run(conn, found.run_id)
if source.user_id != user_id:
    raise RunOwnershipError(source.id)
await self._repo.lock_turn(conn, source.turn_id)
parent = await self._repo.lock_run(conn, source.id)

# 4. 锁 Interrupt 后再检查:仍是 open,且来源 Run 停在 interrupted。
#    同一张卡片的并发审批、审批和编辑同时发生,都在前面的锁上排队,后到的在这里得到 409
interrupt = await self._repo.lock_interrupt(conn, interrupt_id)
if interrupt.status != "open":
    raise InterruptAlreadyResolvedError(interrupt_id)
if parent.status != RunStatus.INTERRUPTED:
    raise InvalidResumeTargetError(parent.id)
第二个请求在锁上等第一个提交;拿到锁后发现中断已经是 resolved,返回 409。部分唯一索引 uq_agent_interrupt_open_graph_thread 保证同一条状态链最多一个 open 的中断。
4.6 加锁顺序
一个事务往往要锁好几行。只要所有事务都按同一个顺序加锁,就不会死锁(原因见 5.3)。DevMind 规定的顺序是:幂等键 → 会话 → 轮次 → 执行 → 中断。
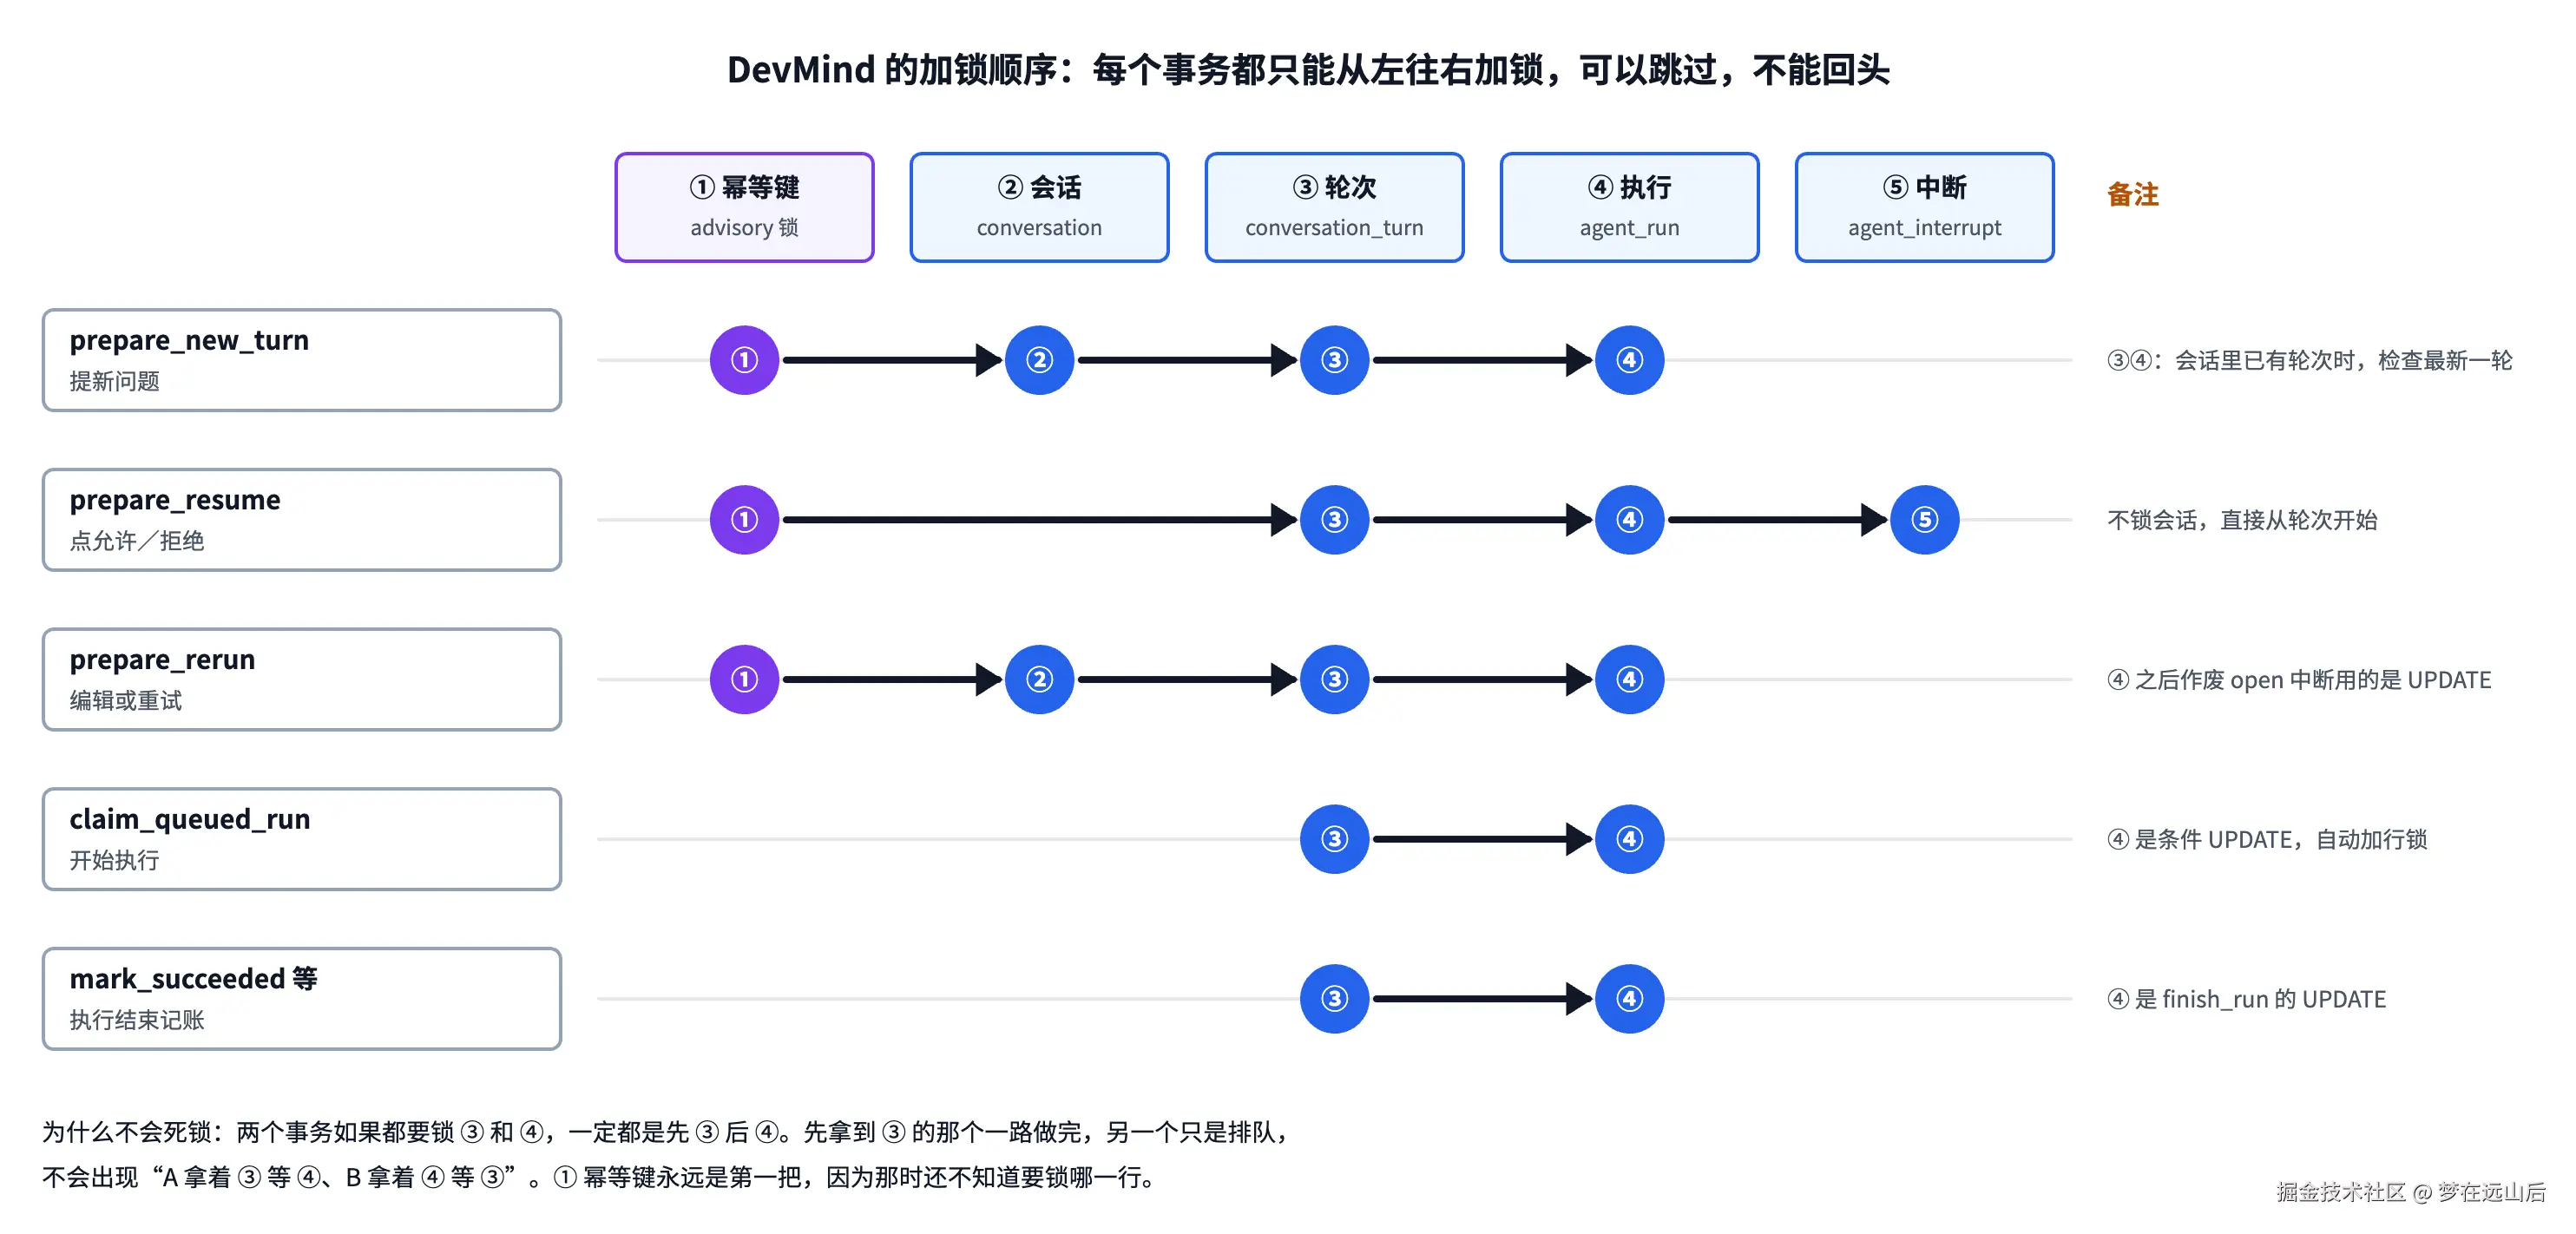
claim_queued_run() 和 mark_succeeded() 这些方法,本来只需要改执行记录,也要先 lock_turn()。原因是它们还要改轮次的状态,如果先改执行记录(UPDATE 会自动锁住执行这一行),再改轮次,就变成了"先 ④ 后 ③",和其他方法的顺序相反。
4.7 为什么准备和执行分成两个事务
DevMind 的一次提问分成"准备"和"执行"两步。准备在一个很短的事务里完成:加锁、检查、插入几行,一般几毫秒到几十毫秒。调模型可能要几十秒,它不在任何事务里 ;执行结束后,mark_succeeded() 再开一个新的短事务记账。
如果把调模型也放进准备的事务里,会话行的锁会被持有几十秒,这个会话里的所有其他操作都要排队;同时这个事务还一直占着连接池里的一个连接,连接池只有 10 个,很快就会被占满。
5. 死锁
5.1 死锁是什么
两个事务各自拿着对方需要的锁,又都在等对方先释放:
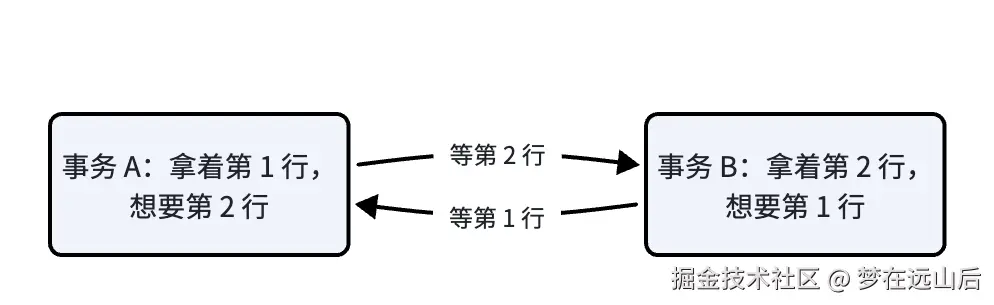
谁都不会主动放手,如果没人干预,两个事务会永远等下去。
和前端对比:JavaScript 是单线程的,await 两个 Promise 互相等待时,程序会一直卡着,但不会有人来"解开"。数据库不一样,PostgreSQL 会自动检测死锁并打破它。
注意:等锁不等于死锁。A 等 B,B 在正常干活,B 提交后 A 就能继续,这只是排队。只有等待关系形成一个环,才是死锁。
5.2 项目里遇到过的一次死锁
DevMind 的一个测试让"编辑重跑"和"点允许"对同一轮同时发出。当时所有 lock_*() 用的都是 FOR UPDATE,结果偶尔报 deadlock detected:
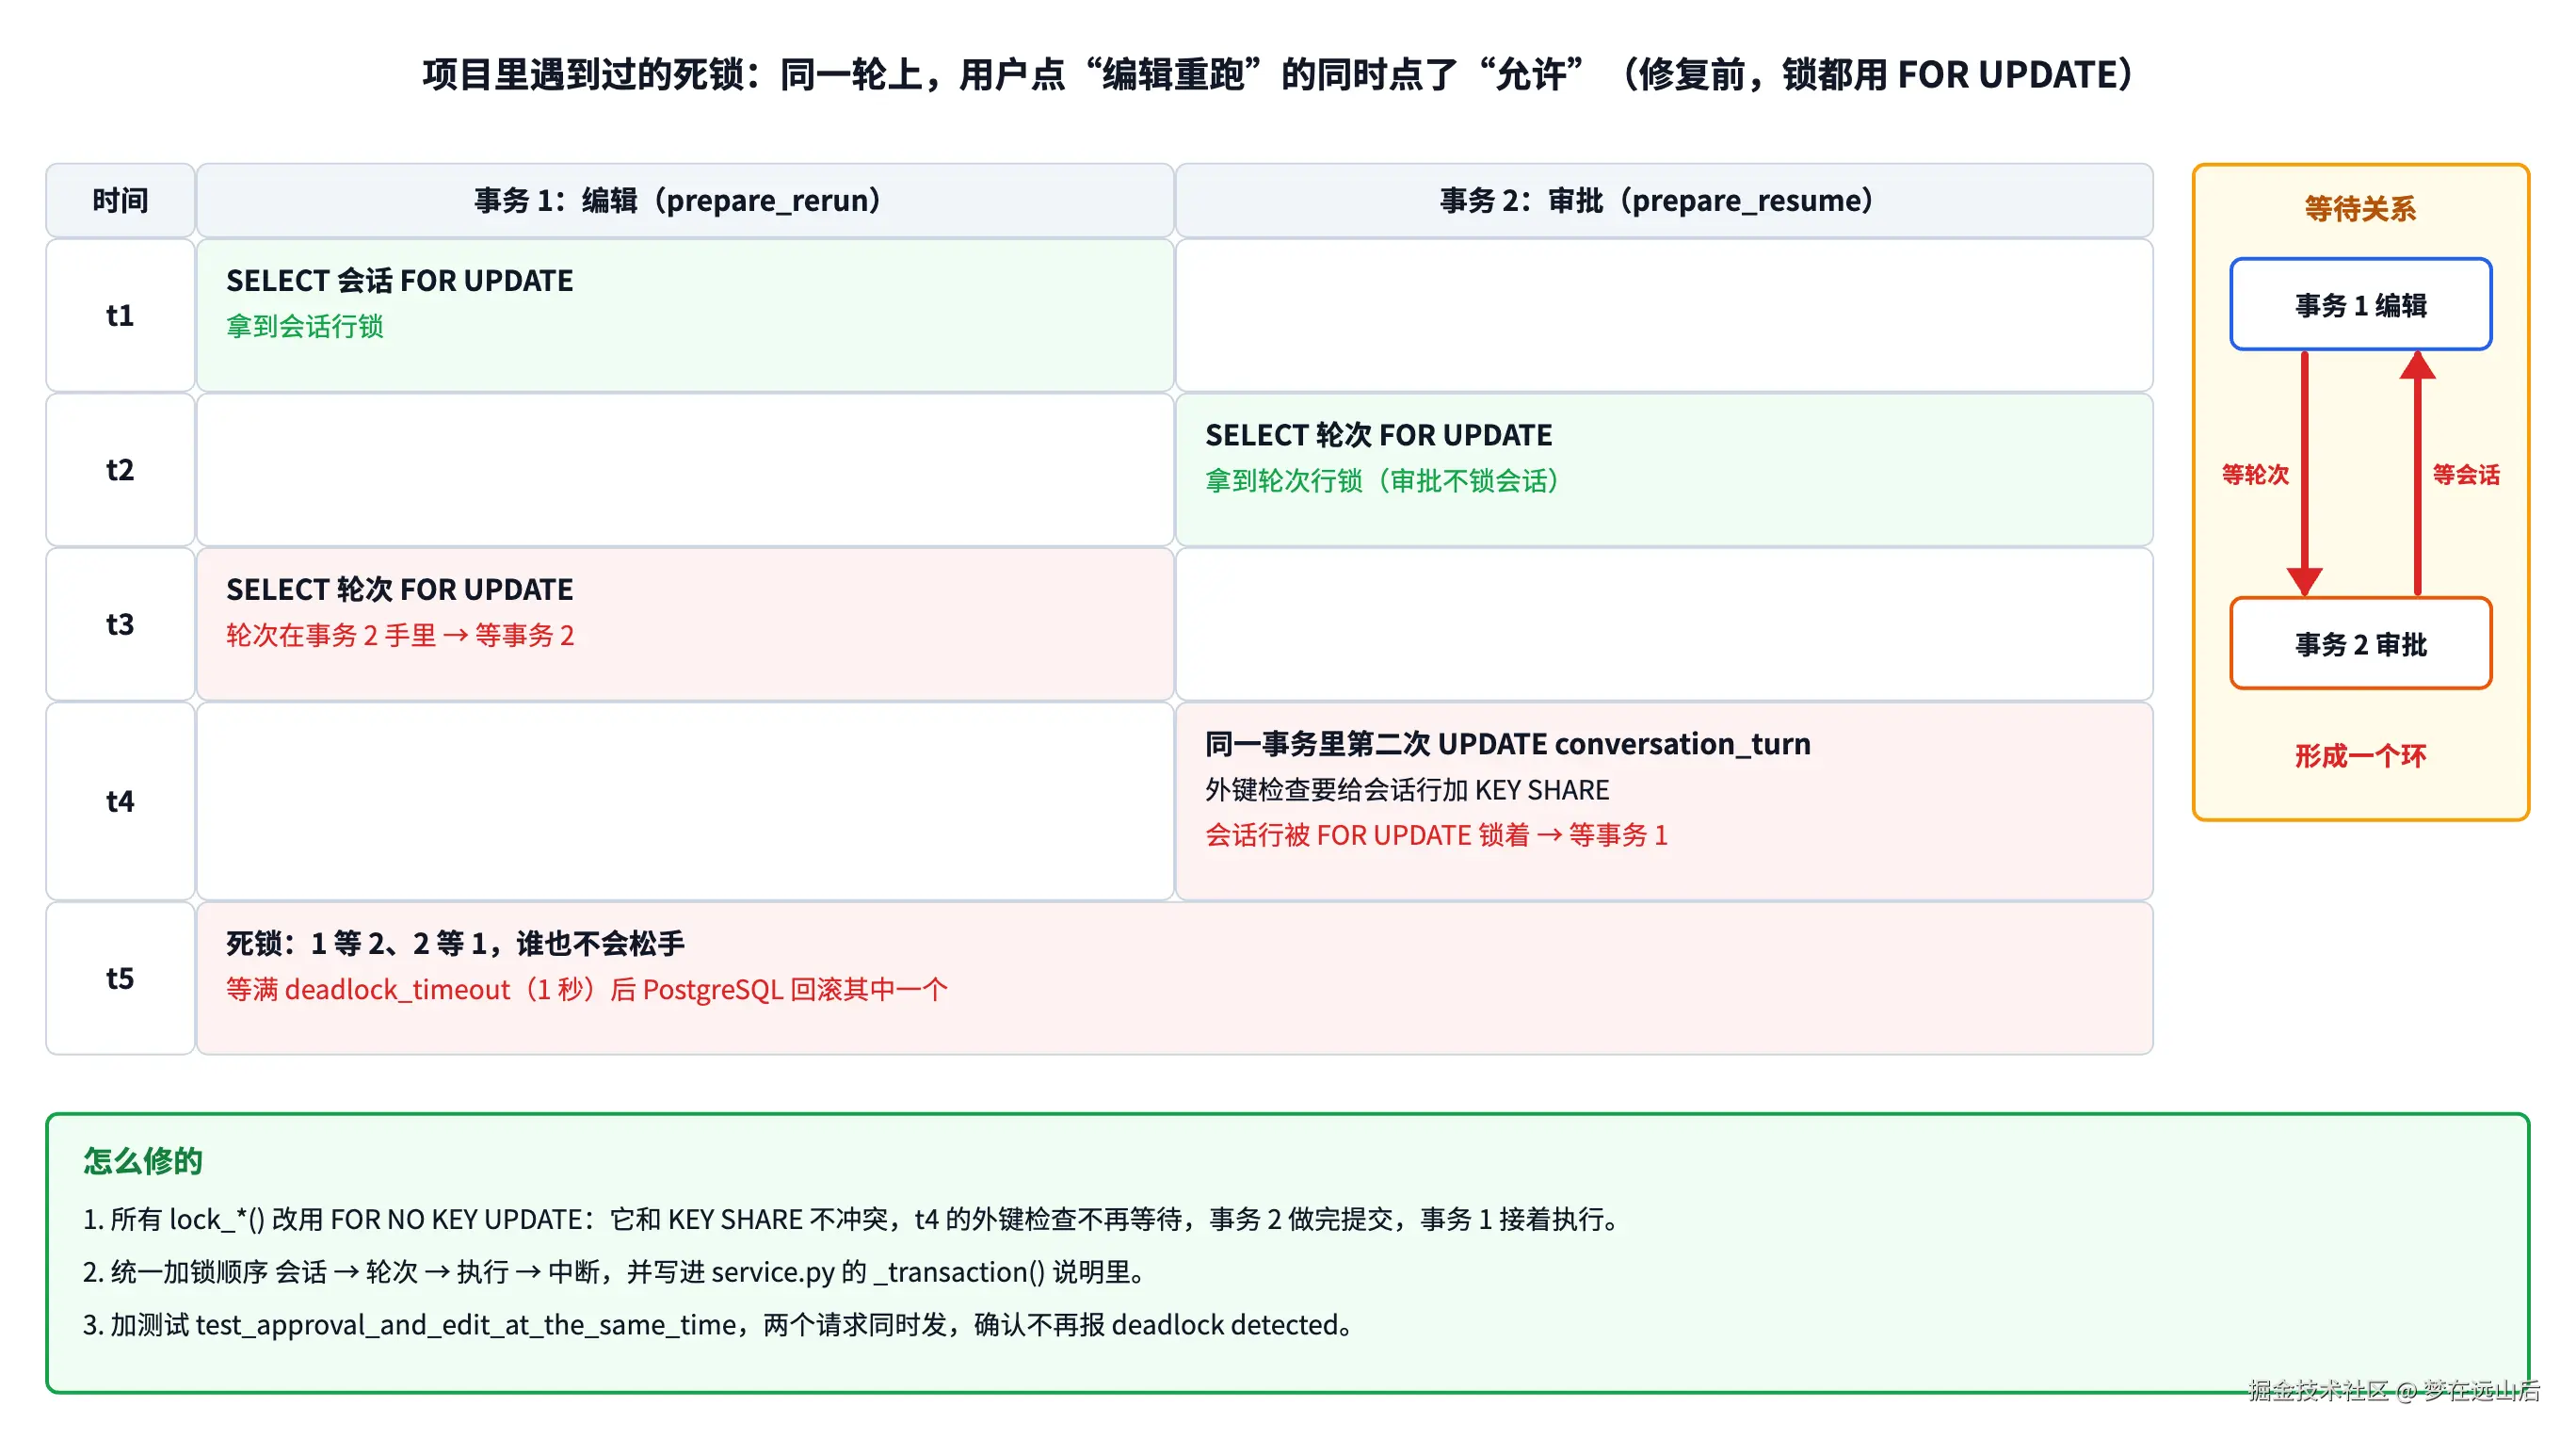
这个死锁很隐蔽:审批的代码里根本没有锁会话行,是 t4 那条 UPDATE 触发的外键检查,自动给会话行加了 KEY SHARE。
为什么是"第二次" UPDATE 才触发:PostgreSQL 更新子表行时,如果外键列没变,会跳过外键检查;但如果这一行是本事务刚插入或刚改过的 ,就一定会检查。prepare_resume() 先用 set_turn_active_run() 改了一次轮次行,再用 update_turn_status_for_run() 改第二次,第二次就触发了检查。第 3.6 节实测表里"第一次 UPDATE"和"第二次 UPDATE"那两行验证了这两种情况。
修复后的写法和原因,写在 runs/repository.py 文件开头的说明里:
vbnet
- SELECT ... FOR NO KEY UPDATE 会锁住查到的行,直到当前事务结束;别的事务要锁同一行时会排队等待。
  为什么不用更常见的 FOR UPDATE:外键检查会给被引用的父行加一把 KEY SHARE 锁,FOR UPDATE 和它冲突,
  FOR NO KEY UPDATE 不冲突。实测的死锁:"编辑"锁着会话行去等轮次;"审批"锁着轮次,更新轮次行时
  PostgreSQL 检查轮次的外键 conversation_id,要给会话行加 KEY SHARE,又在等"编辑"。
  我们从不修改主键,NO KEY 就够了(它表示"会改这一行,但不改主键",彼此之间仍然互斥)。
  它只在事务里有意义:连接池开启了 autocommit,每条语句默认立即提交,
  所以调用 lock_* 方法的 Service 一定要先用 conn.transaction() 开事务。
5.3 PostgreSQL 怎么处理死锁
一个事务等锁超过 deadlock_timeout(默认 1 秒)后,PostgreSQL 检查等待关系里有没有环。有环就选一个事务回滚,让它报错,另一个事务就能继续。
实测时,两个连接交叉更新 id = 1 和 id = 2 两行,大约 1 秒后其中一个收到:
vbnet
ERROR:  deadlock detected
DETAIL:  Process 22611 waits for ShareLock on transaction 9257; blocked by process 22612.
Process 22612 waits for ShareLock on transaction 9256; blocked by process 22611.
HINT:  See server log for query details.
CONTEXT: while updating tuple (0,2) in relation "conv"- 错误码是 40P01,psycopg 里对应
psycopg.errors.DeadlockDetected; - 被回滚的事务里所有修改都作废,另一个事务正常完成;
- "waits for ShareLock on transaction 9257" 的意思是:等 9257 号事务结束(见 3.4 的事务 ID 锁)。
所以死锁不会让数据库卡死,但会让一个请求失败。
5.4 死锁的常见原因
| 原因 | 例子 |
|---|---|
| 加锁顺序不一致 | A 先锁会话再锁轮次,B 先锁轮次再锁会话 |
| 隐式锁 | 外键检查、唯一索引冲突时等另一个事务,代码里看不见(5.2 就是这种) |
| 批量更新的行顺序不同 | A 执行 UPDATE ... WHERE id IN (1, 2),B 执行 WHERE id IN (2, 1),数据库不保证按哪个顺序锁 |
| 锁升级 | 两个事务都先拿 FOR SHARE,然后都想 UPDATE 同一行:都在等对方放掉共享锁 |
| 事务太长 | 事务里做了慢操作,持锁时间变长,和别的事务交叉的机会就多 |
5.5 怎么避免
- 固定加锁顺序 。所有事务按同一个顺序锁资源,就不会出现环:A 和 B 都先锁 ①,谁先拿到 ① 谁就一路做完,另一个只是排队。DevMind 的顺序写在
_transaction()的说明里(见 4.6)。 - 批量加锁时排序 :
SELECT ... WHERE id = ANY(...) ORDER BY id FOR UPDATE,保证每个事务按 id 从小到大锁。 - 用刚好够用的锁。不改主键就用 FOR NO KEY UPDATE,不和外键检查冲突;能用一条条件 UPDATE 解决的,就不要先 SELECT 加锁。
- 事务尽量短。事务里不要调模型、发 HTTP 请求、等用户操作(见 4.7)。
- 一开始就加最终需要的锁。要改就直接 FOR NO KEY UPDATE,不要先 FOR SHARE 再升级。
- 兜底:捕获 40P01 重试。死锁无法百分之百避免时,被回滚的事务整体重试一次通常就能成功。前提是整个事务可以安全重做。
- 写并发测试 。死锁只在真正并发时出现,DevMind 的做法是用
asyncio.gather同时发两个请求,循环几次(test_approval_and_edit_at_the_same_time)。
6. 什么时候用什么锁
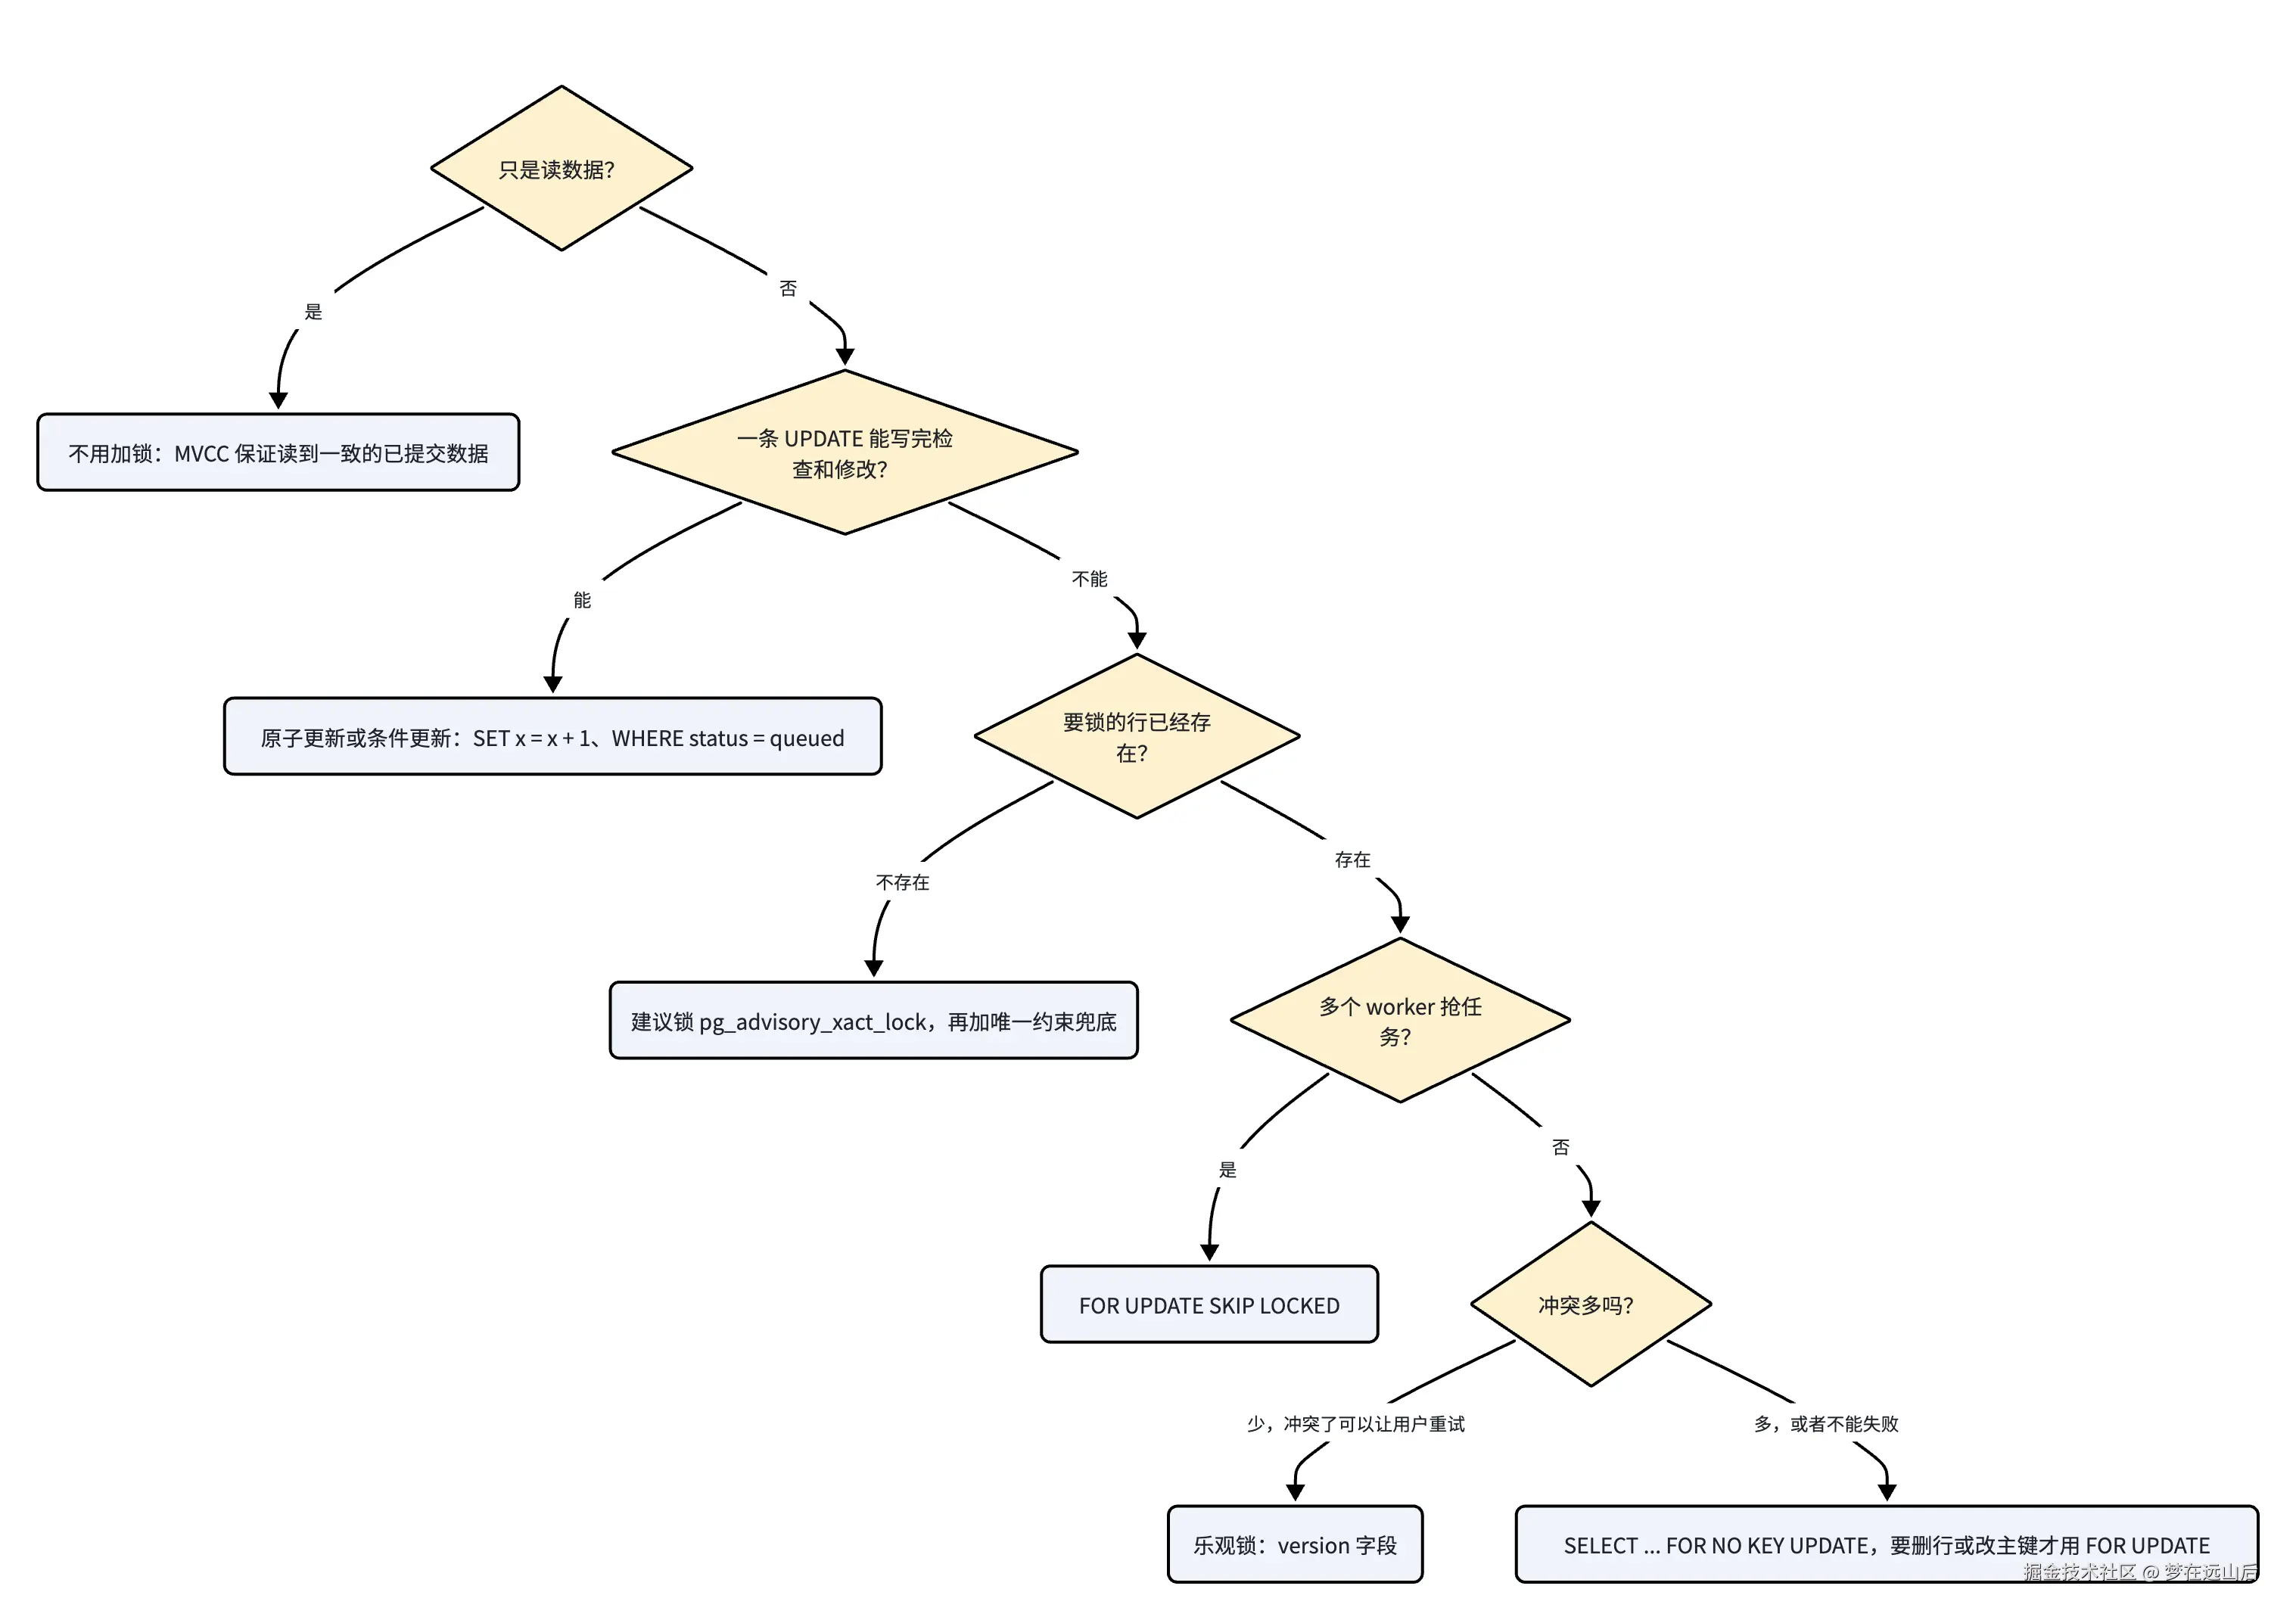
6.1 选择流程
按下面的顺序问自己几个问题,第一个回答"是"的地方就是答案:
6.2 什么情况下需要锁
一个简单的判断标准:代码里有没有"先读、再判断、再写",而且读和写之间别的请求可能改同一份数据。
需要:
- 分配序号、扣库存、改余额:新值依赖旧值;
- 状态流转:只有 queued 才能变成 running,只有 open 的审批才能处理;
- 防重复创建:同一个幂等键只能建一次;
- 多张表要一起改,改的过程中不能被别人看到或改到一半的状态(这一点靠事务,锁是事务的一部分)。
不需要:
- 只读的查询接口,比如 DevMind 的
list_turns(); - 一条 SQL 就能完成的修改;
- 每个用户只改自己的数据、不可能并发的地方(但要想清楚"不可能"是否真的成立:同一个用户双击、开两个标签页,都是并发)。
6.3 前端能不能替代数据库锁
不能。前端禁用按钮、inFlight 标记这些手段,只能减少重复请求,挡不住网络重发、多个标签页、多台设备。DevMind 前端的 useTurnRunner 也有 inFlight 标记挡双击,但真正保证正确的是 Server 端的锁和唯一约束。前端的防护是为了体验,数据库的防护是为了正确。
6.4 注意事项
- 锁只在事务里有效 。autocommit 下单独执行
SELECT ... FOR UPDATE,语句结束锁就没了。 - 普通 SELECT 不加锁。先用普通 SELECT 读、判断、再 UPDATE,是最常见的并发 bug。
- 检查放在锁里面。先查再锁没有用,要先锁再查。
- 锁住的是查到的行 。
WHERE没有用上索引时,FOR UPDATE会扫描并锁住所有匹配的行;查不到的行(还不存在的行)锁不住,要用建议锁或唯一约束。 - 事务要短,不要在事务里做慢操作;也不要让事务开着不提交(idle in transaction),它会一直拿着锁和连接。
- 改表结构要设
lock_timeout。ALTER TABLE 要拿 ACCESS EXCLUSIVE,如果有一个长事务在读这张表,ALTER 会等;而 ALTER 在等的时候,后面所有新来的 SELECT 都会排在它后面,整张表看起来就"卡死"了。线上改表前SET lock_timeout = '3s',拿不到就放弃,稍后重试;建索引用CREATE INDEX CONCURRENTLY(它不能在事务块里执行)。 - 会话级建议锁要记得释放,连接池环境下用事务级版本。
- 唯一约束是最后一道防线。锁写错了、漏了,唯一约束还能挡住重复数据。DevMind 把唯一约束冲突统一转成 409,而不是 500。
- 想清楚锁的强度。不改主键就用 FOR NO KEY UPDATE;只是防止别人改、自己也不改,用 FOR SHARE。
7. 排查:谁在等谁
锁等待和死锁出问题时,用下面这条查询看当前谁被谁挡住:
vbnet
SELECT
    waiting.pid                    AS 等待的进程,
    waiting.query                  AS 等待的语句,
    blocking.pid                   AS 挡住它的进程,
    blocking.query                 AS 挡住它的语句,
    blocking.state                 AS 对方状态,
    now() - waiting.query_start    AS 已经等了
FROM pg_stat_activity AS waiting
JOIN pg_stat_activity AS blocking
  ON blocking.pid = ANY(pg_blocking_pids(waiting.pid))
WHERE waiting.wait_event_type = 'Lock';pg_blocking_pids(pid)返回挡住某个进程的所有进程;- 对方状态如果是
idle in transaction,说明它开了事务却没提交,多半是程序忘了提交,或者在事务里做了慢操作; - 确认要处理时,可以用
SELECT pg_cancel_backend(pid)取消它当前的语句,pg_terminate_backend(pid)断开它的连接。
看某个连接自己持有哪些锁:
ini
SELECT locktype, relation::regclass, mode, granted
FROM pg_locks
WHERE pid = pg_backend_pid();
实测时,对实验表 conv 执行一条未提交的 UPDATE conv ... WHERE id = 1,pg_locks 里显示为:表 conv 和它的主键索引上的 RowExclusiveLock,加上自己事务 ID 上的 ExclusiveLock。注意,行锁不会出现在 pg_locks 里:它记在数据行本身上,只有别人在等这一行时,pg_locks 里才会出现相关的等待记录。
8. 小结
| 场景 | 用什么 | DevMind 的例子 |
|---|---|---|
| 计数、序号 | 原子 UPDATE ... RETURNING | next_turn_sequence() |
| 状态只能变一次 | 条件 UPDATE | claim_queued_run() |
| 读出来判断后再改 | SELECT ... FOR NO KEY UPDATE |
lock_conversation()、lock_turn() 等 |
| 要锁的行还不存在 | 建议锁 + 唯一约束 | lock_idempotency_key() |
| 多个 worker 抢任务 | FOR UPDATE SKIP LOCKED |
项目里暂时没有 |
| 冲突少,允许失败重试 | 乐观锁 version | 项目里暂时没有 |
| 所有写事务 | 固定加锁顺序、事务要短 | 幂等键 → 会话 → 轮次 → 执行 → 中断 |
| 兜底 | 唯一约束、部分唯一索引 | uq_agent_run_idempotency 等 |