小肥柴的Hadoop之旅 快速实验篇(B11)用户 RFM 与聚类分群实战
目录
- [1. 从用户分群说起](#1. 从用户分群说起)
- [2. 5 分钟速读](#2. 5 分钟速读)
- [3. 环境准备与数据概览](#3. 环境准备与数据概览)
- [4. 三段探测](#4. 三段探测)
- [4.1 探测一:用户数和行为覆盖](#4.1 探测一:用户数和行为覆盖)
- [4.2 探测二:R、F、M 的原始分布](#4.2 探测二:R、F、M 的原始分布)
- [4.3 探测三:三个维度的分位数](#4.3 探测三:三个维度的分位数)
- [5. 口径设计:为什么放弃 R 维度](#5. 口径设计:为什么放弃 R 维度)
- [6. 建表](#6. 建表)
- [6.1 ads_user_rfm 建表](#6.1 ads_user_rfm 建表)
- [6.2 导出 CSV 给 Python](#6.2 导出 CSV 给 Python)
- [7. K-means 实验:k=2 到 k=5 的探索](#7. K-means 实验:k=2 到 k=5 的探索)
- [7.1 三项聚类指标交叉验证](#7.1 三项聚类指标交叉验证)
- [7.2 皮尔逊相关系数:F 和 M 是同一维度](#7.2 皮尔逊相关系数:F 和 M 是同一维度)
- [7.3 k=2 和 k=3 的详细对照](#7.3 k=2 和 k=3 的详细对照)
- [7.4 为什么最终选 k=2](#7.4 为什么最终选 k=2)
- [8. 建 ads_user_cluster 表](#8. 建 ads_user_cluster 表)
- [9. 验证:10 项检查](#9. 验证:10 项检查)
- [10. 核心发现](#10. 核心发现)
- [11. 对后续实验的影响](#11. 对后续实验的影响)
- [12. 工程踩坑](#12. 工程踩坑)
- [13. 写在最后](#13. 写在最后)
- [14. 附录:完整脚本](#14. 附录:完整脚本)
1. 从用户分群说起
B11 的使命是做用户 RFM 与聚类分群,回答"高价值、潜力、流失用户是谁"。这是电商里最经典的一类用户运营分析。RFM 是 Recency、Frequency、Monetary 三个维度的缩写:
- R:最近一次行为距今多少天
- F:行为总次数
- M:消费金额(这份数据没有金额字段,用支付产品数代理)
标准做法是按 R、F、M 三个维度各切三档,组合成 3 × 3 × 3 = 27 类用户,或者简化成 8 类。
但在 B01 到 B10 的一路探测里,已经发现这份数据在多个维度上都呈现均匀分布。品类均匀、搜索词均匀、城市维度均匀、品类共现均匀。这些前置结论会直接影响 B11 的结果预期。所以 B11 的第一步不是直接跑 RFM,而是先探测 R、F、M 三个维度是否有区分度。
探测结果既有意外也有收获。R 维度完全均匀(所有用户都是 1 天),但 F 和 M 两个维度有明确的区分度。最终 B11 放弃 R 维度,用 F 和 M 两维跑 K-means 聚类,得出"用户天然分成两群"的结论。
这篇报告记录从探测到聚类到建表的完整过程,包括 k=2 和 k=3 的详细探索对照。
2. 5 分钟速读
- 原始设想:R、F、M 三维分层,识别高价值用户群。
- 探测结论:R 维度完全均匀,所有用户的 R 都等于 1,无区分度。F 和 M 有明确区分度。
- 改用方案:放弃 R,用 F 和 M 两维跑 K-means 聚类。
- 核心方法论:用 silhouette、CH、DB 三指标交叉验证,逐 k 遍历,选出最优 k。
- 主要发现:F 和 M 的皮尔逊相关系数 0.8484,数据本质一维。用户天然分成两群,低价值 40 人,高价值 60 人,占比 40% / 60%。
- 可复用产出 :
ads_user_rfm+ads_user_cluster+ 10 项验证。
3. 环境准备与数据概览
所有操作都在 /home/hadoop/b11 目录下进行。
bash
mkdir -p /home/hadoop/b11/{sql,py,output,docs}
cd /home/hadoop/b11
启动集群:
bash
start-dfs.sh && start-yarn.sh每次写 HQL 脚本,开头必须带这一段 SET 参数,与 B08 到 B10 一致:
sql
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.map.java.opts=-Xmx384m;
SET mapreduce.reduce.memory.mb=768;
SET mapreduce.reduce.java.opts=-Xmx512m;
SET hive.exec.reducers.max=1;
客户端堆也要设,写进 ~/.bashrc:
bash
export HADOOP_CLIENT_OPTS="-Xmx512m -Xms256m"数据是电商用户行为日志,180570 行,覆盖 11 天。B11 的分析口径与 B01 到 B10 一致,全部排除 07-27。
DWD 表 dwd_user_behavior 里 B11 会用到的字段:
| 字段 | 类型 | 说明 |
|---|---|---|
| user_id | bigint | 用户 ID |
| behavior_type | string | click / order / pay / search |
| pay_product_ids | array<string> | 支付产品 ID 列表 |
| dt | string | 分区日期 |
pay_product_ids 是数组类型,B11 用它来算 M 维度(支付产品数)。
4. 三段探测
4.1 探测一:用户数和行为覆盖
先看用户数和每个用户的行为数。
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'P01_user_cnt' AS tag, COUNT(DISTINCT user_id) AS val
FROM dwd_user_behavior WHERE dt < '2019-07-27';

SELECT 'P02_date_range' AS tag, MIN(dt) AS min_dt, MAX(dt) AS max_dt
FROM dwd_user_behavior WHERE dt < '2019-07-27';

SELECT 'P03_user_behavior_dist' AS tag,
       MIN(behavior_cnt) AS min_cnt,
       MAX(behavior_cnt) AS max_cnt,
       AVG(behavior_cnt) AS avg_cnt,
       STDDEV(behavior_cnt) AS std_cnt
FROM (
  SELECT user_id, COUNT(*) AS behavior_cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
" 2>&1 | tee output/probe1.log实测输出:
P01_user_cnt	100
P02_date_range	2019-07-17	2019-07-26
P03_user_behavior_dist	977	2327	1667.7	261.5961200018074
100 个用户,分析范围 07-17 到 07-26。用户行为数最少 977 次,最多 2327 次,max/min = 2.38。这个比值说明用户的活跃度确实有差异,不是均匀分布。
4.2 探测二:R、F、M 的原始分布
把 RFM 三个原始指标分别算出来。
- R:最近一次行为距 07-27 的天数
- F:行为总次数
- M:支付产品数总和
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'P04_rfm_dist' AS tag,
       MIN(r_days) AS min_r, MAX(r_days) AS max_r, AVG(r_days) AS avg_r, STDDEV(r_days) AS std_r,
       MIN(f_cnt)  AS min_f, MAX(f_cnt)  AS max_f, AVG(f_cnt)  AS avg_f, STDDEV(f_cnt)  AS std_f,
       MIN(m_cnt)  AS min_m, MAX(m_cnt)  AS max_m, AVG(m_cnt)  AS avg_m, STDDEV(m_cnt)  AS std_m
FROM (
  SELECT
    user_id,
    DATEDIFF('2019-07-27', MAX(dt)) AS r_days,
    COUNT(*) AS f_cnt,
    SUM(CASE WHEN pay_product_ids IS NOT NULL
             THEN SIZE(pay_product_ids) ELSE 0 END) AS m_cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
" 2>&1 | tee output/probe2.log第一次实测输出(有 bug):
P04_rfm_dist 1 1 1.0 0.0 977 2327 1667.7 261.5961200018074 -2014 -830 -1443.8 225.63723097042296M 维度出现了负数,min = -2014,max = -830。这不对,支付产品数不可能是负数。
排查后发现是 Hive 的一个坑:SIZE(NULL) 在 Hive 里返回 -1,而不是返回 NULL。 探测 SQL 里的写法是:
sql
SUM(CASE WHEN pay_product_ids IS NOT NULL
         THEN SIZE(pay_product_ids) ELSE 0 END)
这段 SQL 对 pay_product_ids 为 NULL 的情况做了兜底,看起来没问题。但问题出在 SIZE 对某些情况返回了 -1,而 IS NOT NULL 判断为 true。可能是 pay_product_ids 里包含空字符串元素,或者是 Hive 对空数组和 NULL 数组的处理不一致。
修复方式:加 SIZE(pay_product_ids) > 0 条件,把 SIZE 返回 -1 的情况也排除掉:
sql
SUM(CASE WHEN pay_product_ids IS NOT NULL AND SIZE(pay_product_ids) > 0
THEN SIZE(pay_product_ids) ELSE 0 END)修复后重跑:
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'P06_rfm_fixed' AS tag,
       MIN(f_cnt) AS min_f, MAX(f_cnt) AS max_f, AVG(f_cnt) AS avg_f, STDDEV(f_cnt) AS std_f,
       MIN(m_cnt) AS min_m, MAX(m_cnt) AS max_m, AVG(m_cnt) AS avg_m, STDDEV(m_cnt) AS std_m
FROM (
  SELECT
    user_id,
    COUNT(*) AS f_cnt,
    SUM(CASE WHEN pay_product_ids IS NOT NULL AND SIZE(pay_product_ids) > 0
             THEN SIZE(pay_product_ids) ELSE 0 END) AS m_cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
" 2>&1 | tee output/probe4_fixed.log修复后实测输出:
P06_rfm_fixed 977 2327 1667.7 261.5961200018074 78 233 149.32 29.461459570089154现在三个维度的数字都合理了:
| 维度 | min | max | avg | std | max/min |
|---|---|---|---|---|---|
| R | 1 | 1 | 1.0 | 0.0 | 1.00 |
| F | 977 | 2327 | 1667.7 | 261.6 | 2.38 |
| M | 78 | 233 | 149.32 | 29.46 | 2.99 |
R 维度完全均匀,所有用户的 R 都等于 1。原因是这份数据里每个用户在 07-26 这天都有行为,最近一次行为都是 07-26,距 07-27 都是 1 天。B08 的探测三也发现每天固定 100 用户有搜索行为,说明这份数据里每个用户每天都在活跃。
F 和 M 都有明确区分度,max/min 分别是 2.38 和 2.99。
4.3 探测三:三个维度的分位数
光看 min/max/avg 不够,还要看分位数。
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'P05_rfm_percentile' AS tag,
       PERCENTILE(r_days, 0.25) AS r_p25, PERCENTILE(r_days, 0.5) AS r_p50, PERCENTILE(r_days, 0.75) AS r_p75,
       PERCENTILE(f_cnt, 0.25)  AS f_p25, PERCENTILE(f_cnt, 0.5)  AS f_p50, PERCENTILE(f_cnt, 0.75)  AS f_p75,
       PERCENTILE(m_cnt, 0.25)  AS m_p25, PERCENTILE(m_cnt, 0.5)  AS m_p50, PERCENTILE(m_cnt, 0.75)  AS m_p75
FROM (
  SELECT
    user_id,
    DATEDIFF('2019-07-27', MAX(dt)) AS r_days,
    COUNT(*) AS f_cnt,
    SUM(CASE WHEN pay_product_ids IS NOT NULL
             THEN SIZE(pay_product_ids) ELSE 0 END) AS m_cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
" 2>&1 | tee output/probe3.log实测输出:
P05_rfm_percentile 1.0 1.0 1.0 1477.75 1696.0 1860.25 -1616.5 -1451.5 -1279.0R 的三个分位数全是 1.0。F 的三个分位数是 1477.75 / 1696.0 / 1860.25,p25 到 p75 之间有 382 的跨度,分布合理。M 的分位数有 bug(负数),需要按修复后的写法重跑。
再跑一次 F 的分位切点,用于后续规则分层:
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;
SELECT 'P07_f_quantile' AS tag,
       PERCENTILE(f_cnt, 0.33) AS f_p33,
       PERCENTILE(f_cnt, 0.67) AS f_p67
FROM (
  SELECT user_id, COUNT(*) AS f_cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
" 2>&1 | tee output/probe6_quantile.log实测输出:
P07_f_quantile 1526.02 1777.3000000000002F 的三分位切点:p33 = 1526.02,p67 = 1777.30。
5. 口径设计:为什么放弃 R 维度
标准 RFM 是 R × F × M 三维切分。但 B11 的探测显示 R 维度完全均匀,所有用户的 R 都是 1。
这个现象在真实电商里不可能出现。真实场景下,用户有的天天来,有的隔一周来一次,R 值会在 1 到 30 天之间分布。现在所有用户的 R 都是 1,说明这份数据里每个用户每天都有行为,是合成数据的一个特征。
R 无区分度意味着三维切分退化成了二维切分。B11 需要重新设计。三条路线:
路线 A:F 和 M 二维分层。 按 F 三分位切 3 档,M 三分位切 3 档,组合成 9 类用户。每类约 11 人。
路线 B:引入新维度替代 R。 用行为趋势替代,比如"最近 3 天行为数 / 前 7 天行为数"的比值。但这个比值本身可能也是均匀的。
路线 C:直接跑 K-means。 不预设分层规则,让算法从 F 和 M 的联合分布里找结构。
B11 选择路线 C。
理由:100 用户样本本来就小,规则分层 9 类每类 11 人,统计意义弱。K-means 直接分 2 到 4 群,每群 25 到 50 人,更稳。而且 K-means 能从二维联合分布里发现规则分层发现不了的结构,比如"F 中等但 M 高的用户"这类边界情况。
6. 建表
6.1 ads_user_rfm 建表
这张表存每个用户的 R、F、M 原始值,以及按规则分层得到的标签。
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.map.java.opts=-Xmx384m;
SET mapreduce.reduce.memory.mb=768;
SET mapreduce.reduce.java.opts=-Xmx512m;
SET hive.exec.reducers.max=1;
USE b_group;

DROP TABLE IF EXISTS ads_user_rfm;
CREATE TABLE ads_user_rfm (
    user_id     bigint,
    r_days      int,
    f_cnt       bigint,
    m_cnt       bigint,
    f_segment   string,
    m_segment   string,
    rfm_segment string
) STORED AS ORC;

INSERT OVERWRITE TABLE ads_user_rfm
SELECT
    user_id,
    r_days,
    f_cnt,
    m_cnt,
    CASE WHEN f_cnt < 1526 THEN 'F_LOW'
         WHEN f_cnt < 1777 THEN 'F_MID'
         ELSE 'F_HIGH' END AS f_segment,
    CASE WHEN m_cnt < 135 THEN 'M_LOW'
         WHEN m_cnt < 165 THEN 'M_MID'
         ELSE 'M_HIGH' END AS m_segment,
    CONCAT(
      CASE WHEN f_cnt < 1526 THEN 'F_LOW'
           WHEN f_cnt < 1777 THEN 'F_MID'
           ELSE 'F_HIGH' END,
      '_',
      CASE WHEN m_cnt < 135 THEN 'M_LOW'
           WHEN m_cnt < 165 THEN 'M_MID'
           ELSE 'M_HIGH' END
    ) AS rfm_segment
FROM (
  SELECT
    user_id,
    1 AS r_days,
    COUNT(*) AS f_cnt,
    SUM(CASE WHEN pay_product_ids IS NOT NULL AND SIZE(pay_product_ids) > 0
             THEN SIZE(pay_product_ids) ELSE 0 END) AS m_cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
" 2>&1 | tee output/01_build_user_rfm.log
跑完后 ads_user_rfm 有 100 行。
6.2 导出 CSV 给 Python
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;
SELECT user_id, f_cnt, m_cnt
FROM ads_user_rfm
ORDER BY user_id;
" 2>&1 | grep -E '^[0-9]+\s+[0-9]+\s+[0-9]+$' > output/user_rfm.csv

wc -l output/user_rfm.csv
预期 100 行。这个 CSV 会 scp 到本地,用 Python 跑 K-means。
7. K-means 实验:k=2 到 k=5 的探索
K-means 的核心参数是簇数量 k。k 太小,用户分群太粗;k 太大,每群人数太少,统计意义弱。B11 用逐 k 遍历 + 三指标交叉验证的方式找最优 k。
7.1 三项聚类指标交叉验证
K-means 的评估不能用单一指标,要用三个指标交叉验证:
| 指标 | 含义 | 判读 |
|---|---|---|
| silhouette | 簇内紧致度和簇间分离度的综合 | 越大越好,> 0.5 算结构明显 |
| calinski_harabasz | 簇间方差和簇内方差的比值 | 越大越好 |
| davies_bouldin | 簇内散度和簇间距离的比值 | 越小越好 |
三个指标的偏好不完全一致。silhouette 和 DB 更看重簇内紧致,CH 更看重簇间分离。当两个阵营分歧时,需要看数据的实际结构判断。
遍历 k=2 到 k=5 的实测输出:
k=2: silhouette=0.5161, calinski_harabasz=155.81, davies_bouldin=0.6657, 各簇大小=[40 60]
k=3: silhouette=0.4491, calinski_harabasz=161.92, davies_bouldin=0.7220, 各簇大小=[46 29 25]
k=4: silhouette=0.3850, calinski_harabasz=151.82, davies_bouldin=0.8022, 各簇大小=[25 34 29 12]
k=5: silhouette=0.3936, calinski_harabasz=153.84, davies_bouldin=0.7648, 各簇大小=[24 20 32  4 20]
三指标最优 k 对比:
- silhouette 最优 k:2(0.5161)
- calinski_harabasz 最优 k:3(161.92,比 k=2 的 155.81 高 4%)
- davies_bouldin 最优 k:2(0.6657)
两个指标支持 k=2,一个指标支持 k=3。 这个分歧需要用数据的实际结构来判断。
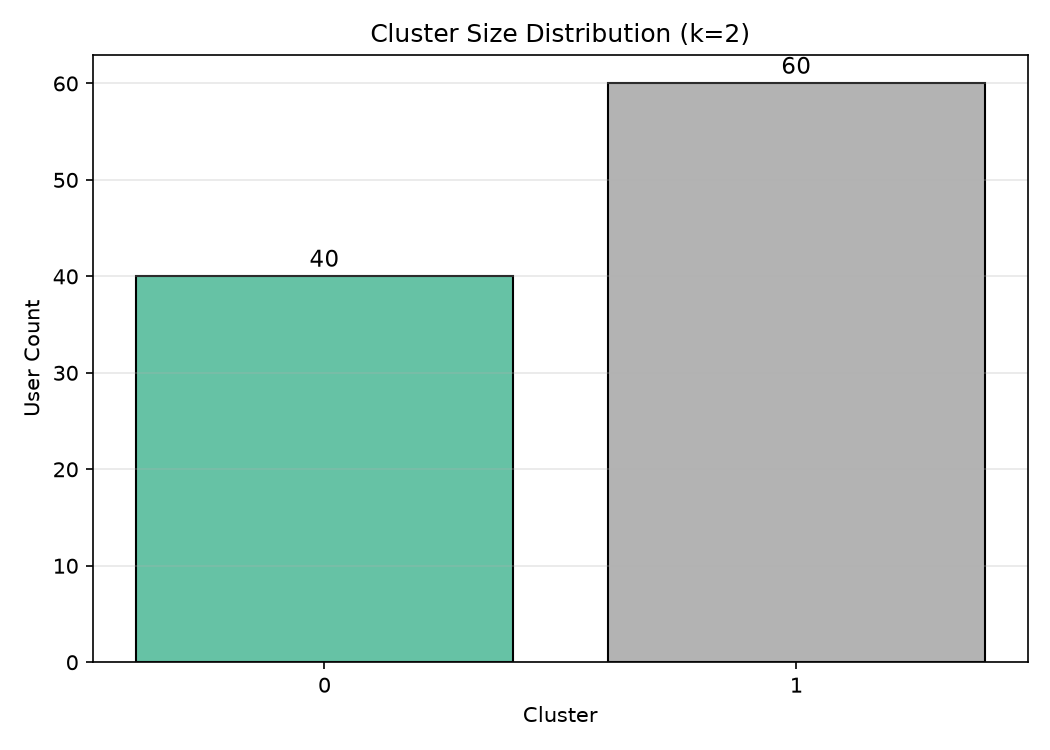
上图是 k=2 时的簇大小分布。左侧绿色柱是 cluster 0,40 人;右侧灰色柱是 cluster 1,60 人。两组人数比是 4 比 6,不是常见的二八分布;这个比例本身就是一个信号,用户结构比真实电商更均衡,高价值用户占比偏高。
7.2 皮尔逊相关系数:F 和 M 是同一维度
在判断 k 之前,先算 F 和 M 的相关系数:
[补强1] F 和 M 的皮尔逊相关系数: 0.8484
        判读: 高度正相关,F 和 M 基本是同一个主成分
相关系数 0.8484。这是 B11 里最关键的一个数字。
F 和 M 高度相关,意味着这两个维度并不是独立的两个方向,而是"用户活跃度"这一个主成分的两个侧面。数据本质上是一维的。在一维空间上做二分,k=2 是唯一合理的分法。
7.3 k=2 和 k=3 的详细对照
为了选出最终 k,B11 对 k=2 和 k=3 各跑一次详细聚类,输出每簇统计、Mann-Whitney 检验、交叉分布表。
k=2 的详细结果:
[K2] 每簇统计:
    cluster 0: n=40, F均值=1408, F标准差=145.5, M均值=122.0, M标准差=19.5
    cluster 1: n=60, F均值=1840, F标准差=161.5, M均值=167.5, M标准差=19.4

[K2] Mann-Whitney U 检验:
    cluster 0 vs cluster 1: F p=4.0425e-17, M p=2.2936e-15

[K2] K-means 与规则分层的交叉分布:
cluster         0   1
rfm_seg
F_HIGH_M_HIGH   0  22
F_HIGH_M_MID    0  11
F_LOW_M_LOW    25   0
F_LOW_M_MID     8   0
F_MID_M_HIGH    0   4
F_MID_M_LOW     4   1
F_MID_M_MID     3  22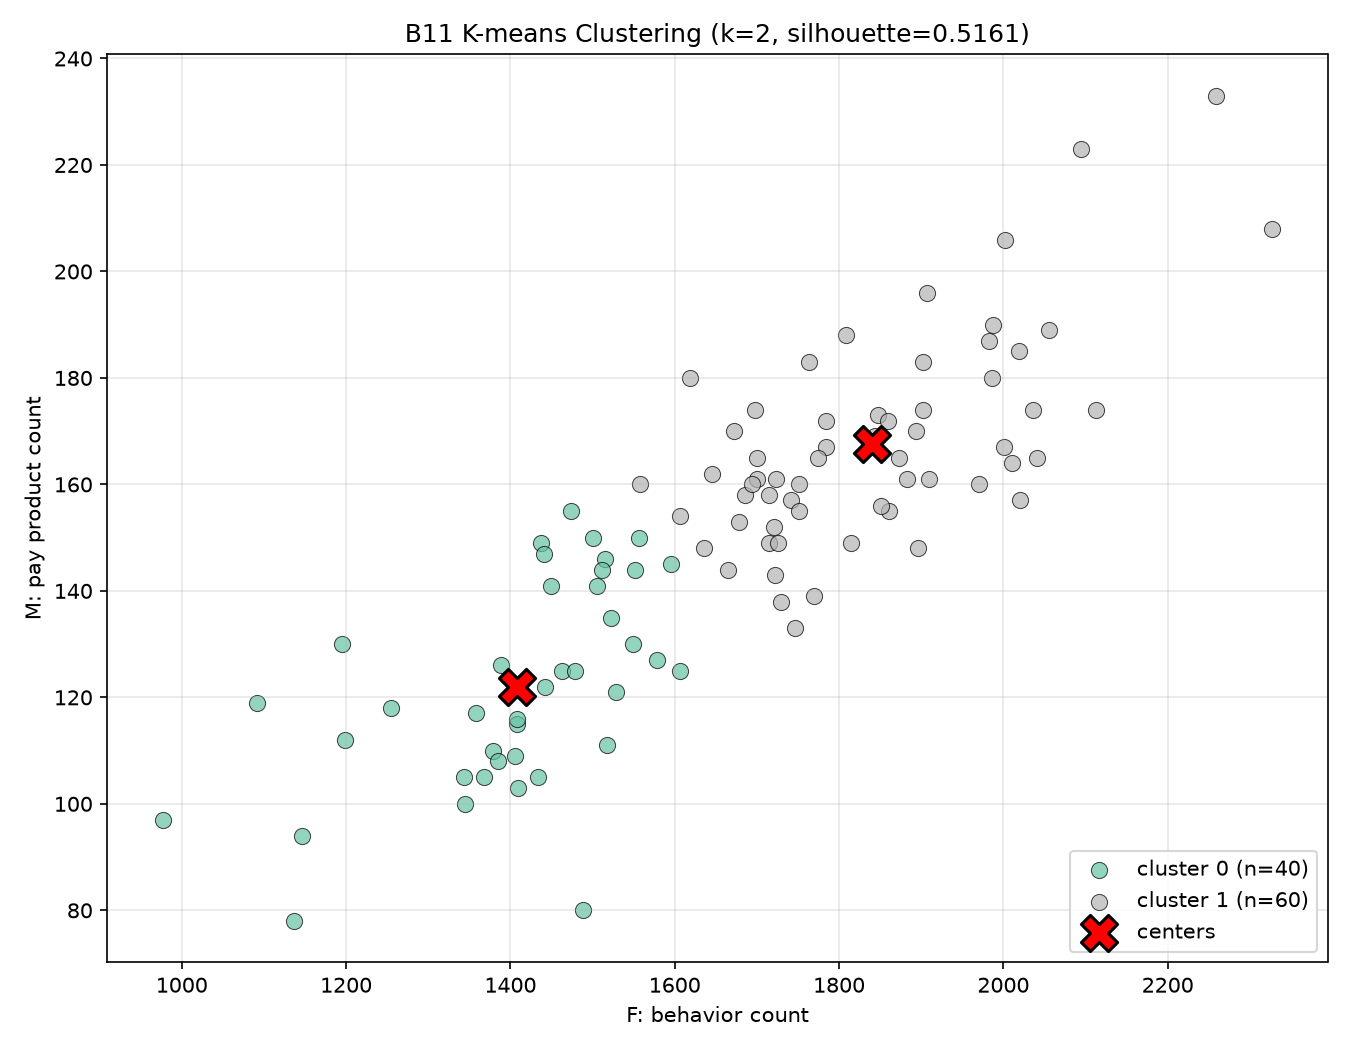
上图是 k=2 的聚类结果。横轴是 F(行为总次数),纵轴是 M(支付产品数)。每个点是一个用户,绿色属于 cluster 0,灰色属于 cluster 1,红色叉号是两个簇的中心。
两个簇的分界沿着对角线,而不是垂直或水平切。这印证了 F 和 M 的高度相关性:F 高的用户 M 也高,反之亦然。左下角有一小群绿色点离中心较远(比如 F 小于 1200 的那几个),它们是低价值群里最极端的样本。右上角同理,是高价值群里最活跃的几个。
k=3 的详细结果:
[K3] 每簇统计:
    cluster 0: n=46, F均值=1655, F标准差=116.7, M均值=151.1, M标准差=11.8
    cluster 1: n=29, F均值=1968, F标准差=128.1, M均值=180.3, M标准差=18.7
    cluster 2: n=25, F均值=1342, F标准差=142.7, M均值=110.0, M标准差=13.2

[K3] Mann-Whitney U 检验:
    cluster 0 vs cluster 1: F p=3.3291e-12, M p=1.3942e-10
    cluster 0 vs cluster 2: F p=5.5556e-11, M p=6.6901e-12
    cluster 1 vs cluster 2: F p=3.3839e-10, M p=3.3554e-10

[K3] K-means 与规则分层的交叉分布:
cluster         0   1   2
rfm_seg
F_HIGH_M_HIGH   1  21   0
F_HIGH_M_MID    4   7   0
F_LOW_M_LOW     1   0  24
F_LOW_M_MID     8   0   0
F_MID_M_HIGH    3   1   0
F_MID_M_LOW     4   0   1
F_MID_M_MID    25   0   0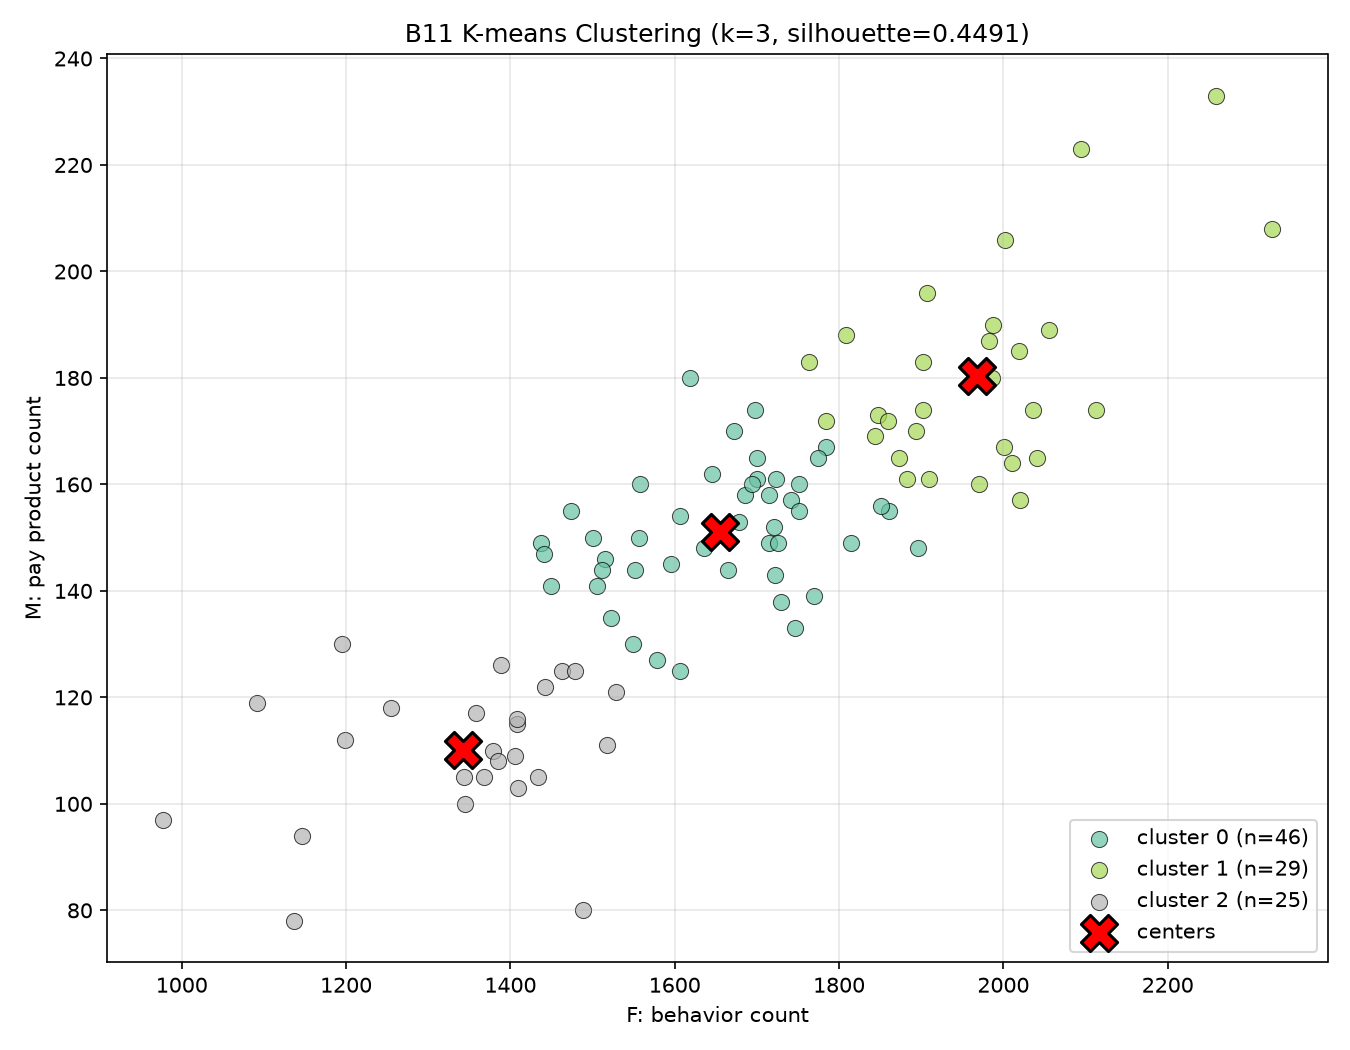
上图是 k=3 的聚类结果,用来和 k=2 做对照。三个簇的中心分别落在左下(F=1342, M=110.0)、中上(F=1655, M=151.1)、右上(F=1968, M=180.3),本质上就是 F 轴上的低、中、高三档。
对照 k=2 的散点图可以看出,k=3 没有发现新的结构,只是把 F 轴按均匀间隔重新切了一遍。中间那一簇(n=46)的大部分样本在 k=2 时属于 cluster 1,小部分属于 cluster 0。也就是说 k=3 的切分并没有比 k=2 携带更多信息,反而 silhouette 从 0.5161 降到 0.4491。
7.4 为什么最终选 k=2
关键观察:k=3 的三簇,本质上就是规则分层的 F_LOW / F_MID / F_HIGH 三档。
看 k=3 的交叉分布表:
- cluster 2(n=25):几乎等价于 F_LOW_M_LOW,24 人落在这里
- cluster 0(n=46):主要是 F_MID 群,25 个 F_MID_M_MID 全在这里
- cluster 1(n=29):几乎等价于 F_HIGH 群,21 个 F_HIGH_M_HIGH 落在这里
k=3 没有发现规则分层之外的额外结构,它只是把 F 轴按"低/中/高"重新分了一遍。
再看 k=2 的交叉分布。核心信息在于 F_MID 这一档的分裂:
- F_MID_M_MID 的 25 个用户里,22 个归到 cluster 1,3 个归到 cluster 0
- F_MID_M_LOW 的 5 个用户里,4 个归到 cluster 0,1 个归到 cluster 1
也就是说,F 值中等这一档,K-means 结合 M 值做了进一步细分:M 高的归 cluster 1,M 低的归 cluster 0。这不是机械地按 F 切分,而是看 F 和 M 的联合分布。
这个行为恰好印证了 F 和 M 相关系数 0.8484 的含义:F 和 M 高度相关,但不是完全一致,在 F 中等的区间里,M 还携带额外的信息。
最终决策:k=2。
理由三条:
- silhouette 0.5161 是所有 k 里最高的,说明这是数据的最优切分。
- F 和 M 相关系数 0.8484,数据本质一维,二分是自然结构。
- Mann-Whitney 检验 p < 1e-15,两簇在 F 和 M 上的差异统计上高度显著。
- k=3 的三簇本质上是规则分层的复现,没有带来新的模式发现。
k=2 的语义标签:
| 簇 | 簇号 | 人数 | F 均值 | M 均值 | 语义 |
|---|---|---|---|---|---|
| 0 | low_value | 40 | 1408 | 122.0 | 低活跃低支付 |
| 1 | high_value | 60 | 1840 | 167.5 | 高活跃高支付 |
8. 建 ads_user_cluster 表
把 K-means 结果写回 Hive。表结构容纳两个 k 的结果:
sql
CREATE TABLE ads_user_cluster (
    user_id     bigint,
    k2_cluster  int,
    k2_label    string,
    k3_cluster  int
) STORED AS ORC;
为什么带 k=3 的簇号? k=3 虽然最终没被选为主结论,但作为对照实验的结果保留下来。后续 B12 异常检测需要按用户分群建基线时,可以两种切分都用一下,看哪种对异常检测更有效。
写回 Hive 的过程(B10 已经踩过 ORC 表不能直接 LOAD 的坑,走文本中转):
bash
# 第一步:建 ORC 表和文本中转表
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;
DROP TABLE IF EXISTS ads_user_cluster;
CREATE TABLE ads_user_cluster (
    user_id     bigint,
    k2_cluster  int,
    k2_label    string,
    k3_cluster  int
) STORED AS ORC;

DROP TABLE IF EXISTS tmp_user_cluster_load;
CREATE TABLE tmp_user_cluster_load (
    user_id     bigint,
    k2_cluster  int,
    k2_label    string,
    k3_cluster  int
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
STORED AS TEXTFILE;
" 2>&1 | tee output/02a_create_tables.log

# 第二步:LOAD DATA 到中转表
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;
LOAD DATA LOCAL INPATH '/home/hadoop/b11/output/user_cluster_full.csv'
INTO TABLE tmp_user_cluster_load;
" 2>&1 | tee output/02b_load_tmp.log

# 第三步:从文本表 INSERT 到 ORC 表
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.map.java.opts=-Xmx384m;
SET mapreduce.reduce.memory.mb=768;
SET mapreduce.reduce.java.opts=-Xmx512m;
SET hive.exec.reducers.max=1;
USE b_group;

INSERT OVERWRITE TABLE ads_user_cluster
SELECT user_id, k2_cluster, k2_label, k3_cluster
FROM tmp_user_cluster_load;
" 2>&1 | tee output/02d_insert_orc.log

# 第四步:清理中转表
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;
DROP TABLE IF EXISTS tmp_user_cluster_load;
" 2>&1 | tee output/02f_drop_tmp.log
9. 验证:10 项检查
bash
cd /home/hadoop/b11 && hive -e "
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'V01_row_cnt' AS tag, COUNT(*) AS val FROM ads_user_cluster;
SELECT 'V02_k2_dist' AS tag, k2_cluster, k2_label, COUNT(*) AS n
FROM ads_user_cluster GROUP BY k2_cluster, k2_label ORDER BY k2_cluster;
SELECT 'V03_k3_dist' AS tag, k3_cluster, COUNT(*) AS n
FROM ads_user_cluster GROUP BY k3_cluster ORDER BY k3_cluster;
SELECT 'V04_null_check' AS tag,
       SUM(CASE WHEN user_id IS NULL OR k2_cluster IS NULL
                OR k2_label IS NULL OR k3_cluster IS NULL
                THEN 1 ELSE 0 END) AS val
FROM ads_user_cluster;
SELECT 'V05_user_distinct' AS tag, COUNT(DISTINCT user_id) AS val FROM ads_user_cluster;
SELECT 'V06_k2_label_values' AS tag, COUNT(DISTINCT k2_label) AS val FROM ads_user_cluster;
SELECT 'V07_k2_range' AS tag, MIN(k2_cluster) AS min_v, MAX(k2_cluster) AS max_v FROM ads_user_cluster;
SELECT 'V08_k3_range' AS tag, MIN(k3_cluster) AS min_v, MAX(k3_cluster) AS max_v FROM ads_user_cluster;
SELECT 'V09_cross_check_rfm' AS tag,
       SUM(CASE WHEN r.user_id IS NULL THEN 1 ELSE 0 END) AS missing_in_rfm
FROM ads_user_cluster c
LEFT JOIN ads_user_rfm r ON c.user_id = r.user_id;
SELECT 'V10_sample' AS tag, user_id, k2_cluster, k2_label, k3_cluster
FROM ads_user_cluster ORDER BY user_id LIMIT 5;
" 2>&1 | tee output/02e_verify.log实测输出:
| 编号 | 验证项 | 实测值 | 判定 |
|---|---|---|---|
| V01 | 表行数 | 100 | ✅ |
| V02 | k2 分布 | 0/low_value=40,1/high_value=60 | ✅ |
| V03 | k3 分布 | 0=46,1=29,2=25 | ✅ |
| V04 | NULL 计数 | 0 | ✅ |
| V05 | 去重用户数 | 100 | ✅ |
| V06 | k2_label 去重数 | 2 | ✅ |
| V07 | k2_cluster 范围 | 0, 1 | ✅ |
| V08 | k3_cluster 范围 | 0, 2 | ✅ |
| V09 | 与 ads_user_rfm 匹配 | 0 条缺失 | ✅ |
| V10 | 前 5 行样本 | 与 Python 输出对应 | ✅ |
十项全部通过。
10. 核心发现
10.1 发现一:R 维度完全均匀,无区分度
所有 100 个用户的 R 都等于 1,标准差 0.0。原因是每个用户在 07-26 这天都有行为,最近一次行为都是 07-26。这个现象在真实电商里不可能出现,是合成数据的一个特征。
R 无区分度意味着标准 RFM 三维分层退化成了二维。
10.2 发现二:F 和 M 高度相关,本质一维
皮尔逊相关系数 0.8484。F 和 M 高度正相关,意味着这两个维度并不是独立的方向,而是"用户活跃度"这一个主成分的两个侧面。
F 和 M 的比值在各用户间保持稳定:F 高的用户 M 也高,F 低的用户 M 也低。用户价值可以用单一维度刻画。
10.3 发现三:用户天然分成两群
K-means 在 k=2 时达到最优(silhouette 0.5161)。两群的分界:
| 簇 | 人数 | F 均值 | M 均值 | 画像 |
|---|---|---|---|---|
| 低价值 | 40 | 1408 | 122.0 | 低活跃低支付 |
| 高价值 | 60 | 1840 | 167.5 | 高活跃高支付 |
Mann-Whitney 检验显示两簇在 F 和 M 上的差异 p-value 分别 4.04e-17 和 2.29e-15,远低于 0.001。这不是采样噪声,两簇的差异是真实存在的。
10.4 发现四:高价值用户占比 60%,远高于真实电商
两群的占比是 40% / 60%。真实电商里高价值用户通常只占 10% 到 20%,遵循二八原则。这份数据里高价值用户占 60%,是合成数据的又一个特征。
10.5 发现五:k=3 只是规则分层的复现
k=3 的三簇(F 均值 1342 / 1655 / 1968)本质上就是规则分层的 F_LOW / F_MID / F_HIGH 三档。k=3 没有发现规则分层之外的额外结构。
而 k=2 的簇划分中,F 中等区间有细分:F_MID_M_MID 的 22 人归 cluster 1,3 人归 cluster 0。这个细分是 K-means 从二维联合分布里发现的,规则分层无法捕捉。
这是 B11 选 k=2 而不是 k=3 的核心论据:k=2 携带的信息量更大,不是简单的粗分。
11. 对后续实验的影响
-
B12 异常流量与刷单识别。 B11 的两群划分给 B12 提供了重要基线:异常检测应该分群建基线,而不是用全局基线。低价值群和高价值群的行为模式不同,同一个行为在两个群里可能一个是正常一个是异常。
-
B13 用户行为路径挖掘。 用户分群标签可以作为路径分析的分组维度。低价值群和高价值群的路径模式可能不同。
-
B14 用户画像与标签体系。
ads_user_cluster表提供了用户画像的核心标签(k2_label)。B14 的特征工程可以基于这个标签,再加上 B07 的 session 序列、B08 的搜索偏好等,形成完整的用户画像。 -
B15 品类推荐系统。 用户分群可以用于分群推荐。低价值群和高价值群的品类偏好可能不同,虽然 B04 发现品类均匀,但分群后可能有微弱差异。
-
B16 用户流失预测。 B11 的分群标签可以作为流失预测的特征之一。低价值群本身可能就有更高的流失倾向。
-
B17 用户价值预测。 B11 的 high_value / low_value 标签可以直接作为价值预测的标签。B17 的回归模型可以基于这个标签,加上用户的历史行为特征,预测用户的未来价值。
12. 工程踩坑
B11 踩到三个新坑。
-
第一个坑,
SIZE(NULL)返回 -1。 探测 M 维度时,SUM(CASE WHEN pay_product_ids IS NOT NULL THEN SIZE(pay_product_ids) ELSE 0 END)出现了负数。原因是 Hive 里SIZE(NULL)返回 -1 而不是返回 NULL。修复方式:加SIZE(pay_product_ids) > 0条件,把 SIZE 返回 -1 的情况也排除掉。 -
第二个坑,ORC 表不能直接 LOAD DATA。 这个坑 B10 已经踩过,B11 直接沿用文本中转表的方案。
-
第三个坑,Tee 类的关闭顺序。 Python 脚本里用 Tee 类同时把 stdout 写到终端和日志文件。脚本末尾直接
log_fp.close()会让sys.stdout指向已关闭的文件,解释器退出时抛ValueError: I/O operation on closed file。修复方式:在关闭日志文件前先sys.stdout = sys.__stdout__恢复原始 stdout。同时 Tee 类的flush方法加if not f.closed判断。
踩过的坑速查表:
| 坑 | 表现 | 解法 |
|---|---|---|
SIZE(NULL) 返回 -1 |
M 维度出现负数 | 加 SIZE(...) > 0 条件 |
| ORC 表不能 LOAD DATA | 报 file format 不匹配 | 走文本中转表 |
| Tee 类关闭顺序 | ValueError: I/O operation on closed file | 先恢复 stdout 再关文件 |
Hive WITH 必须在 INSERT 前 |
INSERT ... WITH 报 ParseException |
改为 WITH ... INSERT |
tee 前必须 cd |
日志落盘失败 | 每次先 cd /home/hadoop/b11 |
13. 写在最后
- 还没搞明白,需要进一步探索的:
-
R 维度完全均匀是合成数据的特征还是业务特征? 所有用户的 R 都是 1,说明每个用户每天都有行为。这在真实电商里不可能出现,只能是数据构造时给每个用户都安排了每天的行为。这个发现进一步印证了"这份数据是人工构造的"。
-
高价值用户占比 60% 是否合理? 真实电商的二八原则是高价值用户占 20%。这份数据里 60% 是高价值用户,用户结构明显比真实数据更均衡。
-
k=3 的簇 0(F_MID 群)内部是否有细分? k=3 的 cluster 0 有 46 人,F 均值 1655,M 均值 151.1。这个簇内部可能还有细分,但 silhouette 已经降到 0.4491,再切下去意义不大。
- 小结:
B11 的价值不在于发现了一个惊艳的用户分群结构,而在于用严格的实验方法确认了"用户只有一个维度的区分度"。R 无区分度,F 和 M 高度相关,数据本质一维。在这个结构下,k=2 是数据自然的分法。
k=2 和 k=3 的对照过程,本身就是一个数据探索的方法论案例。三指标交叉验证、相关系数佐证、Mann-Whitney 显著性检验,这三层证据共同支撑了 k=2 的最终选择。这种"用多个证据交叉验证一个结论"的做法,可以复用到后续任何聚类分析。
14. 附录:完整脚本
本文涉及的全部脚本,都在 /home/hadoop/b11/ 下:
| 文件 | 用途 |
|---|---|
sql/probe1.hql |
探测用户数和行为覆盖(4.1) |
sql/probe2.hql |
探测 R、F、M 分布(4.2) |
sql/probe3.hql |
探测三个维度的分位数(4.3) |
sql/01_build_user_rfm.hql |
建 ads_user_rfm(6.1) |
py/b11_kmeans_v4.py |
K-means 聚类 + 对照(第 7 章) |
sql/02a_create_tables.hql |
建 ads_user_cluster + 中转表(8) |
sql/02b_load_tmp.hql |
LOAD DATA 到中转表(8) |
sql/02d_insert_orc.hql |
INSERT 到 ORC 表(8) |
sql/02e_verify.hql |
10 项验证(9) |
表结构速查:
ads_user_rfm(100 行,每行一个用户)
| 字段 | 说明 |
|---|---|
| user_id | 用户 ID |
| r_days | 最近一次行为距 07-27 的天数(本数据全是 1) |
| f_cnt | 行为总次数 |
| m_cnt | 支付产品数总和 |
| f_segment | F 分层标签(F_LOW / F_MID / F_HIGH) |
| m_segment | M 分层标签(M_LOW / M_MID / M_HIGH) |
| rfm_segment | RFM 组合标签 |
ads_user_cluster(100 行,每行一个用户)
| 字段 | 说明 |
|---|---|
| user_id | 用户 ID |
| k2_cluster | k=2 的簇号(0 或 1) |
| k2_label | k=2 的语义标签(low_value / high_value) |
| k3_cluster | k=3 的簇号(0 / 1 / 2),对照用 |
Python 输出文件:
| 文件 | 用途 |
|---|---|
b11_output/b11_kmeans_v4.log |
完整运行日志 |
b11_output/user_cluster_result.csv |
含 F/M 原值 + cluster 标签 |
b11_output/user_cluster_full.csv |
写回 Hive 用,4 列,100 行 |
b11_output/cluster_k2_scatter.png |
k=2 散点图 |
b11_output/cluster_k3_scatter.png |
k=3 对照图 |
b11_output/cluster_size_bar.png |
k=2 簇大小柱状图 |