开篇介绍:
hello 大家,本篇博客我们来学习RDB持久化。
前言:为什么我们绝对不能容忍 Redis 不开启持久化?
我们每天都在和 Redis 打交道,不管是做分布式锁、做缓存、做排行榜、做计数器、做用户会话存储,几乎所有后端服务、互联网产品、小程序、APP、网站的背后,都离不开 Redis 的支撑。
但绝大多数刚接触 Redis 的同学,最容易忽略、最容易踩坑、最容易导致线上重大生产事故的,就是 持久化 这三个字 ------ 它不像 Redis 命令那样直观,不像主从架构那样有明确的作用,但它却是 Redis 线上运行的 "生命线",没有持久化,Redis 就是一个 "一次性" 的数据库,宕机即丢数据,毫无可用性可言。
一个问题:Redis 的数据到底存在哪里?默认情况下,数据会一直存在吗?
答案非常明确,也非常关键:Redis 的所有数据,默认情况下,全部存在内存里;只要 Redis 进程崩溃、服务器断电、人为重启、系统崩溃,内存里的所有数据会瞬间全部丢失,半点儿都留不下。
为了让你彻底理解这个问题,我用一个生活化的例子,把 "内存" 和 "硬盘" 的区别,讲一讲:
- 内存 = 教室里面的 黑板 :黑板的特点是什么?写字速度极快、擦除速度极快、看的速度极快 ------ 老师写板书,一秒能写好几个字;擦黑板,几秒钟就能擦得干干净净;学生看黑板,一眼就能看清所有内容。但黑板有一个致命的缺陷:只要一断电(比如晚上放学关灯)、一擦除(老师下课擦黑板)、一意外损坏(比如黑板砸了),上面所有的内容会瞬间消失,再也找不回来。哪怕你写了满满一黑板的重点,只要擦一下,就全部归零。
- 硬盘 = 你手里的 笔记本、作业本、纸质文档 :笔记本的特点是什么?写字速度慢一点、看的速度慢一点、修改的速度慢一点 ------ 你写一个字,需要几秒钟;看一页笔记,需要几分钟;修改一个错误,还要涂涂改改。但笔记本的优势也极其明显:只要你把内容写上去了,就算合上本子、就算断电、就算放一年、就算不小心掉在地上,上面的内容也会一直存在,永远不会丢。哪怕你把本子放在抽屉里放十年,再拿出来,上面的字迹依然清晰可见。
Redis 之所以性能逆天、每秒能扛几万甚至几十万次请求,核心原因就是它 全程基于内存操作------ 所有的读命令(GET、HGET、LRANGE 等)、写命令(SET、DEL、HSET 等),都是直接操作内存,不碰硬盘。内存的读写速度,是普通机械硬盘的上万倍、是 SSD 硬盘的上百倍,所以 Redis 才能做到 "秒级响应",支撑高并发业务。
但性能快的代价,就是 数据天生带 "易失性"------ 只要出现以下任何一种情况,Redis 内存里的所有数据,不管是 100M、10G、还是 100G,都会在一瞬间全部清空,彻底消失,找都找不回来:
- 人为误操作:执行
kill -9强制杀死 Redis 进程、执行FLUSHALL清空所有数据(误操作); - 程序异常:Redis 进程崩溃、内存溢出(OOM)导致进程被系统杀死;
- 服务器故障:服务器突然断电、机房跳闸、服务器硬件损坏(CPU、内存、主板故障);
- 系统异常:操作系统崩溃、重启、病毒攻击导致系统瘫痪。
你可以想象一下这些恐怖的场景,每一种场景,在生产环境中发生一次,就是 一级线上事故,轻则服务不可用、用户流失,重则资金损失、企业处罚、团队担责:
- 电商系统:用户的购物车数据、订单缓存、支付状态、商品库存、用户登录态,全部丢失。用户打开 APP,购物车是空的、订单看不到、无法支付、商品库存显示异常,直接导致用户流失、订单流失、营收损失;
- 游戏系统:玩家的战力排行榜、游戏积分、段位、道具缓存、在线状态、游戏进度,全部清零。玩家辛辛苦苦玩了几个月的账号,一夜回到解放前,直接引发玩家炸锅、投诉量爆炸、APP 评分暴跌;
- 社交系统:用户的登录态、会话信息、未读消息、关注列表、好友关系,全部丢失。用户反复登录、消息丢失、无法查看好友动态,功能完全不可用,用户体验直接拉满;
- 金融 / 支付系统:交易流水、账户状态、扣款缓存、订单状态、资金余额,全部丢失。直接引发资损、账务错乱、合规事故,甚至面临监管部门的处罚,对企业的声誉和利益造成致命打击。
这些场景,因为忽略了持久化配置,或者配置不当,一旦出现服务器断电、进程崩溃,就会丢失大量核心数据,造成无法挽回的损失。
而 Redis 持久化,就是用来 彻底解决 "内存数据断电丢失" 这个致命问题 的唯一方案,没有之一。
它的核心作用,用一句通俗直白的话来说就是:把内存里转瞬即逝、一丢就没的数据,老老实实、稳稳当当地保存到硬盘上,变成永久存在的文件;等 Redis 重启、服务器恢复之后,再把硬盘上的文件读回内存,把数据原封不动地还原回来,保证数据不丢、服务可用。
Redis 官方非常清楚,单一的持久化方案无法满足所有业务场景,所以没有只设计一种持久化机制,而是提供了 两套完全独立、逻辑不同、优缺点互补、可以同时开启、可以单独使用 的持久化机制,分别是:
- RDB(Redis Database)持久化 :我们可以把它理解成 "拍照存档、快照备份"------ 在指定的时间点,把 Redis 内存里此时此刻的所有数据,完整拍一张 "全量照片",压缩成一个二进制文件存到硬盘上,重启时直接把这张 "照片" 读回内存,瞬间恢复所有数据;
- AOF(Append Only File)持久化 :我们可以把它理解成 "记账本、流水日志"------Redis 每执行一次修改数据的命令(比如 SET、DEL、HSET、LPUSH、ZADD 等),就把这条命令原封不动地记在一个日志本子上,永远只追加、不删除、不修改历史命令;重启时,Redis 把这本日志从头到尾重新执行一遍,所有数据就全部还原回来了。
这两套机制,没有绝对的好坏,只有 不同的适用场景、不同的性能表现、不同的数据安全等级、不同的恢复速度。比如:
- 如果你追求 "快速恢复、文件小、适合备份",可以用 RDB;
- 如果你追求 "数据安全、实时持久化、不丢数据",可以用 AOF;
- 如果你既想保证数据安全,又想追求快速恢复,就可以同时开启 RDB + AOF,并且开启 Redis 4.0 以后推出的 混合持久化,兼顾两者的所有优点 ------ 这也是现代企业生产环境的标准方案、最优方案。
下面,我们正式进行解析
第一部分:RDB 持久化
第一章:RDB 到底是什么?用最通俗的话彻底讲明白,补充所有你可能想问的小细节
RDB,全称是 Redis Database,它是 Redis 从诞生之初就自带的持久化方案,也是 Redis 中最简单、最容易理解、恢复速度最快、文件体积最小的持久化方式 ------ 它的设计思想非常朴素,就是 "拍快照",把某一时刻的全量数据,完整保存下来。
我们不用记任何专业定义,也不用背任何复杂的概念,只需要记住一句话,就能彻底理解 RDB 的本质:
RDB 持久化,就是在指定的时间点,把 Redis 内存中当前所有的键值对数据(不管是 String、Hash、List、Set、ZSet,还是其他数据类型),完整打包、压缩,生成一个紧凑的二进制文件,存到硬盘上;下次 Redis 启动时,直接加载这个二进制文件,瞬间把所有数据恢复到内存里,还原成拍照那一刻的状态。
我再用一个更生活化的类比,把 RDB 的整个过程还原出来:
- 你有一个 巨大的房间(这个房间,就对应 Redis 的内存),房间里面摆满了各种各样的东西 ------ 有衣服、有家具、有电器、有书籍、有玩具(这些东西,就对应 Redis 内存里的所有键值对数据,比如 String 类型的 "username:zhangsan"、Hash 类型的 "user:1:name=zhangsan&age=20");
- 你担心这个房间某天会被清空、东西会被搬空、房间会被毁(对应 Redis 崩溃、断电、重启),所以你想给房间里的所有东西做一个备份;
- 你找了一个 专业的摄影师 (这个摄影师,就对应 Redis 的 BGSAVE 子进程),和他约定好:"每天晚上 12 点,如果房间里的东西有至少 1 件被移动、被新增、被删除,你就来给我的房间拍一张高清全景照片"(对应 RDB 的自动触发规则
save 86400 1); - 到了约定的时间,摄影师来了,他不打扰你做任何事情(对应 BGSAVE 不阻塞主线程),安安静静地走进房间,把房间里所有的东西,完完整整地拍一张全景照片(对应子进程遍历内存数据、生成 RDB 快照);
- 摄影师拍好照片后,会对照片进行压缩(对应 RDB 的 LZF 压缩),让照片的体积变小,方便保存;
- 压缩完成后,摄影师会把这张照片存到你的 保险柜里 (这个保险柜,就对应服务器的硬盘),并且给照片起一个名字,比如 "room_backup_20260209.rdb"(对应 RDB 的文件名
dbfilename dump.rdb); - 如果某天,你的房间真的被清空了、东西都丢了(对应 Redis 崩溃、断电,内存数据丢失),你只需要把保险柜里的照片拿出来(对应 Redis 加载 RDB 文件),按照照片里的样子,把所有东西原封不动地还原回房间里------ 衣服放回衣柜、家具摆回原位、电器插上电源、书籍放到书架、玩具放到角落(对应 Redis 解析 RDB 文件、恢复所有键值对数据),房间就会恢复成拍照那一刻的样子,所有东西都不会少。
这就是 RDB 的全部本质:某一时刻的全量数据快照、一次性打包、一次性保存、一次性加载,简单、高效、直观。
补充小细节
问:RDB 拍快照的时候,Redis 还能处理业务命令吗?比如我正在给房间拍照,你还能往房间里放东西、拿东西吗?
- 答:可以!只要你用的是 BGSAVE 命令(生产唯一推荐),拍快照的时候,Redis 完全可以正常处理业务命令 ------ 摄影师(子进程)拍照,你(父进程 / 主线程)该往房间放东西、拿东西,完全不影响,互不干扰。只有在摄影师刚开始来(对应 fork 子进程)的那一瞬间,你会短暂停顿一下(对应 fork 阻塞),停顿时间极短,几乎感觉不到。但如果你用的是 SAVE 命令(生产禁用),摄影师拍照的时候,你就不能做任何事情,只能站在原地等他拍完,全程被阻塞。
问:RDB 拍的 "快照",是只拍 "被修改过的东西",还是拍 "房间里的所有东西"?
- 答:不管东西有没有被修改,都会拍!RDB 是 全量快照,只要触发了 RDB,就会把当前内存里的所有数据,不管是新增的、修改的、还是从来没动过的,全部打包、生成快照 ------ 就像摄影师拍全景照片,不管房间里的东西有没有被移动,都会把所有东西都拍进去,不会只拍被移动过的那一件。
问:RDB 生成的文件,是文本文件还是二进制文件?我能直接打开看里面的内容吗?
- 答:是 二进制文件 ,不能直接打开看里面的内容。二进制文件的优点是体积小、加载快,但缺点是可读性差 ------ 你用记事本、vim 打开 RDB 文件,看到的只会是一堆乱码,无法直接查看里面的键值对数据。但你可以用 Redis 自带的工具(比如
redis-check-rdb),查看 RDB 文件的基本信息、校验文件是否完整。
问:如果两次拍快照之间,我给房间里新增了一件东西,然后房间就被清空了,这件新增的东西能恢复吗?
- 答:不能!RDB 只能恢复 "拍照那一刻" 的所有东西,两次快照之间新增、修改、删除的东西,都会丢失 ------ 比如你昨天晚上 12 点拍了一张快照,今天早上 8 点新增了一件衣服,今天早上 9 点房间被清空了,你只能恢复到昨天晚上 12 点的状态,今天早上 8 点新增的那件衣服,因为没有被拍到快照里,所以无法恢复。这也是 RDB 最大的缺点:数据丢失风险高。
问:RDB 快照生成之后,下次再拍快照,会覆盖之前的快照吗?
- 答:会!默认情况下,每次生成 RDB 快照,都会 原子替换 之前的 RDB 文件 ------ 也就是说,新的快照会覆盖旧的快照,硬盘上永远只保留最新的一份 RDB 快照。但你也可以通过修改配置、脚本备份等方式,保留历史快照(比如每天生成快照后,给快照文件加上时间戳,并存放到不同的目录),用于数据回滚、灾难恢复。
RDB 的核心特点
- 文件体积:非常小(二进制格式 + LZF 压缩,通常是内存数据的 1/5 ~ 1/2);
- 恢复速度:非常快(直接加载全量二进制数据,不用重放成千上万条命令,GB 级数据通常几秒、十几秒就能加载完成);
- 数据安全:一般(两次快照之间的数据,宕机就丢,丢失时间取决于自动触发规则);
- 性能影响:较小(只有 fork 子进程瞬间短暂阻塞,其余时间子进程后台运行,不影响主线程处理业务);
- 适用场景:全量冷备、主从全量复制、对数据丢失不敏感的业务、追求快速恢复的业务(比如纯缓存、临时数据)。
第二章:RDB 持久化的触发机制 ------ 手动触发 + 自动触发
RDB 不是随时都在生成快照文件的,它必须满足 明确的触发条件 才会执行 ------ 就像你和摄影师约定好 "每天晚上 12 点,有至少 1 件东西被修改才拍照",只有满足这个条件,摄影师才会来拍照。
Redis 把 RDB 的触发方式分为两大类:手动触发 (人主动执行命令,强制生成快照)和 自动触发(Redis 自己根据配置规则,自动生成快照)。
其中,手动触发里有一个命令是 生产绝对禁用 的,另一个是 唯一推荐 的;
自动触发是生产环境真正发挥作用的核心
第一节:手动触发 ------ 人主动执行命令,强制生成 RDB 文件(生产仅用于临时备份)
手动触发,就是我们通过 Redis 客户端(比如 redis-cli),主动输入命令,让 Redis 立刻、马上生成 RDB 快照文件。Redis 提供了 两条命令 用于手动触发 RDB:SAVE 和 BGSAVE。
这两条命令看起来只有两个字母的差别,但在生产环境中,它们的作用天差地别 ------ 一个是 "地狱级禁用命令",执行一次就可能引发生产事故;
一个是 "天使级推荐命令",是生产中唯一可用的手动触发方式。
1. SAVE 命令 ------ 同步阻塞式 RDB
命令格式 :非常简单,直接在 Redis 客户端(redis-cli)中输入 SAVE,然后回车执行,不需要加任何参数。
执行逻辑 :当你在客户端输入 SAVE 命令并回车后,Redis 的 主线程(也叫父进程)会亲自下场,自己动手生成 RDB 文件------ 它不会创建任何子进程,所有的工作(遍历内存数据、打包数据、压缩数据、写入硬盘),全部由主线程自己完成。
在整个 RDB 文件生成、写入硬盘的全过程中,Redis 主线程会 完全阻塞、暂停一切工作、不接受任何客户端连接、不处理任何读写命令、不响应任何请求------ 就像一个人正在专心致志地写一份重要的文件,谁来打扰、谁来问话,他都完全不理,不管是电话、消息、还是敲门声,都不会回应,直到文件写完为止。
举个例子:如果你的 Redis 实例内存里有 10G 数据,执行 SAVE 命令后,主线程会开始遍历这 10G 数据,打包、压缩、写入硬盘,这个过程可能需要 10 秒、20 秒,甚至更久。
在这十几秒、几十秒的时间里,整个 Redis 服务完全不可用 ------ 所有前端请求(比如用户查询购物车、登录)、后端调用(比如订单系统查询缓存),都会卡住、超时、熔断,最终导致整个系统瘫痪,用户无法使用、接口全部报错、服务彻底宕机。
致命问题:
- 风险 1:长时间阻塞主线程,导致服务不可用 ------ 这是最核心、最致命的问题,对于高并发、低延迟的互联网业务来说,哪怕是 1 秒的阻塞,都可能造成巨大的损失,更别说十几秒、几十秒的阻塞;
- 风险 2:引发缓存雪崩 ------Redis 阻塞后,所有依赖 Redis 的业务都会卡住,进而导致下游服务(比如数据库)压力暴增,最终引发整个系统的雪崩;
- 风险 3:数据丢失风险依然存在 ------ 如果
SAVE执行过程中,服务器突然断电、进程被杀死,RDB 文件会生成失败,不仅之前的数据可能丢失,还可能导致旧的 RDB 文件被损坏。
使用场景 :只有在 完全离线的测试环境、本地调试环境、业务已经 100% 停服、没有任何用户访问、没有任何请求流量 的极端情况下,才能偶尔使用 SAVE 命令。
比如,你在本地调试 Redis,想快速生成一个 RDB 快照,用于测试数据恢复,这时候可以用 SAVE;但在任何有用户访问、有流量、在线上运行的 Redis 实例中,执行 SAVE 命令,直接判定为一级生产事故,后果不堪设想。
命令返回值:
- 执行成功:当 RDB 文件完全生成、写入硬盘后,Redis 会向客户端返回
OK,表示快照生成成功; - 执行失败:如果生成过程中出现错误(比如磁盘满、权限不足、内存不足),Redis 会向客户端返回具体的错误信息,比如 "ERR Background saving error",并打印详细的错误日志。
2. BGSAVE 命令 ------ 异步非阻塞式 RDB
命令格式 :和 SAVE 一样简单,直接在 Redis 客户端(redis-cli)中输入 BGSAVE,回车执行,不需要加任何参数。
执行逻辑 :当你执行 BGSAVE 命令时,Redis 主线程(父进程)不会自己干活,而是调用操作系统的 fork 功能,创建一个全新的子进程(这个子进程,就对应我们之前类比的 "摄影师")。
这个子进程,是父进程的 "复制体"------ 它拥有父进程当前内存里的所有数据快照(这里用到了操作系统的 "写时复制" 技术,我们不用懂底层原理,只需要知道:子进程会完整拥有父进程 fork 那一刻的所有内存数据,而且子进程的工作,完全不会影响父进程)。
创建完子进程之后,整个流程就分成了两部分,互不干扰:
- 子进程(摄影师):全权负责 遍历内存数据、生成 RDB 临时文件、压缩数据、写入硬盘、原子替换旧文件 的全部工作 ------ 它会安安静静地干活,不打扰父进程,不占用父进程的资源(除了 fork 时复制的内存快照),直到所有工作完成;
- 父进程(你):立刻解除阻塞,继续正常接收客户端连接、处理所有读写命令、响应所有请求,完全不受子进程的影响 ------ 你该往房间里放东西、拿东西,完全不影响摄影师拍照,就像没有执行任何命令一样。
整个过程中,唯一可能出现短暂阻塞的地方,只有父进程创建子进程(fork)的那一瞬间------ 就像你招聘摄影师,招聘的过程(fork)只需要几分钟(短暂阻塞),招聘完成后,你就可以继续做自己的事情,摄影师自己去拍照。
这个阻塞时间极短,通常只有 几毫秒到几十毫秒------ 就算是 10G 内存的 Redis 实例,fork 子进程的时间也不会超过 100 毫秒,对于绝大多数业务来说,这个短暂的阻塞几乎没有任何影响,用户完全感觉不到。
核心优势:
- 优势 1:非阻塞、不影响业务 ------ 这是最核心的优势,父进程创建子进程后,立刻恢复正常工作,不阻塞任何客户端请求,不会导致服务不可用、不会引发缓存雪崩;
- 优势 2:数据安全有保障 ------ 子进程生成 RDB 文件时,会先创建临时文件,写入完成、校验通过后,再原子替换旧文件,避免出现文件损坏、不完整的情况;
- 优势 3:性能损耗低 ------ 子进程后台运行,独立完成所有工作,不占用父进程的 CPU、内存资源(写时复制机制,不会真的拷贝全量内存),对 Redis 的整体性能影响微乎其微;
- 优势 4:是自动 RDB 的底层实现 ------Redis 所有的自动触发 RDB 逻辑(比如 save 规则、主从全量复制),底层执行的都是
BGSAVE命令,永远不会执行SAVE命令,这也是BGSAVE成为生产唯一推荐的重要原因。
命令返回值 :和 SAVE 不同,BGSAVE 是异步命令,执行后不会等待 RDB 文件生成完成,而是 立即返回 Background saving started,意思是 "后台保存已启动",表示子进程已经成功创建,正在后台生成 RDB 文件。
如果你想查看 BGSAVE 的执行状态,可以通过以下两个命令:
INFO Persistence:查看持久化相关的统计信息,其中rdb_bgsave_in_progress的值为1,表示正在执行 BGSAVE;值为0,表示执行完成或未执行;rdb_last_bgsave_status的值为ok,表示上次 BGSAVE 执行成功;值为err,表示执行失败;LASTSAVE:查看最后一次成功生成 RDB 文件的时间戳(Unix 时间戳,比如 1739000000,对应北京时间 2026-02-09 12:00:00)。
生产环境铁律:所有 RDB 相关操作,只能用 BGSAVE,绝对不能用 SAVE;任何场景下,只要是在线上运行的 Redis 实例,都不允许手动执行 SAVE 命令,哪怕是测试、调试,也不行。
第二节:自动触发 ------Redis 自己根据规则执行 BGSAVE
手动触发只是运维人员偶尔用来临时备份、测试的手段,自动触发才是 RDB 在生产环境中持续工作、保障数据安全的核心 ------ 它不需要任何人干预,Redis 会自己根据配置好的规则,判断是否需要生成 RDB 快照,满足条件就自动执行 BGSAVE,全程自动化、无人值守。
Redis 内置了 4 种自动触发 BGSAVE 的场景,每一种场景都有明确的触发条件、执行逻辑
自动触发场景 1:配置文件中的 save 规则
这是我们最常配置、最常使用的自动触发方式,也是生产环境中 RDB 自动触发的核心 ------ 就像你和摄影师约定好 "每天晚上 12 点,如果房间里有至少 1 件东西被修改,就来拍照",Redis 也会根据我们配置的规则,自动判断是否触发 BGSAVE。
在 Redis 的配置文件(redis.conf)中,我们可以通过 save m n 的格式,配置 RDB 的自动触发规则,规则的含义非常简单:在 m 秒的时间范围内,如果 Redis 中的数据发生了至少 n 次修改操作(新增、删除、修改),Redis 就自动在后台执行一次 BGSAVE,生成新的 RDB 快照文件。
Redis 默认配置(打开 redis.conf 就能看到):Redis 安装完成后,配置文件中会自带 3 条 save 规则,无需我们手动添加,默认就会生效:
save 3600 1
save 300 100
save 60 10000
我们逐行解释:
-
save 3600 1:3600:表示 3600 秒,也就是 1 个小时;1:表示至少 1 次修改操作;- 整句话的含义:在 1 个小时(3600 秒)之内,如果 Redis 内存中的数据,发生了至少 1 次修改操作(不管是新增、删除、还是修改,只要是改变了数据的命令,都算一次修改),Redis 就会自动在后台执行一次 BGSAVE,生成新的 RDB 快照。
- 适用场景:用于捕捉低频修改的数据 ------ 比如一些配置信息、静态数据,可能几个小时才修改一次,这条规则可以确保这些数据不会丢失太久。
-
save 300 100:300:表示 300 秒,也就是 5 分钟;100:表示至少 100 次修改操作;- 整句话的含义:在 5 分钟(300 秒)之内,如果 Redis 内存中的数据,发生了至少 100 次修改操作,Redis 就会自动执行一次 BGSAVE。
- 适用场景:用于捕捉中频修改的数据 ------ 比如用户的登录态、购物车数据,可能几分钟就会有几十、上百次修改,这条规则可以平衡数据安全和性能。
-
save 60 10000:60:表示 60 秒,也就是 1 分钟;10000:表示至少 10000 次修改操作;- 整句话的含义:在 1 分钟(60 秒)之内,如果 Redis 内存中的数据,发生了至少 10000 次修改操作,Redis 就会自动执行一次 BGSAVE。
- 适用场景:用于捕捉高频修改的数据 ------ 比如游戏的积分、排行榜、计数器,可能一秒钟就有几十、上百次修改,一分钟就能达到 10000 次,这条规则可以避免高频修改场景下,数据丢失过多。
关键细节:
-
多条
save规则之间是 "或" 的关系,不是 "与" 的关系 ------ 只要满足其中任意一条规则,Redis 就会触发 BGSAVE,不需要同时满足所有规则。比如,你的 Redis 在 1 分钟内发生了 10000 次修改,满足了save 60 10000,Redis 就会执行 BGSAVE,不管其他两条规则是否满足; -
"修改操作" 的明确定义 ------ 所有 会改变 Redis 数据内容 的命令,都算一次修改操作,比如:
- 新增数据:SET、HSET、LPUSH、SADD、ZADD、INCR、DECR 等;
- 删除数据:DEL、HDEL、LREM、SREM、ZREM 等;
- 修改数据:SET(覆盖已有的键)、HSET(修改 Hash 中的字段)、INCR(自增)、DECR(自减)等;而单纯的 查询命令(不会改变数据的命令),不算修改操作,比如 GET、HGET、LRANGE、SMEMBERS、ZRANGE、EXISTS 等 ------ 就算你执行了 10000 次 GET 命令,也不会触发任何一条 save 规则,因为数据没有被修改。
-
如何关闭自动 RDB 触发 ------ 如果我们不想让 Redis 自动触发 RDB(比如生产环境中,我们只使用 AOF 持久化),只需要做以下任意一种操作即可:
- 把配置文件中所有的
save行,全部用#注释掉(注释后,该行配置不生效); - 在配置文件中,直接写
save ""(一对空引号),表示关闭所有自动 RDB 触发规则;注意:关闭自动 RDB 后,手动执行 BGSAVE 依然有效,主从全量复制、SHUTDOWN 等场景的自动 RDB 触发,会根据其他配置调整。
- 把配置文件中所有的
-
配置规则的生效方式 ------ 修改配置文件中的 save 规则后,有两种生效方式:
- 重启 Redis 进程:修改完成后,执行
systemctl restart redis(Linux 系统),重启 Redis,新的 save 规则会生效; - 动态修改(不重启 Redis):使用
CONFIG SET命令,动态修改 save 规则,比如CONFIG SET save "3600 1 300 100 60 10000",修改后立即生效,但这种方式是临时生效,Redis 重启后,会恢复成配置文件中的规则;如果想永久生效,需要同时修改配置文件和动态修改。
- 重启 Redis 进程:修改完成后,执行
-
生产环境中如何调整 save 规则 ------ 默认的 save 规则,适合大多数互联网业务,但我们可以根据自己的业务场景,灵活调整:
- 对数据丢失敏感的业务(比如电商订单):可以把规则调得更严格,比如
save 60 10(1 分钟内至少 10 次修改,就触发 BGSAVE),减少数据丢失时间; - 对数据丢失不敏感的业务(比如纯缓存):可以把规则调得宽松一些,比如
save 86400 1(1 天内至少 1 次修改,就触发 BGSAVE),减少 BGSAVE 的执行频率,降低服务器压力; - 高频写入的业务(比如游戏积分):可以保留默认的
save 60 10000,避免频繁触发 BGSAVE。
- 对数据丢失敏感的业务(比如电商订单):可以把规则调得更严格,比如
自动触发场景 2:主从架构中的全量复制(主从同步必备、底层依赖 RDB)
在 Redis 主从(Master-Slave)架构中,主节点(Master)负责接收所有写命令、修改数据,从节点(Slave)负责复制主节点的数据、提供读请求,实现读写分离、高可用 ------ 这是生产环境中 Redis 高可用的核心架构。
当出现以下两种情况时,主节点会 自动执行 BGSAVE,生成 RDB 快照文件,用于主从全量数据同步:
- 从节点 第一次连接主节点(初次全量同步):比如你新部署了一个从节点,配置好主从关系后,从节点会向主节点发送全量同步请求,主节点会自动执行 BGSAVE;
- 从节点与主节点 断连时间过长,复制积压缓冲区(repl_backlog)中的数据已被覆盖,无法进行增量同步,需要重新进行全量同步:比如从节点宕机了 1 小时,主节点在这 1 小时内写入了大量数据,复制积压缓冲区中的数据已经被新的数据覆盖,从节点重新启动后,无法通过增量同步获取缺失的数据,只能请求主节点进行全量同步,主节点会自动执行 BGSAVE。
完整流程:我们用 "老师(主节点)和学生(从节点)" 的类比,来还原这个流程:
- 学生(从节点)向老师(主节点)发送 "抄笔记" 请求(全量同步请求):"老师,我没有你的笔记,麻烦你把所有笔记都给我一份,我抄下来";
- 老师(主节点)收到请求后,知道学生没有任何笔记,需要给学生一份完整的笔记(全量数据),于是老师自动找了一个笔记本(BGSAVE 子进程),开始整理自己所有的笔记(遍历内存数据),把所有笔记完整地抄在笔记本上(生成 RDB 快照文件);
- 老师整理完笔记(BGSAVE 执行完成)后,把这本笔记本(RDB 文件)交给学生(从节点);
- 学生(从节点)收到笔记本(RDB 文件)后,先把自己手里现有的笔记(自身内存数据)全部清空(避免数据冲突),然后逐字逐句地抄老师的笔记(加载 RDB 文件),完成全量数据同步 ------ 此时,学生的笔记和老师的笔记,完全一致;
- 全量同步完成后,老师(主节点)再把后续新增、修改的笔记(增量命令),实时告诉学生(从节点),学生及时补充到自己的笔记里(增量同步),确保老师和学生的笔记,始终保持一致。
核心作用 :RDB 是 Redis 主从全量复制的 唯一载体,没有 RDB,主从架构就无法完成全量数据同步 ------ 因为主节点无法把自己的内存数据,直接 "复制" 给从节点,只能通过生成 RDB 快照文件,把文件发送给从节点,从节点加载文件,才能完成全量同步。
这也是 RDB 至今仍未被淘汰的重要原因之一 ------ 哪怕现在 AOF 是生产主流,RDB 在主从架构中依然不可替代,没有 RDB,主从就无法工作,读写分离、高可用就无从谈起。
补充细节:
- 主节点执行 BGSAVE 时,不会影响主节点处理写命令 ------ 和手动执行 BGSAVE 一样,主节点 fork 子进程生成 RDB,主线程继续处理写命令,子进程后台生成文件,不阻塞业务;
- 从节点加载 RDB 文件时,会阻塞从节点 ------ 从节点加载 RDB 文件的过程中,无法处理任何读请求,直到加载完成;
- 主节点生成的 RDB 文件,会被临时保存,发送给从节点后,不会覆盖主节点自身的 RDB 文件(除非主节点同时满足了 save 规则,触发了自动 BGSAVE)。
自动触发场景 3:执行 SHUTDOWN 命令正常关闭 Redis(优雅退出、数据保存)
当我们使用 SHUTDOWN 命令 正常、优雅地关闭 Redis 时(不是用 kill -9 强制杀死进程),Redis 会做最后的数据保存操作,确保内存中的最新数据,不会因为关闭而丢失 ------ 此时,RDB 会被自动触发,具体逻辑如下:
- 如果 没有开启 AOF 持久化:Redis 会自动执行一次 BGSAVE,把当前内存中的最新数据,生成 RDB 快照文件,写入硬盘;等 BGSAVE 执行完成、数据保存成功后,Redis 再安全、优雅地退出,确保数据不丢;
- 如果 已经开启 AOF 持久化 :Redis 会优先使用 AOF 保证数据安全 ------ 因为 AOF 数据更完整、实时性更强,此时 RDB 的触发逻辑会根据配置进行调整:默认情况下,Redis 不会再触发 BGSAVE,而是直接把 aof_buf 缓冲区中的数据,刷写到 AOF 文件中,然后退出;但如果配置了
rdbcompression yes等相关参数,Redis 可能会在退出前,生成一次 RDB 快照,作为额外备份。
关键细节(无限详细说明,生产必懂):
- 只有 正常执行
SHUTDOWN命令 ,才会触发自动 RDB------SHUTDOWN命令是 Redis 的优雅退出命令,执行后,Redis 会先保存数据,再关闭进程,不会丢失数据; - 如果是 强制关闭 Redis (比如
kill -9 进程号、服务器突然断电、系统崩溃),Redis 来不及执行任何操作,不会触发 BGSAVE,内存中的最新数据,会全部丢失; - 执行
SHUTDOWN命令时,如果 Redis 正在执行 BGSAVE 或 AOF 重写,Redis 会等待这些操作执行完成后,再关闭进程,确保数据保存成功; - 示例:如果你的 Redis 没有开启 AOF,执行
SHUTDOWN后,Redis 会打印日志:"Background saving started"(触发 BGSAVE),等 BGSAVE 完成后,再打印日志:"Redis is now ready to exit, bye bye",表示关闭成功。
自动触发场景 4:执行 debug reload 命令调试重启(仅测试、生产几乎不用)
debug reload 是 Redis 的调试命令,它的作用是:在不重启 Redis 进程的情况下,重新加载 Redis 的配置文件、重新加载内存数据,相当于 "原地重启" Redis,但不会终止进程。
当执行 debug reload 命令时,Redis 会自动触发 BGSAVE------ 先把当前内存中的最新数据,生成 RDB 快照文件,保存到硬盘;然后再重新加载配置文件、重新加载数据,确保数据不会因为重新加载而丢失。
补充细节:
- 这个命令 仅用于本地测试、调试环境 ,生产环境中几乎永远不会用到 ------ 因为生产环境中,重新加载配置、重新加载数据,通常会通过重启 Redis 进程来完成,
debug reload可能会引发一些不可预知的问题; - 执行
debug reload时,Redis 会短暂阻塞 ------ 重新加载数据的过程中,Redis 无法处理客户端请求,直到加载完成; - 示例:在本地调试时,你修改了 Redis 的配置文件,不想重启 Redis,就可以执行
debug reload,Redis 会自动触发 BGSAVE 保存数据,然后加载新的配置文件,生效新的配置。
第三章:BGSAVE 完整执行流程
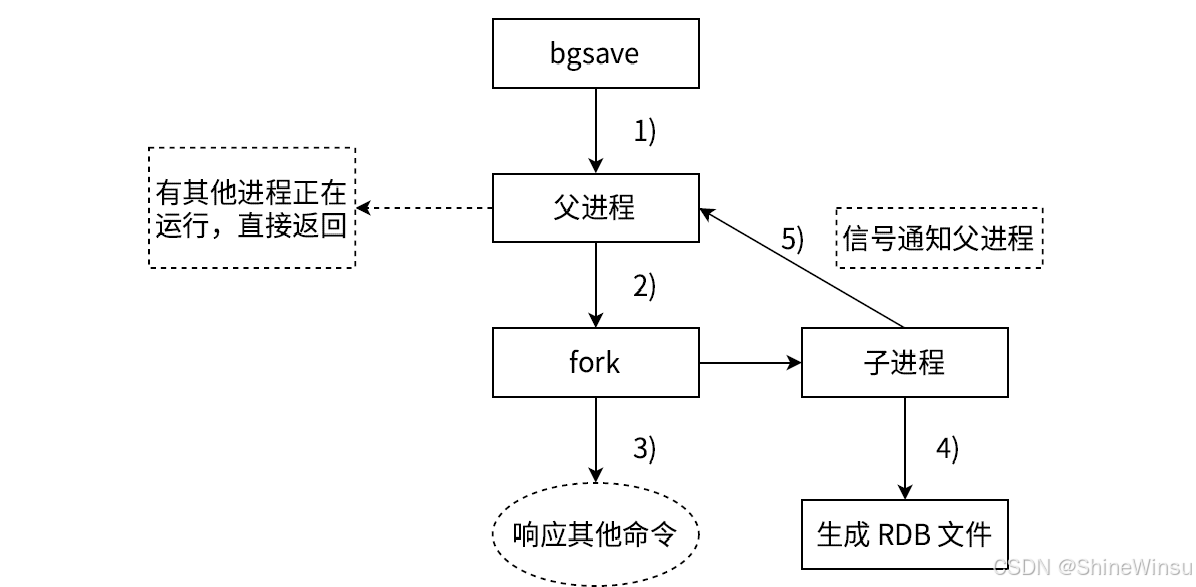
BGSAVE 是 RDB 持久化的核心 ------ 不管是手动触发 RDB,还是自动触发 RDB,底层执行的都是 BGSAVE 命令。它的执行流程是固定的、标准化的,每一步都有明确的操作、明确的角色(父进程 / 子进程)、明确的作用,没有任何模糊的地方。
我们把 BGSAVE 的执行流程,拆分成 5 个步骤:谁在干活?会不会阻塞?数据怎么写?文件怎么存?状态怎么更新?
BGSAVE 整体流程总览
- 命令校验与冲突检查(父进程干活,不阻塞);
- 父进程 fork 创建子进程(唯一短暂阻塞点);
- 父进程解除阻塞,正常处理业务命令(父进程干活,不阻塞);
- 子进程独立生成 RDB 文件,完成原子替换(子进程干活,不阻塞父进程);
- 子进程完成任务,通知父进程更新统计信息(父子进程协作,不阻塞)。
步骤 1:执行 BGSAVE,父进程做冲突检查(第一步:安全校验,不阻塞)
当我们执行 BGSAVE 命令,或者 Redis 自动触发 BGSAVE 时,Redis 父进程(主线程)做的第一件事,不是立刻生成文件,而是 做冲突检查------ 检查当前 Redis 实例中,是否有其他持久化子进程在运行,避免多个子进程同时竞争 CPU、内存、硬盘 IO,导致服务器性能暴跌、文件错乱。
具体操作:父进程会检查两个状态:
rdb_bgsave_in_progress:判断是否有 RDB 子进程正在运行(比如上一次 BGSAVE 还没执行完成);aof_rewrite_in_progress:判断是否有 AOF 重写子进程正在运行(AOF 重写也是 fork 子进程执行,和 BGSAVE 会竞争资源)。
检查结果处理:
- 如果其中任意一个状态为
1(表示有子进程正在运行):说明当前有其他持久化操作正在执行,为了避免资源竞争、文件错乱,本次 BGSAVE 会直接放弃执行,返回信号通知父进程,不做任何操作;同时,Redis 会打印日志,提示 "Background saving already in progress"(后台保存已在进行中); - 如果两个状态都为
0(表示没有子进程正在运行):说明当前环境安全,没有资源竞争,可以继续执行下一步,开始创建子进程。
通俗类比:就像你想去卫生间洗澡,你先敲敲门,检查里面有没有人在洗澡 / 上厕所(冲突检查)。如果有人,你就等一会儿或者直接走(放弃执行);如果没人,你再进去洗澡(继续执行)------ 避免两个人同时占用卫生间,造成冲突。
补充细节:
- 这个检查过程,由父进程执行,完全不阻塞父进程------ 父进程在检查的同时,依然可以处理客户端的读命令(GET、HGET 等),但会暂时拒绝写命令(SET、DEL 等),直到检查完成;
- 检查时间极短,通常只有几微秒、几毫秒,几乎不会对业务造成任何影响。
步骤 2:父进程 fork 创建子进程(整个 RDB 过程中,唯一的短暂阻塞点)
冲突检查通过后,父进程会调用操作系统的 fork() 系统调用,创建一个全新的子进程------ 这个子进程,就是负责生成 RDB 快照文件的 "核心角色",也是 BGSAVE 非阻塞的关键。
关键细节:
- fork 的作用:创建一个和父进程几乎一模一样的子进程 ------ 子进程会拥有父进程 当前时刻内存中的所有数据快照(包括所有键值对、数据类型、过期时间、配置信息等),就像 "复制粘贴" 了一个父进程一样;
- 写时复制机制:很多同学会问,"如果父进程的内存有 10G,fork 子进程的时候,是不是要把 10G 内存全部复制一遍?那样岂不是很耗时、很占用内存?"------ 答案是:不会!操作系统采用了 "写时复制"(Copy-On-Write)技术,fork 子进程时,不会真的把父进程的内存数据,全部复制给子进程,而是让父进程和子进程,共享同一份内存数据;只有当父进程 修改 某一块内存数据时,操作系统才会把这块数据,复制一份给子进程,父进程修改自己的复制件,子进程依然使用原来的那份数据。这样做的好处是:fork 子进程的速度极快(不用复制全量内存),占用的内存也极少(只在父进程修改数据时,才会复制少量数据),大幅降低了 fork 的耗时和内存开销;
- 阻塞说明:在 fork 子进程的这一瞬间,父进程会 短暂阻塞------ 因为操作系统需要创建子进程、分配进程 ID、设置共享内存等,这些操作需要占用一定的时间,会导致父进程暂时无法处理客户端请求。阻塞时间的长短,取决于两个因素:Redis 内存大小、服务器 CPU 性能 ------ 内存越小、CPU 性能越强,阻塞时间越短;内存越大、CPU 性能越弱,阻塞时间越长。通常情况下,10G 内存的 Redis 实例,fork 子进程的阻塞时间,不会超过 100 毫秒;5G 内存的实例,阻塞时间通常在 10~50 毫秒之间,对于绝大多数业务来说,这个短暂的阻塞几乎没有任何影响;
- 查看 fork 耗时:我们可以通过
INFO stats命令,查看最近一次 fork 子进程的耗时,对应的参数是latest_fork_usec,单位是 微秒 (1 秒 = 1000000 微秒)。比如,latest_fork_usec:50000表示最近一次 fork,耗时 50 毫秒; - fork 失败的情况:如果服务器的内存不足、CPU 负载过高、进程数达到上限,fork 子进程可能会失败 ------ 此时,Redis 会打印错误日志,提示 "Cannot fork, out of memory"(无法创建子进程,内存不足),BGSAVE 执行失败,Redis 会拒绝本次持久化操作,同时恢复正常处理业务命令。
通俗类比:父进程(你)要做一份公司全量资产报表(RDB 文件),但你不想耽误自己接待客户(处理业务命令),于是你临时招聘了一个实习生(子进程)------ 招聘实习生的过程(fork),只需要几分钟(短暂阻塞),招聘完成后,你把自己手里的所有资产资料(内存数据),全部 "共享" 给实习生(写时复制),实习生就拥有了和你一样的资料,然后你继续接待客户(父进程处理业务),实习生开始做报表(子进程生成 RDB)。
步骤 3:fork 完成,父进程解除阻塞,正常处理所有业务命令
一旦父进程完成 fork 操作,子进程成功创建,父进程会 立刻解除阻塞 ,同时向客户端返回 Background saving started 信息(如果是手动执行 BGSAVE)。
从这一刻开始,父进程和子进程,就进入了 "并行工作" 的状态,互不干扰:
- 父进程:完全恢复正常工作,继续接收所有客户端连接、处理所有读写命令(GET、SET、DEL、HGET 等)、响应所有请求,和没有执行 BGSAVE 之前,完全一样,没有任何性能影响;
- 子进程:开始独立执行 RDB 快照生成工作,遍历自己拥有的内存数据、打包数据、压缩数据、写入硬盘,全程不依赖父进程,不占用父进程的 CPU、内存资源(除了 fork 时共享的内存)。
步骤 4:子进程独立生成 RDB 文件,完成原子替换(子进程后台工作,完全不影响父进程)
子进程从父进程 fork 出来后,手里已经持有fork 那一刻完整的内存数据快照------ 不管之后父进程再怎么新增、修改、删除数据,子进程都完全看不见、也不会感知,它只基于自己拿到的这份 "静态快照" 来生成 RDB 文件,就像摄影师拿到相机后,不管你再往房间里放东西、拿东西,他只拍自己看到的那一瞬间的画面,后续的变化和他无关。
整个写入过程,子进程会严格按照下面的逻辑一步步执行,每一步都保证安全、不损坏、不乱写,哪怕中途出现意外,也不会影响硬盘上已有的旧 RDB 文件,这也是 RDB 持久化最安全的设计之一:
- 创建临时 RDB 文件(最关键的安全步骤,避免文件损坏) 子进程不会直接往旧的
dump.rdb文件里写数据,也不会直接覆盖旧文件,而是先在 Redis 配置文件中dir参数指定的目录下,创建一个临时 RDB 文件 (文件名通常是temp-xxx.rdb这类带随机后缀的临时名称,比如temp-12345.rdb)。
很多同学会问,为什么要多此一举创建临时文件?直接往旧文件里写不行吗?
答案非常明确:绝对不行,一旦这么做,大概率会导致数据彻底丢失。
举个最常见的生产场景:如果子进程直接覆盖旧的 dump.rdb,写了一半的时候,服务器突然断电、Redis 进程崩溃,那么旧的 RDB 文件已经被覆盖了一部分,新的文件又没写完,相当于 "新旧文件都毁了",Redis 重启后,没有任何可用的 RDB 文件,内存数据全部丢失,这就是生产中的一级事故。
而创建临时文件,就能完美避免这个问题:子进程先把所有数据写到临时文件里,只有当所有数据都写完、校验无误后,再替换旧文件,这样一来,不管中途出现任何意外(断电、崩溃),硬盘上永远有一份完整可用的旧 RDB 文件,不会出现 "两头空" 的情况。
通俗类比:这就像你要替换桌子上的一份旧合同,你不会直接在旧合同上涂改、覆盖,而是先找一张新纸,把完整的新合同写好、检查无误后,再瞬间把旧合同拿走,把新合同放在原来的位置 ------ 桌子上永远有一份完整的合同,不会出现 "写了一半的残缺合同"。
- 遍历全量内存数据,按格式写入临时文件临时文件创建完成后,子进程就开始正式写入数据了。它会从头到尾、一字不落地遍历自己手里持有的 "fork 时刻的内存数据快照",不管是哪个数据库(Redis 默认有 16 个数据库,db0 到 db15)、不管是哪种数据类型(String、Hash、List、Set、ZSet,还有过期键、未过期键),都会逐一处理,并且按照 Redis 官方规定的 RDB 二进制格式,逐条、完整地写入临时文件。
子进程遍历数据时,不会影响父进程的任何操作 ------ 父进程该处理命令就处理命令,该修改数据就修改数据,子进程完全 "置身事外",只专注于自己手里的静态快照,就像摄影师拍照时,不管你再怎么移动房间里的东西,他只拍自己看到的那一瞬间,后续的移动和他无关;
对于过期键的处理:子进程会自动过滤掉已经过期的键值对,不会把过期数据写入 RDB 文件 ------ 这就像摄影师拍照时,会自动忽略房间里已经坏掉、没用的东西,只拍有用的、完好的物品,避免备份无效数据;
如果 Redis 开启了 rdbcompression yes(这是 Redis 的默认配置,默认开启),子进程在写入数据的同时,会同步使用 LZF 无损压缩算法,对数据进行压缩 ------LZF 压缩是 "无损" 的,意思是压缩后的数据,解压后和原来的数据完全一致,不会丢失任何细节;而且压缩比很高,通常能把内存数据压缩到原来的 1/5 到 1/2,大大减小 RDB 文件的体积,节省硬盘空间,也方便后续的备份、传输(比如主从同步时传输 RDB 文件,体积小速度快)。
补充说明:如果你的 Redis 内存数据本身就是高度压缩的(比如存储的是大量重复的短字符串),LZF 压缩的效果可能会差一些,但对于绝大多数生产场景(比如存储用户信息、购物车、积分等),压缩效果都非常明显;而且压缩消耗的 CPU 资源极少,几乎可以忽略不计,所以生产环境中,我们永远不建议关闭这个配置。
- **数据写入完成,执行严格校验(确保文件完整可用)**当子进程把所有内存数据都遍历完成、写入临时文件后,不会立刻进行替换操作,而是会先对临时文件做一次全面、严格的内部校验,只有校验通过,才会认为这份 RDB 文件是合法、完整、可用的,才能用来替换旧文件;如果校验失败,子进程会直接放弃这份临时文件,退出执行,并且通知父进程本次 BGSAVE 执行失败,Redis 会保留原来的旧 RDB 文件,不会受到任何影响。
校验的内容主要有 3 点,每一点都至关重要,直接决定 RDB 文件能否正常使用:
校验文件大小:判断临时文件的大小是否合理,比如如果内存中有 10G 数据,压缩后至少应该有几 G,如果临时文件只有几 K、几 M,说明写入过程中出现了错误,文件不完整;
校验数据校验和(checksum):Redis 会在写入数据的同时,计算一个 "数据校验和"(可以理解为数据的 "身份证",一个唯一的标识),写入完成后,会重新计算临时文件的校验和,和之前记录的校验和对比,如果一致,说明数据没有被篡改、没有丢失;如果不一致,说明文件被损坏,无法使用;
校验键值对完整性:子进程会随机抽取一部分键值对,检查它们的格式、数据内容是否正确,是否和 fork 时刻的内存数据一致,避免出现 "写入格式错误""数据缺失" 等问题。通俗类比:这就像摄影师拍完全景照片后,不会直接把照片存进保险柜,而是先仔细检查照片 ------ 看看照片是否清晰、有没有拍漏东西、有没有模糊的地方、有没有被损坏,只有确认照片完全合格、没有任何问题后,才会存进保险柜,替换掉旧照片。
- 原子替换旧 RDB 文件(瞬间完成,杜绝中间状态) 当临时文件校验通过后,就到了整个 RDB 生成过程中最核心、最安全的一步 ------原子替换旧 RDB 文件。这里的 "原子替换",是操作系统层面的一个特性,意思是:替换操作是 "瞬间完成" 的,要么完全替换成功(旧文件被删除,新文件生效),要么完全不替换(继续使用旧文件),不会出现 "替换了一半" 的中间状态。
具体操作是:子进程会调用操作系统的 "重命名" 命令(Linux 系统中的 rename 命令),把临时文件的名称,瞬间改成 Redis 配置文件中指定的 RDB 文件名(默认是 dump.rdb)。
因为操作系统的重命名命令是原子操作,所以哪怕在替换的瞬间,服务器突然断电、Redis 进程崩溃,也不会出现 "旧文件被删除、新文件没写好" 的情况 ------ 要么替换完成(新文件生效),要么替换没开始(旧文件还在),永远有一份完整可用的 RDB 文件。
替换完成后,子进程会自动删除原来的临时文件(如果有的话),至此,整个 RDB 文件的生成、校验、替换工作,就全部完成了。
补充细节:生产环境中,我们可以通过查看 Redis 的日志,确认原子替换是否成功,日志中会出现类似 "Background saving terminated with success" 的提示,表示 BGSAVE 执行成功,RDB 文件已经完成原子替换;如果日志中出现 "Background saving error",说明替换失败,需要查看具体的错误原因(比如磁盘满、权限不足)。
步骤 5:子进程完成任务,通知父进程更新统计信息(流程正式结束)
子进程把 RDB 文件的写入、校验、原子替换全部做完后,就会自动正常退出(进程终止),并且向父进程(Redis 主线程)发送一个 "完成信号",告诉父进程:"我已经把 RDB 文件做好了,一切正常,可以更新状态了"。
父进程收到子进程的完成信号后,会立刻做两件事,更新 Redis 内部的持久化统计信息,方便我们后续查看 BGSAVE 的执行情况,这两件事都不会阻塞父进程,不会影响业务命令的处理:
- 更新内部状态参数,记录本次 BGSAVE 的执行结果:
- 把
rdb_bgsave_in_progress的值从 1 改成 0,表示当前没有 RDB 子进程正在运行(之前执行 BGSAVE 时,这个参数会被设为 1); - 把
rdb_last_bgsave_status的值设为ok,表示上次 BGSAVE 执行成功(如果执行失败,这个参数会被设为err); - 把
rdb_last_save_time的值设为当前的 Unix 时间戳,表示最后一次成功生成 RDB 文件的时间(我们可以用LASTSAVE命令,查看这个时间戳对应的北京时间); - 同时,Redis 会把本次 BGSAVE 的执行情况,写入日志文件,方便我们后续排查问题,日志内容大概是:"Background saving terminated with success"。
- 把
- 释放子进程相关的资源:父进程会调用操作系统的
waitpid命令,回收子进程的进程资源(比如子进程占用的内存、CPU 资源),避免出现 "僵尸进程"(僵尸进程会占用系统资源,长期积累会导致服务器性能下降)。
这里有一个特殊情况需要说明:如果子进程在生成 RDB 文件的过程中,出现了错误(比如磁盘满、权限不足、内存不足,或者被人为杀死),子进程会异常退出,并且向父进程发送 "执行失败信号"。
父进程收到失败信号后,会做类似的操作,但会把 rdb_last_bgsave_status 的值设为 err,同时在日志中打印具体的错误信息(比如 "Background saving error: No space left on device",表示磁盘满,无法写入文件),方便我们排查问题,而且此时,旧的 RDB 文件不会被替换,依然保持完整,不会受到任何影响。
通俗类比:实习生(子进程)把资产报表(RDB 文件)做好、检查无误后,交给你(父进程),并且告诉你 "报表做好了,没问题",你收到报表后,会在自己的工作台账上,记录 "报表已完成、完成时间",然后让实习生下班,回收他使用的办公用品(资源释放);如果实习生在做报表的过程中,发现没有纸了(磁盘满),无法继续做,就会告诉你 "做不了了,出现错误",你会在台账上记录 "报表制作失败",并且查明原因(为什么没有纸),同时保留原来的旧报表(旧 RDB 文件)。
至此,整个 BGSAVE 命令的完整执行流程,就全部结束了 ------ 从冲突检查、fork 子进程,到父进程处理业务、子进程生成文件,再到原子替换、状态更新,每一步都设计得非常安全、高效,既保证了数据的安全性,又最大限度地减少了对业务的影响,这也是 BGSAVE 成为生产环境中唯一推荐的 RDB 触发方式的核心原因。
第四章:RDB 文件完整管理体系(路径、名称、压缩、校验、备份、加载)
RDB 文件生成之后,并不是 "放着就不管了",我们还需要掌握它的完整管理方法 ------ 知道它存在哪里、怎么修改存放位置和文件名、怎么压缩、怎么校验是否完好、怎么修复损坏的文件、怎么加载到 Redis 中,这些都是生产环境中运维 Redis 必须掌握的核心技能,每一个细节都可能影响数据安全
4.1 RDB 保存路径与文件名(配置 + 动态修改,生产常用)
RDB 文件的存放位置(路径)和文件名,都可以通过 Redis 的配置文件(redis.conf)进行配置,也可以在不重启 Redis 的情况下,动态修改(临时生效),完全由我们自己控制,灵活适配生产环境的存储需求。
核心配置参数(redis.conf 中,逐行详细解释)
Redis 安装完成后,配置文件中会默认配置好 RDB 的路径和文件名,无需我们手动添加,默认就会生效:
-
dir /var/lib/redis- 作用:指定 RDB 文件、AOF 文件(后续会讲)的统一存放目录,所有持久化文件,都会被保存到这个目录下;
- 默认值:
/var/lib/redis(Linux 系统)、Windows 系统默认是 Redis 安装目录下的data文件夹; - 详细说明:这个目录必须是 Redis 进程用户(比如
redis用户)有权限读写的目录,如果权限不足,BGSAVE 会执行失败,日志中会提示 "Permission denied"(权限拒绝); - 生产建议:不要把这个目录设置在系统盘(比如
/目录),建议单独挂载一块数据盘,把目录设置在数据盘上(比如/data/redis/persistence),避免系统盘满导致 Redis 无法写入持久化文件,同时也能提升 IO 性能(数据盘专门用于存储,不承担系统其他 IO 压力)。
-
dbfilename dump.rdb- 作用:指定 RDB 文件的具体文件名 ,生成的 RDB 文件,会以这个名称保存在
dir配置的目录下; - 默认值:
dump.rdb(默认文件名,通俗易懂,便于识别); - 详细说明:文件名可以自定义,建议加上一些标识,比如
dump_20260209.rdb(加上日期)、dump_master.rdb(主节点的 RDB)、dump_slave1.rdb(从节点的 RDB),这样在生产环境中,我们能快速区分不同时间、不同节点的 RDB 文件,方便备份和恢复; - 注意:修改文件名后,下次生成 RDB 文件时,会以新的文件名保存,旧的 RDB 文件不会被自动删除,需要我们手动删除(或者通过脚本自动清理),避免占用过多硬盘空间。
- 作用:指定 RDB 文件的具体文件名 ,生成的 RDB 文件,会以这个名称保存在
生产常用操作:动态修改路径 / 文件名(不重启 Redis)
在生产环境中,我们通常不希望重启 Redis(重启会导致服务不可用),此时可以通过 CONFIG SET 命令,动态修改 RDB 的路径和文件名,修改后立即生效,但这种方式是临时生效------Redis 重启后,会恢复成配置文件(redis.conf)中设置的路径和文件名;如果想让修改永久生效,需要同时修改配置文件和执行动态修改命令。
动态修改的命令:
-
动态修改 RDB 存放目录:
CONFIG SET dir /data/redis/persistence- 解释:把 RDB 文件的存放目录,临时修改为
/data/redis/persistence,下次生成 RDB 文件时,就会保存到这个目录下; - 注意:修改目录前,必须确保这个目录已经存在,并且 Redis 进程用户有权限读写(可以用
chown -R redis:redis /data/redis/persistence命令,修改目录权限)。
- 解释:把 RDB 文件的存放目录,临时修改为
-
动态修改 RDB 文件名:
CONFIG SET dbfilename dump_20260209.rdb- 解释:把 RDB 文件名,临时修改为
dump_20260209.rdb,下次生成 RDB 文件时,就会以这个名称保存; - 注意:修改文件名后,旧的
dump.rdb文件依然存在于原来的目录下,不会被自动替换或删除。
- 解释:把 RDB 文件名,临时修改为
-
查看当前配置的路径和文件名:
CONFIG GET dir、CONFIG GET dbfilename- 执行
CONFIG GET dir,会返回dir的当前配置值(比如/data/redis/persistence); - 执行
CONFIG GET dbfilename,会返回当前的 RDB 文件名(比如dump_20260209.rdb),方便我们确认修改是否生效。
- 执行
关键细节
-
动态修改只对 "下次生成的 RDB 文件" 生效,不会影响已经存在的旧 RDB 文件 ------ 比如你动态修改了存放目录,已经保存在
/var/lib/redis下的dump.rdb,依然会留在原地,不会自动移动到新目录,需要我们手动移动; -
如果修改了存放目录,Redis 启动时,会先去新目录下寻找 RDB 文件,如果新目录下没有 RDB 文件,再去旧目录下寻找(如果旧目录还在的话),如果都没有,Redis 会启动成功,但内存数据为空;
-
生产环境中,建议定期清理旧的 RDB 文件(比如保留最近 7 天的 RDB 文件),避免硬盘空间被占满 ------ 可以写一个定时脚本(比如 Linux 的 crontab 脚本),每天凌晨清理 7 天前的 RDB 文件,脚本示例:
# 每天凌晨 2 点,清理 /data/redis/persistence 目录下,7 天前的 RDB 文件 0 2 * * * find /data/redis/persistence -name "dump_*.rdb" -mtime +7 -delete- 解释:
find命令查找指定目录下,名称以dump_开头、后缀为.rdb的文件,-mtime +7表示文件修改时间在 7 天前,-delete表示删除这些文件;
- 解释:
-
不要把 RDB 文件存放在临时目录(比如
/tmp目录)------Linux 系统会定期清理/tmp目录下的临时文件,可能会导致 RDB 文件被误删,造成数据丢失。
4.2 RDB 压缩(rdbcompression)
Redis 生成 RDB 文件时,会默认对数据进行压缩,使用的是 LZF 无损压缩算法,这个功能由 rdbcompression 配置参数控制,它直接影响 RDB 文件的体积和传输速度,是生产环境中必须关注的配置。
核心配置参数详解
rdbcompression yes # 默认值是 yes,开启压缩;设置为 no,关闭压缩- 作用:控制 RDB 文件生成时,是否对数据进行 LZF 无损压缩;
- 默认值:
yes(开启),Redis 官方推荐开启,也是生产环境的标准配置; - 压缩原理:LZF 是一种轻量级、无损的压缩算法,它不会破坏任何数据,压缩后的数据解压后,和原来的内存数据完全一致;它的压缩速度很快,消耗的 CPU 资源极少,几乎可以忽略不计,同时压缩比很高,通常能把内存数据压缩到原来的 1/5 ~ 1/2,大大减小 RDB 文件的体积。
开启 vs 关闭压缩
| 配置(rdbcompression) | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| yes(开启,默认) | 1. RDB 文件体积小,节省硬盘空间;2. 传输速度快(比如主从同步时,RDB 文件小,传输时间短);3. 压缩消耗 CPU 极少,几乎不影响 Redis 性能;4. 无损压缩,不丢失任何数据。 | 1. 生成 RDB 文件的时间,会比关闭压缩时稍微长一点(但差别极小,比如 10G 数据,开启压缩可能多花 1~2 秒);2. 加载 RDB 文件时,需要先解压,加载时间会稍微长一点(同样差别极小)。 | 生产环境绝大多数场景(99% 的业务),不管是主从架构、冷备、还是数据恢复,都建议开启。 |
| no(关闭) | 1. 生成 RDB 文件的时间稍微短一点(省略压缩步骤);2. 加载 RDB 文件的时间稍微短一点(省略解压步骤)。 | 1. RDB 文件体积极大,占用大量硬盘空间(比如 10G 内存数据,关闭压缩后,RDB 文件可能有 8~10G,开启压缩后只有 2~5G);2. 传输速度慢(主从同步时,大文件传输时间长,可能导致从节点同步延迟);3. 浪费硬盘资源,长期积累会导致硬盘满。 | 只有一种极端场景:Redis 内存数据极小(比如小于 100M),而且对 RDB 生成 / 加载速度有极致要求(比如本地调试、临时测试),可以临时关闭;生产环境绝对不建议关闭。 |
关键细节
- 压缩只对 "值(value)" 进行压缩,不对 "键(key)" 进行压缩 ------ 比如你执行
SET username zhangsan,RDB 会压缩zhangsan这个值,不会压缩username这个键,因为键的长度通常很短,压缩意义不大; - 对于已经压缩过的数据(比如你存储的就是压缩后的图片、视频、文档),LZF 压缩的效果会很差,甚至可能导致 RDB 文件体积变大 ------ 这种场景下,可以考虑关闭压缩,但生产环境中,很少会把压缩后的二进制数据存到 Redis 中(Redis 适合存储结构化数据,不适合存储大二进制文件);
- 动态修改压缩配置(不重启 Redis):
CONFIG SET rdbcompression yes(开启)、CONFIG SET rdbcompression no(关闭),临时生效;永久生效需要修改配置文件; - 压缩不会影响数据安全 ------LZF 是无损压缩,不管压缩、解压多少次,数据都不会丢失、不会被篡改,这是生产环境敢开启压缩的核心原因。
4.3 RDB 校验与损坏修复(redis-check-rdb)------ 生产应急必备,避免数据丢失
Redis 启动时,如果发现 RDB 文件损坏、不完整、被篡改,会直接拒绝启动,并且在日志中打印错误信息(比如 "Bad RDB format version""Unexpected EOF reading RDB file"),避免加载脏数据、错误数据,影响 Redis 正常运行。
生产环境中,RDB 文件损坏的场景很常见,比如:服务器突然断电、Redis 进程被强制杀死(kill -9)、磁盘损坏、文件传输过程中中断(比如主从同步时,RDB 文件传输一半中断),这些都会导致 RDB 文件损坏。此时,我们不能直接删除损坏的 RDB 文件(否则数据会全部丢失),而是可以使用 Redis 自带的 redis-check-rdb 工具,对损坏的 RDB 文件进行校验和修复,尽可能保留完整的数据。
第一步:RDB 文件校验(检查文件是否完好)
redis-check-rdb 是 Redis 官方提供的 RDB 文件校验工具,安装 Redis 后,会自动自带这个工具,不需要额外安装,
它的作用是:检查 RDB 文件的格式是否正确、数据是否完整、校验和是否匹配,判断文件是否可用。
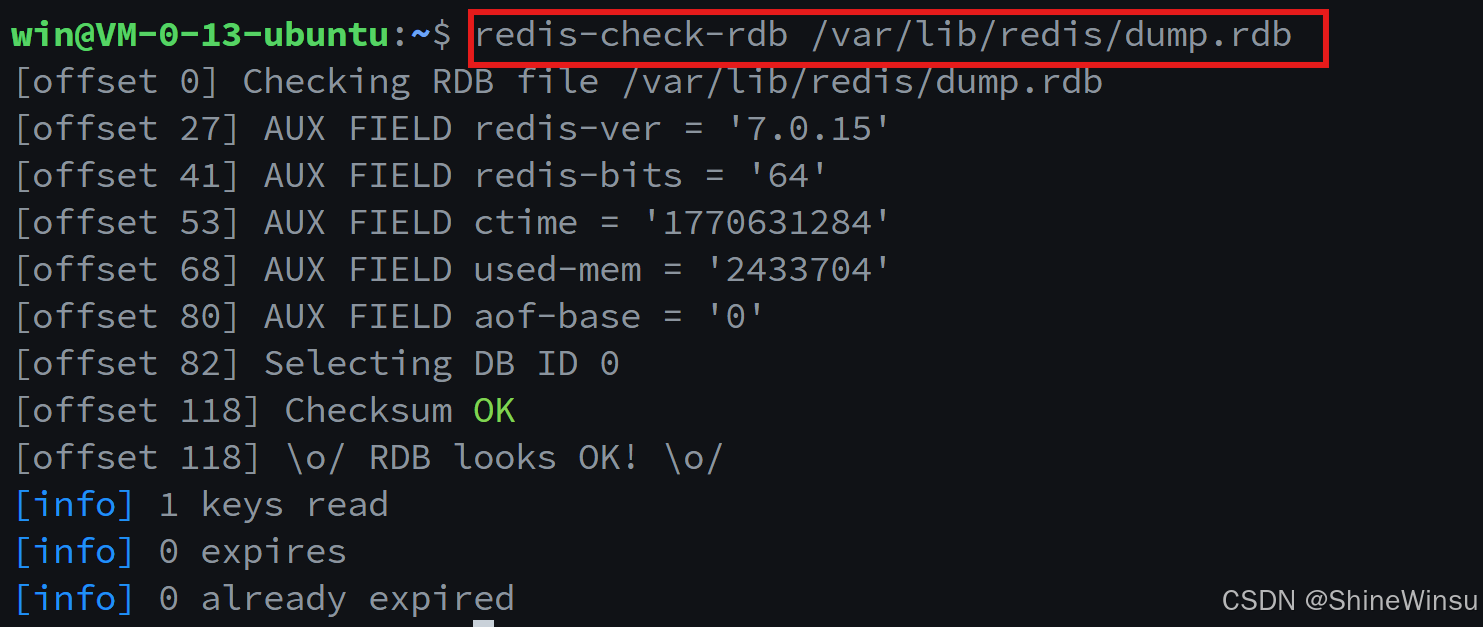
校验命令:
redis-check-rdb /var/lib/redis/dump.rdb- 解释:
redis-check-rdb是工具名称,/var/lib/redis/dump.rdb是 RDB 文件的完整路径(根据你自己的配置修改); - 校验结果解读(生产常用,必须记住):
-
如果校验通过(文件完好):工具会打印 RDB 文件的相关信息(比如文件版本、数据量、压缩方式、数据库数量),最后提示 "OK",表示文件完好,可以正常加载;示例输出:
[offset 0] Checking RDB file /var/lib/redis/dump.rdb [offset 26] AUX FIELD redis-ver = '7.0.0' [offset 40] AUX FIELD redis-bits = '64' [offset 52] AUX FIELD ctime = '1739000000' [offset 67] AUX FIELD used-mem = '10485760' [offset 83] AUX FIELD aof-preamble = '0' [offset 85] Selecting DB ID 0 [offset 1000] Checksum OK [offset 1000] \o/ RDB looks OK! \o/ -
如果校验失败(文件损坏):工具会打印具体的错误信息,提示文件损坏的位置和原因,最后提示 "Fatal error found, RDB can't be loaded",表示文件损坏,无法正常加载;示例输出(文件中断导致损坏):
[offset 0] Checking RDB file /var/lib/redis/dump.rdb
[offset 26] AUX FIELD redis-ver = '7.0.0'
[offset 40] AUX FIELD redis-bits = '64'
[offset 52] AUX FIELD ctime = '1739000000'
[offset 67] AUX FIELD used-mem = '10485760'
[offset 83] AUX FIELD aof-preamble = '0'
[offset 85] Selecting DB ID 0
[offset 500] Unexpected EOF reading RDB file
[offset 500] Fatal error found, RDB can't be loaded
-
第二步:RDB 文件修复(损坏后兜底方案,尽可能保留数据)
如果 RDB 文件校验失败,说明文件已经损坏,此时可以使用 redis-check-rdb 工具的 --fix 参数,对损坏的文件进行修复。
修复的原理很简单:工具会从头到尾扫描 RDB 文件,找到损坏、截断、非法的部分,将这部分损坏的数据删除,保留前面完整、可用的数据,然后生成一个新的、完整的 RDB 文件,让 Redis 能够正常加载。
生产修复标准流程):
-
第一步:备份损坏的 RDB 文件(极其重要,绝对不能跳过)修复前,必须先备份损坏的 RDB 文件,避免修复失败后,连损坏的文件都没有,导致数据彻底丢失。备份命令:
cp /var/lib/redis/dump.rdb /var/lib/redis/dump.rdb.bak- 解释:把损坏的
dump.rdb文件,复制一份,命名为dump.rdb.bak,存放在同一个目录下,作为备份;如果修复失败,我们还可以尝试其他方法(比如找历史备份),或者重新使用这个备份文件进行修复。
- 解释:把损坏的
-
第二步:执行修复命令,修复损坏的 RDB 文件
redis-check-rdb --fix /var/lib/redis/dump.rdb-
解释:
--fix参数表示 "修复模式",工具会自动扫描并修复损坏的 RDB 文件; -
修复过程输出(示例):
[offset 0] Checking RDB file /var/lib/redis/dump.rdb [offset 26] AUX FIELD redis-ver = '7.0.0' [offset 40] AUX FIELD redis-bits = '64' [offset 52] AUX FIELD ctime = '1739000000' [offset 67] AUX FIELD used-mem = '10485760' [offset 83] AUX FIELD aof-preamble = '0' [offset 85] Selecting DB ID 0 [offset 500] Unexpected EOF reading RDB file [offset 500] Fixing... [offset 500] Truncating RDB at offset 500 [offset 500] Checksum OK [offset 500] \o/ Fixed RDB file /var/lib/redis/dump.rdb \o/ -
解读:工具发现文件在偏移量 500 的位置中断(损坏),然后执行修复,截断损坏的部分,保留前面 500 偏移量之前的完整数据,修复完成后,提示 "Fixed RDB file",表示修复成功。
-
-
第三步:校验修复后的 RDB 文件,确认可用修复完成后,必须再次校验修复后的文件,确认文件已经完好,避免加载后出现问题:
redis-check-rdb /var/lib/redis/dump.rdb- 如果校验通过(提示 "OK"),说明修复成功,可以启动 Redis,加载这个修复后的 RDB 文件,恢复数据;
- 如果校验依然失败,说明文件损坏过于严重(比如前面大部分数据都损坏了),此时只能放弃修复,使用历史备份的 RDB 文件,或者接受数据丢失。
-
第四步:启动 Redis,验证数据恢复情况修复并校验通过后,启动 Redis,然后通过 Redis 客户端(redis-cli),执行相关命令,验证数据是否恢复成功(比如
KEYS *查看所有键、GET username查看具体的值),确认恢复的数据是完整的、正确的。
关键细节
- 修复的局限性:
redis-check-rdb只能修复 "尾部损坏" 的 RDB 文件(比如文件写入一半中断,前面的数据是完整的),如果是 "头部损坏"(比如文件开头的格式信息损坏),工具无法修复,只能放弃;修复后,会丢失损坏部分的数据(比如文件写入一半中断,修复后会丢失后半部分的数据),但能保留前面完整的数据,总比全部丢失要好; - 备份优先:修复前,必须备份损坏的文件,这是生产应急的铁律 ------ 一旦修复失败,备份文件是我们最后的希望,绝对不能跳过备份步骤;
- 修复后的文件,建议重新生成 RDB:启动 Redis,加载修复后的 RDB 文件,恢复数据后,手动执行一次
BGSAVE,生成一个全新的、完整的 RDB 文件,替换修复后的文件,避免修复后的文件存在潜在的隐患; - 避免文件损坏的预防措施(生产重点):
- 不要用
kill -9强制杀死 Redis 进程,要用SHUTDOWN命令优雅关闭; - 给 Redis 配置独立的数据盘,定期检查磁盘状态,避免磁盘损坏;
- 主从同步时,确保网络稳定,避免 RDB 文件传输中断;
- 定期校验 RDB 文件(比如每天凌晨,用脚本自动校验),发现损坏及时处理,避免等到 Redis 重启时才发现问题。
- 不要用
4.4 RDB 加载规则
当 Redis 启动时,会自动加载硬盘上的持久化文件(RDB 或 AOF),将文件中的数据恢复到内存中,这个加载过程是自动的,不需要我们手动干预,但加载的顺序(优先级)是固定的、不可改变的,我们必须记住这个优先级,否则会出现 "明明有 RDB 文件,Redis 启动后却没有数据" 的问题。
RDB 加载的完整规则
Redis 启动时,加载持久化文件的顺序是:AOF 文件优先于 RDB 文件,只有当 AOF 未开启、或者 AOF 文件不存在、或者 AOF 文件损坏且无法修复时,Redis 才会尝试加载 RDB 文件;如果 RDB 文件也不存在、或者损坏无法修复,Redis 会启动成功,但内存数据为空(空白实例)。
我们用一个流程图,更直观地展示加载规则:
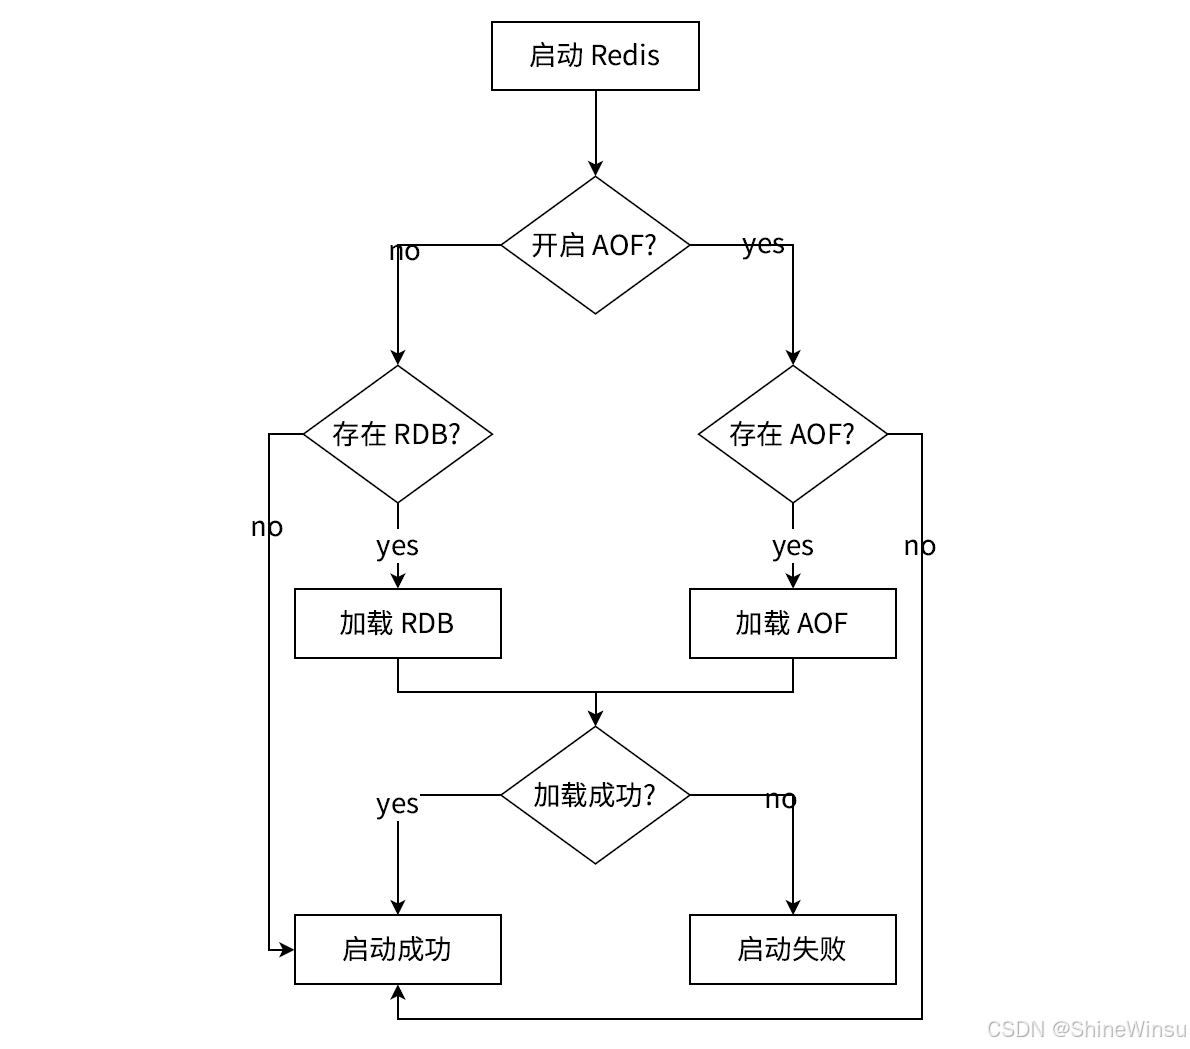
- Redis 启动后,首先检查:是否开启了 AOF 持久化?(也就是
appendonly yes是否配置)- 情况 1:开启了 AOF(
appendonly yes)→ 优先加载 AOF 文件,完全忽略 RDB 文件,不管 RDB 文件是否存在、是否完好;- 继续检查:AOF 文件是否存在?
- AOF 文件存在 → 尝试加载 AOF 文件;
- 加载成功 → Redis 启动成功,数据恢复完成(恢复的是 AOF 文件中的数据);
- 加载失败(AOF 文件损坏)→ Redis 拒绝启动,日志提示错误,需要修复 AOF 文件(后续会讲 AOF 修复);
- AOF 文件不存在 → Redis 启动成功,但内存数据为空(哪怕 RDB 文件存在,也不会加载);
- AOF 文件存在 → 尝试加载 AOF 文件;
- 继续检查:AOF 文件是否存在?
- 情况 2:未开启 AOF(
appendonly no)→ 尝试加载 RDB 文件;- 继续检查:RDB 文件是否存在?
- RDB 文件存在 → 尝试加载 RDB 文件;
- 加载成功 → Redis 启动成功,数据恢复完成(恢复的是 RDB 文件中的数据);
- 加载失败(RDB 文件损坏)→ Redis 拒绝启动,日志提示错误,需要修复 RDB 文件;
- RDB 文件不存在 → Redis 启动成功,但内存数据为空。
- RDB 文件存在 → 尝试加载 RDB 文件;
- 继续检查:RDB 文件是否存在?
- 情况 1:开启了 AOF(
生产常见场景
- 场景 1:同时开启了 AOF 和 RDB,AOF 文件和 RDB 文件都存在 → Redis 启动时,只加载 AOF 文件,忽略 RDB 文件,恢复的是 AOF 中的数据(AOF 数据更完整,实时性更强);
- 场景 2:开启了 AOF,但 AOF 文件损坏无法修复,RDB 文件完好 → Redis 依然会拒绝启动,因为 AOF 开启后,Redis 只会尝试加载 AOF 文件,不会自动切换到 RDB 文件;此时,我们可以临时关闭 AOF(修改配置文件
appendonly no),重启 Redis,加载 RDB 文件恢复数据,恢复后再重新开启 AOF; - 场景 3:未开启 AOF,RDB 文件损坏无法修复 → Redis 拒绝启动,只能修复 RDB 文件,或者使用历史备份的 RDB 文件,否则只能启动空白实例;
- 场景 4:同时开启了 AOF 和 RDB,AOF 文件被误删,RDB 文件存在 → Redis 启动后,内存数据为空(因为 AOF 开启,Redis 会找 AOF 文件,找不到就不加载 RDB 文件),此时需要临时关闭 AOF,重启 Redis 加载 RDB 文件,恢复数据后,再开启 AOF。
关键细节
- 加载优先级的核心原因:AOF 的数据安全性比 RDB 高,AOF 是实时记录命令,数据丢失少(最多丢 1 秒数据,后续会讲),而 RDB 是定时快照,数据丢失多,所以 Redis 官方设计了 "AOF 优先加载" 的规则,优先保证数据的完整性;
- 加载过程会阻塞 Redis 主线程:不管是加载 RDB 文件,还是加载 AOF 文件,Redis 主线程都会被阻塞,无法处理任何客户端请求,直到加载完成;加载时间的长短,取决于持久化文件的大小 ------ 文件越大,加载时间越长(RDB 加载速度比 AOF 快,GB 级 RDB 通常几秒、十几秒,而 GB 级 AOF 可能需要几十秒、几分钟);
- 生产建议:在低峰期(比如凌晨 2~4 点),重启 Redis 或者加载持久化文件,避免加载过程影响业务(比如高峰时段加载,会导致服务不可用,引发用户投诉);
- 查看加载日志:Redis 启动时,会在日志中打印加载持久化文件的过程和结果,比如加载 RDB 的日志:"Loading RDB file into memory: /var/lib/redis/dump.rdb",加载成功后会提示:"RDB loaded from disk";加载 AOF 的日志:"Loading AOF file: /var/lib/redis/appendonly.aof",加载成功后会提示:"AOF loaded from disk",可以通过日志,确认加载是否成功、加载的是哪个文件。
第五章:RDB 的优点
RDB 作为 Redis 最古老、最经典的持久化方案,虽然有一些缺点,但至今依然没有被淘汰,甚至在很多生产场景中不可或缺,核心原因就是它有很多不可替代的优点,这些优点完美适配了 "全量冷备、主从同步、快速恢复" 等生产需求
5.1 优点 1:文件体积极小(二进制 + LZF 压缩,节省硬盘、便于传输)
这是 RDB 最核心、最直观的优点,也是它被广泛用于 "全量冷备、主从同步" 的核心原因 ------RDB 文件是二进制格式,并且默认开启 LZF 无损压缩,文件体积非常小,通常只有内存数据的 1/5 ~ 1/2,比 AOF 文件小很多(哪怕 AOF 经过重写,体积也比 RDB 大)。
详细拆解:
- 为什么文件小?:一方面,RDB 是 "全量数据快照",只存数据的最终状态,不存数据的修改过程(比如你执行了 10 次
INCR count,RDB 只存count的最终值,而 AOF 会存 10 条INCR count命令);另一方面,LZF 无损压缩算法,能进一步减小文件体积,去除数据中的冗余信息; - 生产价值 1:节省硬盘空间 ------ 如果你的 Redis 内存中有 10G 数据,开启压缩后,RDB 文件体积大概在 2~5G,而 AOF 文件(重写后)大概在 5~8G,甚至更大,长期积累下来,RDB 能节省大量的硬盘空间,尤其是对于有多个 Redis 实例、需要长期保留备份的生产环境,这个优点非常明显;
- 生产价值 2:便于传输、节省带宽 ------ 主从架构中,主节点向从节点发送 RDB 文件,进行全量同步,文件越小,传输时间越短,占用的网络带宽越少,能减少主从同步的延迟,避免同步过程中占用过多带宽,影响业务数据传输;另外,我们定期将 RDB 文件备份到远程存储(比如阿里云 OSS、腾讯云 COS),文件越小,备份时间越短,占用的网络资源越少;
- 生产场景举例:某电商平台,Redis 主节点内存有 15G 数据,RDB 文件压缩后只有 4G,主节点向从节点发送 RDB 文件,只需要 1~2 分钟(带宽 50Mbps);如果是 AOF 文件(重写后 10G),传输需要 3~5 分钟,同步延迟会大幅增加,影响从节点的可用性。
5.2 优点 2:恢复速度极快(直接加载二进制数据,远超 AOF)
RDB 的恢复速度,是所有 Redis 持久化方案中最快的,没有之一 ------Redis 启动时,加载 RDB 文件,不需要重放任何命令,只需要直接解析二进制数据,将数据一次性加载到内存中,就能完成数据恢复,速度非常快。
详细拆解:
-
为什么恢复快?:AOF 文件是文本格式,存储的是修改数据的命令,Redis 加载 AOF 时,需要从头到尾、逐条执行这些命令,才能恢复数据(比如 AOF 文件中有 100 万条命令,就需要执行 100 万次);而 RDB 文件是二进制格式,存储的是数据的最终状态,Redis 加载时,只需要解析二进制数据,直接将数据写入内存,不需要执行任何命令,相当于 "直接把数据复制到内存中",效率极高;
-
恢复速度对比(生产真实数据,直观感受):
持久化方式 文件大小 恢复时间(参考) RDB(开启压缩) 5G 5~10 秒 AOF(重写后) 10G 30~60 秒 AOF(未重写) 20G 120~180 秒 - 说明:以上是 16 核 CPU、32G 内存、SSD 硬盘的服务器,恢复速度参考,实际恢复时间,取决于服务器性能和文件大小,但核心结论不变:RDB 恢复速度,是 AOF 的 10~100 倍;
-
生产价值:适合对 "恢复速度有极致要求" 的场景 ------ 比如 Redis 宕机后,需要快速恢复服务,减少服务不可用的时间(比如游戏服务器、电商支付缓存,宕机时间越长,损失越大);另外,生产环境中,我们经常需要搭建新的从节点,从节点加载 RDB 文件恢复数据,恢复速度快,能快速让从节点上线,提升系统的高可用性;
-
生产场景举例:某游戏平台,Redis 实例内存有 10G 数据,RDB 文件压缩后 3G,Redis 宕机后,加载 RDB 文件只需要 8 秒,服务就能快速恢复,玩家几乎感觉不到宕机;如果是 AOF 文件(重写后 8G),加载需要 40 秒,这 40 秒内,玩家无法登录、无法操作,会引发大量投诉,造成巨大损失。
5.3 优点 3:对写入性能影响极小(只有 fork 瞬间短暂阻塞,不影响主线程)
RDB 持久化(使用 BGSAVE 命令),对 Redis 写入性能的影响,几乎可以忽略不计,这也是它能适配高并发场景的核心原因 ------ 整个 RDB 生成过程,只有父进程 fork 子进程的那一瞬间,会短暂阻塞主线程,其余时间,子进程在后台独立工作,不影响父进程(主线程)处理任何业务命令。
详细拆解:
- 性能影响的具体表现:
- fork 瞬间阻塞:父进程 fork 子进程时,会短暂阻塞主线程,阻塞时间极短,通常只有几毫秒到几十毫秒(10G 内存的 Redis 实例,fork 耗时通常不超过 100 毫秒),对于绝大多数业务来说,这个短暂的阻塞,用户完全感觉不到,也不会影响业务的正常运行;
- 子进程后台工作:fork 完成后,子进程独立生成 RDB 文件,遍历数据、压缩、写入硬盘,全程不占用父进程的 CPU、内存资源(写时复制机制,不会真的拷贝全量内存),父进程可以正常处理所有读写命令,和没有执行 BGSAVE 之前,完全一样,没有任何性能损耗;
- 对比 AOF:AOF 持久化,每次执行写命令,都需要将命令写入 aof_buf 缓冲区,并且根据刷盘策略(比如 everysec),定期将缓冲区的数据刷写到硬盘,这个过程会占用一定的 IO 资源,尤其是高写入场景(比如每秒几万次写命令),AOF 的 IO 压力会比较大,而 RDB 只有在生成快照时,才会有短暂的 IO 压力,平时几乎没有;
- 生产价值:适合高并发、高写入的场景 ------ 比如游戏积分、排行榜、计数器,这些场景每秒有大量的写命令,RDB 持久化能最大限度地保证 Redis 的写入性能,不会因为持久化,导致 Redis 响应变慢;
- 生产场景举例:某短视频平台,Redis 实例每秒处理 5 万次写命令(主要是用户点赞、评论、播放量统计),开启 RDB 持久化(save 60 10000),每次 BGSAVE 时,fork 阻塞时间只有 30 毫秒,子进程生成 RDB 文件的过程,完全不影响主线程处理写命令,Redis 的响应时间始终保持在 1 毫秒以内,用户体验不受任何影响。
5.4 优点 4:完美适合全量冷备、定时灾备
RDB 是 "全量数据快照",生成的文件是完整、独立的,不依赖任何其他文件,而且体积小、便于传输,完美适配 "全量冷备、定时灾备" 的生产需求,是企业级 Redis 灾备的标准方案之一。
详细拆解:
- 冷备的核心需求:定期(比如每天、每周)对 Redis 数据进行全量备份,将备份文件存储到远程安全的位置(比如异地存储),一旦发生重大故障(比如服务器硬盘损坏、机房宕机),可以通过备份文件,快速恢复数据,避免数据彻底丢失;
- RDB 适配冷备的原因:
- 全量完整:RDB 文件包含了 Redis 某一时刻的所有数据,备份一次,就相当于备份了全部数据,恢复时,只需要加载这一个文件,就能恢复所有数据,不需要依赖其他文件;
- 体积小、便于存储:RDB 文件体积小,远程存储时,占用的存储空间少,备份成本低;
- 生成方便:可以通过配置自动触发 BGSAVE(比如每天凌晨 2 点,触发一次 BGSAVE),也可以手动执行 BGSAVE,生成 RDB 文件,全程自动化、无人值守,运维成本低;
- 生产灾备标准方案:每天凌晨 2 点,Redis 自动执行一次 BGSAVE,生成 RDB 文件,然后通过脚本,将 RDB 文件复制到异地存储(比如阿里云 OSS 异地备份),保留最近 7 天的 RDB 文件,一旦发生重大故障,就可以从异地备份中,下载最近的 RDB 文件,快速恢复数据;
- 生产场景举例:某金融科技公司,Redis 存储用户的交易流水、账户状态等核心数据,要求 "数据不能丢失,即使机房宕机,也能快速恢复",此时,他们采用的方案是:每天凌晨 2 点,Redis 自动生成 RDB 文件,脚本将 RDB 文件同步到异地机房的存储服务器,保留最近 15 天的备份;如果本地机房宕机,就可以在异地机房,搭建新的 Redis 实例,加载最近的 RDB 文件,快速恢复数据,确保业务正常运行。
5.5 优点 5:主从全量复制的唯一基石(主从架构不可或缺)
在 Redis 主从(Master-Slave)架构中,主节点向从节点进行全量同步时,必须依赖 RDB 文件 ------ 主节点会自动执行 BGSAVE,生成 RDB 文件,然后将 RDB 文件发送给从节点,从节点加载 RDB 文件,完成全量数据同步,没有 RDB,主从架构就无法工作,读写分离、高可用就无从谈起。
详细拆解:
- 主从全量同步的核心需求:新部署的从节点,或者从节点与主节点断连时间过长,需要获取主节点的全量数据,才能与主节点保持一致,提供读服务;而增量同步(后续同步新增命令)只能基于全量同步的基础上进行,没有全量同步,就无法进行增量同步。
- 为什么必须用 RDB?:主节点无法将自己的内存数据,直接 "复制" 给从节点(内存数据是动态的,时刻在变化,而且复制全量内存数据,会占用大量的网络带宽和内存资源,导致主节点性能暴跌);而 RDB 文件是 "静态的全量快照",是一个完整、独立的文件,主节点生成 RDB 文件后,只需要将这个文件发送给从节点,从节点加载文件就能快速获取全量数据,效率高、资源消耗少,这是任何其他方式都无法替代的。
- 对比其他方案(为什么不用 AOF 做全量同步?):很多同学会问,既然 AOF 数据更完整,为什么主从全量同步不用 AOF 文件,而是用 RDB 文件?核心原因有 3 点,每一点都贴合生产实际:
- 体积更小,传输更快:RDB 文件经过压缩,体积比 AOF 文件小很多,主节点向从节点发送 RDB 文件,占用的网络带宽更少、传输时间更短,能减少主从同步的延迟,避免同步过程中占用过多带宽,影响业务数据传输;
- 加载更快,从节点上线更快:从节点加载 RDB 文件的速度,比加载 AOF 文件快 10~100 倍,能快速完成全量同步,让从节点尽快上线,提供读服务,提升系统的高可用性;
- 资源消耗更少:主节点生成 RDB 文件(BGSAVE)的 CPU、IO 消耗,比生成 AOF 文件(尤其是重写 AOF)的消耗更少,不会过度影响主节点的业务处理能力。
- 生产场景举例:某社交平台,Redis 采用 "一主二从" 架构(1 个主节点,2 个从节点),主节点负责接收所有写命令(用户关注、发送消息、点赞等),两个从节点负责接收读命令(查询关注列表、查询消息、查询点赞数等),实现读写分离,提升系统并发能力。当新部署一个从节点时,主节点会自动执行 BGSAVE,生成 RDB 文件(内存 8G,压缩后 2G),发送给新的从节点,从节点加载 RDB 文件只需要 6 秒,就能完成全量同步,快速上线提供读服务;如果用 AOF 文件(重写后 6G),传输需要 3 分钟,加载需要 30 秒,从节点上线速度会大幅变慢,影响系统的读并发能力。
- 补充细节(生产必懂):主节点向从节点发送 RDB 文件时,不会影响主节点的正常业务 ------ 主节点 fork 子进程生成 RDB 文件,主线程继续处理写命令,子进程生成文件后,由专门的线程负责将文件发送给从节点,全程不阻塞主节点;而且主节点生成的 RDB 文件,不会覆盖自身的旧 RDB 文件(除非主节点同时满足 save 规则,触发了自动 BGSAVE),避免影响主节点自身的数据备份。
第六章:RDB 的缺点
虽然 RDB 有很多不可替代的优点,但它的缺点也同样明显、致命 ------ 如果生产环境中单独使用 RDB 持久化,很容易出现 "数据大量丢失""服务不可用""运维成本高" 等问题,这些缺点也决定了它无法成为生产环境的 "主力持久化方案",只能作为 AOF 的补充(比如冷备、主从同步)。
6.1 缺点 1:数据安全性极差(两次快照之间,数据全丢,最致命)
这是 RDB 最致命、最核心的缺点,也是生产环境中几乎不单独使用 RDB 的根本原因 ------RDB 是 "定时全量快照",只有在触发 BGSAVE(手动 / 自动)时,才会将内存数据保存到硬盘;如果在两次 BGSAVE 之间,Redis 出现宕机(断电、进程崩溃、服务器故障等),那么这两次快照之间,所有修改的数据都会全部丢失,丢失的数据量,取决于两次快照的时间间隔,间隔越长,丢失的数据越多。
详细拆解:
- 核心原因:RDB 不记录数据的修改过程,只记录某一时刻的数据最终状态 ------ 就像摄影师每天晚上 12 点给房间拍一张照片,如果你在早上 8 点到晚上 11 点之间,往房间里放了很多贵重物品,结果晚上 11 点 59 分,房间被大火烧毁,那么摄影师晚上 12 点还没来得及拍照,你早上 8 点到晚上 11 点之间放的所有贵重物品,都会全部丢失,只剩下前一天晚上 12 点照片里的东西;RDB 也是一样,两次快照之间的所有修改,都只存在于内存中,没有被保存到硬盘,一旦宕机,全部丢失。
- 丢失数据量的具体场景(结合 save 规则,直观感受):生产环境中,我们常用的 save 规则有 3 种(默认规则),不同规则下,丢失的数据量完全不同:
- 遵循 save 3600 1(1 小时内至少 1 次修改,触发 BGSAVE):如果在 1 小时内,Redis 宕机,那么从上次 BGSAVE 完成,到宕机前的所有修改,都会丢失,最多可能丢失 1 小时的数据;
- 遵循 save 300 100(5 分钟内至少 100 次修改,触发 BGSAVE):如果在 5 分钟内,Redis 宕机,最多可能丢失 5 分钟的数据;
- 遵循 save 60 10000(1 分钟内至少 10000 次修改,触发 BGSAVE):如果在 1 分钟内,Redis 宕机,最多可能丢失 1 分钟的数据。补充说明:如果你的业务修改频率很低(比如几小时才修改一次),那么丢失的数据量可能会更大 ------ 比如你在早上 9 点修改了一条核心数据,然后 Redis 一直没有再触发 BGSAVE(因为没有达到 save 规则),直到晚上 10 点宕机,那么这条早上 9 点修改的数据,会丢失整整 13 小时。
- 补充细节:
- 手动执行 BGSAVE 也无法完全避免数据丢失 ------ 就算你每隔 10 分钟,手动执行一次 BGSAVE,也可能在两次手动执行之间,出现宕机,丢失 10 分钟的数据;而且手动执行需要人工干预,运维成本极高,生产环境中无法依赖手动执行;
- 哪怕配置了很严格的 save 规则(比如 save 10 1,10 秒内至少 1 次修改,触发 BGSAVE),也会丢失最多 10 秒的数据 ------ 对于核心业务(比如支付、金融)来说,10 秒的数据丢失,依然是无法接受的;
- 纯缓存场景也无法完全忽视这个问题 ------ 哪怕你的 Redis 是纯缓存,数据可以从数据库重建,丢失数据也会导致大量请求穿透到数据库,引发数据库压力暴增,甚至导致数据库宕机,引发缓存雪崩。
6.2 缺点 2:fork 子进程存在阻塞风险(内存越大,阻塞越久,可能导致服务不可用)
我们之前讲过,BGSAVE 的核心优势是 "非阻塞",但这个 "非阻塞" 是相对的 ------ 它只有 fork 子进程的那一瞬间,会短暂阻塞 Redis 主线程;而 fork 子进程的阻塞时间,会随着 Redis 内存大小的增加而增加,内存越大,阻塞时间越长,极端情况下,可能导致 Redis 主线程阻塞几秒、几十秒,引发服务不可用、请求超时,这也是 RDB 的一个重要缺点。
详细拆解(结合生产场景,讲透风险,通俗易懂):
- 核心原因:fork 子进程时,操作系统需要创建一个和父进程(Redis 主线程)几乎一模一样的子进程,并且让父子进程共享同一份内存数据(写时复制机制);虽然写时复制机制不会真的拷贝全量内存数据,但操作系统需要做很多准备工作(比如分配进程 ID、设置内存页表、初始化进程环境等),这些准备工作需要消耗一定的时间,而且内存越大,准备工作越多,消耗的时间越长,Redis 主线程就会被阻塞越久。
- 阻塞时间的具体参考(生产真实数据,直观感受):阻塞时间主要取决于两个因素:Redis 内存大小、服务器 CPU 性能,以下是不同内存大小下,fork 子进程的阻塞时间参考(基于 16 核 CPU、32G 内存的服务器):
- 内存 1G 以内:fork 阻塞时间 ≤ 10 毫秒,用户完全感觉不到,对业务没有任何影响;
- 内存 1~5G:fork 阻塞时间 10~50 毫秒,绝大多数业务(比如电商、游戏)可以接受,不会引发请求超时;
- 内存 5~10G:fork 阻塞时间 50~100 毫秒,部分对延迟敏感的业务(比如支付、实时通信),可能会出现少量请求超时;
- 内存 10~20G:fork 阻塞时间 100~300 毫秒,会出现大量请求超时,引发服务不可用,影响用户体验;
- 内存 20G 以上:fork 阻塞时间 ≥ 300 毫秒,甚至可能达到 1~2 秒,Redis 主线程被长时间阻塞,无法处理任何请求,直接导致服务宕机,引发一级生产事故。
- 补充细节:
- fork 阻塞是 "不可避免" 的 ------ 只要执行 BGSAVE,就必须 fork 子进程,就一定会出现短暂阻塞,我们只能通过优化,减少阻塞时间,无法彻底消除;
- 高频触发 BGSAVE,会放大阻塞风险 ------ 如果你的业务写入频率很高(比如每分钟都触发一次 BGSAVE),那么每分钟都会出现一次 fork 阻塞,频繁的阻塞会导致 Redis 响应不稳定,容易引发请求超时;
- 虚拟机环境中,fork 阻塞会更严重 ------ 如果 Redis 部署在虚拟机(比如 VMware、KVM)中,由于虚拟机的内存虚拟化、CPU 虚拟化开销,fork 子进程的阻塞时间,会比物理机多 50%~100%,比如物理机中 100 毫秒的阻塞,虚拟机中可能达到 200 毫秒,所以生产环境中,Redis 优先部署在物理机上。
6.3 缺点 3:高频触发 BGSAVE,服务器 IO/CPU 成本极高(可能导致服务器瘫痪)
RDB 生成 RDB 文件时,需要遍历全量内存数据、进行 LZF 压缩、写入硬盘,这个过程会消耗大量的 CPU 和 IO 资源;如果业务写入频率很高,导致 BGSAVE 被高频触发(比如每分钟一次),那么这些 CPU 和 IO 资源的消耗会被放大,长期下去,会导致服务器 CPU 使用率飙升、IO 负载过高,甚至导致服务器瘫痪,影响 Redis 及其他服务的正常运行。
详细拆解:
- 核心原因:每次执行 BGSAVE,子进程都要做 3 件消耗资源的事情,每一件都会占用大量的 CPU 和 IO:
- 遍历全量内存数据:子进程需要从头到尾,遍历 Redis 内存中的所有键值对,不管是 1G、10G 还是 100G 内存,都要逐一遍历 ------ 遍历内存数据会消耗大量的 CPU 资源(比如 10G 内存,遍历一次可能需要消耗 50% 的 CPU 资源,持续几秒);
- LZF 压缩数据:子进程遍历数据的同时,会对数据进行 LZF 无损压缩,压缩过程也会消耗大量的 CPU 资源(压缩比越高,CPU 消耗越多);
- 写入硬盘:压缩完成后,子进程需要将压缩后的 RDB 文件,写入硬盘 ------ 写入硬盘会消耗大量的 IO 资源(尤其是机械硬盘,IO 速度慢,写入大文件时,IO 使用率会瞬间拉满)。通俗类比:这就像你让一个实习生,每天每分钟都要把整个公司的资产(10G 数据),全部整理一遍、压缩一遍、然后存入保险柜(硬盘),实习生每做一次,都会占用大量的时间和精力(CPU/IO 资源),如果每分钟都做一次,实习生会彻底累垮(CPU 拉满),保险柜也会因为频繁存入文件,变得无法正常使用(IO 饱和);服务器也是一样,高频触发 BGSAVE,会让 CPU 和 IO 长期处于高负载状态,最终瘫痪。
- 生产中的具体风险(结合服务器配置,直观感受):以 "16 核 CPU、32G 内存、机械硬盘(SATA 盘)、Redis 内存 10G" 为例,每次执行 BGSAVE 的资源消耗:
- CPU 消耗:遍历内存 + 压缩数据,会消耗 40%~60% 的 CPU 资源,持续 5~10 秒;
- IO 消耗:写入 RDB 文件(压缩后 2~3G),机械硬盘的写入速度大约是 100~200MB/s,写入 2~3G 文件,需要 10~30 秒,这段时间内,IO 使用率会达到 90% 以上,甚至拉满;如果每分钟触发一次 BGSAVE,那么 CPU 会长期处于 40%~60% 的高负载状态,IO 会长期处于 90% 以上的饱和状态,长期下去,会出现以下问题:
- Redis 自身性能下降:CPU/IO 高负载,会导致 Redis 主线程处理请求的速度变慢,响应时间从 1 毫秒,飙升到 10 毫秒、100 毫秒,甚至超时;
- 服务器其他服务受影响:服务器上的其他服务(比如数据库、应用服务),也需要消耗 CPU 和 IO 资源,Redis 占用了大量资源后,其他服务会因为资源不足,出现性能下降、甚至宕机;
- 服务器瘫痪:长期高负载,会导致服务器过热、硬件老化加速,甚至出现服务器宕机,导致所有服务(包括 Redis)不可用。
- 补充细节:
- 机械硬盘的 IO 压力,比 SSD 硬盘大得多 ------ 如果 Redis 部署在机械硬盘上,高频触发 BGSAVE,IO 很容易拉满;如果部署在 SSD 硬盘上,IO 速度更快(SSD 写入速度通常是 500MB/s 以上),IO 压力会小很多,但 CPU 压力依然存在;
- 关闭 RDB 压缩(rdbcompression no),无法解决根本问题 ------ 关闭压缩后,虽然能减少 CPU 消耗,但会导致 RDB 文件体积大幅增大,写入硬盘的时间更长,IO 压力会更大,得不偿失;
- 高频触发 BGSAVE,反而会增加数据丢失风险 ------ 如果服务器因为高频 BGSAVE 导致 IO 饱和、进程崩溃,那么不仅会丢失两次快照之间的数据,还可能导致 RDB 文件损坏,无法恢复,损失更严重。
6.4 缺点 4:版本兼容性差(高版本 RDB,低版本无法加载,跨版本迁移踩坑)
RDB 文件的格式,会随着 Redis 版本的升级,进行迭代优化(比如新增数据类型、优化压缩算法、调整文件结构),这就导致了一个问题:高版本 Redis 生成的 RDB 文件,低版本 Redis 可能无法加载,甚至会直接拒绝启动,这给 Redis 的跨版本迁移,带来了很大的麻烦,也是生产环境中,RDB 的一个常见缺点。
详细拆解(结合生产场景,讲透风险,通俗易懂):
- 核心原因:Redis 不同版本,对 RDB 文件的格式定义不同 ------ 就像不同版本的办公软件(比如 Word 2021 和 Word 2003),Word 2021 生成的文档(.docx),Word 2003 可能无法打开,因为格式不兼容;RDB 文件也是一样,高版本 Redis 新增的格式特性,低版本 Redis 不支持,所以无法加载高版本生成的 RDB 文件。
- 生产中常见的兼容性问题(真实场景,避坑重点):以下是几个生产中最常遇到的 RDB 版本兼容性问题,每一个都可能导致跨版本迁移失败,数据无法恢复:
- Redis 7.0 生成的 RDB 文件,无法在 Redis 6.0 及以下版本加载 ------Redis 7.0 对 RDB 文件格式进行了较大优化,新增了对 "STREAM 数据类型" 的优化存储、新增了更高效的压缩算法,这些特性是 Redis 6.0 及以下版本没有的,所以 Redis 6.0 加载 Redis 7.0 生成的 RDB 文件,会直接拒绝启动,日志提示 "Bad RDB format version"(RDB 格式版本错误);
- Redis 6.0 生成的 RDB 文件,无法在 Redis 5.0 及以下版本加载 ------Redis 6.0 新增了 "ACL 权限控制" 相关的存储内容,会将 ACL 规则写入 RDB 文件,而 Redis 5.0 及以下版本,不支持 ACL 权限控制,无法解析这部分内容,加载时会报错,拒绝启动;
- Redis 5.0 生成的 RDB 文件,在 Redis 4.0 版本加载,可能丢失数据 ------Redis 5.0 支持 "STREAM 数据类型",会将 STREAM 数据写入 RDB 文件,而 Redis 4.0 不支持 STREAM 数据类型,加载时会忽略这部分数据,导致 STREAM 数据全部丢失,而且不会提示任何错误,很难被发现。
- 补充细节:
- 版本兼容性是 "单向的"------ 低版本 Redis 生成的 RDB 文件,高版本 Redis 通常可以正常加载(高版本会向下兼容低版本的 RDB 格式),比如 Redis 5.0 生成的 RDB 文件,Redis 6.0、7.0 都可以正常加载,不会丢失数据;但高版本生成的 RDB 文件,低版本通常无法加载,或者加载后丢失数据;
- 跨版本迁移,不能直接复制 RDB 文件加载 ------ 如果需要将高版本 Redis 的数据,迁移到低版本 Redis,不能直接复制 RDB 文件,需要通过 "redis-cli 命令导出数据,再导入低版本 Redis" 的方式(比如用 redis-cli dump 命令导出键值对,再用 restore 命令导入),或者先将高版本 Redis 降级,生成低版本兼容的 RDB 文件,再进行迁移;
- 主从架构中,主从节点版本必须一致 ------ 如果主节点是高版本,从节点是低版本,主节点向从节点发送 RDB 文件进行全量同步时,会因为版本不兼容,导致同步失败,从节点无法提供读服务,引发业务异常,所以生产环境中,主从节点的 Redis 版本,必须完全一致。
6.5 缺点 5:只存结果,不存过程(无法审计、无法追溯、无法增量恢复)
RDB 只记录某一时刻的数据最终状态,不记录任何数据的修改过程、修改时间、修改来源(比如哪个客户端执行的修改命令),这就导致了 3 个无法解决的问题:无法审计命令、无法追溯操作、无法增量恢复,这些问题在生产环境中,会给运维和排查问题,带来很大的麻烦。
详细拆解:
- 问题 1:无法审计命令(生产合规风险)很多生产场景(尤其是金融、支付、政务等需要合规的场景),要求对 Redis 的所有修改操作,进行审计 ------ 比如记录 "哪个客户端、在什么时间、执行了什么命令、修改了什么数据",以便出现问题时,能够追溯责任、排查原因;
但 RDB 不记录任何命令,只存数据结果,无法满足审计需求,无法证明 "数据是如何被修改的",无法追溯责任,可能会引发合规风险。通俗类比:这就像公司的保险柜,你只知道保险柜里现在有什么东西(数据最终状态),但不知道 "谁在什么时间、放了什么东西、拿了什么东西",如果保险柜里的贵重物品丢失,你无法追溯是谁拿的,也无法证明是谁的责任;RDB 也是一样,数据被误修改、被删除,你无法知道是谁执行的操作,也无法知道执行了什么命令。
- 问题 2:无法追溯操作(排查问题困难)生产环境中,Redis 数据出现异常(比如数据缺失、数据错误、数据不一致),运维团队需要排查异常原因 ------ 比如是业务代码 bug 导致的、是客户端误操作导致的、还是 Redis 本身出现故障导致的;
但 RDB 不记录任何修改过程,只存数据结果,运维团队无法知道 "数据是如何变成异常状态的",无法追溯操作过程,排查问题的难度极大,可能需要花费大量的时间,甚至无法排查出原因,导致异常持续存在,影响业务
- 问题 3:无法增量恢复(数据恢复不灵活)RDB 是全量快照,只能进行 "全量恢复"------ 也就是将整个 RDB 文件加载到 Redis,恢复所有数据;无法进行 "增量恢复"------ 也就是只恢复某一部分数据、或者只恢复某一段时间内修改的数据;如果 Redis 内存数据很大(比如 100G),全量恢复的时间很长(比如几十分钟),如果只需要恢复某一部分丢失的数据,全量恢复会浪费大量的时间和资源,恢复不灵活,影响服务可用性。
通俗类比:这就像你家里的房间,摄影师给你拍了一张全景照片(RDB 文件),如果你只是丢失了一件衣服(某一部分数据),你无法通过照片,只恢复这件衣服,只能把整个房间的东西,全部重新还原一遍(全量恢复),浪费大量的时间和精力;RDB 也是一样,哪怕只丢失了一条数据,也需要加载整个 RDB 文件,全量恢复所有数据,恢复效率极低。
补充细节:
- 这三个问题,是 RDB 的 "天生缺陷"------ 不管如何优化 RDB 的配置,都无法解决,因为 RDB 的设计思想,就是 "只存结果,不存过程",这也是它和 AOF 的核心区别(AOF 存过程,能解决这三个问题);
- 核心业务、需要排查问题的业务,绝对不能单独使用 RDB------ 如果你的业务,需要审计命令、需要追溯操作、需要灵活恢复数据,那么单独使用 RDB 是完全无法满足需求的,必须搭配 AOF 持久化。
结语
恭喜你,顺利完成 Redis 最经典、最基础的持久化方案 ------RDB 持久化的全体系学习。
如果说前面我们学的数据结构、命令、遍历、多库,是 Redis 的「使用能力」,那持久化就是 Redis 的「生存底线」,而 RDB 就是这条底线上,最老牌、最硬核、至今仍不可替代的一块基石。
回顾整篇内容,我们从最根本的问题出发:为什么 Redis 必须开持久化? 因为内存易失、宕机即丢,而持久化就是把内存数据 "钉" 在硬盘上的唯一手段。Redis 给出两套方案:RDB 快照 、AOF 日志 ,而我们今天吃透的 RDB,就是那个恢复最快、文件最小、主从必用的快照方案。
我们完整打通了 RDB 的全部知识链路:
- 理解了 RDB 的本质:定时全量快照,像给内存数据 "拍照片";
- 分清了生死命令:SAVE 绝对禁用,BGSAVE 生产唯一推荐;
- 吃透了核心原理:fork 子进程 + 写时复制 COW + 临时文件 + 原子替换,这是 RDB 安全、非阻塞的灵魂;
- 掌握了触发机制:手动 BGSAVE、save 规则自动触发、主从全量复制、SHUTDOWN 关闭触发;
- 学会了生产运维:文件路径、压缩、备份、校验、修复、加载优先级;
- 看清了它的真实定位:优点极强,缺点也极明显。
RDB 的价值,从来不是 "全能",而是专一:
- 你要全量冷备、定时灾备 → RDB 是最优解;
- 你要主从全量同步 → RDB 是唯一基石,没有 RDB 主从就无法工作;
- 你要秒级快速恢复 → RDB 吊打 AOF;
- 你要极小文件、节省磁盘 → RDB 天生优势。
但我们也必须清醒记住它的致命短板:
- 两次快照之间宕机,数据必丢,丢失时长从几分钟到几小时不等;
- fork 阻塞随内存变大而加剧,大内存实例风险极高;
- 高频 BGSAVE 会打爆 IO/CPU,拖垮服务器;
- 只存结果、不存过程,无法审计、无法增量恢复。
这也是为什么:生产环境绝对不推荐单独使用 RDB!
真正企业级、高可靠的 Redis 架构,一定是:**RDB + AOF + 混合持久化(Redis 4.0+)**RDB 负责冷备、主从、快速恢复;AOF 负责实时落盘、少丢数据、高可靠;混合持久化兼顾两者优点,成为现代 Redis 的标准标配。
学习 RDB 的真正意义,不止是多会一种持久化方式:
- 它让你理解 Redis 数据是如何落地到硬盘的;
- 它让你搞懂 主从复制为什么必须用快照;
- 它让你建立 灾备、恢复、数据安全的真实生产意识;
- 它是你看懂 Redis 高可用、哨兵、集群、持久化调优的第一步。
从今天起,你不再是那个 "只会 SET/GET,不懂持久化,宕机就丢全量数据" 的新手开发者;你已经具备了线上 Redis 数据安全保障、灾备恢复、运维排查的核心能力。
本篇我们讲透了「拍照存档」的 RDB,下一篇,我们将学习 Redis 真正的数据安全守护神 ------AOF 持久化(Append Only File),它像一本永不修改的记账本,能把数据丢失降到最低(1 秒内),是生产环境真正的主力持久化方案。
牢记今天的核心准则:内存不稳,硬盘保命;SAVE 禁用,BGSAVE 为准;单独 RDB 不可靠,生产必配 AOF。
我们下篇 AOF 持久化,继续深入,把 Redis 数据安全彻底焊死!