四大AI武器:从"盲猜"到"精准打击"
上期我们介绍了区域3确认的几种方法:随机测试、探索性测试、场景变异、AI场景生成。今天咱们深入拆解AI驱动的四种方法:
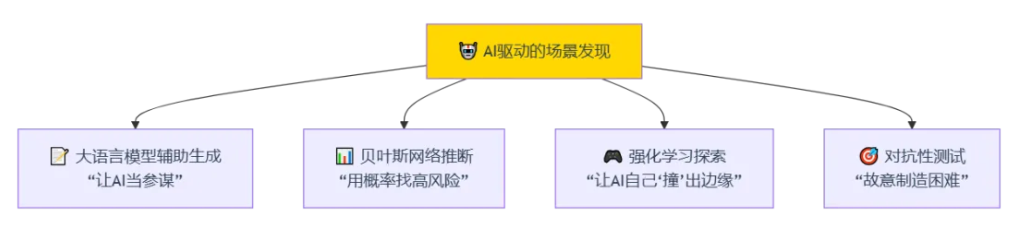
武器一:大语言模型辅助生成------"让AI当参谋"
这是最"新潮" 的方法------用大语言模型(LLM)来辅助生成SOTIF场景。
🎯 为什么LLM能帮上忙?
场景生成是一个技术难度高、劳动强度大的工作,需要持续的创造性投入。SOTIF分析不充分的后果可能很严重。
大语言模型是一种新型的生成式人工智能,在自然语言处理任务上表现出色。既然LLM能写诗、能编程、能写论文------它能不能帮我们"想象"出那些人类没想到的危险场景?
答案是:能。
📌 Heraclitus:一个用LLM生成SOTIF场景的工具
2025年的一项研究介绍了一个叫 Heraclitus 的工程方法和原型软件工具,专门用大语言模型来辅助SOTIF场景生成。
Heraclitus的工作方式:
① 人类分析师输入系统的基本信息(功能、ODD、已知的触发条件)
② LLM基于这些信息,自动生成大量潜在的SOTIF场景
③ 人类分析师对生成的场景进行筛选和优化
④ 形成一套全面的SOTIF场景库,用于持续的风险管理
初步实验结果:
研究人员进行了一项对照实验,让六名系统安全专家分别在有和没有LLM支持的情况下创建SOTIF场景。
结果:有LLM支持的专家生成的场景更全面、更丰富。LLM显示出在支持SOTIF分析方面的潜力,能够生成有用的SOTIF场景。
💡 核心价值:LLM不是"替代"人类分析师,而是"增强"人类分析师。它帮你想出那些"你没想到但可能存在"的场景------然后把筛选和判断的工作留给人来做。
📊 武器二:贝叶斯网络推断------"用概率找高风险"
如果说LLM是"发散思维"(想出各种可能的场景),那贝叶斯网络就是 "收敛思维"(从数据中推断哪些场景最可能危险) 。
🎯 贝叶斯网络在SOTIF中做什么?
2025年的一项研究提出了一种基于贝叶斯网络(Bayesian Network) 的方法,用于系统性地生成ODD内的未知高风险场景。
简单说:从真实事故数据出发,用概率模型推断"哪些场景组合可能导致严重事故,但在历史数据中从未出现过"。
📌 四步法
| 步骤 | 做什么 |
|---|---|
| ① | 从英国道路事故与安全数据库中提取相关属性------道路条件、天气、车辆和环境相关因素 |
| ② | 将这些属性建模为贝叶斯网络中的条件依赖关系,推断严重后果的概率 |
| ③ | 找出历史数据中不存在 、但在贝叶斯网络中概率不为零 且超过严重度阈值的场景------这些就是"未知候选场景" |
| ④ | 通过参数过滤 和轻量级运动学可行性检查,筛选出关键参数范围 |
最终产出 :一个包含高风险、之前未被观察到的场景的数据库,用于自动驾驶系统的验证。
💡 核心价值 :贝叶斯网络让你不是"瞎猜"哪里有问题,而是基于真实事故数据做概率推断------把有限的测试资源集中在"最可能出事"的场景上。
🎮 武器三:强化学习探索------"让AI自己'撞'出边缘"
这是目前最"聪明" 的方法------让AI自己去"探索"系统的能力边界,找出那些会导致系统"犯错"的场景。
🎯 GENESIS-RL:用强化学习生成自然边缘案例
GENESIS-RL 是一个用强化学习(Reinforcement Learning)系统性地生成自然边缘案例(Natural Edge Cases) 的框架。
为什么要强调"自然"?
传统的对抗性攻击方法是在输入中注入人眼不可察觉的噪声 来欺骗模型------这种方法生成的样本不自然、不真实,偏离真实的现实世界场景。
而GENESIS-RL的目标是生成真实的、自然的边缘案例------不是"人工制造"的对抗样本,而是"在真实世界中可能发生"的危险场景。
GENESIS-RL的工作方式:
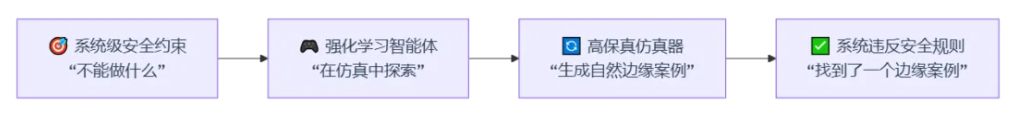
核心逻辑 :强化学习智能体在仿真环境中"试错"------它的目标是找到那些会导致系统违反安全规则的参数组合。由于它是在高保真仿真器中探索,生成的场景是自然的、真实的,而不是人工构造的。
📌 为什么"系统级"很重要?
传统的对抗性攻击通常针对特定组件(比如只攻击感知模块),而不是评估整个系统。
一个在感知模块上的"小错误",如果控制系统能够补偿,可能不会导致系统级故障。
但如果控制系统不能补偿,一个相对较小的感知错误 可能就会导致灾难性的系统级故障。
GENESIS-RL的独特之处在于:它生成的是系统级的边缘案例------不是"某个模块出错了",而是"整个系统在某个场景下'不行'了"。
🎯 武器四:对抗性测试------"故意制造困难"
对抗性测试是最"硬核" 的方法------它故意制造各种"困难条件",看看系统会不会"扛不住"。
📌 运行时未知不安全场景识别
2023年的一项研究提出了一种运行时未知不安全场景识别的方法,专门用于验证自动驾驶的感知系统。
核心思路 :"静默测试"(Silent Testing) ------在不干扰车辆正常行驶的前提下,在后台运行额外的检测算法,识别那些可能导致感知系统出问题的场景。
具体做法:
① 在车辆正常行驶时,后台运行一个额外的感知算法(与主算法不同)
② 当两个算法的输出出现显著差异时,标记当前场景为"潜在危险"
③ 通过多个虚拟实例 从不同的初始状态进行测试,扩展测试空间,发现未知的不安全场景
实验验证 :研究人员使用一个车道标记检测算法(LMDA) 作为案例研究,通过对抗性图像证明了该方法在识别感知系统"死角"方面的有效性。
💡 核心价值 :这种方法不是在仿真中"模拟"场景,而是在真实道路上运行时实时发现"系统可能搞不定的场景"------然后把这些场景记录下来,用于后续的测试和改进
一个重要的"基础设施":PeSOTIF数据集
前面讲的四种方法都需要一个共同的东西------数据。
PeSOTIF数据集 是专门为感知SOTIF问题构建的长尾交通场景视觉数据集。
🎯 PeSOTIF是什么?
PeSOTIF包含1126帧 数据,平均每帧有2.27个关键物体 和2.47个普通物体。
它覆盖了两种类型的触发条件:
| 触发条件类型 | 具体内容 |
|---|---|
| 🌤️ 环境相关 | 雨天、雾天、雪天、直射阳光、远光灯 |
| 🎯 物体相关 | 临时障碍物、干扰物(动物、掉落的轮胎)、意外外观和姿态的道路使用者 |
🎯 PeSOTIF的创新:SOTIF熵
PeSOTIF提出了一个概念------ "感知SOTIF熵" ,用于量化一个场景对感知系统来说是否是"未知且不安全"的。
💡 简单说:如果一个场景的"SOTIF熵"很高,说明感知系统在这个场景下"很没底"------可能看不清、可能认错、可能漏检。
实验结果表明,量化的SOTIF熵可以有效且高效地反映感知算法的失效。
SOTIF熵的价值在于 :它给区域3的"未知不安全"提供了一个量化指标------不再是"我觉得这个场景可能危险",而是"数据告诉我这个场景对系统来说'熵'很高,大概率会出问题"。
📊 四种AI武器的对比
| 武器 | 核心方法 | 优势 | 适用场景 |
|---|---|---|---|
| 📝 大语言模型 | 从功能描述"发散"出大量潜在场景 | 覆盖面广、创意性强 | 初期场景库构建 |
| 📊 贝叶斯网络 | 从事故数据"收敛"到高风险场景 | 数据驱动、有概率依据 | 精准定位高风险区域 |
| 🎮 强化学习 | 在仿真中"试错"发现边缘案例 | 生成自然、真实的场景 | 系统级边缘案例发现 |
| 🎯 对抗性测试 | 在运行时检测"潜在危险场景" | 真实数据、实时发现 | 路测阶段的长尾场景挖掘 |
💡 四种方法不是"选一个",而是"组合使用" :
大语言模型帮你"想"(生成初始场景库)
贝叶斯网络帮你"筛"(找出最可能危险的)
强化学习帮你"探"(在仿真中深入测试)
对抗性测试帮你"验"(在真实道路上确认)
🔥 行业实践:丰田的端到端SOTIF场景生成
丰田已经在使用AI驱动的SOTIF场景生成了。
丰田的做法:

关键步骤:
| 步骤 | 工具 | 做什么 |
|---|---|---|
| ① | dSPACE AUTERA | 采集真实交通数据 |
| ② | understand.ai | 标注道路细节和车辆 |
| ③ | Traffic Virtualizer | 将数据转换为可仿真的场景 |
| ④ | ADAS实车仿真器 | 真实车辆+虚拟环境,无风险测试 |
丰田的目标是进一步扩展仿真环境,更真实地描绘复杂的交通状况,加速自动驾驶系统的安全引入。
💡 丰田案例的启示 :AI驱动的场景生成不是"实验室里的研究",而是已经在量产开发中使用的成熟方法。
⚠️ AI驱动场景发现中容易踩的"坑"
坑1:过度依赖AI,忽视人类判断
❌ "让AI生成所有场景,人类只管执行"
✅ AI是"参谋",不是"决策者" ------人类分析师必须筛选和判断
坑2:生成的场景"不自然"
❌ "用对抗性攻击生成场景"------虽然能找出问题,但场景不真实
✅ 优先使用能生成"自然"场景的方法(如GENESIS-RL),而不是"人工构造"的对抗样本
坑3:只关注"组件级"问题,忽视"系统级"
❌ "只测试感知模块有没有问题"------但系统级故障可能来自多个模块的交互
✅ 优先使用"系统级"的场景生成方法,评估整个系统在场景下的表现
坑4:场景发现"做一次就完事"
❌ "场景库建好了,以后不用再挖了"
✅ 场景发现是持续的过程------系统在进化、ODD在扩展、真实世界在变化,场景库也要持续更新