一. 树
1. 树的概念
1.1 树的定义
树是 n 个结点的有限集。当 n = 0 时,称为空树。当 n > 0 时,称为非空树,任意一棵非空树应该满足一下要求: a. 有且仅有一个特定的称为跟的结点。 b. 当 n > 1时,其余结点可分为 m 个互不相交的有限集 T1,T2,......Tm,其中每个集合本身又是一棵树,并且称为跟的子树。
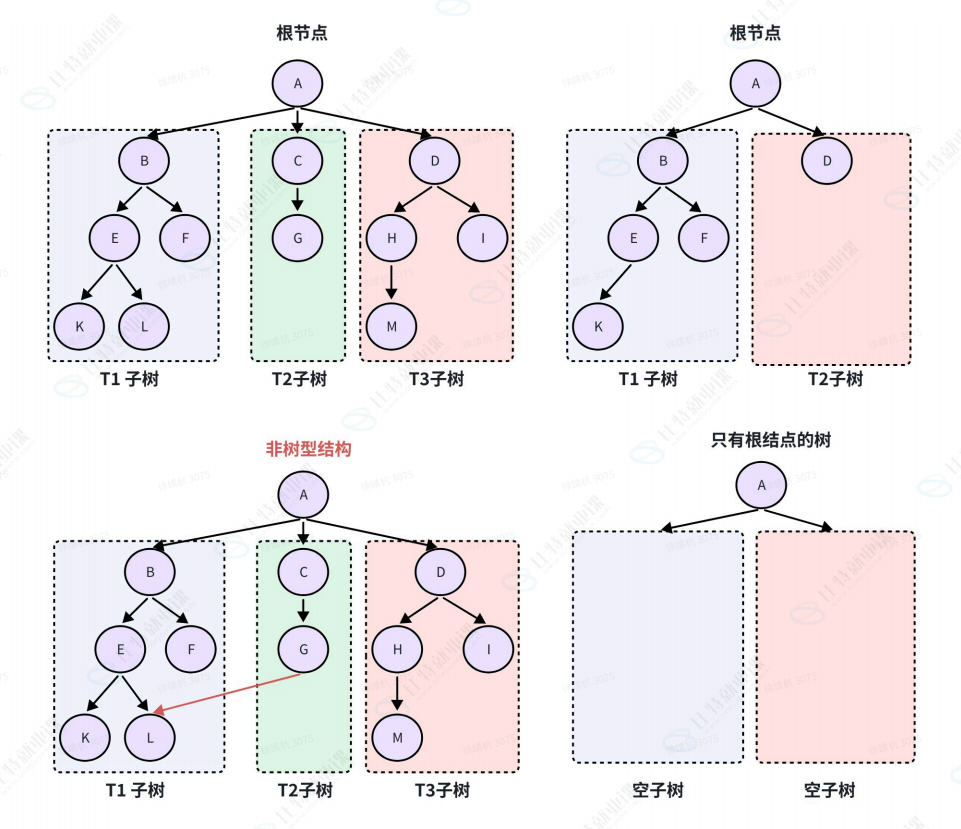
树的跟结点没有前驱结点,除根结点外的所有结点有且只有一个前驱结点,树中的所有结点可以有多个后继结点。
树这个概念名词来源于现实世界中的常见的树,都是从根开始成长,再长出很多子树。
树是一种递归定义的数据结构,树可以分成根和多颗子树,每棵子树又可以分为根和子树,每棵子树又可以......
1.2 基本术语
结点间的关系描述
祖先:从根结点到该结点所经分支上的所有结点称为该结点的祖先。如:A到G分支中,A和C都是G的祖先。
子孙:以某结点为根的子树中任一结点都称为该结点的子孙。如:下面的所有结点都是A的子孙,C的子孙只有G。
孩子 / 双亲:结点所有子树的根结点称为该结点的孩子,相对应,该结点称为孩子的双亲。如:B的孩子是E和F,E和F的双亲是B。
兄弟:同一个双亲的孩子之间互称为兄弟。如:H和I是兄弟结点,这里兄弟类似人类亲缘关系的亲兄弟。
堂兄弟:双亲在同一层的结点互为堂兄弟。如:G和H是堂兄弟关系。
结点和树之间的属性描述
度:树中一个结点的孩子个数称为结点的度,树中结点最大的度数称为树的度。如:下图中结点A的度是3,结点B的度是2,树的度是3。
叶子结点 / 终端结点:度为 0 的结点称为叶子结点或终端结点。如:下图中绿色结点均为叶子结点。
分支结点 / 非终端结点:度不为 0 的结点称为分支结点或非终端结点。
结点的层次:结点的层次从树根结点开始定义,根结点A为第一层,分支结点B,C,D为第二层,依次类推。
树的高度 / 深度:树中结点的最大层数称为树的高度 / 深度。如:下图中该树的高度为4。
有序树 / 无序树:如果将树中结点的各子树看成从左向右是有次序的,则称该树为有序树,否则称为无序树。在有序树中最左边的子树的根称为第一个孩子,最右边的称为最后一个孩子。
路径:树中两个结点之间的路径是由这两个结点之间所经过的结点序列构成的,路径长度为序列结点个数。如:下图中A到K就是一条路径,路径长度为4。
边:表示双亲和孩子之间链接关系叫做边。树中一般很少表示边的关系,一般图中更关注顶点之间的边。
1.3 性质
性质一:树中的结点数 = 所有结点的度数之和 + 1
这个点很好理解,一个结点的度就是这个结点又几个孩子结点,所有的度相加就是累计的孩子结点数,只有根结点没算进去
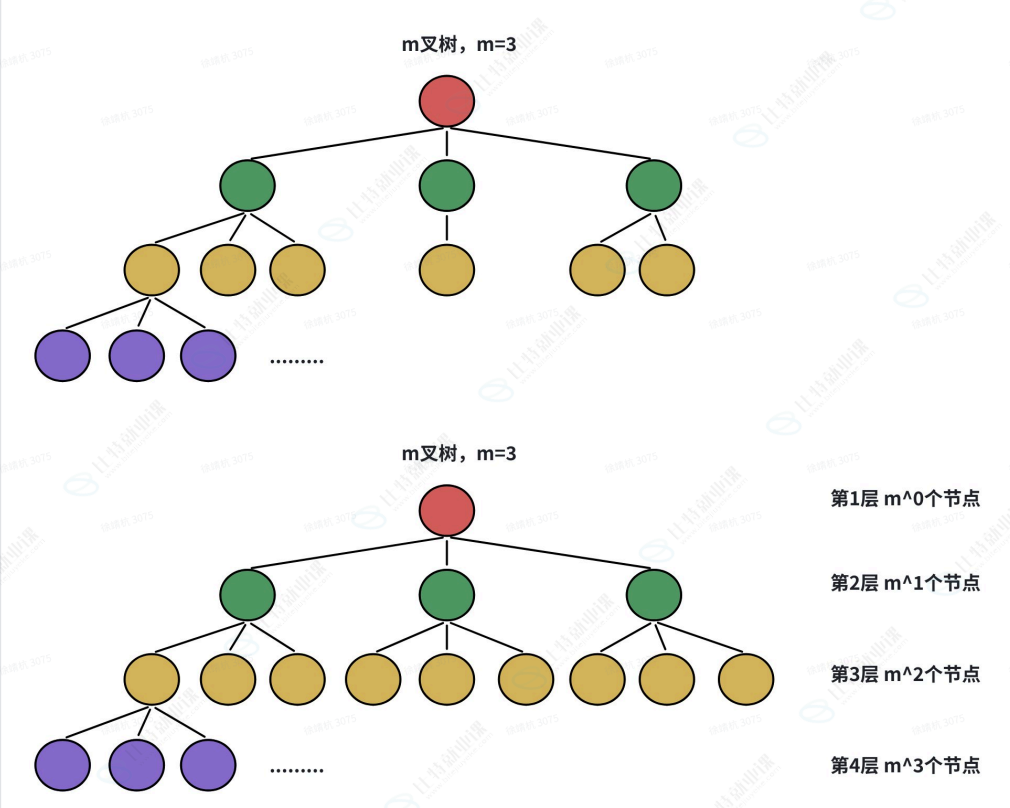
性质二:m叉树中第 i 层上至多又 m ^ ( i -1 ) 个结点
m叉树是指每个结点最多 m 个孩子,最少可以是 0 个孩子,m叉树中不一定存 m 个孩子的结点。
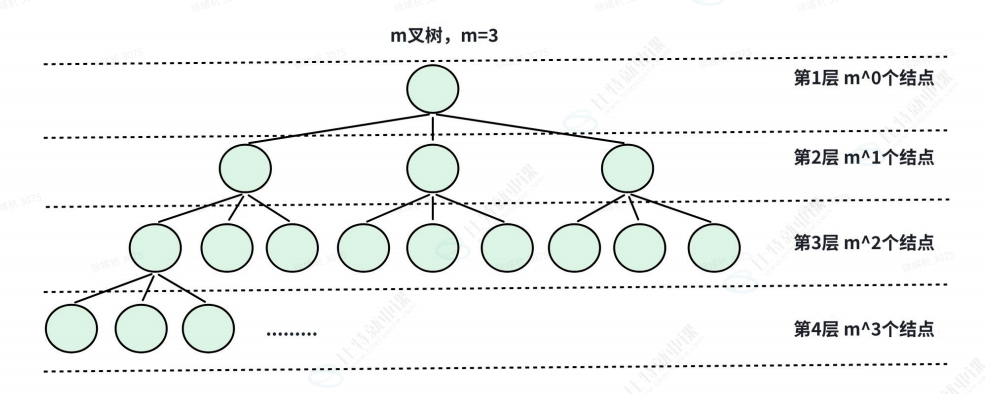
极端场景下高度为 h 的 m 叉树叶子结点都在第 h 层,每个分支结点均有 m 个孩子,每层都是满的,假设层数是 i ,则每层结点树为 m ^ ( i -1 ),则每层结点数为 m ^ ( i -1 ),第 1 至 h 层的结点数是一个以 m 为公比的等比数列。
性质三:高度为 h 的 m 叉树至多有  个结点
极端场景下高度为 h 的 m 叉树叶子结点均在第 h 层,每个分支结点均有 m 个孩子,每层都是结点数达到最大(满),假设层数是 i ,第 1 至 h 层的结点数是一个以 m 为等比的等比数列。
等比数列前 n 项和:
,a1为首项,q为公比,n是项数。
高度为 h 的 m 叉树最多结点数为:
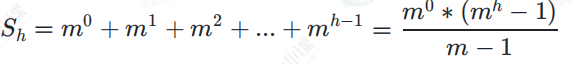
二. 二叉树
1. 二叉树的定义
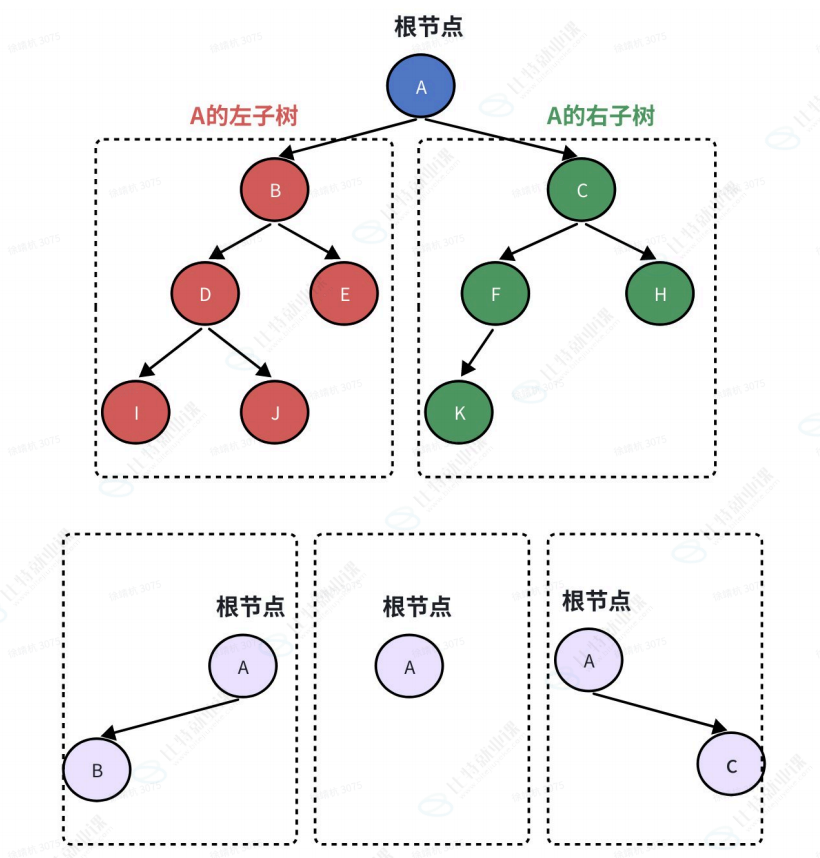
二叉树是另一种树型结构,它的特点是每个结点至多只有两颗子树(即二叉树中不存在度大于 2 的结点),并且二叉树的子树有左右之分,其次序不能任意颠倒(二叉树是有序树),左边的叫左子树,右边的叫右子树。
二叉树的度并不一定为 2,它要求每个结点度最大为 2,特殊情况下,树的度也可能为 0 或者 1.
二叉树也是一个递归定义的数据结构,任何一棵二叉树可以分为根和左右子树,非空的左右子树有可以分为根和左右子树......
2. 几个特殊的二叉树
2.1 满二叉树
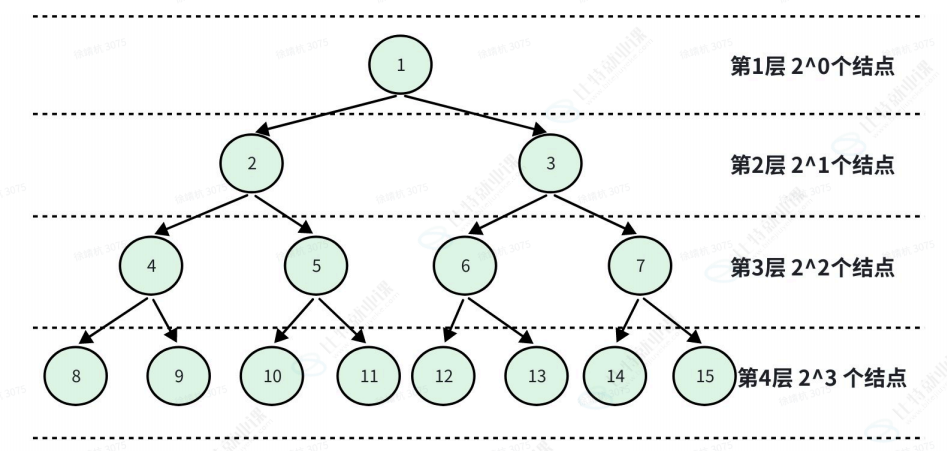
一棵高度为 h 的二叉树,每层结点数都达到最大(满),合计有 2 ^ h -1 个结点的二叉树就叫满二叉树。
满二叉树的叶子结点都在最后一层,且分支结点的度均为 2。满二叉树是当前高度下二叉树结点数最大的形态。
等比数列前 n 项和: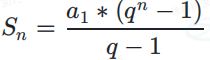 ,a1为首项,q为公比,n是项数。
高度为 h 的满二叉树的合计结点: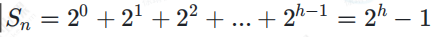
2.2 完全二叉树
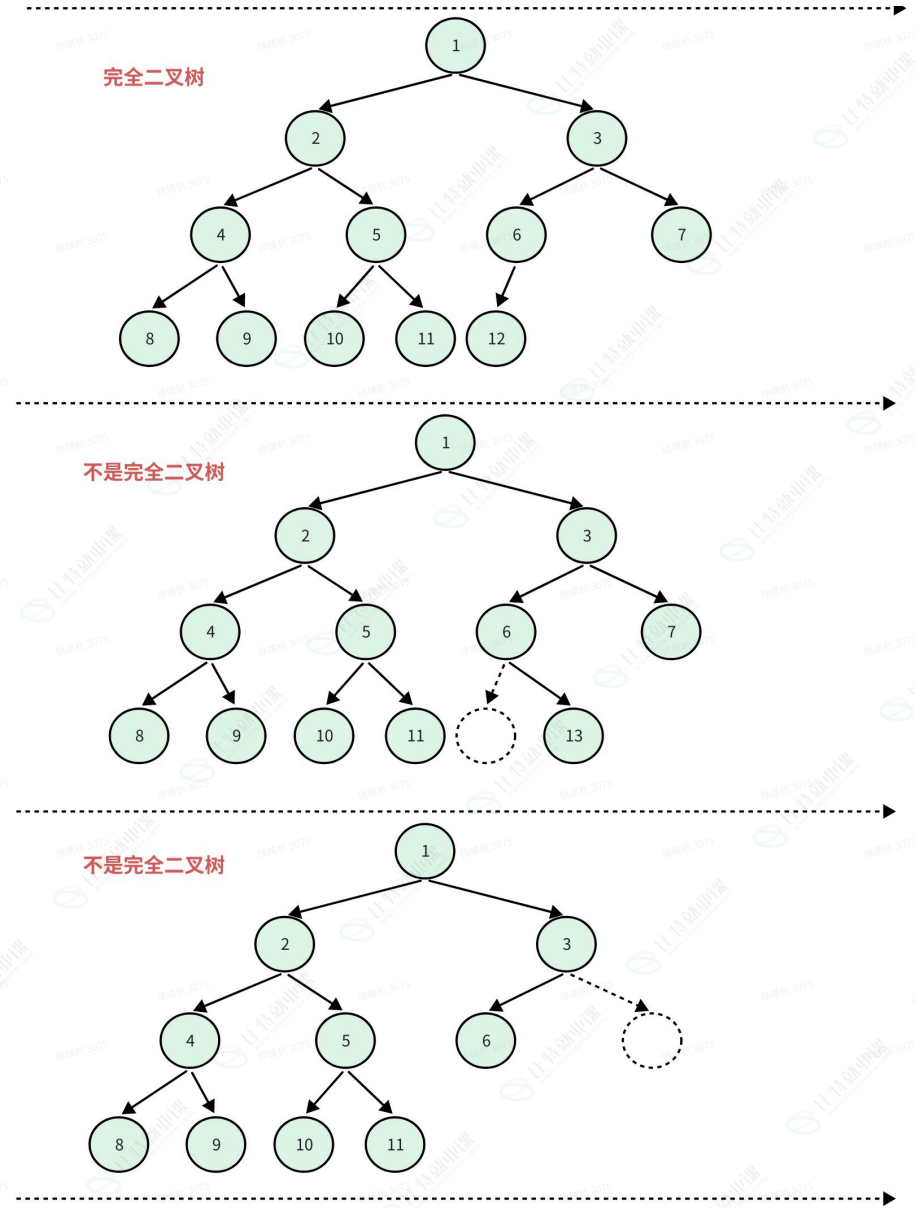
一棵高度为 h 的完全二叉树,前 h - 1 层都是结点数达到最大(满),第 h 层不一定满,但是要求从左到右结点是连续的。
满二叉树一定是完全二叉树,但完全二叉树不一定是满二叉树。
高度为 h 的完全二叉树的结点数量在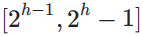 之间。
完全能二叉树的叶子一定只出现在最后两层,且度为 1 的结点最多有 1 个,剩下的结点都是度为 0 和度为 2.
2.3 搜索二叉树
二叉搜索树又称为二叉排序树(它走中序遍历是有序的),它或者是一棵空树,或者是具有以下性质的二叉树: ^ 若它的左子树不为空,则左子树上所有结点的值都小于根结点的值(实践中可变形左子树上所有结点的值都小于等于根结点的值) ^ 若它的右子树不为空,则右子树上所有结点的值都大于根结点的值(实践中可变形右子树上所有结点的值都大于等于根结点的值) ^ 它的左右子树也分别为二叉搜索树
3. 性质
性质一:在二叉树的第 i 层上之多有 2^(i-1) 个结点
性质二:高度为 h 的二叉树至多有 2^h - 1
性质三:对任何一棵二叉树 T,如果其度为0(叶子)结点树为 n0,度为 2 的结点数为的结点数为 n2,则 n0 = n2 + 1
前面树性质讲到,树中的结点树 = 所有结点的度数之和 + 1 。假设树中结点总数为 m ,度为 1 的结点数为 n1,则 m = n1 + 2n2 + 1
假设树中结点总数为 m,则 m = n0 + n1 + n2 = n1 + 2n2 + 1,化解一下可以推导出 n0 = n2 + 1
性质四:具有 n 个结点的完全二叉树的高度为 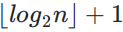
X 表示对X向下取整
完全二叉树小节我们讲到,高度为 h 的完全二叉树的结点数量在 2^(h-1) <= n <= 2^h - 1 之间
4. 二叉树存储结构
4.1 顺序存储结构
将二叉树每层的结点的元素从左到右,从上到下依次存到数组中,空结点也要存到数组中,用特殊元素进行标记,这个特殊元素是二叉树中一定不存在的元素。
可以看到完全二叉树 / 满二叉树是非常适合使用顺序结构存储,非完全二叉树使用顺序结构存储就存在一定的空间浪费。尤其是每层空结点越多浪费越多,这种结构更适合后面的链式结构存储。
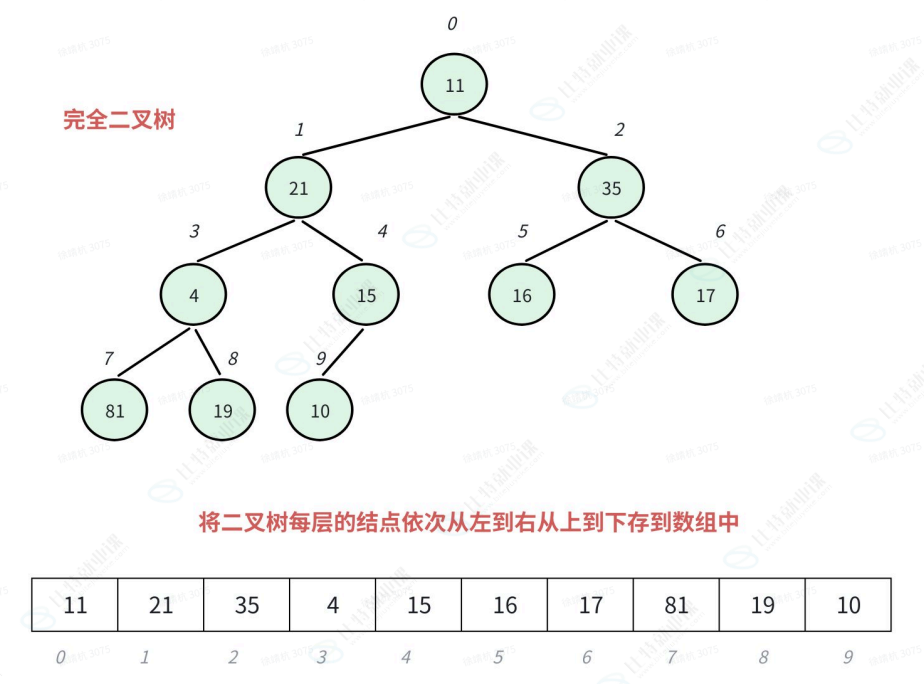
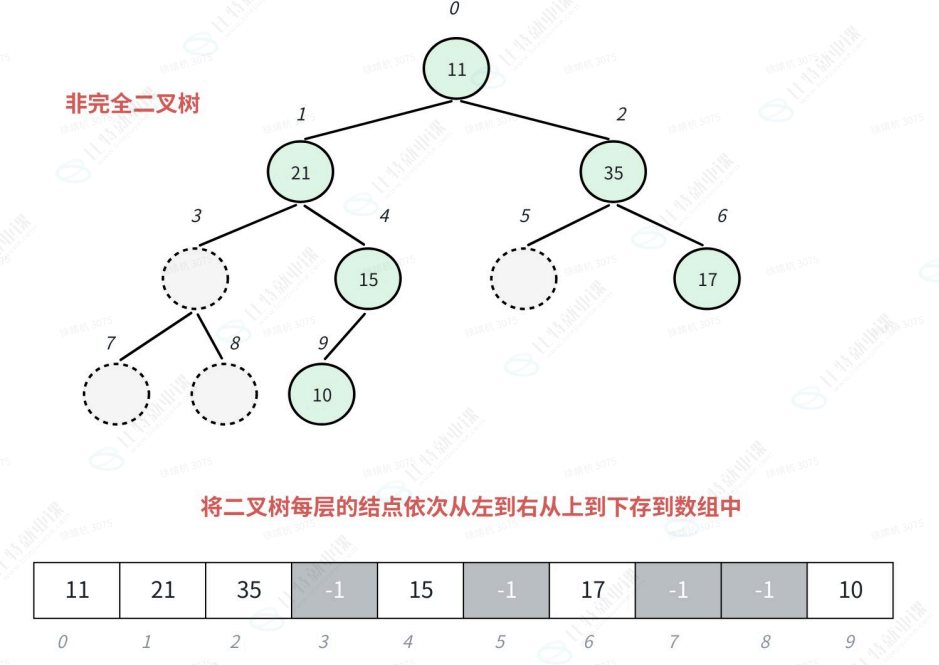
将每层的结点的元素存储到数组时一般从下标 0 位置开始存放。部分书籍中可以从 1 位置开始存放,舍弃了数组下标 0 位置。从实践的角度从下标 1 位置开始放并没什么优势,还浪费了一个空间,使用我们下面的均以从下标 0 位置开始存储数据为主。
假设 x 结点存储位置的下标为 i ,则 x 结点的双亲结点存储位置的下标为 (i-1)/2 。
假设 x 结点存储位置的下标为 i ,则 x 结点的左孩子结点存储位置的下标为 2i + 1,右孩子结点存储位置下标为 2i + 2 。
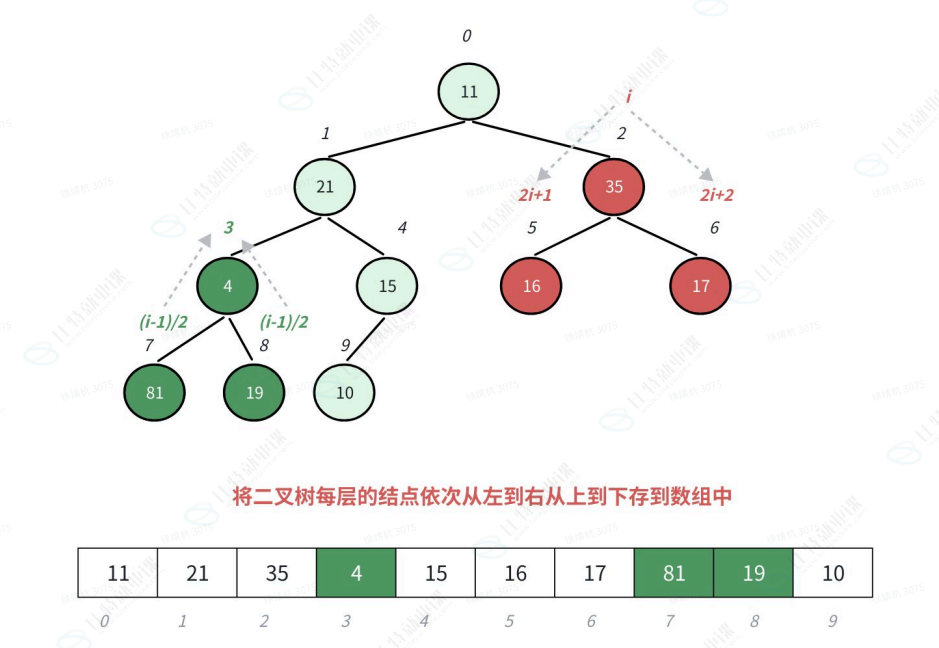
4.2 链式存储结构
完全二叉树结构非常适合顺序存储,但是实践场景更多是非完全二叉树,它们就更适合使用链式存储。链式结点中至少要存储元素,左孩子指针,右孩子指针,有些场景下还会再增加一下双亲指针(红黑树就需要双亲指针),这两种结构分别别称为二叉链和三叉链。
cpp
// 二叉链

typedef struct BinaryTreeNode
{
    struct BinaryTreeNode* left;  // 指向左孩子的指针
    struct BinaryTreeNode* right;  // 指向右孩子的指针
    BTDataType data;  // 数据元素
}BTNode;


// 三叉链
typedef struct BinaryTreeNode
{
    struct BinaryTreeNode* left;  // 指向左孩子的指针
    struct BinaryTreeNode* right;  // 指向右孩子的指针
    struct BinaryTreeNode* parent;  // 指向双亲的指针
    BTDataType data;  // 数据元素
}BTNode;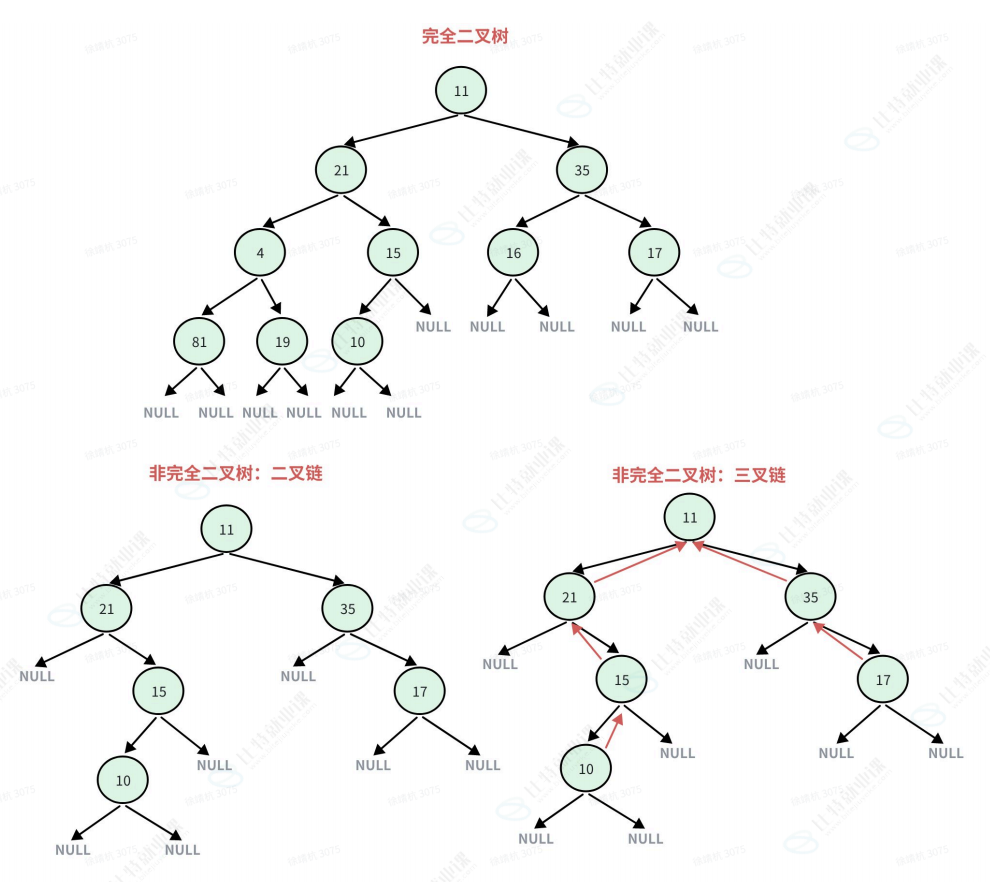
5. 二叉树顺序存储结构 ------ 堆
5.1 堆的定义
n 个元素的元素序列 { k0,k1,k2,......} 按完全二叉树的顺序存储方式存储在一个数组中,并满足:Ki <= K 2*i + 1,则称为小堆(小根堆)。
n 个元素的元素序列 { k0,k1,k2,......} 按完全二叉树的顺序存储方式存储在一个数组中,并满足:Ki >= K 2*i + 1,则称为大堆(大根堆)。
小堆的根是当前树的最小值,任意子树的根也是当前树最小的。大堆的根是当前子树的最大值,任意树的根也是当前子树最大值。
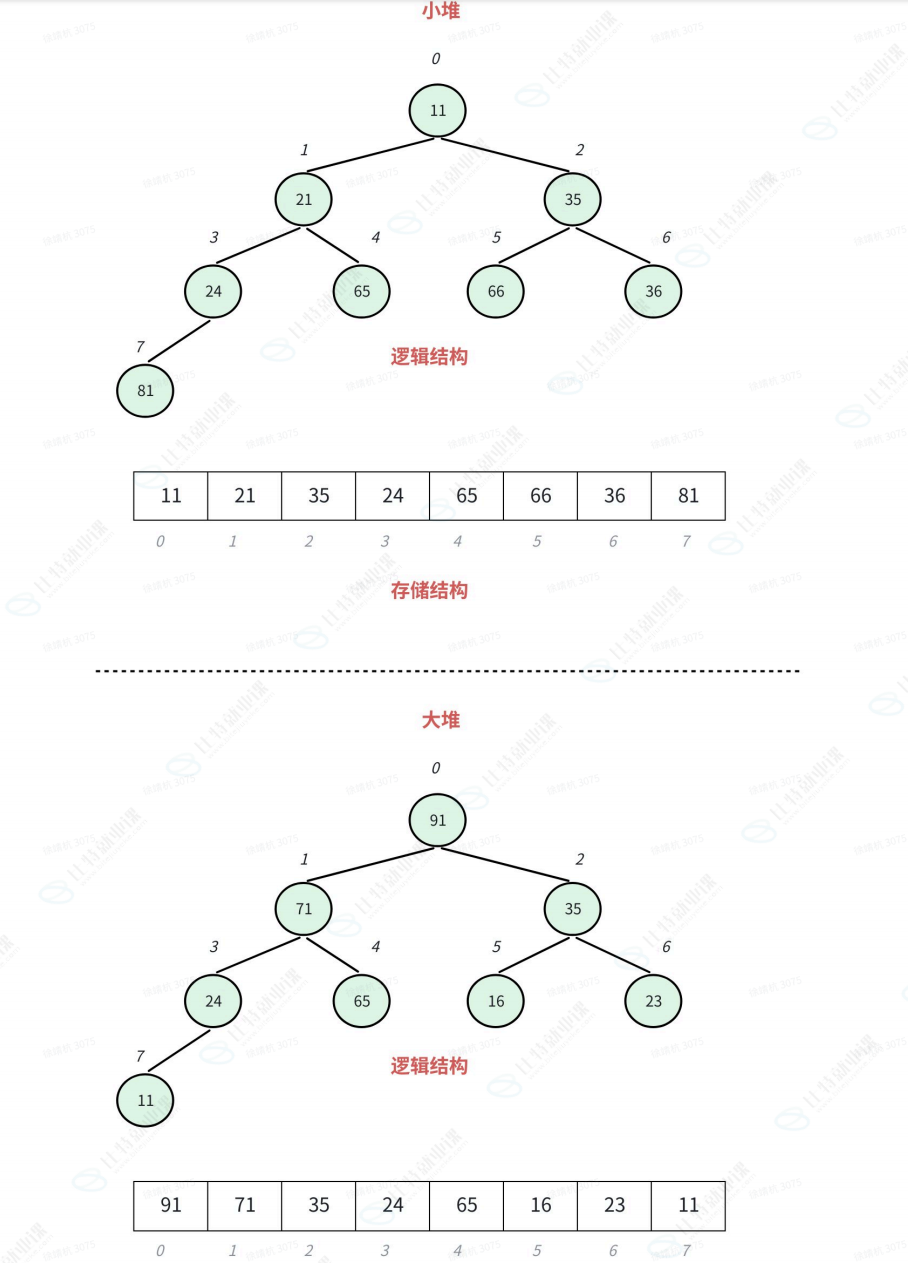
5.2 堆的基本操作
cpp
#pragma once

#include<stdio.h>
#include<stdlib.h>
#include<assert.h>
#include<string.h>
#include<stdbool.h>

typedef int HeapDataType;

typedef struct
{
	HeapDataType* a;
	int size;
	int capacity;
}Heap;

void Swap(int* x, int* y);

// 向上调整算法
void AdjustUp(HeapDataType* a, int child);

// 向下调整算法
void AdjustDown(HeapDataType* a, int n, int parent);

// 默认初始化堆
void HeapInit(Heap* hp);

// 利用给定数组初始化建堆
void HeapInitArray(Heap* hp, HeapDataType* a, int n);

// 堆的销毁
void HeapDestroy(Heap* hp);

// 堆的插入
void HeapPush(Heap* hp, HeapDataType x);

// 堆的删除,删除堆顶数据
void HeapPop(Heap* hp);

// 获取堆顶数据
HeapDataType HeapTop(Heap* hp);

// 判空
bool HeapEmpty(Heap* hp);

// 获取堆的数据个数
int HeapSize(Heap* hp);
5.3 堆的插入
堆中插入数据在存储结构上是插入在数组尾部,逻辑结构上是插入在完全二叉树最后一层一个叶子结点的旁边,保持完全二叉树结构。
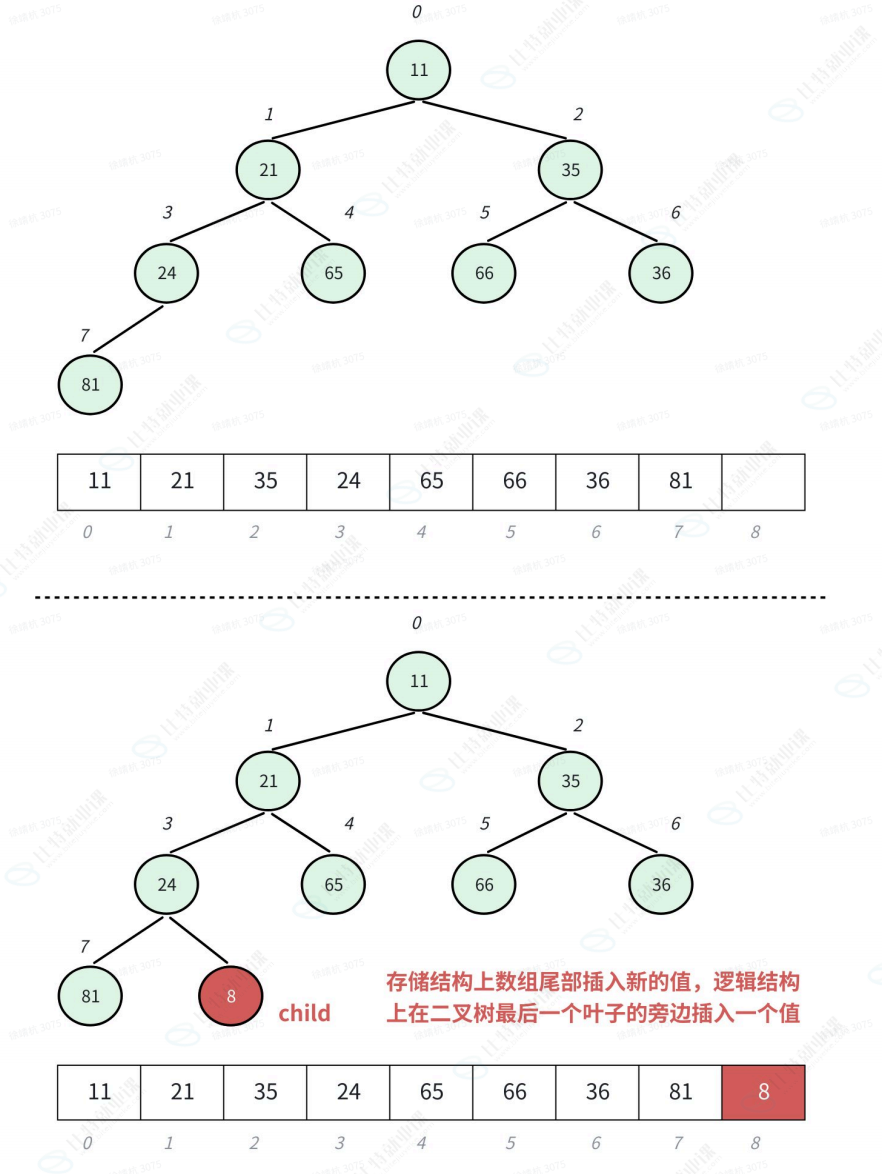
插入数据后,堆结构可能被破坏了,所以我们把使用一个向上调整算法,从插入数据这个位置开始沿着祖先路径向上调整,最坏情况下要调整到根。当然如果调整到祖先路径的中间位置就满足堆也可以停止,甚至插入后,直接就满足堆,就不需要调整。
小堆进行向上调整算法,要求调整算法之前的数据是小堆:大堆进行向上调整算法,要求调整位置之前的数据是大堆。
小堆向上调整算法及堆插入的代码实现
cpp
void Swap(int* x, int* y)
{
    assert(x != NULL && y != NULLL);
    int tmp = *x;
    *x = *y;
    *y = tmp;
}

// 向上调整算法,最坏调整高度次 0(logN)
void AdjustUp(HeapDataType* a, int child)
{
    assert(a != NULL);
    int parent = (child - 1) / 2;

    while (child > 0)
    {
        if (a[child] < a[parent])
        {
            Swap(&a[child] , &a[parent]);
            child = parent;
            parent = (child - 1) / 2;
        }
        else
        {
            break;
        }
    }
}

// 堆的插入
void HeapPush(Heap* hp, HeapDataType x)
{
    assert(hp != NULL);

    if (hp->size == hp->capacity)
    {
        int newCapacity = hp->capacity == 0 ? 4 : hp->capacity * 2;
        HeapDataType* tmp = (HeapDataType*)realloc(hp->a, sizeof(HeapDataType) * newCapacity);

        if (tmp == NULL)
        {
            printf("realloc fail\n");
            exit(-1);
        }
        hp->a = tmp;
        hp->capacity = newCapacity;
    }

    hp->a[hp->size] = x;
    hp->size++;

    AdjustUp(hp->a, hp->size - 1);
}
向上调整算法的时间复杂度 0(logn),因为堆是完全二叉树,完全二叉树的高度是
,向上调整算法最坏情况的调整次数是高度次。
5.4 堆的删除
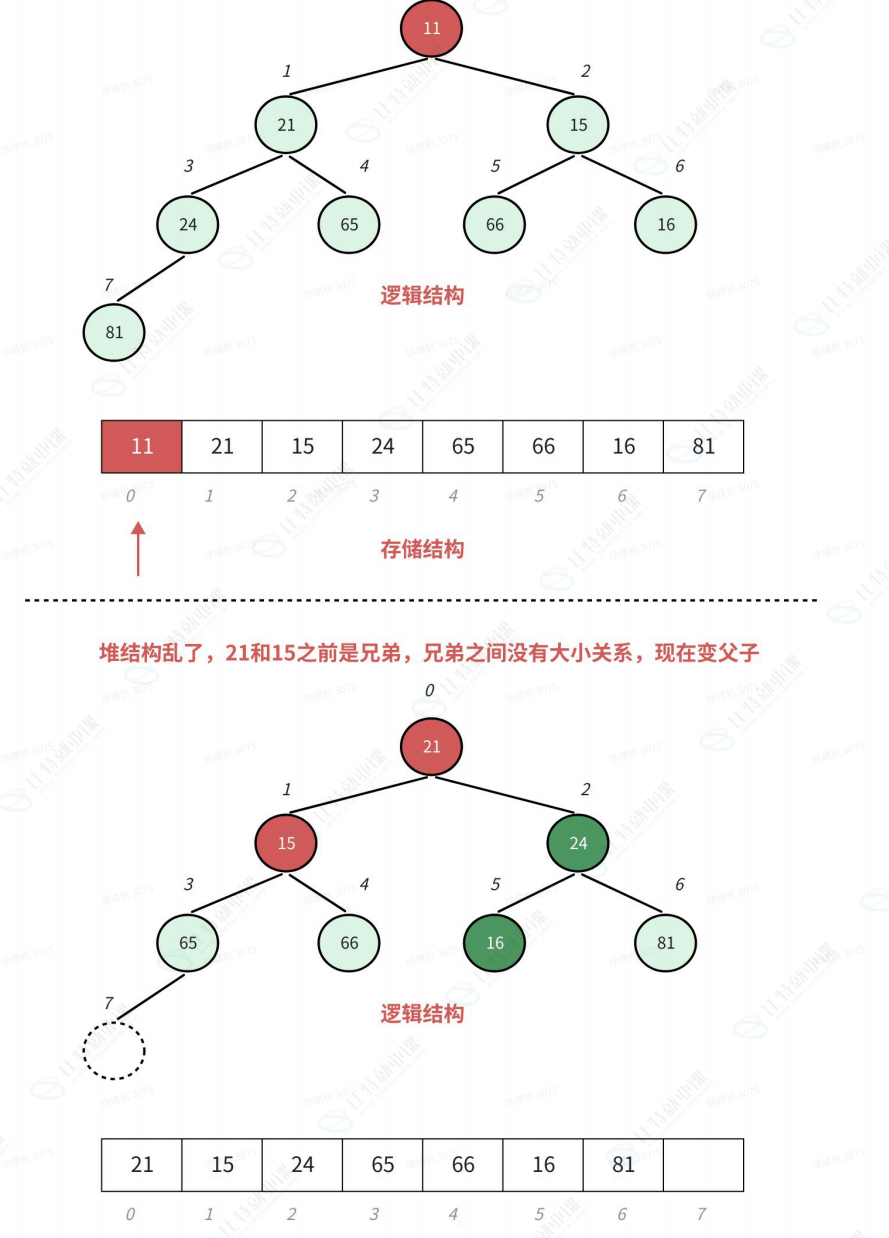
堆的删除不是删除堆尾的数据,因为那样没有什么价值。堆的删除时删除堆顶的数据,删除后使用向下调整算法,这样可以保持它继续是堆,同时把次大或次小的数据选出来放到了堆顶位置。
删除堆顶数据,并不是把后面的数据往前挪动覆盖,原因有二: a. 后面数据往前挪动覆盖效率太低,时间复杂度为 0(n) 。 b. 往前挪动覆盖,堆结构就被破坏了,要把它重新调整为堆,成本很大。
删除堆顶数据的高效方法是把堆尾的数据和堆顶的数据交换,删除堆尾数据,这样左子树和右子树结构不变,依旧保持是堆,使用向下调整算法就可以把它高效的调整为堆。
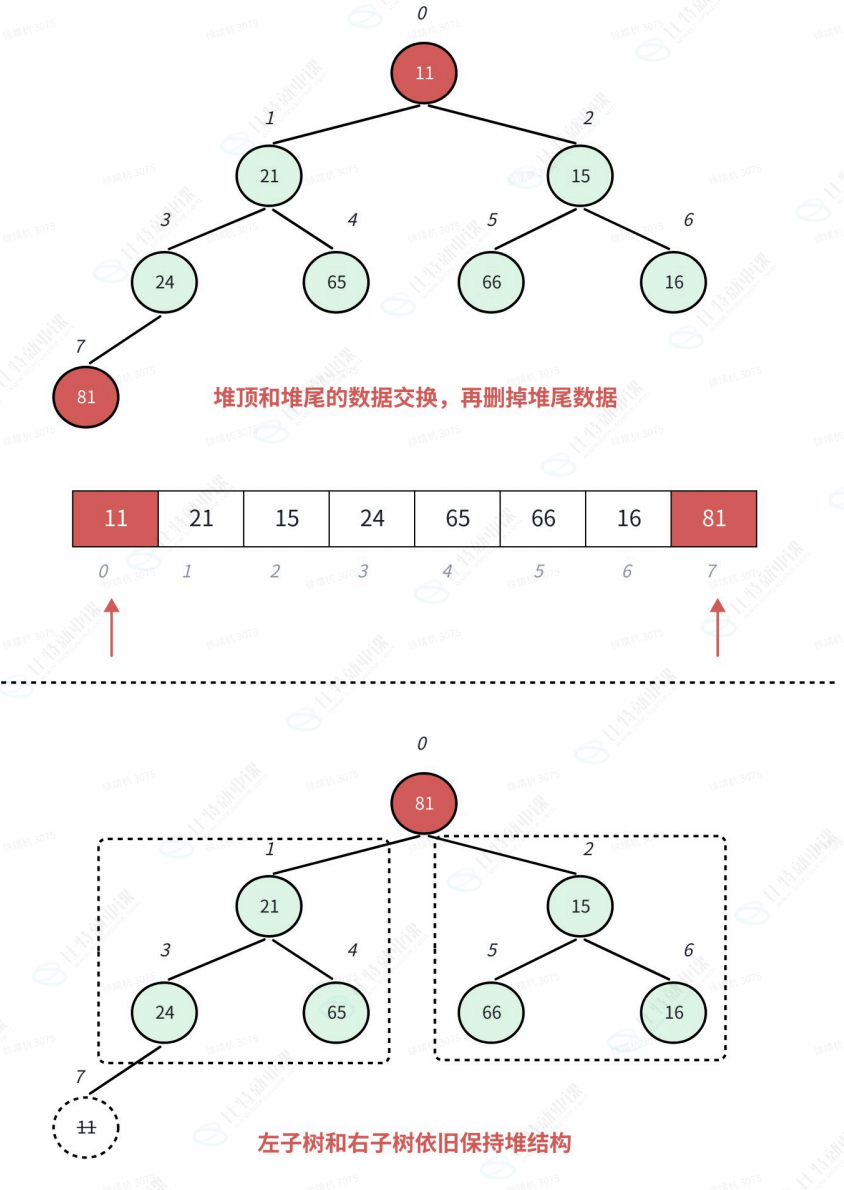
小堆向下调整算法及堆删的代码实现:
cpp
// 向下调整算法
void AdjustDown(HeapDataType* a, int n, int parent)
{
    assert(a != NULL);
    int child = parent * 2 + 1;

    while (child < n)
    {
        if (child + 1 < n && a[child + 1] < a[child])
            ++child;

        if (a[child] < a[parent])
        {
            Swap(&a[child], &a[parent]);
            parent = child;
            child = parent * 2 + 1;
        }
        else
        {
            break;
        }
    }
}

// 堆的删除,删除堆顶数据
void HeapPop(Heap* hp)
{
    assert(hp != NULL && !HeapEmpty(hp));
    Swap(&hp->a[0], &hp->a[hp->size - 1]);

    // 删除
    hp->size--;

    AdjustDown(hp->a, hp -> size, 0);
}
向下调整算法的时间复杂度 0(logn),因为堆是完全二叉树,完全二叉树的高度是
,向下调整算法最坏情况的调整次数是高度次。
5.5 建堆
建堆有两种方法:
第一种方法类似堆插入的过程,先把第0个数看做堆,然后依次把1至n-1位置的数据使用向上调整算法插入堆。
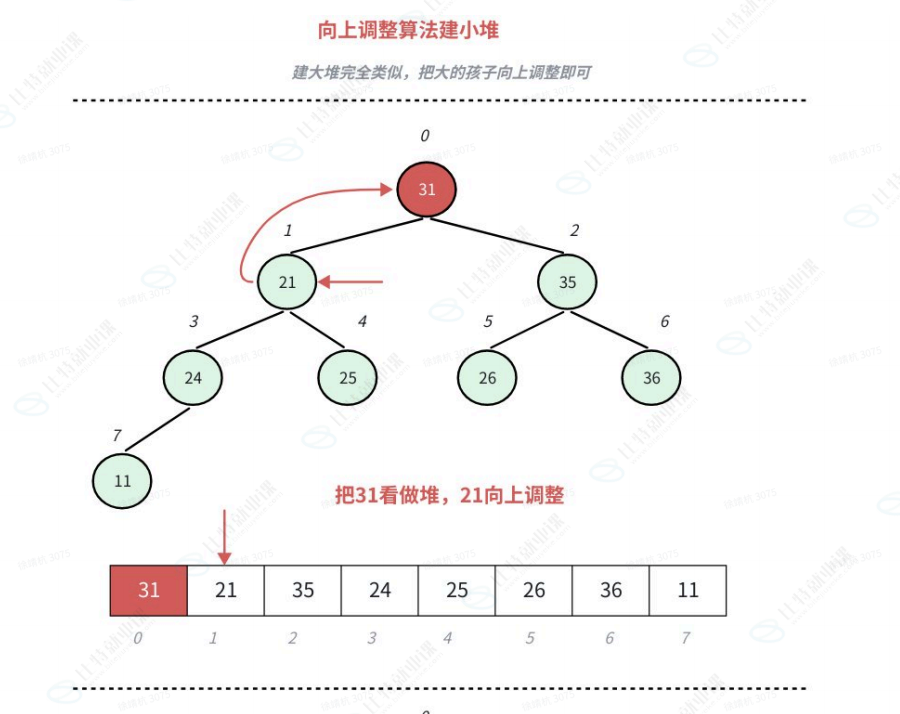
第二种方法把所有的叶子结点都看做一个个堆,从倒数第二层的最后一个非叶子结点(最后一个叶子的双亲)开始进行向下调整算法堆,直到调整到根。
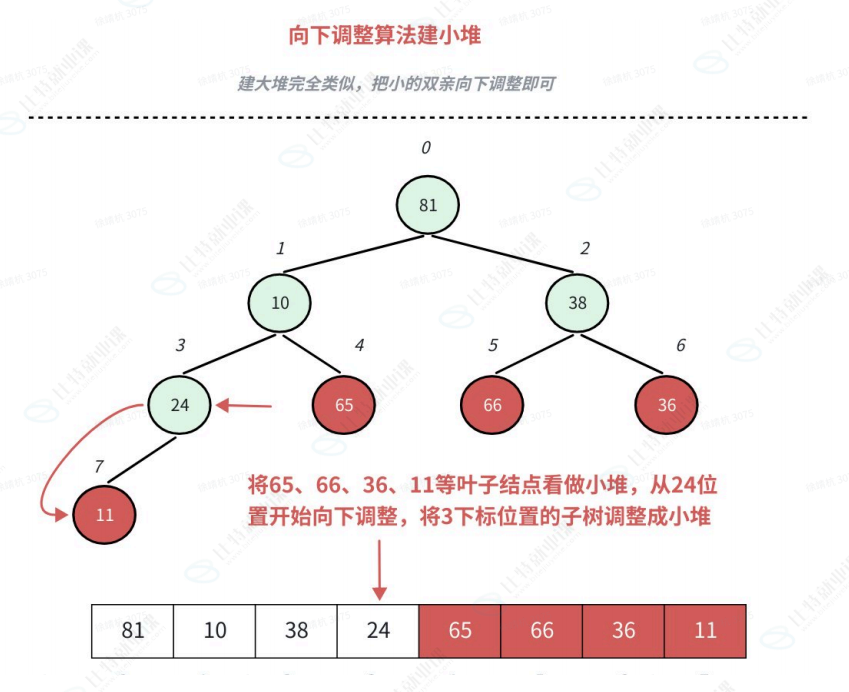
建小堆的代码实现:
cpp
void HeapInitArray(Heap* hp, HeapDataType* a, int n)
{
	assert(hp != NULL && a != NULL);
	hp->a = (HeapDataType*)malloc(sizeof(HeapDataType) * n);
	if (hp->a == NULL)
	{
		printf("malloc fail\n");
		exit(-1);
	}

	hp->size = n;
	hp->capacity = n;

	memcpy(hp->a, a, sizeof(HeapDataType) * n);

	// 向上调整建堆
	for (int i = 1; i < n; i++)
	{
		AdjustUp(hp->a, i);
	}

	// 向下调整建堆
	// i 的初始值为最后一个叶子结点的父亲,最后一个叶子结点下标为 n-1
	// 最后一个叶子结点的父亲则为 (n-1-1)/2
	int i;
	for (i = (hp->size - 1 - 1) / 2; i >= 0; --i)
	{
		AdjustDown(hp->a, n, i);
	}
}
向下调整建堆的时间复杂度 O(n),向上调整建堆的时间复杂度 O(nlogn),所以建堆应该优先选择向下调整建堆。
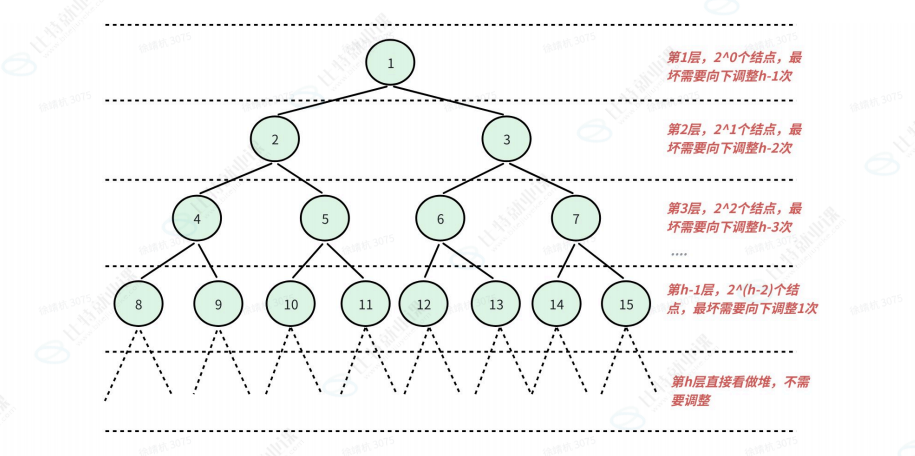
5.6 堆排序
堆排序是堆的一个重要应用场景之一,堆的本质是可以快速选出最大数或最小数,删除堆顶后可以快速算出次大或次小数据。那么我们想要排序就是不断的选出剩余数据中最大值或最小值完成排序,堆排序的思想上是一种选择排序。
堆排序如果我们借助一个堆数据结构,那就简单多了,但是这样需要先实现一个堆数据结构,太麻烦,空间效率也不高。我们其实可以直接把数组看作完全二叉树,建堆,再选数即可。
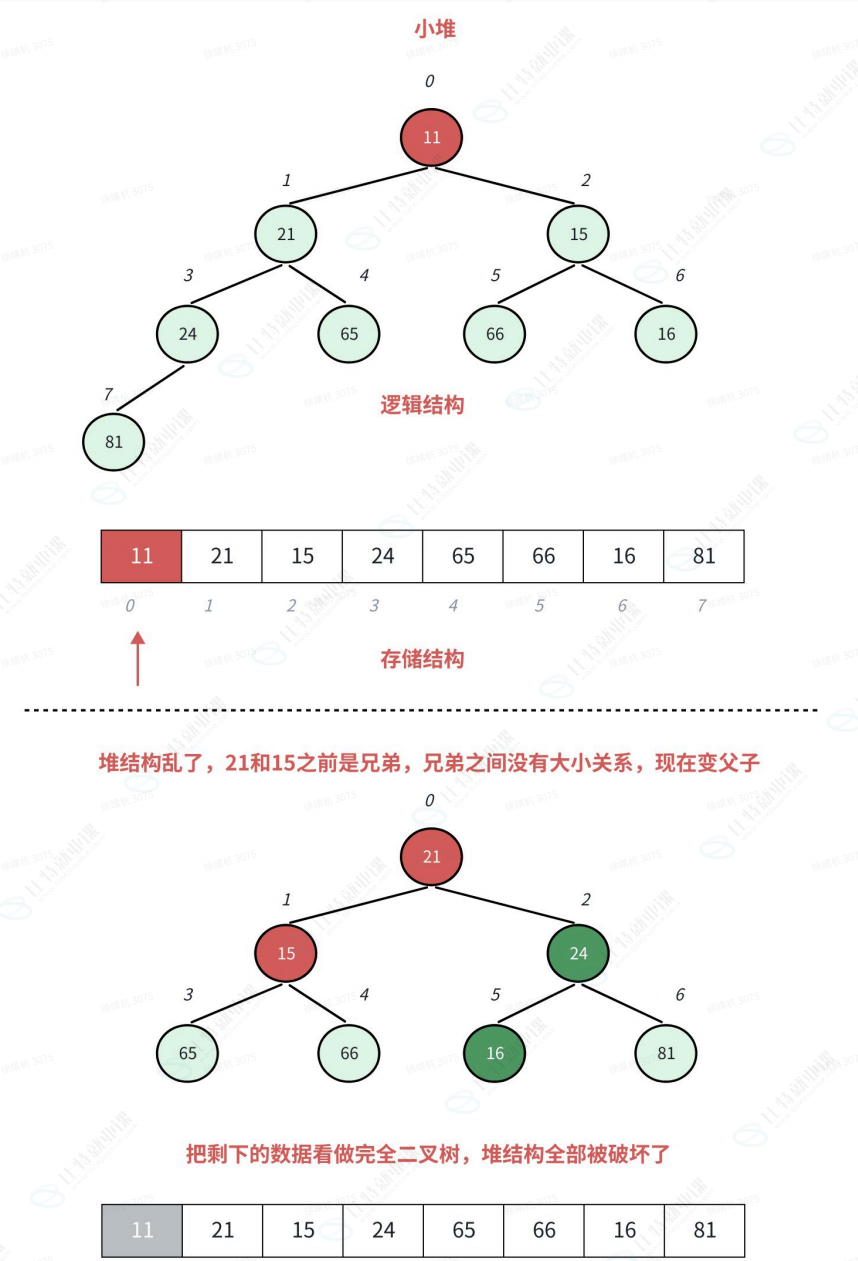
n 个数要排升序,那么注意我们不能建小堆,因为如果建小堆,会导致第 0 个数排好了,但是要选出次小的数以及后面的树,剩下的数堆结构全乱了,需要重新建堆,代价太大。
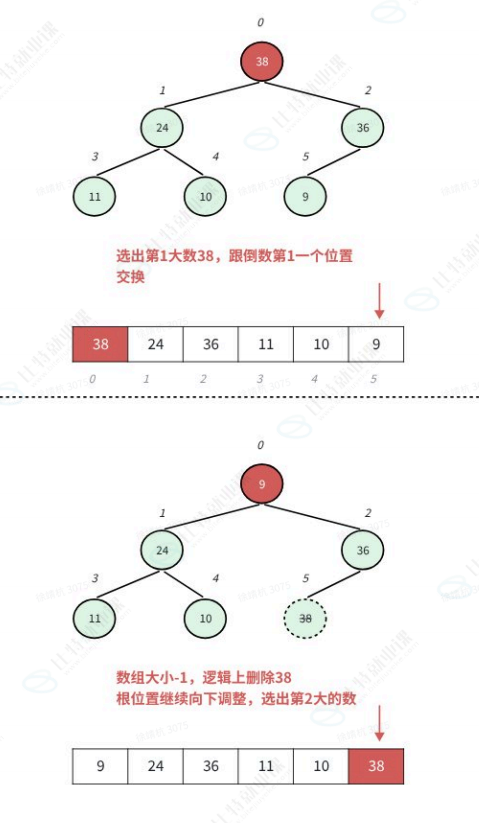
n 个数要排升序的逻辑:
a. n 个建大堆,选出最大的数
b. 然后把堆顶的数据跟堆尾数据交换,最大的数排到最后一个位置了
c. 然后控制堆数据个数为 n-1,逻辑上最后一个数不是堆里面的,然后根位置向下调整选出次大数
d. 然后把次大的数交换到倒数第二个位置,依次类推,重复 b,c,d 步骤的逻辑,直到数组有序
e. 排降序就是反过来,建小堆,选出最小数,换到最后。本质此逻辑类似堆删除的逻辑
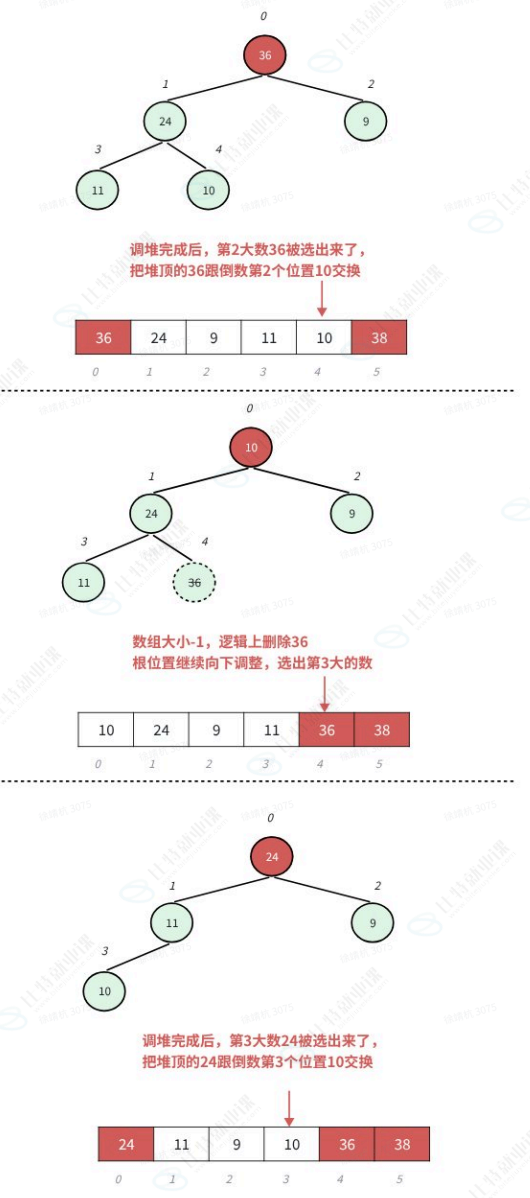
堆排序代码实现:
cpp
// O(N*logN)

void HeapSort(int* a, int n)
{
	// 建堆 O(N)
	// 升序:建大堆
	// 降序:建小堆

	for (int i = (n - 1 - 1) / 2; i >= 0; --i)
	{
		AdjustDown(a, n, i);
	}

	int j = 1;

	while (j < n)
	{
		// 选出的第 j 大/小的数据结构换到倒数第 j 个位置
		Swap(&a[0], &a[n - j]);
		AdjustDown(a, n - j, 0);
		++j;
	}
}
5.7 top-k 问题
top-k 问题指的是:从海量数据(有时甚至大到无法一次性全部装入内存)中,快速,高效地找出最大(或最小)的前 k 个元素,或出现频率最高的 K 个元素。
我们要找前 K 大的数据,主要有以下三种思路(前 K 小的反过来就行):
思路1:排降序,数组前 k 个位置就是前 k 大的。(用堆排 / 快排等最优秀的排序时间复杂度 O(nlogn)。但是如果数据量非常大,都无法一次性装入内存,则这个思路就没有办法使用了,因为排序基本都需要在内存中完成。
思路2:将整个数组建成一个大堆,取堆顶数据,再删除堆顶的数据 k-1 次,就可以取到前 k 大的。时间复杂度为 O(n + ( k -1) logn),一般情况下 k 远小于 n 是一个常数,则时间复杂度为 O(n),最坏情况下 k 接近 n 时,则时间复杂度为 O(nlogn)。但是如果数据量非常大,都无法一次性装入内存,则这个思路也没办法使用,因为堆只能建在内存中。
思路3:用数组的前 k 个数建小堆,剩下的数据 n-k 依次跟堆顶的数据比较,如果比堆顶的数据大,则替换堆顶的数据,再向下调整维护堆。结束后,堆里面剩下的数据就是前 k 大的数据,因为是小堆,所以堆顶的数据就是第 k 大的。时间复杂度为 O(k + (n -k) * logk),一般情况下 k 远小于n时,时间复杂度为 O(n):当 k=n/2 时,时间复杂度是 O(nlong);本思路是最适合解决现实中的 top-k 问题,因为数据量非常大无法导致放入内存时,他也能解决,且效率很高。
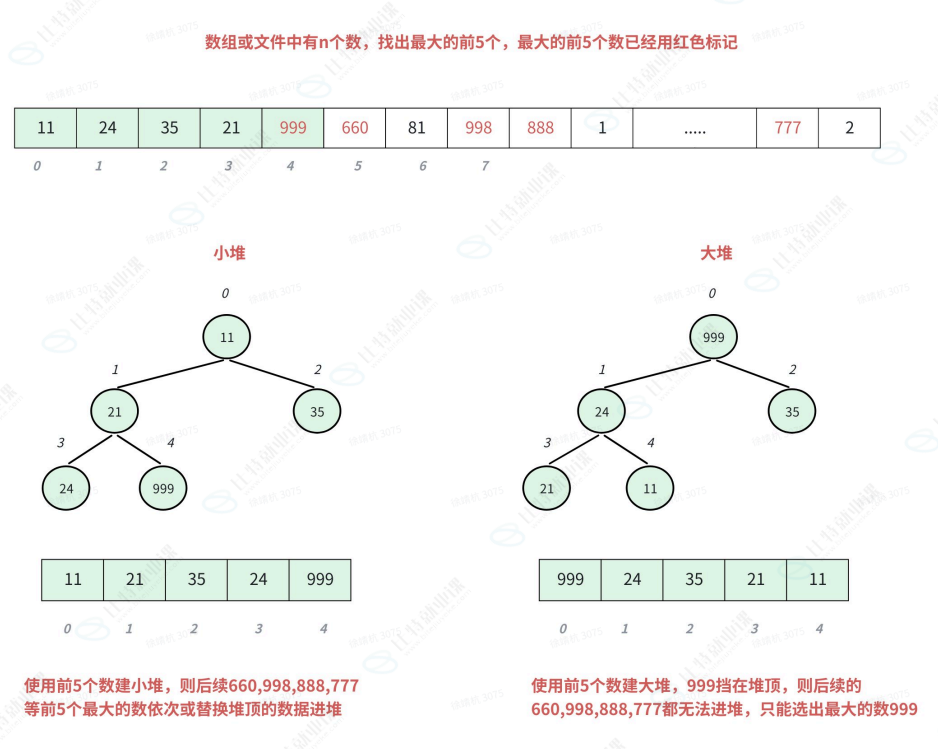
思路3代码实现:
cpp
void CreateNDate() {
    // 造数据⼀堆随机数据⽂件中,⽅便测试
    int n = 100000;
    srand(time(0));
    const char* file = "data.txt";
    FILE* fin = fopen(file, "w");
    if (fin == NULL) {
        perror("fopen error");
        return;
    }
    for (int i = 0; i < n; ++i) {
        int x = (rand() + i) % 1000000;
        fprintf(fin, "%d\n", x);
    }
    fclose(fin);
}

void topk()
{
    int k = 0;
    printf("请输入k:>");
    scanf("%d", &k);

    const char* file = "data.txt";
    FILE* fout = fopen(file, "r");
    if (fout == NULL)
    {
        // 打开文件失败
        perror("fropen error");
        return;
    }

    for (int i = 0; i < k; i++)
    {
        fscanf(fout, "%d", &minheap[i]);
    }

    // 建 k 个数据的小堆
    for (int i = (k - 1 - 1) / 2; i>=0; i--)
    {
        AdjustDown(minheap, k, i);
    }

    int x = 0;
    while (fscanf(fout, "%d", &x) != EOF)
    {
        // 依次读取文件中的剩余数据,比堆顶的值大,就替换他进堆
        if (x > minheap[0])
        {
            minheap[0] = x;
            AdjustDown(minheap, k, 0);
        }
    }

    for (int i = 0; i < k; i++)
    {
        printf("%d", minheap[i]);
    }

    free(minheap);
    fclose(fout);
}
6. 二叉树链式存储结构
6.1 二叉树前中后序遍历
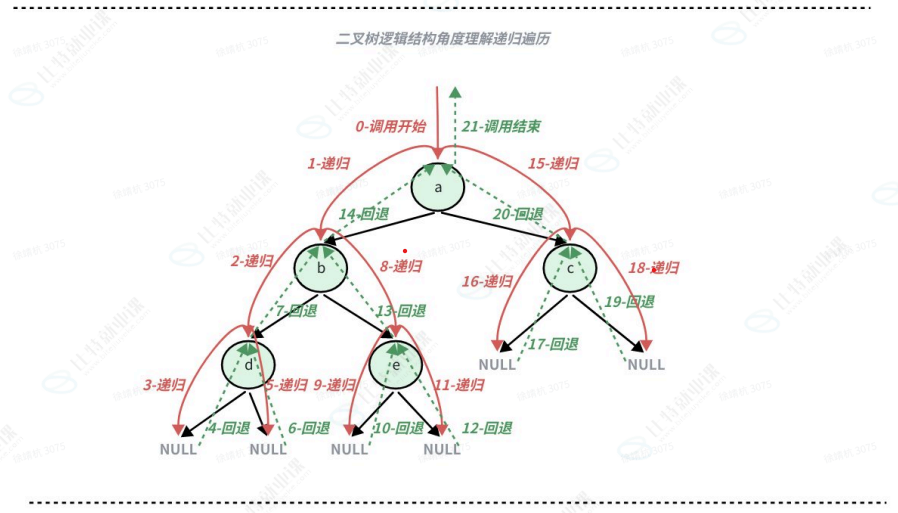
二叉树是一个递归定义的数据结构,任何一棵二叉树可以分为根和左右子树,非空的左右子树又可以分为根和左右子树......
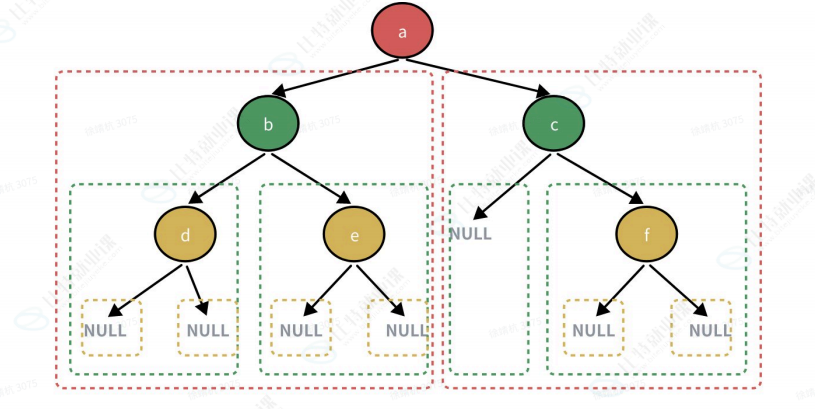
二叉树根据它的递归结构来进行遍历,则分为前序遍历,中序遍历,后序遍历:
a. 前序遍历,亦称先序遍历 / 先根遍历,访问顺序为:根结点,左子树,右子树。 b. 中序遍历,亦称中根遍历,访问顺序为:左子树,根节点,右子树。 c. 后序遍历,亦称后根遍历,访问顺序为:左子树,右子树,根节点。
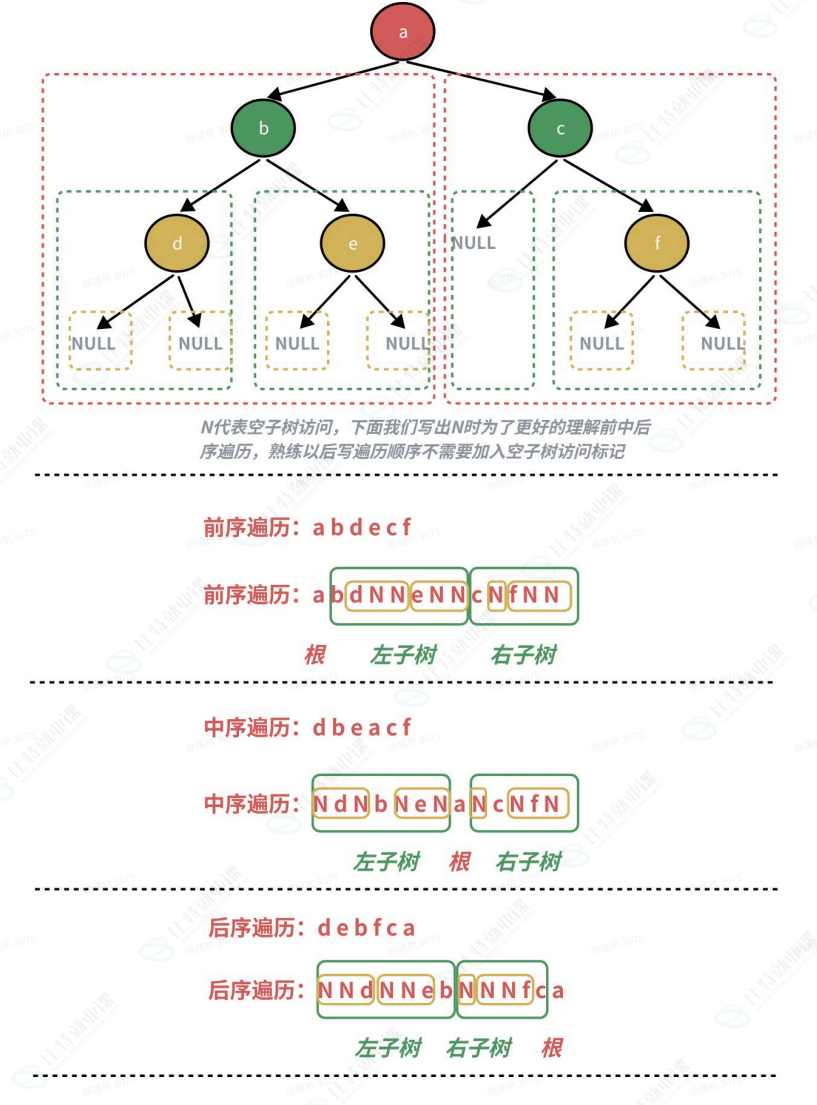
前中后序遍历代码实现:
cpp
void Preorder(BTNode* root)
{
    if (root == NULL)
    {
        printf("N ");
        return;
    }

    // 根
    printf("%c", root->data);

    // 递归遍历左子树
    Preorder(root->left);

    // 递归遍历右子树
    Preorder("%c", root->right);
}
cpp
void Inorder(BTNode* root)
{
    if (root == NULL)
    {
        printf("N ");
        return;
    }

    // 递归遍历左子树
    Inorder(root->left);

    // 根
    printf("%c", root->data);


    // 递归遍历右子树
    Inorder(root->right);
}
cpp
void Postorder(BTNode* root)
{
    if (root == NULL)
    {
        printf("N ");
        return;
    }

    // 递归遍历左子树
    Postorder(root->left);

    //递归遍历右子树
    Postorder(root->right);

    // 根
    printf("%c", root->data);
}
7. 二叉树层序遍历
层次遍历是按照二叉树的层次从上到下,从左到右对二叉树各个结点进行访问。如下图所示,该二叉树层次遍历的顺序为:ABCDEFGHI
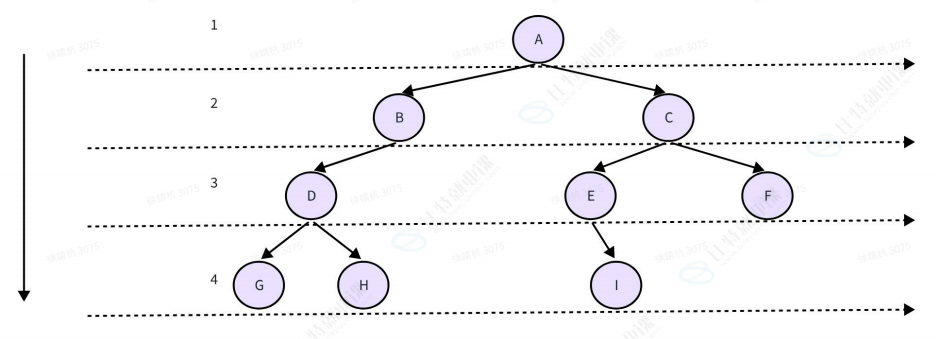
深度优先遍历:一条路走到黑,再回头。你选择一条分支,尽可能深地走下去,直到尽头,然后再回溯到上一个岔路口,尝试另一条没走过的路。DFS一般用递归或者用栈辅助实现,二叉树的前序 / 后序 / 中序本质就是一种深度优先遍历。
广度优先遍历:层层推进,由近及远。你从起点开始,先探索所有直接相连的地方,然后再探索这些地方的下一个邻居,像水波纹一样扩散开。BFS一般用队列辅助实现,二叉树的层序遍历本质就是一种广度优先遍历。
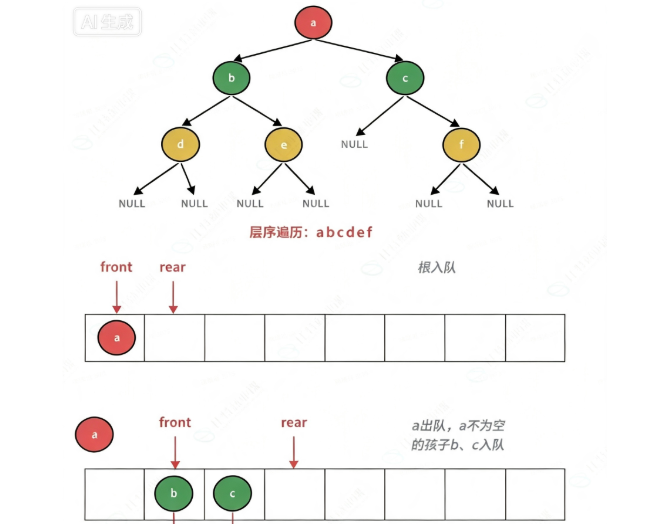
层序遍历的思路: 层序遍历,我们需要借助一个队列来实现,大思路是当前层结点依次入队列,当前层结点出队列时,带下一层结点入队列。 a. 将二叉树根结点入队列 b. 队列不为空,出队头结点 frontNode,并将 frontNode 的下一层(不为空的孩子)入队列 c. 循环重复 b,直至队列为空,则遍历结束。
8. oj
^ 1 二叉树的最大深度
二叉树求高度/深度的递归思想:
空树高度=0
非空树高度 = max(左子树高度,右子树高度)+1
代码实现:
cpp
int maxDepth(struct TreeNode* root)
{
    if(root==NULL)
    return 0;

    return fmax(maxDepth(root->left),maxDepth(root->right))+1;
}
^ 2 根据二叉树创建字符串
606. 根据二叉树创建字符串 - 力扣(LeetCode)
本题的思路相对简单,本质就是前序遍历二叉树,将二叉树结点中的值转换为字符串,追加到字符串数组中,最后生成一个前序的字符数组。还需要注意的是左右子树分别用()括起来。要注意看实例中的说明,省略不必要的括号:
a. 左右为空,要省略括号
b. 右为空,要省略右边的括号
c. 左为空,右不为空,不能省略左边的括号
代码实现:
cpp
char arr[100000];
int i=0;
void _tree2str(struct TreeNode* root)
{
    if(root==NULL)
    return ;

    // 将结点中的值转换为字符串并加入到数组
    char buff[5];
    sprintf(buff,"%d",root->val);
    strcpy(arr+i,buff);
    i+=strlen(buff);

    // 左边和右边有一个为空,左边必须有括号
    if(root->left || root->right)
    {
        arr[i++]='(';
        _tree2str(root->left);
        arr[i++]=')';
    }

    // 右不为空时,右边必须有括号,右边为空时括号总是省略
    if(root->right)
    {
        arr[i++]='(';
        _tree2str(root->right);
        arr[i++]=')';
    }
}

char* tree2str(struct TreeNode* root)
{
    i=0;
    _tree2str(root);
    arr[i]='\0';
    return arr;
}
^ 3 验证二叉搜索树
解题思路:首先要 get 到二叉搜索树的特点,二叉搜索树也叫二叉排序树,也就意味着中序遍历二叉搜索树,结点出现的顺序是有序的,我们只需要跟上一个结点的值比较,如果上一个结点的值 >= 当前结点的值,则说明不是搜索二叉树。
本题要写出递归并不难,真正的难点在于理解递归中返回结果的处理。很多初学者会认为判断不满足搜索树条件了返回 false,程序就结束,结果就返回到调用的最外层了。岂不知递归函数跟普通函数不同,远不是这样简单的,一个递归子函数返回 false,是返给上一层递归调用,所有我们一定要处理好左右子树递归调用的返回值判断
代码实现:
cpp
// 中序的前一个结点
struct TreeNode* prev=NULL;

bool _isValidBST(struct TreeNode* root)
{
    if(root==NULL)
    {
        return true;
    }

    // 递归判断左子树
    if(!_isValidBST(root->left))
    return false;

    // 前一个结点的值 >= 当前结点的值,则不满足搜索树要求
    if(prev && prev->val >= root->val)
    return false;

    // 判断完当前结点后,当前结点的值对于下次中序出现的结点就是中序上一个结点
    prev=root;

    // 递归判断右子树
    if(!_isValidBST(root->right))
    return false;

    return true;


}

bool isValidBST(struct TreeNode* root)
{
    prev=NULL;

   return  _isValidBST(root);
}
^ 4 相同的树
解题思路:本题目跟前面的分治子问题和返回值合并的类似问题,我们检查两颗树是否相同,可以先检查根结点,再用递归子问题分别检查左子树是否相同,跟上一个题类似要注意一下要处理的是子树的检查结果。
代码实现:
cpp
bool isSameTree(struct TreeNode* p, struct TreeNode* q)
{
    if(p==NULL && q==NULL)
    return true;

    if(p==NULL || q==NULL)
    return false;

    if(p->val!=q->val)
    return false;

    return isSameTree(p->left,q->left)
            && isSameTree(p->right,q->right);
}
^ 5 从前序与中序遍历序列构造二叉树
105. 从前序与中序遍历序列构造二叉树 - 力扣(LeetCode)
解题思路:无重复元素的前序序列和中序序列可以确定一棵唯一的二叉树,前序序列为 根->左子树 ->右子树,中序序列为 根->左子树->根->右子树。第一个核心点在前序序列第一个值x可以确定为当前树的根,再找到x在中序序列的位置,可以确定把中序序列分割为 左子树中序序列 x 右子树中序序列。利用x构造好根结点以后,就可以使用前序序列后面的值和左右子树的中序序列区间分别递归构造左右子树。
cpp
struct TreeNode* _buildTree(int* preorder,int* inorder,int* prei,int inbegin,int inend)

{

    // 中序区间不存在,则是空结点

    if(inbegin > inend)

    {

        return NULL;

    }


    // 前序确定根

    struct TreeNode* root=(struct TreeNode*)malloc(sizeof(struct TreeNode));

    root->val=preorder[(*prei)++];


    // 确定根在中序区间的位置分割出左右子树的中序区间

    int rooti=inbegin;

    while(rooti<=inend)

    {

        if(inorder[rooti]==root->val)

        break;

        else

        rooti++;

    }


    // 递归左右子区间,递归构建左右子树

    // [inbegin,rooti-1] rooti [rooti+1,inend]

    root->left=_buildTree(preorder,inorder,prei,inbegin,rooti-1);

    root->right=_buildTree(preorder,inorder,prei,rooti+1,inend);


    return root;

}


struct TreeNode* buildTree(int* preorder, int preorderSize, int* inorder, int inorderSize)

{

   int i=0;

   struct TreeNode* root=_buildTree(preorder,inorder,&i,0,inorderSize-1);


   return root;
}
^ 6 另一棵树的子树
解题思路:本题目为前一个相同的树问题再加码变形,若a树跟b树的某个结点为根的子树是相同的树,则我们遍历b树的每个结点就拿到了b树的每棵子树的根,再调用前面相同的树 isSameTree 的函数去判断即可,若a树和b树某个结点为根的子树相同,则a树是b树的子树。
cpp
bool isSameTree(struct TreeNode* p,struct TreeNode* q)
{
    // 都为空
    if(p==NULL && q==NULL)
    return true;

    // 其中一个为空
    if(p==NULL || q==NULL)
    return false;

    if(p->val!=q->val)
    return false;

    return isSameTree(p->left,q->left) && isSameTree(p->right,q->right);
}

bool isSubtree(struct TreeNode* root, struct TreeNode* subRoot)
{
    if(root==NULL)
    return false;

    if(root->val==subRoot->val && isSameTree(root,subRoot))
    return true;

    return isSubtree(root->left,subRoot) || isSubtree(root->right,subRoot);
}
^ 7 二叉树的构建及遍历
解题思路:二叉树的前序序列是无法确定一棵二叉树的,但是题目中的前序序列中用 # 表示空树,那么我们直接走一个前序遍历过程构造二叉树即可,相当于前序遍历生成签前序序列字符串的逆向过程,现在我们用前序序列字符串反向构建二叉树。
cpp
#include<stdio.h>

typedef struct BinTreeNode
{
    struct BinTreeNode* left;
    struct BinTreeNode* right;
    char val;
}BTNode;

// 前序遍历构造二叉树
BTNode* CreateTree(char* a,int* pi)
{
    if(a[*pi]=='#')
    {
        (*pi)++;
        return NULL;
    }

    // 构建根结点
    BTNode* root=(BTNode*)malloc(sizeof(BTNode));
    root->val=a[(*pi)++];
    // 递归构建左子树
    root->left=CreateTree(a,pi);
    // 递归构建右子树
    root->right=CreateTree(a,pi);

    return root;
}

// 中序遍历
void InOrder(BTNode* root)
{
    if(root==NULL)
    return ;

    InOrder(root->left);
    printf("%c ",root->val);
    InOrder(root->right);
}

int main()
{
    char a[100];
    scanf("%s",a);
    int i=0;
    BTNode* root=CreateTree(a,&i);
    InOrder(root);

    return 0;
}