简介

注意:
在部署spark集群前,请部署好Hadoop集群,jdk8【当然Hadoop集群需要运行在jdk上】,需要注意hadoop,spark的版本,考虑兼容问题。比如hadoop3.0以上的才兼容spark3.0以上的。
下面是Hadoop集群部署的链接,个人笔记,已经成功部署两次了,实时更新,分【一】【二】两部分,需要的自己看。不懂欢迎问,看到了解答。(链接失效的话请参考个人主页)
hadoop集群部署【一】HDFS集群 http://t.csdnimg.cn/BVKlqhadoop集群部署【二】YARN,MapReduce集群http://t.csdnimg.cn/aJJt7
搭建准备工作:
需要python环境,上传Anaconda,找到放置的位置。
安装Anaconda
在node1(我的第一台机器名)安装Anaconda(我的是Anaconda3-2021.05-Linux-x86_64.sh 版本python3.8)
sh ./Anaconda3-2021.05-Linux-x86_64.sh然后一直空格,出现yes\|no 就回答yes,懂?

出现这样的就填你要把anaconda安装到哪里。(路径)


完成后结果(退出终端,重新进来)

更改conda国内源
vim ~/.condarc(新建的,一般里面没东西)
channels:
  - defaults
show_channel_urls: true
default_channels:
  - https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main
  - https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/r
  - https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/msys2
custom_channels:
  conda-forge: https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud
  msys2: https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud
  bioconda: https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud
  menpo: https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud
  pytorch: https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud
  simpleitk: https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud
终端输入
python
创建spark运行的虚拟环境
conda create -n pyspark python=3.8切换虚拟环境
conda activate pyspark
Spark Local部署
上传解压spark
(我的是 spark-3.2.0-bin-hadoop3.2.tgz)
通过什么工具不管,能上传就行。
找到spark上传的位置,cd 进到该目录,不进去也行,自己在前面加路径哈!解压。
tar -zxvf spark-3.2.0-bin-hadoop3.2.tgz -C /export/server spark-3.2.0-bin-hadoop3.2/-C 参数后跟解压到哪(路径)
cd /export/server #填你自己解压的路径建立软链接
 ln -s spark-3.2.0-bin-hadoop3.2/ spark

ll
配置环境变量
vim /etc/profile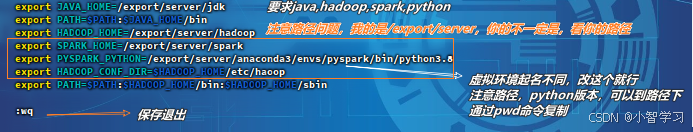
export SPARK_HOME=/export/server/spark
export PYSPARK_PYTHON=/export/server/anaconda3/envs/pyspark/bin/python3.8
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
python
:wq
python
source /etc/profilevim /root/.bashrc添加
export JAVA_HOME=/export/server/jdk
export PYSPARK_PYTHON=/export/server/anaconda3/envs/pyspark/bin/python3.8

:wq
启动spark local模式
pyspark
进入spark的bin路径下
cd /export/server/spark/bin  # 注意路径

./pyspark
运行下面代码,结果参考上图
python
sc.parallelize([1,2,3,4,5]).map(lambda x:x *10).collect()可以通过游览器输入node1:4040查看监控页面(多个进程不会起冲突,具体监控页面的端口看上图spark版本下面第二行)
Ctrl+d退出
scala交互式界面
python
./spark-shellCtrl+d退出
提交python文件(参考spark自带的案例文件pi.py 求圆周率,参数10 迭代十次)
python
./spark-submit --master local[*] /export/server/spark/examples/src/main/python/pi.py 10
提交文件没有监控界面