注:节选自我于24年初所写的「融合RL与LLM思想探寻世界模型以迈向AGI」散文式风格文章,感兴趣的小伙伴儿可以访问我的主页置顶或专栏收录,并制作了电子书供大家参考,有需要的小伙伴可以关注私信我,因为属于技术散文风格,阅读起来不会像论文文献那样过于晦涩。
【节选内容】↓
"...想先为大家做一下这方面的思想试验,有的时候我在想很多RL中所运用的那些看似巧妙而又让人略感毛燥的算法,不论在空间的探索与利用阶段,还是在奖励反馈阶段,如AlphaGO在围棋中的复杂决策,是否能够合理且完备的完成探索、反馈、学习中在近乎无限的大量数据中习得泛化经验吗?当然如果数据确实是无限大的,那么对于pre-training来说其代价是否太高了?而对于alignment来说,则会面临数据alignment本身的诸多挑战,如:
如何找到完备且充分的与alignment相匹配的样本数据分布?
alignment过程中的数据多样性的保障?
在复杂的策略空间探索中,其泛化能力集合的分布是怎样的?
...
对于当下llm合成数据的方式看起来能够基于一定预先规划的策略解决上述部分问题,然而合成数据是否能在生成数据的过程中涌现出新的洞察或知识,即实现基于策略合成上的自主空间探索,且是完备的吗?怎么理解和衡量这种完备性等问题,我想未来都待进一步进行这方面的理论探索以系统性解决,不然我想众多AIer们还将在这里step by step持续的探索,当然这也也是一种美妙和享受的过程:)另外,对大量历史真实世界数据的采样,是否仅仅是学习人类过去已经先验并总结过知识并形成的最终文本表征的结论,其对应的本质等价于这些知识或结论最终仍是来自于真实世界数据的的分布或构象上的表征,而这种历史数据的分布或构象似乎无法通过模型的自回归生成式模式习得到人类在现实世界中未曾见到、更深刻的洞见以及新的知识结构,似乎仅仅是对生成的语言分布概率做了重新排列或组合,并在这种重排列或组合的过程中反复利用已经掌握的泛化能力进行表象知识的发现、探索和链接,从而扩展了某种维度的知识结构。
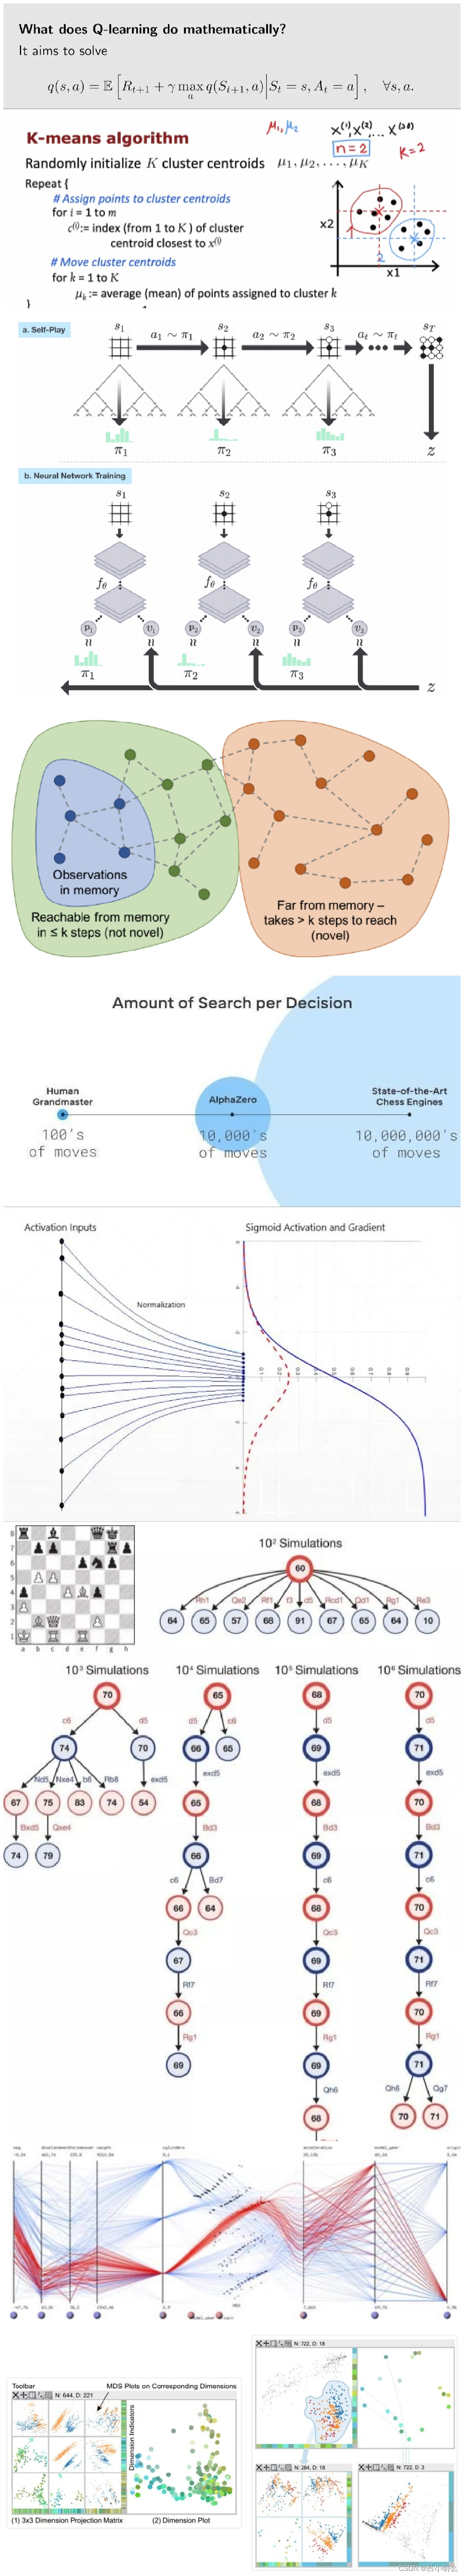
因此,这里我们是否也会回归到对历史经验的pre-training到当下过程中的exploration再到alignment的一些本质问题的思考?是否在他们之间底层对数据的理解与操作上有着不同的角度或内在联系?