1、kafka是如何做到高效读写
1)Kafka 本身是分布式集群 ,可以采用分区 技术,并行度高
2)读数据采用稀疏索引,可以快速定位要消费的数据。(mysql中索引多了之后,写入速度就慢了)
3)顺序写 磁盘
Kafka 的 producer 生产数据,要写入到 log 文件中,写的过程是一直追加到文件末端, 为顺序写。官网有数据表明,同样的磁盘,顺序写能到 600M/s,而随机写只有 100K/s。这与磁盘的机械机构有关,顺序写之所以快,是因为其省去了大量磁头寻址的时间。
4)页缓存 (PageCache) + 零拷贝技术

参考上图,kafka重度依赖底层的PageCache,当有写操作发生时,会先写到页缓存中,页缓存中的数据存储在内存上,当有读操作发生时,会先从页缓存中读取数据,如果找不到的话会再从磁盘(图中的File)中读取
在流程图中,黑色箭头代表写入流程,橙色箭头代表读取流程
写入
生产者将数据发送给kafka,kafka将数据交给linux内核,linux内核将数据放入自身操作系统的页缓存中,到一定值后写入磁盘
读取
消费者消费时,如果是非零拷贝,直接从页缓存中通过网卡发给消费者,没有去kafka的业务数据中获取数据,所以速度比较快
2、Kafka集群中数据的存储是按照什么方式存储的?
topic数据的存储机制

topic是一种逻辑概念,partition是一种物理概念,每个partition对应一个log文件,存储的是producer生产的数据, producer产生的数据会不断追加到文件末端,为了防止文件过大,kafka采用了分片和索引机制,将每个partition分成了多个segment,segment下有日志文件、索引文件、和时间戳索引文件等,这些文件采用了稀疏索引(运行速度快)


3、kafka中是如何快速定位到一个offset的

首先根据目标找到对应的segment文件,找到小于等于目标offset的最大offset对应的索引项,定位到log文件,向下遍历找到目标record
4、简述kafka中的数据清理策略
Kafka 中默认的日志(这个地方是数据的意思,就是Segment)保存时间为 7 天,可以通过调整如下参数修改保存时间
log.retention.hours,最低优先级小时,默认 7 天。
log.retention.minutes,分钟。 --如果设置了该值,小时的设置不起作用。
log.retention.ms,最高优先级毫秒。 --如果设置了该值,分钟的设置不起作用。
log.retention.check.interval.ms,负责设置检查周期,默认 5 分钟。
那么日志一旦超过了设置的时间,怎么处理呢?
Kafka 中提供的日志清理策略有 delete 和 compact 两种。
1)delete 日志删除:将过期数据删除
log.cleanup.policy = delete 所有数据启用删除策略
(1)基于时间:默认打开。以 segment 中所有记录中的最大时间戳作为该文件时间戳。
(2)基于大小:默认关闭。超过设置的所有日志总大小,删除最早的 segment。
log.retention.bytes,默认等于-1,表示无穷大。
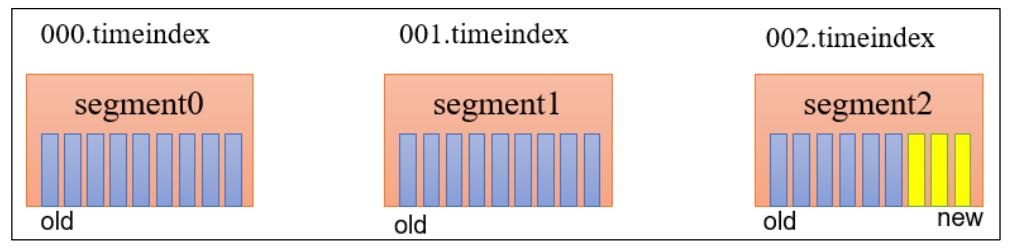
**思考:**如果一个 segment 中有一部分数据过期,一部分没有过期,怎么处理?
2)compact 日志压缩(合并的意思,不是真的压缩)
compact日志压缩:对于相同key的不同value值,只保留最后一个版本。
log.cleanup.policy = compact 所有数据启用压缩策略
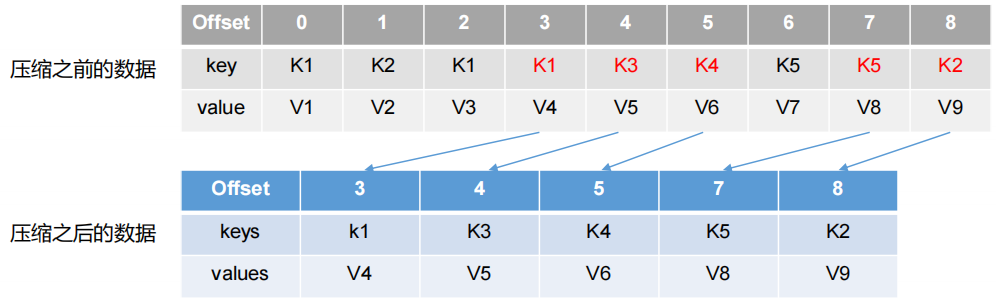
压缩后的offset可能是不连续的,比如上图中没有6,当从这些offset消费消息时,将会拿到比这个offset大的offset对应的消息,实际上会拿到offset为7的消息,并从这个位置开始消费。
这种策略只适合特殊场景,比如消息的key是用户ID,value是用户的资料,通过这种压缩策略,整个消息集里就保存了所有用户最新的资料。
比如:张三 去年18岁,今年19岁,这种场景下可以进行压缩。