文本生成类(机器翻译)系统评估

在机器翻译任务中常用评价指标:BLEU、ROGUE、METEOR、PPL。

这些指标的缺点:只能反应模型输出是否类似于测试文本。

BLUE (Bilingual Evaluation Understudy):是用于评估模型生成的句子(candidate)和实际句子(reference) 的差异的指标。该指标由IBM于2002年提出。该指标还适用于NLP的其他场景,如:语言生成、图像标题生成、文本生成、语音识别。

Python使用NLTK库实现BLEU的计算。

**ROGUE:**指标是在机器翻译、自动摘要、问答生成等领域常见的评估指标。ROUGE 通过将模型生成的摘要或者回答与参考答案(一般是人工生成的)进行比较计算,得到对应的得分。

Python使用rouge库实现。

METEOR:

PPL(Perplexity):困惑度

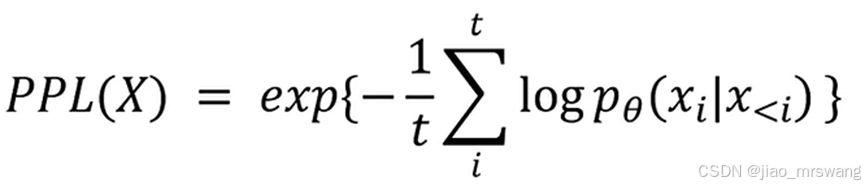
参考文章:

机器翻译评价指标BLEU介绍_bleu指标-CSDN博客

相关推荐
杨杨杨大侠12 分钟前
AI 怎么知道自己改对了?从 Astra 修千问说到 Harness²
人工智能·agent
tellmewhoisi16 分钟前
深度学习39:RNN基础介绍,api参数解惑和代码api
人工智能·rnn·深度学习
金融Tech趋势派30 分钟前
企业微信客户管理工具哪个好?按企业规模、行业与合规要求的三层判断标准
人工智能·企业微信
组工部管理能手李哥32 分钟前
一次政务知识库体验:AI回答之外,我更在意那行引用来源
大数据·人工智能·大模型·政务
硅谷秋水1 小时前
AgenticRoboRL:将“编程智能体”后训练引入智能体化机器人领域
人工智能·机器学习·语言模型·机器人
武天旭1 小时前
AI安全--AI大模型的毒性偏见与安全对齐实践
人工智能·python·深度学习
wordbaby1 小时前
构建高效的智能体(Building Effective Agents)— Anthropic 官方全文精译与图解
人工智能
xsd202411181 小时前
AI 短剧怎么做?
人工智能
m0_715674431 小时前
政务泛监测体系能力排行:AI 重塑监测边界,治理的颗粒度革命
大数据·网络·人工智能·安全·网络安全·政务
羲云网络2 小时前
AI API 门户上线不难,难的是让用户完成第一次调用
人工智能·产品运营·api·开发者·acedatacloud