赛题描述:根据提供的脱敏资讯新闻数据,选手需要对提供的训练集进行特征工程,构建资讯分类模型,对与测试集进行准确的新闻分类。
最终得分:0.8120。十二点关榜没看到排名,估算100+?
训练集很小,只有八千条数据,痛苦了三天,调参加模型效果不升反降。
训练集只有三列:新闻ID,文字,标签,一共四类标签。
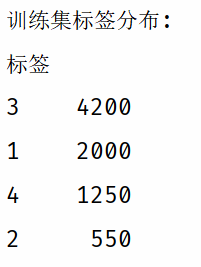
根据文本列中的数字个数加入了文本长度特征,能够反映出文本的复杂性或信息量。
python
X_train['length'] = X_train['文本'].apply(lambda x: len(str(x).split()))
X_test['length'] = X_test['文本'].apply(lambda x: len(str(x).split()))对文本列使用TfidfVectorizer:将文本数据转换为 TF-IDF 特征。
对length列使用StandardScaler:将其转换为均值为 0,标准差为 1 的数值范围。
python
preprocessor = ColumnTransformer(
    transformers=[
        ('text_tfidf', TfidfVectorizer(), '文本'),
        ('length_scaler', StandardScaler(), ['length'])
    ],
    remainder='passthrough'
)
选择线性支持向量机作为分类器:
python
classifier = LinearSVC(class_weight='balanced', random_state=42, dual=False)使用 GridSearchCV 来进行超参数调优。
python
param_grid = {
    'preprocessor__text_tfidf__ngram_range': [(1, 2)],
    'preprocessor__text_tfidf__max_features': [50000, 70000, 90000],
    'preprocessor__text_tfidf__min_df': [1, 2, 3],
    'preprocessor__text_tfidf__max_df': [0.85, 0.9, 0.95],
    'classifier__C': [0.5, 1.0, 2.0, 5.0, 8.0, 10.0],
}
ngram_range: 设置为 (1, 2),表示我们使用 1-gram 和 2-gram(单词和双词组合)来表示文本特征。
max_features: 控制 TfidfVectorizer 中考虑的最大特征数量。尝试不同的值可以帮助我们找到最佳的特征数量。
min_df 和 max_df: 这些参数控制了 TfidfVectorizer 在选择特征时的文档频率范围,有助于排除低频和高频的噪声词汇。
C: 正则化参数,控制模型的复杂度和对训练数据的拟合程度。
对模型进行了多次交叉验证,以选择最佳参数组合。
python
grid_search = GridSearchCV(pipeline, param_grid, cv=cv_strategy,
                           scoring='f1_macro',
                           n_jobs=-1,
                           verbose=2)
best_model = grid_search.best_estimator_
predictions = best_model.predict(X_test)
小白第一次参加类似比赛,大佬轻喷。