神经网络参数初始化详解
在构建神经网络时,参数的初始化虽然只是一个开端步骤,但它对网络最终的训练效果和收敛速度有着至关重要的影响。本文将结合一张手绘风格图,深入浅出地讲解神经网络初始化的背景、方法及其数学依据,帮助大家构建更加高效稳定的神经网络模型。
为什么要重视参数初始化?
在神经网络中,参数(权重)通常需要被初始化为非零值。初始化得当,可以帮助网络快速进入有效训练状态;反之,则可能导致:
-
梯度消失或爆炸(尤其在深层网络中)
-
收敛速度缓慢
-
陷入局部最优或震荡
图示解读:参数初始化要点
我们先来看这张图(来源:Chris Albon):
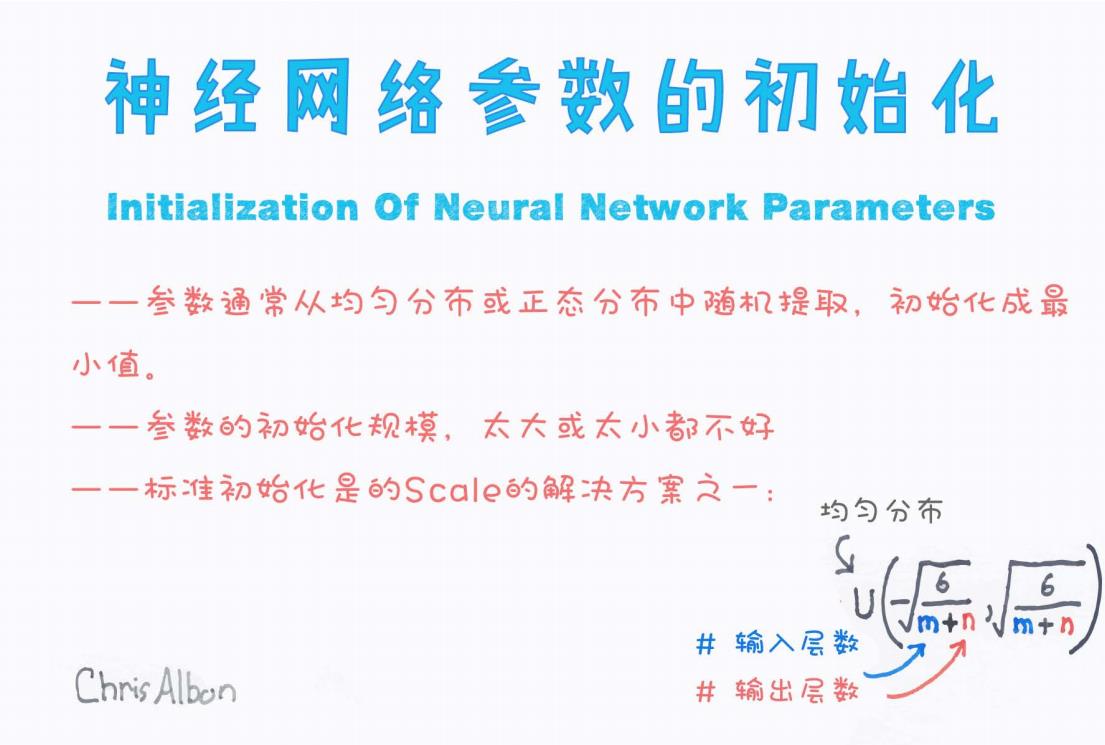
从图中可以总结出三个关键点:
1. 参数来源
"参数通常从均匀分布 或正态分布中随机提取,初始化成最小值。"
-
最常见的方法是从某个概率分布(如
或
-
目的是让初始值"看起来像随机的",但又不至于太极端。
2. 初始值的大小不能随意
"参数的初始化规模,太大或太小都不好。"
-
初始化过大:会导致激活值变得过大,可能造成梯度爆炸。
-
初始化过小:激活值趋近于0,导致梯度消失。
3. 合理控制初始化的 Scale
图中给出了一个标准初始化的 scale 解决方案,其核心公式为:
其中:
-
m:上一层的神经元数量(输入维度)
-
n:当前层的神经元数量(输出维度)
这是 Xavier 初始化(Glorot Uniform) 的核心思想,适用于 sigmoid 或 tanh 激活函数。
Xavier 初始化的由来与数学原理
Xavier 初始化由 Glorot & Bengio 提出,目的是让每一层的输入和输出保持相近的方差,避免激活值和梯度在前向和反向传播中消失或爆炸。
核心思想:
保持:
-
前向传播时的激活值方差不变;
-
反向传播时的梯度方差不变。
因此选择:
-
如果采用 均匀分布,则边界设为:
-
如果采用 正态分布,则使用:
实践中的其他初始化方法
除了 Xavier 初始化,还有一些根据不同激活函数而优化的方法:
| 方法 | 使用场景 | 初始化方式 |
|---|---|---|
| He 初始化 | ReLU 系列激活函数 | |
| LeCun 初始化 | SELU 等自归一化激活函数 | |
| Zero 初始化 | 不可取 | 所有权重设为0,导致每层输出相同 |
| 常量初始化 | 特殊场景 | 比如偏置初始化为0或常数 |
🛠 实际代码示例(PyTorch)
以 PyTorch 为例,我们如何实现 Xavier 初始化?
python
import torch.nn as nn
import torch.nn.init as init

layer = nn.Linear(256, 128)  # 输入256维,输出128维
init.xavier_uniform_(layer.weight)  # 使用均匀分布的Xavier初始化
对于 ReLU 可使用 He 初始化:
python
init.kaiming_uniform_(layer.weight, nonlinearity='relu')总结
-
参数初始化是神经网络训练的起点,需根据网络结构和激活函数选用合适策略。
-
Xavier 初始化是适用于 sigmoid/tanh 的经典方案。
-
初始化的核心是保持激活值和梯度的方差稳定,从而避免训练不收敛的问题。
-
实践中,务必根据具体模型选择对应初始化方式,尤其在构建深层网络或使用特殊激活函数时。
建议阅读:
-
《Understanding the difficulty of training deep feedforward neural networks》(Xavier 初始化提出论文)
-
PyTorch / TensorFlow 源码中的初始化实现逻辑
如果你喜欢这类"图示 + 理论 + 实践"的讲解方式,欢迎点赞、收藏、转发支持!