中山大学&美团&港科大提出首个音频驱动多人对话视频生成MultiTalk,输入一个音频和提示,即可生成对应唇部、音频交互视频。

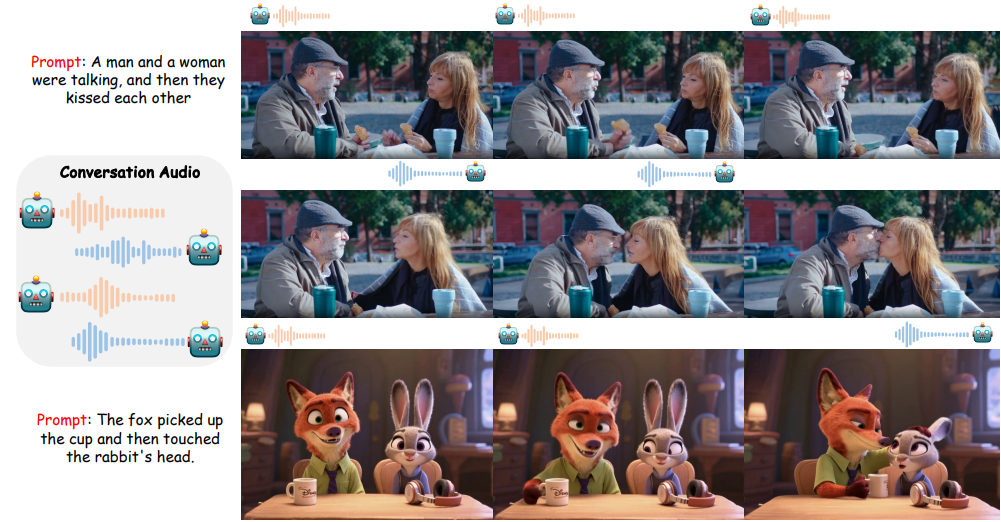
由中山大学、美团、香港科技大学联合提出的MultiTalk是一个用于音频驱动的多人对话视频生成的新框架。给定一个多流音频输入和一个提示,MultiTalk 会生成一个包含提示所对应的交互的视频,其唇部动作与音频保持一致。
相关链接

论文介绍
音频驱动的人体动画方法,例如说话头部和说话身体生成,在生成同步面部动作和引人入胜的视觉质量视频方面取得了显著进展。然而,现有方法主要侧重于单人动画,难以处理多流音频输入,存在音频与人物绑定不正确的问题。此外,它们在指令遵循能力方面也存在局限性。

为了解决这一问题,本文提出了一项新的任务:多人对话视频生成,并引入了一个新框架 MultiTalk 来应对多人生成过程中的挑战。具体来说,对于音频注入,我们研究了多种方案,并提出了标签旋转位置嵌入 (L-RoPE) 方法来解决音频和人物绑定问题。此外,在训练过程中,我们观察到部分参数训练和多任务训练对于保持基础模型的指令遵循能力至关重要。MultiTalk 在多个数据集(包括说话头部、说话身体和多人数据集)上取得了优于其他方法的性能,证明了我们方法强大的生成能力。

方法

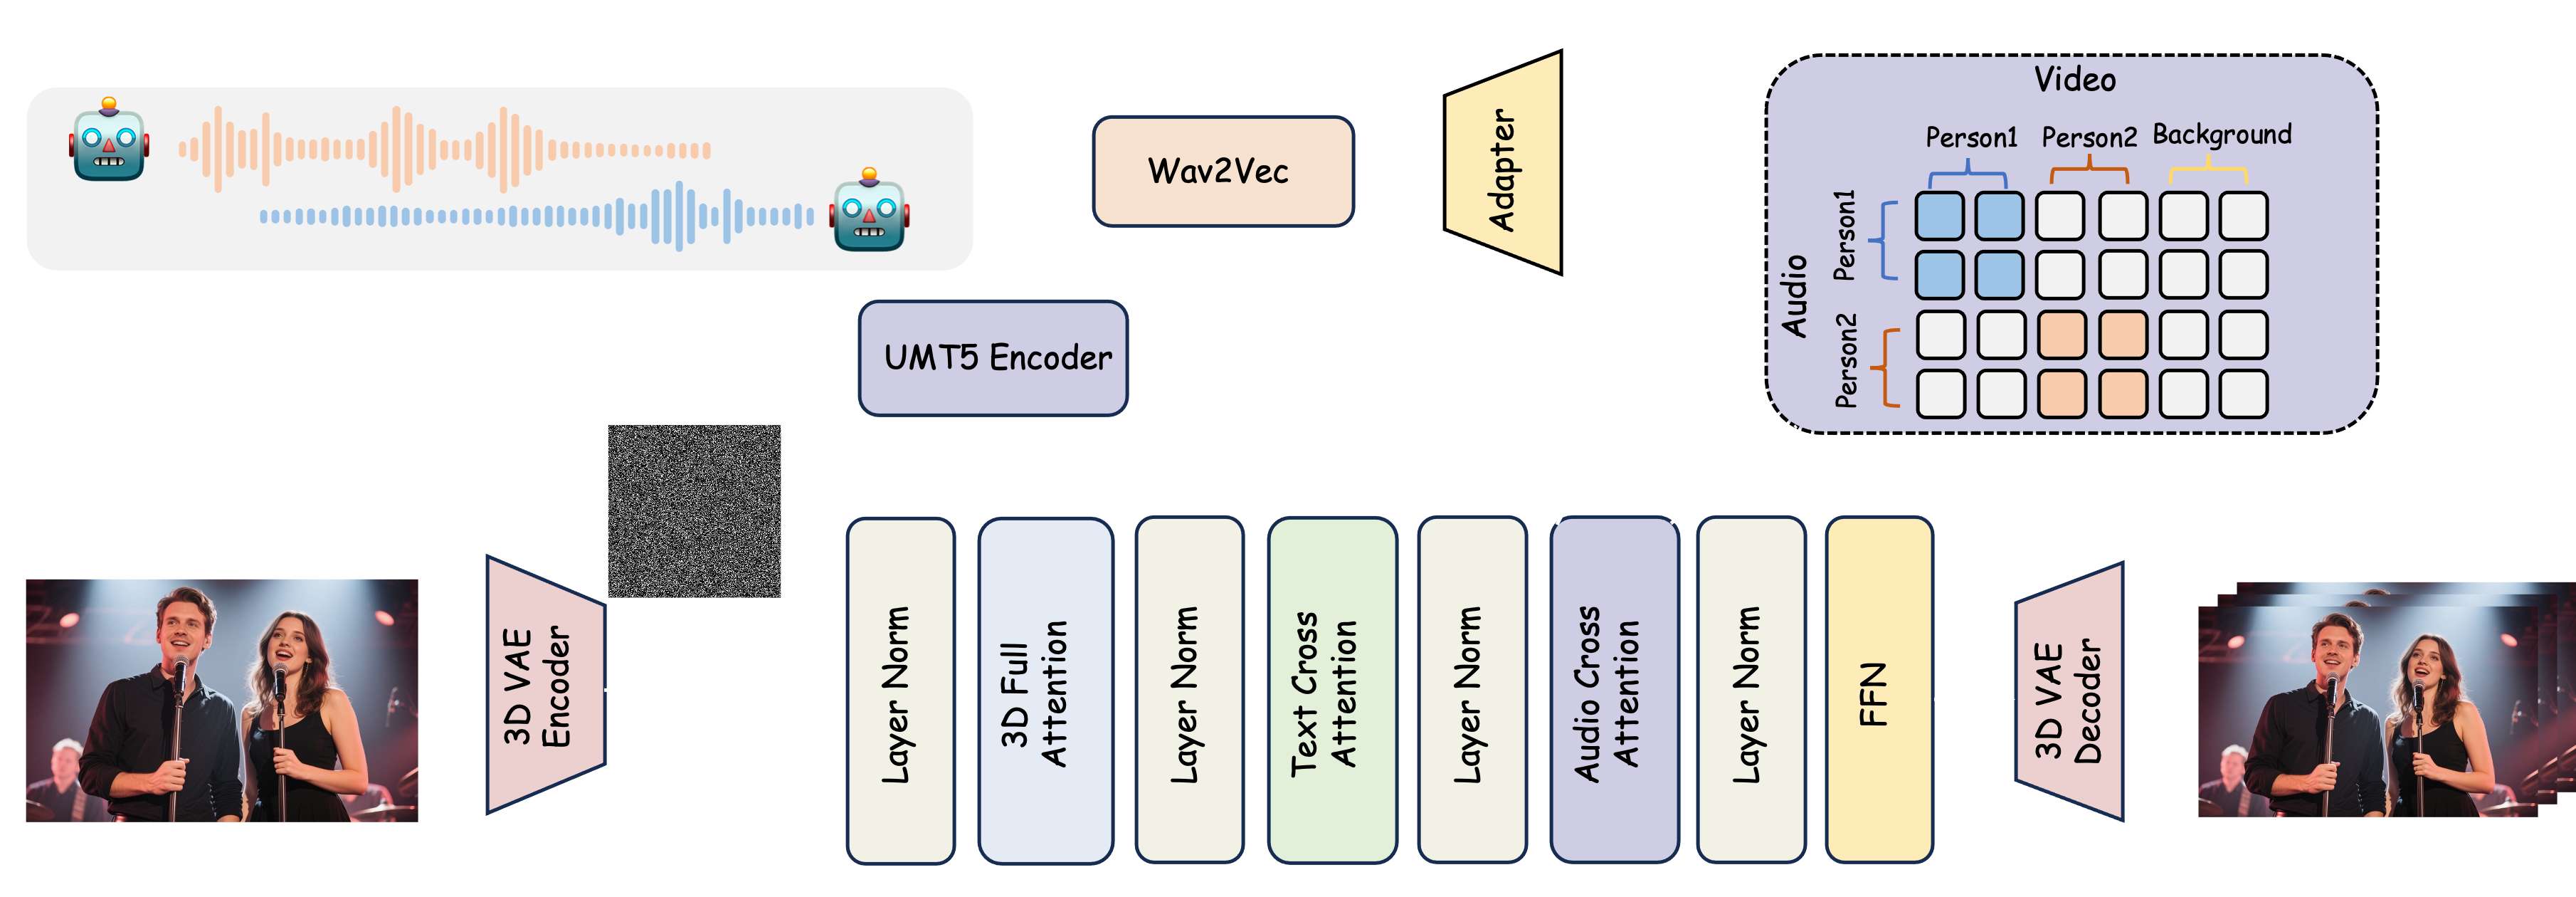
论文提出了一个音频驱动的视频生成框架 MultiTalk。该框架新增了一个音频交叉注意力层,以支持音频条件。为了实现多人对话视频生成,论文提出了一种用于多流音频注入的标签旋转位置嵌入 (L-RoPE)。
相关推荐
weixin_468466852 小时前
从“看懂”到“做到”:视觉-语言-动作模型如何让机器人真正执行指令
人工智能·ai·机器人·大语言模型·前沿科技
朋友圈自动点赞工具3 小时前
科学AI插件化:从蛋白质结构到古籍修复
人工智能
龙粤GEO3 小时前
实体Entity在GEO中代表什么含义
人工智能
前端精髓3 小时前
结构化输出with_structured_output(抽卡)
python·langchain
拜小白4 小时前
【论文解读】《DeepPanoContext:用全局场景关系图 + 可微关系优做全景 3D 场景理解
深度学习·计算机视觉·全景图
尹人入圣4 小时前
目前热门的IP驱动产业新场景新工具
网络·python·网络协议·tcp/ip
剑雨巍巍4 小时前
AI Agent面试之基础概念
人工智能
微帧Visionular4 小时前
AI视频单帧清晰,播放时却闪烁,原因是什么?
人工智能·深度学习·音视频
武子康4 小时前
MultiNet6 空闲崩溃:`EXCVADDR=0x8` 后又出现 `CORRUPT HEAP`
人工智能·后端·agent
云智慧AIOps社区5 小时前
智能巡检机器人应用场景解析:机房巡检、园区安防、管廊巡视与展厅导览
人工智能·机器人·具身智能·智能巡检机器人·企业级智能巡检机器人·机房巡检机器人·导览机器人