作者:来自 Elastic Jeffrey Rengifo
学习如何将 ES|QL 与 JavaScript 的 Apache Arrow 客户端工具一起使用。
想获得 Elastic 认证吗?了解下一期 Elasticsearch Engineer 培训的时间吧!
Elasticsearch 拥有众多新功能,助你为自己的使用场景构建最佳搜索解决方案。深入了解我们的示例笔记本,开始免费的云试用,或立即在本地机器上体验 Elastic。
Elasticsearch 查询语言(ES|QL)是一种基于管道的新指令语言,旨在让用户以逐步的方式连接不同的操作。它是一种为数据分析优化的语言,并在一套新架构中运行,能够高效分析海量数据。
ES|QL 查询支持构建多种格式的响应,例如 JSON、CSV、TSV、YAML、Arrow 和 binary。从 Elasticsearch 8.16 开始,Node.js 客户端中包含了一些处理这些格式的工具。
本文将介绍最新的工具: toArrowReader 和 toArrowTable ,它们在 Elasticsearch Node.js 客户端中专门支持 Apache Arrow。更多关于工具的内容,请查看这篇文章。
什么是 Apache Arrow?
Apache Arrow 是一种列式数据分析工具,使用与现代环境中各种编程语言无关的通用格式。
Arrow 格式的主要优点之一是其二进制列式结构经过优化,可实现非常快速的读取,从而支持高性能的分析计算。
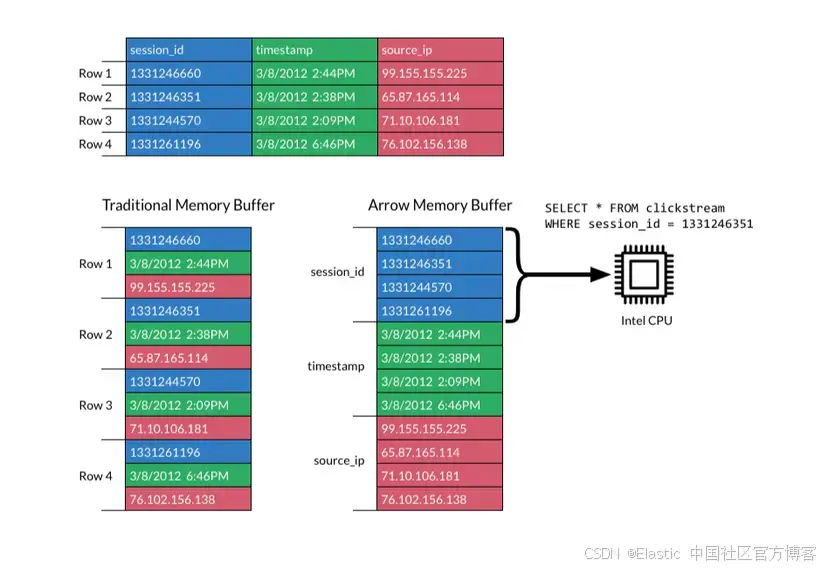 来源: Format | Apache Arrow
阅读这篇文章,了解如何在 ES|QL 中利用 Arrow。
ES|QL Apache Arrow 工具
在示例中,我们将使用 Elastic 的 Web 日志示例数据集 。你可以按照这份文档将其导入。
Elasticsearch 客户端
通过指定你的 Elasticsearch 端点 URL 和 API Key 来配置 Elasticsearch 客户端。
const { Client } = require("@elastic/elasticsearch");

const esClient = new Client({
  node: "ELASTICSEARCH_ENDPOINT",
  auth: { apiKey: "ELASTICSEARCH_API_KEY" },
});
toArrowReader
toArrowReader 工具用于优化内存使用,它不会一次性将整个结果集加载到内存中,而是以批次方式进行流式处理。这使得可以在不耗尽系统内存的情况下,对超大数据集执行计算。
这个工具允许你逐行处理数据:
const q = `FROM kibana_sample_data_logs
    | KEEP message, response, tags, @timestamp, ip, agent
    | LIMIT 2 `;

const reader = await esClient.helpers.esql({ query: q }).toArrowReader();

const toArrowReaderResults = [];

for await (const recordBatch of reader) {
  for (const record of recordBatch) {
    const recordData = record.toJSON();
    toArrowReaderResults.push(recordData);
  }
}

console.log(JSON.stringify(toArrowReaderResults, null, 2));
/*
  RESULT:
  [
    {
      "message": "49.167.60.184 - - [2018-09-16T09:10:01.825Z] \"GET /kibana/kibana-6.3.2-darwin-x86_64.tar.gz HTTP/1.1\" 200 2603 \"-\" \"Mozilla/5.0 (X11; Linux i686) AppleWebKit/534.24 (KHTML, like Gecko) Chrome/11.0.696.50 Safari/534.24\"",
      "response": "200",
      "tags": [
        "error",
        "info"
      ],
      "@timestamp": 1749373801825,
      "ip": {
        "0": 49,
        "1": 167,
        "2": 60,
        "3": 184
      },
      "agent": "Mozilla/5.0 (X11; Linux i686) AppleWebKit/534.24 (KHTML, like Gecko) Chrome/11.0.696.50 Safari/534.24"
    },
    {
      "message": "225.72.201.213 - - [2018-09-16T09:37:35.555Z] \"GET /elasticsearch/elasticsearch-6.3.2.zip HTTP/1.1\" 200 6335 \"-\" \"Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 1.1.4322)\"",
      "response": "200",
      "tags": [
        "success",
        "info"
      ],
      "@timestamp": 1749375455555,
      "ip": {
        "0": 225,
        "1": 72,
        "2": 201,
        "3": 213
      },
      "agent": "Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 1.1.4322)"
    }
  ]
*/
toArrowTable
如果你希望在请求完成后一次性将所有结果加载到一个 Arrow 表对象中,而不是以流的方式逐行返回,可以使用 toArrowTable。
当你的数据集可以轻松装入内存,同时又想利用 Arrow 的零拷贝读取和紧凑传输格式,并保持代码简洁时,这个工具就非常有用。
如果应用本身已经在处理 Arrow 数据,toArrowTable 也是一个不错的选择,因为你无需对数据进行序列化。此外,由于 Arrow 与编程语言无关,无论使用什么平台和语言,你都可以使用它。
const q = `FROM kibana_sample_data_logs
  | KEEP message, response, tags, @timestamp, ip, agent
  | LIMIT 2 `;

const toArrowTableResults = await esClient.helpers
  .esql({ query: q })
  .toArrowTable();

const arrayTable = toArrowTableResults.toArray();

console.log(JSON.stringify(arrayTable, null, 2));
/*
   RESULT:
   [
      {
        "message": "49.167.60.184 - - [2018-09-16T09:10:01.825Z] \"GET /kibana/kibana-6.3.2-darwin-x86_64.tar.gz HTTP/1.1\" 200 2603 \"-\" \"Mozilla/5.0 (X11; Linux i686) AppleWebKit/534.24 (KHTML, like Gecko) Chrome/11.0.696.50 Safari/534.24\"",
        "response": "200",
        "tags": [
          "error",
          "info"
        ],
        "@timestamp": 1749373801825,
        "ip": {
          "0": 49,
          "1": 167,
          "2": 60,
          "3": 184
        },
        "agent": "Mozilla/5.0 (X11; Linux i686) AppleWebKit/534.24 (KHTML, like Gecko) Chrome/11.0.696.50 Safari/534.24"
      },
      {
        "message": "225.72.201.213 - - [2018-09-16T09:37:35.555Z] \"GET /elasticsearch/elasticsearch-6.3.2.zip HTTP/1.1\" 200 6335 \"-\" \"Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 1.1.4322)\"",
        "response": "200",
        "tags": [
          "success",
          "info"
        ],
        "@timestamp": 1749375455555,
        "ip": {
          "0": 225,
          "1": 72,
          "2": 201,
          "3": 213
        },
        "agent": "Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 1.1.4322)"
      }
  ]
*/
总结
Elasticsearch Node.js 客户端提供的 Apache Arrow 工具有助于高效处理日常任务,例如分析大数据集,并以紧凑且与语言无关的格式接收 Elasticsearch 响应。
在本文中,我们学习了如何使用 ES|QL 客户端工具,将 Elasticsearch 响应解析为 Arrow Reader 或 Arrow Table。
原文:ES|QL in JavaScript: Leveraging Apache Arrow helpers - Elasticsearch Labs