基于spark的基于可穿戴设备运动数据预测
项目概况
**👇👇👇👇👇👇👇👇**
**👆👆👆👆👆👆👆👆**
数据类型
可穿戴设备运动数据
开发环境
centos7
软件版本
python3.8.18、hadoop3.2.0、spark3.1.2、mysql5.7.38、scala2.12.18、jdk8
开发语言
python、Scala
开发流程
数据上传(hdfs)->数据分析(spark)->机器学习(spark)->数据存储(mysql)->后端(flask)->前端(html+js+css)
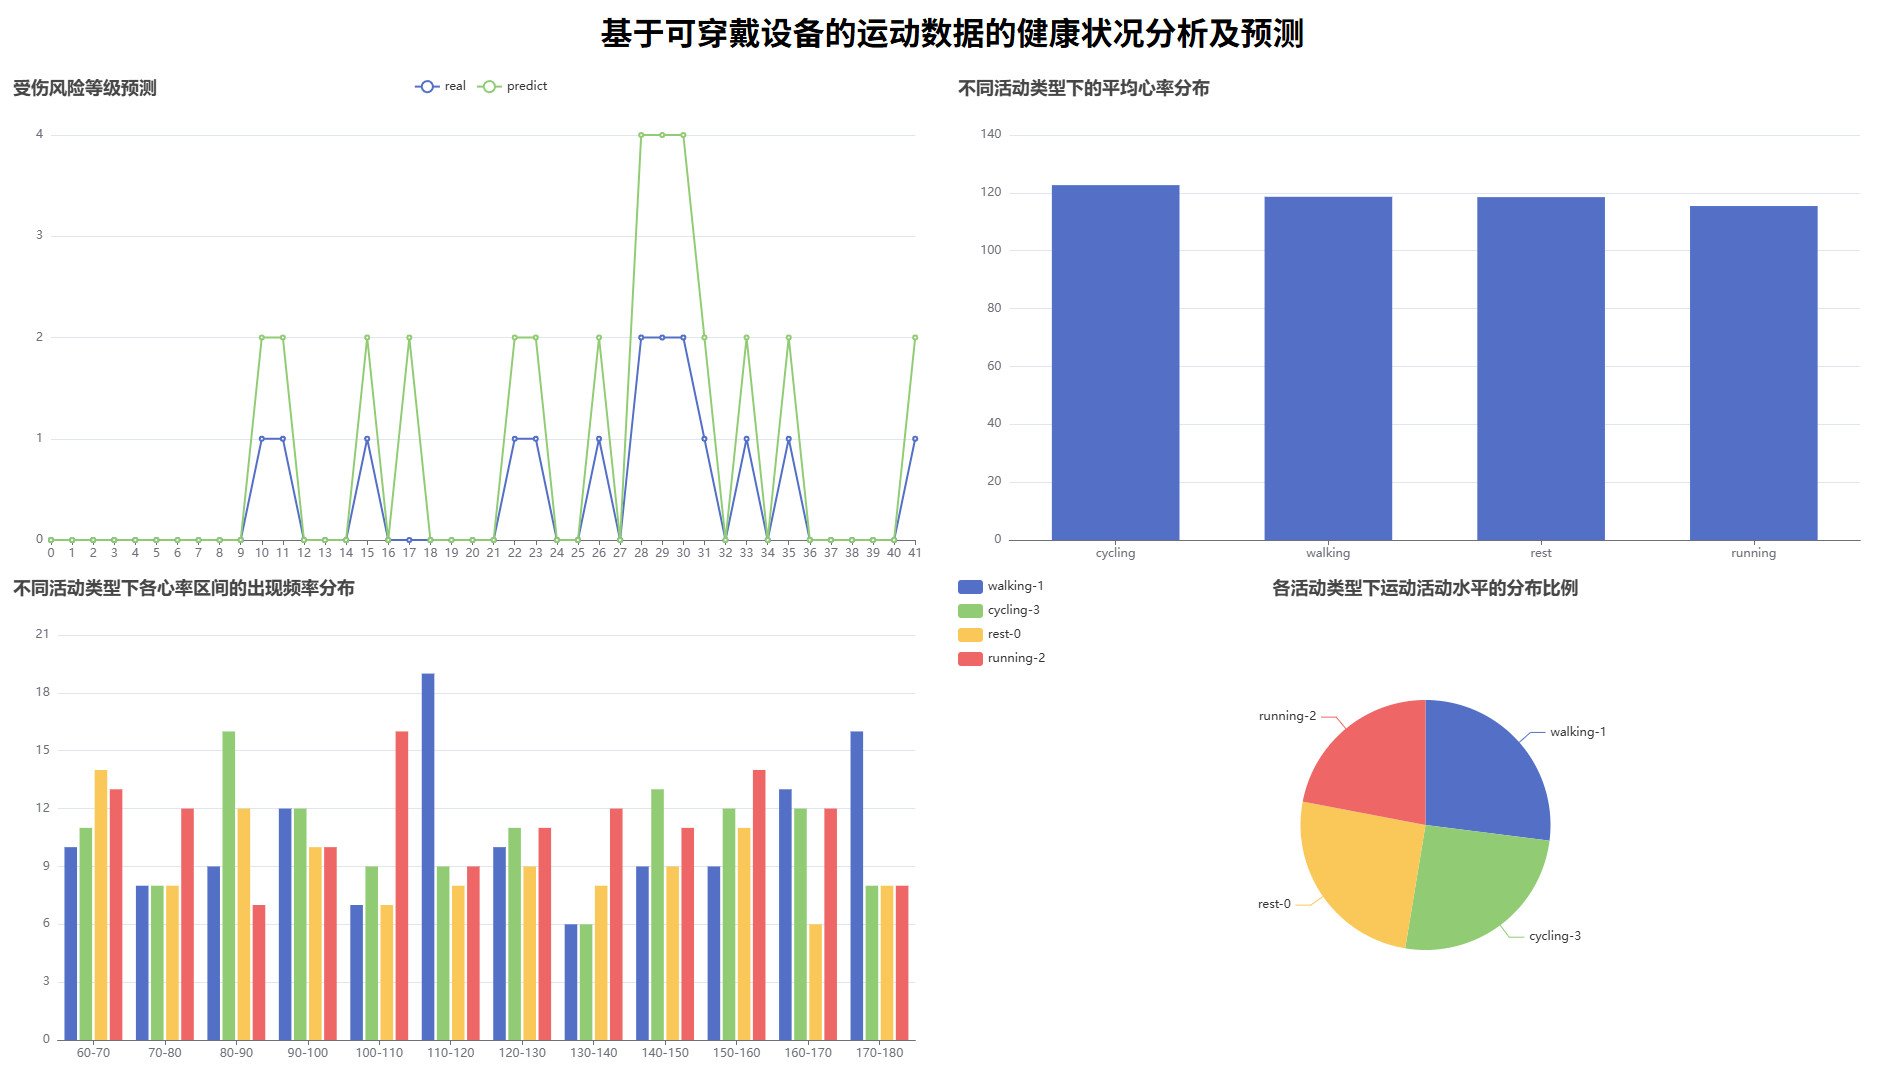
可视化图表
操作步骤
python安装包
shell
pip3 install pandas==2.0.3 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install flask==3.0.0 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install flask-cors==4.0.1 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install pymysql==1.1.0 -i https://mirrors.aliyun.com/pypi/simple/
pip3 install pyecharts==2.0.4 -i https://pypi.tuna.tsinghua.edu.cn/simple
启动MySQL
shell
# 查看mysql是否启动 启动命令: systemctl start mysqld.service
systemctl status mysqld.service
# 进入mysql终端
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
# MySQL的用户名:root 密码:123456
mysql -uroot -p123456
启动Hadoop
shell
# 离开安全模式: hdfs dfsadmin -safemode leave
# 启动hadoop
bash /export/software/hadoop-3.2.0/sbin/start-hadoop.sh
准备目录
shell
mkdir -p /data/jobs/project/
cd /data/jobs/project/

# 上传 "data" 目录下的 "wearable_sensor_data.csv" 文件/文件夹 到 "/data/jobs/project/" 目录
上传文件到hdfs
shell
cd /data/jobs/project/

hdfs dfs -mkdir -p /data/input/
hdfs dfs -rm -r /data/input/*
hdfs dfs -put -f wearable_sensor_data.csv /data/input/
hdfs dfs -ls /data/input/
创建MySQL库
sql
CREATE DATABASE IF NOT EXISTS echarts CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;程序打包
shell
cd /data/jobs/project/

# 对 "project-spark-sport-device-data-predict" 目录下的项目 "project-spark-sport-device-data-predict" 进行打包
# 打包命令: mvn clean package -Dmaven.test.skip=true

# 上传 "project-spark-sport-device-data-predict/target/" 目录下的 "project-spark-sport-device-data-predict-jar-with-dependencies.jar" 文件 到 "/data/jobs/project/" 目录
spark数据分析
shell
cd /data/jobs/project/

spark-submit \
--master local[*] \
--class org.example.demo.SparkAnalysis \
/data/jobs/project/project-spark-sport-device-data-predict-jar-with-dependencies.jar /data/input/
机器学习
shell
cd /data/jobs/project/

spark-submit \
--master local[*] \
--class org.example.demo.Main \
/data/jobs/project/project-spark-sport-device-data-predict-jar-with-dependencies.jar /data/input/
启动可视化
shell
mkdir -p /data/jobs/project/myapp/
cd /data/jobs/project/myapp/

# 上传 "可视化" 目录下的 "所有" 文件和文件夹 到 "/data/jobs/project/" 目录

# windows本地运行: python app.py
python3 app.py pro