本教程以部署单机版Spark为例进行演示,正式环境可部署集群版Spark
一、安装 Java
PySpark 依赖于 Spark,而 Spark 又依赖于 Java,所以,首先要确保你的机器上安装了 Java。
1、下载安装java8
sudo apt update
sudo apt install openjdk-8-jdk
2、配置环境变量
nano ~/.bashrc

export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64
export PATH=$JAVA_HOME/bin:$PATH

source ~/.bashrc
二、本地安装Spark
1、下载 Spark
访问 Spark 官网下载页面,选择你需要的版本(例如,选择 3.x和 Hadoop 3.x),然后用 wget 下载,本教程使用Spark2.4.0
wget http://archive.apache.org/dist/spark/spark-2.4.0/spark-2.4.0-bin-hadoop2.6.tgz2、解压 Spark 压缩包
tar -xvzf spark-2.4.0-bin-hadoop2.6.tgz3、移动到目录 /opt/spark
sudo mv spark-2.4.0-bin-hadoop2.6 /opt/spark4、配置环境变量
为了让 Spark 能在命令行中使用,你需要设置环境变量。打开.bashrc 文件:
nano ~/.bashrc在文件末尾添加以下内容:
在此步骤将python解释器一起进行配置(本教程使用的是python 3.7)
export SPARK_HOME=/opt/spark/spark-2.4.0-bin-hadoop2.6
export PATH=$SPARK_HOME/bin:$PATH
export PYTHONPATH=$SPARK_HOME/python:$PYTHONPATH
export PYSPARK_PYTHON=/home/dell/anaconda3/envs/pyspark_env/bin/python

source ~/.bashrc
三、Python环境安装Pyspark第三方库
Pyspark第三方库版本尽量与Spark版本一直,本教程都为2.4.0
pip install pyspark==2.4.0 -i https://pypi.tuna.tsinghua.edu.cn/simple/四、Pyspark验证安装
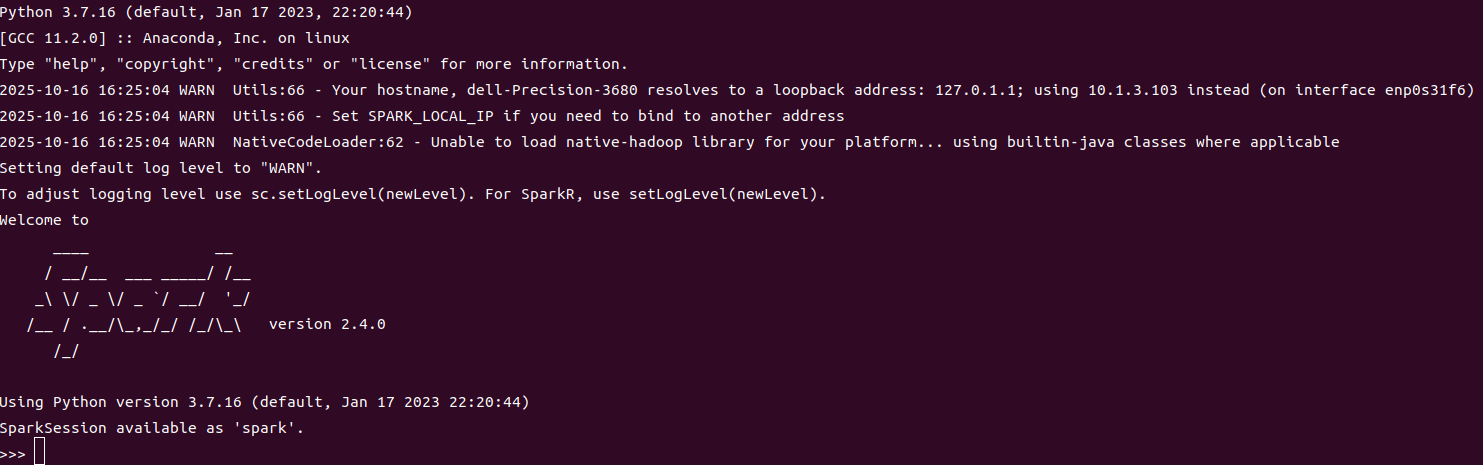
在终端输入:
pyspark你应该能看到类似以下的输出:
五、nebula-spark-connector下载
Nebula-Spark-Connector 是一个用于将 Nebula Graph 数据库与 Apache Spark 集成的连接器,它使得用户能够在 Spark 环境中轻松地读取、写入和处理 Nebula Graph 数据库中的图数据。
必须下载此组件。
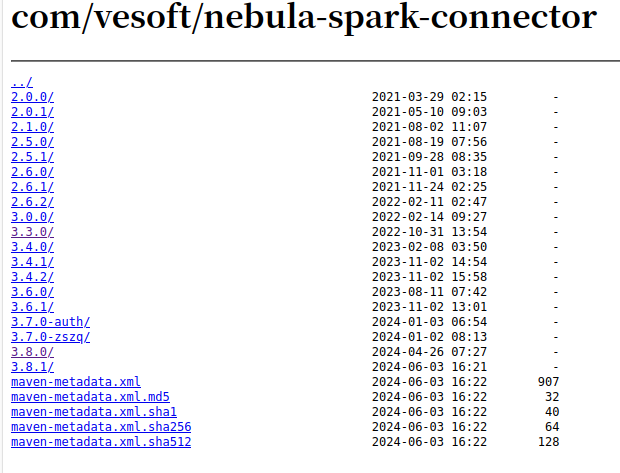
spark使用2.x版本,Nebula-Spark-Connector尽量使用3.3以下版本。
Nebula-Spark-Connector下载地址:
https://repo1.maven.org/maven2/com/vesoft/nebula-spark-connector/
六、Pyspark连接NebulaGraph
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("NebulaVisualization") \
    .master("local[*]") \
    .config("spark.jars", "/mnt/data/nebula-spark-connector-3.3.0.jar") \
    .config("spark.driver.extraClassPath", "/mnt/data/nebula-spark-connector-3.3.0.jar") \
    .config("spark.executor.extraClassPath", "/mnt/data/nebula-spark-connector-3.3.0.jar") \
    .getOrCreate()
spark.sparkContext.setLogLevel("ERROR")

try:
    df = spark.read \
        .format("com.vesoft.nebula.connector.NebulaDataSource") \
        .option("metaAddress", "10.2.7.209:9559") \
        .option("spaceName", "construction_ontology") \
        .option("label", "dependsOnPreTask") \
        .option("type", "edge") \
        .option("returnCols", "") \
        .option("partitionNumber", "10") \
        .option("nebula.user", "root") \
        .option("nebula.password", "nebula") \
        .load()
    df.show()
    print("连接器验证成功!")

except Exception as e:
    print(f"连接器验证失败:{e}")
finally:
    spark.stop()
注意:spark参数 spark.jars、spark.driver.extraClassPath、
spark.executor.extraClassPath需要配置第四步下载的nebula-spark-connector jar