一、题目描述
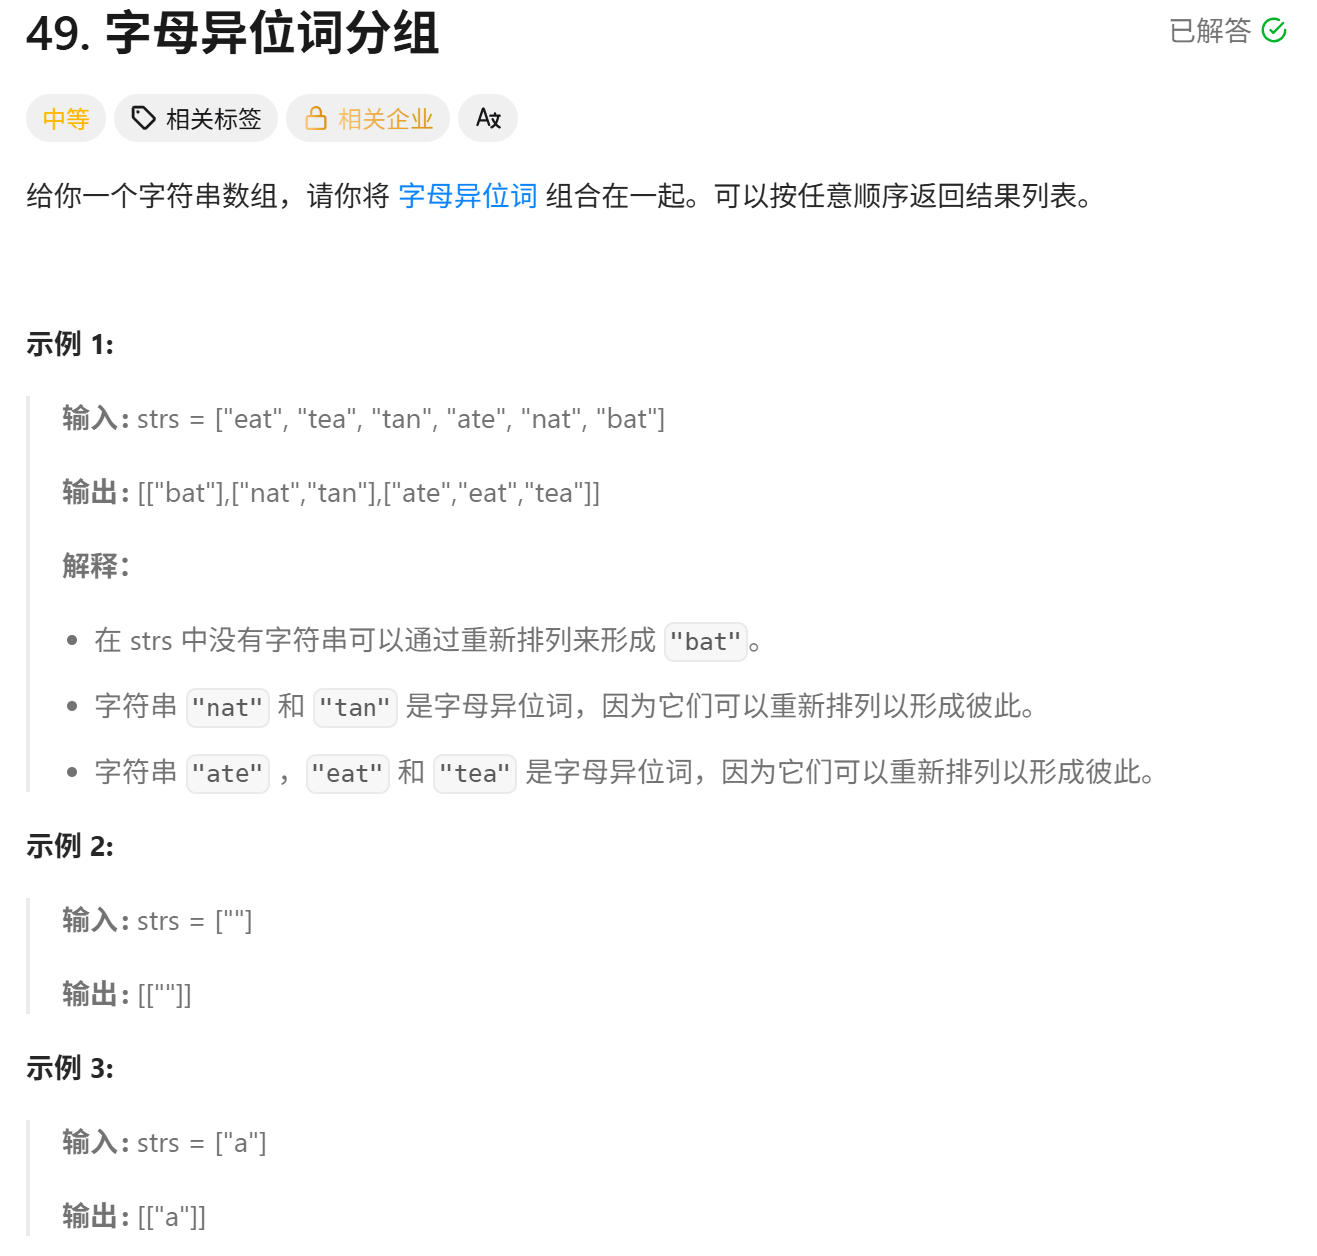
字母异位词:指字母相同,但排列不同的字符串。比如 "eat"、"tea"、"ate" 就是字母异位词。
目标:将字母异位词分组在一起。
二、解题思路
我们可以用字符计数的方法:
-
使用26位数组 统计每个单词的字母频次
-
将频次数组转换为字符串作为哈希表键
-
将原始单词存储为对应键的值
-
相同频次的单词自动归类到同一分组
三、完整代码
class Solution {
public:
vector<vector<string>> groupAnagrams(vector<string>& strs) {
unordered_map <string,vector<string>> map;
for(string str:strs){
int num26={0};
for(char s:str){
nums-'a'++;
}
string key="";
for(int i=0;i<26;i++){
key=key+to_string(numi)+",";
}
mapkey.push_back(str);
}
vector<vector<string>> result;
for(auto r:map){
result.push_back(r.second);
}
return result;
}
};
四、代码解析
1. 哈希表定义
unordered_map<string, vector<string>> map;
-
键string:一个用于记录字幕出现频率的字符串
-
值vector<string>(n个字符串):对应的字母异位词分组
2. 字符计数
vector<int> count(26, 0);
for (char c : str) {
countc - 'a'++;
}
创建26位数组,统计每个字母出现次数。
3. 生成键
for(int i=0;i<26;i++){
key=key+to_string(numi)+",";
}
将计数数组转换为哈希表的键Key。
4. 分组存储
mapkey.push_back(str);
将当前字符串添加到对应分组。
5. 提取结果
vector<vector<string>> result;
for (auto& pair : map) {
result.push_back(pair.second);
}
二维数组的结构:
-
外层
vector包含所有字母异位词分组 -
每个内层
vector<string>是一个具体的分组,包含所有互为字母异位词的字符串
遍历哈希表时,会同时遍历键和值,pair.first=key , pair.second=value
结果如下
result = [
"eat", "tea", "ate", // 第一个分组
"tan", "nat", // 第二个分组
"bat" // 第三个分组
]
五、语法要点
1. vector使用
vector<string> array; // 字符串数组
array.push_back(value); // 添加元素
vector<int> count(26, 0); // 创建26个0的数组
2. unordered_map使用
unordered_map<string, vector<string>> map;
mapkey = value; // 设置键值对
mapkey.push_back(value); // 向值中添加元素
3. 范围循环
&的作用:
-
不加
&:按值传递,每次循环都会创建元素的副本(性能差) -
加
&:按引用传递,直接操作原数据(性能好)
const的作用:
-
不加
const:可以修改原数据 -
加
const:只读访问,不能修改原数据
实际使用场景:
-
for (const auto& x : container):只读访问容器元素 -
for (auto& x : container):需要修改容器元素时使用 -
for (auto x : container):避免使用,性能差
六、执行示例
输入:["eat", "tea", "tan"]
-
"eat" → 键:
"1,0,0,0,1,0,..."→ 分组:{"eat"} -
"tea" → 相同键 → 分组:
{"eat", "tea"} -
"tan" → 新键 → 分组:
{"tan"}
结果:[["eat","tea"],["tan"]]
总结
本文介绍了将字母异位词分组的算法解决方案。通过统计每个单词的字母频次,将频次数组转换为字符串作为哈希表键,实现相同字母组成的单词自动归类。代码使用unordered_map存储分组,其中键为字母频次字符串,值为对应分组的单词集合。算法首先计算每个单词的26位字母计数,生成唯一键值,然后将单词存入对应分组,最后提取所有分组作为结果输出。该方法时间复杂度为O(n*m),其中n为单词数量,m为单词平均长度。