目录
[2.1 什么是目标检测?](#2.1 什么是目标检测?)
[2.2 目标检测与其他计算机视觉任务的关系](#2.2 目标检测与其他计算机视觉任务的关系)
[3.1 传统目标检测时代(1990s-2010s)](#3.1 传统目标检测时代(1990s-2010s))
[3.2 基于区域的深度学习时代(2013-2015)](#3.2 基于区域的深度学习时代(2013-2015))
[3.3 单阶段检测时代(2015至今)](#3.3 单阶段检测时代(2015至今))
[4.1 两阶段检测器:以Faster R-CNN为例](#4.1 两阶段检测器:以Faster R-CNN为例)
[4.2 单阶段检测器:以YOLOv3为例](#4.2 单阶段检测器:以YOLOv3为例)
[4.2.1 新一代检测器:YOLOv8](#4.2.1 新一代检测器:YOLOv8)
[4.3 关键技术概念](#4.3 关键技术概念)
[4.3.1 Anchor Box(锚框)](#4.3.1 Anchor Box(锚框))
[4.3.2 非极大值抑制(NMS)](#4.3.2 非极大值抑制(NMS))
[4.3.3 IoU(交并比)](#4.3.3 IoU(交并比))
[4.3.4 损失函数](#4.3.4 损失函数)
[5.1 智能安防](#5.1 智能安防)
[5.2 自动驾驶](#5.2 自动驾驶)
[5.3 零售领域](#5.3 零售领域)
[5.4 医疗健康](#5.4 医疗健康)
[5.5 农业领域](#5.5 农业领域)
[5.6 机器人](#5.6 机器人)
[6.1 YOLOv3实现(基于OpenCV DNN)](#6.1 YOLOv3实现(基于OpenCV DNN))
[6.1.1 安装依赖](#6.1.1 安装依赖)
[6.1.2 加载预训练模型](#6.1.2 加载预训练模型)
[6.1.3 检测函数实现](#6.1.3 检测函数实现)
[6.2 YOLOv8实现(基于Ultralytics库)](#6.2 YOLOv8实现(基于Ultralytics库))
[6.2.1 安装依赖](#6.2.1 安装依赖)
[6.2.2 检测实现](#6.2.2 检测实现)
[6.3 使用模型进行检测](#6.3 使用模型进行检测)
[6.4 注意事项](#6.4 注意事项)
[7.1 精确率(Precision)和召回率(Recall)](#7.1 精确率(Precision)和召回率(Recall))
[7.2 mAP(mean Average Precision)](#7.2 mAP(mean Average Precision))
[7.3 FPS(Frames Per Second)](#7.3 FPS(Frames Per Second))
[8.1 常见挑战](#8.1 常见挑战)
[8.2 解决方案](#8.2 解决方案)
[9.1 技术发展趋势](#9.1 技术发展趋势)
[9.2 应用发展趋势](#9.2 应用发展趋势)
[10.1 让机器理解世界](#10.1 让机器理解世界)
[10.2 平衡速度与精度](#10.2 平衡速度与精度)
[10.3 从感知到行动](#10.3 从感知到行动)
[10.4 技术的边界与伦理](#10.4 技术的边界与伦理)
一、开篇:保安小王的困惑
在一个阳光明媚的早晨,小区保安小王坐在监控室里,盯着眼前的大屏幕。突然,他看到画面中有一个可疑人物正在翻越围墙。
"不好!有闯入者!"小王立刻拿起对讲机呼叫同事。
就在这时,旁边的智能监控系统发出了警报:
"检测到1个行人,位于(256, 145, 312, 278),置信度98%;检测到1个背包,位于(270, 220, 300, 260),置信度92%。"
小王惊讶地看着系统自动框出的行人和背包,感叹道:"现在的AI真厉害,不仅能认出是人,还能精确指出在哪里!"
这个智能监控系统使用的就是目标检测技术。如果说之前我们学过的图像分类是"认出是什么",那么目标检测就是"认出是什么,并且指出在哪里"。
二、目标检测的基本概念
2.1 什么是目标检测?
目标检测(Object Detection)是计算机视觉领域的一项核心任务,它的目标是:
- 识别 图像或视频中存在的目标类别(如人、车、猫、狗等)
- 定位 每个目标的位置(通常用边界框Bounding Box表示)
- 可能的话,预测 每个目标的姿态或关键点(如人体姿态、面部关键点等)
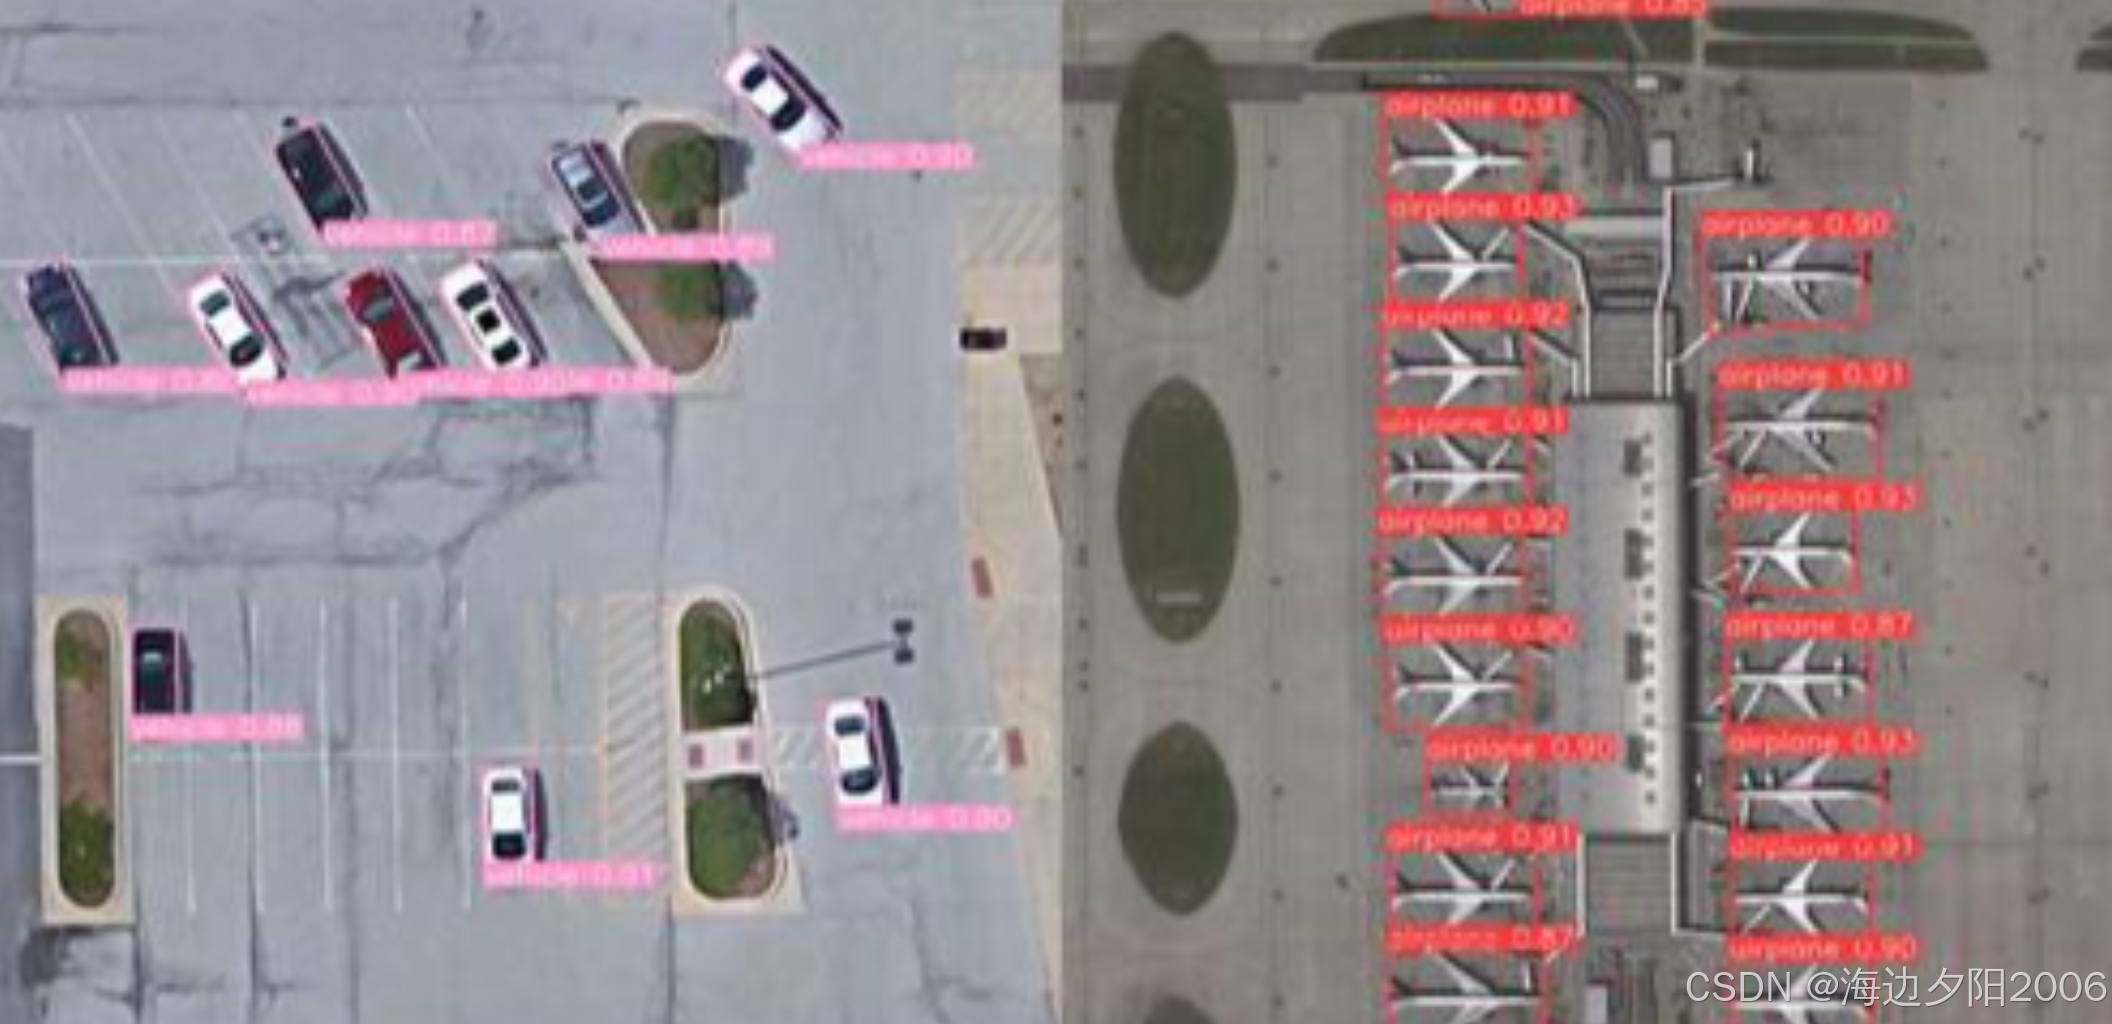
用数学语言来说,目标检测的输出是一组形如(类别, 边界框坐标, 置信度)的三元组。边界框通常用(x, y, w, h)或(x1, y1, x2, y2)表示,其中:
(x, y)是边界框的中心点坐标w, h是边界框的宽度和高度(x1, y1)是左上角坐标,(x2, y2)是右下角坐标置信度表示模型对这个检测结果的信任程度
2.2 目标检测与其他计算机视觉任务的关系
| 任务 | 核心能力 | 输出 | 示例应用 |
|---|---|---|---|
| 图像分类 | 识别是什么 | 类别标签 | 手写数字识别 |
| 目标检测 | 识别是什么+在哪里 | 边界框+类别 | 智能监控 |
| 实例分割 | 识别是什么+在哪里+精确轮廓 | 像素级掩码+类别 | 自动驾驶视觉系统 |
| 图像分割 | 识别每个像素的类别 | 像素级类别图 | 医学影像分析 |
三、目标检测的历史演进
目标检测技术的发展可以分为三个主要阶段:
3.1 传统目标检测时代(1990s-2010s)
在深度学习兴起之前,目标检测主要依赖手工设计的特征和传统机器学习算法:
- 滑动窗口法:在图像上滑动不同大小和比例的窗口,对每个窗口进行分类
- 特征提取:使用HOG(方向梯度直方图)、SIFT(尺度不变特征变换)等手工设计特征
- 分类器:使用SVM、AdaBoost等传统机器学习算法进行分类
代表算法:
- Viola-Jones人脸检测器(2001年):使用Haar特征和AdaBoost,是第一个实时人脸检测算法
- DPM(可变形部件模型,2008年):将目标分解为多个部件,使用HOG特征
局限性:
- 手工特征设计依赖专业知识
- 检测速度慢,难以处理复杂场景
- 准确率有限,特别是对小目标和遮挡目标
3.2 基于区域的深度学习时代(2013-2015)
2012年AlexNet在ImageNet比赛中的成功,标志着深度学习时代的到来。目标检测也开始采用深度学习:
代表算法:
-
R-CNN(Region-CNN,2013年):
- 使用选择性搜索(Selective Search)生成约2000个候选区域
- 对每个候选区域进行缩放,输入CNN提取特征
- 使用SVM进行分类,回归器修正边界框
-
Fast R-CNN(2015年):
- 对整幅图像进行一次CNN特征提取
- 使用RoI Pooling层从特征图中提取候选区域特征
- 共享卷积计算,大幅提高速度
-
Faster R-CNN(2015年):
- 引入RPN(区域提议网络)自动生成候选区域
- 端到端训练,进一步提高速度和准确率
3.3 单阶段检测时代(2015至今)
为了追求更快的检测速度,单阶段检测器应运而生:
代表算法:
-
YOLO(You Only Look Once,2016年):
- 将图像分割为S×S的网格
- 每个网格预测B个边界框和类别概率
- 单次前向传播完成检测,速度极快
-
SSD(Single Shot MultiBox Detector,2016年):
- 从不同尺度的特征图中检测目标
- 使用不同大小的先验框,适合多尺度目标
-
YOLOv2-v5(2017至今):
- YOLOv2:引入批量归一化、Anchor Box、细粒度特征
- YOLOv3:使用多尺度检测、残差网络、FPN结构
- YOLOv4:结合了多种先进技术,如CSPDarknet、PANet、SAM
- YOLOv5:优化了模型架构和训练流程,提供不同尺度的模型
- YOLOv6:引入RepVGG骨干网络、PAN优化结构、量化感知训练
- YOLOv7:使用ELAN网络结构、复合缩放方法、扩展高效头
- YOLOv8:采用CSPDarknetv5、PFN-PAN特征融合、Anchor-Free检测头
YOLO系列的创新点:
| 版本 | 主要创新 | 速度(FPS) | 准确率(mAP) |
|---|---|---|---|
| YOLOv1 | 单阶段检测 | 45 | 63.4 |
| YOLOv2 | Anchor Box、Batch Norm | 67 | 76.8 |
| YOLOv3 | 多尺度检测、FPN | 30 | 83.2 |
| YOLOv4 | CSPDarknet、PANet | 65 | 87.2 |
| YOLOv5 | 灵活架构、自动锚框 | 140 | 89.0 |
| YOLOv6 | RepVGG、量化感知训练 | 300+ | 80.0 |
| YOLOv7 | ELAN、复合缩放 | 161 | 91.3 |
| YOLOv8 | Anchor-Free、CSPDarknetv5 | 180 | 92.0 |
四、目标检测的核心技术原理
4.1 两阶段检测器:以Faster R-CNN为例
Faster R-CNN是典型的两阶段检测器,其工作流程如下:
1. 特征提取:使用卷积神经网络(如VGG、ResNet)对输入图像进行特征提取,得到特征图
2. 区域提议网络(RPN):
- 在特征图上滑动一个小网络
- 每个滑动窗口预测多个边界框(Anchor Box)和两个分数:
- 前景分数(表示该区域是否包含目标)
- 背景分数(表示该区域是否为背景)
- 使用非极大值抑制(NMS)筛选出高质量的候选区域
3. RoI Pooling:
- 将不同大小的候选区域映射到固定大小的特征图
- 方便后续全连接层处理
4. 分类与回归:
- 对每个候选区域进行分类(预测目标类别)
- 对边界框进行回归(修正边界框位置)
5. 后处理:
- 使用NMS去除重叠的检测结果
- 输出最终的检测结果
Faster R-CNN的创新之处:
- 端到端训练,不需要外部区域提议方法
- 共享卷积计算,提高检测速度
- RPN网络可以学习生成高质量的候选区域
4.2 单阶段检测器:以YOLOv3为例
YOLOv3是流行的单阶段检测器,其工作流程如下:
1. 输入处理:将输入图像调整为416×416大小
2. 特征提取:使用Darknet-53网络提取特征,该网络包含53个卷积层,使用残差连接
3. 特征金字塔网络(FPN):
- 从三个不同尺度的特征图(13×13、26×26、52×52)进行检测
- 大尺度特征图(13×13)检测大目标,小尺度特征图(52×52)检测小目标
4. 检测头:
- 每个尺度的特征图上,每个网格预测3个边界框
- 每个边界框包含:
- 4个坐标值(中心x、y和宽w、高h)
- 1个置信度分数(表示该框是否包含目标)
- 80个类别概率(COCO数据集)
5. 后处理:
- 过滤掉低置信度的检测结果
- 使用NMS去除重叠的边界框
- 输出最终的检测结果
YOLOv3的输出格式 :
对于416×416的输入图像,YOLOv3的输出是三个尺度的张量:
- 13×13×255
- 26×26×255
- 52×52×255
其中255 = 3个边界框 × (4个坐标 + 1个置信度 + 80个类别) = 3×85
4.2.1 新一代检测器:YOLOv8
YOLOv8是Ultralytics公司于2023年发布的最新YOLO系列检测器,它在保持YOLO系列一贯的速度优势的同时,进一步提升了检测精度。
YOLOv8的网络结构:
1. 输入处理:
- 支持多种输入尺寸(默认640×640)
- 自动图像增强(Mosaic、MixUp、RandomAffine等)
- 自适应锚框计算
2. 特征提取:
- 使用CSPDarknetv5作为骨干网络
- 引入C2f模块替代YOLOv5的C3模块,增加梯度流
- 更高效的残差连接和特征提取
3. 特征融合:
- 采用PFN-PAN(Path Aggregation Network with PAFPN-like neck)结构
- 自下而上的特征融合(高分辨率到低分辨率)
- 自上而下的特征融合(低分辨率到高分辨率)
- 增强多尺度特征的表达能力
4. 检测头:
- 采用Anchor-Free检测头,不再依赖预定义锚框
- 使用Decoupled Head(解耦头)分离分类和回归任务
- 分类头使用交叉熵损失,回归头使用CIoU损失
- 三个尺度的特征图(80×80、40×40、20×20)进行检测
5. 后处理:
- 支持两种后处理模式:传统NMS和Soft NMS
- 自动置信度过滤和边界框过滤
- 支持批量处理
YOLOv8的创新点:
- Anchor-Free设计:不再需要预定义锚框,减少了超参数调整,提高了检测效率
- C2f模块:增强了特征提取能力,提高了模型精度
- Decoupled Head:分离分类和回归任务,使模型更容易优化
- PFN-PAN特征融合:更高效的特征融合方式,提升多尺度检测能力
- 灵活的模型架构:提供n、s、m、l、x五个尺度的模型,满足不同场景需求
- 完善的训练框架:支持自动混合精度训练、梯度累积、模型蒸馏等
YOLOv8的输出格式 :
对于640×640的输入图像,YOLOv8的输出是三个尺度的张量:
- 80×80×(4+1+80):小目标检测
- 40×40×(4+1+80):中目标检测
- 20×20×(4+1+80):大目标检测
其中(4+1+80)表示4个坐标值、1个置信度和80个类别概率(COCO数据集)
4.3 关键技术概念
4.3.1 Anchor Box(锚框)
Anchor Box是一组预定义的边界框,具有不同的宽高比和大小。它们的作用是:
- 帮助模型学习检测不同形状的目标
- 减少模型需要学习的参数数量
- 提高检测的准确率
以Faster R-CNN为例,通常会定义9种不同的Anchor Box(3种尺度 × 3种宽高比)。
4.3.2 非极大值抑制(NMS)
非极大值抑制是一种用于去除重叠检测框的算法,步骤如下:
- 将所有检测框按置信度从高到低排序
- 选择置信度最高的检测框作为当前框
- 计算当前框与其他所有框的IoU(交并比)
- 去除IoU大于阈值(通常为0.5-0.7)的检测框
- 重复步骤2-4,直到所有框都处理完毕
4.3.3 IoU(交并比)
IoU是评估边界框准确性的重要指标,计算公式为:
IoU = 重叠区域面积 / 联合区域面积IoU的值在0到1之间,越接近1表示边界框越准确。
4.3.4 损失函数
目标检测的损失函数通常包括三部分:
- 分类损失:衡量模型分类的准确性(如交叉熵损失)
- 定位损失:衡量边界框回归的准确性(如平滑L1损失)
- 置信度损失:衡量模型对检测结果的信心(如二元交叉熵损失)
五、目标检测的应用场景
5.1 智能安防
- 实时监控:自动检测行人、车辆、异常行为
- 人脸识别:在人群中识别特定人员
- 入侵检测:检测未经授权的进入
5.2 自动驾驶
- 障碍物检测:检测行人、车辆、自行车等
- 交通标志识别:识别红绿灯、限速标志等
- 车道检测:检测车道线和道路边界
5.3 零售领域
- 货架管理:检测货架上的商品和库存
- 顾客行为分析:分析顾客的购物行为
- 自助结账:自动识别购物车中的商品
5.4 医疗健康
- 医学影像分析:检测肿瘤、病变区域
- 手术辅助:实时跟踪手术器械和解剖结构
- 疾病筛查:自动检测疾病症状
5.5 农业领域
- 作物检测:检测农作物的生长情况
- 病虫害识别:识别作物的病虫害
- 产量预测:基于作物检测的产量预测
5.6 机器人
- 物体识别与抓取:帮助机器人识别和抓取物体
- 环境感知:帮助机器人理解周围环境
- 导航避障:帮助机器人避开障碍物
六、目标检测的实现
下面我们将实现两个目标检测模型:YOLOv3(使用OpenCV DNN模块)和YOLOv8(使用Ultralytics库)。
6.1 YOLOv3实现(基于OpenCV DNN)
6.1.1 安装依赖
bash
pip install tensorflow opencv-python numpy6.1.2 加载预训练模型
python
import cv2
import numpy as np

# 加载YOLOv3模型和配置文件
net = cv2.dnn.readNet("yolov3.weights", "yolov3.cfg")

# 加载COCO数据集的类别标签
with open("coco.names", "r") as f:
    classes = [line.strip() for line in f.readlines()]

# 获取输出层信息
layer_names = net.getLayerNames()
output_layers = [layer_names[i - 1] for i in net.getUnconnectedOutLayers()]
6.1.3 检测函数实现
python
def detect_objects(image_path):
    # 读取图像
    img = cv2.imread(image_path)
    height, width, channels = img.shape

    # 图像预处理
    blob = cv2.dnn.blobFromImage(img, 0.00392, (416, 416), (0, 0, 0), True, crop=False)
    net.setInput(blob)

    # 前向传播
    outs = net.forward(output_layers)

    # 解析检测结果
    class_ids = []
    confidences = []
    boxes = []

    for out in outs:
        for detection in out:
            scores = detection[5:]
            class_id = np.argmax(scores)
            confidence = scores[class_id]

            if confidence > 0.5:
                # 计算边界框坐标
                center_x = int(detection[0] * width)
                center_y = int(detection[1] * height)
                w = int(detection[2] * width)
                h = int(detection[3] * height)

                # 转换为左上角坐标
                x = int(center_x - w / 2)
                y = int(center_y - h / 2)

                boxes.append([x, y, w, h])
                confidences.append(float(confidence))
                class_ids.append(class_id)

    # 非极大值抑制
    indexes = cv2.dnn.NMSBoxes(boxes, confidences, 0.5, 0.4)

    # 绘制检测结果
    colors = np.random.uniform(0, 255, size=(len(classes), 3))

    for i in range(len(boxes)):
        if i in indexes:
            x, y, w, h = boxes[i]
            label = str(classes[class_ids[i]])
            color = colors[class_ids[i]]
            confidence = confidences[i]

            cv2.rectangle(img, (x, y), (x + w, y + h), color, 2)
            cv2.putText(img, f"{label} {confidence:.2f}", (x, y - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.5, color, 2)

    return img
6.2 YOLOv8实现(基于Ultralytics库)
6.2.1 安装依赖
bash
pip install ultralytics opencv-python6.2.2 检测实现
python
from ultralytics import YOLO
import cv2

# 加载YOLOv8模型(自动下载预训练权重)
model = YOLO("yolov8n.pt")  # 可以选择不同尺度:n, s, m, l, x

# YOLOv8检测函数
def detect_objects_yolov8(image_path, conf_threshold=0.5):
    # 读取图像
    img = cv2.imread(image_path)

    # 使用模型进行检测
    results = model(img, conf=conf_threshold)

    # 绘制检测结果
    annotated_img = results[0].plot()

    return annotated_img
6.3 使用模型进行检测
python
# 检测图像路径
image_path = "test.jpg"

# 使用YOLOv3检测
print("使用YOLOv3进行检测...")
detected_image_v3 = detect_objects_yolov3(image_path)
cv2.imwrite("detected_result_v3.jpg", detected_image_v3)
print("YOLOv3检测完成,结果已保存为detected_result_v3.jpg")

# 使用YOLOv8检测
print("使用YOLOv8进行检测...")
detected_image_v8 = detect_objects_yolov8(image_path)
cv2.imwrite("detected_result_v8.jpg", detected_image_v8)
print("YOLOv8检测完成,结果已保存为detected_result_v8.jpg")

# 显示YOLOv8检测结果
cv2.imshow("YOLOv8 Object Detection", detected_image_v8)
cv2.waitKey(0)
cv2.destroyAllWindows()
6.4 注意事项
YOLOv3注意事项:
- 需要下载YOLOv3的预训练权重文件(yolov3.weights)和配置文件(yolov3.cfg)
- 需要下载COCO数据集的类别标签文件(coco.names)
- 可以根据需要调整置信度阈值和NMS阈值
YOLOv8注意事项:
- Ultralytics库会自动下载YOLOv8的预训练权重
- YOLOv8提供多种尺度模型:n(ano)、s(mall)、m(edium)、l(arge)、x(large)
- 可以通过conf参数调整置信度阈值
- 支持GPU加速(如果环境配置了CUDA)
- 可以通过device参数指定使用CPU或GPU:model(img, device='cpu')或model(img, device='0')
七、目标检测的评估指标
7.1 精确率(Precision)和召回率(Recall)
-
精确率:检测为正例的样本中,实际为正例的比例
Precision = TP / (TP + FP) -
召回率:实际为正例的样本中,被检测为正例的比例
Recall = TP / (TP + FN)
其中:
- TP(True Positive):正确检测到的目标
- FP(False Positive):误检测到的目标
- FN(False Negative):未检测到的目标
7.2 mAP(mean Average Precision)
mAP是目标检测中最常用的评估指标,计算步骤如下:
- 对每个类别,绘制Precision-Recall曲线
- 计算每个类别的AP(Average Precision),即PR曲线下的面积
- 计算所有类别的AP的平均值,得到mAP
mAP的值在0到1之间,越接近1表示模型性能越好。
7.3 FPS(Frames Per Second)
FPS表示每秒处理的图像帧数,是衡量模型速度的重要指标:
- FPS越高,模型处理速度越快
- 实时应用通常要求FPS≥25
- 不同的应用场景对FPS的要求不同
八、目标检测的挑战与解决方案
8.1 常见挑战
- 小目标检测:小目标像素少,特征不明显
- 遮挡问题:目标被部分或完全遮挡
- 多尺度目标:同一图像中目标大小差异大
- 复杂背景:目标与背景颜色或纹理相似
- 实时性要求:某些应用需要实时检测
- 数据集偏差:训练数据与实际场景差异大
8.2 解决方案
1. 小目标检测解决方案:
- 使用高分辨率输入图像
- 特征金字塔网络(FPN)
- 多尺度检测
- 数据增强(如缩放、裁剪)
2. 遮挡问题解决方案:
- 使用注意力机制
- 部分检测(检测可见部分)
- 上下文信息融合
3. 多尺度目标解决方案:
- 特征金字塔网络
- 自适应锚框
- 图像金字塔
4. 复杂背景解决方案:
- 语义分割辅助
- 注意力机制
- 更强大的特征提取网络
5. 实时性解决方案:
- 轻量级网络(如MobileNet、ShuffleNet)
- 模型蒸馏
- 量化和剪枝
- 硬件加速(GPU、TPU、NPU)
6. 数据集偏差解决方案:
- 数据增强
- 迁移学习
- 领域自适应
- 合成数据生成
九、目标检测的发展趋势
9.1 技术发展趋势
-
端到端目标检测:进一步简化检测流程,提高性能
-
Transformer在目标检测中的应用:
- DETR(Detection Transformer)
- ViT(Vision Transformer)在目标检测中的应用
-
自监督学习:减少对标注数据的依赖
-
小样本目标检测:在少量标注数据下实现高精度检测
-
多模态目标检测:结合图像、文本、音频等多种模态
-
三维目标检测:从2D检测扩展到3D检测
9.2 应用发展趋势
- 边缘计算:将检测模型部署到边缘设备,减少延迟
- 联邦学习:在保护隐私的前提下训练检测模型
- 实时视频分析:处理高清、高帧率视频
- 跨域目标检测:在不同场景间迁移检测能力
- 人机协作:AI辅助人类完成检测任务
十、目标检测的意义
10.1 让机器理解世界
目标检测是机器理解视觉世界的重要一步。通过检测和定位目标,机器能够建立起对世界的基本认知,为更高级的智能行为打下基础。
10.2 平衡速度与精度
目标检测技术的发展,体现了人类在追求速度与精度平衡上的智慧。从两阶段检测器到单阶段检测器,从R-CNN到YOLO,每一次技术进步都是在速度与精度之间寻找更好的平衡点。
10.3 从感知到行动
目标检测不仅仅是一种感知技术,更是连接感知与行动的桥梁。在自动驾驶、机器人等领域,准确的目标检测是做出正确决策的前提。
10.4 技术的边界与伦理
随着目标检测技术的发展,我们也需要思考技术的边界和伦理问题:
- 隐私保护:如何在使用目标检测技术的同时保护个人隐私?
- 算法偏见:如何避免检测模型对某些群体的偏见?
- 安全风险:如何防止技术被滥用?
总结
目标检测是计算机视觉领域的核心技术之一,它让机器能够"看到"并"理解"图像中的目标。从传统的滑动窗口法到现代的深度学习方法,目标检测技术经历了飞速的发展。
如今,目标检测已经广泛应用于智能安防、自动驾驶、医疗健康等领域,为我们的生活带来了便利。同时,它也面临着小目标检测、遮挡问题、实时性等挑战,需要我们不断探索和创新。
未来,随着Transformer、自监督学习等新技术的应用,目标检测技术将继续发展,为人工智能的进步做出更大的贡献。