输出 查看模型结构 使用print(model) model.name_module() model.named_parameters()等方式查看层级结构
对于vit reanet yolox等常见架构 结合官方文档和源吗
确定可冻结/可训练的模块 在vit中 可以冻结 patch_embed 和前几层blocks 只微调后面几层+分类头
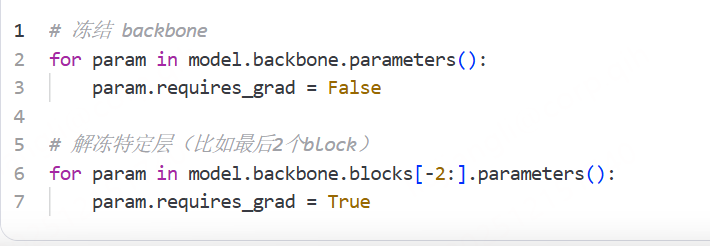
通过requires_grad控制梯度更新 冻结backbone 解冻特定层
微调的时候 不同模块用不同的学习率
还有的是在不同的epoch使用不同的学习率
学习率调度知识点:
按epoch变化 step decay 阶梯衰减 每隔固定epoch 学习率*一个衰减因子
多阶段衰减,在预设的epoch节点 衰减
linear warmup_decay 线性预热+衰减 前几个epoch线性增加 learning rate 之后按照step/cosine衰减
啥是cosine decay?余弦衰减 学习率就像余弦的图像一样衰减下来
关于早停机制、保存最佳模型、最终模型是否最优
在深度学习训练中,训练loss会持续下降,但是验证指标(比如准确率 mAp f1 )往往会线上升后下降 这就是过拟合
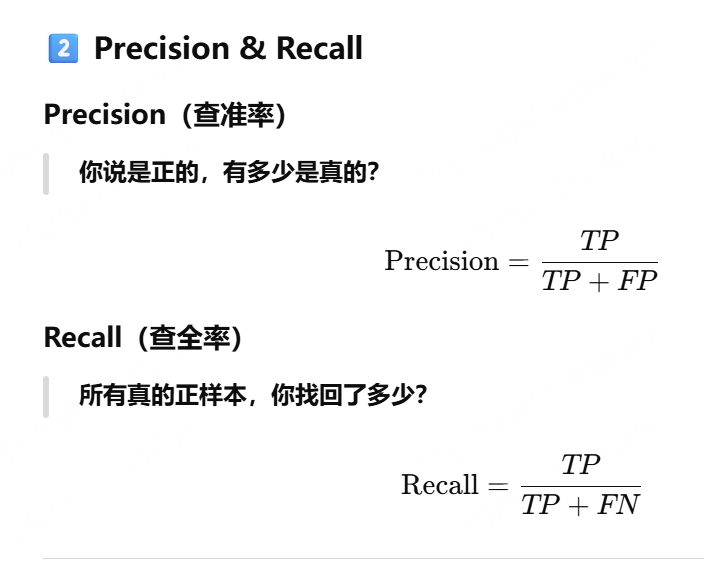
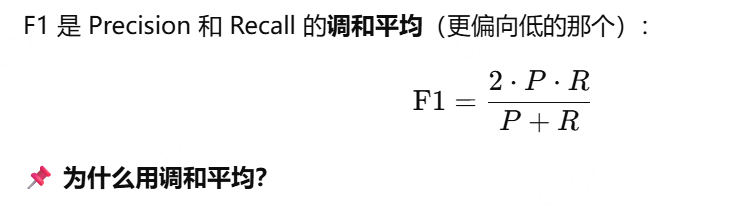
F1的计算就是:
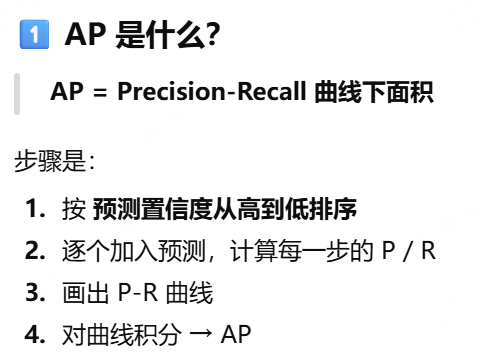
不能只是保存最后的checkpoint 而是要监控验证指标,保存历史最佳
最好的标准是自己决定的:你所关心的指标达到最优就是 最好
早停机制 :当模型在验证集上不再变好时,提前终止训练, 在每个epoch 或者是n个step 在验证集上评估指标 如果连续 m个epoch没有提升,就停止训练
让我想起了一个叫做优化器的东西。
optimizer = torch.optim.AdamW(
model.parameters(),#model.parameters这些参数是需要被更新的
lr=5e-5,#学习率
weight_decay=0.05,#衰减
betas=(0.9, 0.98) # ViT 常用 beta1=0.9 当前梯度占0.1 过去梯度占0.9 beta2=0.98梯度平方的平滑,控制步长缩放,防止某些参数更新太猛
scheduler = get_cosine_schedule_with_warmup(
optimizer,
num_warmup_steps=500,#学习率这样持续500个step 注意step和epoch的区别 训练一次就能看出来了 epoch是多个step
num_training_steps=total_steps
)