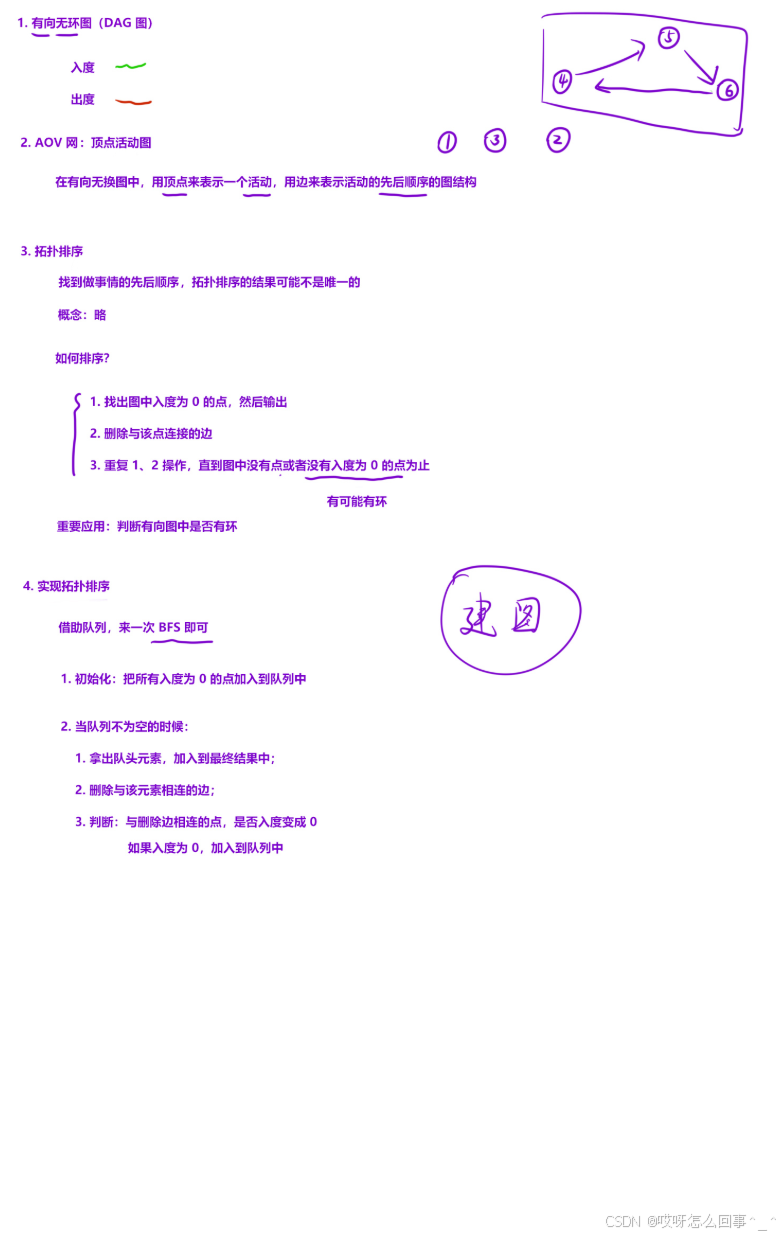
拓扑排序简介:
207. 课程表 - 力扣(LeetCode)
class Solution
{
public:
bool canFinish(int numCourses, vector<vector<int>>& prerequisites)
{
unordered_map<int, vector<int>> egdes; // 图
vector<int> in(numCourses, 0); // 每个点的入度
for(int i = 0; i < prerequisites.size(); i++)
{
int a = prerequisitesi0, b = prerequisitesi1;
egdesb.push_back(a);
ina++;
}
queue<int> q;
// 将入度为0的进队列开始BFS
for(int i = 0; i < in.size(); i++)
{
if(ini == 0) q.push(i);
}
while(q.size())
{
int t = q.front();
q.pop();
for(auto& i : egdest)
{
ini--;
if(ini == 0) q.push(i);
}
}
for(int i = 0; i < in.size(); i++)
{
if(ini != 0) return false;
}
return true;
}
};
// 一次拓扑排序看最终能不能将所有点排完,排不完说明存在环,则返回false
// 利用STL容器建图,记录有向边
// 记录每一个点的入度
// BFS,每次选择入度为0的点拿出来相当于给这些点排序了,之后把图中和这些点相连的边删掉,那么一定有的点的入度会减少
// 之后将入度减为0的点再次BFS,看最终存不存在入度不为0的点,存在则不能全部排序
210. 课程表 II - 力扣(LeetCode)
class Solution
{
public:
vector<int> findOrder(int numCourses, vector<vector<int>>& prerequisites)
{
unordered_map<int, vector<int>> edges;
vector<int> in(numCourses);
int a = 0, b = 0;
for(int i = 0; i < prerequisites.size(); i++)
{
a = prerequisitesi0;
b = prerequisitesi1;
edgesb.push_back(a);
ina++;
}
queue<int> q;
for(int i = 0; i < numCourses; i++)
{
if(ini == 0) q.push(i);
}
vector<int> ret;
while(q.size())
{
int t = q.front();
q.pop();
ret.push_back(t);
for(auto& i : edgest)
{
ini--;
if(ini == 0) q.push(i);
}
}
for(int i = 0; i < numCourses; i++)
{
if(ini != 0) return {};
}
return ret;
}
};
// 和课程表那题区别就是需要记录点的顺序
// 那么只需要在BFS出队列时,用一个数组记录即可
LCR 114. 火星词典 - 力扣(LeetCode)
class Solution
{
public:
string alienOrder(vector<string>& words)
{
int n = words.size();
unordered_map<char, unordered_set<char>>edges;
unordered_map<char, int>in;
// 初始化记录入度的哈希表
for(auto& str : words)
{
for(auto& c : str) inc = 0;
}
// 两层for循环收集信息
for(int i = 0; i < n; i++)
{
for(int j = i + 1; j < n; j++)
{
// 下面情况就是合法的,此时只需要找出两个字符串中第一对不同的字符即可,这就是一个记录
int p = 0;
char start = 'a', end = 'a';
while(p < wordsi.size() && p < wordsj.size())
{
if(wordsip != wordsjp)
{
start = wordsip;
end = wordsjp;
break;
}
p++;
}
// 处理出错情况,即abc在ab前面或者a->b和b->a同时出现
if((start == end && wordsi.size() > wordsj.size()) || (edgesend.count(start))) return {};
// 有可能是ab、abc的情况此时不需要记录,即start和end相同
if(start != end)
{
if (!edgesstart.count(end)) inend++; // 避免冗余统计多的入度,若是start->end已经存在就不需要增加end的入度
edgesstart.insert(end);
}
}
}
// BFS
queue<char> q;
string ret;
// 先进入度为0的点
for(auto& ch, cnt : in)
{
if(cnt == 0) q.push(ch);
}
while(q.size())
{
char t = q.front(); q.pop();
ret += t;
// 更新t指向的点的入度,即--
for(auto& ch : edgest)
{
inch--;
if(inch == 0) q.push(ch);
}
}
return ret;
}
};
// 两层for循环统计信息,即固定一个字符串遍历剩下的字符串;
// 出现例如abc、ab的情况就出错,因为理应是ab<abc,但是在words中表明的是abc<ab,这种情况直接返回{}
// 建图:用哈希表,统计信息当比较两个字符串时,会得出两个字符的顺序(例如a->b),此时记录在哈希表中,但是可能会出现很多a->b,所以要避免冗余
// 那么哈希表应该是unordered_map<char, unordered_set<char>>edges,a->b时就是edgesa.push(b),unordered_set不支持重复值
// 入度:用数组但是并不是每个字符都出现,在开始记录入度为0的点时可能出错,比如例一中a没有出现,但是也会被当作入度为为0的点进队列
// 用哈希表unordered_map<char, int>in 但是在最开始要初始化,将出现的字符进哈希表并且入度初始化为0。若是没有初始化那么入度为0的字符,不会进入这个哈希表,因为统计入度时是统计有向边指向的字符,例如a->b此时inb++,若是没有字符指向a,那么a进不了in,那么队列的初始值就没了,无法正确BFS