记录xgboost等基于决策树的集成模型存在的问题

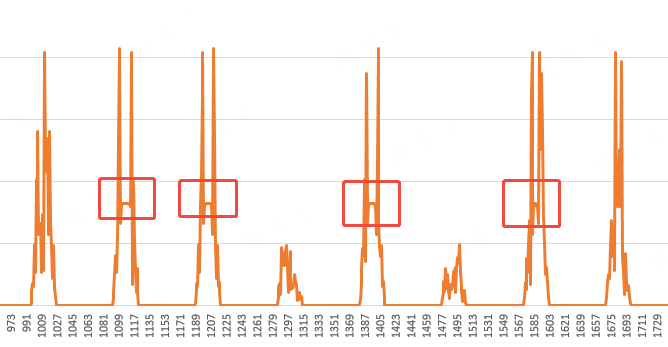
最近做基于辐照度的光伏预测,在数据量很少的情况下,采用xgboost遇到一个问题,就是预测值在正午时分全部是一样的,经过多轮测试及与豆包对话找到了原因。

豆包解释:XGBoost 的预测特性:XGBoost 对于超出训练数据分布的特征值,预测结果会趋于一个固定值(你的情况就是 0.07105778),这是模型的泛化特性导致的。

XGBoost(以及所有基于决策树的集成模型,如随机森林、LightGBM)之所以会出现 "遇到超出训练范围的特征值时,预测值趋于常数" 的现象,是因为决策树是基于 "轴平行" 的分裂(Axis-Aligned Splitting)。

简单来说,树模型在训练数据的最大值(例如 GHI=1.0)之后,就没有继续分裂的规则了,它不知道 1.0 之后的趋势是上升、下降还是保持不变,因此只能输出该叶子节点上训练数据的平均值。

当然和豆包说的不完全一致,因为我的ghi归一化后确定没有超过1.0,所以我怀疑主要原因是数据量太少(10天左右),加上ghi和光伏数据归一化后范围比较小(荷兰冬季辐照度最高只有200多,发电效率只有20~30%),综合导致这种问题。

换成线性模型后不再出现这种问题。
相关推荐
一水鉴天5 小时前
同一与唯一:AppBus 外壳与 DevOps 内核 之1 20261121(元宝)
人工智能·机器学习
伞伞悦读7 小时前
【第92期】逻辑回归的分数概率与阈值的实验与排查
人工智能·python·深度学习·机器学习
电科_银尘9 小时前
【大模型算法与工程 27】训练配方:批量、学习率、精度与梯度裁剪
学习·算法·机器学习
硅谷秋水15 小时前
面向精确到达任务的机器人-对齐3D高斯溅射方法——基于腕部-相机VLA策略
数码相机·机器学习·计算机视觉·3d·机器人
龙腾AI白云16 小时前
数字孪生与计算机视觉:让机器看懂现场
大数据·数据库·机器学习·知识图谱·pygame
高洁011 天前
数字孪生与计算机视觉:让机器看懂现场
人工智能·python·机器学习·transformer·迁移学习
在所不辞兄1 天前
为什么数字孪生驱动的产线标定需要在线更新机制,而不能一次标定后长期沿用?
人工智能·神经网络·其他·算法·机器学习
Oiiouui1 天前
原始CNN识别与训练模型实现
神经网络·机器学习·cnn
罗西的思考1 天前
【轻量化复现大模型 / KIMI K3】训练模块梳理 & Muon P2P 优化器
人工智能·深度学习·机器学习