DeepSeek-OCR 发布于25年10月,而这次DeepSeek-OCR 2发布仅隔了三个月。这会不会是DeepSeek V4发布前上的前菜呢?让我们一起尝尝鲜吧。
github地址:https://github.com/deepseek-ai/DeepSeek-OCR-2
一、研究背景
传统视觉语言模型(VLMs)处理视觉令牌时,采用固定的从左上到右下的光栅扫描顺序,搭配固定位置编码,这与人类视觉感知存在本质差异。人类视觉会遵循由语义逻辑驱动的灵活且连贯的扫描模式,尤其在处理布局复杂的图像(如包含复杂版式、公式和表格的文档)时,会进行基于因果关系的顺序处理。
现有模型将2D图像块按预定义光栅扫描顺序展平为1D序列的方式,引入了不必要的归纳偏置,忽略了语义关联。而文档OCR任务中存在的复杂布局顺序、复杂公式和表格等结构化元素,天然携带因果视觉逻辑,需要复杂的推理能力,这使得文档OCR成为验证新型视觉编码方法的理想场景,因此亟需一种更贴近人类视觉编码方式的模型架构。
二、核心工作
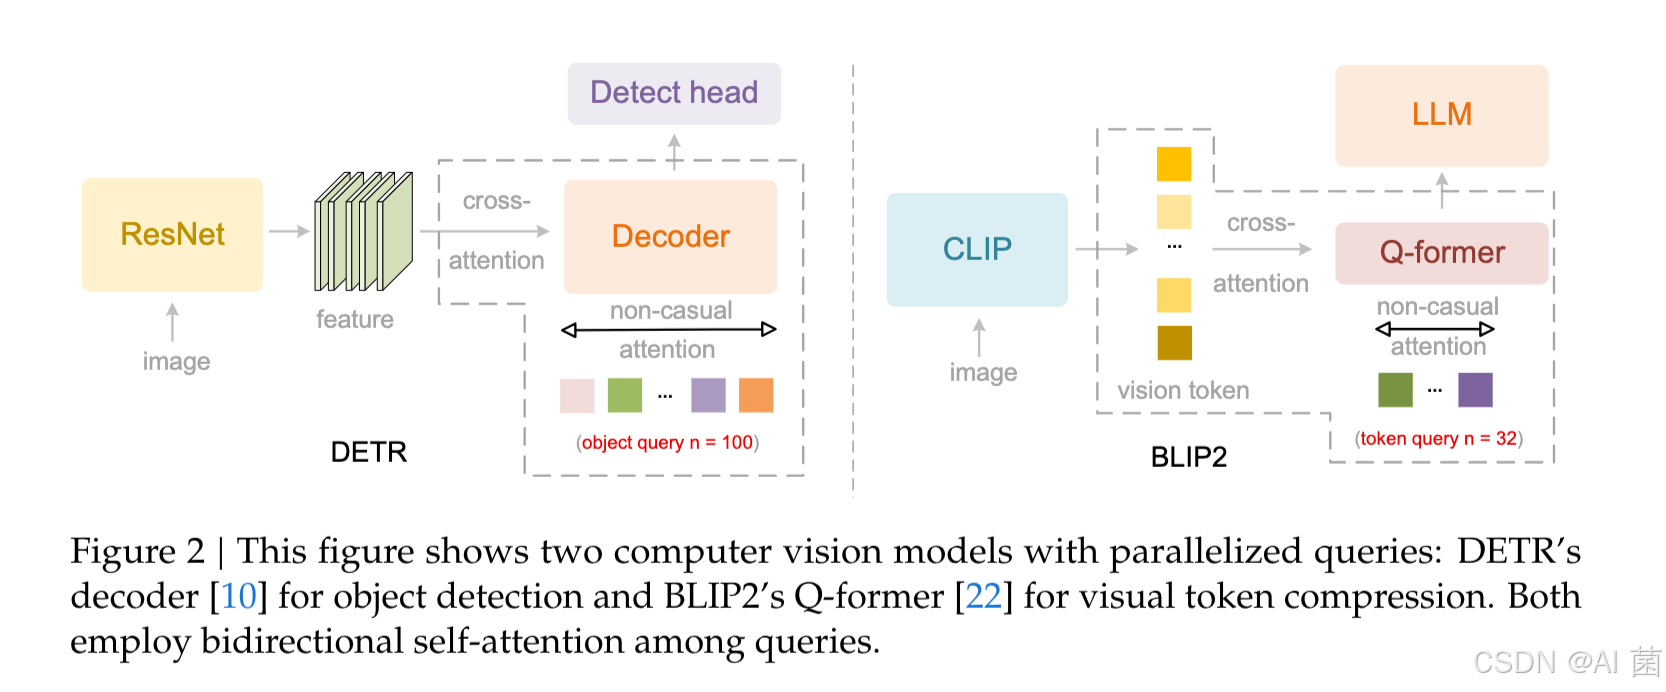
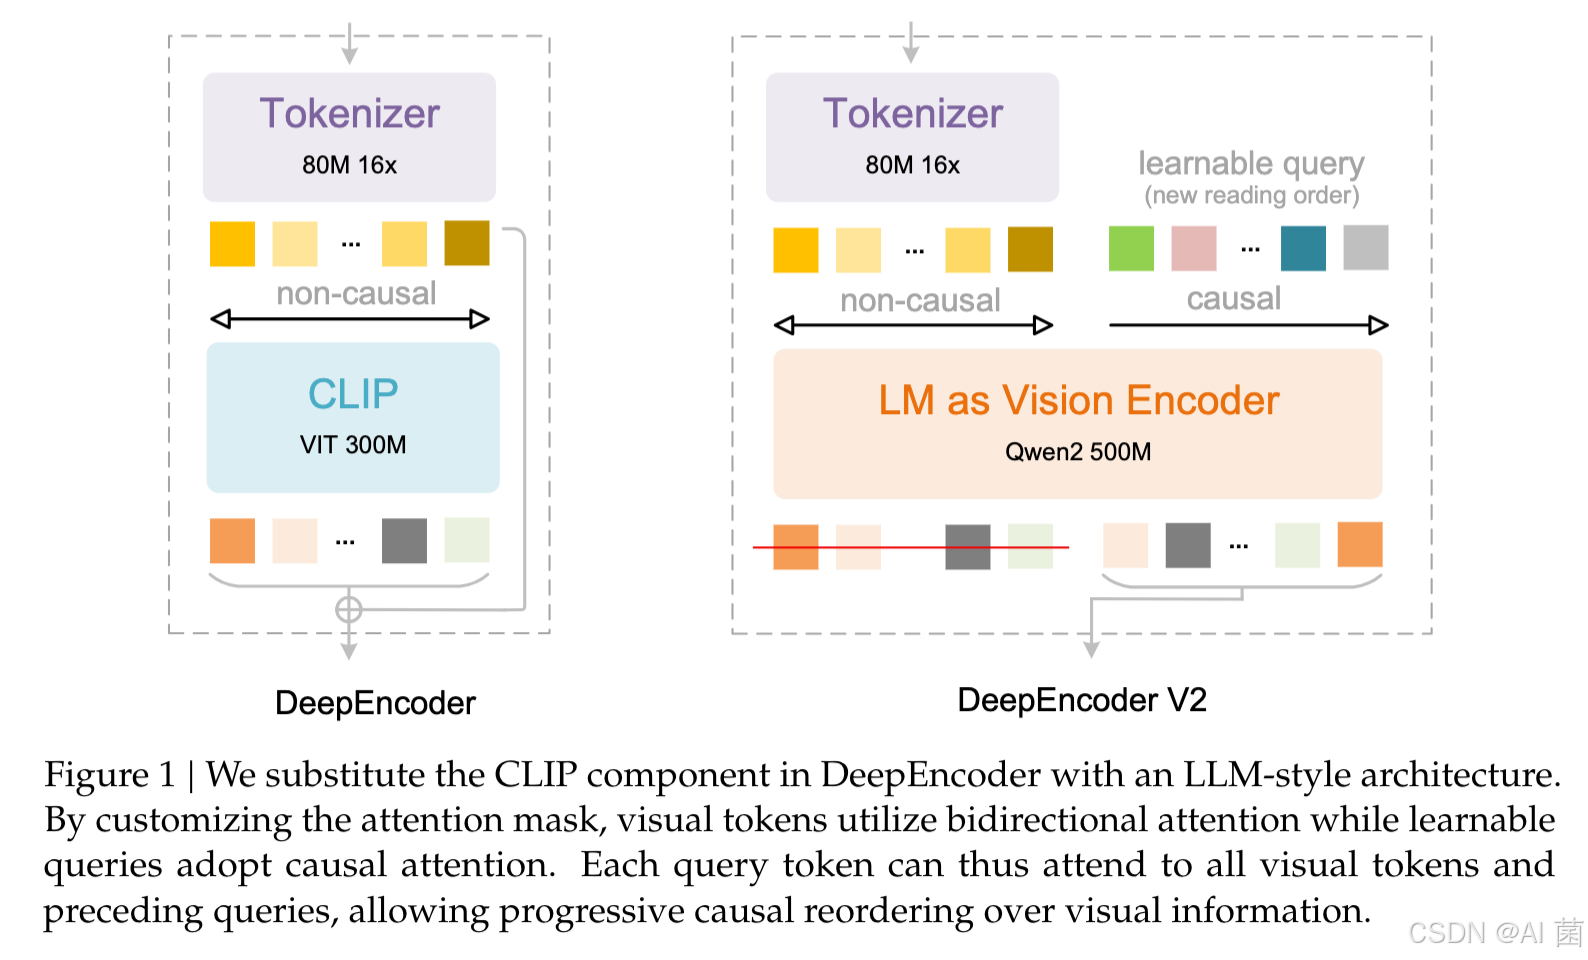
- 提出新型编码器DeepEncoder V2 ,通过融合双向注意力 和因果注意力机制,让视觉编码器具备因果推理能力,实现视觉令牌的语义驱动重排序,突破传统固定扫描顺序的限制。
- 构建DeepSeek-OCR 2模型,在继承DeepSeek-OCR的图像压缩比和解码效率的基础上,显著提升性能,其视觉令牌数量控制在256-1120之间,既保证实用性又具备竞争力。
- 验证了将语言模型架构用作VLM编码器的可行性,为实现统一的全模态编码提供了新路径,该架构可通过配置特定模态的可学习查询,实现跨图像、音频、文本等多种模态的特征提取和令牌压缩。
三、研究方法
3.1 整体架构
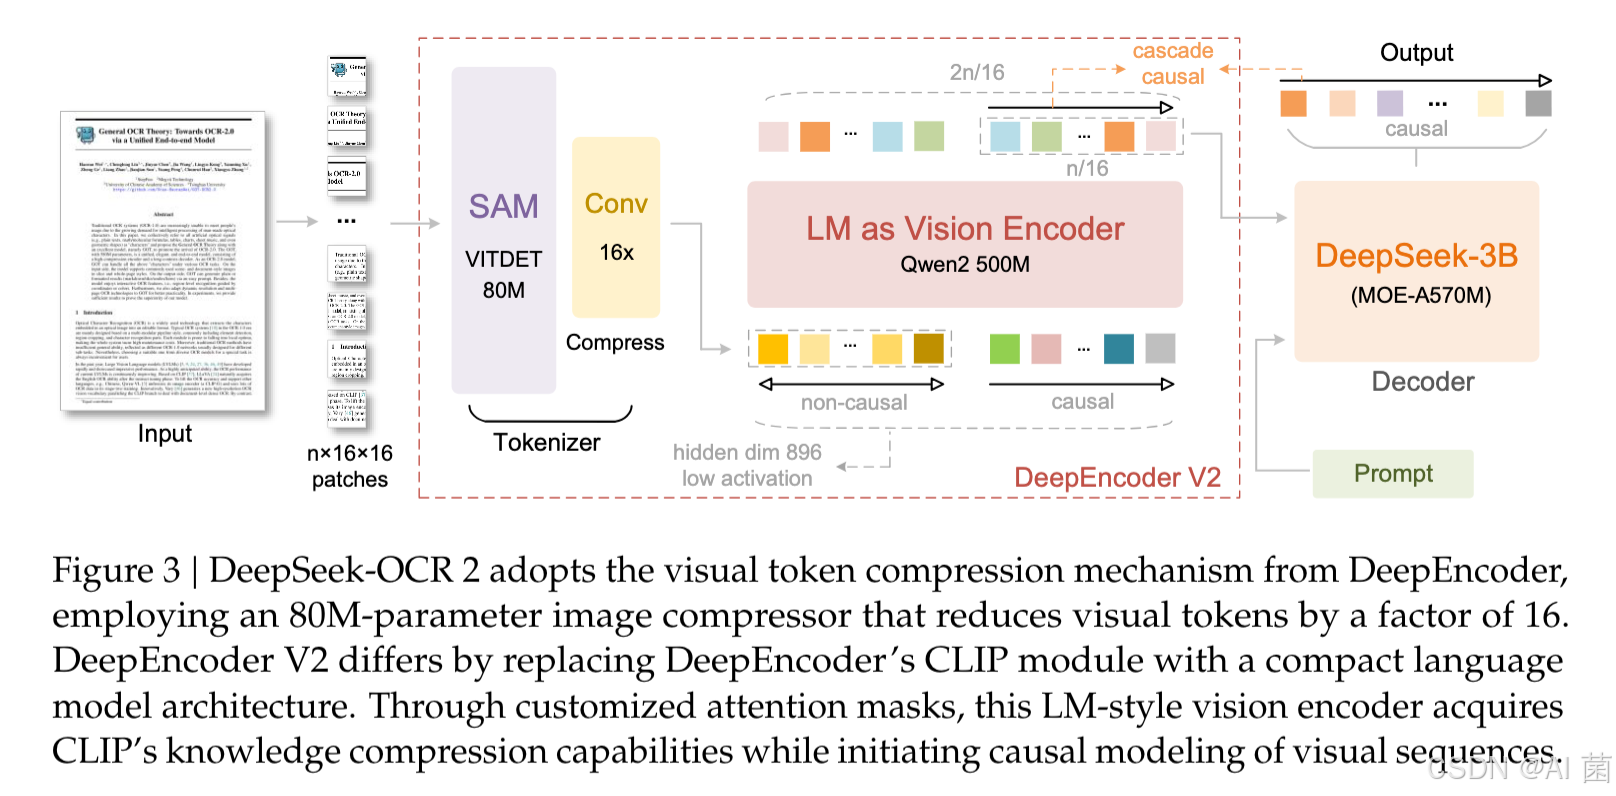
延续DeepSeek-OCR的编码器-解码器架构,编码器负责将图像离散化为视觉令牌,解码器基于视觉令牌和文本提示生成输出,核心改进集中在编码器部分(升级为DeepEncoder V2)。
3.2 DeepEncoder V2关键设计
- 视觉令牌器:采用80M参数的SAM-base与两个卷积层结合的架构,最终卷积层输出维度从1024降至896,实现16倍令牌压缩,平衡计算成本和内存占用。
- 语言模型作为视觉编码器:用Qwen2-0.5B(500M参数)替代DeepEncoder中的CLIP组件,视觉令牌采用双向注意力保留全局建模能力,新增的因果流查询采用因果注意力,且查询与视觉令牌数量相等,仅将因果查询输出送入LLM解码器。
- 因果流查询:采用多裁剪策略,全局视图(1024×1024分辨率)对应256个查询嵌入,局部裁剪(768×768分辨率)可设置0-6个裁剪区域,每个局部视图共享144个查询嵌入,总令牌数为k×144+256(k为局部裁剪数)。
- 注意力掩码 :由双向掩码(用于视觉令牌,支持全令牌可见)和因果三角掩码(用于因果流令牌,仅允许关注前面的令牌)拼接而成,实现特定的注意力机制。
3.3 解码器与训练流程
- 解码器:沿用DeepSeek-OCR的3B参数MoE结构,活跃参数约500M。
- 训练三阶段:
- 第一阶段预训练编码器,使其具备特征提取、令牌压缩和重排序能力;
- 第二阶段查询增强,联合优化LLM编码器和解码器,强化令牌重排序和视觉知识压缩;
- 第三阶段冻结编码器,仅优化解码器,提升训练效率和令牌理解能力。
四、实验设计
4.1 数据设置
采用与DeepSeek-OCR相同的数据源,包括OCR 1.0、OCR 2.0和通用视觉数据,OCR数据占训练混合数据的80%。对数据进行两项优化:
- 对OCR 1.0数据采用更均衡的采样策略,按文本、公式、表格3:1:1的比例划分页面。
- 合并语义相似的布局检测类别。
4.2 基准测试
选用OmniDocBench v1.5作为主要基准,该基准包含1355个文档页面,涵盖9个主要类别,支持中英文,具有多样化测试样本和稳健的评估标准,可全面验证模型在文本、公式、表格识别及阅读顺序等方面的性能。
4.3 评估指标
主要采用整体性能准确率、编辑距离(ED)作为评估指标,包括文本编辑距离、公式CDM、表格TEDs、阅读顺序编辑距离等,编辑距离越低表示性能越好。同时在生产环境中以重复率作为关键质量指标。
五、实验分析
5.1 主要结果
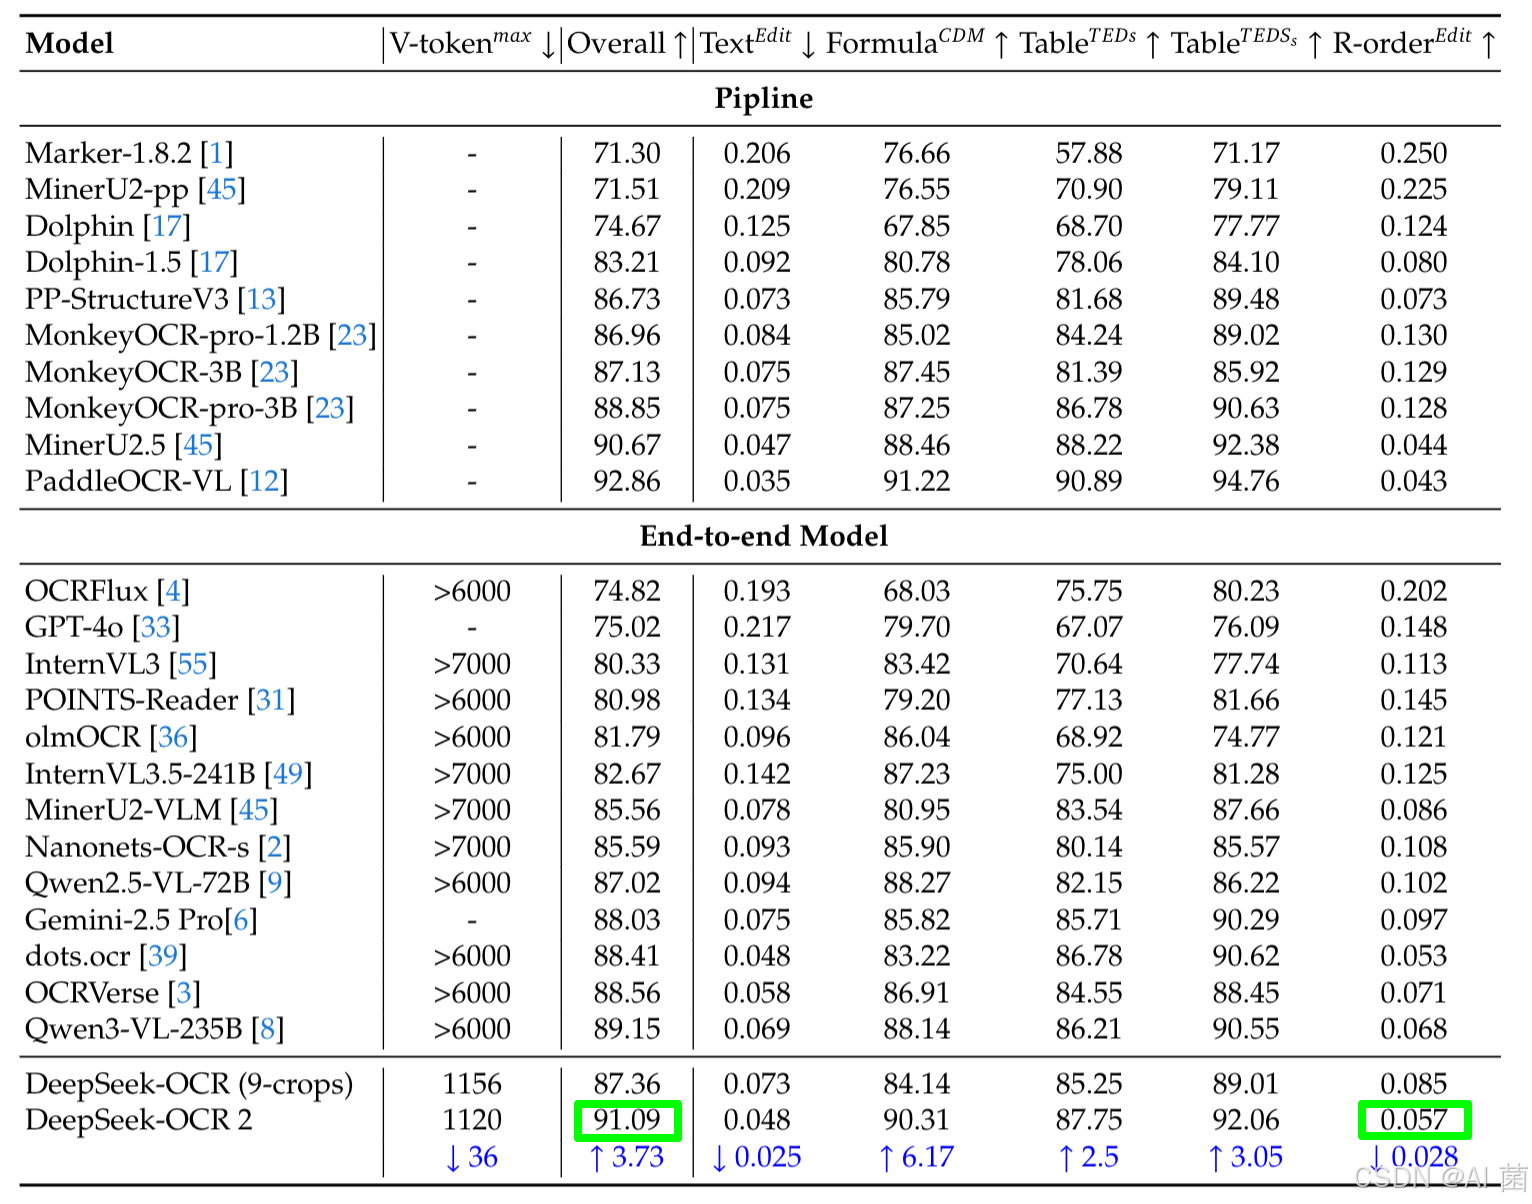
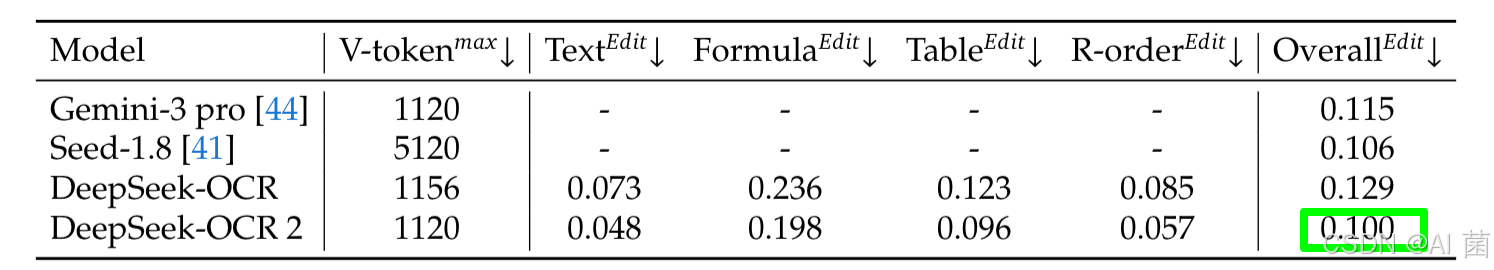
- 在OmniDocBench v1.5上,DeepSeek-OCR 2整体性能达到91.09% ,相比DeepSeek-OCR基准提升3.73%,阅读顺序编辑距离从0.085降至0.057,证明DeepEncoder V2能有效基于图像信息选择和排列视觉令牌。
- 在相同视觉令牌预算(1120)下,DeepSeek-OCR 2的整体编辑距离(0.100)低于Gemini-3 Pro(0.115),在文本、公式、表格的编辑距离上均有优化,体现了其在高压缩率下的优异性能。
5.2 改进空间
- 在报纸类文档的文本识别编辑距离上表现不佳(>0.13 ED),推测原因是视觉令牌上限较低以及相关训练数据不足(仅250k样本)。
- 阅读顺序指标在所有9类文档中均优于DeepSeek-OCR,进一步验证了视觉因果流编码器设计的有效性。
5.3 实际应用性能
在生产场景中,DeepSeek-OCR 2的重复率显著降低,在线用户日志图像的重复率从6.25%降至4.17%,PDF数据生产的重复率从3.69%降至2.88%,提升了实际应用中的实用性。
六、总结
DeepSeek-OCR 2通过引入新型编码器DeepEncoder V2,实现了视觉令牌的因果语义重排序,突破了传统视觉语言模型固定扫描顺序的局限。该模型在保持高视觉令牌压缩率和解码效率的同时,显著提升了文档OCR任务的性能,尤其在阅读顺序和多类型文档元素识别上表现突出。
此外,论文验证了语言模型架构作为VLM编码器的可行性,为统一全模态编码奠定了基础。未来研究将进一步优化架构,探索真正的2D推理能力,同时扩展至更多模态,朝着更全面的多模态智能方向发展。