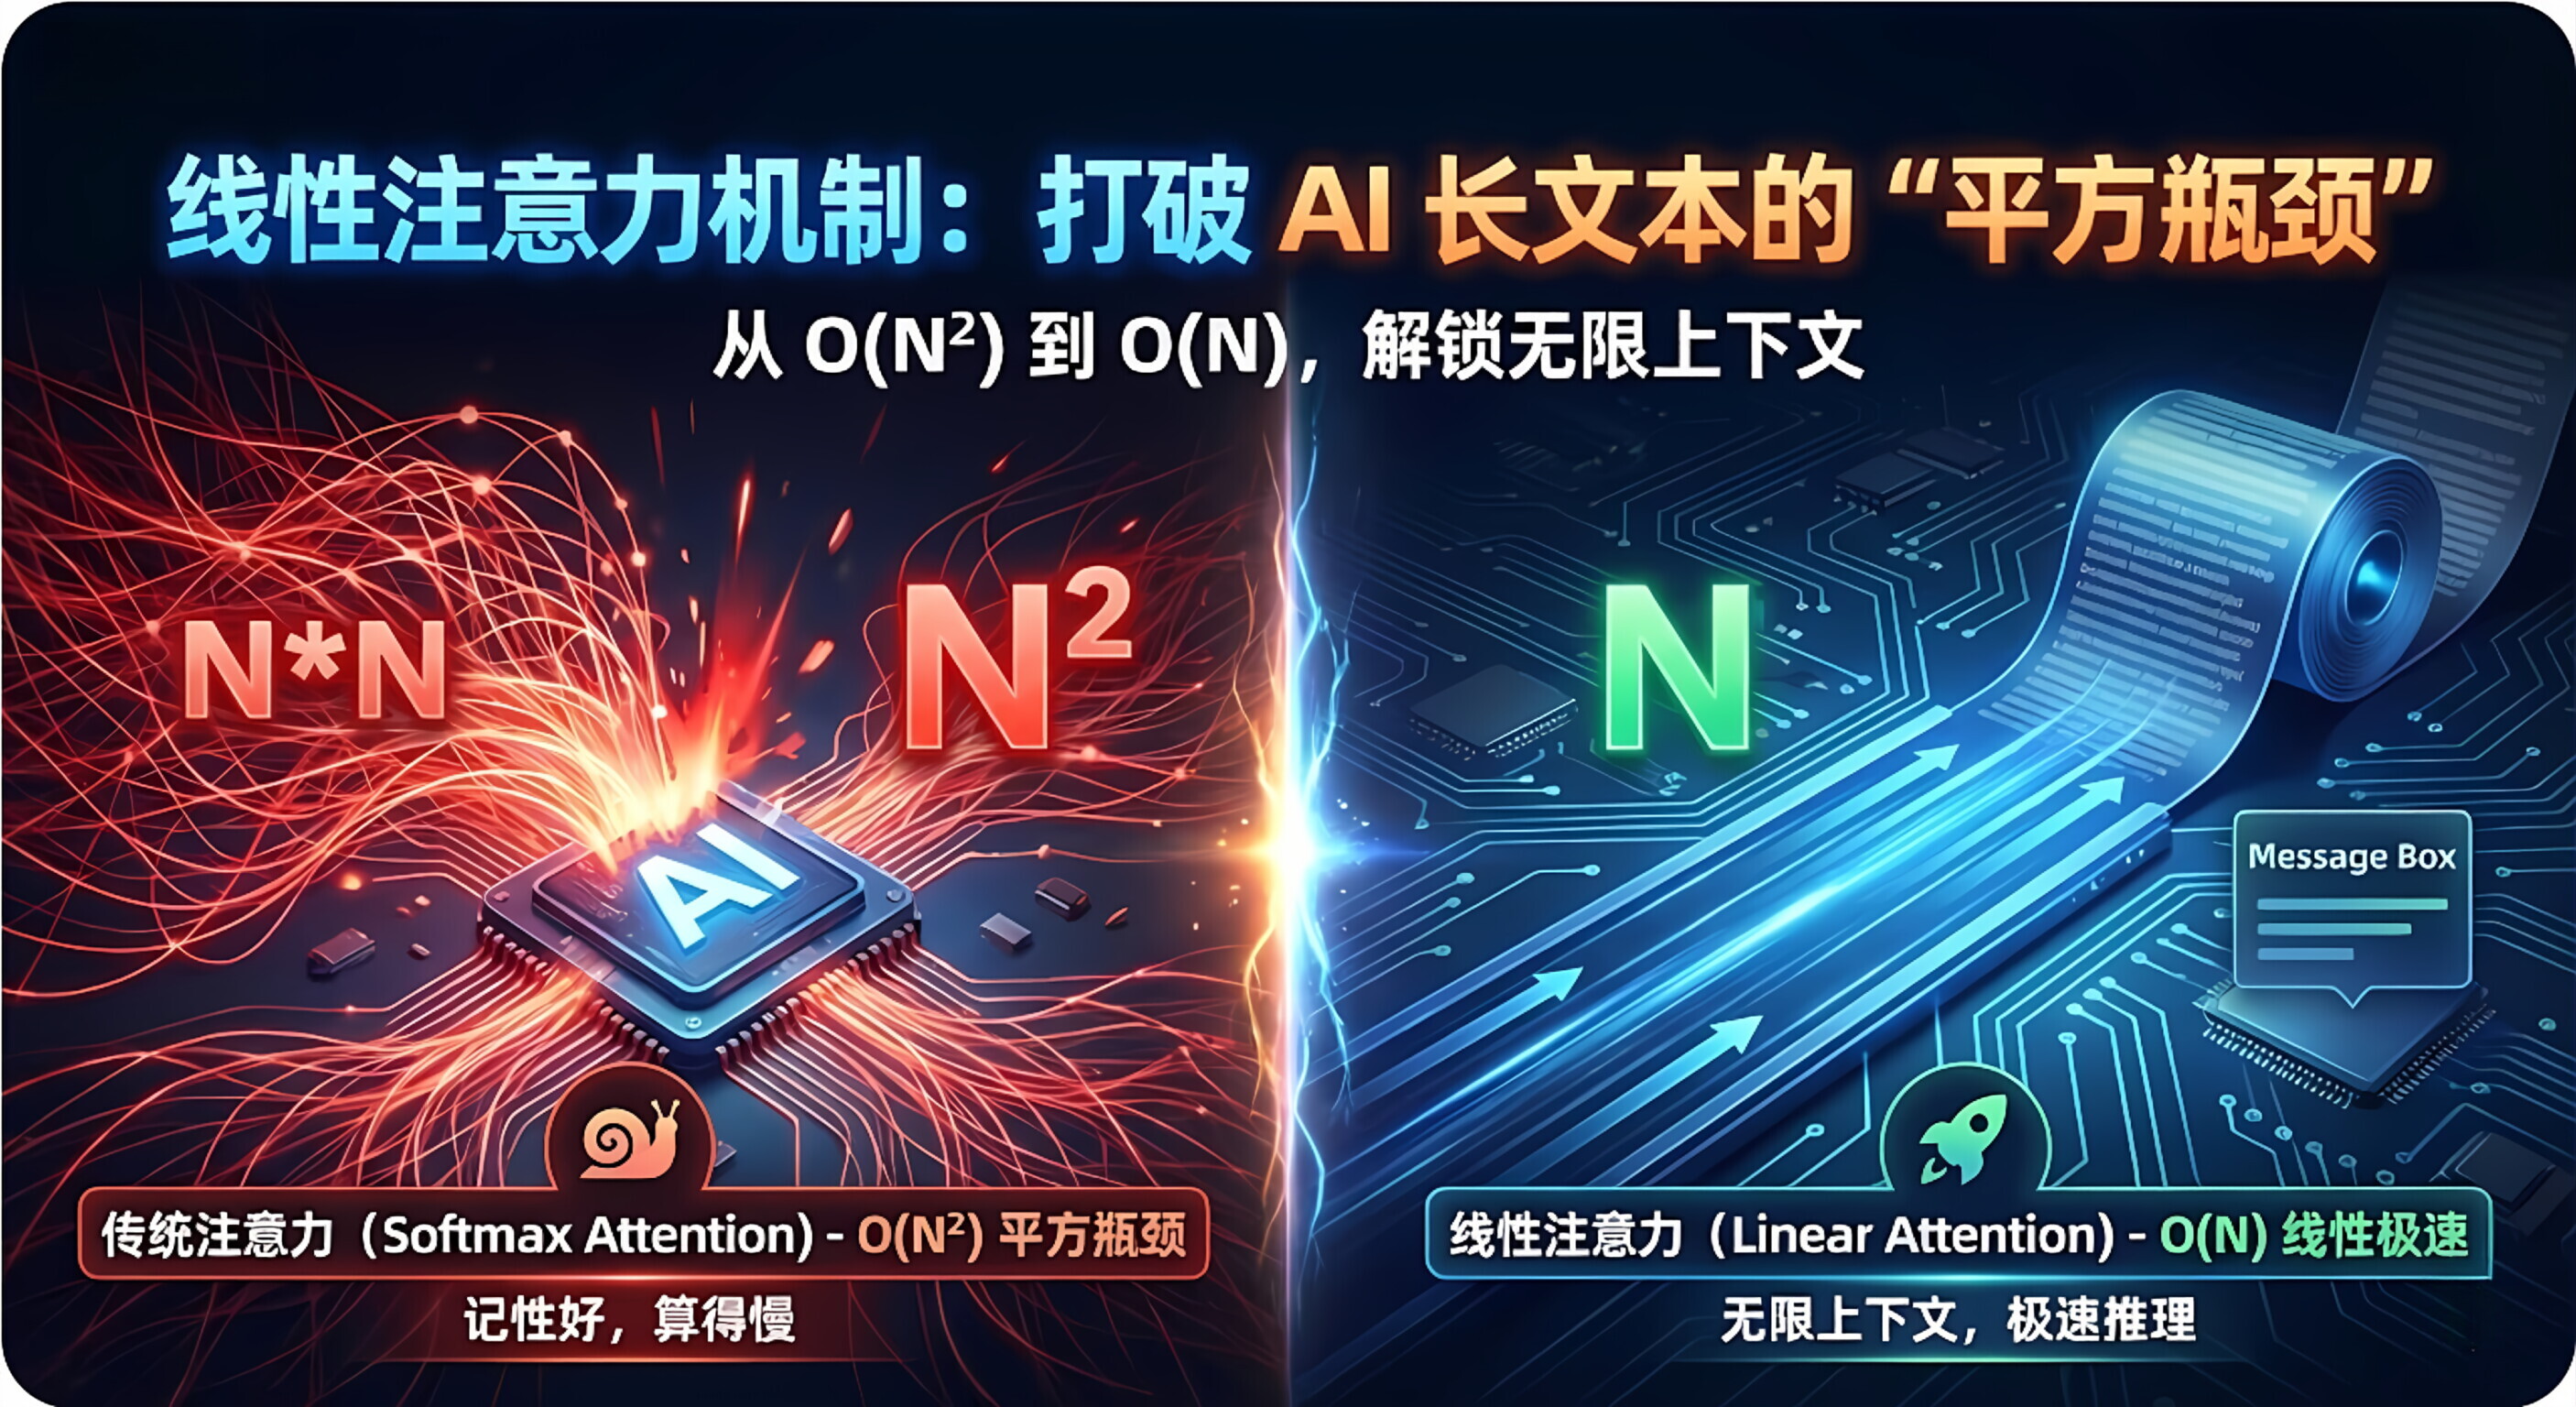
线性 注意力机制 (Linear Attention Mechanism ) 是为了解决传统 Transformer 模型**"记性越好,算得越慢"** 这一致命缺陷而诞生的一种优化技术。
它的核心目标是:把 大模型 处理长文本的时间复杂度,从"平方级爆炸" (O(N^2)) 降低到"线性增长" (O(N))。
简单来说,它是让 AI 能够一口气读完几十万字的小说,而不会把显卡内存撑爆的关键技术之一。
1.🐢 背景:传统注意力的"平方瓶颈"
要理解线性注意力,先得看标准注意力 (Standard Softmax Attention) 的痛点。
在标准的 Transformer(如 GPT-4)中,计算注意力是一个全员社交的过程:
-
机制 :序列里的每一个字 ,都要和序列里其他所有的字进行一次计算(握手),看看彼此关系有多紧密。
-
代价:
-
如果文章有 100 个字,计算量是 100 \times 100 = 10,000 次。
-
如果文章有 1000 个字,计算量是 1000 \times 1000 = 1,000,000 次。
-
-
后果 :随着文章长度 (N) 变长,计算量和显存占用是平方级 (N^2) 增加的。这导致传统模型很难处理超长上下文(比如 100k 以上)。
2.⚡ 原理:数学上的"偷懒"技巧
线性注意力 发现了一个数学上的"漏洞"(或者说结合律特性),通过改变计算顺序来规避那个巨大的矩阵。
A. 标准做法:先相乘,再求和
公式逻辑是:Attention(Q, K, V) = \\text{Softmax}(Q \\times K\^T) \\times
-
先算 Q \times K^T。这会生成一个巨大的 N \times N 矩阵(注意力分数图)。
-
再把这个巨大矩阵乘以 V。
-
瓶颈:那个 N \times N 的中间产物太大了。
B. 线性做法:先合并,再相乘
公式逻辑是:Attention(Q, K, V) = Q \\times (K\^T \\times V
注:这里需要用 核函数 \phi(\cdot) 替换掉非线性的 Softmax。
-
先算 K^T \times V。因为 K 和 V 的维度(d)通常很小(比如 64 或 128),这个结果是一个很小的 d \times d 矩阵,跟文章长度 N 没关系。
-
再用 Q 去乘以这个小矩阵。
-
结果 :不管文章有多长,我都不需要生成那个巨大的注意力图。计算量变成了 N \times d^2,这只是 N 的线性倍数。
3.🏟️ 形象比喻:派对握手 vs. 留言箱
-
标准注意力 (O(N^2)):
-
派对上有 1000 个人。每个人都必须和其他 999 个人一对一握手,并交换名片。
-
耗时极长,现场乱成一锅粥。
-
-
线性注意力 (O(N)):
-
派对上有 1000 个人。每个人进门时,把名片扔进一个公共的"留言箱" (K^T \times V)。
-
每个人出门时,从箱子里拿一份"大家名片的汇总摘要"即可。
-
每个人只需要跟箱子交互一次,速度极快。
-
4.⚔️ 优缺点权衡
既然线性注意力这么快,为什么 GPT-4 不立刻全部换成它?因为它有代价。
|------|------------------------------|-------------------------------------|
| 特性 | 标准注意力 (Softmax Attention) | 线性注意力 (Linear Attention) |
| 速度 | 慢 (N^2),长文噩梦 | 快 (N),长文无压力 |
| 精度 | 高。能精准捕捉任意两个字之间的微妙关系。 | 略低。因为使用了核函数近似或改变了计算逻辑,会有信息压缩损耗。 |
| 召回能力 | 强。能从 100 页前的角落里找到一个名字(大海捞针)。 | 弱。容易遗忘极其久远或细微的信息(好像记得有这回事,但细节模糊了)。 |
| 代表技术 | Transformers (GPT, BERT) | RWKV, Linear Transformer, Performer |
5.🔮 进阶与现状:RNN 的复活?
线性注意力的一个神奇副产品是:它可以像 RNN ( 循环神经网络 )一样运行。
-
因为它不需要一次性看全所有文字,它可以把前文的信息压缩成一个固定的状态 (State),然后读一个字,更新一下状态,再读一个字。
-
这意味着:推理时的 显存 占用是恒定的! 不管你聊了 1 句还是 1 万句,它占用的内存一样多。
目前最火的 Mamba (SSM 状态空间模型) 和 RWKV ,本质上都是这类线性复杂度模型的杰出代表。它们试图在"保持线性速度"的同时,把"精度"提升到接近标准 Transformer 的水平。
总结
线性 注意力机制 是 AI 为了追求**"无限上下文"** 而做出的数学妥协与创新。
它打破了"文章越长,智商越慢"的魔咒,是未来 AI 能够在这个窗口处理整本《红楼梦》或整个 Windows 代码库的关键底层技术。