③模型架构-Kimi K2.5 技术报告解读

模型架构

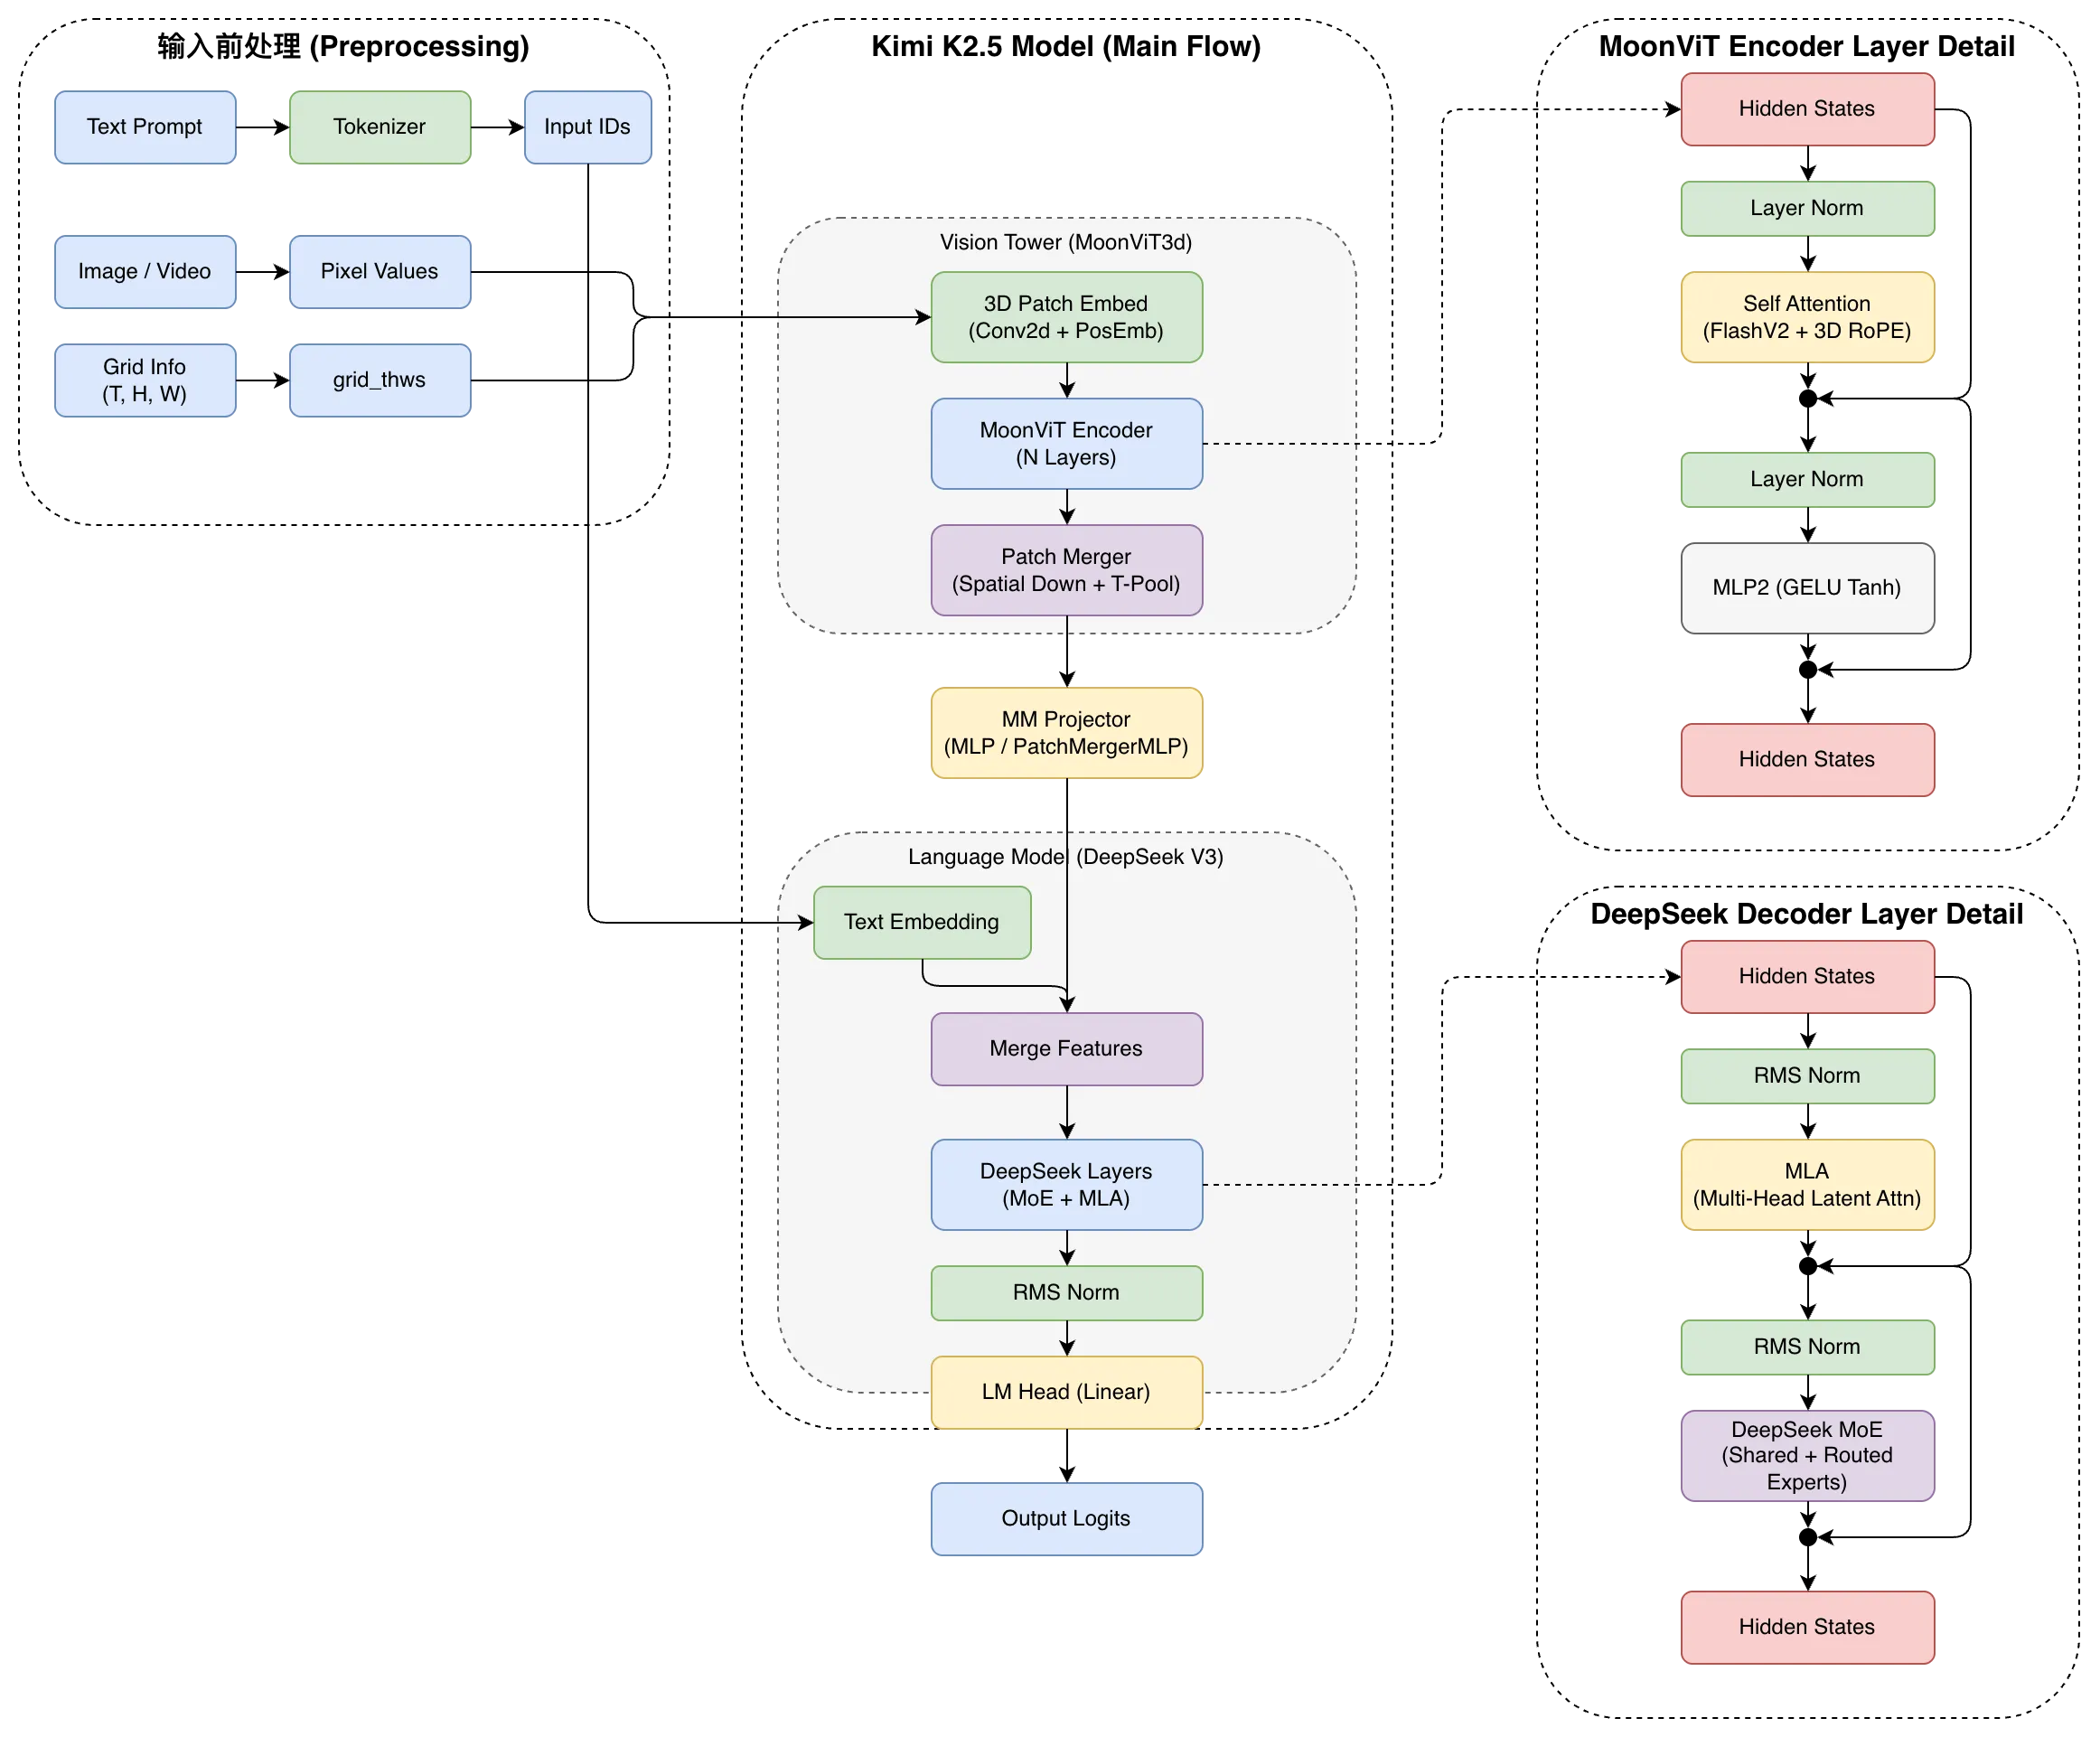
模型主要包含三个部分:MoonViT-3D、MLP投影器、Kimi-K2。没错,刚发现Kimi-K2其实是单模态的,这里面使用的是Kimi-K2的模型架构而非其训练参数。
Kimi-K2

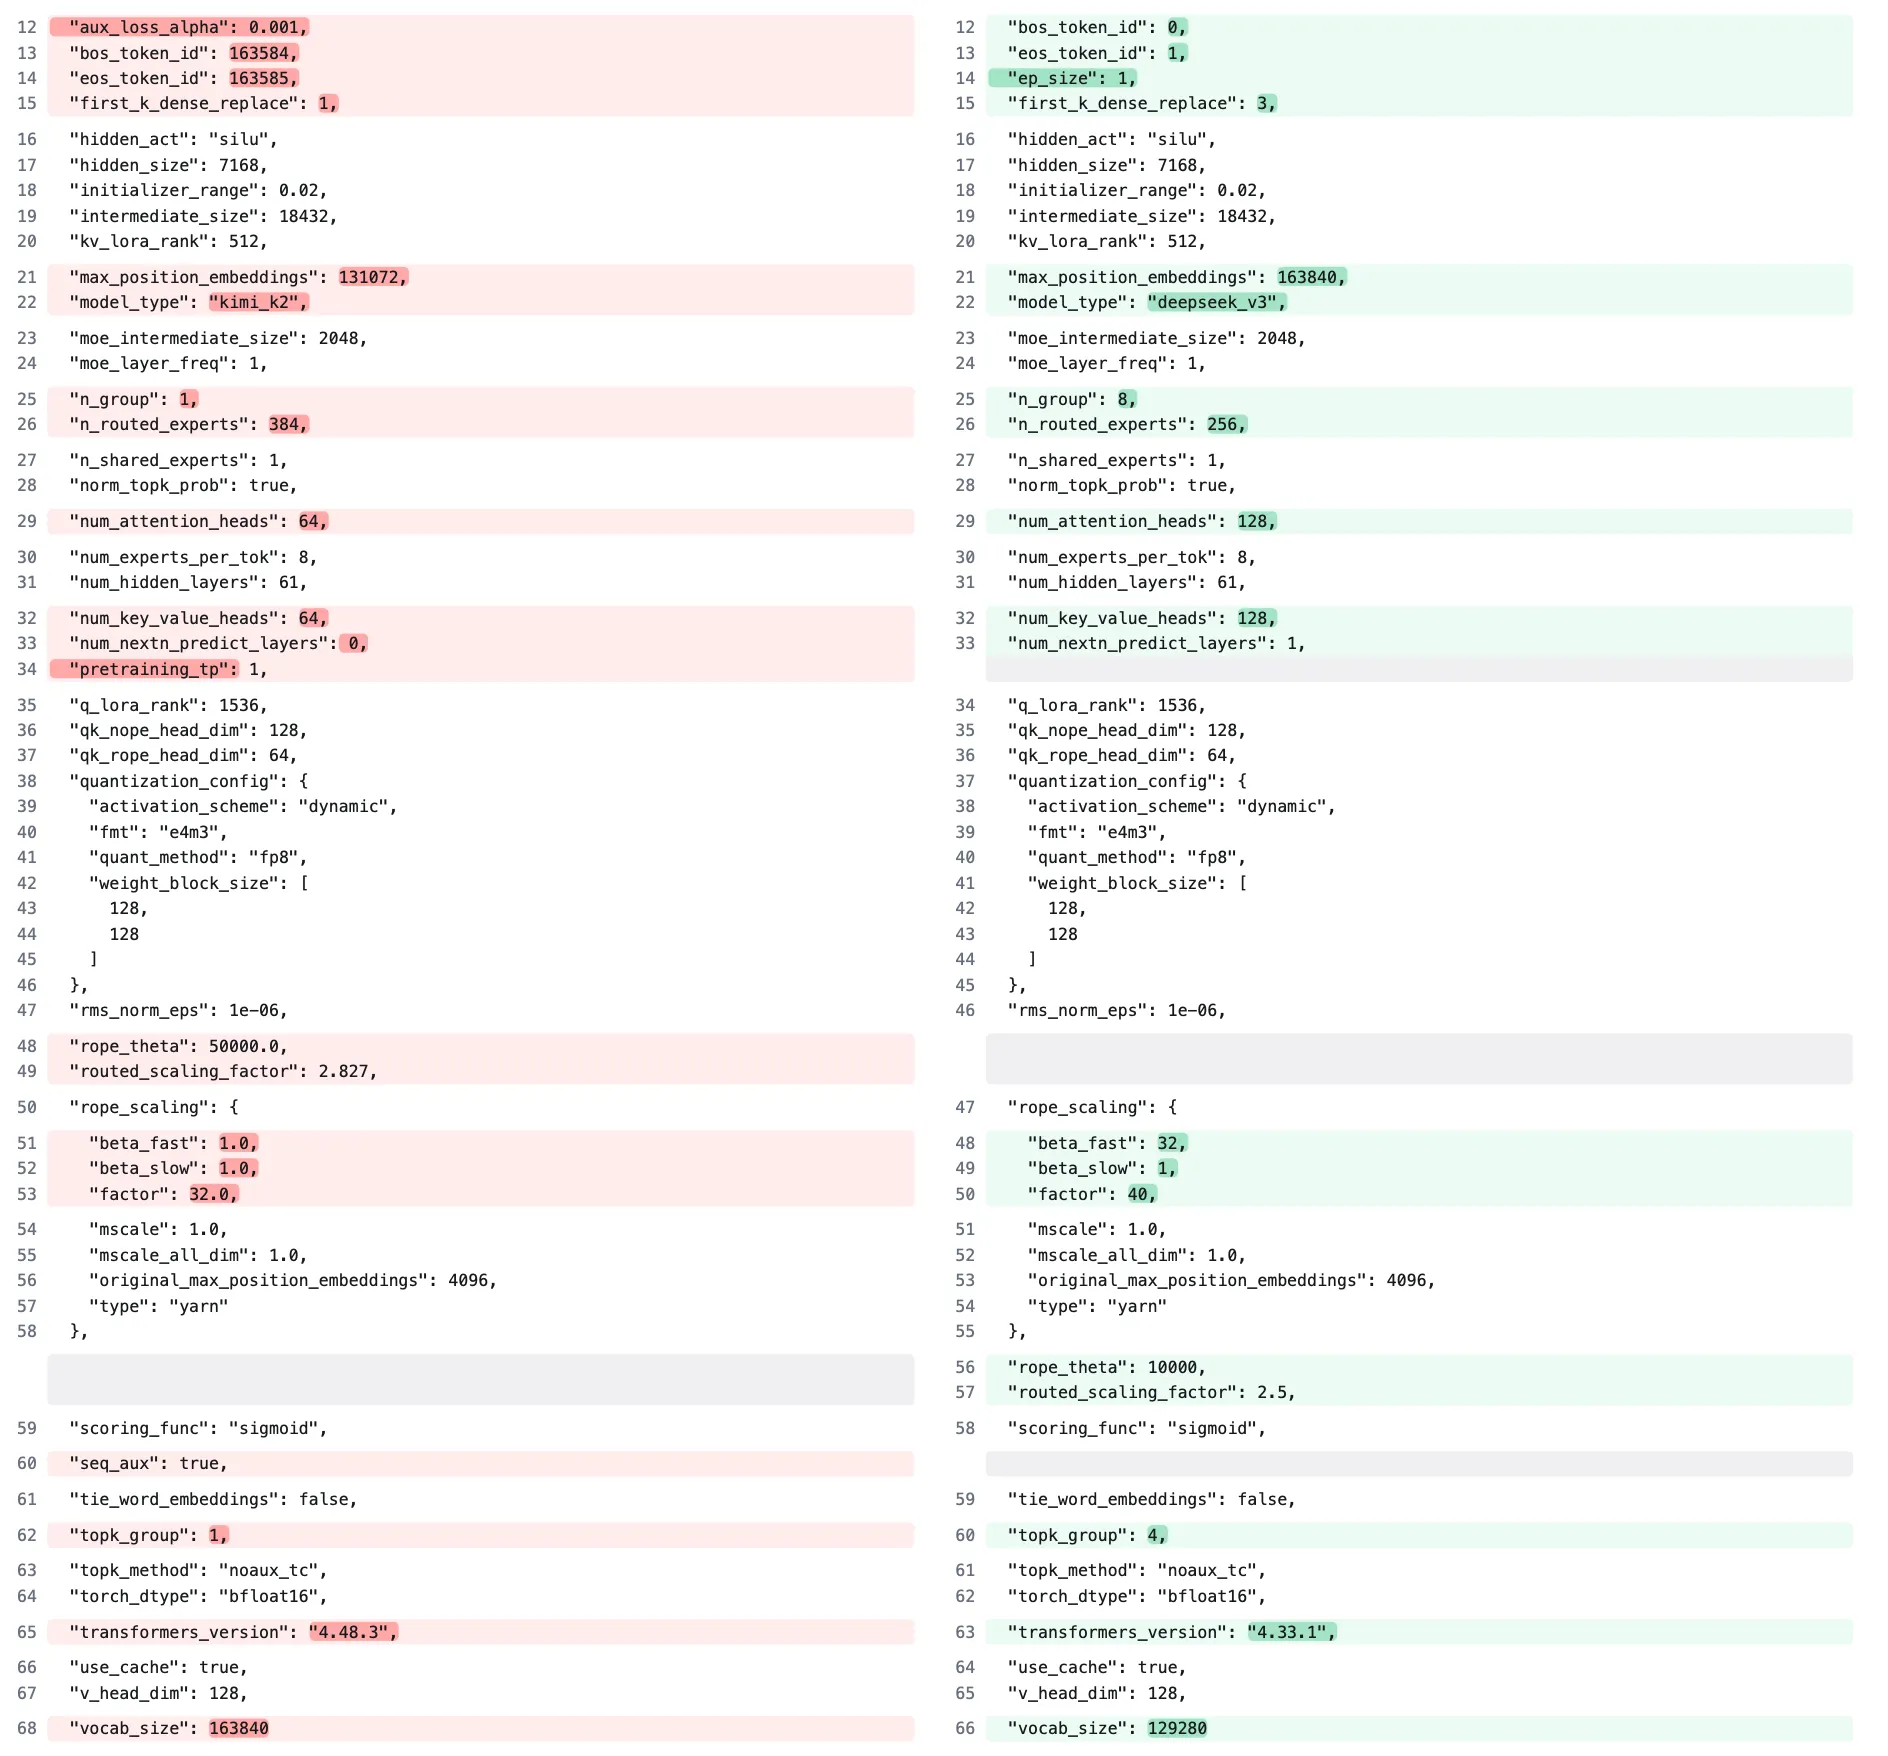
又仔细看了一下Kimi-K2的huggingface仓库,发现其模型架构继承自DeepSeek-V3,只是在模型配置层面有所改动:

左侧为Kimi-K2,右侧为DeepSeek-V3的配置参数。
MoonViT-3D

在Kimi-VL中,使用了MoonViT,其允许原生分辨率处理,无需复杂的切割拼接操作。更详细的介绍可见GitHub仓库:"datawhalechina/self-llm/models/Kimi-VL/02-Kimi-VL-技术报告解读.md"

在Kimi-K2.5中,为了最大程度地使图像理解能力迁移到视频理解上,使用了MoonViT的升级版------MoonViT-3D。使用了统一的架构、完全共享的参数以及一致的嵌入空间,将时间-空间维度一同处理。

  1. Pack Stage:在 MoonViT3dEncoder 中,最多4个连续帧被视为一个时空体积,在这个阶段,4个时间帧被当作一个整体进行特征提取,但并没有减少时间维度的大小。
  2. Packed Attention:经过上述操作后,每个时空Pack由4帧视频变成了一段 flattened tokens。在这个阶段使用了cu_seqlens 进行mask,保证每次注意力的计算只在每个Pack的范围内,Pack之间不做交互,且注意力的是双向的(相当于transformer-encoder)
  3. Pool Stage:在 tpool_patch_merger 函数中,通过 .mean(dim=0) 操作沿时间维度进行平均池化,将4个时间帧压缩为1个时间步。

最后,一段视频就被编码成一段 token 的 embedding 了,在后面的阶段根据图片插入文字的位置插入到 text tokens 里就完成了多模态融合的功能。

相关推荐
东姬AI1 小时前
文心5.5 Flash今日发布:内容管线连配音都自动化了,最后卡住的为什么是「会表演」?
百度·大模型·数字人·ai视频·moe·文心5.5·联合生成
dozenyaoyida2 小时前
AI与大模型新闻日报 | 2026-11-11
人工智能·chatgpt·大模型·新闻
武子康8 小时前
H3-World 的动作能按时发生,为何还不能据此判断实时互动?
人工智能·深度学习·agent
Rocky Ding*9 小时前
【三年面试五年模拟】2026-11-05_月之暗面大模型算法岗一面、二面面经全解析
论文阅读·人工智能·深度学习·机器学习·aigc·强化学习·ai-native
在所不辞兄10 小时前
【人工智能驱动的电催化研究-05】条件、循环与数据检查
人工智能·深度学习·神经网络·机器学习·有限元·电化学·电催化
Flynn Liang1 天前
同一需求三套写法:用 Spring AI、LangChain4j、AgentScope Java 各实现一个带工具调用的 RAG 助手(实战对比)
java·人工智能·大模型·架构设计·spring ai·langchain4j·agentscope
伞伞悦读1 天前
【第81期】特征缩放怎么选:标准化、MinMax 与 Robust 的原理、泄漏对照和完整实验
人工智能·python·深度学习·机器学习
jay神1 天前
基于深度学习的交通流量预测系统(Web 版)
前端·人工智能·深度学习·yolo·计算机毕业设计
莽夫搞战术1 天前
【量化实战】单卡3090部署Hy-SimulMT-30B-A3B-Interleave同传大模型
大模型·量化·混元·语音翻译·simulmt·ai同传
武子康1 天前
H3-World 的 11.3 小时训练数据,是怎样对齐成动作监督的?
大数据·人工智能·深度学习