前言:AI 浪潮下的开发者焦虑
2025年,AI 领域的发展速度已经不能用"日新月异"来形容,简直是"时新分异"。从年初爆火的开源框架 Open Claw ,到近期内测表现惊人的 GPT-5.3-Codex 、Claude-Opus-4-6 ,再到视频生成领域的双子星 Sora2 和 Veo3,模型的能力边界在不断被推高。
然而,作为一名一线开发者或架构师,你是否发现:模型越强,接入越累?
- 多模型适配地狱: 不同的 API 协议、不同的鉴权方式、不同的 SDK。
- 网络波动的"玄学": 关键时刻的 504 Timeout 让你在客户面前颜面扫地。
- 成本管理的黑洞: 预充值过期、Token 计费不透明、高昂的运维成本。
今天,我们不聊虚的,直接从底层架构出发,探讨如何通过**向量引擎(Vector Engine)**这一技术中台,实现对 GPT-5.2-Pro、Kimi-k2.5 等顶级模型的"降维打击"式调用。
第一部分:大模型调用层的技术痛点深度剖析
在构建企业级 AI 应用时,调用层(Inference Layer)往往是整个架构中最脆弱的一环。
1.1 协议碎片化与代码腐化
每一个主流模型厂商(OpenAI, Anthropic, Google, DeepSeek)都有自己的 API 标准。当你试图在一个项目中同时引入 GPT-5.3 的逻辑能力和 Claude 的长文本能力时,你的代码库会迅速充斥着各种适配层。这种"胶水代码"不仅难以维护,更增加了系统解耦的难度。
1.2 物理延迟与 CN2 线路的重要性
对于国内开发者而言,跨境请求的稳定性是永远的痛。普通公网路由跳数多、丢包率高。在 AI 实时对话场景下,哪怕 500ms 的额外延迟都会导致用户体验的断崖式下跌。
1.3 并发控制与弹性伸缩的成本
自建一套支持高并发(如 1000 QPS 以上)的 API 转发与负载均衡系统,需要投入大量的 DevOps 资源。对于初创团队来说,这无异于为了喝牛奶而养了一头牛。
第二部分:向量引擎(Vector Engine)的技术原理与优势
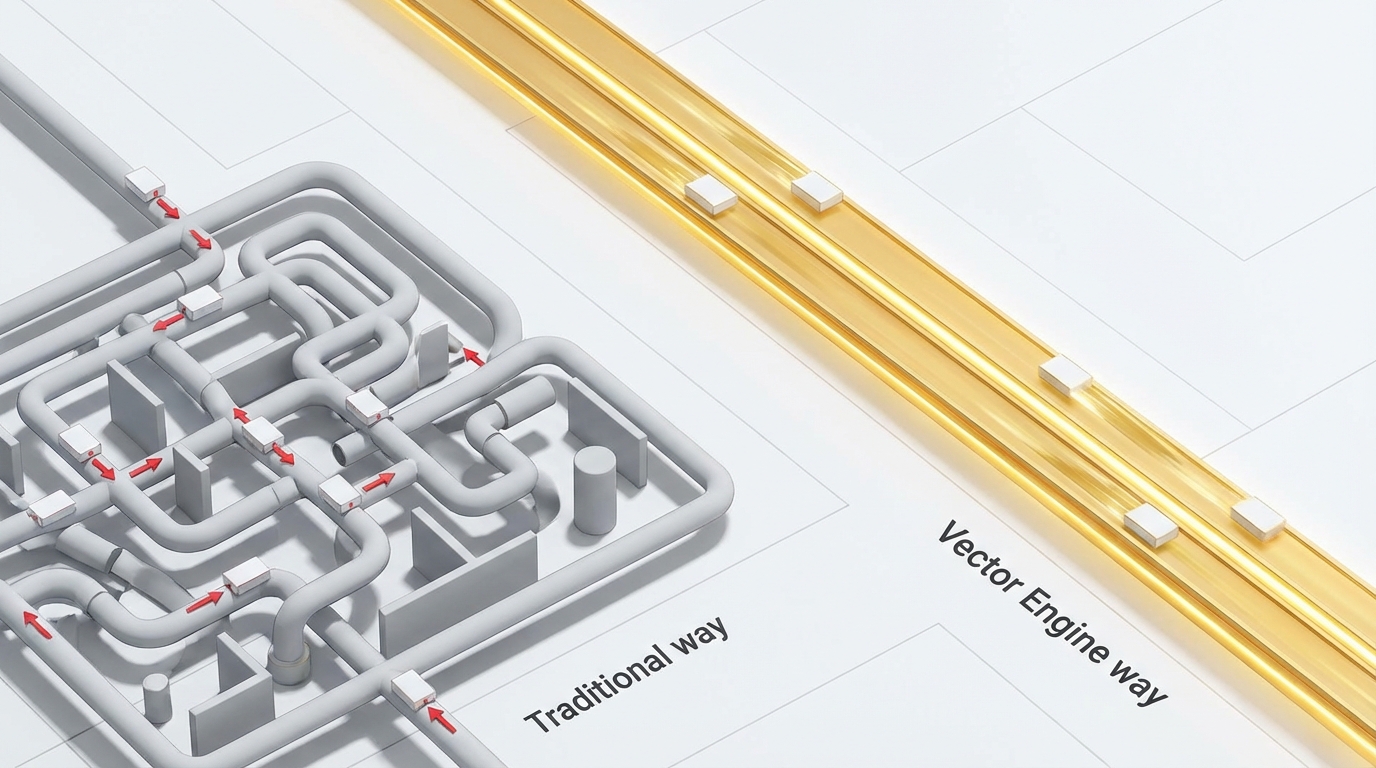
什么是向量引擎?简单来说,它是一个专门为大模型调用设计的"智能网关+加速中台"。它不仅解决了"能不能用"的问题,更解决了"好不好用"的问题。
2.1 CN2 高速通道与全球节点布局
向量引擎在全球部署了 7 个核心节点,这些节点选址极具讲究------全部位于离 OpenAI、Google 等原始服务器物理距离最近的数据中心。
- 智能路由: 系统会根据当前链路的拥塞情况,自动选择最优的 CN2 专线。
- 实战数据: 相比直接调用官方接口,通过向量引擎转发的平均响应耗时可降低 40% 以上,响应速度稳定在 1-3 秒。
2.2 100% 兼容 OpenAI 生态的意义
这不仅仅是少写几行代码的问题。兼容 OpenAI SDK 意味着你可以无缝集成 LangChain 、LlamaIndex 等成熟的开源生态。
技术细节: 向量引擎在协议层做了全映射,你只需要修改
base_url即可完成迁移。
2.3 成本控制:Token 计费的透明化
很多开发者苦于 OpenAI 的固定配额制度。向量引擎引入了"按需付费+余额永不过期"的机制。
- 计费模型: 完全同步官方 Token 标准。
- 透明度: 后台提供详细的请求日志,每一笔 Token 消耗都清晰可查。
第三部分:实战演练------3步实现多模型自由
为了让大家更直观地理解,我们直接看操作流程。
3.1 环境准备
首先,你需要获取一个统一的入口凭证。
- 官方地址: https://api.vectorengine.ai/register?aff=QfS4
- 配置参考: https://www.yuque.com/nailao-zvxvm/pwqwxv?#
3.2 代码集成(以 Python 为例)
只需修改初始化参数,即可调用包括 GPT-5.3-Codex 在内的所有模型。
python
import openai

# 核心逻辑:仅需修改 base_url 和 api_key
client = openai.OpenAI(
    api_key="你的向量引擎密钥",
    base_url="https://api.vectorengine.ai/v1"
)

# 调用最新的 GPT-5.2-Pro
response = client.chat.completions.create(
    model="gpt-5.2-pro",
    messages=[{"role": "user", "content": "分析 Open Claw 框架的核心架构"}]
)
print(response.choices[0].message.content)
3.3 多模型联动案例
在同一个脚本中,你可以先用 GPT 生成文案,再调用向量引擎集成的 Midjourney 接口生成配图,最后用 Sora2 生成视频脚本。这种一站式体验是传统方式无法比拟的。
第四部分:深度对比与架构思维导图
为了帮助大家做决策,我们对几种主流方案进行了深度对比。
4.1 方案对比表
| 特性 | 方案 A:直接对接官方 | 方案 B:自建代理服务器 | 方案 C:向量引擎 (Vector Engine) |
|---|---|---|---|
| 网络延迟 | 高(受公网波动影响) | 中(取决于代理质量) | 极低(CN2 专线优化) |
| 开发成本 | 高(需维护多套 SDK) | 中(需维护代理代码) | 极低(100% 兼容 SDK) |
| 运维压力 | 无 | 高(需处理节点挂掉、封号) | 无(24小时专业运维) |
| 资金利用率 | 低(配额易过期) | 中 | 极高(余额永不过期) |
| 并发上限 | 受限(Tier 等级限制) | 取决于账号数量 | 高(默认 500 次/秒) |
4.2 架构思维导图(文字版)
- AI 应用层 (User App)
- ↓ 发起标准 OpenAI 请求
- 向量引擎接入层 (Vector Engine Gateway)
- ├─ 鉴权与配额校验
- ├─ 智能路由分配 (CN2/专线)
- └─ 协议转换 (OpenAI/Claude/Gemini)
- 模型资源池 (Model Pool)
- ├─ GPT-5.3-Codex / Sora2
- ├─ Claude-Opus-4-6
- └─ Kimi-k2.5 / DeepSeek
第五部分:企业级高并发场景下的优化策略
在处理每秒数千次的请求时,单纯的转发是不够的。向量引擎在后台做了大量不可见的优化:
- 无感知扩容: 当检测到流量突增时,系统会自动调度更多的计算节点参与请求转发,避免请求排队。
- 错误重试机制: 如果某个上游节点返回 5xx 错误,向量引擎会自动进行毫秒级的重试或切换备用节点。
- 日志追踪: 每一条请求都有唯一的 TraceID,方便开发者排查业务逻辑问题。
第六部分:总结与未来展望
AI 的下半场,拼的不仅是模型的能力,更是落地的效率 。
向量引擎 通过解决接口适配、运维扩容、预算浪费等琐事,让开发者能够真正回归业务本身。无论你是想尝试最新的 Veo3 视频模型,还是需要稳定的 GPT-5.2 生产环境,选择一个靠谱的底层引擎都是事半功倍的关键。