今天这篇文章将介绍如何使用 Elasticsearch 搭建AI搜索系统和RAG应用系统。
Elasticsearch 搭建 AI 搜索系统
在 Elasticsearch 中实现向量搜索涉及四个关键组件:
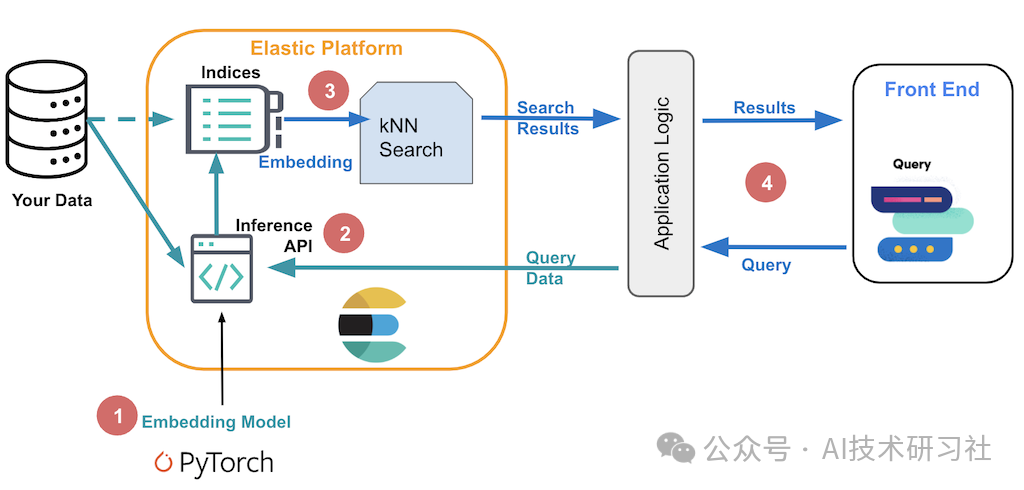
嵌入模型:这是一个机器学习模型,能够将数据作为输入并返回该数据的数字表示形式,即向量(也称为"嵌入")。嵌入模型是整个向量搜索的基础,它将文本、图像等非结构化数据转换为向量表示,以便在向量空间中进行相似性搜索。
推理终端节点:Elastic Inference API 或 Elastic Inference 管道处理器用于将机器学习模型应用于文本数据。推理端点在数据引入和查询执行时都发挥着关键作用。对于非文本数据(如图像文件),需要在机器学习模型中使用外部脚本来生成嵌入,这些嵌入将存储在 Elasticsearch 中并用于后续的搜索操作。
搜索:Elasticsearch 将嵌入和元数据存储在其索引中,并执行近似的 k 最近邻搜索(k-NN),以在嵌入空间中找到与查询最接近的匹配项。通过这种方式,Elasticsearch 能够在大规模数据集中高效地执行相似性搜索,为各种 AI 应用场景提供支持。
应用程序逻辑:这是核心向量搜索之外的所有必要逻辑,包括与用户的交互、应用业务逻辑、处理搜索结果等。应用程序逻辑负责将搜索结果展示给用户,并执行任何其他所需的操作,使整个搜索过程更加完整和用户友好。
通过整合这些组件,您可以在 Elasticsearch 中构建一个强大的 AI 搜索系统,实现对文本、图像等多种数据类型的高效相似性搜索,满足各种复杂的业务需求。
在以下部分中,我们将了解如何从头开始构建一个 AI 对话式搜索应用程序。
👉CSDN大礼包🎁:[全网最全《LLM大模型入门+进阶学习资源包》免费分享](https://hnxx.oss-cn-shanghai.aliyuncs.com/official/1725500307561.jpg?t=0.4405313375184585)**(安全链接,放心点击)**()👈
首先,让我们介绍一下什么是 AI 对话式搜索。
AI 对话式搜索是一种基于自然语言处理(NLP)和机器学习技术的搜索方式,旨在通过与用户的自然对话实现信息检索。这种搜索模式允许用户以自然语言提问,而不是输入特定的关键词。
AI 对话式搜索系统可以理解用户的查询意图,并通过智能匹配算法提供相关的答案或信息。这种搜索体验更加贴近人类的交流方式,使搜索过程更加直观和用户友好,特别适用于需要复杂查询或个性化推荐的场景。
接下来,我们将深入探讨如何构建这样的 AI 对话式搜索应用程序,从数据准备、模型选择到系统集成,逐步展示实现这一技术的不同步骤。
首先,一个AI对话应用的架构,如下图所示:
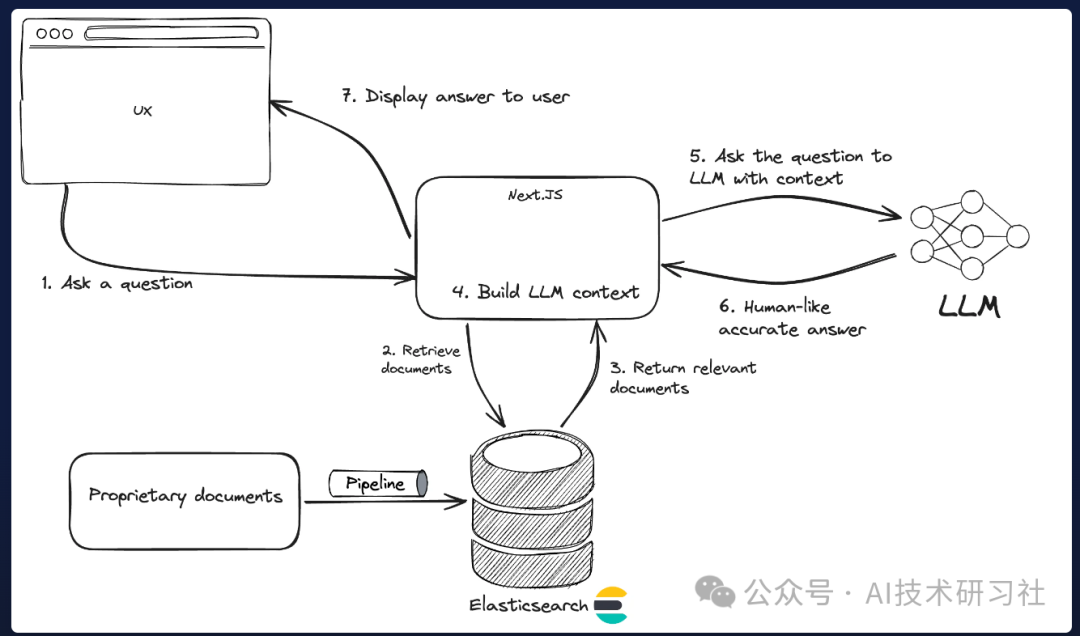
第一步:数据收集和预处理
需要确定数据的来源,例如内部知识库、常见问题解答和文档。接下来,构建一个数据管道,将此数据引入检索系统,并准备在 RAG 应用程序中使用。
第二步:设置数据管道
需要准备索引映射,建立索引,并存储数据。
from elasticsearch_serverless import Elasticsearch``import json``import os`` ``client = Elasticsearch(` `os.getenv("ELASTICSEARCH_URL"),` `api_key=os.getenv("ES_API_KEY"),` `request_timeout=600``)`` ``mappings={"properties":{"semantic":{"type":"semantic_text","inference_id":"e5-small"},"content":{"type":"text","copy_to":"semantic"}}}`` ``# Create index``client.indices.create(index="search-faq", mappings=mappings)第三步:创建推理服务
需要创建一个推理服务来操作 E5 多语言 ML 模型。
inference_config={"service":"elasticsearch","service_settings":{"num_allocations":1,"num_threads":1,"model_id":".multilingual-e5-small"}}`` ``# Create inference``client.inference.put(inference_id="e5-small", task_type="text_embedding", inference_config=inference_config)第四步:数据生成文档嵌入
with open("faq.json") as f:` `documents = json.load(f)` `def generate_docs():` `index_name = "search-faq"` `for row in documents:` `yield { "index" : { "_index" : index_name } }` `yield row`` ``client.bulk(operations=generate_docs())第5步:前端页面开发
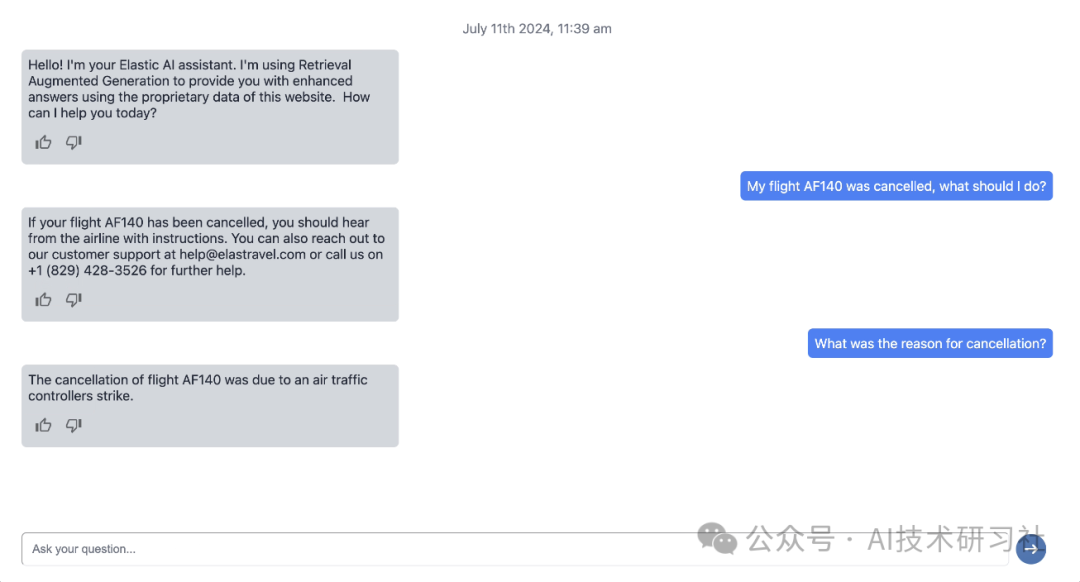
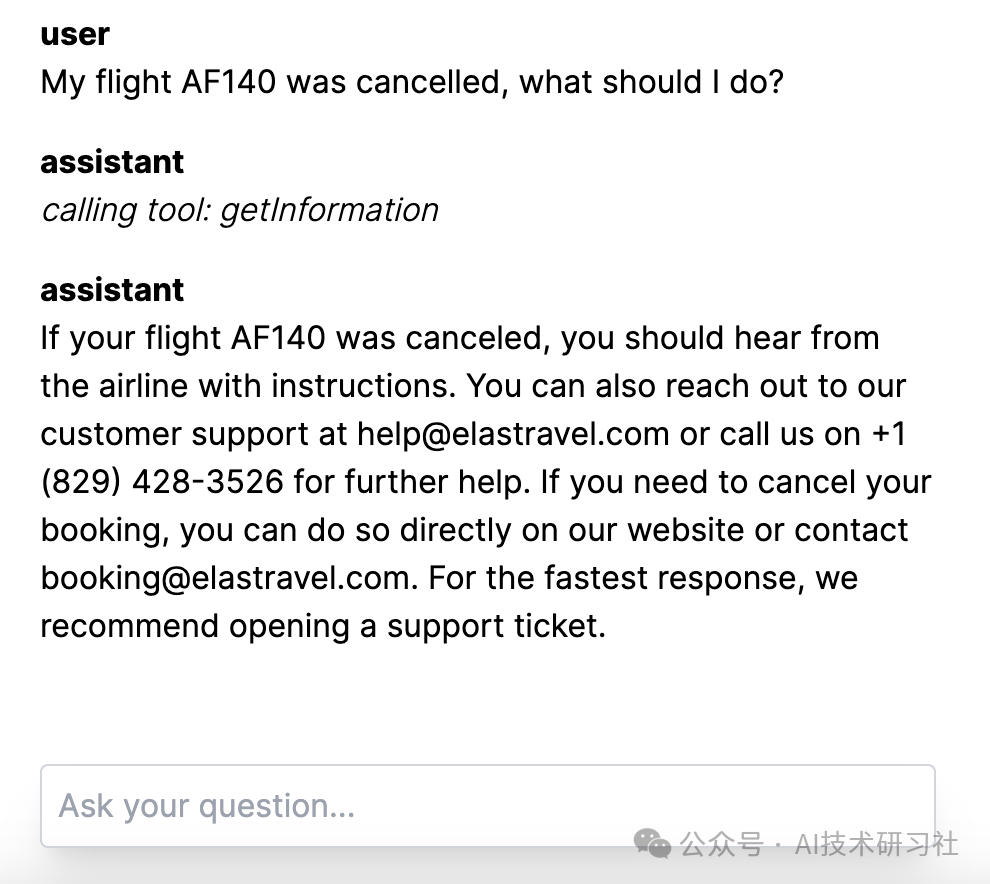
// Retrieve relevant content from the knowledge base``async function findRelevantContent(question: string) {` ` // Semantic search query` `const body = await client.search({` `size: 3,` `index: 'search-faq',` `body: {` `query: {` `semantic: {` `field: "semantic",` `query: question` `}` `}` `}` `});` `return body.hits.hits.map((hit: any) => ({` `content: hit._source.content` `}));``}`` 最后页面效果图,如下。
完整代码参考:https://www.elastic.co/search-labs/blog/llm-rag-conversational-search-for-customer-success
Elasticsearch 搭建 RAG系统
构建一个基于 Elasticsearch 向量数据库和 LangChain 的 RAG(Retrieval-Augmented Generation)应用,可以有效提升生成式 AI 的能力,特别是在需要结合实时信息和大规模知识库的场景中。以下是这一过程的原理、步骤、目的和价值。
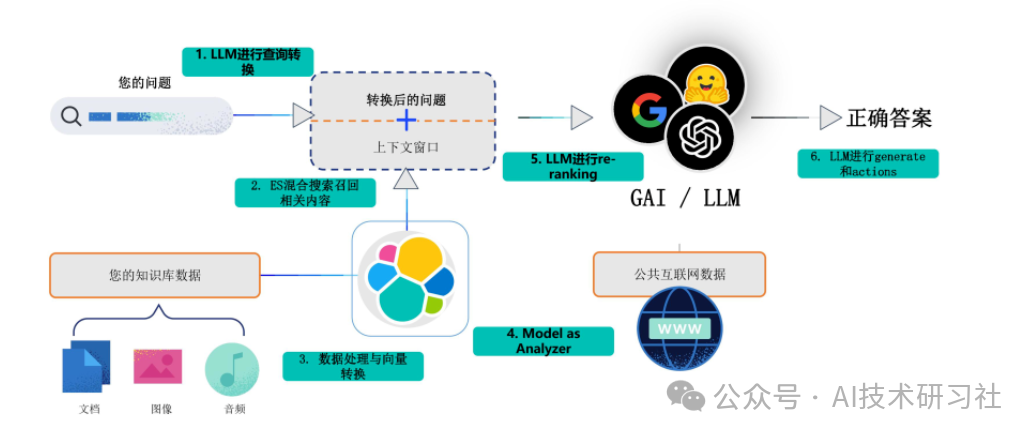
ES 在 RAG 领域的解决方案如上图所示。一个传统的用法就是当用户有一个问题的时候,将问题直接提交给大模型,大模型根据自己的知识去给出回答。如果遇到企业私域信息,大模型不知道答案,那么 ES 就会通过 RAG 方案,将问题给到我们的知识库。
知识库中不仅有文本,还会有图片、视频,我们会提前把这些内容进行向量化。在检索过程中,进行文本和向量的联合召回,得到一个 TopN list。把这个 list 和用户自己的问题一起构成一个 prompt,再提交给大模型。这时,大模型就可以很好地去回答这个问题了。
RAG(Retrieval-Augmented Generation)结合了检索(Retrieval)和生成(Generation)的能力。其核心思想是首先从外部知识库中检索出与用户查询相关的信息片段,然后将这些片段与用户输入一起送入生成模型,以生成更加准确和上下文相关的回答。使用 Elasticsearch 作为向量数据库,可以高效地处理大规模数据并快速进行相似性搜索;而 LangChain 提供了构建和管理这类复杂应用的工具链。
安装依赖库。
pip install langchain-elasticsearch

from langchain_elasticsearch import ElasticsearchStore`` ``es_store = ElasticsearchStore(` `es_cloud_id="your-cloud-id",` `es_api_key="your-api-key",` `index_name="rag-example",` `strategy=ElasticsearchStore.SparseVectorRetrievalStrategy(model_id=".elser_model_2"),``)文档收集:收集相关的文档、文章或技术资料,并将其存储在 Elasticsearch 中。
texts = [` `"LangChain is a framework for developing applications powered by large language models (LLMs).",` `"Elasticsearch is a distributed, RESTful search and analytics engine capable of addressing a growing number of use cases.",` `...``]``es_store.add_texts(texts)`` 向量化:利用嵌入模型(如 BERT、OpenAI Embeddings)将文档内容转化为向量,并将这些向量存储在 Elasticsearch 的向量字段中,以便后续的相似性搜索。
from langchain_openai import ChatOpenAI``   ``llm = ChatOpenAI(api_key="sk-...") # or set the OPENAI_API_KEY environment variable

from langchain import hub``from langchain_core.runnables import RunnablePassthrough`` ``prompt = hub.pull("rlm/rag-prompt") # standard prompt from LangChain hub`` ``retriever = es_store.as_retriever()`` ``def format_docs(docs):` `return "\n\n".join(doc.page_content for doc in docs)`` ``rag_chain = (` `{"context": retriever | format_docs, "question": RunnablePassthrough()}` `| prompt` `| llm` `| StrOutputParser()``)用户查询向量化:当用户输入查询时,首先通过嵌入模型将查询转化为向量。
生成回答:使用 LangChain 集成生成式 AI 模型(如 GPT-4),基于输入的信息生成最终的回答。
rag_chain.invoke("Which frameworks can help me build LLM apps?")Elasticsearch 商店提供了开箱即用的常见检索策略,开发人员可以自由地试验最适合给定用例的方法。但是,如果您的数据模型比只有单个字段的文本更复杂,该怎么办?
例如,如果您的索引设置包括一个网络爬虫,该爬虫会生成带有文本、标题、URL 和标签的文档,并且所有这些字段对于搜索都很重要,那么该怎么办?Elasticsearch 的查询 DSL 使用户能够完全控制如何搜索他们的数据。
而在LangChain中,ElasticsearchRetriever直接实现了这种充分的灵活性。只需定义一个函数,将用户输入查询映射到 Elasticsearch 请求。
假设我们想将语义重新排名功能添加到我们的检索步骤中。通过添加 Cohere 重新排名步骤,顶部的结果会变得更加相关,而无需额外的手动调整。为此,我们定义了一个 Retriever,它接受一个返回相应 Query DSL 结构的函数。
def text_similarity_reranking(search_query: str) -> Dict:` `return {` `"retriever": {` `"text_similarity_reranker": {` `"retriever": {` `"standard": {` `"query": {` `"match": {` `"text_field": search_query` `}` `}` `}` `},` `"field": "text_field",` `"inference_id": "cohere-rerank-service",` `"inference_text": search_query,` `"window_size": 10` `}` `}` `}`` ``retriever = ElasticsearchRetriever.from_es_params(` `es_cloud_id="your-cloud-id",` `es_api_key="your-api-key",` `index_name="rag-example",` `content_field=text_field,` `body_func=text_similarity_reranking,``)通过结合 Elasticsearch 的强大检索能力和 LangChain 的灵活生成能力,RAG 应用旨在提高生成式 AI 的准确性、上下文关联性和信息丰富度。
具体目标包括:
-
提供基于最新和最相关信息的高质量回答。
-
利用大规模外部知识库,增强生成模型的知识范围和实用性。
-
提升 AI 系统在复杂问答场景中的表现,满足用户更高层次的信息需求。
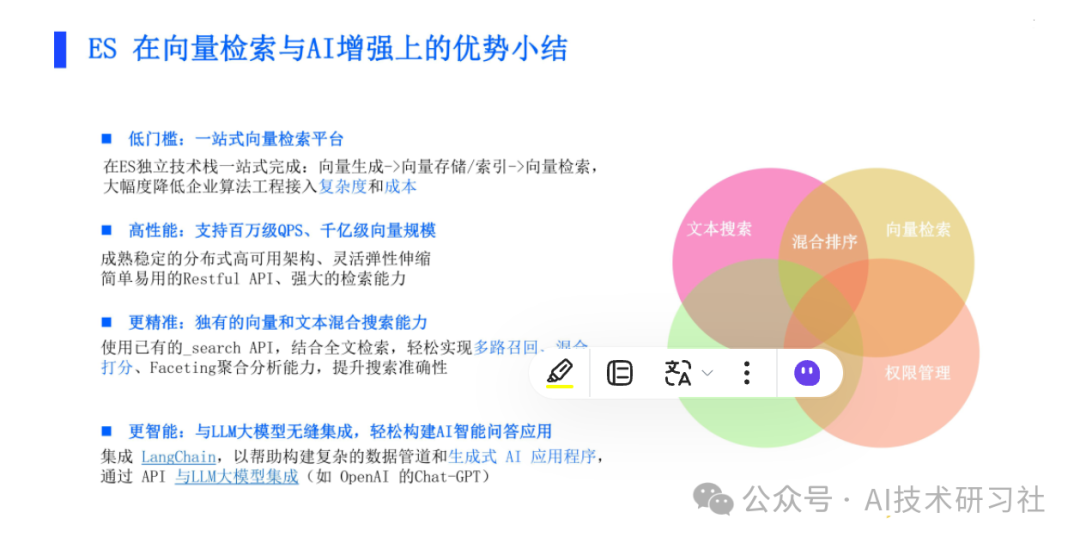 Elasticsearch 在 RAG 方向上具有显著优势,包括:
低门槛的独立技术栈,能够一站式完成向量生成、存储、索引和检索,通过配置即可实现大部分功能,大大降低了接入门槛;
高性能,支持百万级 QPS 和千亿级数据量,得益于其分布式架构和灵活的弹性;
更精准的搜索,支持文本与向量的混合检索,显著提升搜索结果的准确性;
更智能的集成,能够无缝连接大模型,轻松构建 AI 智能问答应用。
读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用
对于0基础小白入门:
如果你是零基础小白,想快速入门大模型是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!
😝有需要的小伙伴,可以保存图片到wx扫描二v码 免费领取【保证100%免费】🆓
👉AI大模型学习路线汇总👈
大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)
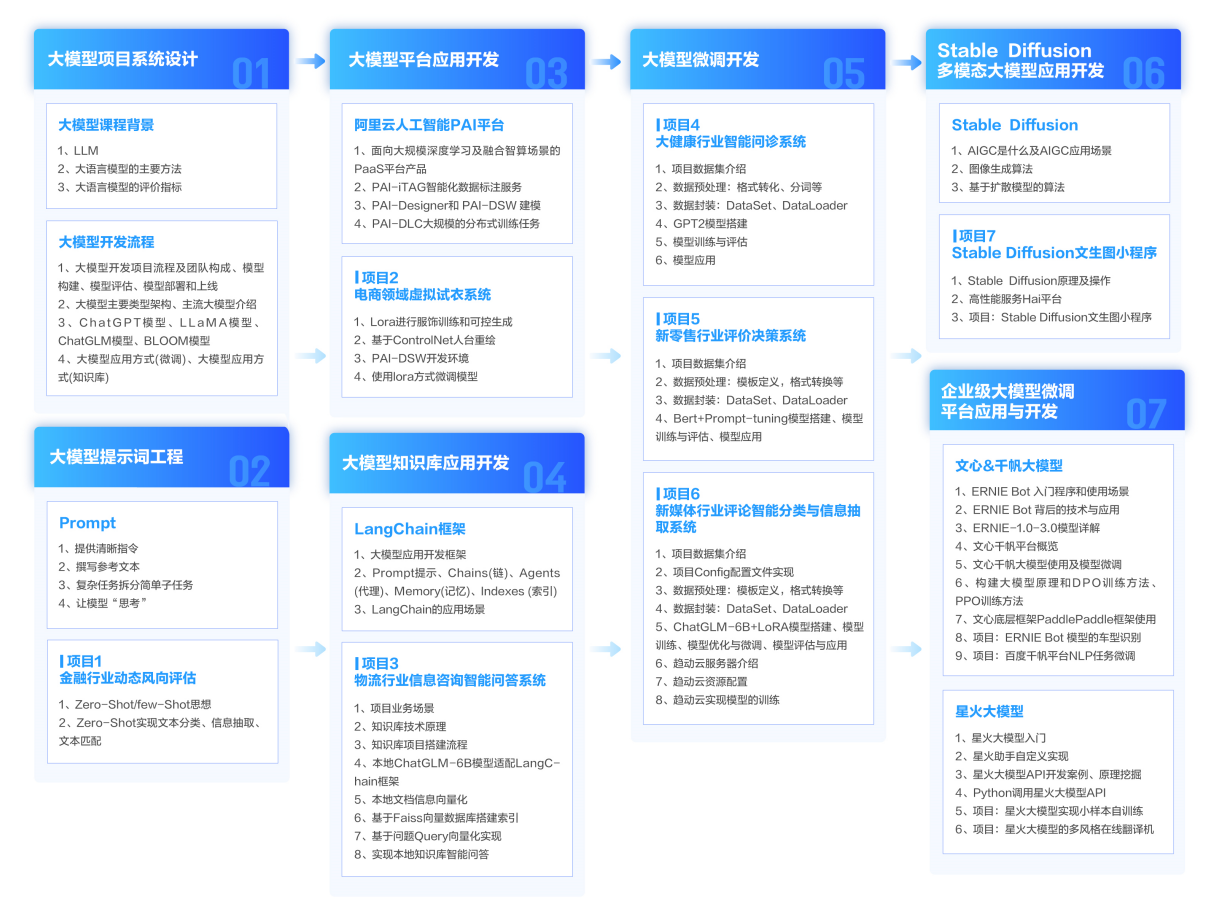
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码 免费领取【保证100%免费】🆓